https://arxiv.org/pdf/2512.12309
摘要
开放词汇目标检测旨在通过文本提示检测任意类别。没有跨模态融合层(非融合)的方法通过将识别视为检索问题(即在共享嵌入空间中将图像区域与文本查询进行匹配)来提供更快的推理速度。在这项工作中,我们充分探索了这种检索理念,并通过一个名为 WeDetect 的模型家族展示了其在效率和多功能性方面的独特优势:(1) 最先进的性能 。WeDetect 是一个具有双塔架构的实时检测器。我们表明,通过精心策划的数据和充分训练,非融合的 WeDetect 超越了其他融合模型,并建立了强大的开放词汇基础。(2) 历史数据的快速回溯 。WeDetect-Uni 是一个基于 WeDetect 的通用候选区域(proposal)生成器。我们冻结整个检测器,仅微调一个物体性提示(objectness prompt),以跨类别检索通用的物体候选区域。重要的是,候选区域的嵌入是特定于类别的,并支持一种新应用:物体检索,支持在历史数据中检索物体。(3) 与大型多模态模型 (LMMs) 集成用于指代表达理解 (REC)。我们进一步提出了 WeDetect-Ref,这是一个基于 LMM 的物体分类器,用于处理复杂的指代表达,它从 WeDetect-Uni 提取的候选区域列表中检索目标物体。它摒弃了耗时的下一个词元预测(next-token prediction),并在单次前向传播中对物体进行分类。总之,WeDetect 家族在连贯的检索框架下统一了检测、候选区域生成、物体检索和 REC,在 15 个基准测试中实现了最先进的性能,并具有极高的推理效率。代码已开源:https://github.com/WeChatCV/WeDetect。
1. 引言
识别是计算机视觉的核心问题。在图像级别,该领域已从闭集图像分类 12, 22, 27 发展到由大规模图像-文本对比学习驱动的开放词汇图像检索 58。与此同时,开放词汇目标检测 16, 17, 40, 48 超越了闭集检测器 3, 14, 15, 60 的固定标签空间,允许识别和定位由文本提示指定的任意类别。通过将区域特征与文本嵌入对齐,开放词汇检测器无需特定任务的训练即可实现零样本区域识别。
为了改善视觉-语言对齐,最近的开放词汇目标检测器 17, 40, 48 采用了各种深度的跨模态融合机制。虽然实现了高精度,但其计算密集的融合层大幅降低了推理效率。此外,融合使得视觉特征特定于查询,阻碍了不同文本提示之间的特征共享。例如,在包含 1,203 个类别的 LVIS 20 数据集上以 40 的块大小评估 Grounding-DINO 48 时,需要 31 次独立的前向传播,导致每张图像产生数秒的延迟,限制了实际部署。
相比之下,非融合方法采用双塔架构,享有快速的推理速度。我们注意到非融合范式的一个关键特征,即其识别类似于检索问题,它在共享嵌入空间中将图像区域与文本查询进行匹配。这种表述在效率和多功能性方面享有独特的优势。受此洞察的启发,我们通过一个名为 WeDetect 的模型家族充分探索了这种受检索启发的理念:(1) WeDetect ,一个具有实时延迟和卓越开放词汇目标检测性能的强大检测基础;(2) WeDetect-Uni ,一个支持历史数据快速回溯的通用候选区域生成器;(3) WeDetect-Ref ,一个用于复杂表达检测的基于 LLM 的 REC 模型。具体说明如下:WeDetect 从预训练的 CLIP 模型微调而来,包含一个用于编码类别名称的文本编码器和一个用于提取多尺度视觉特征的视觉编码器。分类是通过类别嵌入和图像网格特征之间的点积来执行的。我们不依赖深度融合,而是采用三种关键技术,在保持高效推理的同时实现卓越的开放词汇目标检测性能:(1) 模型预训练 :WeDetect 从强大且预训练良好的 CLIP 模型微调而来,以继承强大的开放词汇能力;(2) 模型架构 :由于主流的 CLIP 变体通常采用 ViT 编码器 12,其简单的设计对检测而言并非最优,我们预训练了一个具有 ConvNeXt 49 骨干网络的 CLIP 变体,它自然地提供了多尺度特征;(3) 训练数据 :我们开发了一个数据引擎来策划一个高质量的数据集,其特征是概念平衡、详尽的注释和多粒度标签,包含 15M15\text{M}15M 张图像和 330M330\text{M}330M 个边界框。这些设计选择共同使得 WeDetect 能够在不使用深度融合的情况下,提供强大的开放词汇目标检测性能和快速推理。
在 WeDetect 的基础上,我们引入了一个通用候选区域生成器 WeDetect-Uni。我们冻结整个检测器,仅训练一个用于分类的物体性嵌入(objectness embedding)。由于检测器被冻结,对应于最高得分候选区域的框嵌入仍然是特定于类别的,因此可用于特定类别的分类。通过将候选区域及其框嵌入一起缓存,我们能够通过 CLIP 风格的点积实现快速的物体检索。在此基础上,我们提出了一种新应用:物体检索,旨在检索包含用户指定物体(即使它们很小,如烟头)的图像。这种细粒度的局部检索任务补充了 CLIP 传统的图像级检索。
为了进一步处理指代表达理解 (REC) 中的复杂表达,我们采用了一个基于 LMM 的分类模型 WeDetect-Ref。给定 WeDetect-Uni 产生的最高得分候选区域以及查询表达,WeDetect-Ref 通过在候选区域上应用新设计的二分类头来检索目标物体。该模型并行处理所有物体,并在单次前向传播中进行预测,消除了顺序解码物体的耗时下一个词元预测。这种基于检索的范式避免了源自语言建模的边界框回归缺陷和源自下一个词元预测的缓慢推理速度,同时充分利用了 LLM 的语言理解和开放词汇能力,实现了快速且准确的分类。
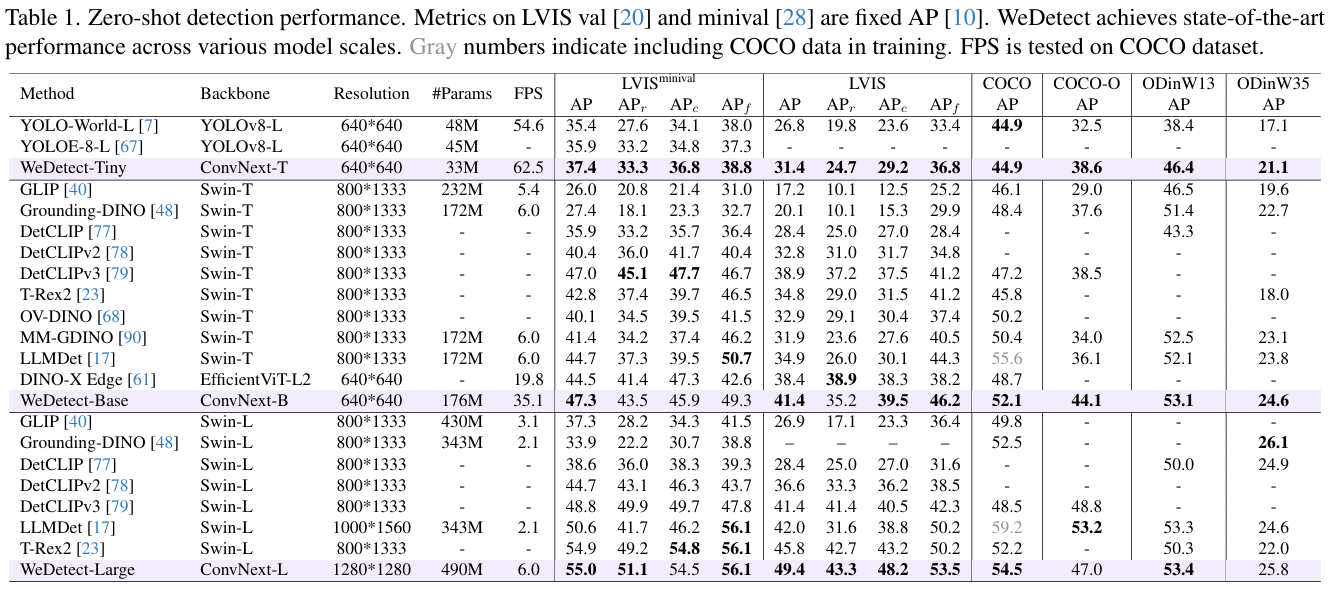
利用基于检索的方法,WeDetect 家族展示了强大的开放词汇能力和极高的推理吞吐量。具体而言,WeDetect-Tiny 在 LVIS minival 上达到了 37.437.437.4 APAPAP,在 LVIS 上达到了 31.431.431.4 APAPAP,速度为 62.562.562.5 fpsfpsfps,分别比运行速度为 54.654.654.6 fpsfpsfps 的 YOLO-World-L 7 高出 2.02.02.0 和 4.64.64.6 APAPAP。通过扩大模型规模,WeDetect-Large 在 LVIS 上达到了 49.449.449.4 APAPAP,比 LLMDet 17 高出 7.47.47.4 APAPAP。在物体检索任务中,WeDetect-Uni 比 CLIP 58 高出 37.237.237.2 的 F1F1F1 分数,展示了其在细粒度感知方面的独特优势。此外,WeDetect-Ref 4B 在 refcoco/+/g 29 上获得了 93.293.293.2 的平均分,比 Qwen3-VL 1 4B 高出 6.56.56.5 分,且速度提升了 131313 倍。我们希望这种检索范式能被研究界广泛采用。
2. 相关工作
2.1 开放词汇目标检测
开放词汇目标检测旨在通过文本提示检测物体,需要细粒度的视觉-语言对齐。为了构建统一的视觉-语言空间,先前的工作主要集中在四个方面:(1) 训练数据构建 :GLIP 40 首先通过区域-词对比预训练统一了目标检测和短语接地(phrase grounding),从而可以利用海量图像-文本对进行训练。网络规模图像-文本对中存在的庞大词汇表构建了强大的视觉-语言空间。此外,构建硬负样本 39, 77, 78, 89 可以提供更丰富的监督并实现细粒度对齐。通过扩大数据和计算规模 55, 78,模型可以实现令人印象深刻的零样本性能。(2) 训练目标 :除了区域-词对比学习,统一其他语言任务(包括掩码语言建模 86、密集描述 50, 79 以及与大型语言模型联合训练 17),用语言知识丰富了视觉表示,从而创建了更强大的开放词汇检测器。(3) 视觉-语言融合层 :联合集成视觉和文本特征的深度视觉-语言融合层 13, 19, 40, 48, 68 可以进一步改善视觉-语言对齐。然而,这些计算密集的融合层极大地降低了推理效率。并且提取的视觉特征无法在不同的查询之间共享。(4) 模型蒸馏:其他方法 15, 16, 18, 70 旨在从其他基础模型中蒸馏开放词汇知识。在这项工作中,我们重新审视了深度融合架构,并提出了一系列遵循检索方法的简单架构模型。
2.2 大型视觉-语言模型
大型视觉-语言模型 (LVLMs) 1, 2, 6, 72 在海量语料库上预训练,不仅展示了专业的世界知识和推理能力,还展示了卓越的视觉感知和理解能力。因此,LVLMs 擅长开放词汇感知。为了扩展 LVLMs 的区域感知能力 41, 82, 83, 87,每个物体将被单独编码为特殊的词元。然而,语言建模机制限制了它们进行精确的物体定位,因为数字被编码为单独的离散词元,并通过交叉熵损失进行优化。为了消除回归缺陷,一些方法 34, 65, 66 利用额外的解码器来解码物体词元,而另一些方法 24, 26, 47, 88 预先提取一些候选区域供 LLMs 参考。然而,这些方法仍然遵循下一个词元预测机制,其中物体是顺序解码的。因此,推理速度受到极大限制。在这项工作中,我们遵循检索方法,并利用 LLM 作为分类器来并行处理物体。
3. WeDetect: 强大的检测基础
在这项工作中,我们的目标是遵循检索方法,开发一个简单、快速且具有多种用途的开放词汇目标检测器。基于这个目标,我们摒弃了耗时的融合层。相反,我们采用了 CLIP 58 的双塔架构,并将其扩展到区域级感知。为了实现细粒度的视觉-语言对齐,我们在数据集构建和模型训练方面做出了巨大努力,详情如下。
3.1 模型架构
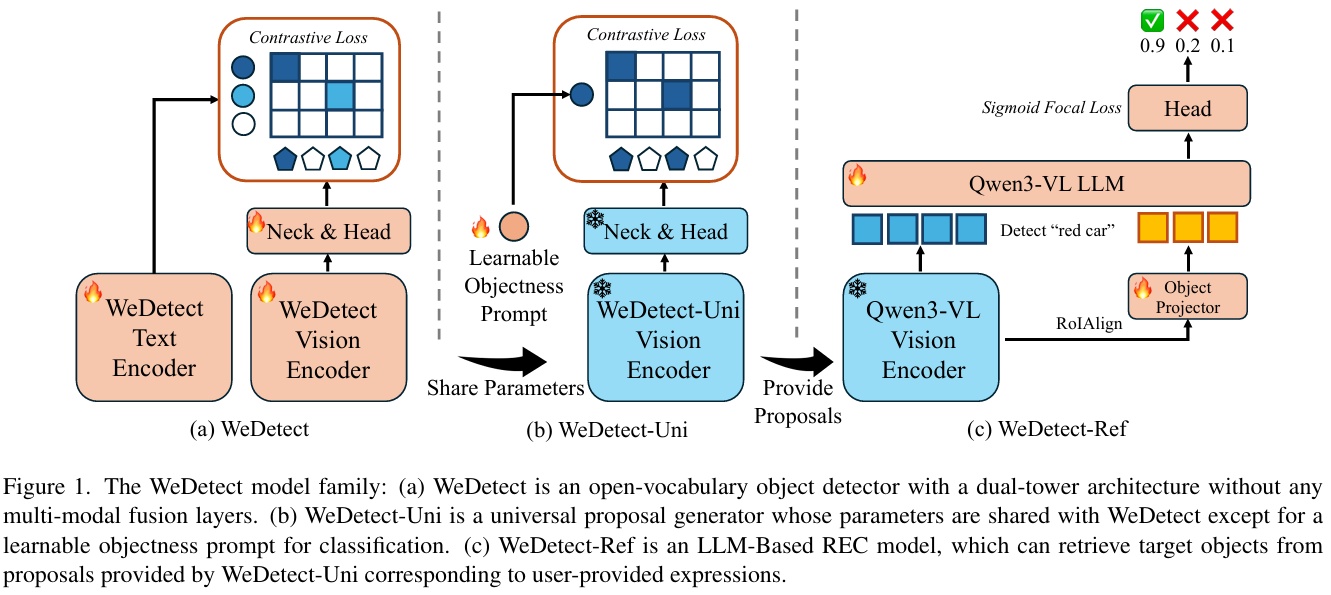
WeDetect 是一个双塔架构模型,如图 1(a) 所示。语言编码器从 XLM-RoBERTa 8 初始化,而视觉编码器遵循类似 YOLO 的架构,包含一个 ConvNeXt 49 骨干网络以产生多尺度特征,一个 CSPRepBiFPAN 颈部网络 (neck) 37,以及一个 YOLO-World 7 对比头。损失函数和标签分配策略与 YOLO-World 完全相同,即用于分类的区域-文本对比损失以及边界框回归损失。与 YOLO-World 不同的是,我们在颈部网络中不使用任何融合层。分类简单地通过图像网格特征和类别文本嵌入之间的点积来进行。这种简单优雅的架构确保了高推理速度。
3.2 数据集构建
高质量的数据集应该具有丰富的多样性和准确的标注。虽然开源的接地(grounding)数据集(例如 GoldG 40)包含多样化的文本表达,但它们在数据集大小、图像多样性、标注完整性和标注多样性方面存在局限。因此,我们收集了一个具有平衡采样图像和高质量标注的大规模接地数据集。
源图像采样 。我们首先从各种数据集中采样源图像,包括 SAM-1B 31、LAION 62、CC12M 4、Zero 74 以及从授权网站自行抓取的图像。与图像配对的原始描述(如果存在)用于选择一些罕见的名词以平衡概念。总共,源图像包含 15M15\text{M}15M 个样本,涵盖了来自各个领域的广泛概念,确保了高度的图像多样性。
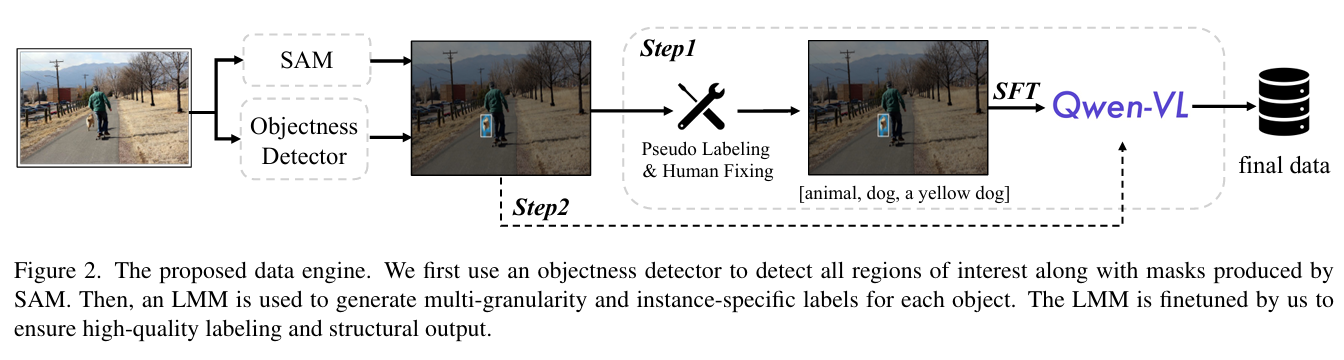
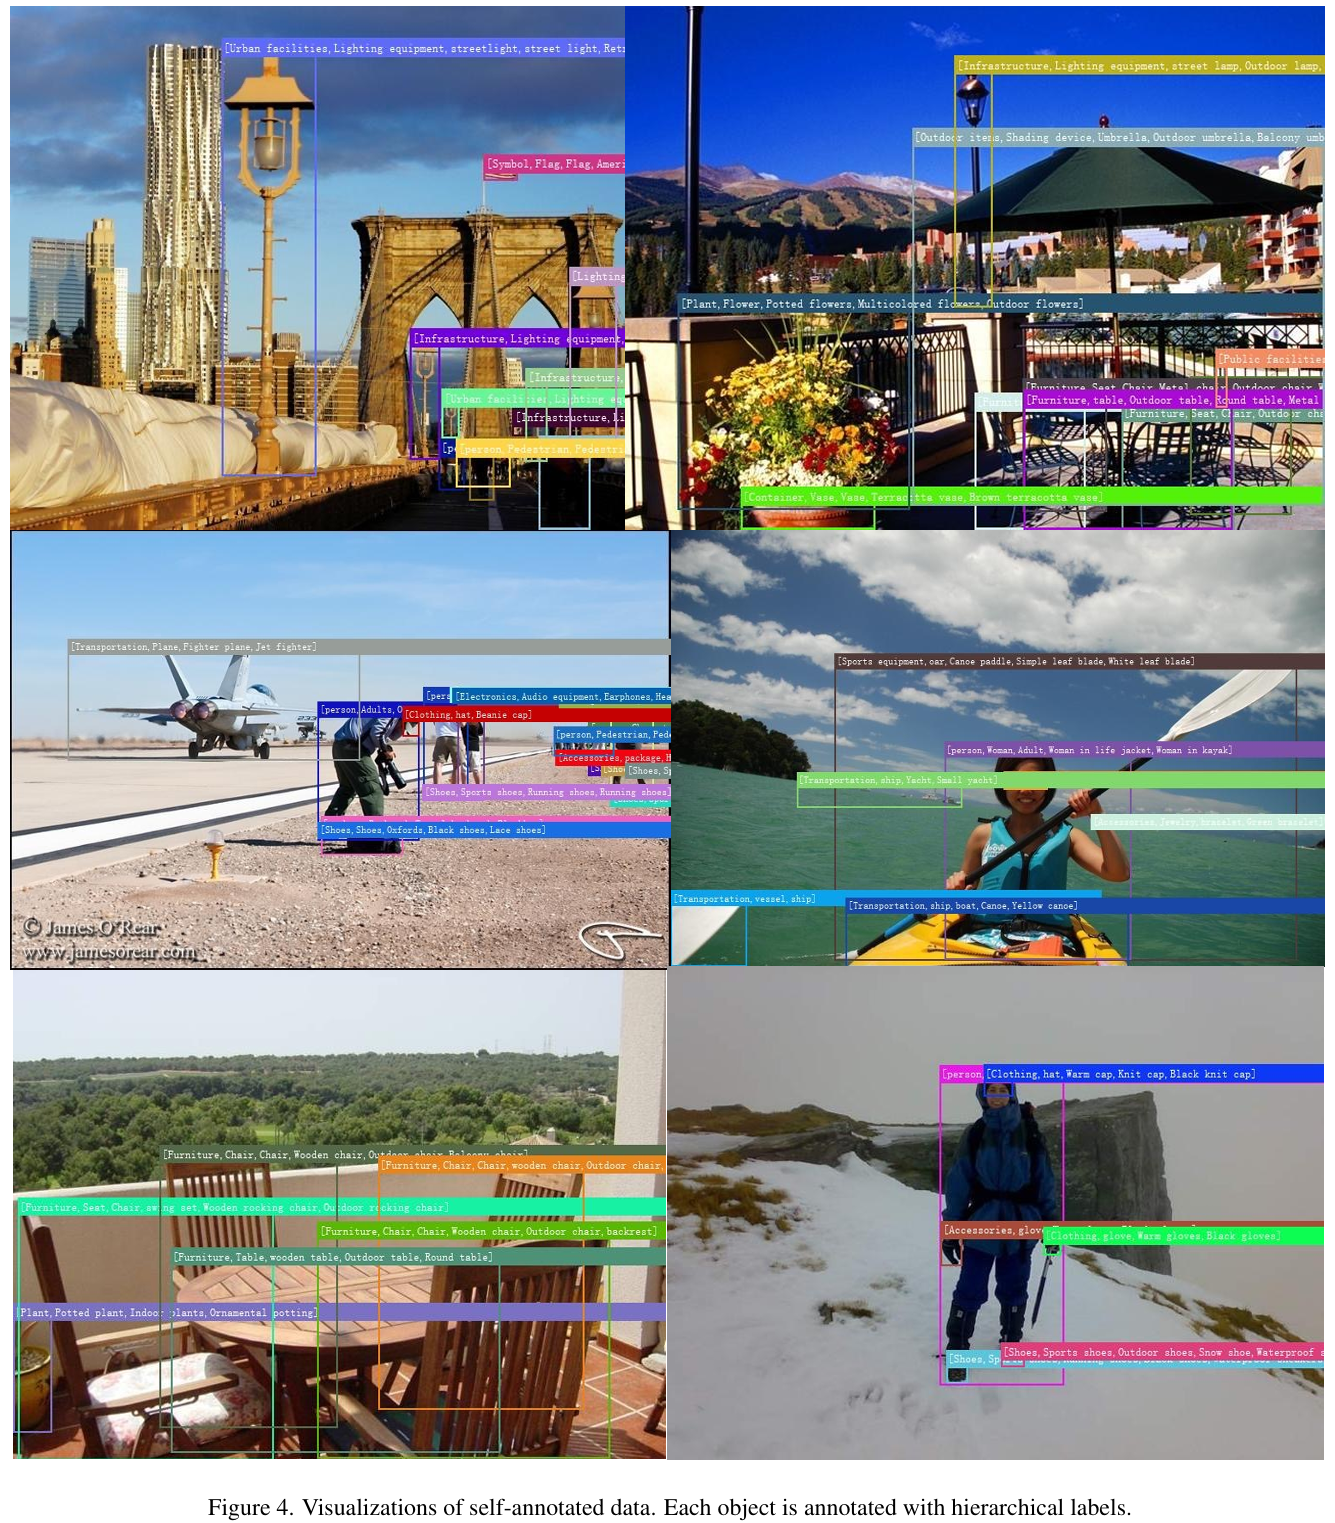
边界框标注流程。我们进一步提出了一种自动数据引擎,用高质量和多粒度标签标注图像,如图 2 所示。为了确保高度的文本多样性,我们采用生成方法来生成特定于实例的标注。具体而言,我们首先使用所有可用的目标检测数据集训练一个物体性检测器。该物体性检测器召回图像中的所有物体,从而确保了标注的完整性。然后,使用现代 MLLM Qwen2.5-VL 7B 2 为每个实例生成特定于实例的层次化标签。例如,如图 2 所示,一只狗将被标注为"动物,狗,一只黄色的狗"。在我们的实验中,这些多粒度标签极大地丰富了文本多样性并提高了性能。为了确保标签质量,我们使用人工标注的指令数据集对 Qwen2.5-VL 模型进行了微调,以增强两种关键能力:结构化输出和拒绝识别。结构化输出要求模型以固定模板输出标签,先输出粗粒度标签,再输出细粒度标签。具有拒绝识别能力的模型不会为错误的边界框生成标签,这也作为对先前候选区域生成的验证。这些边界框将被丢弃。此外,为了增强 Qwen2.5-VL 的局部感知能力,我们在原始图像中使用 SAM 31 产生的掩码突出显示物体边界,并将文本边界框坐标作为模型输入。一旦标注器训练完成,它就可以在没有人工监督的情况下标注剩余的图像。
总之,我们自行标注的数据集包含 15M15\text{M}15M 个样本和 330M330\text{M}330M 个边界框。我们还包含了其他开源的目标检测和接地数据集进行训练,包括 OpenImagesV6 33、Objects365 V2 63、V3Det 69、ImageNetBox 11 和 GoldG 40。详细信息见附录。
3.3 模型训练
分阶段训练方法。为了使模型具备基本的开放词汇能力,我们首先在一个大规模图像-文本数据集上使用类似 CLIP 的图像级对比物体性对模型进行预训练。生成的检查点用于初始化 WeDetect 的视觉骨干网络和语言编码器。由于颈部网络和头部仍然是随机初始化的,在第二阶段,我们冻结视觉骨干网络和语言编码器,仅训练剩余的组件。在最后阶段,所有参数以端到端的方式进行训练。这种分阶段训练方法可以充分利用预训练知识,同时将其从图像级适应到区域级。
多粒度标签采样。在我们自行收集的数据集中,每个物体都标注有多粒度标签。我们提出了一种多粒度标签采样方法作为一种数据增强,在每次训练迭代中独立地从候选列表中为每个物体采样一个标签。细粒度且多样化的文本标签不仅将为单个物体提供丰富的监督,还将为整个批次构建多样化且特定于训练时的词汇表,为学习提供多样化的负样本。这种数据增强极大地提升了开放词汇性能。
4. WeDetect-Uni: 通用候选区域生成器
通过通用物体性提示提取任意物体。在本节中,我们将 WeDetect 扩展为通用候选区域生成器 WeDetect-Uni,无需用户提供文本提示。具体而言,如图 1(b) 所示,我们冻结整个检测器,并训练一个通用的物体性提示用于分类,这类似于线性探测微调。基于 WeDetect 的判别性特征,仅需单个可学习的提示即可实现高召回率。重要的是,与其他类别无关的候选区域网络 60 不同,对应于最高得分候选区域的框嵌入仍然是特定于类别的,这可用于分类,并为以下新应用奠定基础。
新的局部物体检索任务 。在这项工作中,我们提出了一项新任务:物体检索,模型应从数据库中检索包含用户指定物体类别的所有图像。与查询侧重于全局图像语义的图像-文本检索任务不同,物体检索任务关注局部语义,例如"烟头"等小物体,这补充了图像级检索任务。该任务在关键字图像检索、图像内容审查和验证以及其他现实世界应用中具有重要价值。为了进行评估,新任务可以在常见的目标检测数据集上进行,其中类别名称作为用户查询,整个验证集作为数据库,包含特定类别标注的图像构成真实图像集。评估在真实图像集和预测图像集之间进行,指标为精确率 (Precision)、召回率 (Recall) 和 F1F1F1 分数。
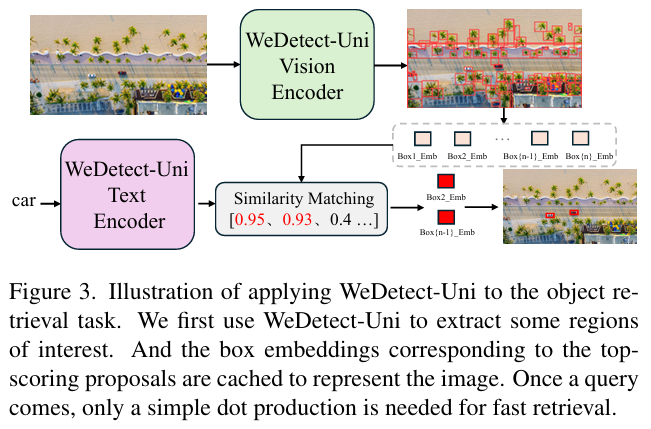
将 WeDetect-Uni 应用于物体检索任务。与将每张图像编码为单个嵌入的 CLIP 不同,我们使用一组物体嵌入来表示图像。如图 3 所示,我们使用 WeDetect-Uni 检测所有感兴趣的区域。对应于最高得分候选区域的框嵌入被预先提取并缓存以表示图像。一旦新的查询到来,只需进行简单的点积即可实现快速检索。
5. WeDetect-Ref: 基于 LLM 的 REC 模型
5.1 将 REC 公式化为检索
在现实世界的应用中,用户查询可能会复杂得多,例如指定外观、材料、位置,甚至需要基于常识的推理能力,这需要深度的语言和语义理解,并对传统检测器提出了巨大挑战。
受最近前沿大型视觉-语言模型的启发,我们的目标是使用它们来处理复杂的指代表达理解 (REC) 任务。然而,必须解决两个关键挑战:首先,由于大型语言模型 (LLMs) 是使用语言建模目标而非回归目标训练的(其中数字被表示为离散词元并通过交叉熵损失优化),这使得模型对精确边界框的敏感度较低。其次,LLMs 以下一个词元预测的方式工作,其中词元必须通过多次模型前向传播顺序生成,导致极长的模型延迟。受 VideoITG 71 的启发,我们将 REC 任务公式化为检索任务,并简单地使用大型语言模型作为分类器,从预先提取的候选列表中检索目标物体。
具体而言,我们首先使用 WeDetect-Uni 提取一些感兴趣的物体作为物体候选列表 {Bi}i=1n\{B_i\}{i=1}^n{Bi}i=1n。如图 1© 所示,对于每个物体,我们从 MLLM 的视觉编码器中提取其多尺度 RoI 特征,然后通过线性物体投影器将其压缩为单个词元 {oi}i=1n\{o_i\}{i=1}^n{oi}i=1n。完整图像词元 III、用户查询 qqq 和物体词元 {oi}i=1n\{o_i\}_{i=1}^n{oi}i=1n 被连接并发送到 LLM 进行分类。分类是通过在物体词元的隐藏嵌入上应用新引入的二分类头来决定该物体是否属于查询来执行的:
{hi}i=1n=LLM(I,q,{oi}i=1n),(1) \{h_i\}{i=1}^n = \text{LLM}(I, q, \{o_i\}{i=1}^n), \quad (1) {hi}i=1n=LLM(I,q,{oi}i=1n),(1)
{si}i=1n=Sigmoid(Classifier({hi}i=1n))∈0,1,(2) \{s_i\}{i=1}^n = \text{Sigmoid}(\text{Classifier}(\{h_i\}{i=1}^n)) \in 0, 1, \quad (2) {si}i=1n=Sigmoid(Classifier({hi}i=1n))∈0,1,(2)
其中 {si}i=1n\{s_i\}_{i=1}^n{si}i=1n 是每个物体的分类得分。
在这种范式中,LLM 仅作为分类器,从类别无关的候选列表中检索与查询对应的目标物体,这具有两个优势:首先,这种基于检索的范式避免了源自语言建模的边界框回归缺陷,同时充分利用了 LLM 的语言理解和开放词汇能力,实现了快速且准确的分类。其次,这种基于检索的范式摒弃了下一个词元预测机制,因此预测可以在单次模型前向传播中进行,实现了卓越的推理速度。尽管先前的工作 24, 88 简要探索了基于检索的范式,但它们仍然遵循下一个词元预测机制,从而限制了推理速度。
5.2 三阶段训练方案
在这项工作中,我们使用 Qwen3-VL 1 作为我们的基础 MLLM,并通过三阶段训练方案扩展其细粒度区域感知能力。
阶段 1:区域投影器训练 。在我们的模型中,我们引入了一个新的特殊词元 "⟨object⟩\langle\text{object}\rangle⟨object⟩" 作为每个物体的占位符。对于每个物体,我们使用 RoIAlign 从最后的视觉特征图和其他深层视觉特征图中提取其多尺度特征。我们使用线性层作为区域投影器,将 RoI 特征压缩为单个词元。边界框将被编码为位置嵌入并添加到物体词元中。然后,在发送到 LLM 之前,占位符将被物体词元替换。在这个阶段,我们仅使用 700K700\text{K}700K 的图像级和区域级描述数据集微调新引入的区域投影器。数据格式如下所示:
user: ⟨image⟩\langle\text{image}\rangle⟨image⟩ Briefly describe the object ⟨object⟩\langle\text{object}\rangle⟨object⟩.
assistant: far right guy. (用户:⟨图像⟩\langle\text{图像}\rangle⟨图像⟩ 简要描述物体 ⟨物体⟩\langle\text{物体}\rangle⟨物体⟩。助手:最右边的家伙。)
阶段 2:区域感知微调 。在这个阶段,我们进一步微调 LLM 和投影器,以更好地与物体词元对齐,而视觉编码器仍然被冻结。除了描述数据外,我们还包含了许多其他图像级和区域级指令微调数据(约 1.7M1.7\text{M}1.7M 条数据),格式与上述相同。微调后,LLM 能够准确感知特定物体。
阶段 3:区域分类微调。在最后阶段,我们将 LLM 微调为分类模型。我们丢弃了原始的语言建模头,而是训练了一个二分类头。分类头仅应用于物体词元的隐藏嵌入上。为了同时处理物体列表,我们将数据模板构建如下:
user: ⟨image⟩\langle\text{image}\rangle⟨image⟩ Please detect the "CLASSNAME" in the image.
assistant: ⟨object⟩⟨object⟩⟨object⟩⟨object⟩⟨object⟩\langle\text{object}\rangle\langle\text{object}\rangle\langle\text{object}\rangle\langle\text{object}\rangle\langle\text{object}\rangle⟨object⟩⟨object⟩⟨object⟩⟨object⟩⟨object⟩
(用户:⟨图像⟩\langle\text{图像}\rangle⟨图像⟩ 请检测图像中的"类别名称"。助手:⟨物体⟩⟨物体⟩⟨物体⟩⟨物体⟩⟨物体⟩\langle\text{物体}\rangle\langle\text{物体}\rangle\langle\text{物体}\rangle\langle\text{物体}\rangle\langle\text{物体}\rangle⟨物体⟩⟨物体⟩⟨物体⟩⟨物体⟩⟨物体⟩)
其中"CLASSNAME"将被用户提供的类别或表达替换,且 ⟨object⟩\langle\text{object}\rangle⟨object⟩ 的数量等于候选区域的数量。我们收集了一些开源的目标检测数据集和指代表达理解数据集,包含 4M4\text{M}4M 个样本用于训练。详细信息总结在附录中。对于损失函数,我们使用以 IoU 作为软标签的 Sigmoid Focal Loss 43。所有与任何真实边界框的 IoU 大于 0.50.50.5 的候选区域都被视为正样本。在这个阶段,可训练的参数也是 LLM 和投影器。其他实现细节将在附录中提供。
6. 实验
6.1 主要结果
WeDetect 以更快的推理速度实现了卓越的开放词汇目标检测性能 。为了展示开放词汇能力,我们以零样本方式在各种目标检测基准上评估 WeDetect,包括 LVIS 20、COCO 42、COCO-O 54 和 ODinW 36。LVIS 是一个具有 1,203 个类别和长尾分布的大词汇量数据集,需要识别广泛的物体。COCO 包含日常场景中的 80 个常见物体类别,而 COCO-O 保留了相同的类别,但将其扩展到六个不同的领域,对跨域泛化提出了挑战。ODinW 包含 35 个具有不同词汇表的多样化目标检测数据集,提供了对零样本迁移能力的全面测试。如表 1 所示,WeDetect 在不同模型规模下均实现了最先进的性能。具体而言,WeDetect-Tiny 在 LVIS minival 上比 YOLO-World-L 7 高出 2.02.02.0 APAPAP,在 LVIS 上高出 4.64.64.6 APAPAP,在 COCO-O 上高出 6.16.16.1 APAPAP,在 ODinW13 上高出 8.08.08.0 APAPAP,在 ODinW35 上高出 4.04.04.0 APAPAP,同时运行速度更快。当扩大模型规模时,WeDetect-Large 在具有挑战性的 LVIS 基准上比先前的 SOTA 模型 T-Rex2 23 高出 3.63.63.6 APAPAP。这些结果凸显了 WeDetect 卓越的开放词汇识别能力。更重要的是,在没有跨模态融合层的情况下,WeDetect 以极快的速度运行。WeDetect-Tiny 的运行速度为 62.562.562.5 fpsfpsfps,超越了针对高效推理优化的 YOLO-World。此外,WeDetect-Base 和 WeDetect-Large 的速度分别是 GroundingDINO 48 的 6 倍和 3 倍,且性能更高。这些结果证明了双塔架构的卓越优势。
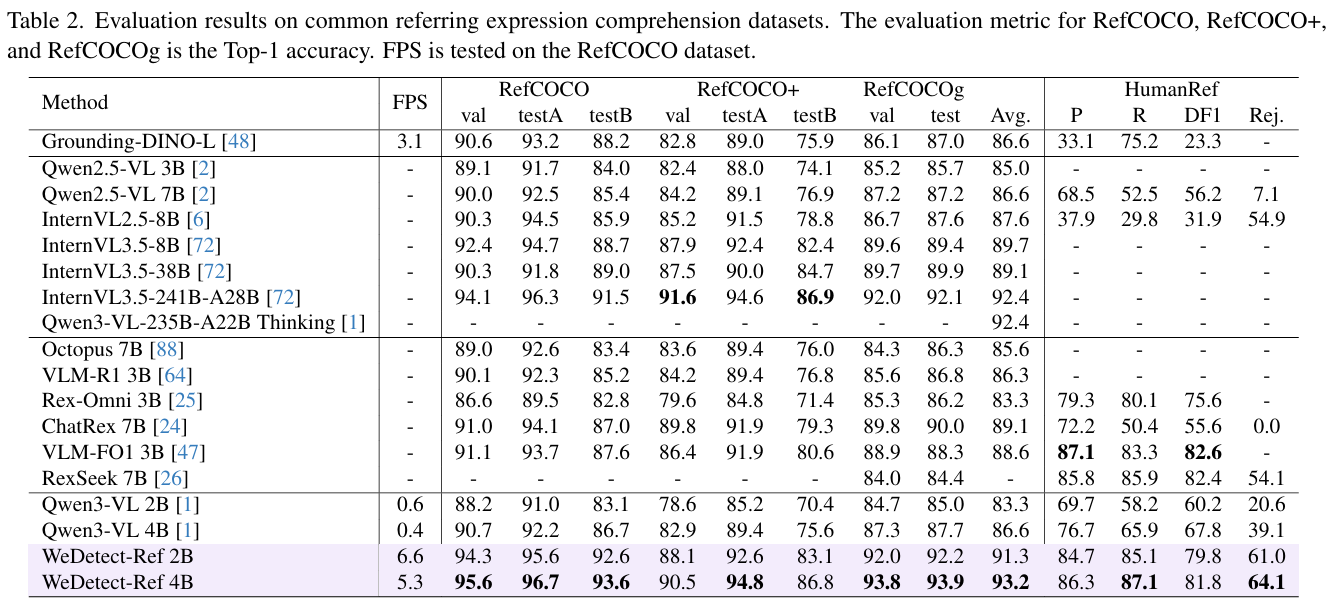
WeDetect-Uni 仅用一个可学习的提示即可获得高召回率 。基于强大的检测基础 WeDetect,WeDetect-Uni 仅训练一个可学习的提示用于通用候选区域生成。我们在三个基准上评估了召回率:COCO 42、LVIS 20 和 PACO-LVIS 59。请注意,这三个基准共享相同的图像,但具有不同的标注粒度。COCO 只有 80 个类别,而 LVIS 将词汇表扩展到 1,203 个类别,PACO 进一步标注了物体部件。多粒度标注为通用候选区域构建了一个理想的基准。如表 3 所示,WeDetect-Large-Uni 在冻结检测器的情况下,在所有数据集上实现了最高的召回率,这证明了 WeDetect 特征的高度判别性。
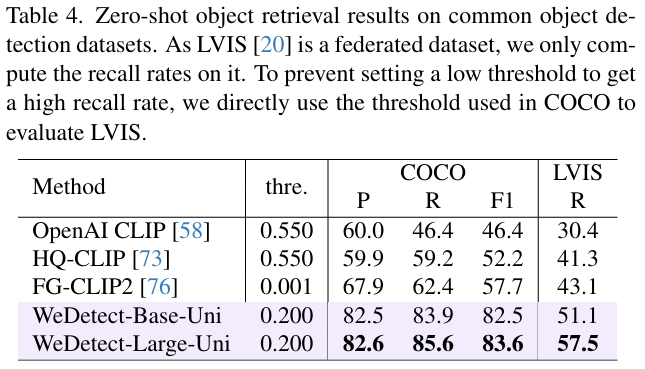
WeDetect-Uni 在区域级物体检索任务中享有独特优势 。在这项工作中,我们提出了一项新应用,称为物体检索,旨在检索包含用户指定物体的图像。我们使用常见的目标检测数据集 COCO val 42 和 LVIS val 20 作为基准数据集,并使用类别名称作为查询。精确率、召回率和 F1F1F1 分数首先在每个类别内计算,然后在不同类别之间取平均。由于 LVIS 是一个联合数据集,并非图像中的所有类别都被标注,我们仅在上面计算召回率。我们选择 OpenAI CLIP ViT-large-patch14-336 58、包含硬负样本训练的 HQ-CLIP-base 73,以及针对细粒度感知优化的 FG-CLIP2-so400M 76 作为图像级感知模型进行比较。如表 4 所示,具有 300 个候选区域的 WeDetect-Large-Uni 显著优于图像级基线,表明物体检索任务是对图像-文本检索任务的补充,且 WeDetect-Uni 在细粒度感知方面享有独特优势。
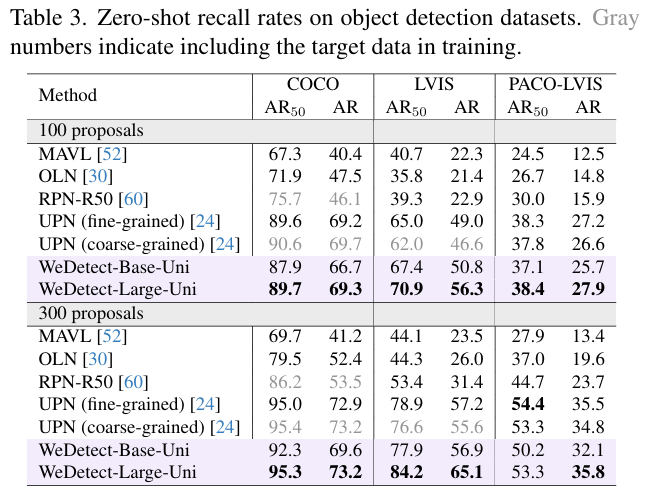
WeDetect-Ref 在 REC 任务中以更少的参数和更快的推理速度表现出色 。我们选择 RefCOCO 29、RefCOCO+ 81、RefCOCOg 53 和 HumanRef 26 作为 REC 基准。如表 2 所示,我们的 WeDetect-Ref 4B 仅使用 4B 参数和来自 WeDetect-Base-Uni 的前 100 个候选区域,在 refcoco/+/g 上实现了最高的 93.293.293.2 平均分,比我们的基线 Qwen3-VL 4B 1 高出 6.66.66.6 分,并超越了其他具有思考能力的更大模型。重要的是,由于我们将 REC 任务公式化为检索任务并摒弃了下一个词元预测机制,WeDetect-Ref 4B 以极快的速度运行,比 Qwen3-VL 4B 快 13 倍,甚至比 Grounding-DINO-L 48 还要快。在我们的场景中,每张图像将表示为 900-1600 个词元,并使用 100 个候选区域,每张图像包含约 1000 个词元。这种简单朴素的架构(仅包含自注意力层)可以很容易地被现代 GPU 和 Flash Attention 9 加速。此外,WeDetect-Ref 的推理时间与目标物体的数量一致,而具有下一个词元预测的方法的时间将线性增加。在准确性和推理速度方面的双重优势证明了新范式的有效性。
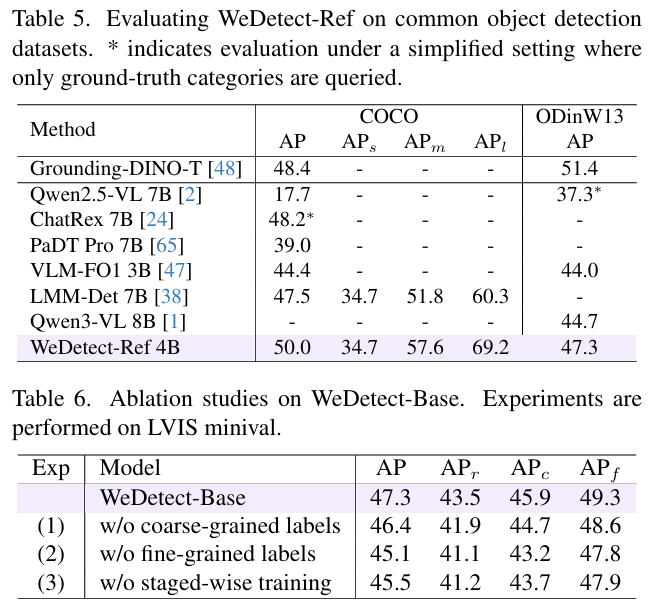
WeDetect-Ref 在多类别多实例目标检测任务中也表现出色 。尽管目标检测对于传统检测器来说是一个相对容易的任务,但它对 LMMs 提出了巨大挑战,原因有二:首先,由于图像可能包含多个实例,具有下一个词元预测的 LMMs 倾向于预测物体的一小部分,导致召回率低。其次,最近的 LMMs 倾向于为每个查询预测物体,无法拒绝图像中不存在物体的负查询。因此,Qwen2.5-VL 7B 2 在 COCO 数据集上仅获得 17.717.717.7 APAPAP。相比之下,WeDetect-Ref 从候选列表中检索物体,并且每个物体被独立解码,这确保了高召回率,并且它是第一个在 COCO 数据集上超过 505050 APAPAP 的 LMM,首次达到了与传统目标检测器相匹配的性能。WeDetect-Ref 在 ODinW13 上也达到了 47.347.347.3 mAPmAPmAP 的高分。我们在附录中提供了更多实现细节。
6.2 消融实验
WeDetect 不同训练策略的效果 。在这项工作中,我们使用预训练的 CLIP 模型初始化 WeDetect,并使用带有我们具有多粒度标签的接地数据集对其进行微调。对于多粒度标签,我们随机从列表的最后两个标签(最细粒度和第二细粒度)中采样一个。如果没有多粒度标签,文本多样性将大大降低,无法实现细粒度的视觉-语言对齐。在表 6(1) 和 (2) 中,仅使用细粒度标签会使 APrAP_rAPr 降低 1.61.61.6,仅使用粗粒度标签会使 APAPAP 降低 2.22.22.2。同时使用多粒度标签实现了最高性能。我们还提出了一种分阶段训练方案,首先训练随机初始化的头部和颈部,然后将整个模型作为一个整体进行训练。在表 6(3) 中,如果不初始化头部和颈部,预训练的 CLIP 特征将受到干扰,导致 APAPAP 下降 1.81.81.8。
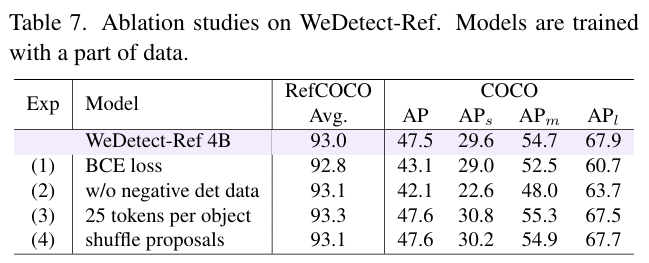
WeDetect-Ref 不同设计选择的效果 。如表 7 所示:(1) Sigmoid focal loss 是目标检测中的标准损失函数,它也适用于 WeDetect-Ref。将其替换为二元交叉熵 (BCE) 损失会导致 COCO 上的 APAPAP 显著下降 4.44.44.4。(2) 负监督对于学习鲁棒的模型至关重要。对于目标检测数据集,图像中不存在的类别作为负查询。添加负检测数据可以显著增加 5.45.45.4 APAPAP 和 7.07.07.0 APsAP_sAPs。(3) 在这项工作中,我们用单个词元表示每个物体以保持效率。我们发现将每个物体的词元数量增加到 25 带来的边际改善微乎其微,同时却使上下文长度膨胀了 25 倍。我们假设完整图像的上下文已经保留了足够的物体细节,使得单个词元足以在物体和全局图像表示之间建立有效的对应关系。(4) 由于 LLM 在注意力层中采用因果掩码,我们研究了候选区域的顺序是否会影响性能。我们观察到,在训练期间,正样本物体可以出现在词元序列的任意位置。因此,模型对候选区域顺序具有鲁棒性,即使候选区域被随机打乱,评估性能也保持稳定。
7. 结论
在这项工作中,我们提出了一系列遵循检索方法的开放词汇检测模型家族,其中目标只是从候选列表中简单地挑选出来,而不是生成特定于查询的临时候选列表。这种设计原则不使用计算密集的跨模态融合层,并确保了高推理速度。遵循该方法论,我们提出了:(1) WeDetect ,一个开放词汇目标检测基础;(2) WeDetect-Uni ,一个通用候选区域生成器,可应用于新的物体检索应用;(3) WeDetect-Ref,一个摒弃下一个词元预测的基于 LLM 的 REC 模型。WeDetect 模型家族在 15 个不同的基准测试中实现了最先进的性能,展示了强大的泛化能力,并且仍然以极快的速度运行。
补充材料 (Supplementary Material)
表 8. WeDetect 训练数据集
| 样本数 | 数据集 |
|---|---|
| 5.0M5.0\text{M}5.0M | OpenImagesV6 (1.74M1.74\text{M}1.74M) 33, Objects365 V2 (1.74M1.74\text{M}1.74M) 63, V3Det (0.18M0.18\text{M}0.18M) 69, ImageNetBox (0.54M0.54\text{M}0.54M) 11, GoldG (0.8M0.8\text{M}0.8M) 40 |
| 15.0M15.0\text{M}15.0M | 自行收集的数据 (15.0M15.0\text{M}15.0M) |
表 9. WeDetect-Ref 训练数据集
| 阶段 | 样本数 | 任务 | 数据集 |
|---|---|---|---|
| 阶段 1 | 685k685\text{k}685k | 图像描述 | LLaVA Pretrain (558k558\text{k}558k) 45 |
| 阶段 1 | 685k685\text{k}685k | 区域描述 | refcoco/+/g (127k127\text{k}127k) 29, 53, 81 |
| 阶段 2 | 1685k1685\text{k}1685k | 图像问答 | LLaVA-OneVision-SI (835k835\text{k}835k) 35 |
| 阶段 2 | 1685k1685\text{k}1685k | 接地对话 | VCR (213k213\text{k}213k) 84, Osprey (145k145\text{k}145k) 82 |
| 阶段 2 | 1685k1685\text{k}1685k | 区域描述 | refcoco/+/g (56k56\text{k}56k) 29, 53, 81, DAM-LVIS (90k90\text{k}90k) 41, VG (346k346\text{k}346k) 32 |
| 阶段 3 | 3911k3911\text{k}3911k | 检测 | V3Det (1122k1122\text{k}1122k) 69, LVIS (661k661\text{k}661k) 20, COCO (698k698\text{k}698k) 42 |
| 阶段 3 | 3911k3911\text{k}3911k | REC | refcoco/+/g (127k127\text{k}127k) 29, 53, 81, flickr (185k185\text{k}185k) 57, humanref (135k135\text{k}135k) 26, Ref-L4 (45k45\text{k}45k) 5, grefcoco (209k209\text{k}209k) 44, FineCops-Ref (182k182\text{k}182k) 46, reircoco (547k547\text{k}547k) 21 |
表 10. WeDetect-Ref 训练设置
| 配置 | 阶段 1 | 阶段 2 | 阶段 3 |
|---|---|---|---|
| 训练模块 | 投影器 | 投影器 + LLM | 投影器 + LLM |
| 训练目标 | 语言建模损失 | 语言建模损失 | Sigmoid focal loss |
| 批次大小 | 256256256 | 128128128 | 128128128 |
| 学习率 | 1e−31\text{e}-31e−3 | 1e−51\text{e}-51e−5 | 1e−51\text{e}-51e−5 |
| 轮数 (epoch) | 111 | 111 | 111 |
8. 局限性
与其他具有下一个词元预测的 LMMs 不同,WeDetect-Ref 是一个二分类模型,不支持在单次前向传播中检测多个查询。相反,我们可以多次检测多个查询,然后合并结果,类似于 Grounding-DINO 在 LVIS 上的推理管道。表 5 中在 COCO 和 ODinW13 上的高性能证明了该机制的有效性。此外,由于 WeDetect-Ref 比 Qwen3-VL 享有 131313 倍的速度提升,即使进行少量查询,WeDetect-Ref 的运行速度仍然可以比它更快,同时获得更高的性能。
9. 实现细节
WeDetect 使用约 20M20\text{M}20M 个样本进行训练,包括 15M15\text{M}15M 自行收集的数据和 5M5\text{M}5M 开源数据。详细信息总结在表 8 中。每个类别名称被单独编码并表示为单个嵌入。对于头部和颈部初始化,模型以 5e−45\text{e}-45e−4 的学习率训练了 202020 个 epoch。对于端到端训练,模型以 1e−51\text{e}-51e−5 的学习率训练了 303030 个 epoch。总批次大小为 320320320。
WeDetect-Ref 从 Qwen3-VL 1 微调而来,使用三阶段训练策略。训练数据和配置分别总结在表 9 和表 10 中。如表 7 所示,我们发现结合负检测数据对于实现高检测性能至关重要。为此,对于检测数据集中的每张图像,我们选择三个负类别名称作为负训练样本。这些负类别名称是基于 WeDetect 在负类别中的前 3 个置信度预测选择的,作为硬负样本。用于训练和评估的候选区域是由 WeDetect-Base-Uni 生成的前 100 个边界框。在训练期间,如果真实边界框与任何提议的边界框都没有重叠,则将其直接添加到提议集中,以确保每个真实实例至少有一个正匹配。输入图像尺寸被限制在 900×32×32900 \times 32 \times 32900×32×32 到 1600×32×321600 \times 32 \times 321600×32×32 之间,对应于 900900900--160016001600 个视觉词元。由于 WeDetect-Ref 每次前向传播只能处理一个查询,我们在评估目标检测基准时,对每个查询分别进行推理,然后合并结果。例如,在 COCO 数据集上,模型每张图像运行 808080 次,每个类别一次。
10. 更多实验结果
10.1 基于语言的目标检测性能
基于语言的目标检测将类别名称扩展为灵活的语言表达,用于开放词汇目标检测 (OVD),并克服了指代表达理解 (REC) 仅能接地已存在物体的限制,这是两者的结合任务。我们在常用的 D3 75 数据集上评估了我们的模型。如表 11 所示,得益于其在 OVD 和 REC 上的高性能,WeDetect-Ref 以超过 101010 APAPAP 的优势显著优于其他模型。
10.2 详细的 WeDetect 评估结果
在表 12、表 13 和表 14 中,我们分别提供了 WeDetect 在 COCO 42、ODinW35 36 和 COCO-O 54 上的详细评估结果。在所有基准测试中均衡且高性能的表现证明了 WeDetect 系列卓越的开放词汇能力。
表 11. 在 D3 75 数据集上的零样本评估
| 模型 | Full | Pres | Abs |
|---|---|---|---|
| OFA-DOD-B 75 | 21.621.621.6 | 23.723.723.7 | 15.415.415.4 |
| Grounding-DINO-B 48 | 20.720.720.7 | 20.120.120.1 | 22.522.522.5 |
| OWLv2 55 | 22.822.822.8 | 22.122.122.1 | 24.724.724.7 |
| GLIP-T 40 | 19.119.119.1 | 18.318.318.3 | 21.521.521.5 |
| FIBER-B 13 | 22.722.722.7 | 21.521.521.5 | 26.026.026.0 |
| Gen-Enhanced-Negs 89 | 26.026.026.0 | 25.225.225.2 | 28.128.128.1 |
| Weak-to-Strong 56 | 30.830.830.8 | 31.031.031.0 | 30.430.430.4 |
| InternVL2-8B 6 | 9.89.89.8 | 11.011.011.0 | 6.26.26.2 |
| Griffon-13B 85 | 12.312.312.3 | 12.412.412.4 | 12.212.212.2 |
| Groma-7B 51 | 16.016.016.0 | 15.915.915.9 | 16.316.316.3 |
| InternVL2-76B 6 | 25.325.325.3 | 25.725.725.7 | 23.523.523.5 |
| ROD-MLLM-7B 80 | 29.729.729.7 | 30.030.030.0 | 28.728.728.7 |
| WeDetect-Ref 2B | 41.841.841.8 | 43.943.943.9 | 35.435.435.4 |
| WeDetect-Ref 4B | 42.042.042.0 | 44.044.044.0 | 35.835.835.8 |
表 12. COCO 42 上的详细零样本结果
| 模型 | APAPAP | AP50AP_{50}AP50 | AP75AP_{75}AP75 | APsAP_sAPs | APmAP_mAPm | APlAP_lAPl |
|---|---|---|---|---|---|---|
| WeDetect-Tiny | 44.944.944.9 | 61.461.461.4 | 48.948.948.9 | 26.626.626.6 | 49.849.849.8 | 62.362.362.3 |
| WeDetect-Base | 52.152.152.1 | 69.469.469.4 | 57.057.057.0 | 34.834.834.8 | 57.157.157.1 | 69.269.269.2 |
| WeDetect-Large | 54.554.554.5 | 72.972.972.9 | 59.759.759.7 | 42.242.242.2 | 59.959.959.9 | 66.566.566.5 |
表 13. ODinW35 36 上的详细零样本结果
(注:表格中 ✓\checkmark✓ 表示该数据集包含在评估中,数值为对应模型的 APAPAP)
| 数据集 | WeDetect-Tiny | WeDetect-Base | WeDetect-Large |
|---|---|---|---|
| AerialMaritimeDrone large | 10.810.810.8 | 13.513.513.5 | 11.011.011.0 |
| AerialMaritimeDrone tiled | 19.219.219.2 | 19.719.719.7 | 25.425.425.4 |
| AmericanSignLanguageLetters | 2.72.72.7 | 4.54.54.5 | 5.15.15.1 |
| Aquarium | 22.622.622.6 | 30.030.030.0 | 33.333.333.3 |
| BCCD | 5.25.25.2 | 4.04.04.0 | 9.49.49.4 |
| boggleBoards | 0.60.60.6 | 0.50.50.5 | 1.21.21.2 |
| brackishUnderwater | 4.24.24.2 | 5.85.85.8 | 7.57.57.5 |
| ChessPieces | 6.86.86.8 | 3.93.93.9 | 11.911.911.9 |
| CottontailRabbits | 78.378.378.3 | 78.878.878.8 | 79.179.179.1 |
| dice | 2.02.02.0 | 1.41.41.4 | 2.52.52.5 |
| DroneControl | 2.92.92.9 | 1.71.71.7 | 5.35.35.3 |
| EgoHands generic | 58.258.258.2 | 62.462.462.4 | 65.065.065.0 |
| EgoHands specific | 17.717.717.7 | 21.221.221.2 | 20.320.320.3 |
| HardHatWorkers | 7.27.27.2 | 9.39.39.3 | 10.310.310.3 |
| MaskWearing | 1.21.21.2 | 1.81.81.8 | 2.42.42.4 |
| MountainDewCommercial | 33.033.033.0 | 41.941.941.9 | 44.244.244.2 |
| NorthAmericaMushrooms | 39.839.839.8 | 55.055.055.0 | 41.341.341.3 |
| openPoetryVision | 0.00.00.0 | 0.20.20.2 | 1.11.11.1 |
| OxfordPets by breed | 0.70.70.7 | 1.91.91.9 | 2.62.62.6 |
| OxfordPets by species | 1.91.91.9 | 11.811.811.8 | 8.98.98.9 |
| PKLot | 0.00.00.0 | 0.00.00.0 | 0.80.80.8 |
| Packages | 67.967.967.9 | 68.368.368.3 | 71.371.371.3 |
| PascalVOC | 61.161.161.1 | 64.964.964.9 | 66.666.666.6 |
| pistols | 52.152.152.1 | 65.265.265.2 | 69.569.569.5 |
| plantdoc | 1.71.71.7 | 2.22.22.2 | 4.24.24.2 |
| pothole | 13.613.613.6 | 24.524.524.5 | 24.324.324.3 |
| Raccoons | 53.153.153.1 | 50.950.950.9 | 52.352.352.3 |
| selfdrivingCar | 8.28.28.2 | 9.39.39.3 | 10.410.410.4 |
| ShellfishOpenImages | 45.745.745.7 | 59.959.959.9 | 60.760.760.7 |
| ThermalCheetah | 0.80.80.8 | 0.10.10.1 | 2.92.92.9 |
| thermalDogsAndPeople | 40.740.740.7 | 53.553.553.5 | 52.852.852.8 |
| UnoCards | 0.00.00.0 | 0.00.00.0 | 1.11.11.1 |
| VehiclesOpenImages | 59.959.959.9 | 63.363.363.3 | 67.367.367.3 |
| WildfireSmoke | 14.014.014.0 | 25.425.425.4 | 24.324.324.3 |
| websiteScreenshots | 3.33.33.3 | 3.63.63.6 | 5.15.15.1 |
| ODinW13 平均 | 46.446.446.4 | 53.153.153.1 | 53.453.453.4 |
| ODinW35 平均 | 21.121.121.1 | 24.624.624.6 | 25.825.825.8 |
表 14. COCO-O 54 上的详细零样本结果
| 模型 | Cartoon | Handmake | Painting | Sketch | Tattoo | Weather | Average |
|---|---|---|---|---|---|---|---|
| WeDetect-Tiny | 43.543.543.5 | 28.828.828.8 | 42.942.942.9 | 44.744.744.7 | 27.127.127.1 | 44.744.744.7 | 38.638.638.6 |
| WeDetect-Base | 52.752.752.7 | 37.437.437.4 | 52.052.052.0 | 50.750.750.7 | 22.422.422.4 | 49.649.649.6 | 44.144.144.1 |
| WeDetect-Large | 53.853.853.8 | 37.437.437.4 | 51.551.551.5 | 50.550.550.5 | 35.735.735.7 | 52.552.552.5 | 47.047.047.0 |
11. 可视化
11.1 自行收集数据集的可视化
在这项工作中,我们开发了一个数据引擎来策划一个高质量的数据集,其特征是概念平衡、详尽的注释和多粒度标签。示例如图 4 所示。例如,在第一张图片中,路灯将被标注为层次化标签列表"城市设施, 照明设备, 路灯"。
11.2 WeDetect-Uni 推理结果的可视化
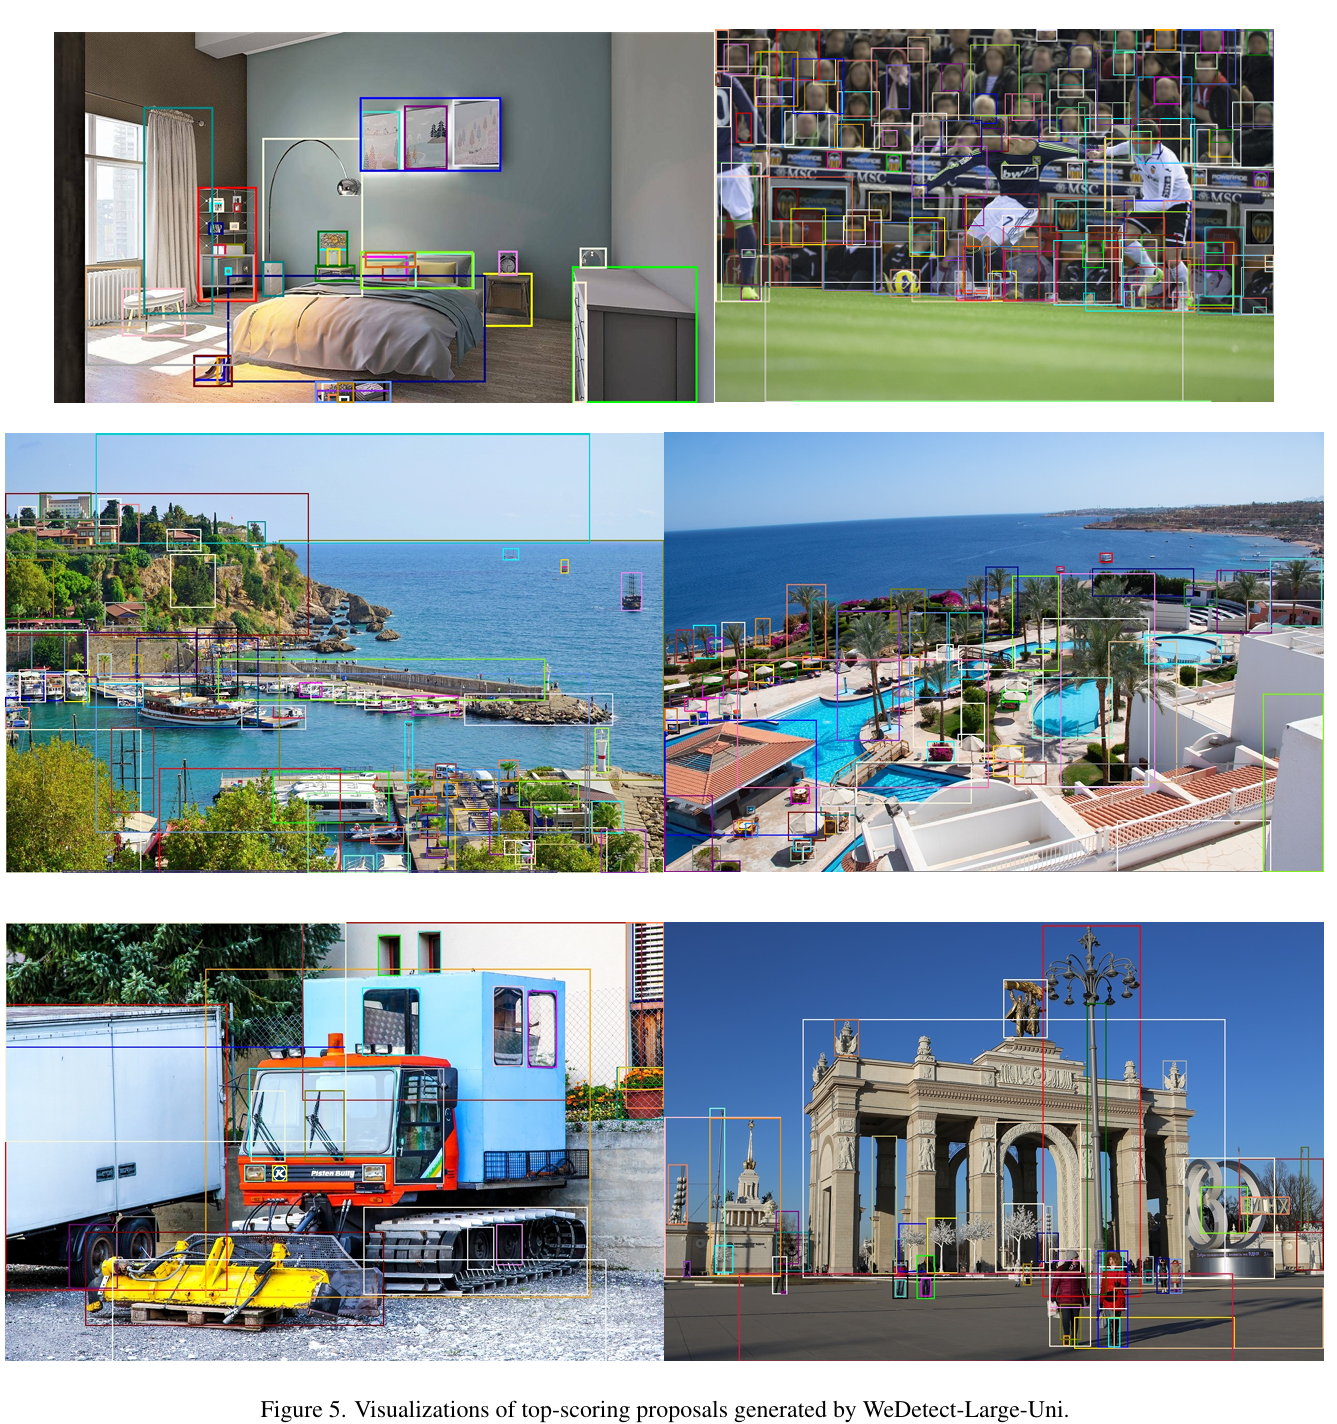
在图 5 中,我们可视化了由 WeDetect-Large-Uni 提取的一些最高得分的候选区域。该模型能够以高召回率提取包含完整物体和物体主要部分的候选区域。
11.3 WeDetect-Ref 推理结果的可视化
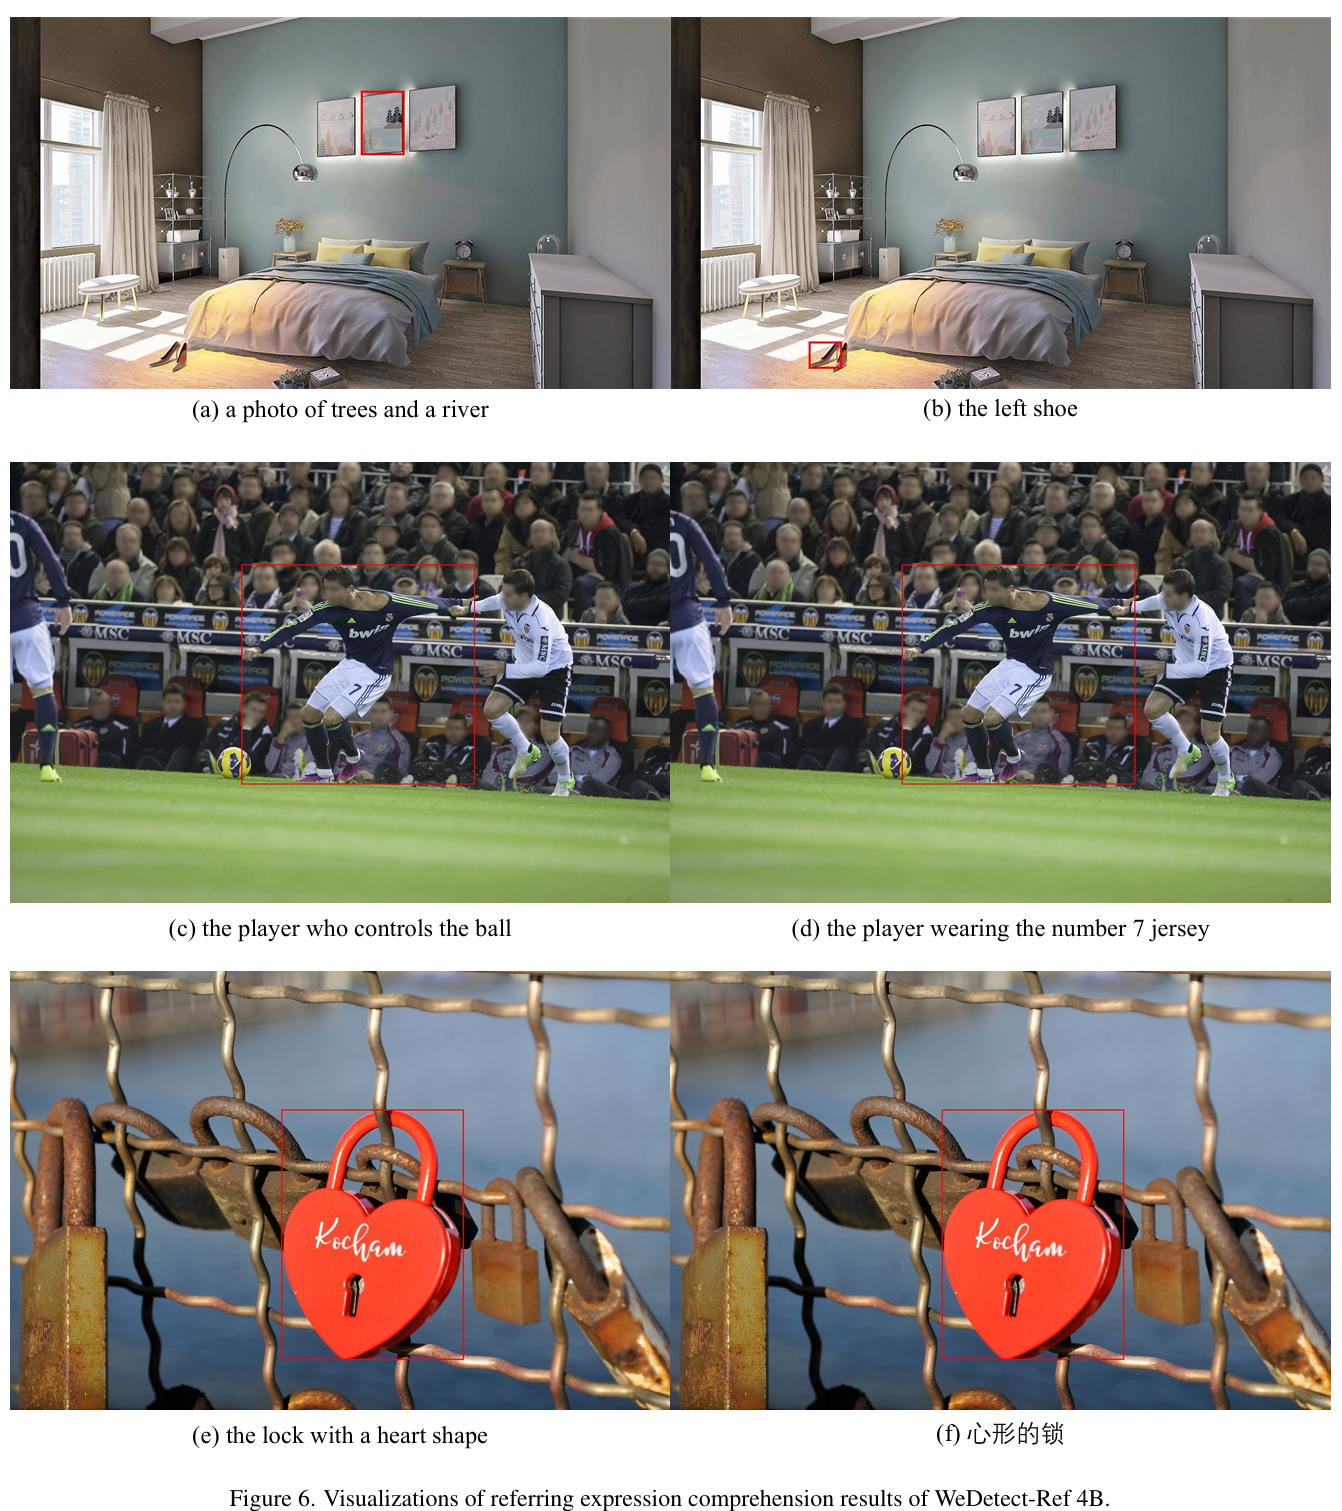
在图 6 中,我们可视化了几个指代表达理解的示例。我们证明了 WeDetect-Ref 能够处理:(a) 具有组合描述的查询,(b) 涉及空间方向的查询,© 需要高级语义理解的查询,以及 (d) 与 OCR 相关的查询。有趣的是,尽管 WeDetect-Ref 仅在英语数据上进行训练,但它仍然可以处理多语言查询 (f),这得益于 Qwen3-VL 1 提供的强大多语言基础。