从线性回归到 KNN,从决策树到聚类,我们一路走过了机器学习的主要算法。但这些算法都有一个共同的特点------它们处理的是"浅层"特征,需要人工提取和选择特征。而深度学习的革命性在于:它能自动从原始数据中提取特征,通过多层非线性变换,端到端地完成从输入到输出的映射。
今天这篇文章,我们正式踏入深度学习的世界。先从核心概念出发,理解深度学习的定义、特点和常见算法,再深入 PyTorch 框架,掌握 Tensor 张量的创建、运算和索引操作------这是所有深度学习代码的基础。
一、什么是深度学习
定义
深度学习是一种机器学习的方法,它的核心思想是通过多层神经网络自动从数据中提取特征,进行非线性变换,实现端到端的训练和调优。
传统机器学习中,特征工程是最耗时也最关键的环节------你需要手动设计特征,比如从图像中提取边缘、从文本中提取词频。而深度学习把这个过程交给模型自己完成:给它原始数据,它通过多层网络逐层提取从低级到高级的特征,最终直接输出预测结果。这就是"端到端"的含义------从输入到输出,中间不需要人工干预。
特点
深度学习有四个显著特点:
自动提取特征。 这是深度学习与传统机器学习最大的区别。卷积神经网络能自动学习图像中的边缘、纹理、形状等特征;Transformer 能自动学习文本中的语法、语义关系。你不需要告诉模型"该关注什么",它自己学。
大数据驱动力。 深度学习是"数据饥渴型"方法------模型参数动辄百万、千亿级别,需要海量数据才能训练好。数据量越大,深度学习的优势越明显;数据量小的时候,传统机器学习反而可能更好。
可解释性差。 深度学习常被称为"黑盒"------模型给出了预测结果,但你很难解释它为什么做出这个判断。虽然可解释性研究在不断推进,但相比决策树"如果特征 A 大于 5 就分为类别 B"这样清晰的规则,深度学习的解释性确实差很多。
非线性的力量。 现实世界的关系大多是非线性的,深度学习通过激活函数(ReLU、Sigmoid 等)引入非线性,使得模型能拟合任意复杂的函数关系。层数越多,能表达的函数越复杂。
二、常见算法
深度学习的算法家族庞大,每种算法擅长不同的领域:
ANN(全连接神经网络):最基础的网络结构,每一层的每个神经元与上一层的所有神经元相连。适合处理结构化表格数据,是理解其他网络的基础。
CNN(卷积神经网络):专为图像处理设计。通过卷积核在图像上滑动,提取局部特征(边缘、纹理、形状),通过池化层降低维度。从 LeNet 到 ResNet 再到 EfficientNet,CNN 在图像识别、目标检测等领域取得了革命性突破。
RNN(循环神经网络):专为序列数据处理设计。网络具有"记忆"功能,能利用之前的信息处理当前输入,适合文本、语音、时间序列等有序数据。但 RNN 存在长距离依赖问题,后来发展出 LSTM 和 GRU 来缓解。
Transformer :当前深度学习最炙手可热的架构。它由编码器和解码器 两部分构成,核心创新是自注意力机制------让模型在处理每个位置时,能直接"看到"序列中所有其他位置的信息,不再像 RNN 那样逐个处理。基于 Transformer 的两大代表:BERT(编码器路线,擅长理解)和 GPT(解码器路线,擅长生成),分别引领了自然语言处理的两个方向。
深度强化学习:将深度学习与强化学习结合,让智能体在与环境的交互中学习最优策略。AlphaGo 就是典型代表------通过深度网络评估棋局,通过强化学习优化策略,最终战胜人类围棋冠军。近年来的代表还有 OpenAI 的 DOTA2 AI(OpenAI Five)和 DeepMind 的星际争霸 AI(AlphaStar),它们展示了深度强化学习在复杂多智能体环境中的潜力。
值得一提的是,这些算法并非孤立存在,实际应用中经常组合使用。比如目标检测模型 YOLO 用 CNN 提取图像特征,再结合回归头输出边界框;自动驾驶系统可能同时使用 CNN 处理视觉输入、用 Transformer 融合多传感器数据、用深度强化学习做决策规划。理解每种算法的特长和局限,才能在实际项目中做出正确的技术选型。
三、应用场景
深度学习已经渗透到生活的方方面面:
-
文本翻译:从 Google 翻译到 DeepL,Transformer 架构让机器翻译质量大幅提升,某些语言对的翻译已接近人类水平
-
目标检测:自动驾驶中的行人识别、车辆检测,安防中的人脸识别,医疗影像中的病灶定位
-
图像识别:手机相册的自动分类、医学影像诊断、工业质检中的缺陷检测
这些场景的共同特点是:数据量大、模式复杂、传统方法效果有限------恰好是深度学习的用武之地。
四、发展史与核心术语
深度学习的"大繁荣"离不开一个人------辛顿(Geoffrey Hinton),被誉为"深度学习之父"。他在 2006 年提出了深度信念网络的训练方法,开启了深度学习复兴的序幕。2012 年,他的学生 Alex Krizhevsky 用深度卷积网络 AlexNet 在 ImageNet 竞赛中以压倒性优势夺冠,将错误率从 26% 大幅降至 15%,震惊学术界,深度学习从此爆发。此后,深度学习的发展一日千里------2014 年 GAN 生成对抗网络问世,2017 年 Transformer 架构提出,2018 年 BERT 刷新 11 项 NLP 记录,2020 年 GPT-3 展示了惊人的少样本学习能力,每一个里程碑都在拓宽深度学习的边界。
理解深度学习,必须掌握三个核心术语:
前向传播:数据从输入层经过隐藏层到输出层的过程,每一层对数据进行线性变换(加权求和)和非线性变换(激活函数),最终得到预测结果。简单说,前向传播就是"让数据走一遍网络,得到预测"。
反向传播 :根据预测结果与真实值的误差,通过链式法则,从输出层向输入层逐层计算梯度,更新每个参数。如果说前向传播是"正向走一遍得到预测",反向传播就是"反向走一遍修正参数"。
梯度下降 :通过梯度指导参数更新的方向和幅度。参数沿着梯度的反方向移动,逐步逼近损失函数的最小值。这三个概念构成了深度学习训练的核心循环:前向传播算预测 → 算误差 → 反向传播算梯度 → 梯度下降更新参数 → 重复。
五、PyTorch:深度学习的利器
为什么选择 PyTorch
PyTorch 是深度学习的一个框架,由 Facebook 于 2016 年发布。它的前身是 Torch,底层基于张量计算。你可以把 PyTorch 理解为"升级版的 NumPy"------它不仅支持 NumPy 的所有数组操作,还增加了两大核心能力:GPU 加速 和自动求导。
GPU 加速让大规模矩阵运算的速度提升几十甚至上百倍,这是训练百万甚至千亿参数模型的必要条件;自动求导让你无需手动推导和实现梯度计算,框架会自动帮你完成反向传播的链式求导。这两点对于深度学习至关重要------深度学习本质上就是大量的矩阵运算和梯度更新,没有 GPU 加速和自动求导,训练一个现代深度学习模型几乎是不可能的。
PyTorch 的设计哲学是"动态图"------每运行一行代码就构建一步计算图,调试方便、直觉性强,这也是它在学术界迅速超越 TensorFlow 的原因。
安装
# CPU 版本
pip install torch torchvision

# GPU 版本(需要先安装 CUDA)
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu118
六、Tensor 张量:PyTorch 的基础数据结构
什么是 Tensor
Tensor(张量)就是 PyTorch 中的数据形式,类似于 NumPy 的 ndarray,但多了 GPU 加速和自动求导的能力。在深度学习中,所有数据------输入特征、标签、模型参数、梯度------都以 Tensor 的形式存在。
张量的创建
PyTorch 提供了丰富的张量创建方式:
import torch

# 从数据创建
t1 = torch.tensor([1, 2, 3])           # 直接从列表创建
t2 = torch.Tensor(2, 3)                # 创建指定维度的随机张量(未初始化)

# 全0全1张量
zeros = torch.zeros(3, 4)              # 3×4 的全0张量
ones = torch.ones(2, 3)                # 2×3 的全1张量

# 随机张量
rand = torch.rand(2, 3)                # 0-1 均匀分布随机数
randint = torch.randint(0, 10, (3, 3)) # 指定范围的随机整数
arange = torch.arange(0, 10, 2)        # 0到10步长为2:[0, 2, 4, 6, 8]
linspace = torch.linspace(0, 1, 5)     # 0到1均匀取5个数:[0, 0.25, 0.5, 0.75, 1]
normal = torch.normal(mean=0, std=1, size=(3, 3))  # 正态分布随机数
Tensor() 和 tensor() 的区别值得注意:tensor() 从已有数据创建张量,类似 np.array();Tensor() 创建指定维度的张量但不保证初始化值,使用时需谨慎。
常见张量类型
PyTorch 支持多种数据类型,常用的有:
| 类型 | PyTorch 表示 | 说明 |
|---|---|---|
| int32 | torch.int32 | 整数默认类型 |
| int64 | torch.int64 | 长整型 |
| float32 | torch.float32 | 浮点数默认类型 |
| float64 | torch.float64 | 双精度浮点 |
| bool | torch.bool | 布尔型 |
默认浮点类型是 float32,默认整数类型是 int32------这一点和 NumPy 的 float64 不同,深度学习中通常用 float32 以节省显存和加速计算。
类型查看与转换
# 查看类型
print(t1.dtype)       # torch.int64

# 类型转换
t_float = t1.float()   # 转 float32
t_double = t1.double() # 转 float64
t_long = t1.long()     # 转 int64
t_short = t1.short()   # 转 int16
t_byte = t1.byte()     # 转 int8
类型转换在深度学习中很常见------比如从数据加载器出来的标签可能是 int64,但某些损失函数要求 float32,就需要手动转换。
Tensor 与 NumPy 互转
PyTorch 和 NumPy 可以无缝互转,这在数据预处理时非常实用:
import numpy as np

# Tensor 转 NumPy
t = torch.tensor([1, 2, 3])
n = t.numpy()           # tensor → numpy

# NumPy 转 Tensor
n = np.array([4, 5, 6])
t = torch.from_numpy(n) # numpy → tensor
内存共享问题 :torch.from_numpy() 和 tensor.numpy() 转换后的对象与原对象共享内存 ------修改一个,另一个也会变。如果你不希望共享内存,用 copy() 创建独立副本:
# 共享内存(修改互相影响)
t = torch.from_numpy(n)

# 独立内存(修改互不影响)
t = torch.tensor(n)          # 方法一:用 tensor() 创建新张量
n = t.numpy().copy()         # 方法二:numpy 后 copy
从 Tensor 取标量值
当 Tensor 只有一个元素时,用 item() 可以取出 Python 标量:
loss = torch.tensor(0.5)
print(loss.item()) # 0.5(Python float,不是 Tensor)这在打印训练损失时很常用------item() 把 Tensor 转成普通数字,避免 Tensor 一直占用显存。
七、张量的数学运算
四则运算
a = torch.tensor([1, 2, 3])
b = torch.tensor([4, 5, 6])

print(torch.add(a, b))    # [5, 7, 9]
print(torch.sub(a, b))    # [-3, -3, -3]
print(torch.mul(a, b))    # [4, 10, 18]  逐元素相乘
print(torch.div(a, b)) # [0.25, 0.4, 0.5] 逐元素相除注意:mul 是逐元素相乘,不是矩阵乘法。div 是逐元素相除,可以用 / 运算符。矩阵不能和标量直接做矩阵除法,但逐元素除法可以用 /。
矩阵乘法
矩阵乘法是深度学习中最频繁的运算------神经网络的每一层本质上就是一个矩阵乘法:
a = torch.tensor([[1, 2], [3, 4]])
b = torch.tensor([[5, 6], [7, 8]])

# 两种写法等价
print(torch.matmul(a, b))  # 矩阵乘法
print(a @ b)                # @ 运算符,更简洁
matmul() 和 @ 完全等价,选哪个看个人习惯。在深度学习代码中,@ 更常见,因为更简洁。
常用函数运算
t = torch.tensor([1.0, 4.0, 9.0])

print(t.sum())    # 求和:14.0
print(t.mean())   # 均值:4.6667
print(t.max())    # 最大值:9.0
print(t.min())    # 最小值:1.0
print(t.abs())    # 绝对值
print(t.sqrt())   # 平方根:[1.0, 2.0, 3.0]
print(t.exp())    # 指数:e^x
print(torch.log(t))  # 对数:ln(x)
这些函数和 NumPy 的用法几乎一致,会 NumPy 就能无缝迁移到 PyTorch。
八、张量的索引与切片
索引和切片是操作张量的基本功,PyTorch 的索引方式与 NumPy 高度一致:
# 一维张量
data = torch.tensor([10, 20, 30, 40, 50])
print(data[0])       # 索引取值:10
print(data[2:])      # 切片:[30, 40, 50]

# 二维张量
data2d = torch.tensor([[1, 2, 3], [4, 5, 6], [7, 8, 9]])
print(data2d[2, 1])      # 取第2行第1列:8
print(data2d[0:2, 0:3])  # 取前2行前3列

# 多维张量
data3d = torch.randn(3, 4, 5)
print(data3d[1, 2, 3])   # 取第1层第2行第3列的元素

# 布尔索引(条件筛选)
mask = data > 20
print(data[mask])        # [30, 40, 50]

# 花式索引(用索引列表取值)
indices = torch.tensor([0, 2, 4])
print(data[indices])     # [10, 30, 50]

# 步长切片
print(data[::2])         # 每隔一个取:[10, 30, 50]
布尔索引在深度学习中特别实用------比如你想知道模型预测中有多少个置信度大于 0.9 的结果,一个布尔索引就能筛出来。花式索引则适合从大数据集中按指定位置抽取样本,比如在强化学习的经验回放中随机采样。
切片操作 [::2] 表示每隔一个取一个,在降采样或隔行取数据的场景中会用到。掌握这些索引和切片操作,你在处理 Tensor 时就能像操作 NumPy 数组一样得心应手。
九、学习心得与建议
第一,深度学习的核心是"自动化"。 传统机器学习的瓶颈在特征工程------需要领域专家手动设计特征。深度学习的革命性在于把这个过程自动化了。理解这一点,你就理解了为什么深度学习能在图像、文本等领域取得碾压性优势------因为这些领域的特征太复杂了,人工设计根本跟不上。
第二,前向传播和反向传播是灵魂。 所有的深度学习框架------PyTorch、TensorFlow、JAX------本质上都在做两件事:帮你高效地做前向传播(矩阵运算)和反向传播(自动求导)。把这两个概念彻底搞懂,后面的所有网络结构都是在这两个基础上的变体。
第三,Tensor 操作是代码基础。 深度学习代码 80% 都在操作 Tensor------创建、变形、运算、索引。把 Tensor 操作练熟,写模型代码时就不会在基础语法上卡壳。建议对照 NumPy 学 PyTorch,两者 API 高度相似,迁移成本很低。
第四,不要被"深度"吓到。 深度学习听起来很高深,但拆开来看:一层网络就是一个矩阵乘法加一个激活函数,多层叠起来就是深度学习。核心概念并不多------前向传播、反向传播、梯度下降、损失函数,这些在前面学线性回归时已经接触过了,深度学习只是把它们用到了更复杂的网络上。
写在最后
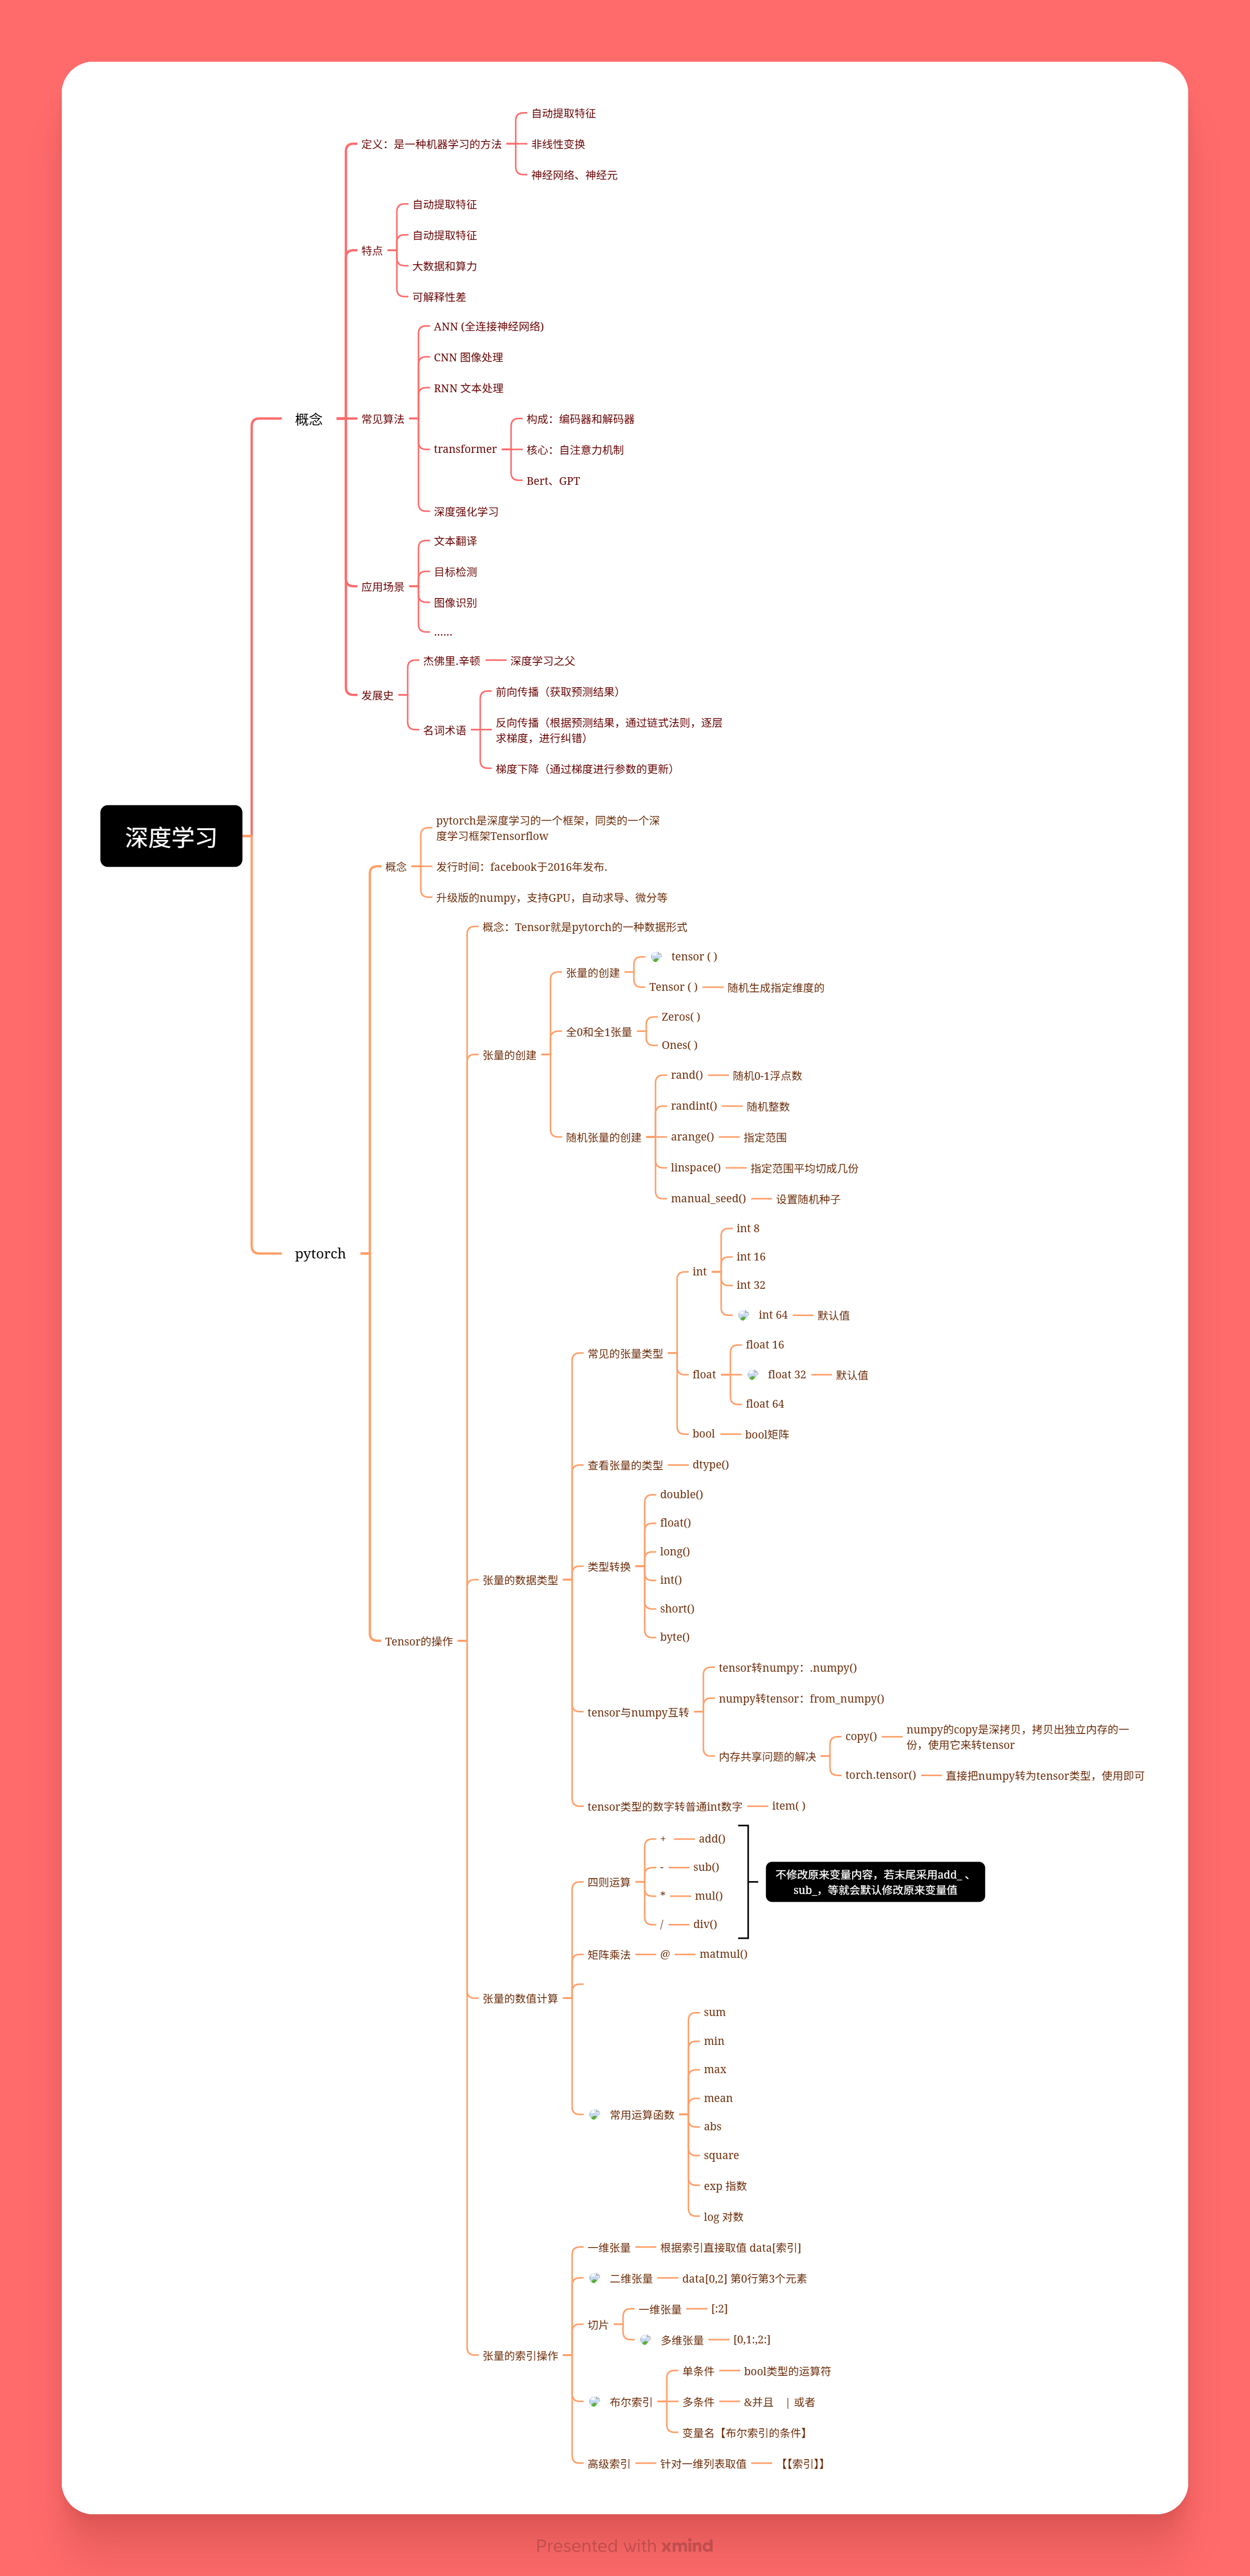
从机器学习到深度学习,我们完成了一次认知升级------从"人工设计特征 + 简单模型"到"自动提取特征 + 深层模型"。这不是对前面知识的否定,而是延展。线性回归中的梯度下降、KNN 中的距离度量、决策树中的特征分裂,这些思想在深度学习中依然以各种形式出现。
今天我们梳理了深度学习的核心概念和 PyTorch 的 Tensor 操作。概念层面,理解了深度学习的定义、特点、常见算法和应用场景;工具层面,掌握了 Tensor 的创建、类型转换、数学运算和索引切片。这些是后续搭建神经网络模型的基础------下篇文章,我们将用 PyTorch 搭建第一个神经网络,把前向传播和反向传播从概念变成代码。
深度学习的世界很大,但入口很清晰:理解概念,掌握工具,动手写代码。迈出第一步,后面的路自然会在脚下展开。
如果这篇文章对你有帮助,欢迎点赞收藏。下一篇我们将用 PyTorch 搭建第一个神经网络,敬请关注。