文章链接: 2007.07646 A Survey of Privacy Attacks in Machine Learning
摘要
随着机器学习的应用越来越广泛,研究其对安全和隐私的影响的需要变得更加迫切。尽管隐私方面的工作在过去几年中一直在稳步增长,但机器学习隐私方面的研究比安全方面受到的关注较少。我们在这项研究中的贡献是对过去七年中发表的 40 多篇与针对机器学习的隐私攻击相关的论文进行了分析。我们提出了一种攻击分类法以及一个威胁模型,该模型允许根据攻击者知识和受到攻击的资产对不同的攻击进行分类。对隐私泄露的原因进行了初步探讨,并对不同的攻击进行了详细分析。最后,我们概述了最常见的防御措施,并讨论了分析过程中确定的开放问题和未来方向。
1 引言
在大量可用数据和硬件进步的推动下,机器学习在学术研究和现实世界应用中经历了巨大的增长。与此同时,机器学习对安全、隐私和公平的影响也越来越受到关注。在隐私方面,几乎所有在线服务都会收集我们的个人数据,并用于训练为机器学习应用程序提供动力的模型。然而,目前尚不清楚这些模型是否以及如何揭示有关其训练所用数据的信息。如果使用位置、健康记录或身份信息等敏感数据来训练模型,那么允许攻击者从模型中提取此信息的攻击是非常不可取的。同时,如果私人数据在未经所有者同意的情况下被使用,则可以使用相同类型的攻击来确定数据的未经授权的使用,从而有利于用户的隐私。
除了对攻击本身越来越感兴趣之外,人们越来越有兴趣揭示导致隐私泄露的原因以及模型在哪些条件下容易受到不同类型的隐私相关攻击。模型泄露信息的原因有多种。其中一些是结构性的,与模型的构建方式有关,而另一些则是由于敏感数据样本的泛化能力差或记忆力差等因素造成的。对抗鲁棒性的训练也可能是影响信息泄漏程度的一个因素。
模型泄露信息的原因:1. 模型的构建与训练方式有关。2. 对敏感样本的过度记忆等因素造成的。3.对抗鲁棒性的训练影响信息泄露。
这项调查的重点是对机器学习算法的隐私和机密性攻击。也就是说,试图提取有关训练数据的信息或提取模型本身的攻击。一些现有的调查89, 8提供了隐私攻击的部分覆盖,并且还有一些其他同行评审的关于47, 2主题的作品。然而,这些论文要么太高级,要么太专注于狭窄的攻击子集。
机器学习的安全性和对抗性攻击对模型性能的影响在社区中得到了广泛的研究,一些调查突出了90, 117, 8, 71, 65领域的主要进展。基于8中提出的分类,对机器学习系统的攻击有三种类型: i) 针对完整性的攻击,例如导致特定样本错误分类的逃避和中毒后门攻击,ii) 针对系统可用性的攻击,例如试图最大化错误分类错误的中毒攻击和iii) 针对隐私和机密性的攻击,即试图推断有关用户数据和模型的信息的攻击。虽然所有针对机器学习的攻击本质上都是对抗性的,但术语 "对抗性攻击" 通常用于指与安全相关的攻击,更具体地说是对抗性样本。在本综述中,我们只关注隐私和机密性攻击。
严格来说,提取有关模型结构和参数的信息的攻击是对模型机密性的攻击。之所以做出包含模型提取攻击的决定,是因为在现有文献中,对模型机密性的攻击通常与隐私攻击90, 8分组在一起。另一个重要的原因是,窃取模型功能也可能被视为侵犯隐私。Veale等人112认为,诸如会员资格推断 (4.1节) 之类的隐私攻击会增加机器学习模型在欧盟通用数据保护条例 (GDPR) 法律下被归类为个人数据的风险,因为它们可以使人被识别。尽管GDPR当前未涵盖模型,但可能会发生将其视为个人数据的情况,然后针对它们的攻击可能与针对个人数据的攻击属于同一范围。由于模型提取攻击可以用作其他攻击的垫脚石,这可能会进一步复杂化。
据我们所知,这篇论文是第一篇针对机器学习的隐私相关攻击的全面调查。它回顾并系统分析了 40 多篇研究论文。这些论文于2014-2020年间发表在安全、隐私和机器学习领域的顶级会议和期刊上。使用与"隐私"、"机器学习"相关的关键字搜索以及攻击本身的名称("成员推断"、"模型反演"、"属性推理"、模型窃取、"模型提取"等)在 Google Scholar 中选择了一组初始论文。选择初始论文集后,通过基于参考文献的反向搜索以及基于引用它们的论文的正向搜索来添加更多论文。
本文的主要贡献是:
- 第一个针对机器学习系统隐私和机密性攻击的全面研究。
- 针对机器学习隐私的攻击的统一分类。
- 关于机器学习系统中隐私泄露的可能原因的讨论。
- 深入介绍攻击的实施。
- 概述了为防御不同攻击而测试的不同防御措施。
1.1 论文结构
本文其余部分的组织如下:第 2 节介绍了与机器学习相关的一些基本概念,这些概念与第 6 节中介绍的攻击的实施相关。第 3 节中介绍了威胁模型,攻击的分类及其定义是第 4 节的重点。在第 5 节中,我们介绍了迄今为止已知或已调查的机器学习泄漏的原因。第 7 节的重点是对每种攻击类型提出的防御措施的概述。最后,第 8 节包含对当前和未来研究方向的讨论,第 9 节提供了结论性意见。
2 机器学习
机器学习 (ML) 是一个研究在没有明确编程的情况下从数据中学习的问题的领域。本节的目的是提供与本调查有关的机器学习的非详尽概述,并促进后续章节的讨论。我们简要介绍了不同机器学习范例和分类以及机器学习架构的高级视图。最后,我们对模型训练和推理进行了简要的讨论。对于感兴趣的读者,有几本教科书,如29, 9, 78, 97,提供了对该主题的全面介绍。
2.1 学习类型
在非常高的层面上,机器学习传统上分为三个主要领域:监督学习、无监督学习和强化学习。每个区域都有自己的细分区域。多年来,出现了新的类别来捕获不易适应这三个领域的学习类型,例如半监督和自监督学习,或其他对模型进行分类的方法,例如生成模型和判别模型。
2.1.1 监督学习
在监督学习设置中,参数为 θ 的模型 f 是输入 x 和输出 y=f(x;θ) 之间的映射函数,其中 x 是维度为 n 的属性或特征的向量。根据学习任务,输出或标签 y 可以采用不同的维度。用于训练模型的训练集D是一组数据点D = {(x_i, y_i)}_i=1^m,其中m是输入输出对的数量。最常见的监督学习任务是分类和回归。监督学习算法的示例包括线性回归、逻辑回归、决策树、支持向量机等等。迄今为止,绝大多数攻击论文都集中在使用深度神经网络的监督学习上。
2.1.2 无监督学习
在无监督学习中,没有标签 y。训练集 D 仅包含输入 x_i。无监督算法的目的是在不访问标签的情况下找到数据中的结构或模式。无监督学习中的常见任务是聚类特征学习、异常检测和降维。在本综述中,对无监督学习的攻击主要表现为对语言模型的攻击。
2.1.3 强化学习
强化学习涉及对环境进行观察的代理,并使用这些观察来采取行动,以最大化奖励信号。在最一般的表述中,该组动作不是预定义的,并且奖励不一定是立即的,而是可以在一系列动作108之后发生。据我们所知,没有针对强化学习的隐私相关攻击的报道,但它已被用于发起其他与隐私相关的攻击87。
2.1.4 半监督学习
在许多现实环境中,标记的数据量可能比未标记的数据量小得多,并且获得高质量标签的成本可能太高。半监督学习算法旨在使用未标记的数据来学习更高级别的表示,然后使用标记的示例来指导下游学习任务。半监督学习的一个例子是使用无监督学习技术,例如对未标记数据进行聚类,然后使用分类器从每个聚类中分离出代表性的训练数据。其他值得注意的例子是生成模型,例如生成对抗网络 (gan) 30。
2.1.5 生成式学习与判别式学习
学习算法的另一种分类是判别算法与生成算法。判别分类器试图对条件概率p(y | x) 进行建模,即,它们试图学习直接基于输入数据x来分离不同课程的决策边界。这种算法的例子是逻辑回归和神经网络。生成式分类器试图捕获联合分布p(x,y)。这样的分类器的示例是朴素贝叶斯。生成模型不需要标签,但他们试图模型p(x),显式或隐式。值得注意的例子是在给定一些输入文本或gan的情况下预测下一个单词的语言模型,以及能够生成与训练数据的属性匹配的数据样本的变分自动编码器 (vae) 57。
2.2 学习架构
从系统架构的角度来看,我们将学习过程视为集中式或分布式。这种分类背后的主要标准是数据和模型是否并置。
2.2.1 集中式学习
在集中式学习环境中,数据和模型是并置的。可以有一个或多个数据生产者或所有者,但所有数据都收集在一个中心位置并用于模型的训练。数据的位置可以位于同一数据中心的单台机器甚至多台机器中。虽然以多个 GPU 和 CPU 的形式使用并行性可以被认为是一种分布式学习模式,但它不适合我们,因为我们使用模型和数据搭配作为区分集中式学习和分布式学习的主要标准。集中式学习架构包括机器学习即服务 (MLaaS) 设置,其中数据所有者将其数据上传到基于云的服务,该服务的任务是创建最佳模型。
2.2.2 分布式学习
推动分布式学习架构需求的需求包括大量数据的处理和处理、计算和内存容量的需求,甚至是隐私问题。从分布式学习的现有变体中,我们提出了那些从隐私角度相关的变体,即协作或联合学习(FL)、完全分散或点对点(P2P)学习和分割学习。
协作或联合学习是一种分散训练的形式,其目标是从存储在多个远程设备或位置61中的数据学习一个全局模型。主要思想是数据不会离开远程设备。数据在本地处理,然后用于更新本地模型。中间模型更新被发送到中央服务器,该中央服务器聚合它们并创建全局模型。中央服务器然后将全局模型发送回所有参与者设备。
在完全分散的学习或点对点(P2P)学习中,没有中央编排服务器。相反,设备以 P2P 方式进行通信,并直接与其他设备交换更新。从隐私角度来看,这种设置可能很有趣,因为它减轻了信任中央服务器的需要。然而,对 P2P 系统的攻击与此类设置相关,需要予以考虑。到目前为止,还没有关于此类系统的基于隐私的攻击的报告;尽管它们将来可能会变得相关。此外,根据同伴之间共享的信息类型,对协作学习的几种攻击可能适用。
在分裂学习中,训练的模型被分成两个或更多部分。边缘设备保留深度学习模型的初始层,集中式服务器保留最终层34, 54。拆分的原因主要是通过发送中间模型输出而不是输入数据来降低通信成本。这种设置在远程或边缘设备具有有限资源并连接到中央云服务器的情况下也是相关的。这种情况对于物联网 (IoT) 设备很常见。
2.3 训练与推理
监督ML模型的训练通常遵循经验风险最小化 (ERM) 方法111,其中目标是找到最小化风险或目标函数的参数 θ ^ *,其计算为训练数据集的平均值:
J(D;θ) = 1/m∑_i=1^ml(f(x_i; θ), y_i)
其中 l(·) 是损失函数,例如交叉熵损失,m是数据集D中数据点的数量。
ERM 背后的想法是,训练数据集是从学习任务的未知真实数据分布中提取的子集。由于我们不知道真实的数据分布,因此我们无法最小化真实的目标函数,但我们可以最小化我们拥有的数据样本的估计目标。在某些情况下,目标函数中会添加正则化项,以减少过度拟合并稳定训练过程。
2.3.1 集中式环境中的训练
训练过程通常涉及迭代优化算法,例如梯度下降12,其目的是通过遵循其梯度引起的路径来最小化目标函数。当数据集很大时,就像深度神经网络通常的情况一样,采用一个梯度步骤的成本太高。在这种情况下,涉及在较小批量的数据上采取的步骤的梯度下降的变体是优选的。一种这样的优化方法称为随机梯度下降 (SGD) 93,定义为:
θ_t+1 = θ_t - ηg
g = 1/m' ∇_θ ∑_i=1^m' l(f(x_i; θ), y_i)
其中,η为学习率,g为损失函数关于参数θ的梯度。在随机梯度下降法的原始形式中,梯度g是通过对从数据集D中随机选取的一个数据点计算得到的,因此得名"随机"。在实践中,通常使用大小为m' 的小批量,其中m' <m,而不是单个数据点来计算每个步骤的损耗梯度 (公式3)。小批量样本能够降低随机梯度估计的方差,但批量大小m' 是一个可调参数,可能会影响算法的性能。尽管随机梯度下降法(SGD)仍然十分流行,但人们提出了多项改进措施,旨在通过引入动量91来加速收敛,或像RMSprop算法40那样采用自适应学习率,亦或是将这两种改进相结合,如Adam算法56所示。
2.3.2 分布式环境中的训练
联合学习最流行的学习算法是联合平均73,其中每个远程设备从本地存储的数据计算一步梯度下降,然后与参数服务器共享更新的模型权重。参数服务器对所有远程参与者的权重求平均,并更新随后再次与远程设备共享的全局模型。它可以通过以下方式定义:
θ_t+1 = 1/K ∑_k=1^K θ_t^(k)
其中K是远程参与者的数量,并且参与者k的参数 θ_t ~ (k) 已经基于等式2和3在本地计算。
来自分布式计算领域的另一种方法是downpour (或同步) SGD 19,它建议与聚合分布式设备的参数服务器共享分布式设备的损耗梯度,然后执行一个梯度下降步骤。它可以被定义为:
θ_t+1 = θ_t - η∑_k=1^K m^(k)/Mg_t^(k)
其中g_t ^(k) 是参与者k使用其本地数据基于等式3计算的梯度,m ^(k) 是远程参与者中的数据点的数量,并且M是训练数据中的数据点的总数。在公式5的计算之后,参数服务器将更新的模型参数 θ_t1发送给远程参与者。
2.3.3 推理
一旦模型经过训练,它们就可以用于对以前未见过的数据进行推断或预测。在此阶段,假设模型参数是固定的,尽管模型通常会受到监控、评估,并在必要时进行重新训练。本综述中的大多数攻击都是模型生命周期推理阶段的攻击,除了通常在训练期间执行的协作学习攻击。
3 威胁模型
为了从隐私角度理解和防御机器学习中的攻击,拥有环境、不同参与者和要保护的资产的通用模型非常有用。
从威胁模型的角度来看,敏感且可能受到攻击的资产是训练数据集 D、模型本身、其参数 θ、超参数及其架构。该威胁模型中确定的参与者是:
- 数据所有者,其数据可能是敏感的。
- 模型所有者,可能拥有也可能不拥有数据,并且可能希望也可能不希望共享有关其模型的信息。
- 模型使用者,通常通过某种编程或用户界面使用模型所有者公开的服务。
- 攻击者也可以像普通消费者一样访问模型的界面。如果模型所有者允许,他们可以访问模型本身。
图1描述了威胁模型下的资产和已识别的参与者,以及信息流和可能的操作。这种威胁模型是一种逻辑模型,它不排除其中一些资产可能被并置或分散在多个位置的可能性。
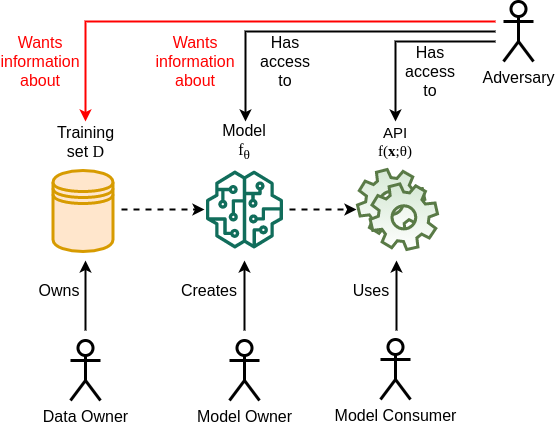
图 1 针对机器学习系统的隐私和机密性攻击的威胁模型。人物代表演员,符号代表资产。虚线代表数据和信息流,而实线代表可能的操作。红色是攻击者的行动,可在威胁模型下进行。
分布式学习模式,例如联合学习或协作学习,引入了攻击者的不同空间模型。在联合学习设置中,攻击者可以与全局模型并置,但也可以是本地攻击者。图2显示了协作学习设置中的威胁模型。多个参与者的存在也允许勾结联合起来的攻击者的可能性。
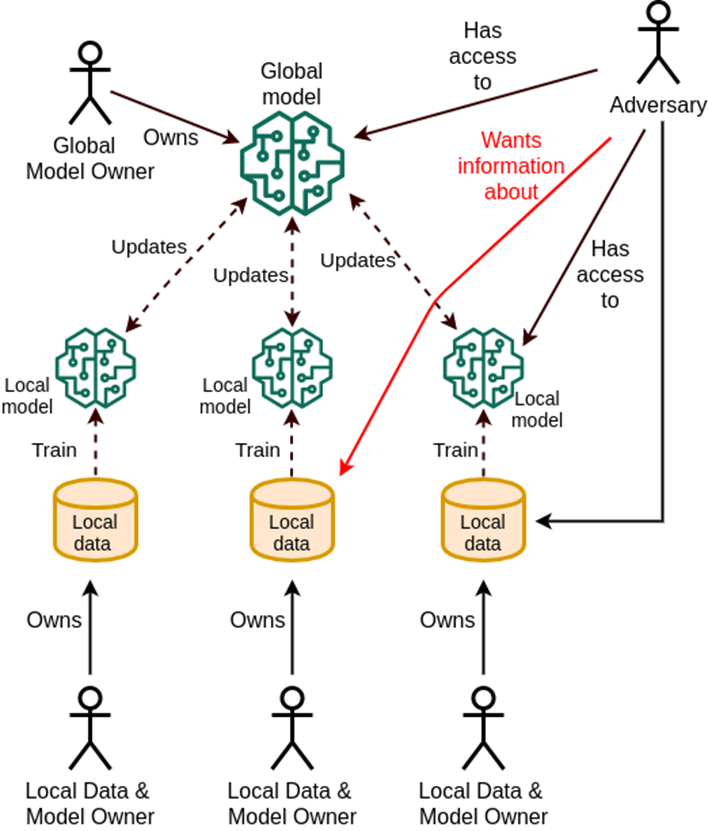
图 2 协作学习环境中的威胁模型。虚线代表数据和信息流,而实线代表可能的操作。红色是攻击者的行动,可在威胁模型下进行。在此设置中,攻击者可以放置在参数服务器上或本地。为了简单起见,没有描绘模型消费者。在联邦学习环境中,本地模型所有者也是模型消费者。
针对机器学习模型的不同攻击面可以根据攻击者知识进行建模。知识范围各不相同,从有限的(例如可以访问机器学习 API)到了解完整的模型参数和训练设置。在这两个极端之间,存在一系列可能性,例如模型架构、其超参数或训练设置的部分知识。攻击者的知识也可以从数据集的角度来考虑。在大多数审查的论文中,作者假设攻击者不了解训练数据样本,但他们可能对底层数据分布有一些了解。
从分类学的角度来看,攻击者不了解模型参数、架构或训练数据的攻击称为黑盒攻击。黑盒系统的一个示例是机器学习即服务 (MLaaS),其中用户通常提供一些输入并从云中托管的预训练模型接收预测向量或类标签。大多数黑盒论文都假设预测向量的存在。以类似的方式,白盒攻击是指攻击者在训练期间可以完全访问目标模型参数或其损失梯度。例如,在大多数分布式训练模式中就是这种情况。在这两个极端之间,还有一些攻击做出比黑盒攻击更强的假设,但不假设完全访问模型参数。我们将这些攻击称为部分白盒攻击。在这里需要补充的是,尽管可能需要某种形式的预处理,但大多数工作都假设对预期输入有充分的了解。
从分类学的角度来看,攻击时间是另一个需要考虑的参数。该领域的大多数研究都是在处理推理期间的攻击,但是大多数协作学习攻击都假设在训练期间访问模型参数或梯度。模型训练阶段的攻击为不同类型的对抗行为提供了可能性。被动或诚实但好奇的攻击者不会干扰训练过程,他们只是试图在训练期间或之后推断知识。如果攻击者以任何方式干扰训练,他们就会被视为主动攻击者。
最后,由于本综述的重点是基于数据或机器学习模型的无意信息泄露的隐私攻击,因此没有涵盖基于安全的攻击,例如模型中毒或逃避攻击,或针对托管数据、模型或提供的服务的基础设施的攻击。
4 攻击类型
在与隐私相关的攻击中,攻击者的目标是获取原本不打算共享的知识。这些知识可以是关于训练数据 D 或关于模型的信息,甚至是提取关于数据属性的信息,例如无意编码的偏差。在我们的分类中,研究的隐私攻击分为四种类型:成员推断、重建、属性推理和模型提取。
4.1 成员推断攻击
成员推断试图确定输入样本x是否被用作训练集D的一部分。这是最受欢迎的攻击类别,由Shokri et al. 101首次引入。该攻击仅假定模型的输出预测向量 (黑盒) 的知识,并且是针对受监督的机器学习模型进行的。这类白盒攻击也是一种威胁,尤其是在协作环境中,攻击者可以发起被动和主动攻击。如果存在对模型参数和梯度的访问,则这允许在准确性方面更有效的白盒成员推断攻击80。
除了监督模型之外,gan和vae等生成模型也容易受到成员推断攻击35, 39, 15的影响。在这种情况下,攻击的目标是使用数据生成组件的不同程度的知识来检索有关训练数据的信息。
最后,这些类型的攻击可以从不同的角度来看,即从数据所有者的角度来看。在这种情况下,数据的所有者可能具有审计黑盒模型的能力,以查看数据是否在未经授权的情况下被使用103, 41。
4.2 重构攻击
重构攻击试图重建一个或多个训练样本和/或它们各自的训练标签。重建可以是部分的或完全的。以前的工作也使用术语属性推断或模型反演来描述攻击,给定输出标签和某些特征的部分知识,尝试恢复敏感特征或完整数据样本。出于本综述的目的,所有这些攻击都被视为较大的重构攻击集合的一部分。在隐私相关文献的其他部分中已经使用了术语属性推断来描述通过利用可公开访问的数据28, 48来推断目标用户的敏感 "属性" 的攻击。这些攻击不是本次审查的一部分,因为它们直接针对个人数据,而不是针对ML模型。
该类别的作品之间的主要区别在于创建数据130, 36, 119, 123, 129的实际重建的作品与创建不一定属于训练数据集25, 42, 123, 38的敏感特征的类代表或可能值的作品之间的区别。在分类模型中,后一种情况限于课程由一种类型的对象 (例如,同一个人的面部) 组成的场景。虽然这限制了攻击的适用性,但在某些情况下,它仍然是一个有趣的场景。
4.3 属性推断攻击
提取未明确编码为特征或与学习任务不相关的数据集属性的能力称为属性推断。属性推断的一个示例是当该信息不是数据集的编码属性或标签时,提取关于患者数据集中的女性和男性的比率的信息。或者有一个执行性别分类的神经网络,可以用来推断训练数据集中的人是否戴眼镜。在某些情况下,这种类型的泄漏可能会影响隐私。这些类型的属性还可用于获得有关训练数据的更多信息,这可能导致攻击者使用此信息创建类似的模型3,甚至在学习的属性可用于检测系统26的漏洞时甚至具有安全隐患。
属性推断旨在提取无意中从模型中学到的、与训练任务无关的信息。即使是很好的概括模型也可以学习与整个输入数据分布相关的属性,有时这对于学习过程是不可避免的甚至是必要的。从对抗的角度来看,更有趣的是可以从训练数据的特定子集或最终关于特定个体推断出的属性。
到目前为止,属性推理攻击的目标要么是数据集范围的属性3, 26, 102,要么是一批数据75中出现的属性。后一种攻击是对模型的协作训练进行的。
4.4 模型提取攻击
模型提取是一类黑盒攻击,攻击者试图通过创建与攻击f下的模型非常相似的替代模型来提取信息并可能完全重建模型。替代模型有两个主要重点。首先,在从输入数据分布中提取并与学习任务77, 87, 109, 58相关的测试集中,创建与目标模型f的精度相匹配的模型。其次,要创建一个替代模型f â,该模型在一组输入点处与f匹配,这些输入点不一定与学习任务109, 51, 18, 45相关。Jagielski等人45将前者的攻击称为任务精度提取,后者称为保真度提取。在任务准确性提取中,攻击者有兴趣创建一个替代,该替代可以很好地或更好地学习与目标模型相同的任务。在后一种情况下,攻击者的目标是创建一个尽可能忠实地复制f的决策边界的替代品。这种类型的攻击可以在以后启动其他类型的攻击之前用作垫脚石,例如对抗性攻击89, 51或成员推断攻击80。在这两种情况下,假设攻击者希望尽可能高效,即使用尽可能少的查询。在某些工作中假设了目标模型体系结构的知识,但是如果攻击者选择的替代模型的复杂性与受攻击的模型87, 51, 58相同或更高,则不是严格必要的。
除了创建替代模型外,还有一些方法专注于从目标模型中恢复信息,例如目标函数116中的超参数或有关各种神经网络架构属性的信息,例如激活类型,优化算法,层数等86。
5 隐私泄漏的原因
机器学习模型泄漏的条件是过去几年开始出现的一个研究课题。一些模型由于它们的构造方式而泄漏信息。这种情况的示例是支持向量机 (svm),其中支持向量是来自训练数据集的数据点。其他模型 (例如线性分类器) 相对容易 "逆向工程",并且仅通过具有足够的输入/输出数据对109来检索其参数。诸如深度神经网络之类的较大模型通常具有大量参数,并且简单的攻击是不可行的。但是,在某些假设和条件下,可以检索有关训练数据或模型本身的信息。
5.1 成员推断攻击的成因
已证明可以提高成员推断精度的条件之一是模型的泛化能力差。Shokri et al. 101最初研究了过拟合和黑盒成员推断之间的联系。本文是第一个研究神经网络上的成员推断攻击的论文。作者通过使用相同的数据集在不同的MLaaS平台中训练模型来测量过度拟合对攻击准确性的影响。作者通过实验表明,过度拟合会导致隐私泄露,但也指出,这不是唯一的条件,因为一些模型具有较高的泛化误差,更容易发生成员泄露。过拟合的影响后来被Yeom等人正式证实。125。作者将成员优势定义为攻击者在访问模型的情况下可以区分数据样本是否属于训练集的度量。他们证明了隶属优势与模型的泛化误差成正比,并且过拟合是执行成员推断攻击的充分条件,但不是必要条件。此外,Long等人67表明,即使在通用的模型中,也可以对他们命名为易受攻击记录的训练数据的子集进行隶属关系推断。
其他因素,如模型架构、模型类型和数据集结构,会影响攻击的准确性。与101类似,但在白盒设置中,Nasr等人。80表明,具有相同泛化误差的两个模型显示出不同程度的泄漏。更具体地说,就参数数量而言,最复杂的模型表现出更高的攻击精度,这表明模型复杂性也是一个重要因素。
Truex等人110进行了不同类型的实验,以测量模型类型的重要性以及数据集中存在的类别数量。他们发现,某些模型类型 (如朴素贝叶斯) 比决策树或神经网络更不容易受到成员推断攻击的影响。他们还表明,随着数据集中的类别数量增加,成员资格泄漏的可能性也会增加。这一发现与101中的结果一致。
如Song等人105所示,保护机器学习模型免受对抗性攻击也会对模型的隐私产生不利影响。用于鲁棒模型训练的最新技术建议,例如投影梯度下降 (PGD) 对抗性训练69,增加了模型对成员推断攻击的敏感性。这并不意外,因为强大的训练方法 (经验和可证明的防御) 往往会增加泛化误差。如前所述,泛化误差与攻击的成功有关。此外,105的作者认为,稳健的训练可能会导致模型对训练数据的敏感性增加,这也会影响成员推断。
在假设测试数据可以捕获实际数据分布的细微差别的情况下,在监督学习中很容易测量泛化误差。在生成模型中,特别是在gan中,情况并非如此,因此过拟合的概念并不直接适用。处理针对gan的成员推断攻击的所有三篇论文都提到过拟合是成功攻击35, 39, 15背后的重要因素。在这种情况下,过拟合意味着生成器已经记忆并重放了部分训练数据。这在15的研究中得到进一步证实,其中随着训练数据大小的增加,它们的攻击被证明不太成功。
5.2 重构攻击的成因
关于重构攻击,Yeom et al. 125表明,较高的泛化误差可以导致较高的概率来推断数据属性,但目标特征对模型的影响也是一个重要因素。然而,作者假设攻击者知道目标特征和标签的先验分布。使用关于攻击者知识的较弱假设,Zhang等人129在理论上和实验上表明,具有高预测能力的模型更容易受到重构攻击。最后,与隶属关系推断中的易受攻击的记录类似,即使对于不适合11的模型,也显示出不分布的数据的记忆和检索也是如此。
5.3 属性推断攻击的成因
即使使用通用的模型75, 26,属性推理也是可能的,因此过拟合似乎不是属性推理攻击的原因。不幸的是,关于属性推理攻击,我们对使它们成为可能以及在何种情况下它们似乎有效的信息较少。无论从理论还是实证的角度来看,这都是未来研究的一个有趣的途径。
5.4 模型提取的成因
过度拟合增加了黑盒成员资格推理攻击的成功率,而模型提取攻击则恰恰相反。当受到攻击的模型在测试集86中具有98% 或更高精度时,可能会窃取模型参数。此外,具有较高泛化误差的模型更难以窃取,这可能是由于它们可能记住了不属于攻击者数据集66的样本。可能影响模型提取成功的另一个因素是用于训练的数据集。较高的类别数可能导致较差的攻击性能66。
6 攻击的实现
分析了 40 多篇与针对机器学习的隐私攻击相关的论文。本节详细描述最常用的技术以及它们之间的本质区别。论文分两部分讨论:对集中式学习的攻击和对分布式学习的攻击。
6.1 针对集中式学习的攻击
在集中式学习环境中,主要假设是模型和数据在训练阶段位于同一位置。下一小节介绍多篇论文使用的常见设计方法,即使用影子模型或影子训练。其余小节专门讨论不同的攻击类型,并介绍所评述论文的假设、共同要素以及差异。
6.1.1 影子训练
在许多有监督学习攻击中,一种常见的设计模式是使用影子模型和元模型(或攻击模型)3, 101, 26, 86, 92, 46, 95, 110, 94, 41。图3中描绘了一般的影子训练架构。这种设计的主要思路是:当模型遇到不属于训练数据集的数据时,其行为会发生变化。这种差异既体现在模型的输出中,也体现在其内部表征中。在大多数设计中,都存在一个目标模型和一个目标数据集。攻击者正试图推断训练数据的成员身份或其属性。他们使用影子数据集D_shadow = {x_shadow,i, y_shadow,i}i=1^n训练多个影子模型,这些影子数据集通常被假定与目标数据集来自同一分布。在影子模型训练完成后,攻击者构建一个攻击数据集D_attack = {f_i(x_shadow, i), y_shadow, i}{i=1}^n,其中f_i为对应的影子模型。攻击数据集用于训练元模型,该元模型本质上是基于影子模型的输出进行推理。一旦元模型训练完成,便使用目标模型的输出对其进行测试。
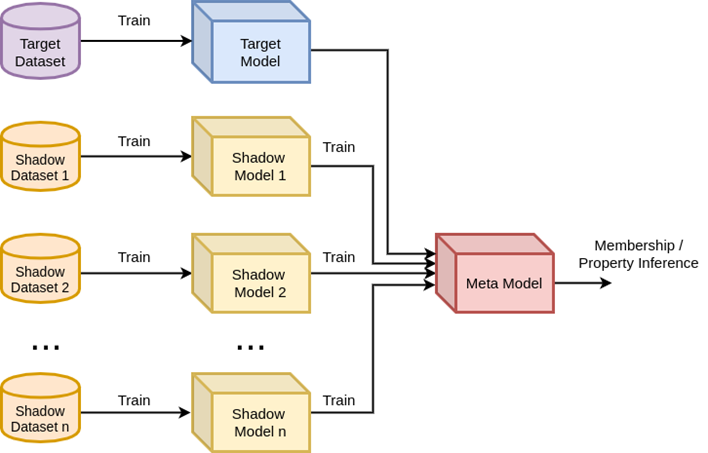
图 3 影子训练架构。首先,使用各自的影子数据集训练多个影子模型,以模拟目标模型的行为。在第二阶段,根据影子模型的输出和影子数据集的已知标签来训练元模型。元模型用于在给定目标模型的输出的情况下推断数据或模型的成员资格或属性。
6.1.2 成员推断攻击
在成员推断黑盒攻击中,最常见的攻击模式是使用影子模型。影子模型的输出通常是预测向量101, 95, 92, 110, 46。用于攻击数据集的标签来自影子数据的测试和训练分割,其中属于测试集的数据点被标记为训练集的非成员。训练元模型以识别目标模型的预测向量输出中的模式。这些模式允许元模型推断数据点是否属于训练数据集。影子模型的数量会影响攻击的准确性,但也会给攻击者带来成本。Salem等人95表明,只要一个影子模型,成员推断攻击是可能的。
影子训练可以进一步简化为基于阈值的攻击,其中代替训练元模型,可以计算指示样本是否是训练集的成员的合适的阈值函数。可以从多个影子模型94或甚至不使用任何影子模型125来学习阈值。Sablayrolles等人。94表明,贝叶斯最优成员推断攻击仅取决于损失,并且其攻击优于以前的攻击,例如101, 125。在攻击准确性方面,他们报告了多达90.8% 个大型神经网络模型,如VGG16 64,这些模型在Imagenet 20数据集上执行分类。
除了放松影子模型的数量外,攻击还被证明是数据驱动的,即即使目标模型与影子模型和元模型110不同,攻击也可以成功。作者测试了几种类型的模型,如k-nn,逻辑回归,决策树和朴素贝叶斯分类器在目标模型,阴影和元模型的作用的不同组合。结果表明,i) 使用不同类型的模型不会影响攻击准确性,并且ii) 在大多数情况下,决策树等模型在攻击准确性和准确性方面优于神经网络。
影子模型训练需要一个影子数据集。对监督学习模型进行成员推断攻击的主要假设之一是,攻击者对所使用的训练样本没有了解或了解有限。但是,攻击者对训练数据的底层数据分布有所了解。如果攻击者无法访问合适的数据集,他们可以尝试生成一个101, 110。访问有关多个特征的概率分布的统计信息允许攻击者使用采样技术创建影子数据集。如果基于统计的生成是不可能的,则使用目标模型的预测向量的基于查询的方法是另一种可能性。Hayes et al. 35也提出了使用gan生成辅助数据。如果攻击者设法找到生成具有高置信度的预测的输入数据,则成功攻击101不需要数据分布的先验知识。Salem等人95甚至表明,甚至没有必要使用来自与目标相同的分布的数据来训练影子模型,这使得攻击更加现实,因为它不假设训练数据的任何知识。
前面的讨论主要与监督分类或回归任务有关。41研究了针对机器翻译的序列到序列模型训练的成员推断攻击的功效。作者使用了影子模型,试图模仿目标模型的行为,然后使用元模型来推断成员资格。他们发现,与图像分类等其他类型的模型相比,序列生成模型更难攻击。但是,域外和词汇表外数据的成员资格更容易推断。
成员推断攻击也适用于深度生成模型,如gan和VAEs 35, 39, 15。由于这些模型具有多个组件 (生成器/鉴别器,编码器/解码器),因此攻击者知识需要将其考虑在内。对于这些类型的模型,部分遵循Chen等人15提出的分类法。我们将对生成器的黑盒访问视为访问生成的样本的能力和部分黑盒访问,即提供输入z并生成样本的能力。访问生成器模型及其参数被认为是白盒攻击。查询鉴别器的能力也是白盒攻击。
访问GAN鉴别器的完全白盒攻击基于以下假设: 如果GAN已经 "过拟合",则用于其训练的数据点将接收由鉴别器35输出的更高置信度值。除了之前的攻击,Hayes等人35提出了一组部分黑盒设置的攻击。这些攻击适用于gan和vae或任何生成模型。如果攻击者没有辅助数据,则他们可以尝试训练辅助GAN,其鉴别器区分由目标生成器生成的数据和由辅助GAN生成的数据。一旦辅助GAN被训练,其鉴别器可以用于白盒攻击。作者还考虑了攻击者可能具有辅助信息的情况,例如培训知识和测试数据。使用辅助数据,他们可以训练另一个GAN,其鉴别器将能够区分原始训练集的成员和非成员。
Chen等人针对全黑盒模型提出了一种基于距离的攻击数据点最近邻居的攻击。15。在这种情况下,如果在其k个最近邻中存在至少一个具有低于阈值 ε 的距离的点,则数据点x是训练集的成员。作者提出了更复杂的攻击,因为攻击者的知识水平增加,基于这样的想法,即如果数据点来自训练集,则真实数据点x与生成器生成的样本之间的重建误差应较小。
6.1.3 重构攻击
最初的重构攻击基于以下假设: 攻击者可以访问模型f,敏感和非敏感特征的先验以及特定输入x的模型输出。给定非敏感特征的值和输出标签25,攻击基于估计敏感特征的值。该方法使用属性的最大后验 (MAP) 估计,其最大化观察已知参数的概率。Hidano等人38使用了类似的攻击,但他们没有假设非敏感属性的知识。为了使他们的攻击起作用,他们假设攻击者可以在训练期间执行模型中毒攻击。
之前的两种攻击都对线性回归模型起作用,但是随着特征数量及其范围的增加,攻击可行性降低。为了克服MAP攻击的局限性,Fredrikson等人提出了另一种反转攻击,该攻击使用目标标签和可选的辅助信息来恢复特征。攻击被公式化为优化问题,其中目标函数基于观察到的模型输出,并在输入空间中使用梯度下降来恢复输入数据点。对该方法进行了图像重建实验。结果是类代表图像,在某些情况下,即使在去噪之后,该图像也非常模糊。25, 24中的模型反演攻击的形式化后来由Wu等人提出。120。
由于24中的优化问题很难解决,Zhang等人提出使用GAN来学习训练数据的一些辅助信息并产生更好的结果。在这种情况下,辅助信息是输入图像中模糊或掩模的存在。该攻击首先使用GAN学习使用公共数据从掩盖或模糊的图像生成逼真的图像。第二步是GAN反演,计算生成最可能图像的潜矢量 ẑ:
ẑ=min_z L_prior(z) + λL_id(z)
其中先验损失L_prior确保生成逼真的图像,而L_id确保图像在目标网络中具有高可能性。攻击相当成功,尤其是在蒙版图像上。
到目前为止,唯一的黑盒重构攻击是由Yang et al. 123提出的。该攻击采用了一个额外的分类器,该分类器执行从目标模型f(x) 的输出到候选输出的反演。该设置类似于自动编码器的设置,仅在这种情况下,扮演编码器角色的目标网络是黑盒,并且不可训练。在不同类型的目标模型输出上测试了攻击: 完整预测向量、截断向量和仅目标标签。当完整的预测向量可用时,攻击执行良好的重建,但是由于可用信息较少,产生的数据点看起来更像类代表。
6.1.4 属性推断攻击
在属性推断中,基于攻击者想要推断的属性来标记影子数据集,因此攻击者需要访问具有该属性的数据和不具有该属性的数据。然后,训练元模型以推断具有该属性的数据的输出向量与不具有该属性的数据的输出向量之间的差异。在白盒攻击中,元模型输入可以是其他特征表示,例如SVM 3的支持向量或神经网络层输出26的变换。当攻击语言模型嵌入时,嵌入向量本身可用于训练分类器以区分诸如文本作者102之类的属性。
6.1.5 模型提取攻击
当攻击者可以访问模型的输入和预测输出时,可以将这些输入和输出对视为方程组,其中未知数是模型参数109或目标函数116的超参数。在线性二元分类器的情况下,方程组是线性的,并且仅需要d 1查询来检索模型参数,其中d是参数向量 θ 的维数。在更复杂的情况下,例如多类线性回归或多层感知器,方程组不再是线性的。然后使用诸如broyden-fletcher-goldfarb-shanno (BFGS) 85或随机梯度下降之类的优化技术来近似模型参数109。
缺乏预测向量或大量模型参数使得方程求解攻击效率低下。需要一种策略来选择将为模型提取提供最有用信息的输入。从这个角度来看,模型提取与主动学习14非常相似。主动学习利用外部oracle为输入查询提供标签。oracle可以是人类专家或系统。然后使用标签来训练或更新模型。在模型提取的情况下,目标模型扮演oracle的角色。
遵循主动学习方法,几篇论文提出了一种自适应训练策略。他们从一些初始数据点或种子开始,用于查询目标模型,并检索用于训练替代模型的标签或预测向量。对于随后的多个轮次,他们基于一些自适应策略用新的合成数据点扩展他们的数据集,该策略允许他们找到接近目标模型109, 51, 89, 14的决策边界的点。Chandrasekaran等14提供了一种查询效率更高的提取核svm等非线性模型的方法,其精度略低于Tramer等109提出的方法,而决策树模型则相反。
选择最适合查询目标模型的数据的其他几种策略使用 :( i) 不是合成的但属于不同域的数据,例如来自不同数据集18, 87, 6的图像,(ii) 半监督学习技术,例如旋转损失127或混合匹配7,以增强数据集45或 (iii) 随机生成的输入数据109, 51, 58。在效率方面,与使用CIFAR-10和SVHN数据集45进行分类训练的模型相比,MixMatch等半监督方法需要比完全监督提取方法少得多的查询,以在任务准确性和保真度方面表现相似或更好。对于较大的模型,针对Imagenet分类进行训练,甚至查询Imagenet数据的10%,都可以提供与目标模型45相当的性能。针对已部署的提供面部特征的MLaaS服务,Orekondy et al. 87设法创建了一个替代模型,该模型在任务准确性方面达到目标的80% %,仅花费30美元。
一些 (主要是理论上的) 工作已经证明了执行超出线性模型77, 45的直接模型提取的能力。Milli et al. 77证明,完全模型提取在理论上可以对抗具有整流线性单元 (ReLU) 激活的两层完全连接神经网络。但是,他们的假设是攻击者可以访问相对于输入的损失梯度。Jagielski等人45设法在不需要梯度的情况下对类似网络进行完全提取。两种方法都考虑到ReLUs将神经网络转换为输入的分段线性函数。通过使用不同的输入来探测模型,可以识别出线性中断的位置,并使用该知识来计算网络参数。在使用学习策略和直接提取的混合方法中,Jagielski等人45表明,他们可以通过使用平均2 ^ 19.2到2 ^ 22.2个查询来提取在MNIST上训练的几乎100% 保真度的模型包含多达400,000个参数的模型。但是,此攻击假定访问类似于77的损失梯度。
最后,除了直接学习替代模型外,还可以使用shadow model 86提取模型信息,例如体系结构,优化方法和超参数。大多数攻击是针对在MNIST上训练的神经网络进行的。使用影子模型的预测向量作为输入,元模型设法学习区分模型是否具有某些架构属性。同一作者提出的另一次攻击,旨在生成由具有相关属性的模型创建的对抗性样本。如果生成的样本具有所讨论的属性,则以使分类器输出特定预测的方式创建生成的样本。然后,如果目标模型具有特定属性,则使用目标模型对该对抗性样本的预测来建立。两种攻击的结合被证明是最有效的方法。最成功地预测了一些属性,例如激活函数,dropout的存在和最大池化。
6.2 针对分布式学习的攻击
在联合学习设置中,多个设备获取对从属于不同最终用户的数据训练的全局模型的访问。此外,参数服务器可以以模型参数的形式或损失梯度的形式访问每个参与者的模型更新。在分割学习设置中,中央服务器还可以访问每个参与者的中间神经网络层的输出。这种类型的信息可用于由驻留在中心位置的参与者或甚至由单个参与者发起不同类型的攻击。以下小节介绍了分布式设置中的攻击类型,以及它们的共同元素,差异和假设。
6.2.1 成员推断攻击
Nasr et al。79表明,在假设攻击者具有有关训练数据的一些辅助知识,即可以从训练数据集中访问一些数据的假设下,成员推断攻击比黑盒攻击更有效。要么明确,要么因为它们是攻击者拥有的更大数据集的一部分。攻击者可以使用模型参数和损失梯度作为另一个模型的输入,该模型被训练以区分成员和非成员。使用各种神经网络架构的白盒攻击精度高达75.1%,但是,所有目标模型都具有较高的泛化误差。
在主动攻击场景中,攻击者 (也是本地参与者) 更改梯度更新,以针对其成员资格受到质疑的数据执行梯度上升而不是下降。如果其他一些参与者使用数据进行训练,那么他们的本地SGD将显着降低损失的梯度,并且变化将反映在更新的模型中,从而允许攻击者提取成员资格信息。来自本地主动参与者的攻击达到了76.3% 的攻击准确性,并且通常,在所有测试的情况下,主动攻击准确性都高于被动准确性。但是,随着参与者数量的增加,它对攻击准确性产生了不利影响,在五个或更多参与者之后,攻击准确性明显下降。处于更有利位置的全局主动攻击者可以隔离他们从每个参与者接收的模型参数更新。这样的主动攻击者达到了92.1% 的攻击准确度。
6.2.2 属性推断攻击
被动属性推理需要访问一些拥有属性的数据和一些不拥有属性的数据。该攻击适用于联合平均和同步SGD设置,其中每个远程参与者在每个训练回合75之后从参数服务器接收参数更新。初始数据集的形式为D' ={(x,y,y')},其中x和y是用于训练分布式模型的数据,y' 是属性标签。每次更新本地模型时,攻击者都会计算两批数据的损失梯度。一批具有所述特性,另一批则不具有。这允许构建由梯度和属性标签 (∇ L,y') 组成的新数据集。一旦已经收集了足够的标记数据,则训练第二模型f' 以区分具有该属性的数据的损失梯度与不具有该属性的数据的损失梯度。然后使用此模型来推断是否使用具有属性的数据进行了后续模型更新。假设模型更新是以数据批次为单位进行的。攻击达到98% 的攻击曲线下面积 (AUC) 得分,并且随着时期数量的增加而变得越来越成功。攻击准确性也随着具有所讨论的属性的数据部分的增加而增加。但是,随着分布式模型中参与者数量的增加,攻击性能会大大降低。
6.2.3 重构攻击
联合学习设置中的一些数据重构攻击使用生成模型,特别是gan 42, 119。当攻击者是参与者之中时,他们可以迫使受害者发布有关他们对重建42感兴趣的类的更多信息。这种攻击的工作原理如下: 潜在的受害者拥有攻击者想要重建的 "a" 类数据。攻击者训练了一个额外的GAN模型。在每个训练回合之后,攻击者使用GAN鉴别器的目标模型参数,其目的是确定输入数据是来自类 "A" 还是由生成器生成。GAN的目的是创建能够生成忠实的 "a" 类样本的生成器。在目标模型的下一个训练步骤中,攻击者使用GAN生成一些数据,并将其标记为 "B" 类。这迫使目标模型学会区分课程 "A" 和 "B",从而提高了GAN训练及其生成类别 "A" 代表的能力。
如果攻击者可以访问中央参数服务器,则他们可以直接访问每个远程参与者的模型更新。这使得执行更成功的重构攻击119成为可能。在这种情况下,GAN鉴别器再次使用共享的模型参数,并学习区分真实数据和生成的数据以及参与者的身份。一旦训练了生成器,就使用优化方法来创建重建样本,该优化方法使真实模型更新与由于生成的数据而导致的更新之间的距离最小化。两种基于GAN的方法都假定访问属于受害者的一些辅助数据。但是,前一种方法仅生成类代表。
在同步的SGD设置中,可以访问参数服务器的攻击者可以在训练期间访问每个参与者的损失梯度。使用损失梯度足以产生训练数据样本的高质量重建,尤其是当批大小较小时130。攻击使用第二个 "虚拟" 模型。从随机虚拟输入x' 和标签y' 开始,攻击者试图将虚拟模型的损失梯度 ∇_θ J' 与参与者的损失梯度 ∇_θ J相匹配。此梯度匹配被公式化为优化任务,旨在找到使梯度距离最小化的最佳x' 和y':
x^*, y^* = min_x',y' ∇_θ J'(D';θ) - ∇_θ J(D;θ) ^2
使用有限存储器BFGS (l-bfgs) 62来求解等式7中的最小化问题。训练批次的大小是影响该攻击收敛速度的一个重要因素。
在分裂学习场景36中的推理阶段,数据重构攻击也是可能的。当本地节点处理新数据时,它们对这些初始层执行推断,然后将其输出发送到集中式服务器。在这种攻击中,攻击者被放置在集中式服务器中,他们的目标是尝试重建用于推理的数据。36涵盖了一系列场景 :( i) 白盒,其中攻击者可以访问初始层并使用它们来重建图像,(ii) 黑盒,其中攻击者不知道初始层,但可以查询它们,从而重新创建丢失的层,以及 (iii) 无查询,其中攻击者不能查询远程参与者,并尝试创建允许数据重建的替代模型。正如预期的那样,后一种攻击产生了最糟糕的结果,因为攻击者是最弱的。边缘设备和中央服务器之间的层分割也影响重建的质量。边缘神经网络中的较少层允许在集中式服务器中更好地重建。
6.3 攻击总结
为了总结针对机器学习隐私提出的攻击,表1列出了从对抗知识、攻击模型、攻击类型和攻击时机等方面分析的42篇论文。
表 1 关于机器学习系统隐私攻击的论文摘要,包括其关于对抗知识 ( 黑 / 白盒 ) 的假设信息,受攻击的模型类型,攻击类型和攻击时间 ( 在训练期间或推理期间 ) 。 知识栏中的透明圆圈表示部分白盒攻击。
| 文献 | 年份 | 攻击者知识 | 模型 | 攻击类型 | 阶段 |
|---|---|---|---|---|---|
| Fredrikson et al. 25 | 2014 | 白盒 | 线性回归 | 成员推断 | 训练 |
| Fredrikson et al. 24 | 2015 | 黑盒、白盒 | 决策树、神经网络 | 重构 | 推理 |
| Ateniese et al. 3 | 2015 | 白盒 | SVM、HMM | 属性推断 | 推理 |
| Tramer et al. 109 | 2016 | 黑盒、白盒 | 逻辑回归、决策树、SVM、神经网络 | 模型提取 | 推理 |
| Wu et al. 120 | 2016 | 黑盒、白盒 | 逻辑回归、神经网络 | 重构 | 推理 |
| Hidano et al. 38 | 2017 | 白盒 | 线性回归 | 重构 | 推理 |
| Hitaj et al. 42 | 2017 | 白盒 | 神经网络 | 重构 | 训练 |
| Papernot et al. 89 | 2017 | 黑盒 | 神经网络 | 模型提取 | 推理 |
| Shokri et al. 101 | 2017 | 黑盒 | 神经网络 | 成员推断 | 推理 |
| Correia-Silva et al. 18 | 2018 | 黑盒 | 神经网络 | 模型提取 | 推理 |
| Ganju et al. 26 | 2018 | 白盒 | 神经网络 | 属性推断 | 推理 |
| Oh et al. 86 | 2018 | 黑盒 | 神经网络 | 模型提取 | 推理 |
| Long et al. 67 | 2018 | 黑盒 | 神经网络 | 成员推断 | 推理 |
| Rahman et al. 92 | 2018 | 白盒 | 神经网络 | 成员推断 | 推理 |
| Wang | Gong 116 | 线性回归、逻辑回归、决策树、HMM、GAN/VAE | 训练 | ||
| Yeom et al. 125 | 2018 | 黑盒、部分白盒 | 线性回归、决策树、神经网络 | 重构 | 推理 |
| Carlini et al. 11 | 2019 | 黑盒 | 神经网络 | 重构 | 推理 |
| Hayes et al. 35 | 2019 | 黑盒、白盒 | GAN/VAE | 成员推断 | 推理 |
| He et al. 36 | 2019 | 黑盒、白盒 | 神经网络 | 重构 | 推理 |
| Hilprecht et al. 39 | 2019 | 黑盒 | GAN/VAE | 成员推断 | 推理 |
| Jayaraman | Evans 46 | 白盒 | 线性回归、GAN/VAE | 重构、属性推断 | |
| Juuti et al. 51 | 2019 | 黑盒 | 神经网络 | 模型提取 | 推理 |
| Milli et al. 77 | 2019 | 黑盒 | 神经网络 | 模型提取 | 推理 |
| Nasr et al. 80 | 2019 | 白盒 | 神经网络 | 成员推断 | 训练 |
| Melis et al. 75 | 2019 | 白盒 | 神经网络 | 成员推断、属性推断 | 训练 |
| Orekondy et al. 87 | 2019 | 黑盒 | 神经网络 | 模型提取 | 推理 |
| Sablayrolles et al. 94 | 2019 | 部分白盒 | 神经网络 | 成员推断 | 推理 |
| Salem et al. 95 | 2019 | 黑盒 | 神经网络 | 成员推断 | 推理 |
| Song L. et al. 105 | 2019 | 黑盒 | 神经网络 | 成员推断 | 推理 |
| Truex, et al. 110 | 2019 | 黑盒 | 逻辑回归、决策树、神经网络 | 成员推断 | 推理 |
| Wang et al. 119 | 2019 | 白盒 | 神经网络 | 重构 | 训练 |
| Yang et al. 123 | 2019 | 黑盒 | 神经网络 | 重构 | 推理 |
| Zhu et al. 130 | 2019 | 白盒 | 神经网络 | 重构 | 训练 |
| Barbalau et al. 6 | 2020 | 黑盒 | 神经网络 | 模型提取 | 推理 |
| Chandrasekaran et al. 14 | 2020 | 黑盒 | 决策树、SVM、神经网络 | 模型提取 | 推理 |
| Chen et al. 15 | 2020 | 黑盒、白盒 | GAN/VAE | 成员推断 | 推理 |
| Hishamoto et al. 41 | 2020 | 黑盒 | 神经网络 | 成员推断 | 推理 |
| Jagielski et al. 45 | 2020 | 黑盒 | 神经网络 | 模型提取 | 推理 |
| Krishna et al. 58 | 2020 | 黑盒 | 神经网络 | 模型提取 | 推理 |
| Pan et al. 88 | 2020 | 白盒 | 神经网络 | 重构 | 推理 |
| Song | Raghunathan 102 | 白盒 | 线性回归、GAN/VAE | 重构、属性推断、模型提取 | |
| Zhang et al. 129 | 2020 | 白盒 | 神经网络 | 重构 | 推理 |
在模型类型方面,83.3% 论文涉及针对神经网络的攻击,其中决策树是第二受欢迎的11.9% 攻击模型 (一些论文涵盖了针对多种模型类型的攻击)。神经网络的概念将浅层和深层模型以及多种架构组合在一起,例如卷积神经网络,递归神经网络,而在svm下,我们将线性和非线性版本组合在一起。
最受欢迎的攻击类型是隶属关系推断和重构攻击 (分别为35.7% 篇论文),模型提取是其次最受欢迎的攻击类型 (31%)。大多数建议的攻击是在推理阶段 (88%) 执行的。训练期间的攻击主要针对分布式学习形式。分别在66.7% 和54.8% 论文中研究了黑盒和白盒攻击 (一些论文涵盖了这两种设置)。在白盒类别中,我们还包括部分白盒攻击。
现有文献中对神经网络的关注以及对监督学习的关注在图4中也很明显。该图展示了基于现有文献,机器学习算法的类型与迄今为止已研究的攻击类型的对应关系。算法列表仅供参考,并不exhaustive,但其中包含了在学术研究及实际系统部署中最为流行的算法。诸如随机森林10或梯度提升树16, 55之类的算法几乎未受到关注,强化学习等整个机器学习领域也同样如此。
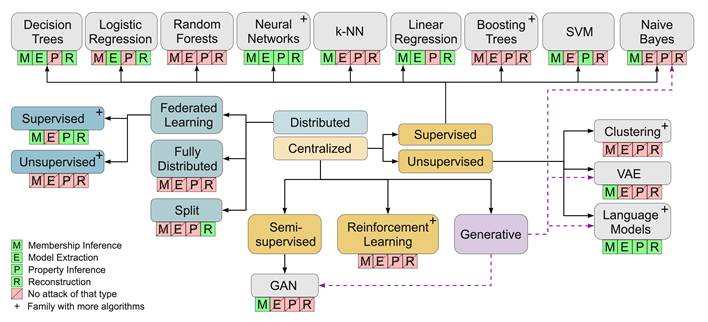
图 4 每个算法的攻击类型映射。给出的算法列表不是详尽的,而是指示性的。在每个算法或机器学习领域的下面,都有一个迄今为止已经研究过的攻击的迹象。红色框表示没有攻击。
另一个值得分析的维度是,迄今为止遭受攻击的学习任务类型。图5显示了与学习任务和攻击类型相关的论文数量信息。我们所说的"学习任务"是指目标模型最初进行训练的任务。如图所示,绝大多数攻击都针对用于分类任务的模型,包括二分类和多分类任务。在所有四种攻击类型中均是如此。
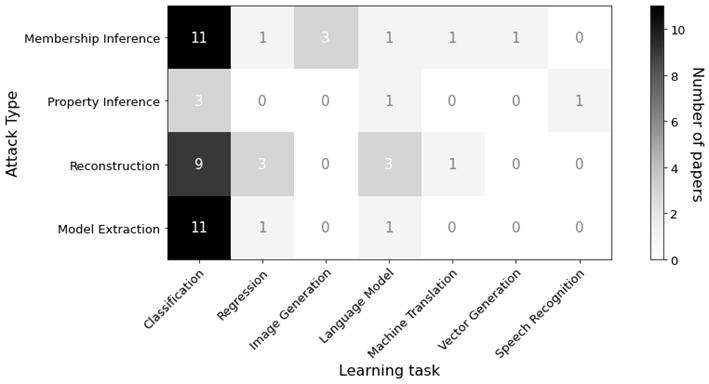
图 5 针对每个学习任务和攻击类型使用的论文数量。分类包括二元分类和多类分类。深灰色表示纸张数量较多。
尽管所回顾的论文种类多样,但仍可从中归纳出一些高层次的攻击技术模式。图6显示了与攻击技术和攻击类型相关的论文数量。最值得注意的是,有九篇论文主要将影子训练用于成员推断攻击和属性推断攻击。主动学习在模型提取攻击中颇为流行,并由四篇论文提出。生成模型(主要是GAN)被用于涵盖所有攻击类型的五篇论文中,另有三篇论文采用了梯度匹配技术。需要注意的是,"学习"技术包含多种不同的方法,从将模型参数和梯度作为分类器的输入(79, 75),到利用输入-输出查询来构建替代模型(87, 18, 45),再到从语言模型中学习分类器以进行重构(88)和属性推断(102)。在基于"阈值"的攻击中,我们对125和94及其后续论文中提出的、用于成员推断和属性推断的攻击进行了分类。
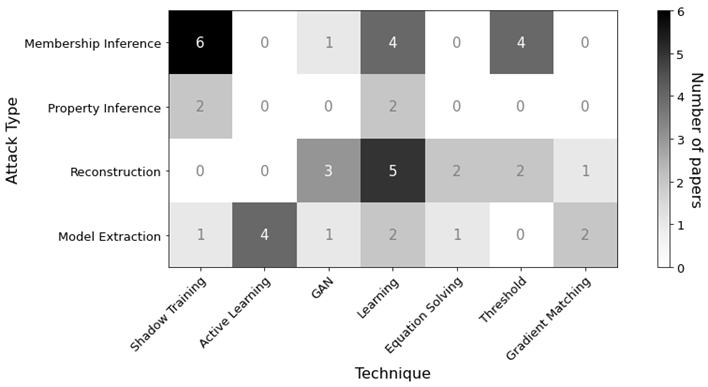
图 6 每种攻击类型使用攻击技术的论文数量。较深的灰色表示论文数量较多。
某些攻击可能适用于多个学习任务和数据集,但这种情况并非普遍存在。数据集大小、类别数量以及特征也可能是某些攻击成功与否的影响因素,尤其是因为大多数攻击都是基于经验的。表2是所有攻击论文中使用的数据集的摘要,以及其特征的数据类型,它们用于的学习任务以及数据集大小。这些数据集在目标模型的训练过程中被使用,并且在某些情况下还作为攻击过程中的辅助信息。该表格收录了42篇论文中使用的51个独特数据集,这表明不同研究方法的多样性。
表 2 关于机器学习系统隐私攻击的论文中使用的数据集摘要。除非另有说明,否则每个数据集的大小通过样品的数量来测量。 " 大小 " 列中的范围表示不同的论文使用了数据集的不同子集。
| 名称 | 数据类型 | 学习任务 | 参考文献 | 规模 |
|---|---|---|---|---|
| 538 Steak Survey 37 | 混合特征 | 多分类 | 24, 109, 14, 38 | 332 |
| AT&T Faces 4 | 图像 | 多分类 | 24, 42, 119 | 400 |
| Bank Marketing 21 | 混合特征 | 多分类 | 116 | 45,210 |
| Bitcoin prices | 时间序列 | 回归 | 109 | 1,076 |
| Book Corpus 131 | 文本 | 词级语言模型 | 102 | 14,000 sent. |
| Breast Cancer 21 | 数值特征 | 二分类 | 109, 14, 67 | 699 |
| Caltech 256 31 | 图像 | 多分类 | 87 | 30,607 |
| Caltech birds 115 | 图像 | 多分类 | 87 | 6,033 |
| CelebA 63 | 图像 | 二分类 | 26, 15, 123, 129, 6 | 20-202,599 |
| CIFAR-10 59 | 图像 | 图像生成, 多分类 | 35, 92, 95, 101, 105, 125, 94, 36, 110, 39, 77, 45, 123, 6 | 60,000 |
| CIFAR-100 59 | 图像 | 多分类 | 80, 95, 101, 125, 130, 46, 6 | 60,000 |
| CLiPS stylometry 113 | 文本 | 二分类 | 75 | 1,412 reviews |
| Chest X-ray 118 | 图像 | 多分类 | 129 | 10,000 |
| Diabetes 21 | 时间序列 | binary class., 回归 | 109, 116, 14 | 768 |
| Diabetic ret. 53 | 图像 | 图像生成 | 35, 87 | 88,702 |
| Enron emails | 文本 | 字符级语言模型 | 11 | - |
| Eyedata 96 | 数值特征 | 回归 | 125 | 120 |
| FaceScrub 83 | 图像 | 二分类 | 75, 123 | 18,809-48,579 |
| Fashion-MNIST 121 | 图像 | 多分类 | 105, 39, 45, 6 | 60,000 |
| Foursquare 122 | 混合特征 | 二分类 | 75, 101, 95 | 528,878 |
| Geog. Orig. Music 21 | 数值特征 | 回归 | 116 | 1,059 |
| German Credit 21 | 混合特征 | 二分类 | 109 | 1,000 |
| GSS marital survey 32 | 混合特征 | 多分类 | 24, 109, 14 | 16127 |
| GTSRB 107 | 图像 | 多分类 | 51, 89 | 51839 |
| HW Perf. Counters (private) | 数值特征 | 二分类 | 26 | 36,000 |
| Imagenet 20 | 图像 | 多分类 | 86, 94, 45, 6 | 14,000,000 |
| Instagram 5 | 位置数据 | 向量生成 | 15 | - |
| Iris 23 | 数值特征 | 多分类 | 109, 14 | 150 |
| IWPC 17 | 混合特征 | 回归 | 25, 125 | 3497 |
| IWSLT Eng-Vietnamese 68 | 文本 | 神经机器翻译 | 11 | - |
| LFW 43 | 图像 | 图像生成 | 35, 75, 130 | 13233 |
| Madelon 21 | 混合特征 | 多分类 | 116 | 4,400 |
| MIMIC-III 50 | 二元特征 | 记录生成 | 15 | 41,307 |
| Movielens 1M 33 | 数值特征 | 回归 | 38 | 1,000,000 |
| MNIST 60 | 图像 | 多分类 | 26, 42, 86, 92, 95, 101, 109, 125, 130, 36, 110, 39, 119, 51, 89, 77, 14, 45, 123, 129, 67 | 70,000 |
| Mushrooms 21 | 类别特征 | 二分类 | 109, 14 | 8,124 |
| Netflix 81 | 二元特征 | 二分类 | 125 | 2,416 |
| Netflows (private) | 网络数据 | 二分类 | 3 | - |
| PTB 72 | 文本 | 字符级语言模型 | 11 | 5 MB |
| PiPA 128 | 图像 | 二分类 | 75 | 18,000 |
| Purchase-100 52 | 二元特征 | 多分类 | 80, 101, 110, 46 | 197,324 |
| SVHN 82 | 图像 | 多分类 | 130, 45 | 60,000 |
| TED talks 44 | 文本 | 机器翻译 | 11 | 100,000 pairs |
| Texas-100 13 | 混合特征 | 多分类 | 80, 101 | 67,330 |
| UJIndoor 21 | 混合特征 | 回归 | 116 | 19,937 |
| UCI / Adult 21 | various | 二分类 | 26, 95, 101, 109, 110, 14, 67 | 48,842 |
| Voxforge 114 | 音频 | 语音识别 | 3 | 11,137 rec. |
| Wikipedia 70 | 文本 | 语言模型 | 102 | 150,000 articles |
| Wikitext-103 76 | 文本 | 词级语言模型 | 11, 58 | 500 MB |
| Yale-Face 27 | 图像 | 多分类 | 105 | 2,414 |
| Yelp reviews 124 | 文本 | 二分类 | 75 | 16-40,000 |
这种高度的变异性既是福也是祸。一方面,使用多种类型的数据集来测试不同的假设是非常可取的,大多数被评述的研究都遵循这一方法。另一方面,这些众多的选择使得方法之间的比较变得更加困难。从表2中可以明显看出,一些数据集非常受欢迎。MNIST、CIFAR-10、CIFAR-100和UCI Adult数据集已被超过六篇论文使用,而另有26个数据集仅被一篇论文使用。
模型参数的数量因模型、任务以及实验中所使用的数据集而异。从表2中可以看出,大多数数据集都不是非常大,因此受到攻击的模型也不是非常大。鉴于大多数论文都聚焦于神经网络,这可能表明大多数攻击针对的是规模较小的数据集和模型,而这些数据集和模型未必能代表现实场景。然而,隐私攻击并不一定非要针对那些拥有海量数据的大型模型;而且,无论神经网络多么流行,在"现实世界"中也并非最常用的技术。
7 保护机器学习隐私
泄露诸如医疗记录或信用卡号之类的个人信息通常是不希望的情况。研究针对机器学习模型的攻击的目的是能够探索机器学习的局限性和假设,并预测攻击者的行为。大多数分析论文都提出并测试了缓解措施来应对其攻击。在接下来的小节中,我们将介绍几篇论文中提出的各种防御措施,这些防御措施是根据他们试图防御的攻击类型组织的。
7.1 成员推断攻击防御
针对成员推断攻击的最突出的防御是差分隐私 (differentialprivacy,DP),它为单个数据记录对算法或模型的输出的影响提供了保证。但是,其他防御措施已经过经验测试,并在以下小节中进行了介绍。
7.1.1 差分隐私
差分隐私最初是数据分析的隐私定义,它基于 "在学习有关人群的有用信息的同时不了解个人" 的思想22。它的定义基于以下概念: 如果两个数据库仅相差一个记录,并且由相同的算法 (或机制) 使用,则该算法的输出应相似。更正式地说,
具有域R和输出S的随机化机制M是 (∈,δ)-差分私有的,如果对于任何相邻的输入D,D' ∈ R和输出S的任何子集,则认为:
PrM(D) ∈S ≤e^ϵ PrM(D') ∈S +δ
其中,ε 是隐私预算,δ 是失败概率。
DP的原始定义不包括 δ,δ 是作为一种松弛引入的,它允许某些输出不受e ^ ε 的限制。
DP的通常应用是将拉普拉斯或高斯噪声添加到数据库上的查询或函数的输出。噪声量与灵敏度有关,灵敏度给出了我们必须扰动机制输出以保护隐私的上限22:
函数f的l_1 (或l_2)-灵敏度定义为
Δf = D, D', D-D'=1max f(D) - f(D')
哪里。是l_1或l_2-norm,并且在所有可能的输入D、D' 上计算最大值。
从机器学习的角度来看,D和D' 是相差一个训练样本的两个数据集,随机化机制M是机器学习训练算法。在深度学习中,在梯度计算步骤中添加噪声。因为需要约束梯度范数,所以梯度裁剪也被应用1。
差分隐私提供了隐私保护与效用或模型准确性之间的权衡。针对成员资格推理攻击的差分私有机器学习模型的评估得出的结论是,只有当模型大大牺牲其效用92, 46时,它们才能提供隐私保护。Jayaraman等人46评估了逻辑回归和神经网络模型中DP对成员推断攻击的几种松弛。他们表明,这些放松对效用-隐私权衡有影响。虽然它们减少了所需的噪声,但它们也增加了隐私泄露。
分布式学习场景需要关于差分隐私的额外考虑。在集中式模型中,重点是样本级别DP,即在各个数据点级别保护隐私。在有多个参与者的联合学习环境中,我们不仅关心他们使用的个人训练数据点,还关心确保参与者级别的隐私。McMahan等人提出了在参与者级别应用DP的建议。74但是,它需要大量的参与者。当用低至30的数字进行测试时,该方法被认为是不成功的75。
7.1.2 正则化
机器学习中的正则化技术旨在减少过度拟合并提高模型泛化性能。Dropout 106是一种正则化形式,在训练期间随机丢弃预定义百分比的神经网络单元。鉴于黑盒成员推断攻击与过拟合有关,因此对于这种类型的攻击是一种明智的方法,并且有多篇论文提出将其作为防御措施,并取得了不同程度的成功35, 75, 95, 101, 105。另一种形式的正则化使用组合单独训练的多个模型的技术。其中一种方法,即模型堆叠,在95中进行了测试,并针对成员推断产生了积极的结果。模型堆叠或类似技术的优点是它们是模型不可知的,并且不要求目标模型是神经网络。
7.1.3 预测向量处理
由于许多模型假设在推理期间访问预测向量,因此提出的对策之一是将输出限制为模型101的前k个类别或预测。然而,即使在最严格的形式下(仅输出类别标签),这一限制似乎也未能完全缓解成员推断攻击,因为模型的误分类仍可能导致信息泄露。另一种方法是降低预测向量的精度,这将减少信息泄露101。向输出向量添加噪声也会影响隶属关系推断攻击49。
7.2 重构攻击防御
重构攻击通常需要在训练期间访问损失梯度。大多数针对重构攻击的防御措施都提出了影响从这些梯度中检索到的信息的技术。将低于某个阈值的所有损失梯度设置为零,被提议作为对深度学习中的重构攻击的防御。这种技术被证明是非常有效的,只有20% 梯度设置为零,对模型性能130的影响可以忽略不计。另一方面,对神经网络权重执行量化或使用半精度浮点似乎并不能分别阻止11和130中的攻击。
7.3 属性推断攻击防御
差分隐私旨在在成员推断攻击场景中提供隐私保证,并且它似乎不提供针对属性推断攻击3的保护。除了DP,Melis等人75还探索了其他防御属性推理攻击的方法。正则化 (dropout) 产生了不利影响,实际上使攻击变得更强。由于75中的攻击是在协作环境中进行的,因此作者在99中测试了该建议,即在培训参与者之间共享更少的梯度。尽管共享较少的信息使攻击效果降低,但并没有完全缓解攻击。
7.4 模型提取攻击防御
模型提取攻击通常要求攻击者对目标模型执行大量查询。到目前为止,提出的防御措施的目标是检测这些查询。这与先前提出的主要试图防止攻击的防御形成对比。
7.4.1 深度神经网络模型窃取防护 PRADA
Juuti et al. 51提出了基于攻击者使用的模型查询来检测模型窃取攻击。该检测基于以下假设: 试图探索决策边界的模型查询将具有与正常查询不同的分布。虽然检测成功,但作者指出,如果攻击者适应他们的策略,就有可能逃避。
7.4.2 成员推断
Krishna et al. 58研究了使用成员推断来防御模型提取的思想。它基于使用成员推断的前提,模型所有者可以区分合法的用户查询和无意义的查询,这些查询的唯一目的是提取模型。作者指出,这种类型的防御具有局限性,例如可能标记合法用户进行的合法但分布外查询,但更重要的是,进行自适应查询的攻击者可以逃避它们。
8 讨论
对机器学习隐私的攻击越来越多地被曝光。然而,我们仍处于探索阶段。许多攻击仅适用于特定的假设集,或者无法扩展到更大的训练数据集,类别数量,参与者数量等。攻击将不断改进,并成功防御它们,社区需要首先回答关于为什么它们是可能的基本问题。虽然在一些攻击的理论方面取得了进展,但要更好地理解机器学习中的隐私泄露,还有很长的路要走。
就像我们需要回答为什么泄漏发生在理论层面上一样,我们还需要知道隐私攻击在实际部署的系统上如何运作。对现实系统的对抗性攻击揭示了攻击工作所需的额外约束的问题。当创建可以欺骗面部识别系统的眼镜时,Sharif等人98,他们必须提出与物理实现有关的约束,例如,眼镜的颜色应该是可打印的。在与隐私相关的攻击中,最现实的案例来自模型提取领域,在多篇论文中已经证明了针对MLaaS系统的攻击。对于大多数其他攻击,这当然是一个悬而未决的问题,即它们在已部署模型上的表现如何,以及需要什么样的额外要求才能成功。
与此同时,迄今为止的主要研究重点一直是监督学习。即使在监督学习中,也有一些领域和学习任务在很大程度上尚未被探索,尽管应用广泛,但很少有针对流行算法 (如随机森林或梯度提升树) 的攻击报告。在无监督和半监督学习中,重点主要放在生成模型上,直到最近,论文才开始探索表示学习和语言模型等领域。对图像分类器的一些攻击不能很好地转移到自然语言处理任务41,而其他攻击则可以,但可能需要不同的假设和设计考虑88。
除了扩大对不同学习任务的关注之外,还有数据集的问题。几篇论文已经证明了数据集对攻击成功的影响。然而,目前,我们缺乏一个通用的方法来确定哪些数据集最适合评估隐私攻击,或者构成成功攻击的最低要求。有几个问题值得考虑: 我们是否需要标准化数据集?如果需要,我们如何着手创建它们?所有数据都值得保护吗?如果有些数据比其他数据更有趣,我们不应该测试流行图像数据集之外的攻击吗?
最后,当我们努力理解机器学习的隐私含义时,我们也意识到几个研究领域是相互联系和相互影响的。例如,我们知道对抗性训练会影响成员推断100,并且模型审查仍然会泄露私有属性104。属性推断攻击可以推断出训练数据集的属性,这些属性没有被专门编码或不一定与学习任务相关。这可以理解为偏差检测的一种形式,这意味着模型公平性领域的相关文献应作为潜在的补充进行审查。此外,虽然深度学习模型在可解释性方面被认为是黑盒,但揭示什么样的数据使神经元激活126, 84的工作可能与发现有关训练数据集的信息有关,因此可能导致隐私泄露。所有这些都是机器学习研究的不同领域之间潜在相互依赖的例子,因此,更好地理解隐私攻击需要跨学科的方法。
9 结论
随着机器学习变得无处不在,科学界对其在安全性,隐私性,公平性和可解释性方面的影响和副作用越来越感兴趣。这项调查对最先进的隐私相关攻击进行了全面研究,并根据其特征提出了威胁模型和不同类型攻击的统一分类法。对当前最先进的研究进行了深入的检查,使我们能够进行详细的分析,以揭示常见的设计模式及其之间的差异。
确定了几个值得进一步研究的开放性问题。首先,我们的分析揭示了到目前为止进行的研究的一个狭窄的焦点,主要是对深度学习模型的攻击。我们认为,在现实世界的部署和适用性方面,有几种流行的算法和模型值得进一步研究。其次,对隐私泄露背后的原因的透彻的理论理解仍然不发达,这影响了拟议的防御措施和我们对隐私攻击的局限性的理解。迄今为止,对影响隐私泄漏的因素的实验研究提供了有用的见解。然而,总的来说,在数据集大小和部署方面,在现实条件下测试攻击的工作很少。最后,检查安全性,可解释性和公平性等其他相邻研究领域的影响也是一个需要进一步探索的主题。尽管可能无法构建和部署针对所有类型的攻击者完全私有的模型,但了解影响隐私的相互依赖关系将有助于做出更明智的决策。
虽然社区仍处于关于机器学习系统隐私泄露的探索模式,但我们希望这项调查将为感兴趣的读者以及希望从事这一主题的研究人员提供必要的背景。
这项工作得到了Avast软件和OP RDE资助的信息学项目研究中心的部分支持,编号: CZ.02.1.01/0.0./16_019/0000765。
参考文献
1 Martin Abadi, Andy Chu, Ian Goodfellow, H. Brendan McMahan, Ilya Mironov, Kunal Talwar, and Li Zhang. 2016. Deep Learning with Differential Privacy. In Proceedings of the 2016 ACM SIGSAC Conference on Computer and Communications Security (CCS '16). Association for Computing Machinery, New York, NY, USA, 308--318. 9781450341394 https://doi.org/10.1145/2976749.2978318
2 Mohammad Al-Rubaie and Morris J. Chang. 2019. Privacy-Preserving Machine Learning: Threats and Solutions. IEEE Security & Privacy 17, 2 (2019), 49--58. https://doi.org/10.1109/MSEC.2018.2888775
3 Giuseppe Ateniese, Luigi V. Mancini, Angelo Spognardi, Antonio Villani, Domenico Vitali, and Giovanni Felici. 2015. Hacking Smart Machines with Smarter Ones: How to Extract Meaningful Data from Machine Learning Classifiers. International Journal of Security and Networks 10, 3 (Sept. 2015), 137--150. 1747-8405 https://doi.org/10.1504/IJSN.2015.071829
4 AT&T 1994. Database of Faces. http://cam-orl.co.uk/facedatabase.html Retrieved April 17, 2020 from
5 Michael Backes, Mathias Humbert, Jun Pang, and Yang Zhang. 2017. Walk2friends: Inferring Social Links from Mobility Profiles. In Proceedings of the 2017 ACM SIGSAC Conference on Computer and Communications Security (CCS '17). Association for Computing Machinery, New York, NY, USA, 1943--1957. 9781450349468 https://doi.org/10.1145/3133956.3133972
6 Antonio Barbalau, Adrian Cosma, Radu Tudor Ionescu, and Marius Popescu. 2020. Black-Box Ripper: Copying black-box models using generative evolutionary algorithms. In Advances in Neural Information Processing Systems, H. Larochelle, M. Ranzato, R. Hadsell, M. F. Balcan, and H. Lin (Eds.), Vol. 33. Curran Associates, Inc., 20120--20129. https://proceedings.neurips.cc/paper/2020/file/e8d66338fab3727e34a9179ed8804f64-Paper.pdf
7 David Berthelot, Nicholas Carlini, Ian Goodfellow, Nicolas Papernot, Avital Oliver, and Colin A Raffel. 2019. Mixmatch: A holistic approach to semi-supervised learning. In Advances in Neural Information Processing Systems. NeurIPS, Vancouver, Canada, 5050--5060.
8 Battista Biggio and Fabio Roli. 2018. Wild patterns: Ten years after the rise of adversarial machine learning. Pattern Recognition 84 (2018), 317--331.
9 Christopher M. Bishop. 2006. Pattern Recognition and Machine Learning (Information Science and Statistics). Springer-Verlag, Berlin, Heidelberg. 0387310738
10 Leo Breiman. 2001. Random forests. Machine learning 45, 1 (2001), 5--32.
11 Nicholas Carlini, Chang Liu, Úlfar Erlingsson, Jernej Kos, and Dawn Song. 2019. The Secret Sharer: Evaluating and Testing Unintended Memorization in Neural Networks. In 28th USENIX Security Symposium (USENIX Security 19). USENIX Association, Santa Clara, CA, 267--284. 978-1-939133-06-9
12 Augustin Cauchy et al 1847. Méthode générale pour la résolution des systemes d'équations simultanées. Comp. Rend. Sci. Paris 25, 1847 (1847), 536--538.
13 Texas Health Care Information Collection Center. 2006-2009. Texas Inpatient Public Use Data File (PUDF). https://www.dshs.texas.gov/thcic/hospitals/Inpatientpudf.shtm Retrieved April 17, 2020 from
14 Varun Chandrasekaran, Kamalika Chaudhuri, Irene Giacomelli, Somesh Jha, and Songbai Yan. 2020. Exploring Connections Between Active Learning and Model Extraction. In 29th USENIX Security Symposium (USENIX Security 20). USENIX Association, Boston, MA. https://www.usenix.org/conference/usenixsecurity20/presentation/chandrasekaran
15 Dingfan Chen, Ning Yu, Yang Zhang, and Mario Fritz. 2020. GAN-Leaks: A Taxonomy of Membership Inference Attacks against Generative Models. In Proceedings of the 2020 ACM SIGSAC Conference on Computer and Communications Security (CCS '20). Association for Computing Machinery, New York, NY, USA, 343--362. 9781450370899 https://doi.org/10.1145/3372297.3417238
16 Tianqi Chen and Carlos Guestrin. 2016. XGBoost: A Scalable Tree Boosting System. In Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16). Association for Computing Machinery, New York, NY, USA, 785--794. 9781450342322 https://doi.org/10.1145/2939672.2939785
17 International Warfarin Pharmacogenetics Consortium. 2009. Estimation of the warfarin dose with clinical and pharmacogenetic data. New England Journal of Medicine 360, 8 (2009), 753--764.
18 Jackson Rodrigues Correia-Silva, Rodrigo F. Berriel, Claudine Badue, Alferto F. de Souza, and Thiago Oliveira-Santos. 2018. Copycat CNN: Stealing Knowledge by Persuading Confession with Random Non-Labeled Data. In 2018 International Joint Conference on Neural Networks (IJCNN). IEEE, Rio de Janeiro, Brazil, 1--8. 2161-4407 https://doi.org/10.1109/IJCNN.2018.8489592
19 Jeffrey Dean, Greg Corrado, Rajat Monga, Kai Chen, Matthieu Devin, Mark Mao, Marc'aurelio Ranzato, Andrew Senior, Paul Tucker, Ke Yang, et al 2012. Large scale distributed deep networks. In Advances in Neural Information Processing Systems. NIPS, USA, 1223--1231.
20 Jia Deng, Wei Dong, Richard Socher, Li-Jia Li, Kai Li, and Li Fei-Fei. 2009. ImageNet: A Large-Scale Hierarchical Image Database. In 2009 IEEE Conference on Computer Vision and Pattern Recognition. IEEE, Miami, FL, USA, 248--255.
21 Dheeru Dua and Casey Graff. 2017. UCI Machine Learning Repository. http://archive.ics.uci.edu/ml Retrieved April 17, 2020 from
22 Cynthia Dwork and Aaron Roth. 2013. The algorithmic foundations of differential privacy. Foundations and Trends in Theoretical Computer Science 9, 3-4 (2013), 211--487. 15513068 https://doi.org/10.1561/0400000042
23 Ronald A Fisher. 1936. The use of multiple measurements in taxonomic problems. Annals of eugenics 7, 2 (1936), 179--188.
24 Matt Fredrikson, Somesh Jha, and Thomas Ristenpart. 2015. Model Inversion Attacks That Exploit Confidence Information and Basic Countermeasures. In Proceedings of the 22nd ACM SIGSAC Conference on Computer and Communications Security (CCS '15). Association for Computing Machinery, New York, NY, USA, 1322--1333. 9781450338325 https://doi.org/10.1145/2810103.2813677
25 Matthew Fredrikson, Eric Lantz, Somesh Jha, Simon Lin, David Page, and Thomas Ristenpart. 2014. Privacy in Pharmacogenetics: An End-to-End Case Study of Personalized Warfarin Dosing. In 23rd USENIX Security Symposium (USENIX Security 14). USENIX Association, San Diego, CA, 17--32. 978-1-931971-15-7
26 Karan Ganju, Qi Wang, Wei Yang, Carl A. Gunter, and Nikita Borisov. 2018. Property Inference Attacks on Fully Connected Neural Networks Using Permutation Invariant Representations. In Proceedings of the 2018 ACM SIGSAC Conference on Computer and Communications Security (CCS '18). Association for Computing Machinery, New York, NY, USA, 619--633. 9781450356930 https://doi.org/10.1145/3243734.3243834
27 Athinodoros S. Georghiades, Peter N. Belhumeur, and David J. Kriegman. 2001. From few to many: Illumination cone models for face recognition under variable lighting and pose. IEEE transactions on pattern analysis and machine intelligence 23, 6 (2001), 643--660.
28 Neil Zhenqiang Gong and Bin Liu. 2016. You are who you know and how you behave: Attribute inference attacks via users' social friends and behaviors. In 25th {USENIX} Security Symposium ({USENIX} Security 16). Usenix, Austin, TX, USA, 979--995.
29 Ian Goodfellow, Yoshua Bengio, and Aaron Courville. 2016. Deep Learning. The MIT Press, Cambridge, MA, USA. 0262035618
30 Ian Goodfellow, Jean Pouget-Abadie, Mehdi Mirza, Bing Xu, David Warde-Farley, Sherjil Ozair, Aaron Courville, and Yoshua Bengio. 2014. Generative Adversarial Nets. In Advances in Neural Information Processing Systems 27, Z. Ghahramani, M. Welling, C. Cortes, N. D. Lawrence, and K. Q. Weinberger (Eds.). Curran Associates, Inc., Montreal, Canada, 2672--2680. http://papers.nips.cc/paper/5423-generative-adversarial-nets.pdf
31 Gregory Griffin, Alex Holub, and Pietro Perona. 2007. The Caltech 256. Technical Report. Pasadena, CA, USA.
32 GSS. 2006. Social science research on pornography. https://byuresearch.org/ssrp/downloads/GSS.xls Retrieved April 17, 2020 from
33 F. Maxwell Harper and Joseph A. Konstan. 2015. The MovieLens Datasets: History and Context. ACM Trans. Interact. Intell. Syst. 5, 4, Article 19 (Dec. 2015), 19 pages. 2160-6455 https://doi.org/10.1145/2827872
34 Johann Hauswald, Thomas Manville, Qi Zheng, Ronald Dreslinski, Chaitali Chakrabarti, and Trevor Mudge. 2014. A hybrid approach to offloading mobile image classification. In 2014 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, Florence, Italy, 8375--8379.
35 Jamie Hayes, Luca Melis, George Danezis, and Emiliano De Cristofaro. 2019. LOGAN: Membership inference attacks against generative models. Proceedings on Privacy Enhancing Technologies 2019, 1 (2019), 133--152.
36 Zecheng He, Tianwei Zhang, and Ruby B. Lee. 2019. Model Inversion Attacks against Collaborative Inference. In Proceedings of the 35th Annual Computer Security Applications Conference (ACSAC '19). Association for Computing Machinery, New York, NY, USA, 148--162. 9781450376280 https://doi.org/10.1145/3359789.3359824
37 Walt Hickey. 2014. DataLab: How americans like their steak. http://fivethirtyeight.com/datalab/how-americans-like-their-steak Retrieved April 17, 2020 from
38 Seira Hidano, Takao Murakami, Shuichi Katsumata, Shinsaku Kiyomoto, and Goichiro Hanaoka. 2017. Model Inversion Attacks for Prediction Systems: Without Knowledge of Non-Sensitive Attributes. In 2017 15th Annual Conference on Privacy, Security and Trust (PST). IEEE, Calgary, AB, Canada, 115--124.
39 Benjamin Hilprecht, Martin Härterich, and Daniel Bernau. 2019. Monte Carlo and Reconstruction Membership Inference Attacks against Generative Models. Proceedings on Privacy Enhancing Technologies 2019, 4 (2019), 232--249.
40 Geoffrey Hinton, Nitsh Srivastava, and Kevin Swersky. 2012. Neural networks for machine learning. Coursera, video lectures 264, 1 (2012).
41 Sorami Hisamoto, Matt Post, and Kevin Duh. 2020. Membership Inference Attacks on Sequence-to-Sequence Models: Is My Data In Your Machine Translation System? Transactions of the Association for Computational Linguistics 8 (2020), 49--63. https://doi.org/10.1162/tacl_a_00299
42 Briland Hitaj, Giuseppe Ateniese, and Fernando Perez-Cruz. 2017. Deep Models Under the GAN: Information Leakage from Collaborative Deep Learning. In Proceedings of the 2017 ACM SIGSAC Conference on Computer and Communications Security (CCS '17). Association for Computing Machinery, New York, NY, USA, 603--618. 9781450349468 https://doi.org/10.1145/3133956.3134012
43 Gary B. Huang, Marwan Mattar, Tamara Berg, and Eric Learned-Miller. 2008. Labeled Faces in the Wild: A Database forStudying Face Recognition in Unconstrained Environments. In Workshop on Faces in 'Real-Life' Images: Detection, Alignment, and Recognition. Erik Learned-Miller and Andras Ferencz and Frédéric Jurie, HAL, Marseille, France. https://hal.inria.fr/inria-00321923
44 International Conference on Spoken Language Translation 2015. IWSLT Evaluation 2015. https://sites.google.com/site/iwsltevaluation2015 Retrieved April 17, 2020 from
45 Matthew Jagielski, Nicholas Carlini, David Berthelot, Alex Kurakin, and Nicolas Papernot. 2020. High Accuracy and High Fidelity Extraction of Neural Networks. In 29th USENIX Security Symposium (USENIX Security 20). USENIX Association, Boston, MA. https://www.usenix.org/conference/usenixsecurity20/presentation/jagielski
46 Bargav Jayaraman and David Evans. 2019. Evaluating Differentially Private Machine Learning in Practice. In 28th USENIX Security Symposium (USENIX Security 19). USENIX Association, Santa Clara, CA, 1895--1912. 978-1-939133-06-9
47 Malhar S. Jere, Tyler Farnan, and Farinaz Koushanfar. 2020. A Taxonomy of Attacks on Federated Learning. IEEE Security & Privacy (2020), 0--0. https://doi.org/10.1109/MSEC.2020.3039941
48 Jinyuan Jia and Neil Zhenqiang Gong. 2018. AttriGuard: A Practical Defense Against Attribute Inference Attacks via Adversarial Machine Learning. In 27th USENIX Security Symposium (USENIX Security 18). USENIX Association, Baltimore, MD, 513--529. 978-1-939133-04-5 https://www.usenix.org/conference/usenixsecurity18/presentation/jia-jinyuan
49 Jinyuan Jia, Ahmed Salem, Michael Backes, Yang Zhang, and Neil Zhenqiang Gong. 2019. MemGuard: Defending against Black-Box Membership Inference Attacks via Adversarial Examples. In Proceedings of the 2019 ACM SIGSAC Conference on Computer and Communications Security (CCS '19). Association for Computing Machinery, New York, NY, USA, 259--274. 9781450367479 https://doi.org/10.1145/3319535.3363201
50 Alistair EW Johnson, Tom J Pollard, Lu Shen, H Lehman Li-wei, Mengling Feng, Mohammad Ghassemi, Benjamin Moody, Peter Szolovits, Leo Anthony Celi, and Roger G Mark. 2016. MIMIC-III, a freely accessible critical care database. Scientific data 3 (2016), 160035.
51 Mika Juuti, Sebastian Szyller, Samuel Marchal, and N Asokan. 2019. PRADA: protecting against DNN model stealing attacks. In 2019 IEEE European Symposium on Security and Privacy (EuroS&P). IEEE, Stockholm, Sweden, 512--527.
52 Kaggle. 2014. Acquire Valued Shoppers Challenge. https://www.kaggle.com/c/acquire-valued-shoppers-challenge/data Retrieved April 17, 2020 from
53 Kaggle. 2015. Diabetic Retinopathy Detection. https://www.kaggle.com/c/diabetic-retinopathy-detection Retrieved April 17, 2020 from
54 Yiping Kang, Johann Hauswald, Cao Gao, Austin Rovinski, Trevor Mudge, Jason Mars, and Lingjia Tang. 2017. Neurosurgeon: Collaborative Intelligence Between the Cloud and Mobile Edge. In Proceedings of the Twenty-Second International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS '17). Association for Computing Machinery, New York, NY, USA, 615--629. 9781450344654 https://doi.org/10.1145/3037697.3037698
55 Guolin Ke, Qi Meng, Thomas Finley, Taifeng Wang, Wei Chen, Weidong Ma, Qiwei Ye, and Tie-Yan Liu. 2017. LightGBM: A Highly Efficient Gradient Boosting Decision Tree. Advances in Neural Information Processing Systems 30 (2017), 3146--3154.
56 Diederik P Kingma and Jimmy Ba. 2014. Adam: A method for stochastic optimization. arXiv preprint arXiv:1412.6980 (2014).
57 Diederik P Kingma and Max Welling. 2014. Auto-encoding variational bayes. In 2nd International Conference on Learning Representations, ICLR 2014, Vol. 1. ICLR, Banff, Canada.
58 Kalpesh Krishna, Gaurav Singh Tomar, Ankur P. Parikh, Nicolas Papernot, and Mohit Iyyer. 2020. Thieves on Sesame Street! Model Extraction of BERT-based APIs. In International Conference on Learning Representations. ICLR, Virtual Conference, formerly Addis Ababa, Ethiopia. https://openreview.net/forum?id=Byl5NREFDr
59 Alex Krizhevsky, Geoffrey Hinton, et al 2009. Learning multiple layers of features from tiny images. (2009).
60 Yann LeCun, Corinna Cortes, and Christopher J. C. Burges. 1998. The MNIST database of handwritten digits. http://yann.lecun.com/exdb/mnist/ Retrieved April 17, 2020 from
61 Tian Li, Anit Kumar Sahu, Ameet Talwalkar, and Virginia Smith. 2019. Federated learning: Challenges, methods, and future directions. (2019). arXiv:1908.07873
62 Dong C Liu and Jorge Nocedal. 1989. On the limited memory BFGS method for large scale optimization. Mathematical programming 45, 1-3 (1989), 503--528.
63 Jian Liu, Mika Juuti, Yao Lu, and N. Asokan. 2017. Oblivious Neural Network Predictions via MiniONN Transformations. In Proceedings of the 2017 ACM SIGSAC Conference on Computer and Communications Security (CCS '17). Association for Computing Machinery, New York, NY, USA, 619--631. 9781450349468 https://doi.org/10.1145/3133956.3134056
64 Shuying Liu and Weihong Deng. 2015. Very deep convolutional neural network based image classification using small training sample size. In 2015 3rd IAPR Asian conference on pattern recognition (ACPR). IEEE, 730--734.
65 Ximeng Liu, Lehui Xie, Yaopeng Wang, Jian Zou, Jinbo Xiong, Zuobin Ying, and Athanasios V. Vasilakos. 2021. Privacy and Security Issues in Deep Learning: A Survey. IEEE Access 9 (2021), 4566--4593. https://doi.org/10.1109/ACCESS.2020.3045078
66 Yugeng Liu, Rui Wen, Xinlei He, Ahmed Salem, Zhikun Zhang, Michael Backes, Emiliano De Cristofaro, Mario Fritz, and Yang Zhang. 2021. ML-Doctor: Holistic Risk Assessment of Inference Attacks Against Machine Learning Models. arXiv preprint arXiv:2102.02551 (2021).
67 Yunhui Long, Vincent Bindschaedler, Lei Wang, Diyue Bu, Xiaofeng Wang, Haixu Tang, Carl A Gunter, and Kai Chen. 2018. Understanding membership inferences on well-generalized learning models. arXiv preprint arXiv:1802.04889 (2018).
68 Minh-Thang Luong and Christopher D. Manning. 2015. Stanford Neural Machine Translation Systems for Spoken Language Domain. In International Workshop on Spoken Language Translation. Da Nang, Vietnam.
69 Aleksander Madry, Aleksandar Makelov, Ludwig Schmidt, Dimitris Tsipras, and Adrian Vladu. 2018. Towards Deep Learning Models Resistant to Adversarial Attacks. In International Conference on Learning Representations. ICLR, Vancouver, Canada.
70 Matt Mahoney. n.d.. Large Text Compression Benchmark. http://mattmahoney.net/dc/text.html Retrieved March 8, 2021 from
71 Davide Maiorca, Battista Biggio, and Giorgio Giacinto. 2019. Towards adversarial malware detection: Lessons learned from PDF-based attacks. ACM Computing Surveys (CSUR) 52, 4 (2019), 1--36.
72 Mitchell P. Marcus, Mary Ann Marcinkiewicz, and Beatrice Santorini. 1993. Building a Large Annotated Corpus of English: The Penn Treebank. Comput. Linguist. 19, 2 (June 1993), 313--330. 0891-2017
73 Brendan McMahan, Eider Moore, Daniel Ramage, Seth Hampson, and Blaise Aguera y Arcas. 2017. Communication-Efficient Learning of Deep Networks from Decentralized Data. In Proceedings of the 20th International Conference on Artificial Intelligence and Statistics (Proceedings of Machine Learning Research), Aarti Singh and Jerry Zhu (Eds.), Vol. 54. PMLR, Fort Lauderdale, FL, USA, 1273--1282. http://proceedings.mlr.press/v54/mcmahan17a.html
74 Brendan McMahan, Daniel Ramage, Kunal Talwar, and Li Zhang. 2018. Learning Differentially Private Recurrent Language Models. In International Conference on Learning Representations. ICLR, Vancouver, Canada. https://openreview.net/forum?id=BJ0hF1Z0b
75 Luca Melis, Congzheng Song, Emiliano De Cristofaro, and Vitaly Shmatikov. 2019. Exploiting unintended feature leakage in collaborative learning. In 2019 IEEE Symposium on Security and Privacy (SP). IEEE, San Francisco, CA, USA, 691--706.
76 Stephen Merity, Caiming Xiong, James Bradbury, and Richard Socher. 2016. Pointer sentinel mixture models. (2016). arXiv:1609.07843
77 Smitha Milli, Ludwig Schmidt, Anca D. Dragan, and Moritz Hardt. 2019. Model Reconstruction from Model Explanations. In Proceedings of the Conference on Fairness, Accountability, and Transparency (FAT* '19). Association for Computing Machinery, New York, NY, USA, 1--9. 9781450361255 https://doi.org/10.1145/3287560.3287562
78 Kevin P Murphy. 2012. Machine learning: a probabilistic perspective. MIT press, Cambridge, MA, USA.
79 Milad Nasr, Reza Shokri, and Amir Houmansadr. 2018. Machine learning with membership privacy using adversarial regularization. In Proceedings of the 2018 ACM SIGSAC Conference on Computer and Communications Security. 634--646.
80 Milad Nasr, Reza Shokri, and Amir Houmansadr. 2019. Comprehensive privacy analysis of deep learning: Passive and active white-box inference attacks against centralized and federated learning. In 2019 IEEE Symposium on Security and Privacy (SP). IEEE, San Francisco, CA, USA, 739--753.
81 Netflix 2009. Netflix prize. https://www.netflixprize.com Retrieved April 17, 2020 from
82 Yuval Netzer, Tao Wang, Adam Coates, Alessandro Bissacco, Bo Wu, and Andrew Y. Ng. 2011. Reading Digits in Natural Images with Unsupervised Feature Learning. In NIPS Workshop on Deep Learning and Unsupervised Feature Learning 2011. NIPS, Granada, Spain. http://ufldl.stanford.edu/housenumbers/nips2011_housenumbers.pdf
83 Hong-Wei Ng and Stefan Winkler. 2014. A data-driven approach to cleaning large face datasets. In 2014 IEEE international conference on image processing (ICIP). IEEE, Paris, France, 343--347.
84 Anh Nguyen, Alexey Dosovitskiy, Jason Yosinski, Thomas Brox, and Jeff Clune. 2016. Synthesizing the Preferred Inputs for Neurons in Neural Networks via Deep Generator Networks. In Proceedings of the 30th International Conference on Neural Information Processing Systems (NIPS'16). Curran Associates Inc., Red Hook, NY, USA, 3395--3403. 9781510838819
85 Jorge Nocedal and Stephen J Wright. 2006. Numerical Optimization. Springer, Berlin, Heidelberg.
86 Seong Joon Oh, Max Augustin, Mario Fritz, and Bernt Schiele. 2018. Towards Reverse-Engineering Black-Box Neural Networks. In Sixth International Conference on Learning Representations. ICLR, Vancouver, Canada. https://openreview.net/forum?id=BydjJte0-
87 Tribhuvanesh Orekondy, Bernt Schiele, and Mario Fritz. 2019. Knockoff nets: Stealing functionality of black-box models. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition. IEEE, Long Beach, CA, USA, 4954--4963.
88 Xudong Pan, Mi Zhang, Shouling Ji, and Min Yang. 2020. Privacy Risks of General-Purpose Language Models.. In 2020 IEEE Symposium on Security and Privacy (SP). IEEE, San Francisco, CA, USA, 1314--1331.
89 Nicolas Papernot, Patrick McDaniel, Ian Goodfellow, Somesh Jha, Z. Berkay Celik, and Ananthram Swami. 2017. Practical Black-Box Attacks against Machine Learning. In Proceedings of the 2017 ACM on Asia Conference on Computer and Communications Security (ASIA CCS '17). Association for Computing Machinery, New York, NY, USA, 506--519. 9781450349444 https://doi.org/10.1145/3052973.3053009
90 Nicholas Papernot, Patrick McDaniel, Arunesh Sinha, and Michael P. Wellman. 2018. SoK: Security and Privacy in Machine Learning. In 2018 IEEE European Symposium on Security and Privacy (EuroS P). IEEE, London, UK, 399--414.
91 Boris T Polyak. 1964. Some methods of speeding up the convergence of iteration methods. Ussr computational mathematics and mathematical physics 4, 5 (1964), 1--17.
92 Md Atiqur Rahman, Tanzila Rahman, Robert Laganière, Noman Mohammed, and Yang Wang. 2018. Membership Inference Attack against Differentially Private Deep Learning Model. Transactions on Data Privacy 11, 1 (2018), 61--79.
93 Herbert Robbins and Sutton Monro. 1951. A stochastic approximation method. The annals of mathematical statistics (1951), 400--407.
94 Alexandre Sablayrolles, Matthijs Douze, Cordelia Schmid, Yann Ollivier, and Herve Jegou. 2019. White-box vs Black-box: Bayes Optimal Strategies for Membership Inference. In Proceedings of the 36th International Conference on Machine Learning (Proceedings of Machine Learning Research), Kamalika Chaudhuri and Ruslan Salakhutdinov (Eds.), Vol. 97. PMLR, Long Beach, California, USA, 5558--5567. http://proceedings.mlr.press/v97/sablayrolles19a.html
95 Ahmed Salem, Yang Zhang, Mathias Humbert, Pascal Berrang, Mario Fritz, and Michael Backes. 2019. ML-Leaks: Model and Data Independent Membership Inference Attacks and Defenses on Machine Learning Models. In 26th Annual Network and Distributed System Security Symposium, NDSS. NDSS, San Diego, California, USA.
96 Todd E Scheetz, Kwang-Youn A Kim, Ruth E Swiderski, Alisdair R Philp, Terry A Braun, Kevin L Knudtson, Anne M Dorrance, Gerald F DiBona, Jian Huang, Thomas L Casavant, et al 2006. Regulation of gene expression in the mammalian eye and its relevance to eye disease. Proceedings of the National Academy of Sciences 103, 39 (2006), 14429--14434.
97 Shai Shalev-Shwartz and Shai Ben-David. 2014. Understanding Machine Learning: From Theory to Algorithms. Cambridge University Press, USA. 1107057132
98 Mahmood Sharif, Sruti Bhagavatula, Lujo Bauer, and Michael K. Reiter. 2016. Accessorize to a Crime: Real and Stealthy Attacks on State-of-the-Art Face Recognition. In Proceedings of the 2016 ACM SIGSAC Conference on Computer and Communications Security (CCS '16). Association for Computing Machinery, New York, NY, USA, 1528--1540. 9781450341394 https://doi.org/10.1145/2976749.2978392
99 Reza Shokri and Vitaly Shmatikov. 2015. Privacy-Preserving Deep Learning. In Proceedings of the 22nd ACM SIGSAC Conference on Computer and Communications Security (CCS '15). Association for Computing Machinery, New York, NY, USA, 1310--1321. 9781450338325 https://doi.org/10.1145/2810103.2813687
100 Reza Shokri, Martin Strobel, and Yair Zick. 2019. Privacy risks of explaining machine learning models. (2019). arXiv:1907.00164
101 Reza Shokri, Marco Stronati, Congzheng Song, and Vitaly Shmatikov. 2017. Membership inference attacks against machine learning models. In 2017 IEEE Symposium on Security and Privacy (SP). IEEE, San Francisco, CA, USA, 3--18.
102 Congzheng Song and Ananth Raghunathan. 2020. Information Leakage in Embedding Models. In Proceedings of the 2020 ACM SIGSAC Conference on Computer and Communications Security (CCS '20). Association for Computing Machinery, New York, NY, USA, 377--390. 9781450370899 https://doi.org/10.1145/3372297.3417270
103 Congzheng Song and Vitaly Shmatikov. 2019. Auditing Data Provenance in Text-Generation Models. In Proceedings of the 25th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining (KDD '19). Association for Computing Machinery, New York, NY, USA, 196--206. 9781450362016 https://doi.org/10.1145/3292500.3330885
104 Congzheng Song and Vitaly Shmatikov. 2020. Overlearning Reveals Sensitive Attributes. In International Conference on Learning Representations. ICLR, virtual conference.
105 Liwei Song, Reza Shokri, and Prateek Mittal. 2019. Privacy Risks of Securing Machine Learning Models against Adversarial Examples. In Proceedings of the 2019 ACM SIGSAC Conference on Computer and Communications Security (CCS '19). Association for Computing Machinery, New York, NY, USA, 241--257. 9781450367479 https://doi.org/10.1145/3319535.3354211
106 Nitish Srivastava, Geoffrey Hinton, Alex Krizhevsky, Ilya Sutskever, and Ruslan Salakhutdinov. 2014. Dropout: a simple way to prevent neural networks from overfitting. The journal of machine learning research 15, 1 (2014), 1929--1958.
107 Johannes Stallkamp, Marc Schlipsing, Jan Salmen, and Christian Igel. 2011. The German traffic sign recognition benchmark: a multi-class classification competition. In The 2011 international joint conference on neural networks. IEEE, San Jose, CA, USA, 1453--1460.
108 Richard S Sutton and Andrew G Barto. 2018. Reinforcement learning: An introduction. MIT press, Cambridge, MA.
109 Florian Tramèr, Fan Zhang, Ari Juels, Michael K. Reiter, and Thomas Ristenpart. 2016. Stealing Machine Learning Models via Prediction APIs. In 25th USENIX Security Symposium (USENIX Security 16). USENIX Association, Austin, TX, 601--618. 978-1-931971-32-4
110 Stacey Truex, Ling Liu, Mehmet Emre Gursoy, Lei Yu, and Wenqi Wei. 2019. Demystifying Membership Inference Attacks in Machine Learning as a Service. IEEE Transactions on Services Computing -, - (2019), 1--1. https://doi.org/10.1109/TSC.2019.2897554
111 Vladimir Vapnik. 1992. Principles of risk minimization for learning theory. In Advances in neural information processing systems. 831--838.
112 Michael Veale, Reuben Binns, and Lilian Edwards. 2018. Algorithms that remember: model inversion attacks and data protection law. Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences 376, 2133 (2018), 20180083.
113 Ben Verhoeven and Walter Daelemans. 2014. CLiPS Stylometry Investigation (CSI) corpus: a Dutch corpus for the detection of age, gender, personality, sentiment and deception in text. In Proceedings of the Ninth International Conference on Language Resources and Evaluation (LREC-2014). European Language Resources Association (ELRA), Reykjavik, Iceland, 3081--3085.
114 VoxForge 2009. VoxForge Speech Corpus. http://www.voxforge.org/ Retrieved April 17, 2020 from
115 Catherine Wah, Steve Branson, Peter Welinder, Pietro Perona, and Serge Belongie. 2011. The caltech UCSD birds-200-2011 dataset. Technical Report. Pasadena, CA, USA.
116 Binghui Wang and Neil Zhenqiang Gong. 2018. Stealing hyperparameters in machine learning. In 2018 IEEE Symposium on Security and Privacy (SP). IEEE, San Francisco, CA, USA, 36--52.
117 Xianmin Wang, Jing Li, Xiaohui Kuang, Yu-an Tan, and Jin Li. 2019. The security of machine learning in an adversarial setting: A survey. J. Parallel and Distrib. Comput. 130 (2019), 12--23.
118 Xiaosong Wang, Yifan Peng, Le Lu, Zhiyong Lu, Mohammadhadi Bagheri, and Ronald M. Summers. 2017. ChestX-ray8: Hospital-Scale Chest X-Ray Database and Benchmarks on Weakly-Supervised Classification and Localization of Common Thorax Diseases. In The IEEE Conference on Computer Vision and Pattern Recognition (CVPR). IEEE, Honolulu, HI, USA.
119 Zhibo Wang, Mengkai Song, Zhifei Zhang, Yang Song, Qian Wang, and Hairong Qi. 2019. Beyond Inferring Class Representatives: User-Level Privacy Leakage From Federated Learning. In IEEE INFOCOM 2019 - IEEE Conference on Computer Communications. IEEE, Paris, France, 2512--2520.
120 Xi Wu, Matthew Fredrikson, Somesh Jha, and Jeffrey F Naughton. 2016. A methodology for formalizing model-inversion attacks. In 2016 IEEE 29th Computer Security Foundations Symposium (CSF). IEEE, Lisbon, Portugal, 355--370.
121 Han Xiao, Kashif Rasul, and Roland Vollgraf. 2017. Fashion-mnist: a novel image dataset for benchmarking machine learning algorithms. (2017). arXiv:1708.07747
122 Dingqi Yang, Daqing Zhang, Longbiao Chen, and Bingqing Qu. 2015. Nationtelescope: Monitoring and visualizing large-scale collective behavior in lbsns. Journal of Network and Computer Applications 55 (2015), 170--180.
123 Ziqi Yang, Jiyi Zhang, Ee-Chien Chang, and Zhenkai Liang. 2019. Neural Network Inversion in Adversarial Setting via Background Knowledge Alignment. In Proceedings of the 2019 ACM SIGSAC Conference on Computer and Communications Security (CCS '19). Association for Computing Machinery, New York, NY, USA, 225--240. 9781450367479 https://doi.org/10.1145/3319535.3354261
124 Yelp. n.d.. Yelp Open Dataset. https://www.yelp.com/dataset Retrieved April 17, 2020 from
125 Samuel Yeom, Irene Giacomelli, Matt Fredrikson, and Somesh Jha. 2018. Privacy risk in machine learning: Analyzing the connection to overfitting. In 2018 IEEE 31st Computer Security Foundations Symposium (CSF). IEEE, Oxford, UK, 268--282.
126 Jason Yosinski, Jeff Clune, Anh Nguyen, Thomas Fuchs, and Hod Lipson. 2015. Understanding neural networks through deep visualization. arXiv preprint arXiv:1506.06579 (2015).
127 Xiaohua Zhai, Avital Oliver, Alexander Kolesnikov, and Lucas Beyer. 2019. S4l: Self-supervised semi-supervised learning. In Proceedings of the IEEE international conference on computer vision. IEEE, Seoul, Korea (South), 1476--1485.
128 Ning Zhang, Manohar Paluri, Yaniv Taigman, Rob Fergus, and Lubomir Bourdev. 2015. Beyond frontal faces: Improving person recognition using multiple cues. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition. IEEE, Boston, MA, USA, 4804--4813.
129 Yuheng Zhang, Ruoxi Jia, Hengzhi Pei, Wenxiao Wang, Bo Li, and Dawn Song. 2020. The secret revealer: generative model-inversion attacks against deep neural networks. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. IEEE, 253--261.
130 Ligeng Zhu, Zhijian Liu, and Song Han. 2019. Deep Leakage from Gradients. In Advances in Neural Information Processing Systems 32, H. Wallach, H. Larochelle, A. Beygelzimer, F. d'Alché-Buc, E. Fox, and R. Garnett (Eds.). Curran Associates, Inc., Vancouver, Canada, 14747--14756.
131 Yukun Zhu, Ryan Kiros, Rich Zemel, Ruslan Salakhutdinov, Raquel Urtasun, Antonio Torralba, and Sanja Fidler. 2015. Aligning books and movies: Towards story-like visual explanations by watching movies and reading books. In Proceedings of the IEEE international conference on computer vision. 19--27.