目录标题
一、概念
二、推导概述
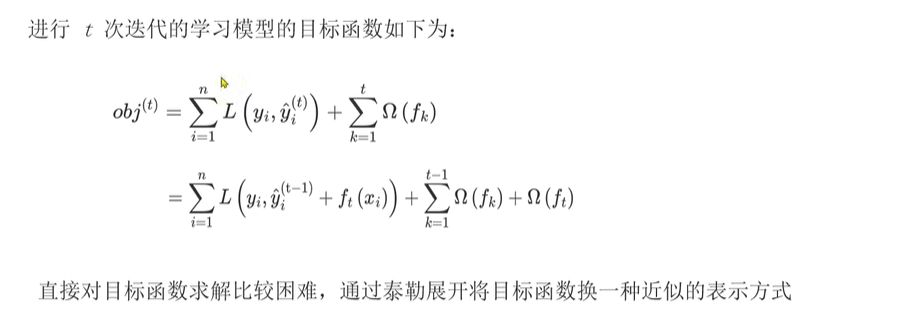
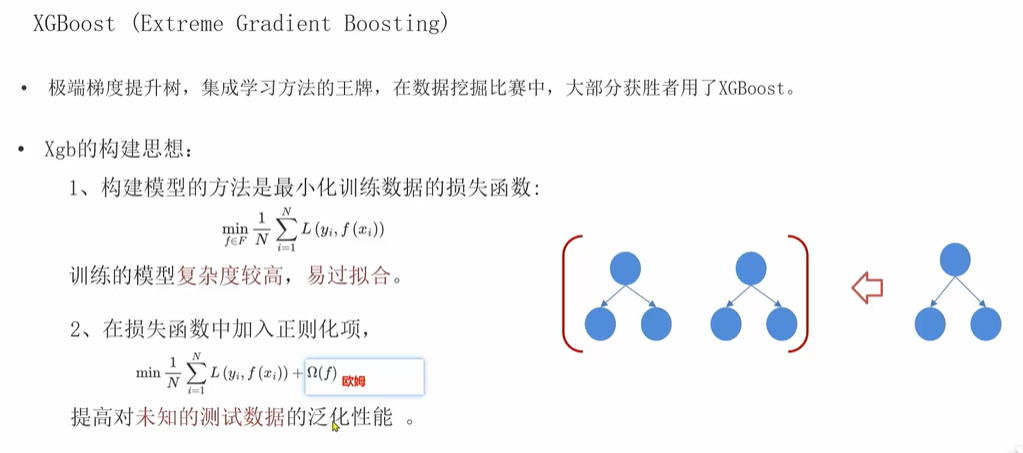
XGBoost(极限梯度提升树,Extheme Gradient Boosting Tree),基于 打分函数的结果 决定是否分枝
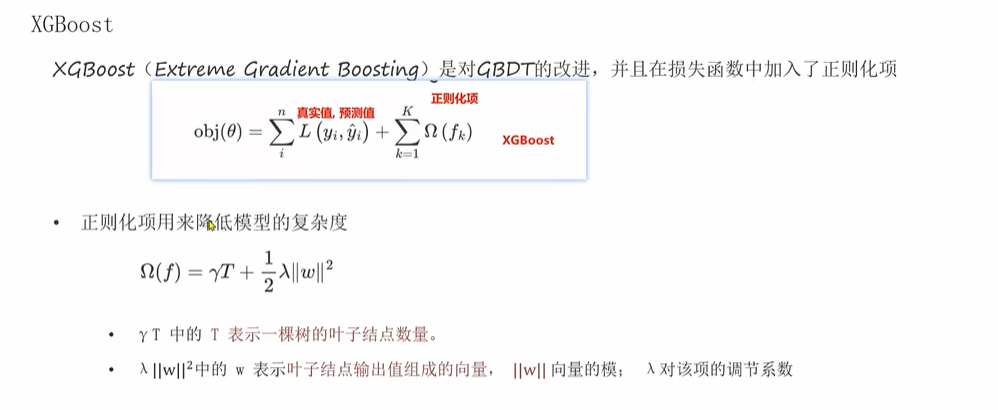
步骤: 1.在损失函数的基础上 + 正则化项
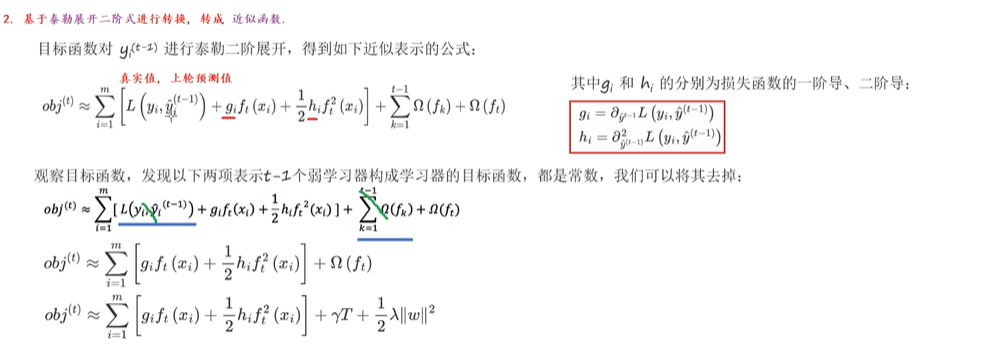
2.基于特勒展开二阶式进行转换, 转成 近似函数
3.把问题从 样本角度 -> 叶子点角度 进行分析
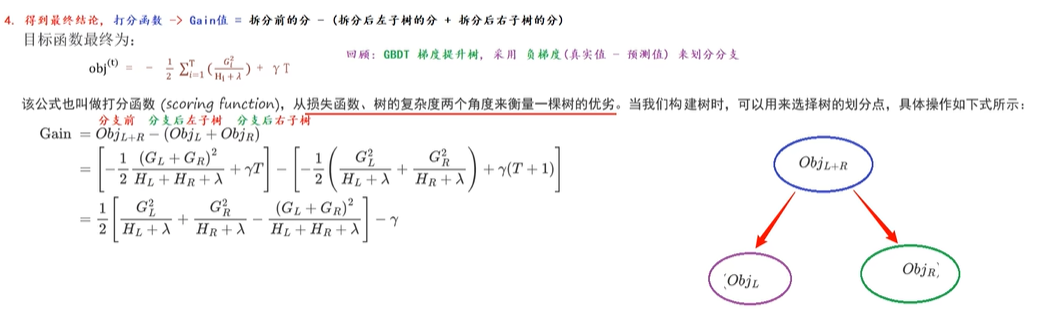
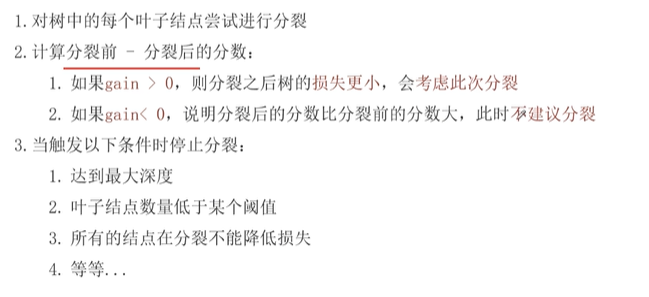
4.得到最终结论,打分函数 ->Gian值 = 拆分前的分 - (拆分后左子树的分 - 拆分后右子树的分)
三、推导第一步
特勒展开看我前置知识 blog:机器学习:集成学习4(XGBoost前置知识泰勒展开式1)(或自行学习)
这里t轮的预测 怎么等于 t- 1 的预测 + t棵树的输出 这步转换在 blog
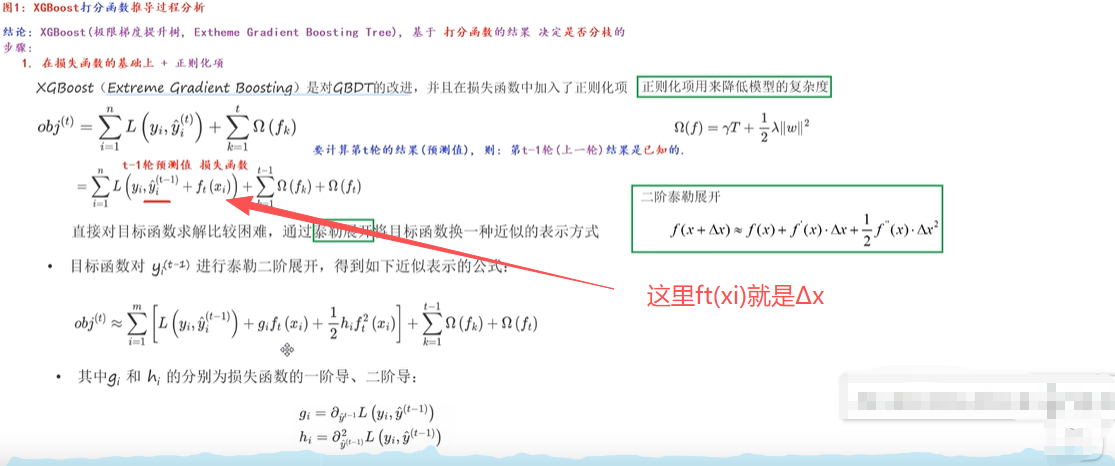
1、先看原始目标函数
图片上方写的是:
o b j ( t ) = ∑ i = 1 n L ( y i , y ^ i ( t ) ) + ∑ k = 1 t Ω ( f k ) obj^{(t)} = \sum_{i=1}^n L\left(y_i, \hat{y}i^{(t)}\right) + \sum{k=1}^t \Omega(f_k) obj(t)=i=1∑nL(yi,y^i(t))+k=1∑tΩ(fk)
这里:
- ( t (t (t) 表示第 ( t (t (t) 轮
- ( y ^ i ( t ) (\hat{y}_i^{(t)} (y^i(t)) 是第 ( t (t (t) 轮的预测值
- ( L (L (L) 是损失函数
- ( Ω ( f k ) (\Omega(f_k) (Ω(fk)) 是第 ( k (k (k) 棵树的正则化项
- y i y_i yi就是真实值,不是本轮真实,右上角可没有标t(老师讲课讲错了,使用t-1 个弱学习器 预测值 和 t 个弱学习器的预测值 算 t 弱学习器 的输出,和这个 y i y_i yi就是真实值没关系, 最终二阶泰勒展开算的是 f t ( x i ) f_t(x_i) ft(xi))
2、关键:预测值是怎么累加的?
XGBoost 是加法模型,每一轮新加一棵树。
所以第 (t) 轮的预测值等于:
y ^ i ( t ) = y ^ i ( t − 1 ) + f t ( x i ) \hat{y}_i^{(t)} = \hat{y}_i^{(t-1)} + f_t(x_i) y^i(t)=y^i(t−1)+ft(xi)
意思是:
第 (t) 轮的预测值 = 前 (t - 1) 轮的预测值 + 第 (t) 棵树的输出
这个公式是理解这一步的全部关键。
四、推导第二步
泰勒可以将一个函数变成各阶导数和
五、推导第三步
理解下面前置知识图片
前置知识:区分 f t ( x i ) f_t(x_i) ft(xi)和 w w w 区别
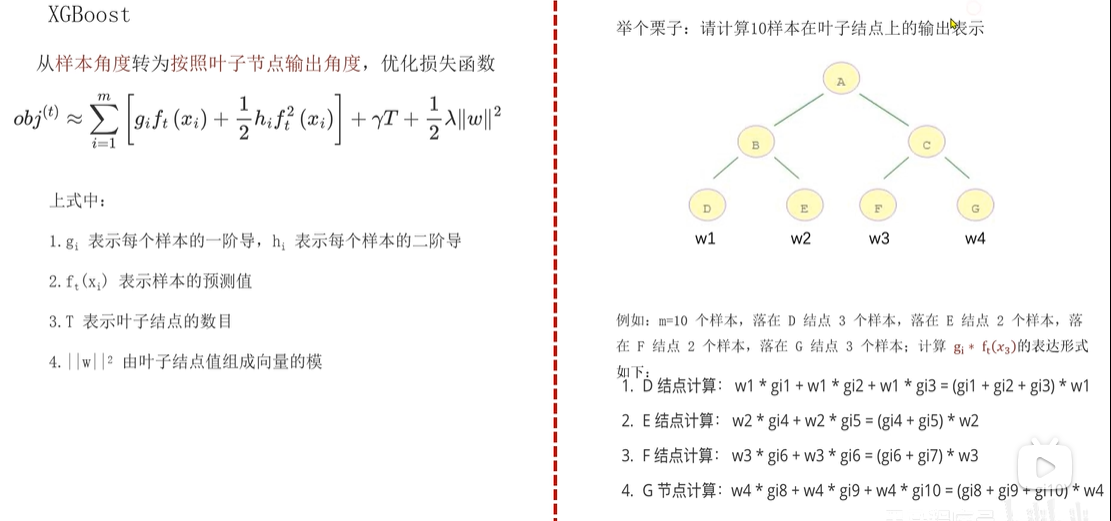
结论先放在前面:
- ( w (w (w) 确实是这个叶子节点的输出值(也就是这个样本的输出)。
- PPT 并没有写错, ( f t ( x i ) (f_t(x_i) (ft(xi)) 和 ( w (w (w) 其实是同一个东西的两种不同表达方式,只是站在了不同的视角。
为了让你彻底明白,我们把这两张图拆开,用大白话一步步理顺。
1、为什么 PPT 没有写错? ( f t ( x i ) (f_t(x_i) (ft(xi)) 到底是什么?
首先,我们要搞懂 ( f t ( x i ) (f_t(x_i) (ft(xi)) 这个符号代表什么。
- ( t (t (t):代表第 ( t (t (t) 棵树。
- ( x i (x_i (xi):代表第 ( i (i (i) 个样本的特征。
- ( f t ( x i ) (f_t(x_i) (ft(xi)):意思是"第 ( t (t (t) 棵树,对第 ( i (i (i) 个样本给出的预测值"。
现在,假设你有一棵树(比如图里的那棵树),样本 ( i (i (i) 顺着树的分支往下走,最后落在了 D 这个叶子节点上。
那么,这棵树对这个样本的预测值 ( f t ( x i ) (f_t(x_i) (ft(xi)) 是多少呢?就是 D 这个叶子节点的输出值。
我们把 D 叶子节点的输出值命名为 ( w 1 (w_1 (w1)。
所以,对于落在 D 节点的样本来讲, ( f t ( x i ) = w 1 (f_t(x_i) = w_1 (ft(xi)=w1)。
PPT 右图只是把"某个具体样本的预测值"统一抽象成了 ( w 1 , w 2 , w 3 , w 4 (w_1, w_2, w_3, w_4 (w1,w2,w3,w4)。它们本质上是一回事,只是叫法不同。就像同一个人,在家里叫"爸爸",在公司叫"张总"。
2、为什么 PPT 左边写 ( f t ( x i ) (f_t(x_i) (ft(xi)),右边写 ( w (w (w)?
因为这两张图在推导不同的阶段,视角发生了转换:
-
左图(宏观/样本视角):
我们要算总损失 ( o b j ( t ) (obj^{(t)} (obj(t)),公式是 ( ∑ i = 1 m g i f t ( x i ) + 1 2 h i f t 2 ( x i ) (\sum_{i=1}^m g_i f_t(x_i) + \\frac{1}{2} h_i f_t\^2(x_i) (∑i=1mgift(xi)+21hift2(xi))。
这里是在遍历每一个样本 ( i (i (i),把每个样本的预测值加起来。对于样本 ( i (i (i) 来说,它的预测值就是 ( f t ( x i ) (f_t(x_i) (ft(xi))。
所以公式里只能写 ( f t ( x i ) (f_t(x_i) (ft(xi)),因为还没确定它落在哪个叶子节点。
-
右图(微观/叶子节点视角):
我们需要把上面的公式整理一下,合并同类项。
如果 10 个样本里,有 3 个样本落在了 D 节点,那么这 3 个样本的预测值都是同一个数,也就是 D 节点的输出值 ( w 1 (w_1 (w1)。
所以,原本的 ( ∑ i = 1 m (\sum_{i=1}^m (∑i=1m)(按样本求和),就变成了按叶子节点求和:
( g 1 w 1 + g 2 w 1 + g 3 w 1 ) + ( g 4 w 2 + g 5 w 2 ) + ... (g_1 w_1 + g_2 w_1 + g_3 w_1) + (g_4 w_2 + g_5 w_2) + \dots (g1w1+g2w1+g3w1)+(g4w2+g5w2)+...
提取公因式 ( w 1 (w_1 (w1) 之后,就变成了 ( ( g 1 + g 2 + g 3 ) w 1 ((g_1 + g_2 + g_3)w_1 ((g1+g2+g3)w1)。
所以,PPT 右图并没有把 ( f t ( x i ) (f_t(x_i) (ft(xi)) 错写成 ( w (w (w),而是把 ( f t ( x i ) (f_t(x_i) (ft(xi)) 替换成了它实际代表的数值 ( w (w (w),用来做合并同类项化简。
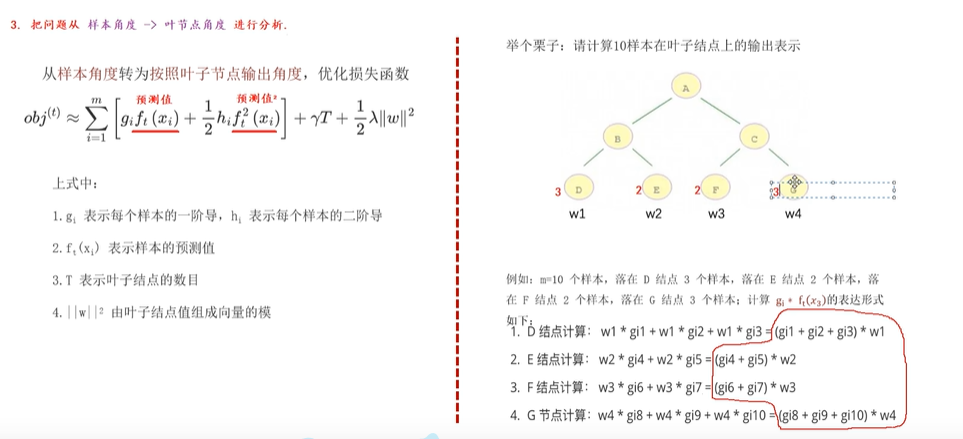
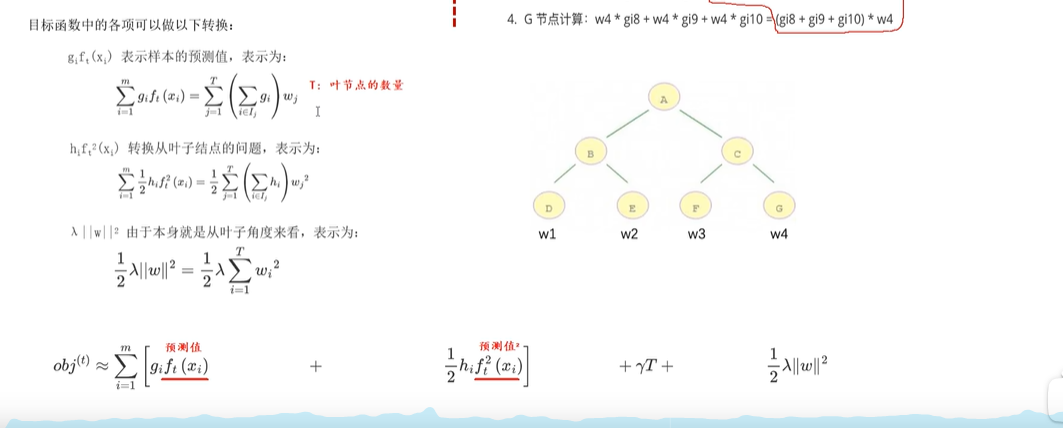
对应样本角度转成叶节点角度(公式转换)
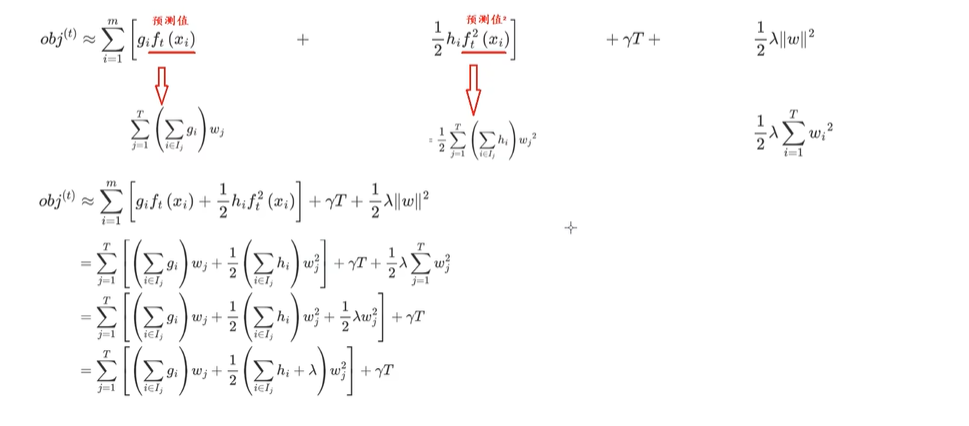
所有样本一阶导之和和二阶导之和带入 转换
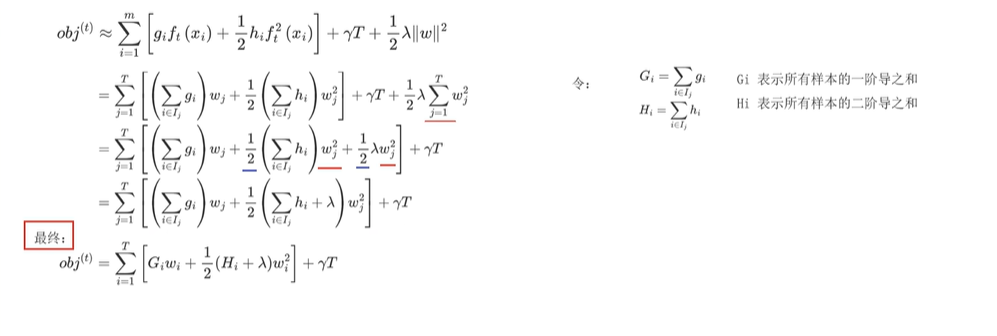
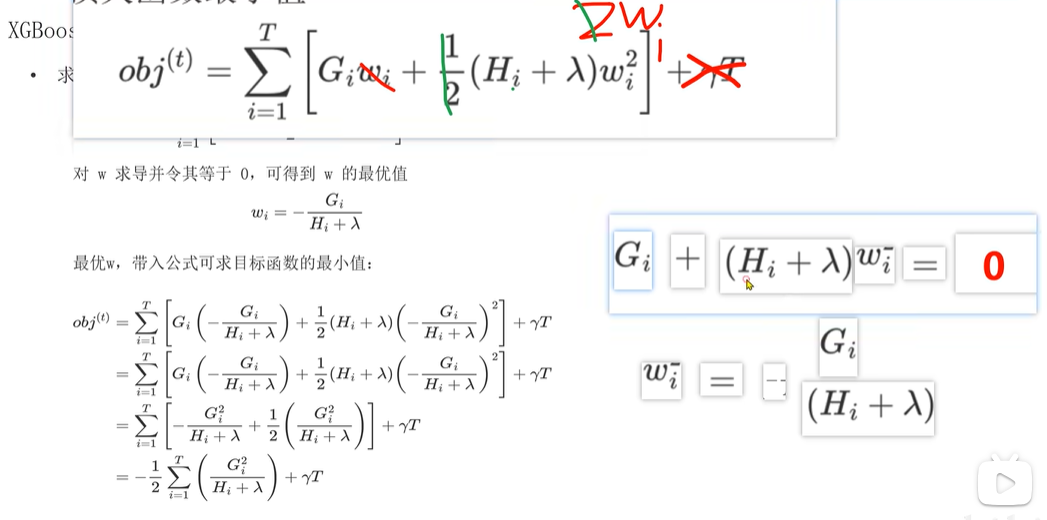
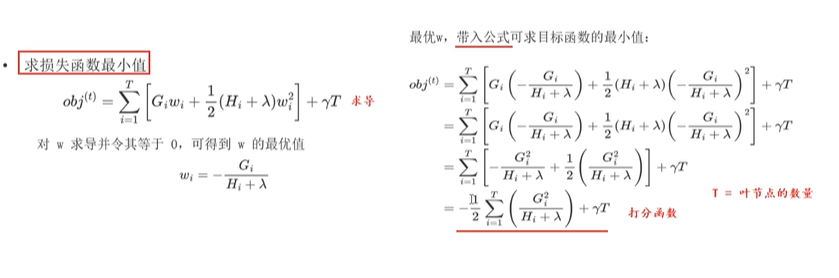
求导算出 w ,然后带入公式
六、推导第四步