深入理解lstm的底层原理
- 一、深入理解什么lstm的底层原理
-
- [1. RNN循环神经网络痛点](#1. RNN循环神经网络痛点)
- [2. LSTM 到底是什么](#2. LSTM 到底是什么)
-
- [2.1. LSTM核心概念](#2.1. LSTM核心概念)
- [2.2. LSTM核心组件](#2.2. LSTM核心组件)
- [3. LSTM 核心工作流程](#3. LSTM 核心工作流程)
-
- [3.1 遗忘门-决定旧记忆保留多少](#3.1 遗忘门-决定旧记忆保留多少)
- [3.2 输入门-哪些新信息值得记录](#3.2 输入门-哪些新信息值得记录)
- [3.3 更新长期记忆 C](#3.3 更新长期记忆 C)
- [3.4 输出门-暴露哪些信息给h使用](#3.4 输出门-暴露哪些信息给h使用)
- [3.5 输出参数yt(不属于lstm的结构门)](#3.5 输出参数yt(不属于lstm的结构门))
- [4. LSTM案例连贯输出](#4. LSTM案例连贯输出)
- [5. LSTM的价值和局限](#5. LSTM的价值和局限)
-
- [5.1 RNN vs LSTM](#5.1 RNN vs LSTM)
- [5.2 LSTM 缓解梯度消失](#5.2 LSTM 缓解梯度消失)
- [5.3 LSTM 的实际应用场景](#5.3 LSTM 的实际应用场景)
- [5.4 LSTM 的痛点](#5.4 LSTM 的痛点)
如需转载,请附上链接:https://zhenghuisheng.blog.csdn.net/article/details/166679102
一、深入理解什么lstm的底层原理
在学习LSTM之前,需要先学习这个RNN循环神经网络:RNN循环神经网络
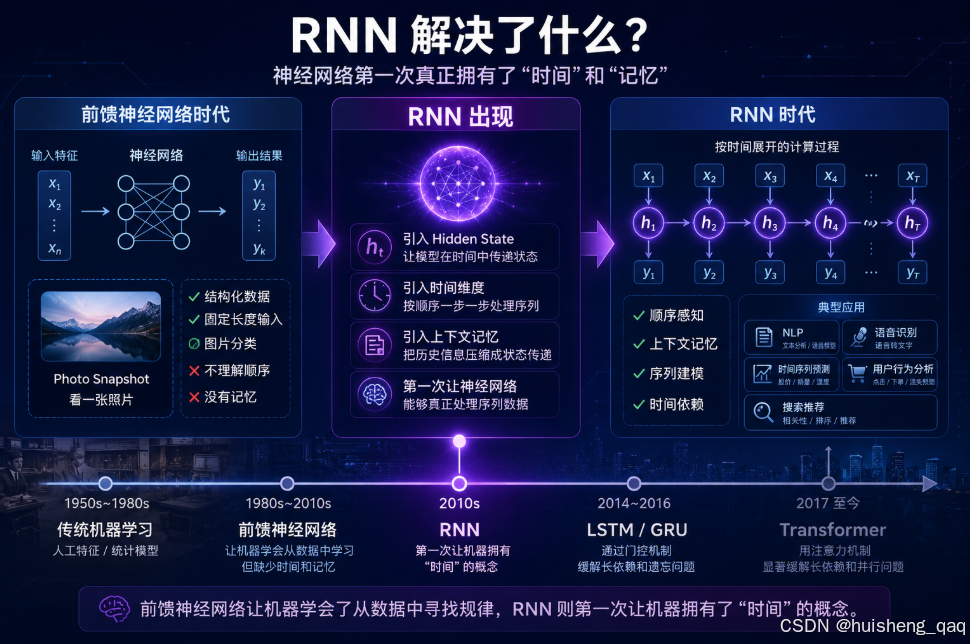
上一篇文章我们讲解了RNN循环神经网络,RNN循环神经网络基于前馈神经网络的基础上已经有了很大的优化,在集成了前馈神经网络的特点的情况下,同时引入了隐藏状态H---上下文的压缩摘要(压缩记忆),让模型有了上下文记忆;引入时间维度让整个流程固定的顺序读,使得他有了固定处理顺序数据的能力 。通过这两点让神经网络有了顺序和短期记忆。RNN虽然在这些方面有了一定的改进,但本身仍然有着许多的痛点,比如会随着序列越长导致早期的许多重要信息逐渐丢失,记忆能力不断下降等,因此才有了本文的主角-LSTM。
1. RNN循环神经网络痛点
RNN循环神经网络已经是一项具有历史意义的突破,他使得模型短期内有了记忆。但是对于RNN循环神经网络本身,还是具有一定的局限限,比如长序列问题导致压缩在h中的前文的记忆不断地被稀释和衰减、训练时共用一套参数会导致梯度消失或者梯度衰减。
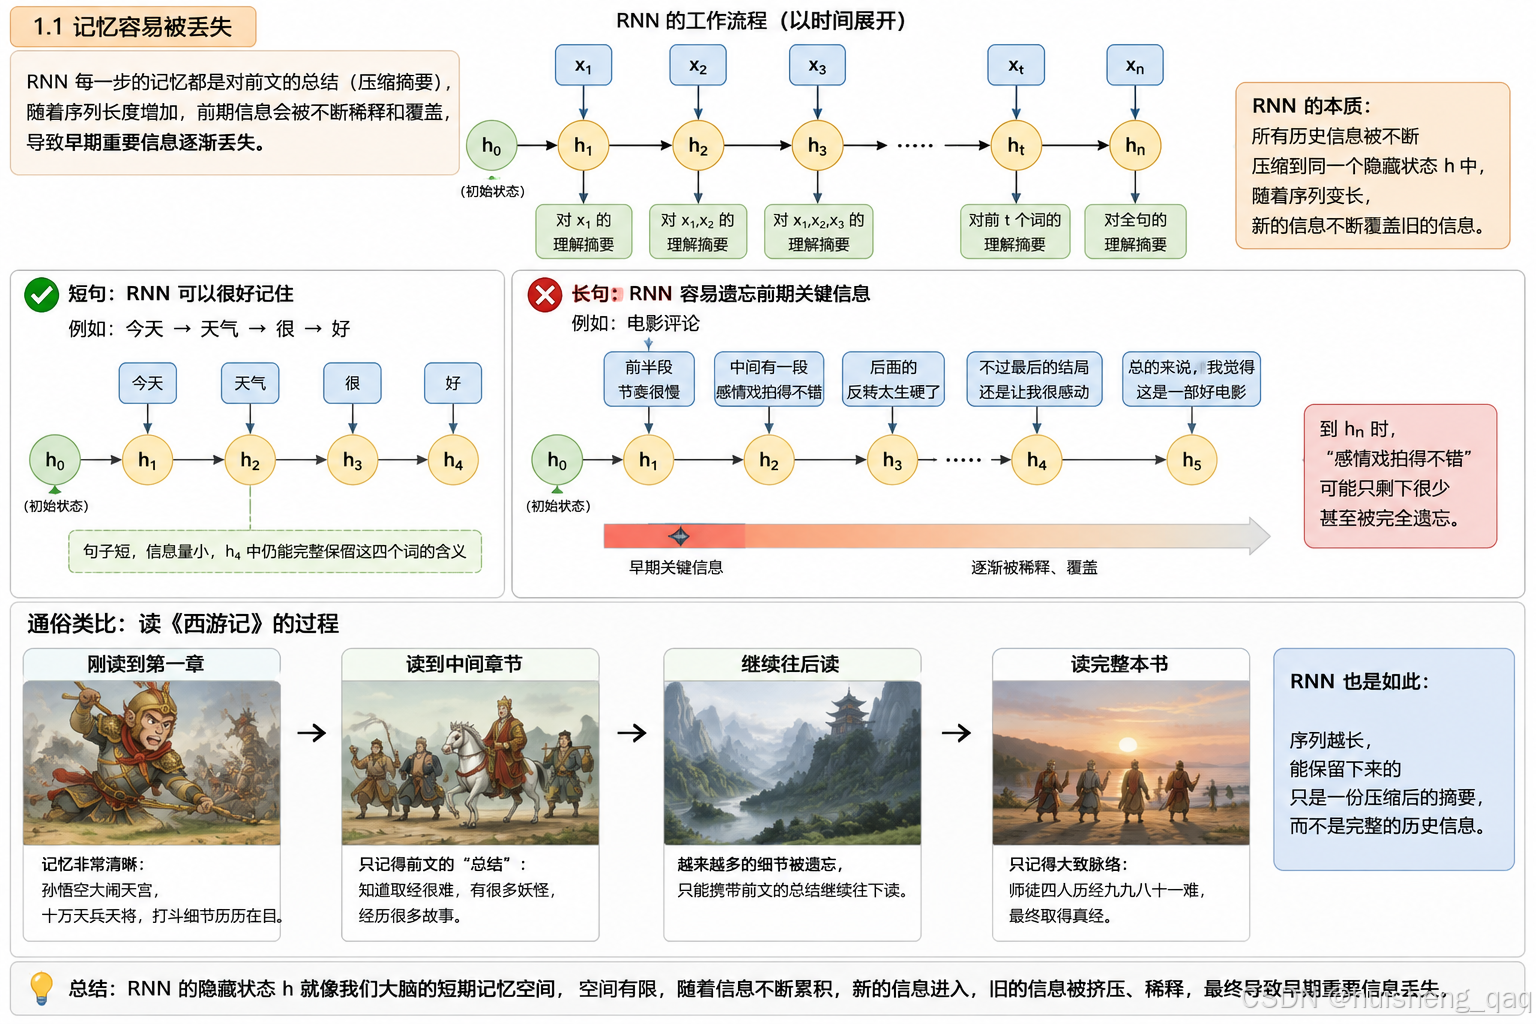
1.1,记忆容易被丢失
比如虽然可以拥有记忆,但是每一步的记忆都是总结的摘要,也就是说前面先出现的记忆会被先总结,但是随着上下文的长度增加,前期的记忆容易被稀释和衰减,所以记忆也容易丢失。
-
对于短句而言,RNN循环神经网络没有任何问题。如今天天气很好,"今天→天气 → 很 → 好",在h4中是可以清楚的记住这四个词,信息还没有来的及被覆盖
-
但是对于长句而言,如最后一个好是怎么体现出来的,按理来说是因为感情戏拍的不错,结局让我很感动,但是在RNN循环神经网络中,可以能会因为隐藏状态导致记忆被不断稀释,可能到了最后的hn剩下的记忆并没有存储到这些内容,或者存储的不多,记忆内容被稀释导致
这部电影的前半段节奏很慢,中间有一段感情戏拍得不错,但是后面的反转太生硬了,不过最后的结局还是让我很感动,总的来说,我觉得这是一部好电影。
举个通俗易懂的例子:比如在读西游记,我们的脑子在读某一个章节的时候或许当时的记忆很深刻,但是继续读下一章节的时候,就只能携带上一章节总结的记忆继续读下文,比如在读孙悟空大战10万天兵天将的时候可以清晰的知道每一处细节,但是在不断的往下文读的时候,只能携带前文的总结不断的往下读,直到读取到取经成功,可能前面的每一章的细节都忘记了,或者某一难某一个具体的任务精彩的打斗都可能被遗忘,甚至某一章节也可能遗漏,脑子里记住的都是全文总结,尤其是文章前面的很多内容估计都差不多忘记了,这个和RNN循环神经网络的痛点是一样的。
换句话说,就是我们的大脑每次都只能存这么多信息,如果存的越多那么前文的的信息就有被稀释和遗忘的可能,这个和循环神经网络是一样的。循环神经网络的本质也是会将整个序列的上下文全部压缩在一个h隐藏记忆里面,他的空间和大脑一样有限,如果量太大也就只能记忆一些最终压缩后的记忆,那么在最前面的以就可能不断的被稀释或者直接丢失 。
1.2,梯度爆炸或者趋于0
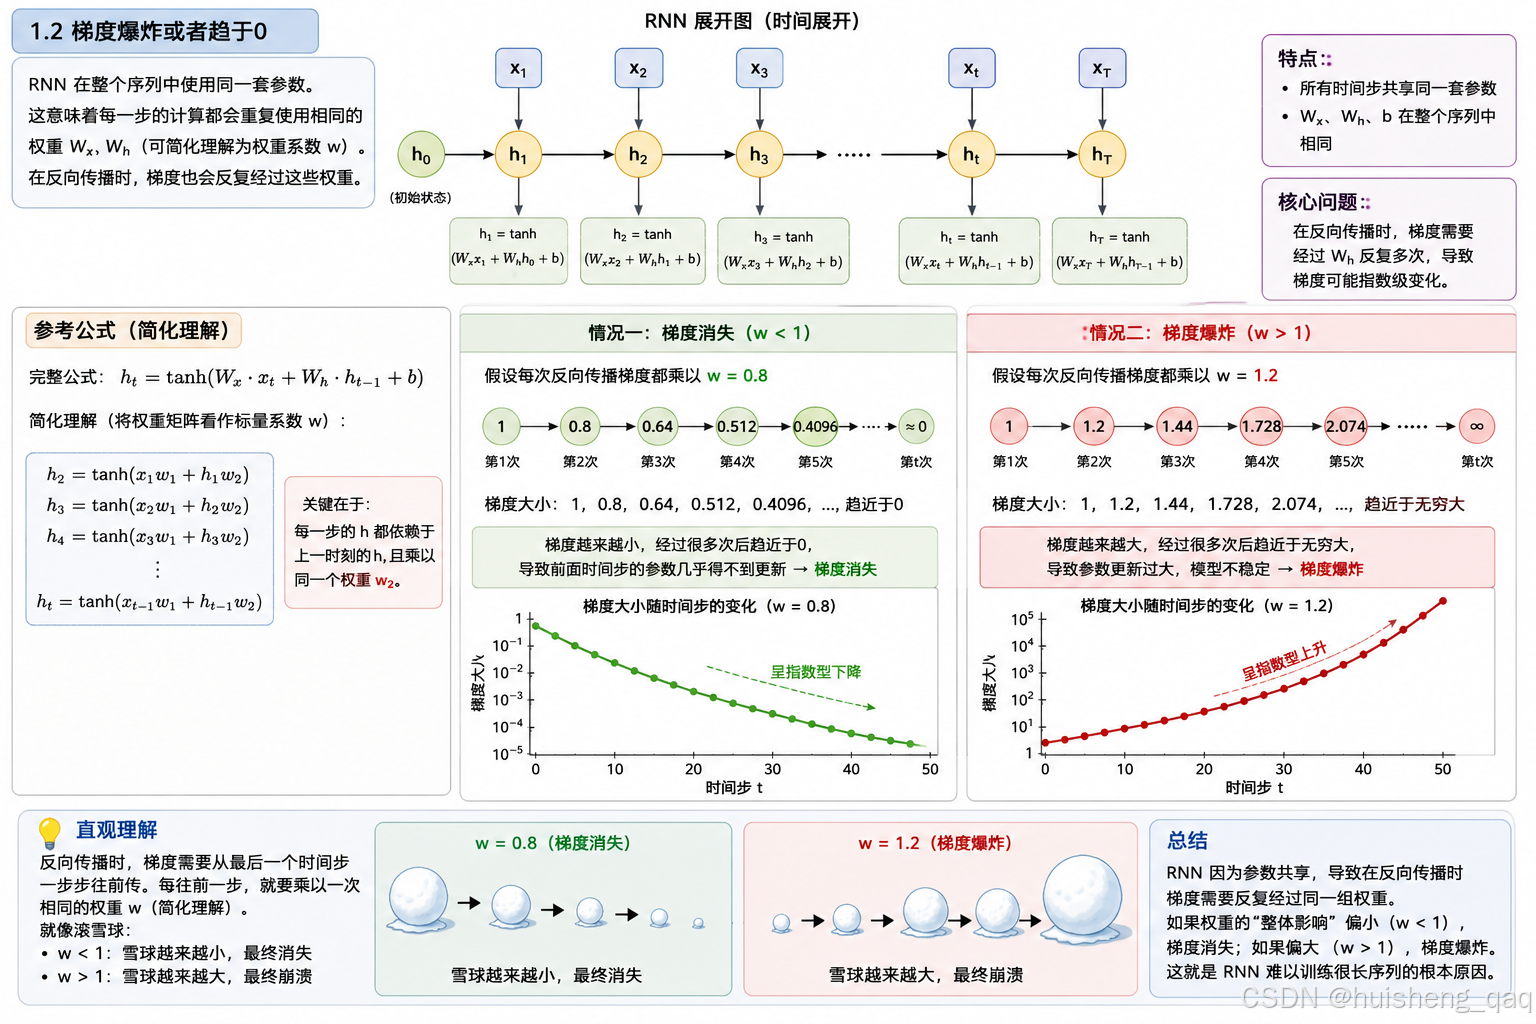
整个RNN的计算方式都是共用一套参数,相当于输入参数x和记忆h对应的值的参考公式如下, 都会乘以一个相同的权重w,如果w大于1,那么就会对这梯度指数级别的增加,容易导致梯度爆炸;如果w小于1,那么就是会指数级别的降低,容易导致梯度最终趋于0。当然这里w是一个向量,这里先用一个数字先表示一下。
java
h_t = tanh(W_x · x_t + W_h · h_{t-1} + b)
h2 = tanh(x1w1 + h1w2)
h3 = tanh(x2w1 + h2w2)
因为每一步都要乘以一个相同的权重,比如一开始初始值是1:
- 如果权重w=0.8,那么第一次就是0.8,第二次就是0.64...呈指数型变小,直到趋近于0,那么这个就是梯度消失
- 如果权重w=1.2,那么第一次就是1.2,第二次就是1.44...呈指数型变大,直到趋近于无穷大,那么这个就是梯度爆炸
2. LSTM 到底是什么
2.1. LSTM核心概念
既然上面得到RNN还存在着这些历史缺陷,显然这个lstm就是用来优化这个RNN的流程的。lstm指的是 Long Short-Term Memory ,意思就是同时拥有长记忆和短期记忆。
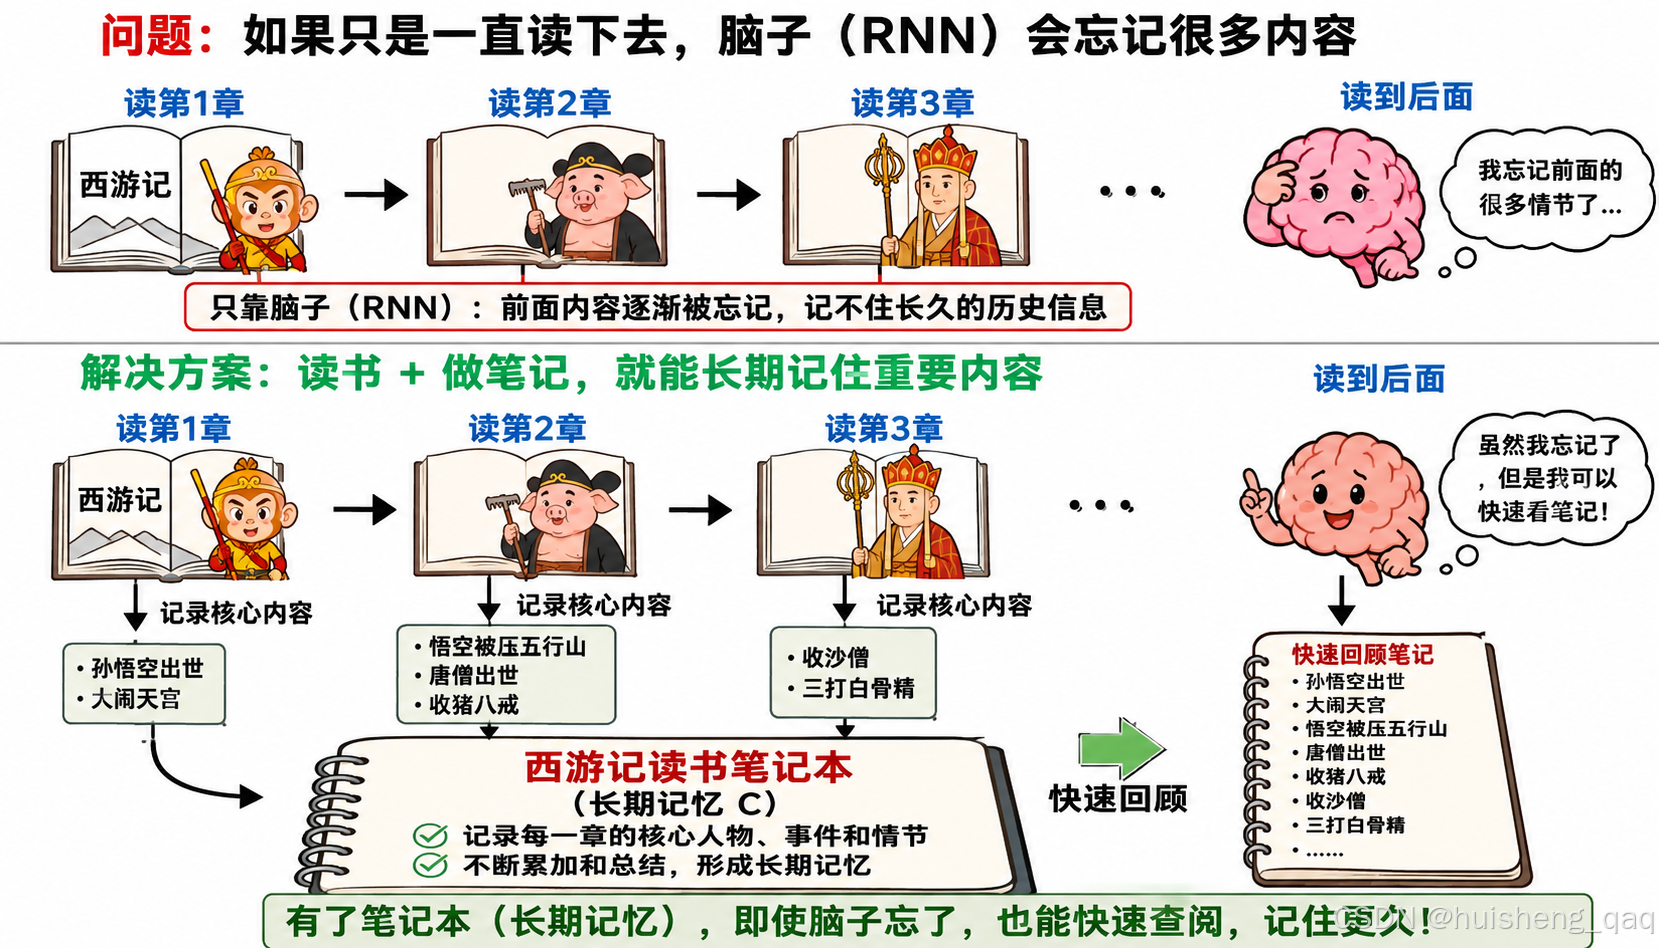
在讲解lstm之前,我们可以先来分析RNN循环神经网络记忆容易被丢失这个问题。依旧是用读西游记这本书,如果还是一直读下去,肯定是会忘记很多东西的,甚至前面的都会忘记;这里我们是不是可以每读一章节,就将这一章节的核心人物、情节全部接在一个笔记本上,主要记一些真正重要的任务、事件和情节,然后边读边记,读到后面如果我有什么情节虽然我脑子(RNN)我忘记了,但是我可以快速看笔记,这样就能快速回顾。
2.2. LSTM核心组件
ok看到了上面这个例子,其实这个lstm就是这样设计的,我脑子里记不住某些重要的东西我还不能做笔记?所以在lstm中,引入了下面五个核心的组件:cell笔记本、输入门、输出门、遗忘门和候选记忆这五个组件。cell是用于当做存储的笔记本,输入门、输出门和遗忘门是用于更好的管理这个笔记本。
- cell笔记本:就是我们上面说的笔记本,他会不断的累加和总结在这个笔记本中,同时每一步在累加的时候也会不断的微调,主要利用下面三个门实现
- 输入门:就是这一章节总结了哪些重要的故事情节、人物等,可以写入到笔记本里面,结合x参数和h-1记忆先更新笔记本C,这样笔记本里会有最新的内容
- 输出门:需要从笔记本中拿出多少记忆来理解当前章节。输出门在输入门之后,输入门拿到最新数据C后,就可以从有很多记忆C中选出对应的记忆来理解获取h隐藏记忆。
- 遗忘门:就是本子空间有限,如果确定了一些不在那么重要的记忆,那么就会降低这些记忆的权重、逐渐遗忘。
- 候选记忆:这个也比较好理解,就是我读了一个新章节,总结了信息重要的故事情节,待加入到这个cell笔记本中。
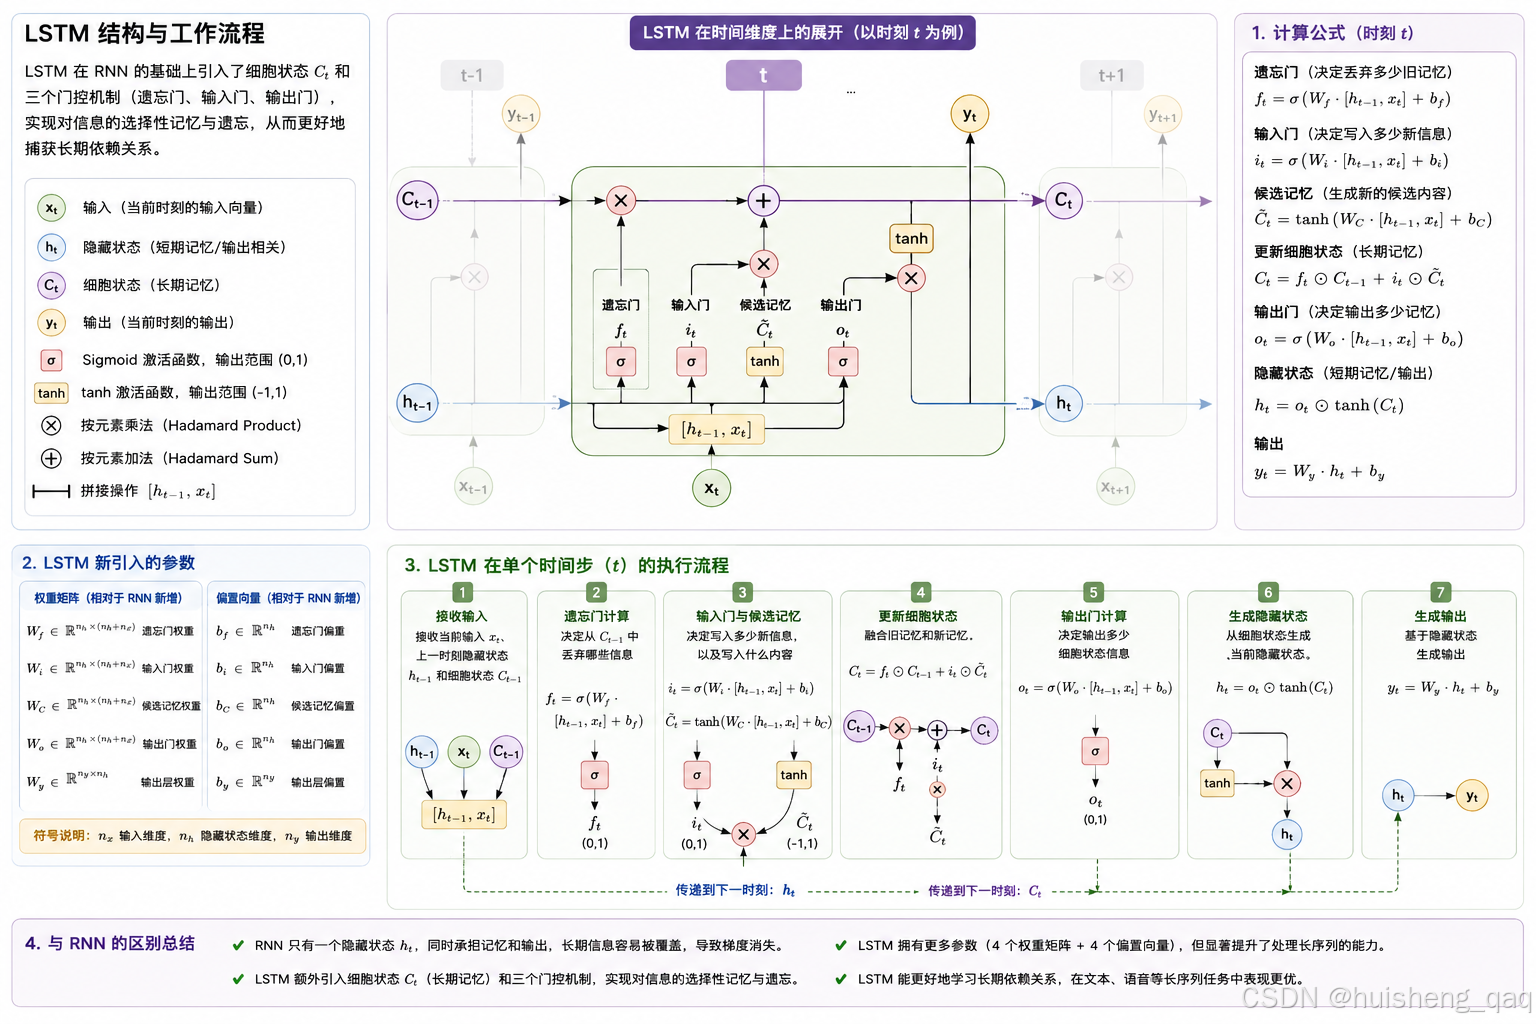
通过cell更加长期的记忆,解决rnn短期记忆以及记忆被覆盖的问题,让lstm在rnn的基础上拥有更长时间的记忆。就像一场会议,如果没有记事本,那么大脑中很多前面讨论的知识都可能忘记,但是如果有了记事本,那么就能将核心纲要等全部记录下来,完了也能通过这个记事本进行回忆。rnn就是纯靠脑子记,能记多少记多少;lstm就是给一个笔记本,他可以保留长期重要的核心信息。
光有笔记本肯定是不够,因为毕竟容量有限,肯定得好好的操作里面的内容,比如一些前期可能没那么重要的记忆可以去掉,保留更加更新一些记忆。有点类似于缓存的淘汰策略,但是lstm不会直接就把记忆给删掉,而是降级处理。通过引入遗忘门、输入门和输出门三个门协调合作,从而将整个效率最大化。
| 门 | 作用 | 类比 |
|---|---|---|
| 遗忘门(Forget Gate) | 决定笔记本上哪些旧内容该划掉 | "这条已经过时了,删掉" |
| 输入门(Input Gate) | 决定当前哪些新信息该写进笔记本 | "这条很重要,记下来" |
| 输出门(Output Gate) | 决定当前要从笔记本里读出哪些内容 | "现在需要用到这条,拿出来" |
3. LSTM 核心工作流程
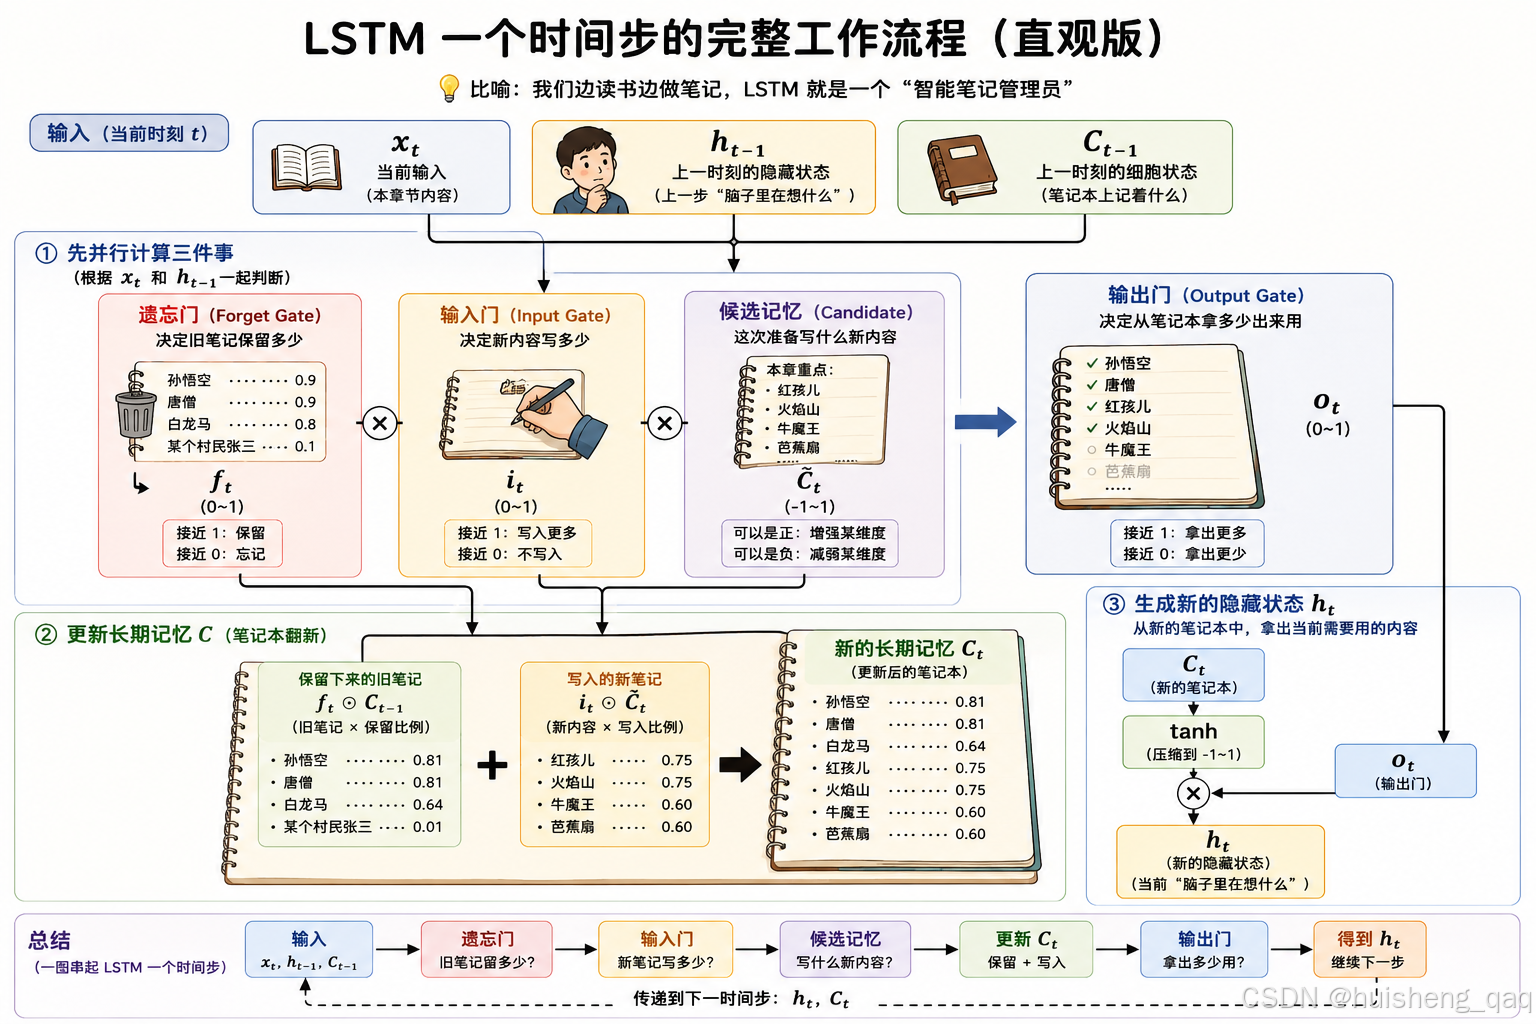
好,现在我们来拆解 LSTM 内部到底在干什么,讲解里面每一个组件如何相互合作实现整个工作流,其大致核心流程如下:
-
首先会携带上一步获取的ht-1的隐藏状态(短期记忆)和ct-1笔记本笔记(长期记忆),并结合当前输入参数xt一起作为整个下一把的输入参数
-
接下来就是多门合作,分别是遗忘门、输入门和候选记忆直接协调合作操作和更新这个c长期记忆。以下三步是并行执行的
- 操作遗忘门,就是决定忘记某些东西,因为空间就这么大,肯定是需要先解决遗忘一些相对没那么重要的
- 操作输入门,根据这个xt输入的新东西决定写入多少内容
- 操作候选记忆,根据这次xt输入的内容总结出本次重点,可以候选哪些内容
-
最终就是拿到上面更新后的长期记忆ct,再操作这个输出门,再去生成最新的隐藏记忆ht。
3.1 遗忘门-决定旧记忆保留多少
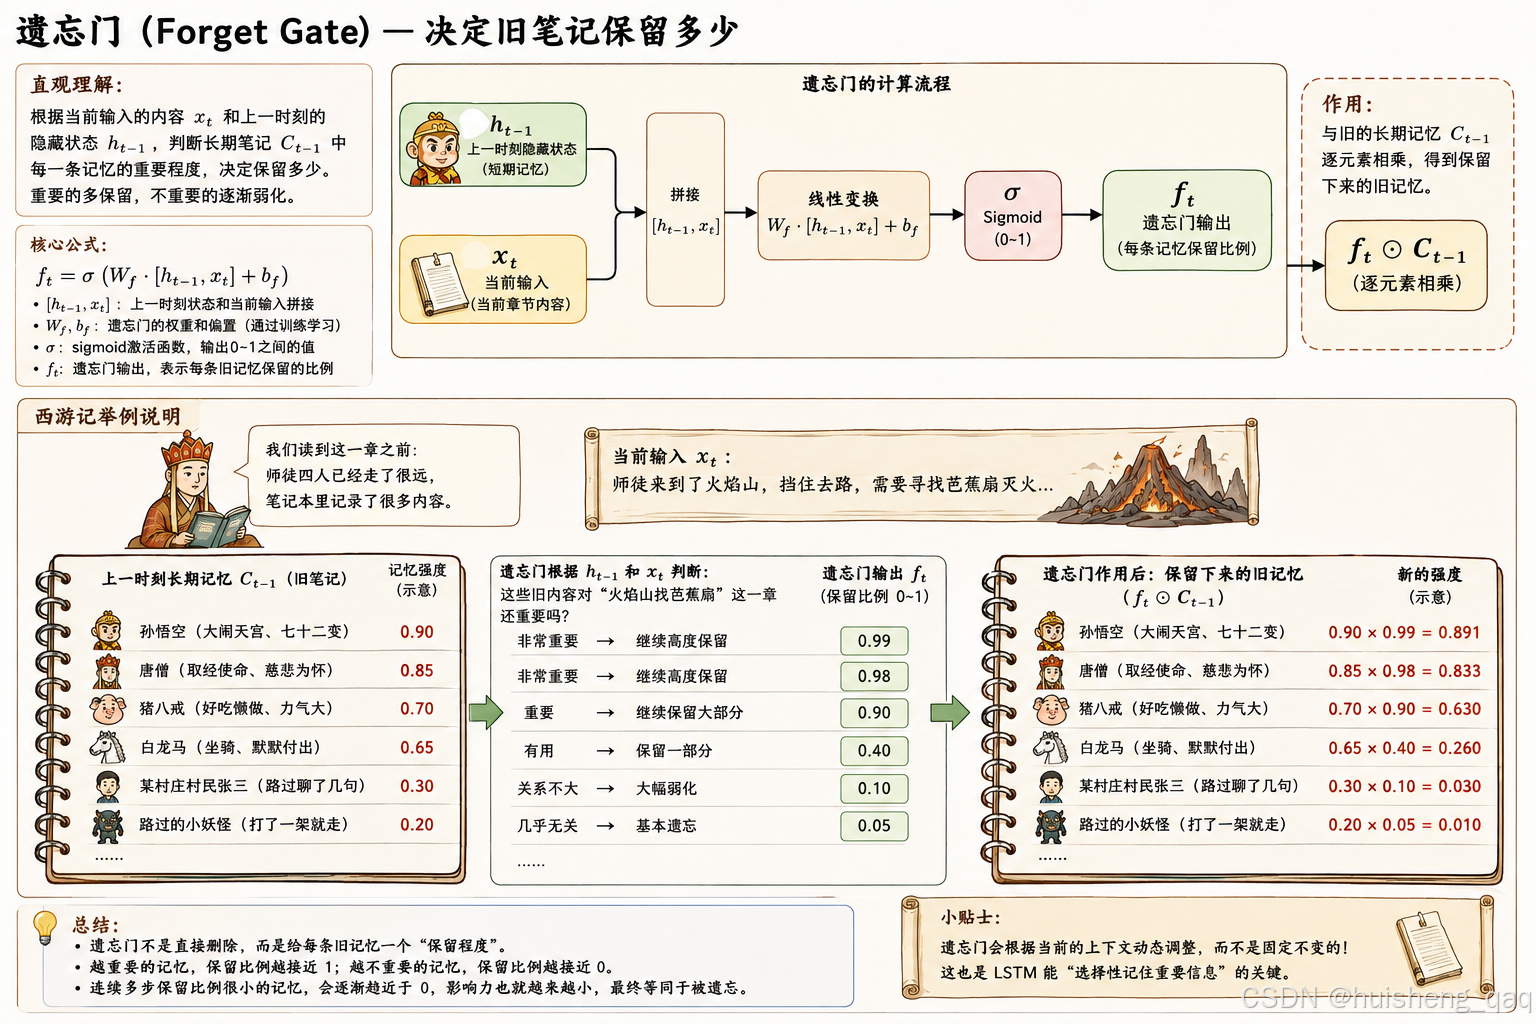
通俗的理解就是每一条记忆在c长期记忆中的重要的程度,一般就是介于0和1之间的比例,接近于1的说明重要,接近于0的说明没那么重要,当趋近于0时,这条数据就会被遗忘甚至被删除。因为每条数据都是以向量的形式存储,所以这里一般只是会趋近于0。
其核心公式如下,这里的公式了解一下即可。可以看出来其实和rnn很像,都是有输入参数、权重和激活函数,只是内部的算法变得更复杂了一些,但是思想还是不变的,都是通过大量的样本和反向传播来在什么情况下保留哪些历史信息。旧的长期记忆 × 遗忘门给出的保留比例,才能真正得到旧记忆中被保留下来的部分。
f t = σ ( W f ⋅ h t − 1 , x t + b f ) f_t = \sigma(W_f \cdot h_{t-1}, x_t + b_f) ft=σ(Wf⋅ht−1,xt+bf)
所以说其实遗忘门也很简单,就是继续以西游记为例,越重要的任务会在这个c长期记忆中得到分值越高,说明越重要。比如西游记里面的孙悟空、唐僧、猪八戒、沙和尚师徒四人的权重肯定是很高的;但是比如每个故事情节的妖怪,在某一个章节可能会高一点,但是在后续也会最终被稀释;比如一些村庄的村民,只有1-2个故事情节,那么最终的打分肯定是会很低的。如下图所示,孙悟空在火焰山情节依旧能拿一个不错的分数,因为这个章节的相关性也高,但是可能前面的一个路过的小妖怪可能就只有一个小镜头甚至可能镜头都没有,那么其分数就会更低甚至接近于0
3.2 输入门-哪些新信息值得记录
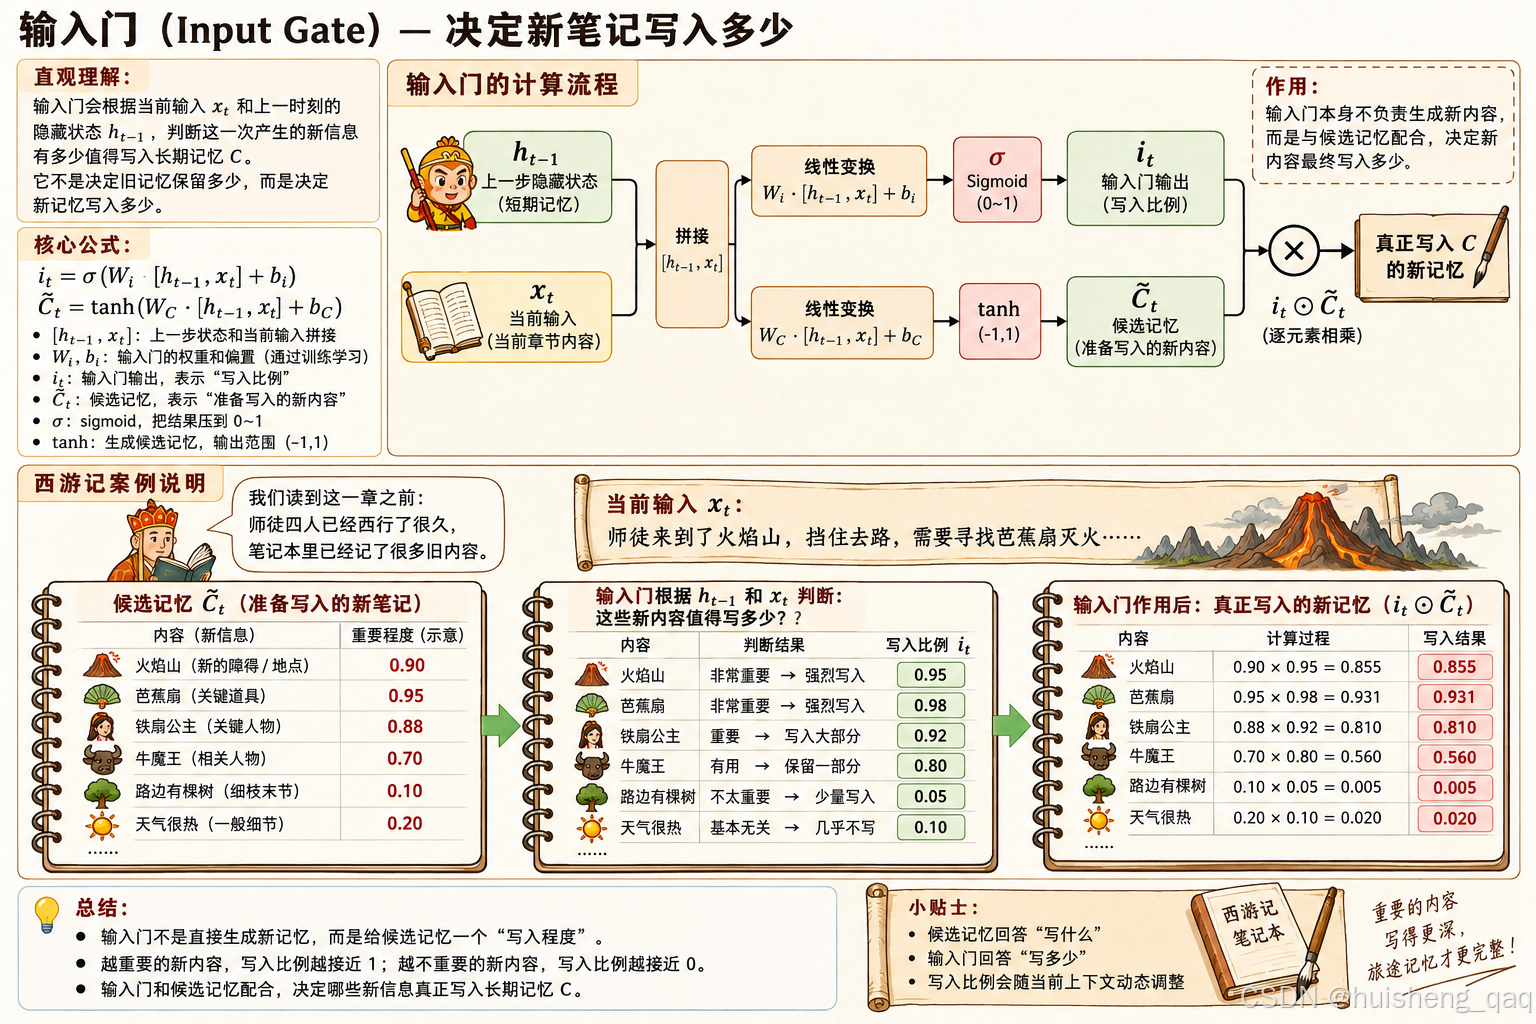
输入门通俗的话说就是这次多少内容值得写到c长期记忆中,遗忘门是用来删除一些旧的东西,而输入门就是用来加一些新的东西,和上面的一样是基于比例来判断内容的重要性。其核心公式如下,分值越高说明更重要
i t = σ ( W i ⋅ h t − 1 , x t + b i ) i_t = \sigma(W_i \cdot h_{t-1}, x_t + b_i) it=σ(Wi⋅ht−1,xt+bi)
一般输入门会和候选记忆配合使用,二者配合后的结果,最终决定这部分候选记忆以多大的比例写入长期记忆 C 中 。。其核心公式如下:候选记忆比较特殊,tanh 的输出范围是 -1 到 1,意味着新信息可以是"增强"某个维度,也可以是"减弱"某个维度。
C ~ t = tanh ( W C ⋅ h t − 1 , x t + b C ) \tilde{C}_t = \tanh(W_C \cdot h_{t-1}, x_t + b_C) C~t=tanh(WC⋅ht−1,xt+bC)
在一定程度上,我们可以将候选记忆比作是一个产品经理,将所有的需要做的产品规划好,而输入门更高是一个技术经理,将全部的产品进行一个打分,给一个权重,判断产品执行优先级。二者必须相互结合使用,给一个合理的值,最终将数据写入到新记忆c中。如下面的火焰山剧情中,:火焰山、芭蕉扇、铁扇公主和牛魔王都是相关人物、所以给的分会比较高,而其他的相对来说会比较低,最终给一个的打分写入到长期记忆c中。
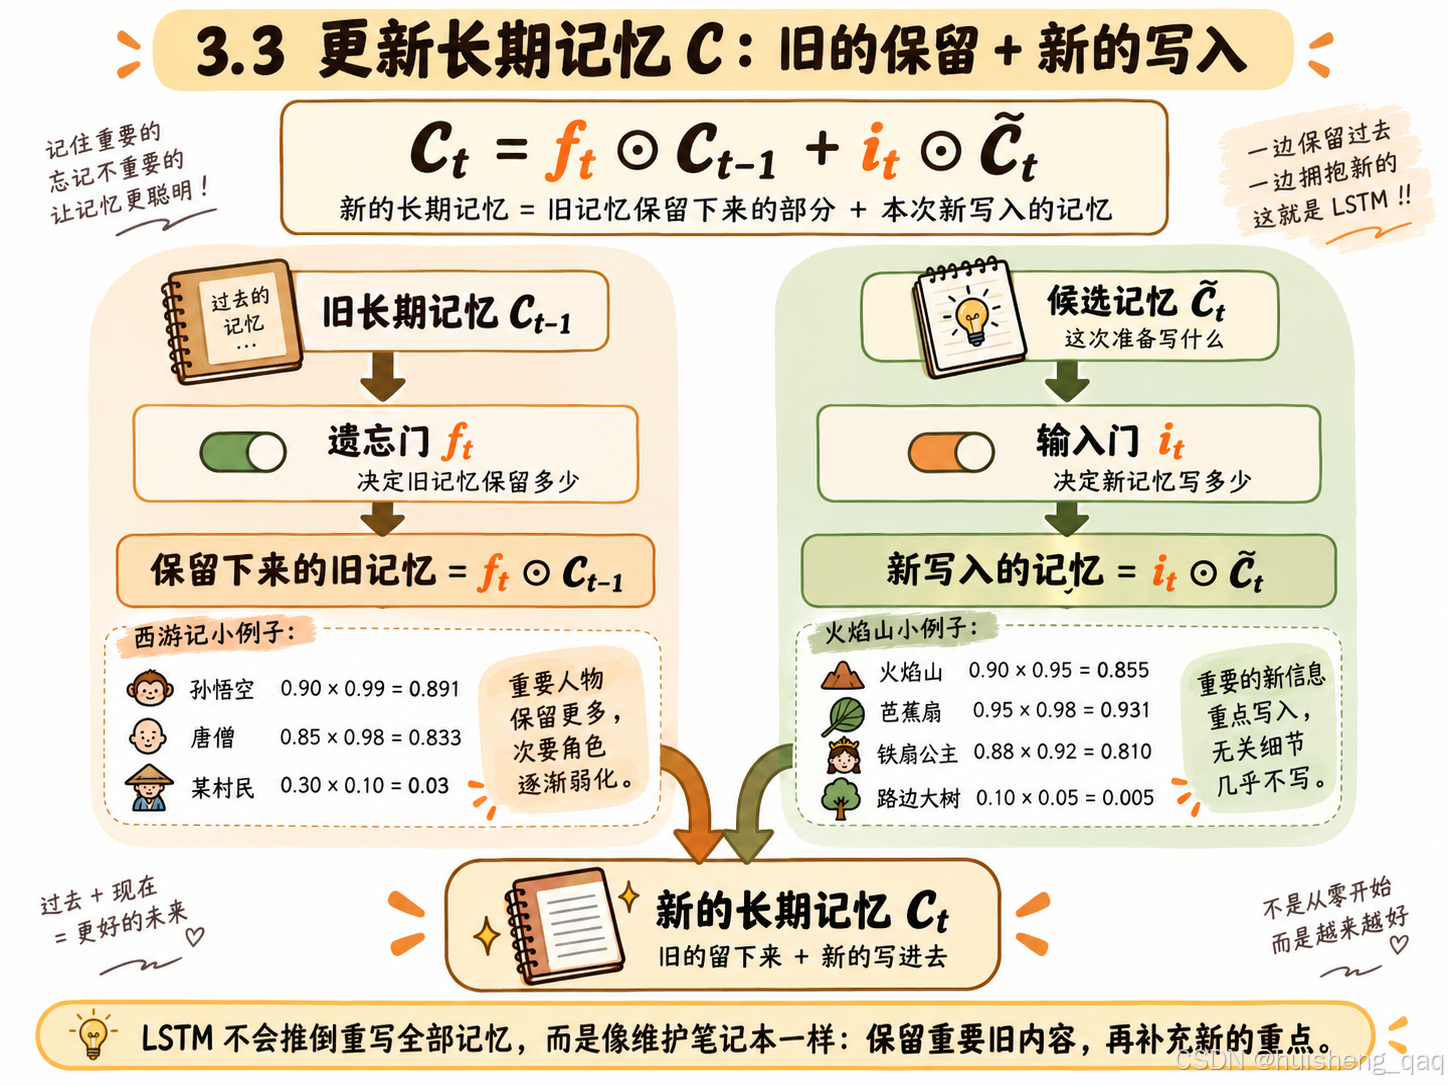
3.3 更新长期记忆 C
这一步相对来说就是比较简单,主要是针对前面两步的一个汇总,就是将旧记忆保留的部分ct-1+刚刚候选记忆*输入门的的累积一起当入到这个c长期记忆中。
C t = f t ⊙ C t − 1 + i t ⊙ C ~ t C_t = f_t \odot C_{t-1} + i_t \odot \tilde{C}_t Ct=ft⊙Ct−1+it⊙C~t
通过上面两步也可以知道信息是被随机的隐藏和随机的保留,二者相对比较重要的内容进行一个汇总,最终将记忆写入到c中
3.4 输出门-暴露哪些信息给h使用
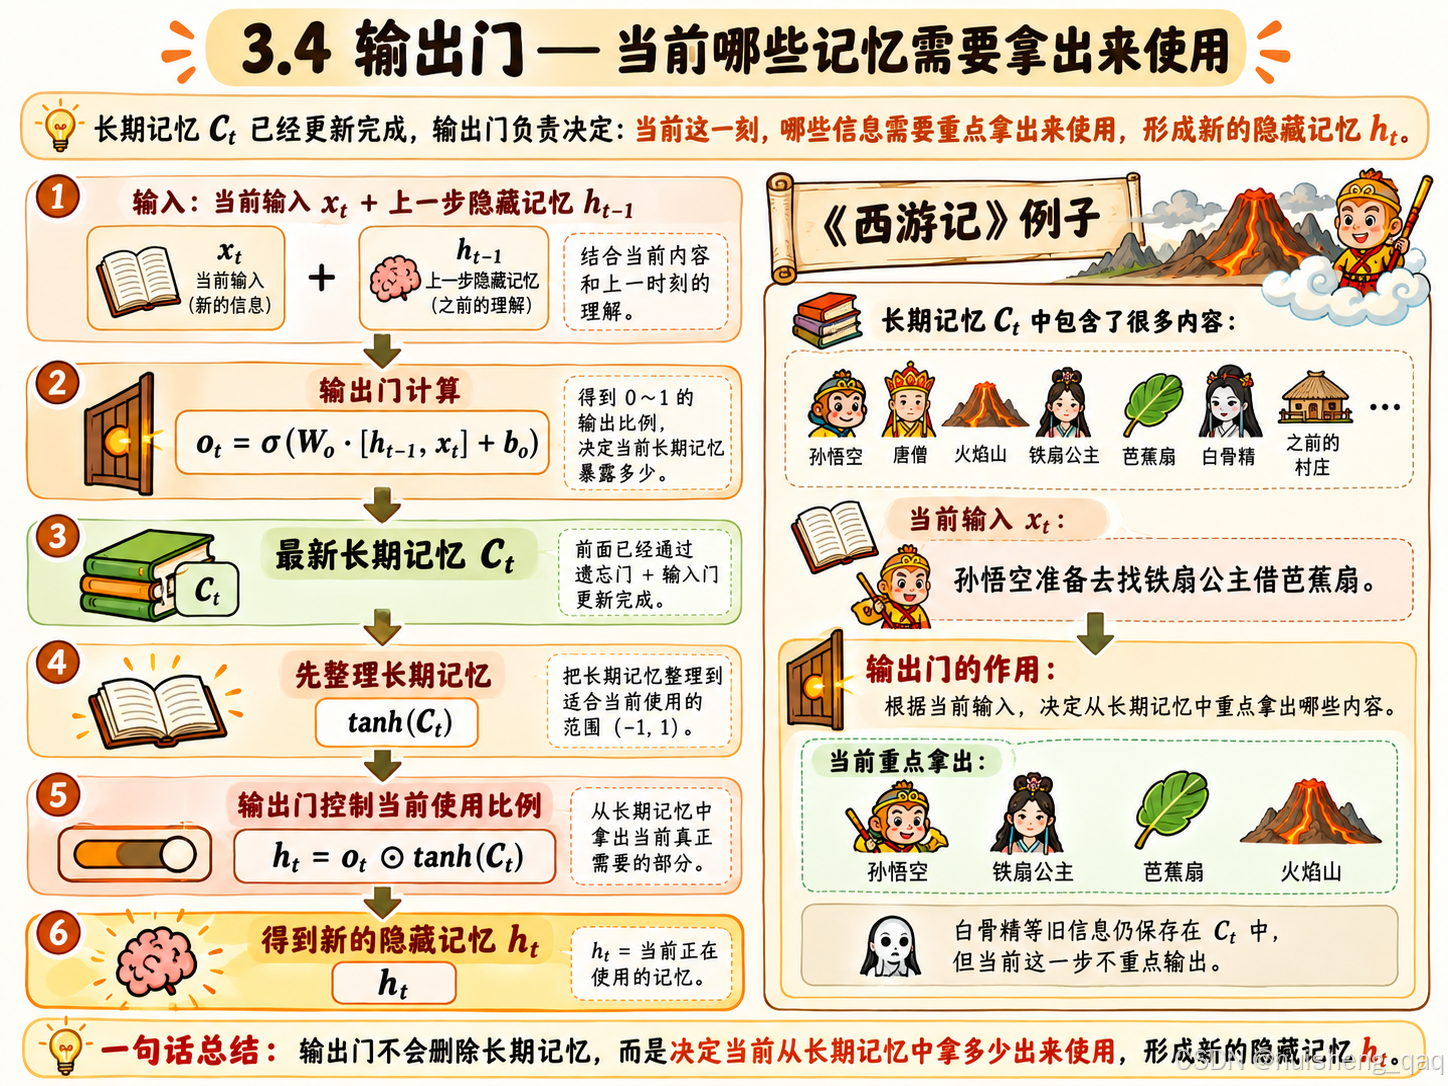
经历了前面三步,此时我们的长期记忆c已经获取到了最新的内容,接下来就是执行我们的第四步-输出门,上文也说了这个长期记忆更像是一个笔记本,而笔记本的记忆就是在大脑(短期记忆/隐藏记忆)需要使用的时候拿出来用了,因此就有了我们的第四步,会根据这个输入参数来判断需要拿出哪些内容来使用。
其对应的公式如下,其核心流程就是:前需要用到笔记本的哪些部分,然后从笔记本里取出对应内容,作为当前的输出 。这个输出门并不是隐藏记忆h,而是给隐藏记忆使用需要暴露的内容,更像是给隐藏记忆h配置的一个笔记顾问,隐藏记忆的劣势上面页提过,所以lstm基于这个机制对RNN进行了一个优化。
x 1 C t = f t ⊙ C t − 1 + i t ⊙ C ~ t x1C_t = f_t \odot C_{t-1} + i_t \odot \tilde{C}_t x1Ct=ft⊙Ct−1+it⊙C~t
h_t = o_t \odot \tanh(C_t)
依旧拿我们的西游记钟的火焰山来举个例子,此时更新后的c中已经记了很多内容,如下
孙悟空、唐僧、西天取经、白骨精、火焰山、铁扇公主、芭蕉扇、牛魔王、......
然后孙悟空准备去找铁扇公主借芭蕉扇。此时识别出的输入们需要和不需要如下,其实也是基于权重来判断是否需要还是不需要,权重接近于1的会被重点使用,接近于0的基本就是不需要,趋近于1的就会被输出门输出,内容会被暴露给隐藏记忆h使用
权重高:孙悟空、铁扇公主、芭蕉扇、火焰山
权重低:白骨精、以前经过的村庄、之前遇到的小妖怪
隐藏记忆ht-1也会利用这个输出门的信息内容,将形成整个链路最新的ht,从而完成整个步骤流程。
至此,当前时刻最新的长期记忆ct 和隐藏状态 ht都已经计算完成。二者会继续传递到下一个时间步给下一个流程使用
3.5 输出参数yt(不属于lstm的结构门)
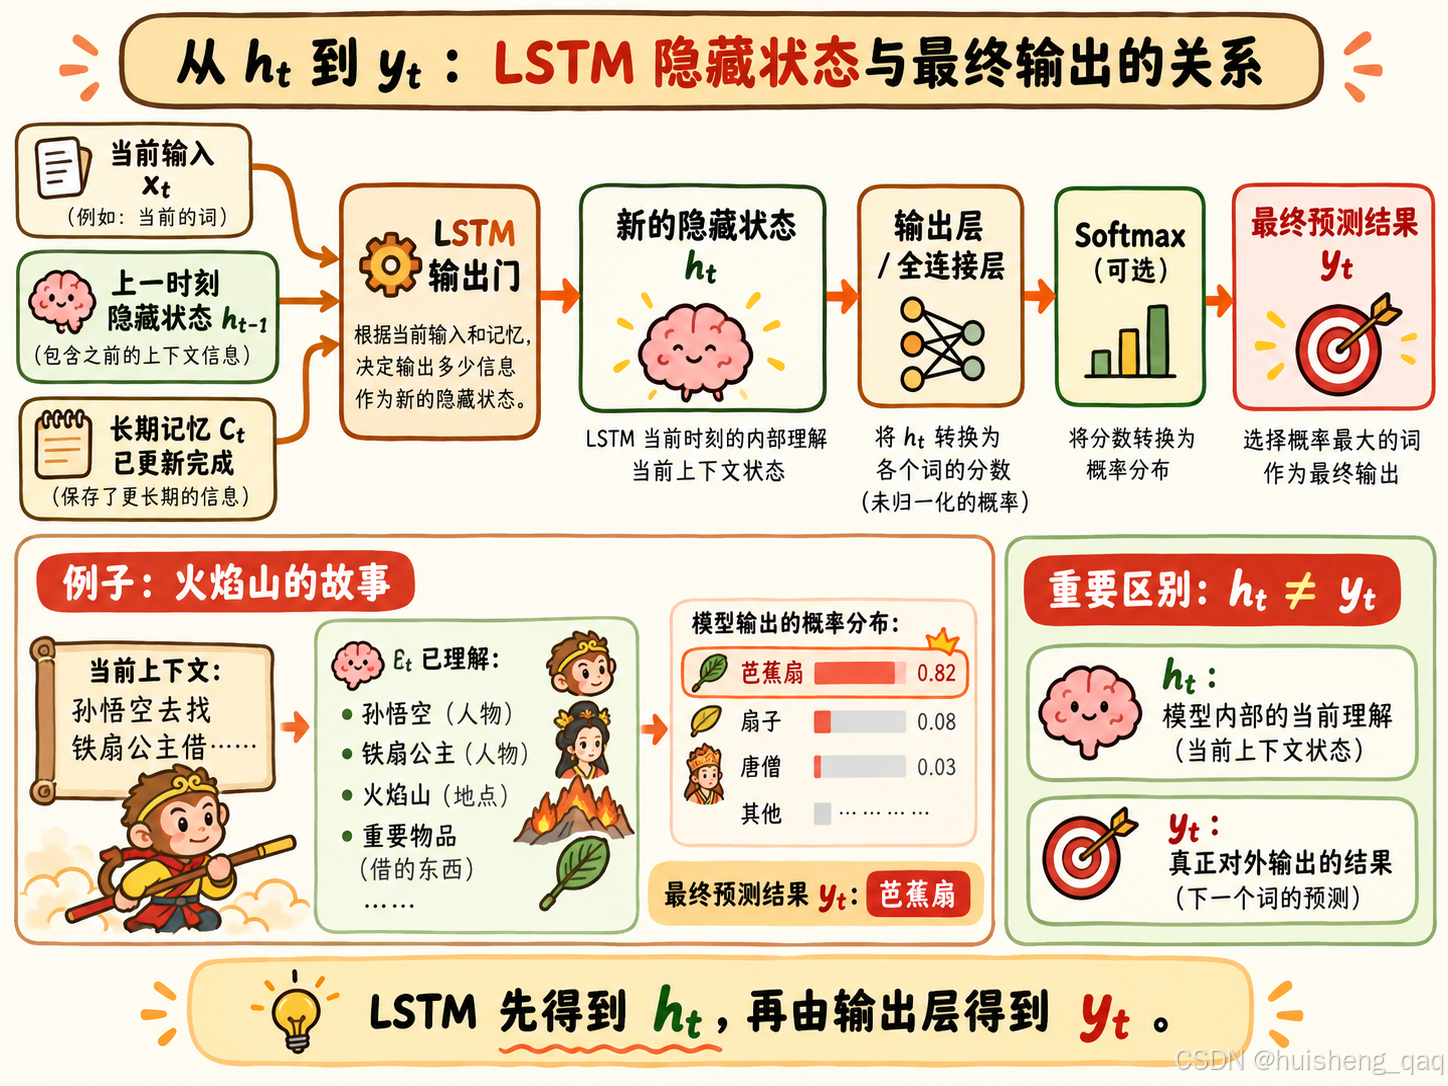
经过前面的四个步骤,我们已经得到了当前时刻最新的长期记忆ct和隐藏状态ht。此时就来到了最重要的一环节输出参数,说白了就是前面一系列就是提前训练或者被问时需要准备的东西,而这个输出参数就是用户在提问,输入这个xt参数后,经过几个门的处理,再经过额外的输出层处理后所返回的一个结果yt。
ht只能是隐藏记忆对当前的上下文的理解和概括,而回答当前问题还是得结果输出层的一个加工和总结,针对具体的xt来对外输出一个结果yt,就是预测输出的下一个结果。其简单的公式如下
y t = W y h t + b y yt=Wyht+by yt=Wyht+by
输出层并不属于 LSTM 内部几个门结构的一部分,而是根据具体任务额外接在 LSTM 后面的预测层。 比如此时外部参数提问:
孙悟空去找铁扇公主借什么?
那么会根据这个隐藏记忆ht来判断需要怎么回复,此时隐藏记忆会针对于这个提问来对已有的内容进行一个概率计算,其内部本质就是一个预测,通过最终的预算分布,获取一个最高的概率,其内部的打分可能如下:
4. LSTM案例连贯输出
上面主要是讲解lstm的底层原理,接下来用一个连贯的具体案例来讲解整个lstm的整个核心流程,依旧是使用这个孙悟空到火焰山借芭蕉扇的这个案例,其故事背景如下
孙悟空师徒来到火焰山,得知必须借到芭蕉扇才能继续西行,于是孙悟空准备去找铁扇公主借芭蕉扇。
1、此时的长期记忆ct-1的内容如下,就是一个小本本,里面记录了一些核心章节
唐僧师徒正在西天取经孙悟空负责保护唐僧 猪八戒、沙和尚属于取经团队、长期目标是到达西天 孙悟空拥有很强的战斗能力、以前经历过白骨精等剧情、以前经过的村庄、以前经过的村庄 等等......
此时的的ht-1的内容如下,其本质就是当前大脑里记忆的东西,会比较有限,比如刚好就是这一页的内容
当前人物还是唐僧师徒、当前任务仍然是继续西行、最近天气越来越炎热 、方可能会出现新的问题
2、接下来当前输入参数 x_t 就是即将进入的新一难---火焰山章节。
师徒四人来到了火焰山
3、接下来就是使用到遗忘门,对于新章节哪一些是可以遗忘的,先统计出来,后续会依旧权重分进行遗忘或者降低在长期记忆中的权重
西天取经、孙悟空、唐僧→保留很多
以前某个村庄→大幅弱化
白骨精剧情→当前影响开始弱化
某个路人→几乎没有影响
4、候选记忆如下,会将当前章节的核心点记忆
火焰山 当前遇到了新的地点 道路可能受到阻碍 天气非常炎热
5、输入参数会根据候选记忆的点进行一个打分,哪些点的分高哪些低。上面也说过这个候选记忆就是产品经理,列出要做的点;而输入参数就是一个技术经理,对这些列出来的点进行一个打分,判断哪些点的分高哪些低,高的可以写入
火焰山 → 写入很多
无法继续前进 → 写入很多
天气炎热 → 写入一些
路边石头 → 基本不写
6、此时的长期记忆会根据上面要写的内容进行一个更新,将重要的数据加入到这个长期记忆c中
西天取经 孙悟空 唐僧 当前来到了火焰山 火焰山阻挡继续前进 必须想办法解决火焰山的问题
7、随后又读取到:土地告诉孙悟空,只有铁扇公主的芭蕉扇才能扇灭火焰山的大火,那么又会执行上面的流程,从遗忘门-》候选记忆+输入参数--》更新长期记忆c-》输出门-》更新短期记忆h,其本质就是一个循环神经网络
8、接下来来一个输入参数xt,就是外部来问一个问题
孙悟空去找铁扇公主借什么?
9、 当前问题 xt 经过 LSTM 的门控处理后,会得到当前最新的长期记忆ct和隐藏状态ht。随后再将ht交给额外的输出层进行概率预测,概率最高的是"芭蕉扇",因此当前预测结果 yty_t 就是"芭蕉扇"
芭蕉扇=0.82
扇子=0.08
武器=0.03
唐僧=0.01
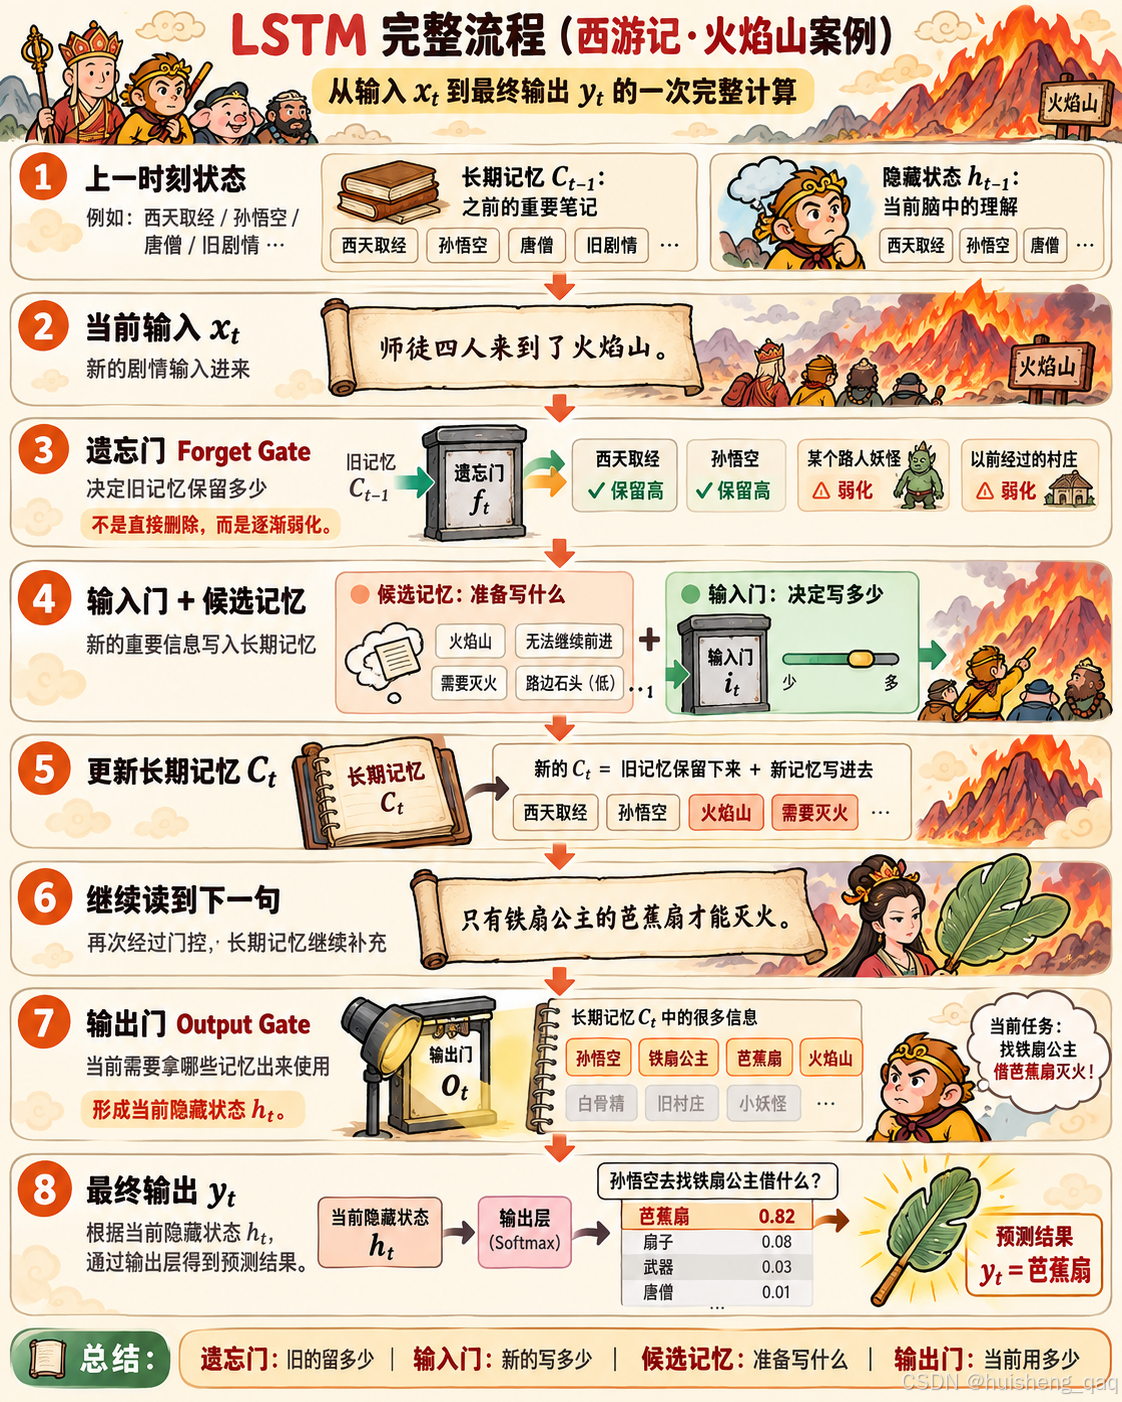
其总结如下:带着上一轮的长期记忆 Ct−1C_{t-1} 和隐藏状态 ht−1h_{t-1},读取新的输入 xtx_t,通过遗忘门决定旧的留多少,通过候选记忆和输入门决定新的写什么、写多少,形成新的长期记忆 CtC_t,再通过输出门生成当前隐藏状态 hth_t,如果具体任务需要预测结果,再通过额外输出层得到 yty_t 。
5. LSTM的价值和局限
5.1 RNN vs LSTM
接下来对两个循环神经网络就先一个对比,其详细的对比数据如下面这个列表,RNN的痛点在上面也说过,就是记忆容易被丢失和梯度为0或者梯度爆炸 ,而LSTM引入了一个长期记忆c来维护部分核心记忆,从而增加返回数据的可靠性,增加了记忆,是的长距离更有优势。劣势也明显,就是需要增加参数量和计算的复杂度,其结构也相对的更加复杂。
| 对比维度 | RNN | LSTM |
|---|---|---|
| 记忆状态 | 主要依赖隐藏状态 hh | 同时维护 hh 和长期记忆 CC |
| 历史信息 | 不断压缩进新的 hh | 通过 CC 单独维护长期信息 |
| 信息管理 | 缺少显式控制机制 | 遗忘门、输入门、输出门主动控制 |
| 长距离依赖 | 较弱 | 明显更强 |
| 梯度传播 | 长序列中容易消失或爆炸 | 通过 CC 的更新路径缓解梯度消失 |
| 参数量 | 较少 | 明显更多 |
| 计算复杂度 | 较低 | 较高 |
| 时间维度并行 | 不支持 | 同样不支持 |
| 结构 | 简单 | 更复杂 |
5.2 LSTM 缓解梯度消失
在上文说过,RNN肯能会因为权重小于1不断相乘的问题导致这个梯度会趋近于0,而lstm会因为数据在c长期记忆的缘故从而缓解这个问题,其核心公式如下,主要是通过累加的方式实现,而这个ft就是遗忘门的权重,如果越低则容易被遗忘。
C t = f t ⊙ C t − 1 + i t ⊙ C t Ct=ft⊙Ct−1+it⊙C~t Ct=ft⊙Ct−1+it⊙C t
如果模型在训练过程中学习到某段记忆比较重要,那么遗忘门 ftf_t 可能会输出接近 1 的值,比如 0.99,从而让这部分历史信息尽可能保留下来。比如0.99等,让机器自己学会某段记忆是比较重要的,比如菩提祖师这些略核心人物, 当然这只能缓解,如果长期经过很多时间步,并且遗忘门持续小于 1,那么历史信息仍然可能逐渐衰减。主要是通过这种"加法式更新 + 门控"的结构,缓解梯度消失问题。
5.3 LSTM 的实际应用场景
比如一些核心的自然语言:文本分类、情感分析、机器翻译、命名实体识别、文本生成 等都是可以应用的一些场景,话句话说: 只要数据存在比较明显的时间顺序或者前后依赖关系,LSTM 就曾经是非常常见的一种建模方案。 例如下面的这些应用场景,其本质就是前面的状态,会影响后面的判断。
用户行为记录
系统监控指标
设备运行状态
日志序列
调用序列
文本
语音
5.4 LSTM 的痛点
lstm本身就是一个在rnn基础上的一个优化,其本身依旧有着多个痛点
- 结构更加复杂:内部包含遗忘门、输入门、候选记忆和输出门,因此参数更多、计算量更大,训练成本也更高。
- 本质上还是串行计算:后文的数据依旧得通过前文一步步训练的到
- 超长距离依赖依然困难 :LSTM 有了长期记忆C,但C 本身依然是一份固定维度的内部状态 ,说白了就是一个笔记本,其容量有限,因此也不能记住全部内容
- 远距离信息仍然需要一步一步传递:比如第1步想影响第100步,依旧需要经历中间的98步