文章目录
-
- 一、先用三个任务理解三种架构
- 二、Encoder-Only:双向阅读,适合理解
- 三、Decoder-Only:因果生成,适合续写和对话
- 四、Encoder-Decoder:先读输入,再生成输出
- 五、三种注意力方向对比
-
- [Encoder 双向 self-attention](#Encoder 双向 self-attention)
- [Decoder 因果 self-attention](#Decoder 因果 self-attention)
- Cross-attention
- [六、为什么现代大模型多用 Decoder-Only](#六、为什么现代大模型多用 Decoder-Only)
- [七、Prompt 如何统一任务](#七、Prompt 如何统一任务)
- 八、三种架构的工程选型
- [九、BERT、T5、GPT 的目标差异](#九、BERT、T5、GPT 的目标差异)
- [十、为什么 Encoder 模型仍然重要](#十、为什么 Encoder 模型仍然重要)
- 十一、架构和推理成本的关系
- 十二、常见误区
- 十三、你应该记住的最小对比
- 总结
- 大模型视角
- 下一篇
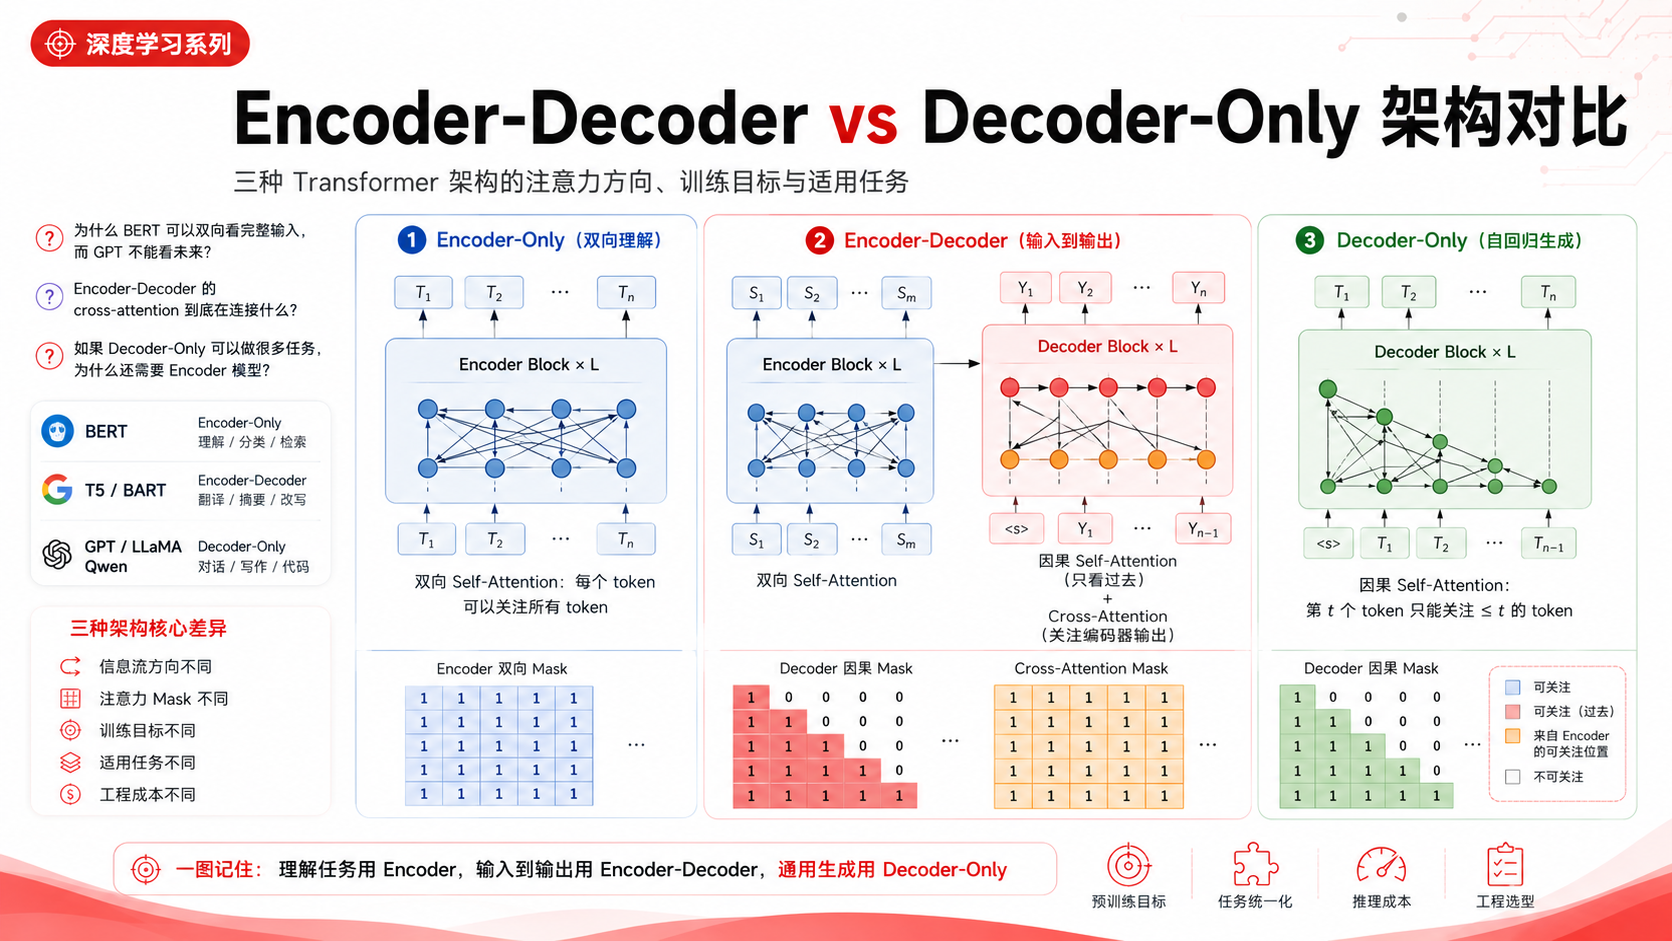
摘要:Transformer 不是只有一种形态。BERT 是 Encoder-Only,T5/BART 是 Encoder-Decoder,GPT/LLaMA/Qwen 是 Decoder-Only。三者差异不只是"模块名字不同",而是注意力方向、训练目标、输入输出组织方式和工程成本都不同。本文从任务直觉出发,解释 Encoder-Only 为什么适合理解,Encoder-Decoder 为什么适合序列到序列转换,Decoder-Only 为什么成为现代生成式大模型主流,并用 mask 和伪代码展示它们的关键区别。读完后,你应该能根据任务判断该选 embedding/理解模型、seq2seq 模型,还是通用生成模型。
前置知识 : Transformer 架构,多头注意力,位置编码
阅读时间 :约 60 分钟
代码环境:概念为主,少量 Python/PyTorch 风格伪代码
入门导读:先抓住主线
如果你第一次看到 Encoder、Decoder、Encoder-Decoder,不要先背结构图,先把它们放到任务里理解。
- Encoder-Only:先把整段输入读完,再做理解判断;
- Encoder-Decoder:先读一个序列,再生成另一个序列;
- Decoder-Only:从左到右不断生成下一个 token。
对应到常见模型:
text
BERT      -> Encoder-Only      -> 理解、分类、检索
T5/BART   -> Encoder-Decoder   -> 翻译、摘要、改写
GPT/LLaMA -> Decoder-Only      -> 对话、写作、代码、通用生成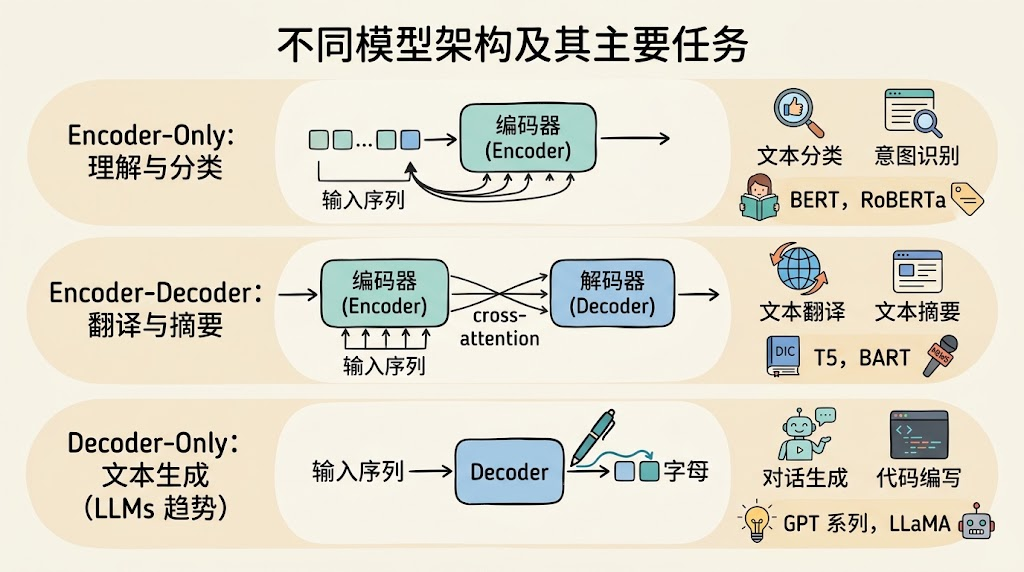
现代大模型偏向 Decoder-Only,不是因为其他架构没价值,而是因为 next token prediction 可以把大量任务统一成"给定上下文,继续生成"。这种统一目标非常适合互联网规模文本预训练、指令微调和产品交互。
读完先达到这个程度就够了:
- 能解释 Encoder-Only、Encoder-Decoder、Decoder-Only 的核心区别;
- 能理解双向注意力、因果注意力、交叉注意力分别是什么;
- 能知道 BERT 为什么适合理解但不适合直接续写;
- 能知道 T5/BART 为什么适合输入到输出的转换任务;
- 能解释 GPT 类模型为什么能统一对话、翻译、分类和代码生成;
- 能在工程选型时做基本判断。
带着这 3 个问题读:
- 为什么 BERT 可以双向看完整输入,而 GPT 不能看未来?
- Encoder-Decoder 的 cross-attention 到底在连接什么?
- 如果 Decoder-Only 可以做很多任务,为什么还需要 Encoder 模型?
一、先用三个任务理解三种架构
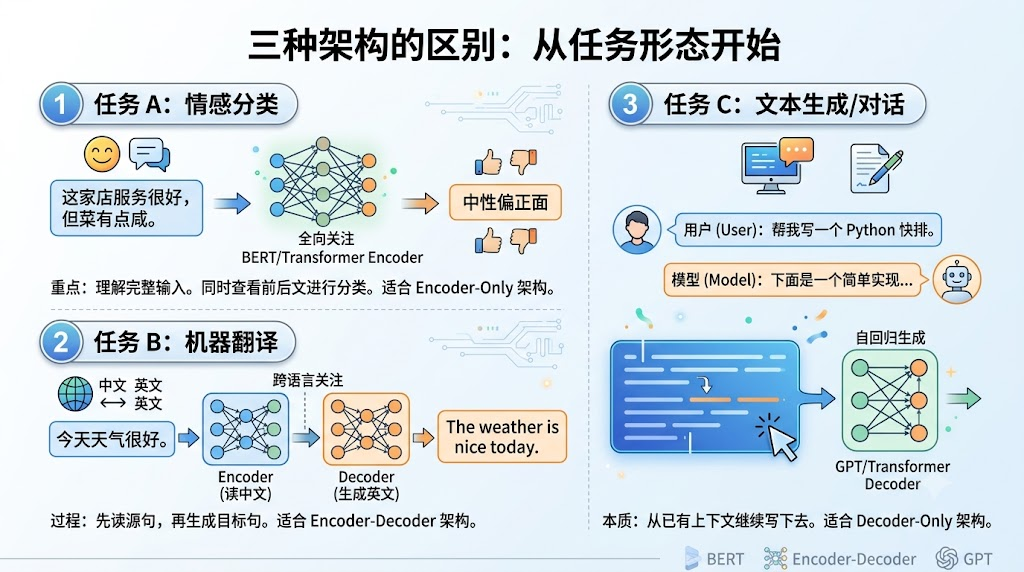
假设我们有三个任务。
任务 A:判断一句话情感是正面还是负面。
text
输入:这家店服务很好,但菜有点咸。
输出:中性偏正面
这个任务的重点是理解完整输入。模型最好能同时看前后文,再给出分类结果。Encoder-Only 很适合。
任务 B:把中文翻译成英文。
text
输入:今天天气很好。
输出:The weather is nice today.
这个任务需要先读完整源句,再生成目标句。Encoder-Decoder 很自然:Encoder 读中文,Decoder 生成英文。
任务 C:和用户对话并继续生成。
text
用户:帮我写一个 Python 快排。
模型:下面是一个简单实现...
这个任务本质上是从已有上下文继续写下去。Decoder-Only 很适合。
三种架构的区别,先从任务形态开始理解,比从结构图开始更容易。
二、Encoder-Only:双向阅读,适合理解
Encoder-Only 模型的代表是 BERT。
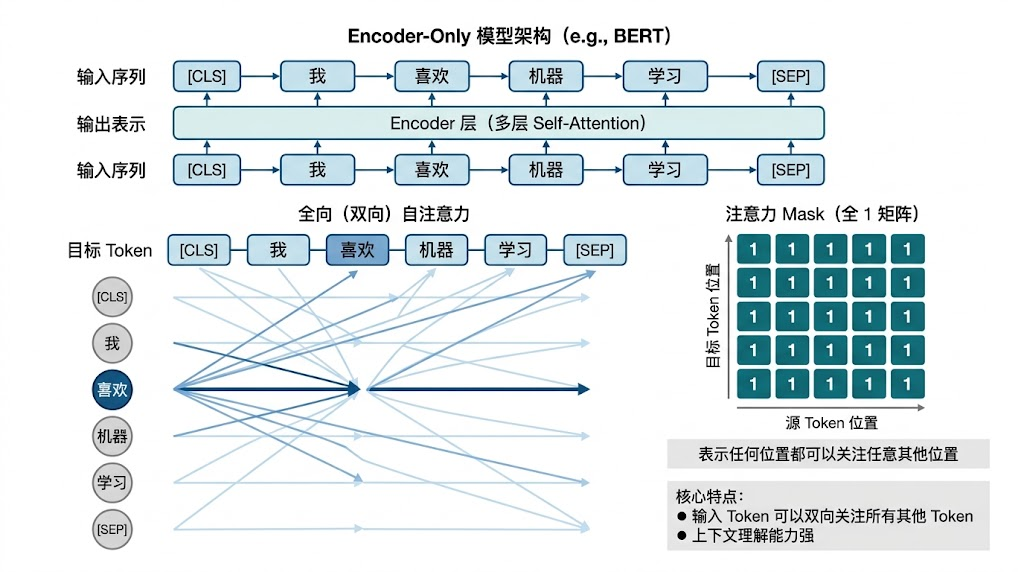
它的核心特点是:输入序列中的每个 token 可以双向关注所有 token。
如果输入是:
text
[CLS] 我 喜欢 机器 学习 [SEP]那么"喜欢"可以看左边的"我",也可以看右边的"机器学习"。
注意力 mask 可以近似理解成全 1:
text
1 1 1 1 1
1 1 1 1 1
1 1 1 1 1
1 1 1 1 1
1 1 1 1 1
这种双向上下文非常适合理解任务:
- 文本分类;
- 情感分析;
- 命名实体识别;
- 语义匹配;
- 检索 embedding;
- 重排序 reranking;
- 阅读理解中的答案抽取。
Encoder-Only 的典型使用方式是:把整段文本输入模型,取 [CLS] 或池化后的表示,再接一个任务头。
python
# 伪代码:Encoder-Only 分类
hidden = encoder(input_ids, attention_mask)
cls_hidden = hidden[:, 0, :]
logits = classifier(cls_hidden)
它的优势是理解完整输入。它的限制是:它不是天然从左到右生成的语言模型。BERT 可以做 masked token prediction,但不适合像 GPT 那样一个 token 一个 token 地续写长文本。
三、Decoder-Only:因果生成,适合续写和对话
Decoder-Only 模型的代表是 GPT、LLaMA、Qwen 等。
它的核心特点是:第 t 个 token 只能看自己和之前的 token,不能看未来。
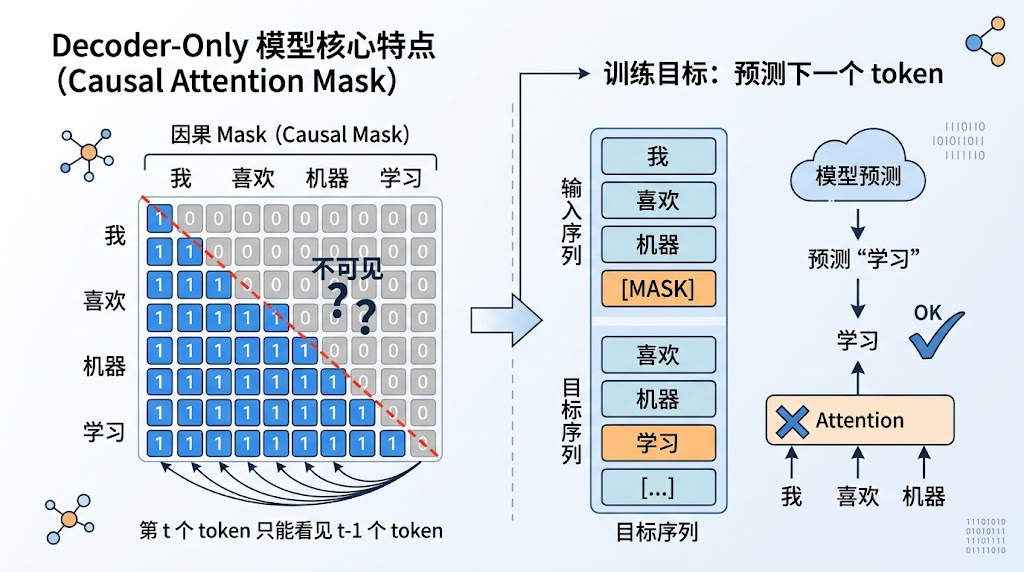
因果 mask 形状如下:
text
1 0 0 0 0
1 1 0 0 0
1 1 1 0 0
1 1 1 1 0
1 1 1 1 1
这个约束对应训练目标:预测下一个 token。
text
输入:我 喜欢 机器
目标:喜欢 机器 学习
模型看到"我 喜欢 机器"时,要预测下一个 token "学习"。
伪代码:
python
# 伪代码:Decoder-Only 语言模型
hidden = decoder(input_ids, causal_mask)
logits = lm_head(hidden)
loss = cross_entropy(logits[:, :-1], input_ids[:, 1:])
Decoder-Only 的强大之处在于任务统一。很多任务都可以写成 prompt 到 completion:
| 任务 | Prompt | Completion |
|---|---|---|
| 翻译 | 把这句话翻译成英文:今天天气很好。 | The weather is nice today. |
| 分类 | 判断情感:这家店很好。答案只输出正面/负面。 | 正面 |
| 问答 | 问题:Transformer 是什么? | Transformer 是一种... |
| 代码 | 写一个 Python 快排。 | def quicksort... |
| 推理 | 一步步分析下面问题。 | 第一步... |
这就是现代大模型选择 Decoder-Only 的关键原因:预训练、指令微调、聊天、工具调用都能统一成生成式接口。
四、Encoder-Decoder:先读输入,再生成输出
Encoder-Decoder 是原始 Transformer 的结构,也是 T5、BART 等模型的基础。
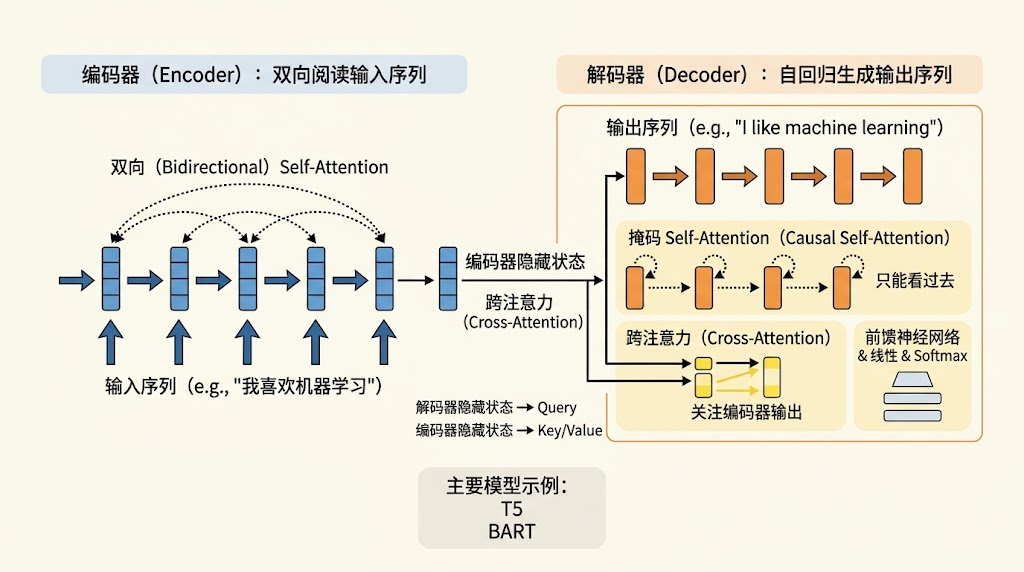
它包含两个部分:
text
Encoder:双向阅读输入序列
Decoder:自回归生成输出序列
Decoder 里除了 causal self-attention,还有 cross-attention。
Cross-attention 的意思是:Decoder 当前生成位置,用 Query 去关注 Encoder 输出的 Key/Value。
text
Decoder hidden -> Query
Encoder hidden -> Key/Value
伪代码:
python
# 伪代码:Encoder-Decoder
encoder_hidden = encoder(source_ids, source_mask)

decoder_hidden = decoder(
    target_ids,
    causal_mask=target_mask,
    encoder_hidden=encoder_hidden,
    encoder_mask=source_mask,
)

logits = lm_head(decoder_hidden)
这个结构非常适合序列到序列转换:
- 机器翻译;
- 摘要生成;
- 文本改写;
- 纠错;
- 结构化信息生成;
- 输入和输出边界清晰的任务。
它的优势是输入和输出分工明确。Encoder 可以充分双向理解源文本,Decoder 可以逐步生成目标文本。
它的代价是结构更复杂,训练和推理实现也比纯 Decoder-Only 多一套 cross-attention 逻辑。
五、三种注意力方向对比
理解架构差异,关键是看 attention mask。
Encoder 双向 self-attention
每个 token 看所有 token:
text
1 1 1 1
1 1 1 1
1 1 1 1
1 1 1 1
适合完整理解输入。
Decoder 因果 self-attention
每个 token 只能看过去:
text
1 0 0 0
1 1 0 0
1 1 1 0
1 1 1 1
适合从左到右生成。
Cross-attention
Decoder 每个生成位置可以关注 Encoder 所有输入位置:
text
输出 token 1 -> 看全部输入 token
输出 token 2 -> 看全部输入 token
输出 token 3 -> 看全部输入 token
适合"根据输入生成输出"。
用一段小代码生成 mask:
python
import torch

seq_len = 5
encoder_mask = torch.ones(seq_len, seq_len).bool()
decoder_mask = torch.tril(torch.ones(seq_len, seq_len)).bool()

print("encoder bidirectional mask")
print(encoder_mask.int())

print("decoder causal mask")
print(decoder_mask.int())
mask 方向决定了模型能使用什么信息,也决定了训练目标应该怎么设计。
六、为什么现代大模型多用 Decoder-Only
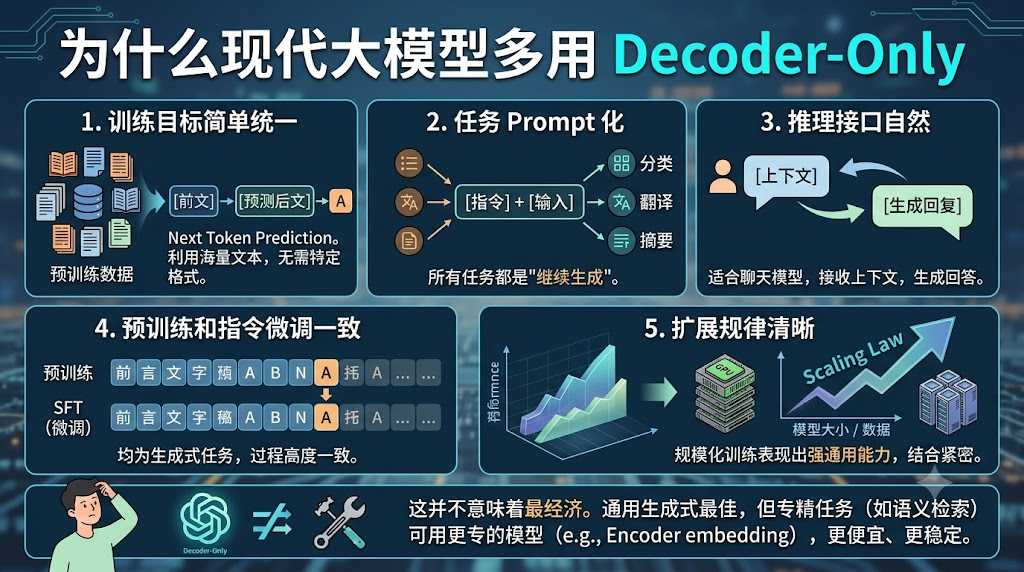
GPT 类大模型选择 Decoder-Only,有几个现实原因。
第一,训练目标简单统一。Next token prediction 可以直接利用海量文本:给定前文,预测后文。不需要为每种任务设计单独输入输出格式。
第二,任务可以 prompt 化。分类、翻译、摘要、代码、问答都能变成"继续生成答案"。
第三,推理接口自然。聊天模型本来就是接收上下文,然后生成回复。
第四,预训练和指令微调一致。预训练是生成下一个 token,SFT 也是根据指令生成回答,RLHF/DPO 也是优化回答偏好。
第五,扩展规律清晰。Decoder-Only 在规模化训练中表现出很强的通用能力,和 Scaling Law 路线结合紧密。
这并不意味着 Decoder-Only 在所有任务上都最经济。它只是最适合做通用生成式基础模型。
如果你的任务只是做语义检索,用一个专门训练的 Encoder embedding 模型,通常比调用一个巨大 Decoder-Only 聊天模型更便宜、更稳定。
七、Prompt 如何统一任务
Decoder-Only 的一个关键能力,是把不同任务统一成文本生成。
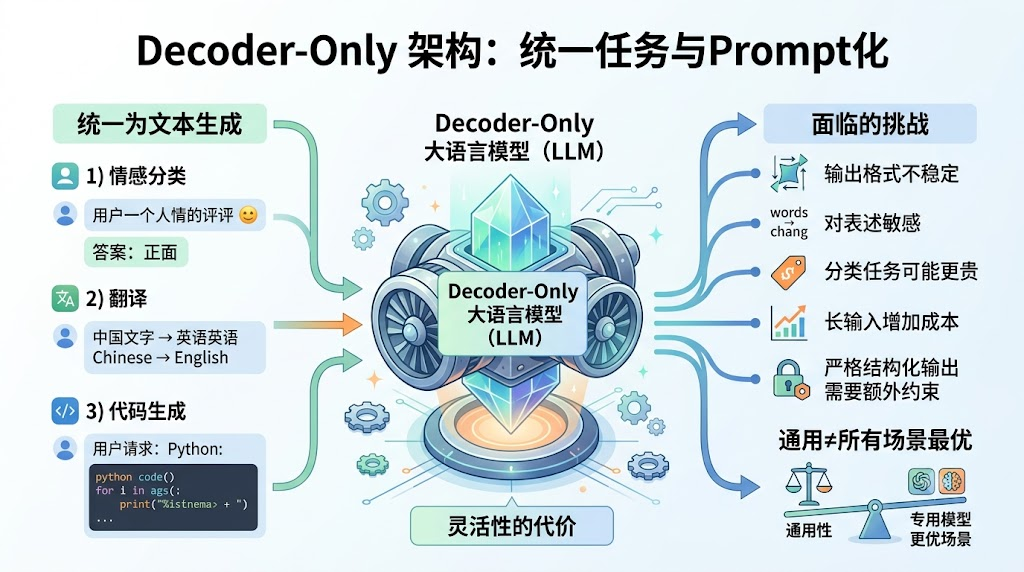
例如情感分类原本是:
text
输入 x -> 分类标签 y在 Decoder-Only 里可以写成:
text
请判断下面评论的情感,只输出"正面"或"负面"。
评论:这家店味道很好,服务也热情。
答案:
模型继续生成:
text
正面翻译任务:
text
把下面中文翻译成英文:
今天天气很好。
英文:
代码任务:
text
用 Python 写一个函数,输入整数列表,返回其中的最大值。这种统一带来了巨大灵活性。开发者不需要为每个任务训练一个独立模型,而是设计 prompt、提供示例、接入工具或检索系统。
但 prompt 化也有代价:
- 输出格式可能不稳定;
- 对 prompt 表述敏感;
- 分类任务可能比专用模型更贵;
- 长输入会增加推理成本;
- 对严格结构化输出需要额外约束。
所以 Decoder-Only 是通用,不等于所有场景最优。
八、三种架构的工程选型
可以按任务类型粗略选择:
| 任务 | 推荐方向 | 原因 |
|---|---|---|
| 文本分类 | Encoder-Only 或小型 Decoder | Encoder 便宜稳定,Decoder 适合少样本和复杂说明 |
| 语义检索 embedding | Encoder-Only / 双塔模型 | 需要高吞吐向量表示 |
| Rerank | Encoder-Only Cross-Encoder | 双向理解 query-doc 匹配 |
| 翻译 | Encoder-Decoder 或 Decoder-Only | 专用 seq2seq 稳定,通用大模型更灵活 |
| 摘要 | Encoder-Decoder 或 Decoder-Only | 输入输出转换明确,也可 prompt 化 |
| 聊天助手 | Decoder-Only | 自然生成回复 |
| 代码生成 | Decoder-Only | 从上下文续写代码 |
| 信息抽取 | Encoder 或 Decoder | 取决于是否需要生成复杂结构 |
| 企业知识库问答 | RAG + Decoder-Only,检索用 Encoder | 生成和检索分工 |
真实系统经常混用:
text
Encoder embedding 模型负责检索
Reranker 负责重排
Decoder-Only 大模型负责综合回答
这比只用一个超大模型处理所有步骤更经济、更可控。
九、BERT、T5、GPT 的目标差异
三种架构常和不同预训练目标绑定。
BERT 常用 MLM:遮住输入中的一部分 token,让模型根据双向上下文预测。
text
我 喜欢 [MASK] 学习 -> 机器T5 把任务统一成 text-to-text,常见做法是 span corruption:遮住一段文本,让模型生成缺失片段。
text
输入:我 <extra_id_0> 机器学习
输出:<extra_id_0> 喜欢
GPT 使用 causal language modeling:给定前文预测下一个 token。
text
我 喜欢 机器 -> 学习目标函数塑造了模型能力。
- MLM 让 BERT 强于双向理解;
- Seq2Seq 让 T5/BART 强于输入到输出转换;
- CLM 让 GPT 类模型强于开放式生成和上下文续写。
架构和训练目标要一起看,不能只看模块名字。
十、为什么 Encoder 模型仍然重要
现代聊天大模型大多是 Decoder-Only,但 Encoder 模型没有消失。
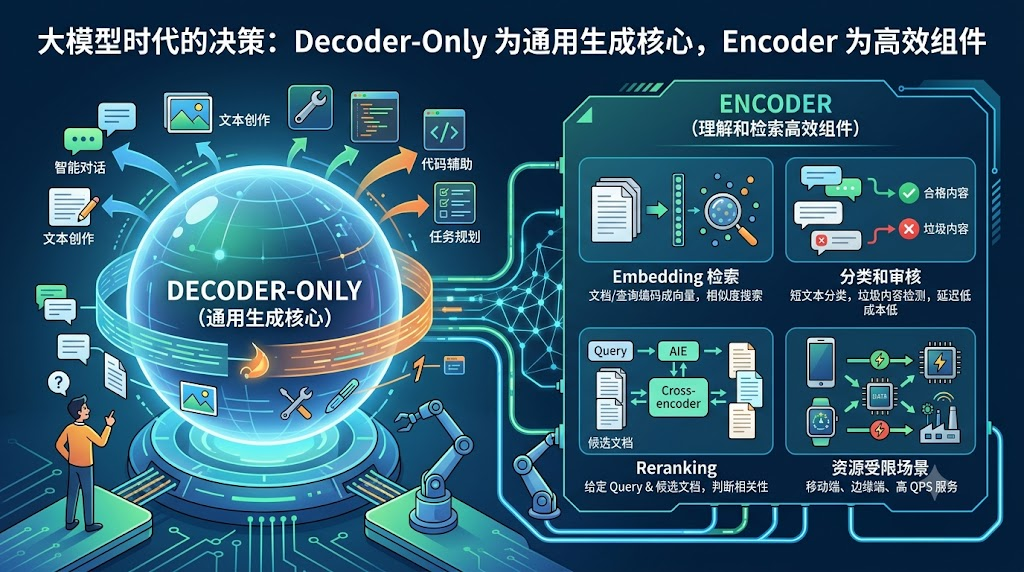
在很多工程系统里,Encoder 模型仍然更合适。
第一,embedding 检索。你需要把文档和查询编码成向量,做相似度搜索。Encoder 模型通常更便宜、更适合批量编码。
第二,分类和审核。短文本分类、意图识别、垃圾内容检测等任务,专用 Encoder 模型延迟低、成本低、输出稳定。
第三,reranking。给定 query 和候选文档,让模型双向读取二者并判断相关性,Encoder Cross-Encoder 很常见。
第四,资源受限场景。移动端、边缘端、高 QPS 服务,不一定能承受大 Decoder 模型。
所以更成熟的判断不是"Decoder-Only 取代一切",而是:
Decoder-Only 是通用生成核心,Encoder 是理解和检索系统里的高效组件。
十一、架构和推理成本的关系
不同架构的推理成本也不一样。
Encoder-Only 通常一次性读完整输入,输出分类或向量,不需要逐 token 自回归生成。它适合高吞吐理解任务。
Decoder-Only 生成时要一个 token 一个 token 地解码。虽然 KV Cache 能避免重复计算历史 K/V,但输出越长,生成步骤越多。
Encoder-Decoder 的 Encoder 对输入算一次,Decoder 生成时每步既要做自注意力,也要通过 cross-attention 关注 Encoder 输出。
这会影响工程选型。
如果你只需要判断一个文本是否违规,用大语言模型生成"是/否"可能可行,但成本未必合理。
如果你需要写一段解释、综合多篇资料、生成代码,Decoder-Only 的灵活性就更有价值。
十二、常见误区
误区 1:Decoder 就一定比 Encoder 高级。
不是高级低级之分,而是任务方向不同。Encoder 擅长理解,Decoder 擅长生成。
误区 2:BERT 不能生成,所以没有价值。
BERT 类模型在分类、检索、rerank、序列标注等任务中仍然很有价值。
误区 3:Encoder-Decoder 已经过时。
在翻译、摘要、改写等输入输出边界清晰的任务中,Encoder-Decoder 仍然是合理选择。
误区 4:Decoder-Only 做分类一定最好。
它可以通过 prompt 做分类,但高 QPS、低成本、强稳定性场景下,专用分类模型可能更好。
误区 5:架构和训练目标可以分开理解。
架构决定信息流,训练目标决定能力形成方式。BERT、T5、GPT 的差异必须一起看。
十三、你应该记住的最小对比
可以用下面三句话记住:
text
Encoder-Only:双向读完整输入,输出理解表示。
Encoder-Decoder:Encoder 读输入,Decoder 生成输出。
Decoder-Only:只看过去,从左到右继续生成。
再对应到注意力:
text
Encoder self-attention:看全文
Decoder self-attention:只看过去
Cross-attention:输出位置看输入表示
再对应到任务:
text
理解和检索:Encoder
翻译和摘要:Encoder-Decoder 或 Decoder
对话和通用生成:Decoder-Only
这个框架足以支撑你读大多数模型介绍。
总结
Encoder-Only、Encoder-Decoder 和 Decoder-Only 是 Transformer 的三条重要路线。Encoder-Only 通过双向 self-attention 充分理解输入,适合分类、检索、rerank 等任务。Encoder-Decoder 用 Encoder 阅读源序列,再用 Decoder 自回归生成目标序列,适合翻译、摘要和改写。Decoder-Only 通过因果 self-attention 从左到右预测下一个 token,适合对话、写作、代码和通用生成。
现代大模型多采用 Decoder-Only,是因为 next token prediction 能统一大规模预训练、指令微调和聊天生成。但工程上不应把它理解成唯一正确架构。很多真实系统会同时使用 Encoder 做检索和理解,用 Decoder-Only 做综合生成。
第一遍记住一句话:架构差异的本质是信息流方向不同,任务选择要跟信息流匹配。
大模型视角
理解三种架构后,你会更容易看懂后续模型路线:BERT 为什么代表双向理解,T5 为什么把任务做成 text-to-text,GPT 为什么靠 Decoder-Only 统一生成。你也会理解 RAG 系统为什么常常是 Encoder 和 Decoder 的组合,而不是单一模型包办所有事情。
下一篇
BERT:双向预训练语言模型的开端 ------ 下一篇聚焦 Encoder-Only 路线的代表模型 BERT,看它如何用 MLM 预训练打开双向语言理解模型时代。