做实时音视频系统时,我们经常讨论 RTSP、RTMP、SRT、WHIP/WHEP,也经常讨论 H.264、H.265、AV1、VVC,但真正深入到底层后会发现,决定一套系统性能上限的,很多时候并不是协议和 Codec,而是更基础的问题:一帧视频进入系统以后,到底以什么格式存在,又被复制和转换了多少次。
YUV、I420、NV12、NV21、RGB24、RGBA、RGB565,看起来只是不同的像素排列方式,实际上却贯穿摄像头采集、软硬件编解码、GPU 渲染、截图、图像算法、AI 推理以及二次编码整个链路。对于大牛直播SDK(SmartMediaKit)这样的实时音视频 SDK 来说,像素格式不是一个孤立的数据类型,而应该被看成整个 Video Pipeline 的底层数据契约。
一、像素格式的本质,不是"颜色",而是视频系统中的数据组织方式
一条最典型的实时视频链路可以抽象为:
Camera
  ↓
Raw Video
  ↓
Encoder
  ↓
H.264 / H.265
  ↓
Network
  ↓
Decoder
  ↓
Raw Video
  ↓
GPU / Display
如果增加 AI:
Camera / Decoder
        ↓
      YUV Frame
        ↓
   ┌────┴────┐
   ↓         ↓
Render      AI
            ↓
       RGB / Tensor
如果增加转码、水印、裁剪或二次编码:
Decode → YUV → Process → YUV → Encode所以,像素格式真正决定的是:视频帧在各个计算单元之间如何移动。
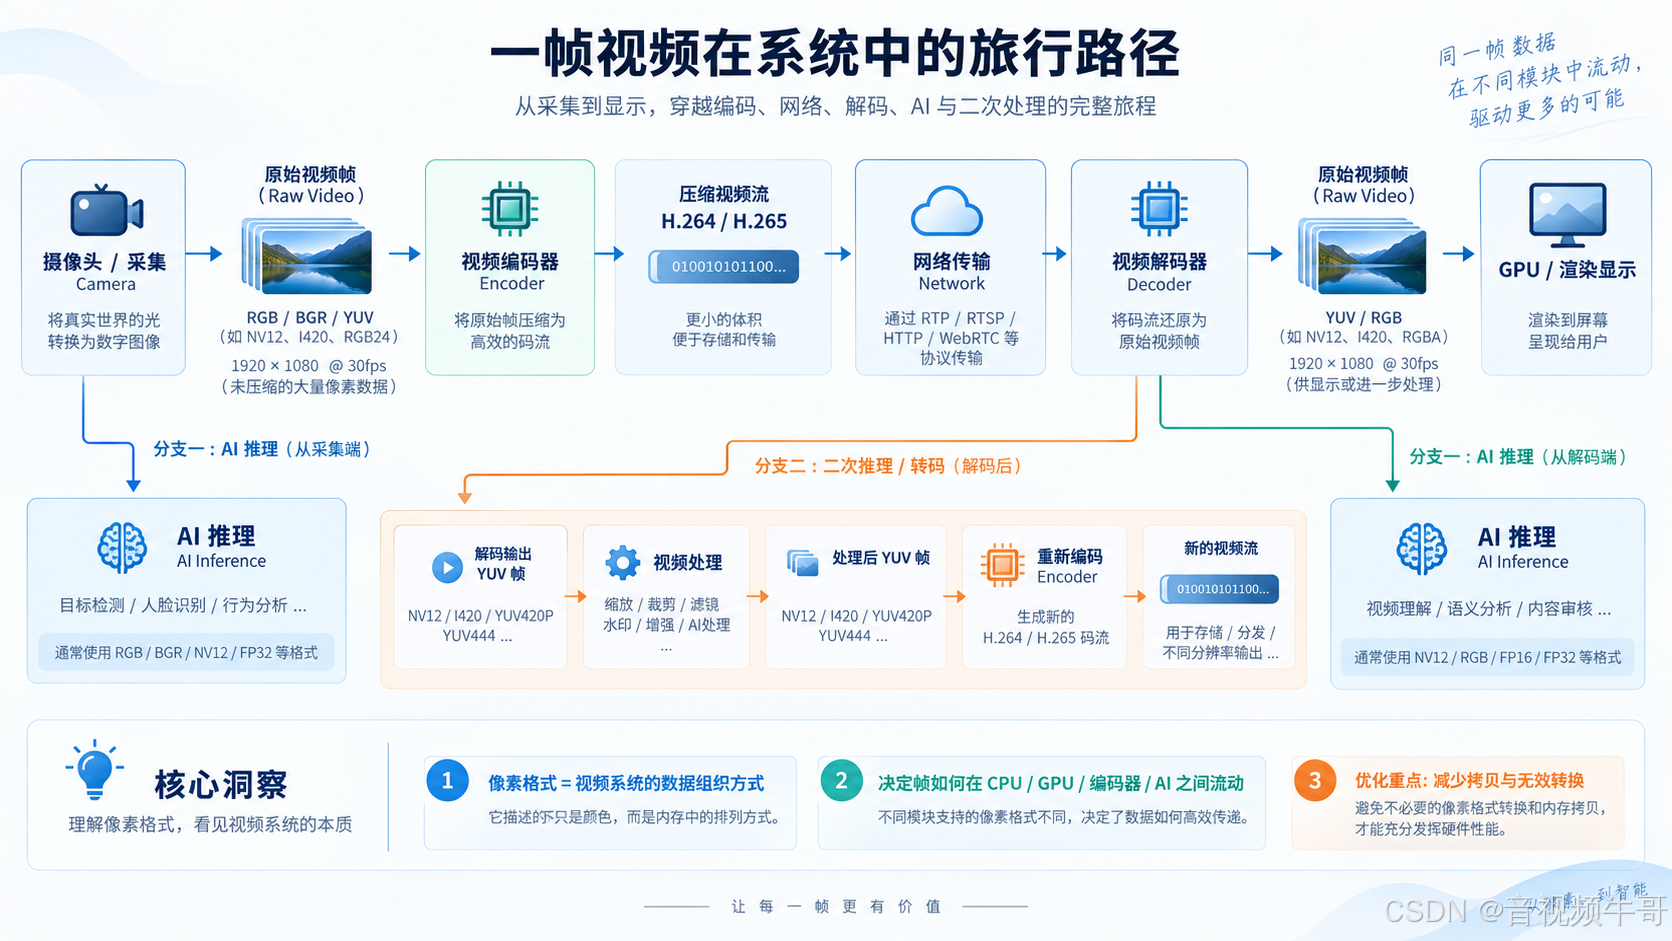
例如 1920×1080 的 YUV420 8bit 视频,一帧数据量大约为:
1920 × 1080 × 1.5 ≈ 3.11 MB30fps 时,单路原始视频每秒已经约有:
3.11 × 30 ≈ 93 MB/s如果一个流程中发生:
Decode
 ↓
memcpy
 ↓
YUV → RGB
 ↓
memcpy
 ↓
RGB → YUV
 ↓
Encode
那么真正消耗系统资源的,可能已经不只是编解码,而是内存读写与颜色转换。
到了 4K、多路播放、多路 AI 分析场景,这种问题会迅速放大。因此成熟音视频系统优化的重点并不是"能不能转换格式",而是:
这一帧数据到底有没有必要转换。
二、为什么视频编码体系长期选择 YUV,而不是 RGB
RGB 更符合显示设备和图像处理的直觉,每个像素保存 R、G、B 三个颜色分量。但视频编码系统更倾向使用 YCbCr,工程中通常习惯称为 YUV。
核心原因来自人眼视觉特性:人眼对于亮度细节比色度细节更加敏感。
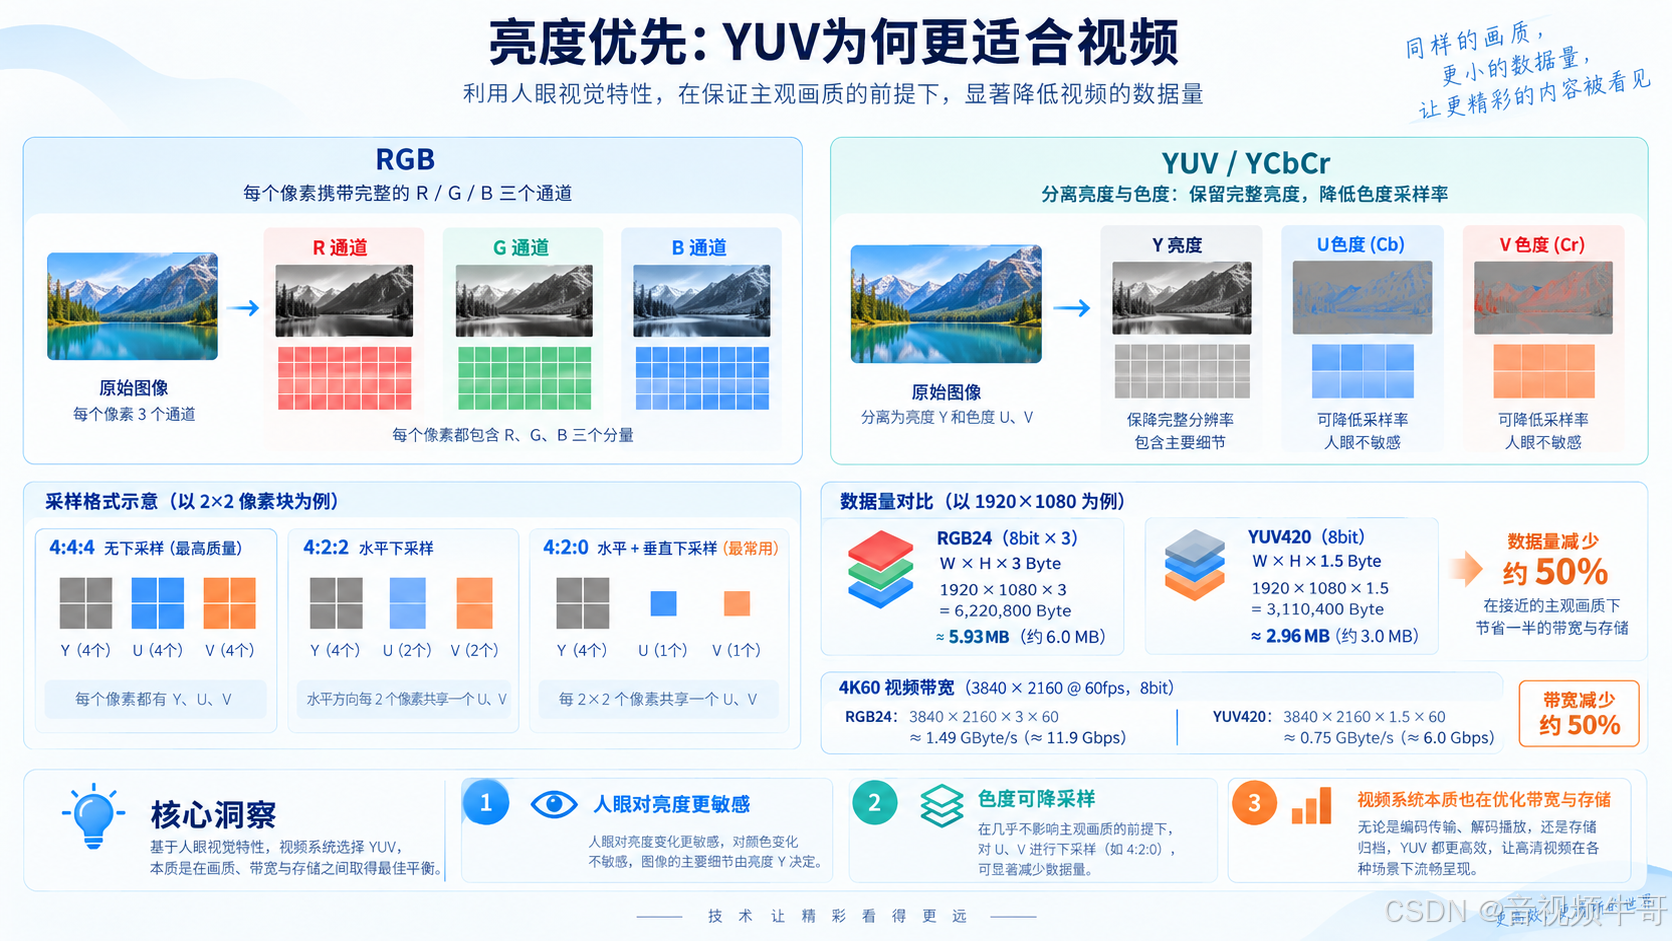
于是视频系统把图像拆成:
Y  :Luma,亮度
Cb :Blue-difference Chroma
Cr :Red-difference Chroma
并通过色度子采样减少数据量。
例如 YUV 4:2:0:
Y  = W × H
U  = W × H / 4
V  = W × H / 4
因此:
Frame Size = W × H × 1.5 Byte而 RGB24:
Frame Size = W × H × 3 Byte1920×1080:
| 格式 | 单帧理论数据量 |
|---|---|
| YUV420 8bit | ≈ 3.11 MB |
| RGB24 | ≈ 6.22 MB |
| RGBA32 | ≈ 8.29 MB |
这就是为什么摄像头采集、视频编解码器以及硬件视频 Pipeline 更喜欢 YUV。
问题到了 4K 会更加明显:
3840 × 2160 × 1.5 ≈ 12.44 MB/frame60fps 时,仅单路 YUV420 理论原始数据吞吐就接近:
746 MB/sRGBA32 更是接近:
1.99 GB/s如果再增加多路视频和几次额外 memcpy,系统首先撞上的可能不是 CPU 算力,而是 DDR Memory Bandwidth。
因此做高性能实时视频系统,本质上同时是在做:
Codec Optimization + Memory Architecture Optimization。
三、I420、NV12、NV21 的差异,小到只是排列顺序,大到影响整个硬件链路
I420、NV12、NV21 都属于常见 YUV420 格式,但它们的内存组织方式不同。
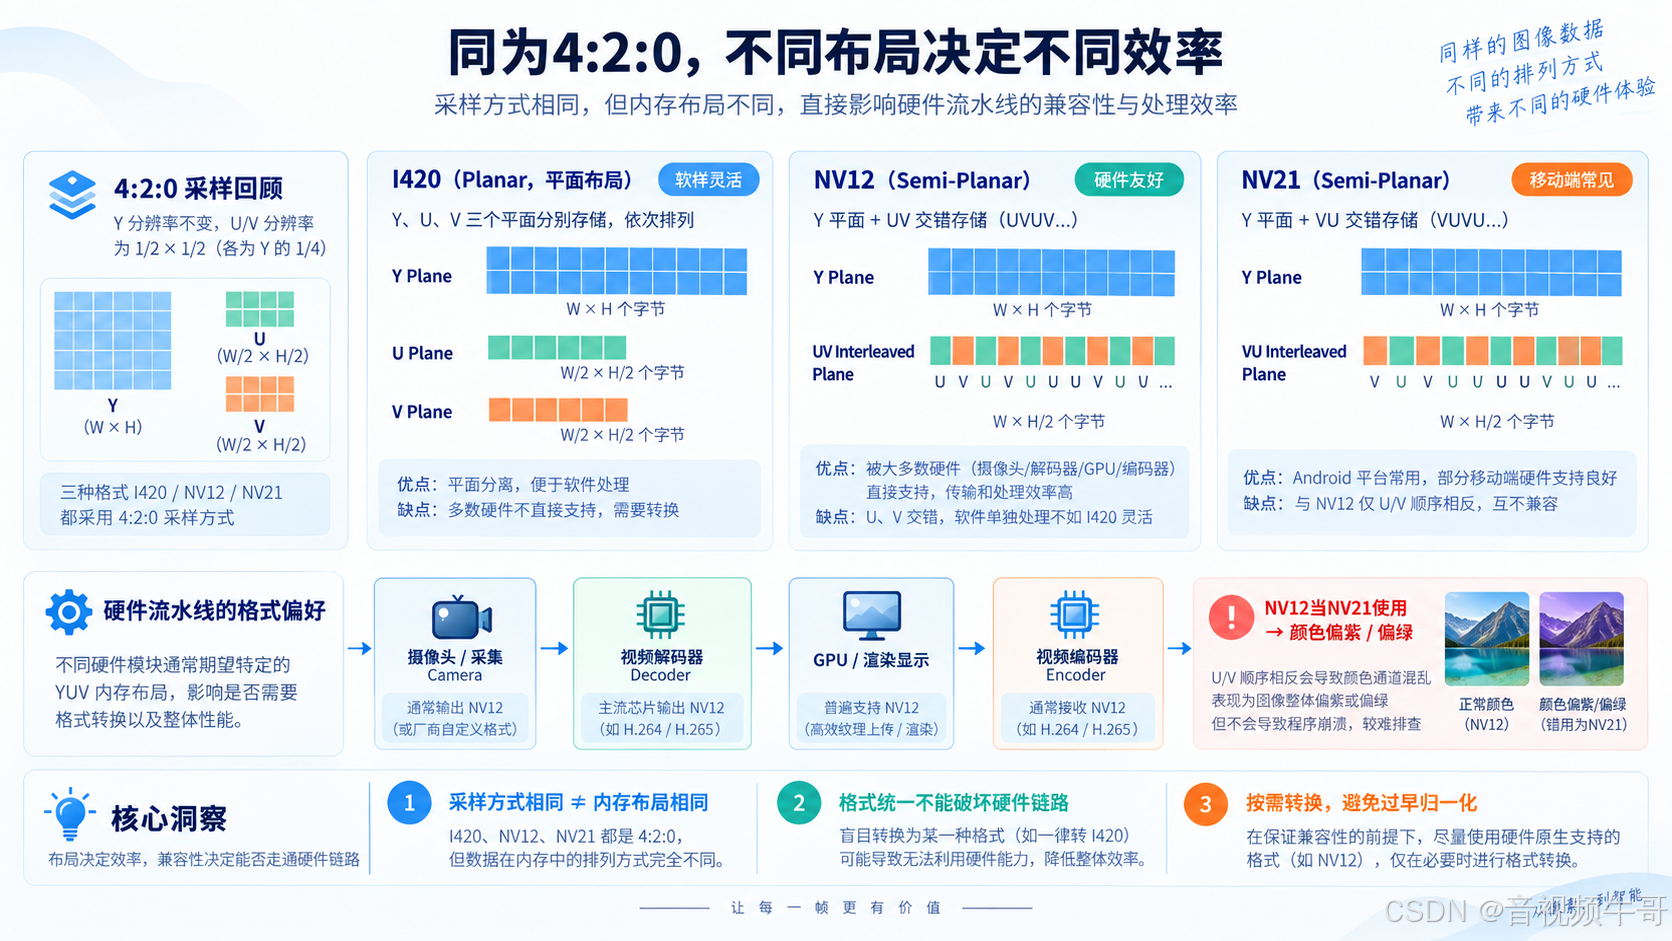
I420 是典型的 Planar:
YYYYYYYY
YYYYYYYY
UUUU
VVVV
即:
Y Plane
U Plane
V Plane
NV12 则是 Semi-Planar:
YYYYYYYY
YYYYYYYY
UVUVUVUV
即:
Y Plane
UV Plane
NV21 与 NV12 几乎完全一样,只是色度顺序变为:
Y Plane
VUVUVUVU
因此:
NV12 = UVUV
NV21 = VUVU
如果把 NV12 按 NV21 解释,图像结构通常还是正确的,但颜色会明显偏紫或偏绿。这是实际音视频开发中最经典的一类问题。
从纯算法角度看,I420 和 NV12 数据量一样;从现代硬件角度看,却并不完全等价。
NV12 更容易与:
Hardware Decoder
GPU Texture
Video Processor
Hardware Encoder
形成高效链路。
因此在 Windows D3D、移动端硬解码、GPU Shader,以及大量硬件媒体框架中,NV12 都具有非常重要的地位。
这带来一个架构设计原则:
SDK 内部不要为了"统一格式"而过早把所有输入都转换成 I420。
统一格式可以降低代码复杂度,却也可能人为破坏硬件友好的数据链路。
真正好的设计应该是:
Input Format
     ↓
Native Frame
     ↓
Consumer decides
     ↓
Convert only if required
而不是:
Anything
   ↓
Convert to I420
   ↓
Everything
前者是现代媒体框架思路,后者更多是传统软件视频架构。
四、Stride 和 Plane 才是工程里最容易被低估的问题
很多开发者理解了 NV12、NV21,却仍然会遇到花屏,因为真正的视频内存布局远比:
width × height复杂。
例如视频宽度:
width = 1920硬件解码器为了满足 32、64、128 Byte 对齐要求,实际一行内存可能是:
stride = 2048于是每行真实布局为:
1920 Byte Valid Data
128  Byte Padding
如果程序按照:
data + row * width寻找下一行,图像就会逐行错位。
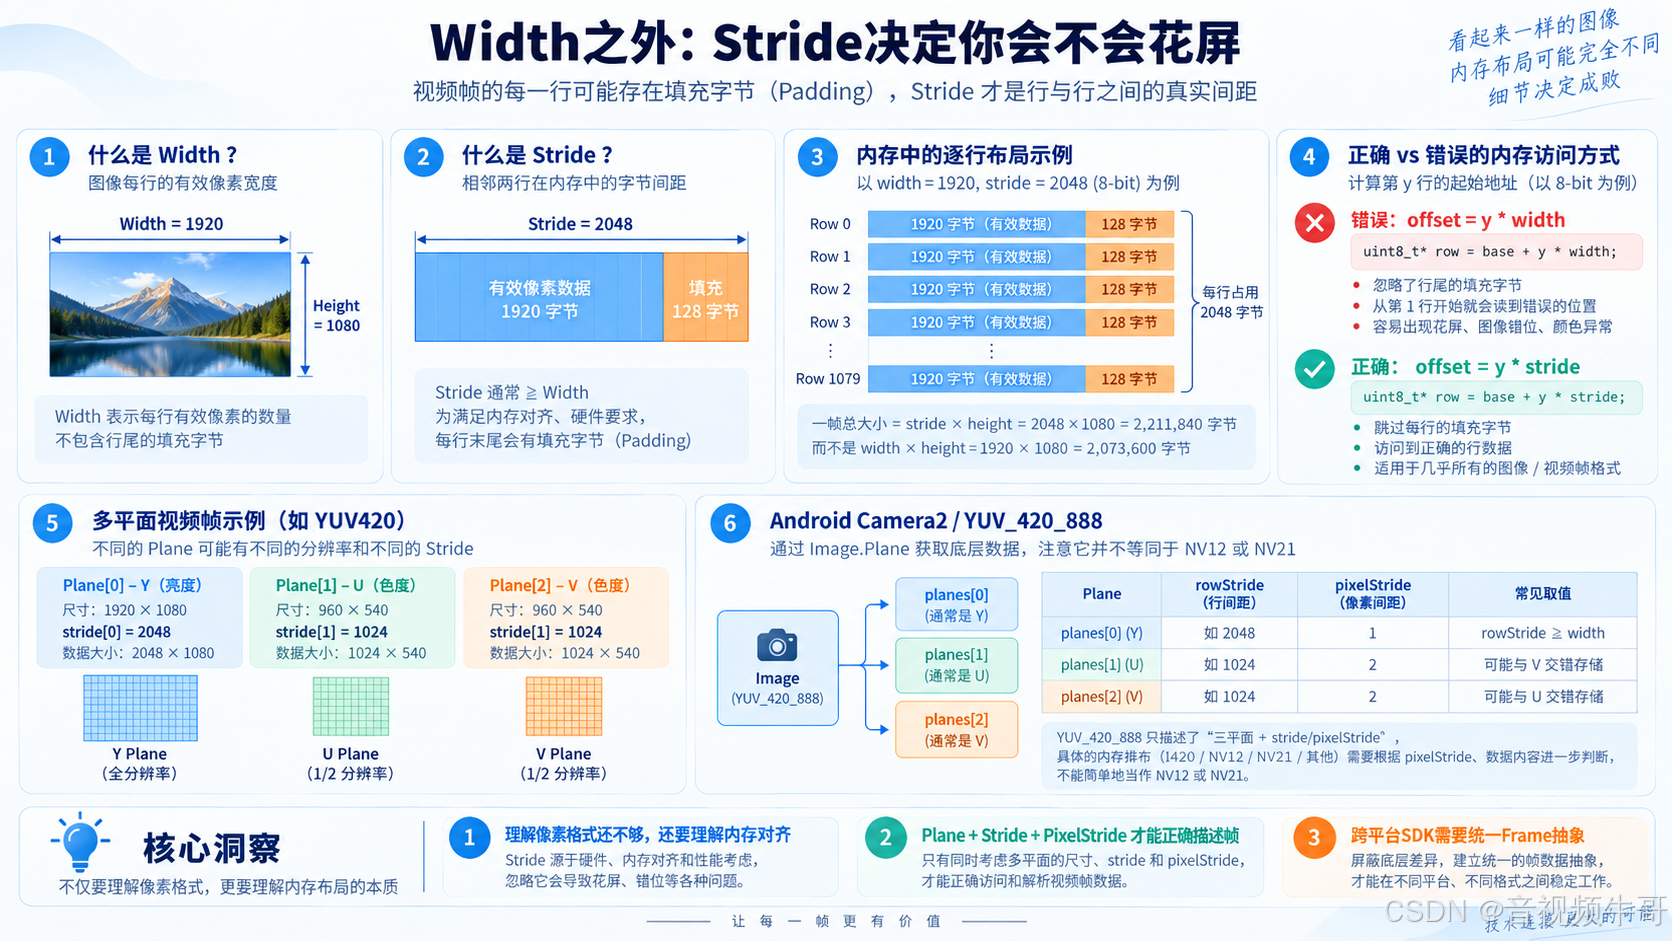
正确逻辑应该按照:
data + row * stride处理。
这也是为什么一个成熟的 VideoFrame 描述不能只有:
uint8_t* data;
int width;
int height;
而应该接近:
struct VideoFrame {
    PixelFormat format;

    int width;
    int height;

    uint8_t* plane[4];
    int stride[4];

    int64_t pts;

    ColorSpace color_space;
};
Android 的 YUV_420_888 就很好地说明了这个问题。
它并不等于 NV12,也不等于 NV21,而是一种灵活的 YUV420 描述。Y、U、V Plane 可以分别具有:
rowStride
pixelStride
因此下面这种思路在很多设备上并不可靠:
Y Plane + U Plane + V Plane
=
NV21
这也是为什么某些 Camera2 程序会出现:
A 手机正常,B 手机偏色,C 手机花屏。
问题往往不是 Camera2 本身,而是程序错误地假设了底层 Plane 布局。
对于 SmartMediaKit 这类跨 Windows、Android、iOS 的 SDK 来说,真正需要抽象的是:
PixelFormat
Plane
Stride
Width / Height
Timestamp
Color Information
而不是单纯抽象一个 buffer。
五、RGB 和 RGB565 并没有退出历史舞台,只是角色发生了变化
视频传输和编码主要偏向 YUV,但 RGB 仍然是整个媒体系统的重要组成部分。
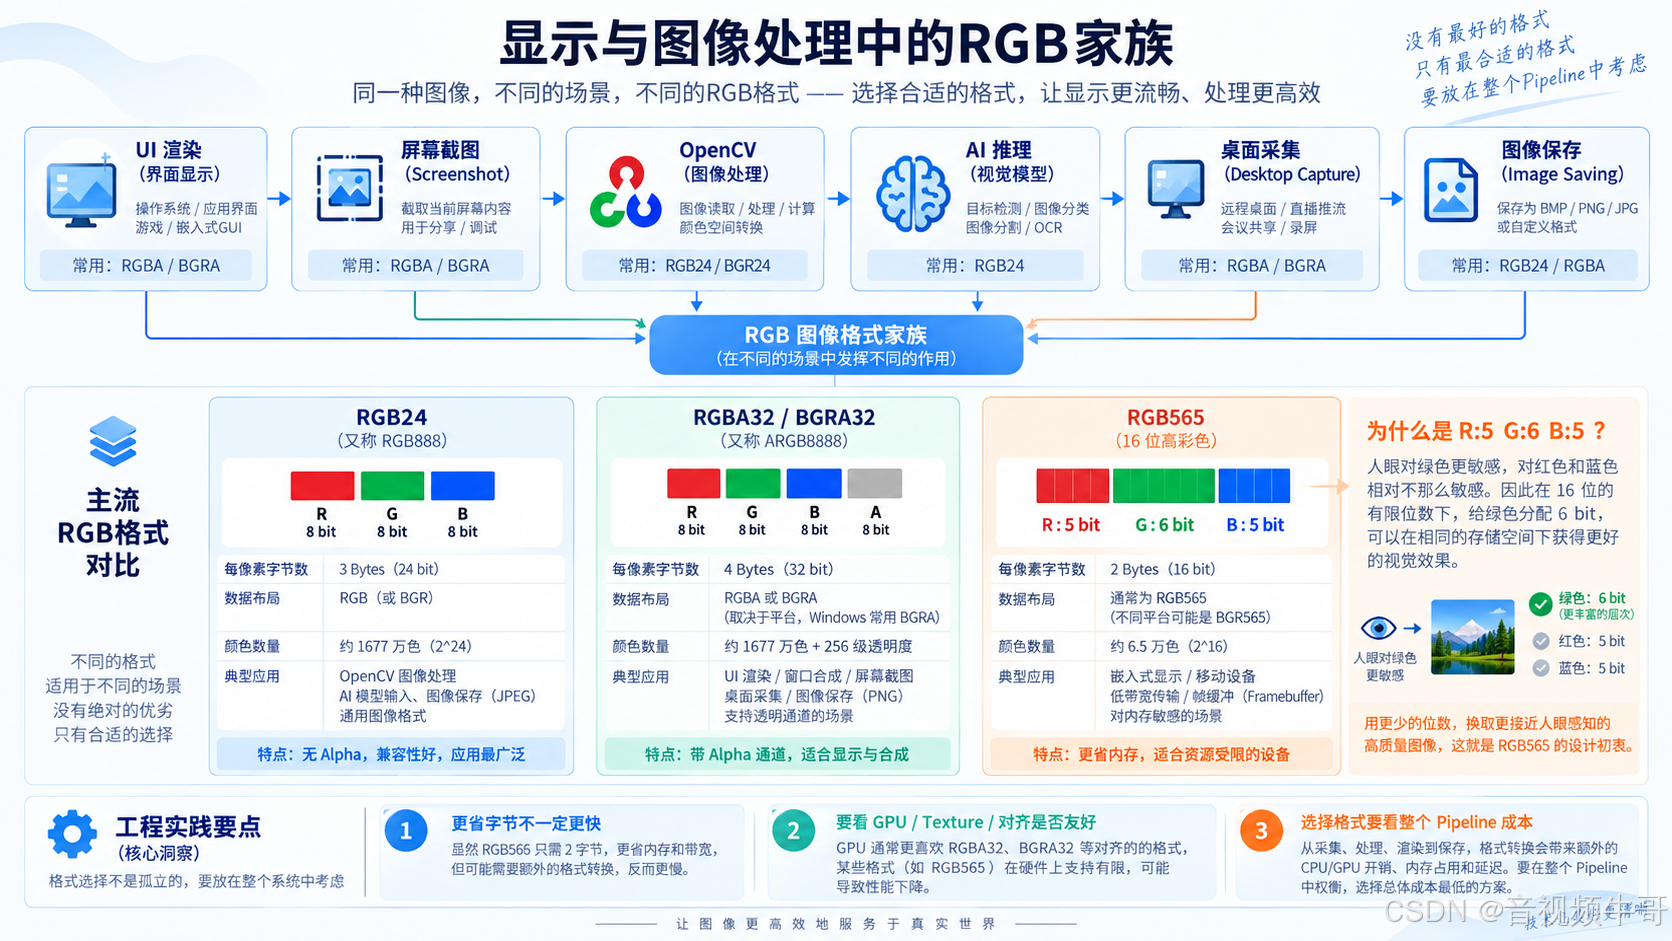
RGB 常见于:
UI Rendering
Screenshot
Image Processing
OpenCV
AI
Desktop Capture
Bitmap
Image Saving
实际开发中又会遇到:
RGB24
BGR24
RGBA
BGRA
ARGB
ABGR
RGB565
所以 RGB 的难点并不只是颜色,而是:
Channel Order + Alpha + Endianness + API Convention。
其中 RGB565 很有代表性:
R = 5 bit
G = 6 bit
B = 5 bit
总共:
16 bit / pixel相比 RGB888 的:
24 bit / pixel可以减少约 1/3 内存。
RGB565 曾经广泛用于移动设备、Framebuffer、LCD 和嵌入式系统,因为当时内存和显存非常宝贵。
但现代系统逐渐转向 RGBA8888、BGRA8888,一个重要原因不是现代系统"不在乎内存",而是 GPU 更关注:
Alignment
Texture Format
SIMD
Native GPU Pipeline
这揭示了音视频性能优化中一个经常被忽视的原则:
单帧数据量更小,并不一定意味着整个 Pipeline 更快。
假设 RGB565 需要:
RGB565
  ↓
Convert
  ↓
RGBA8888
  ↓
GPU
而 RGBA8888 可以:
RGBA8888
  ↓
GPU
那么后者虽然每像素多占 2 Byte,却可能拥有更高的整体性能。
所以工程上不能只问:
Which format uses less memory?真正应该问:
Which format minimizes total pipeline cost?六、真正昂贵的往往不是编解码,而是 YUV 与 RGB 之间反复横跳
在实时视频系统中,一个非常典型的低效 Pipeline 是:
H.264
 ↓
Hardware Decoder
 ↓
NV12
 ↓
CPU Convert
 ↓
RGB
 ↓
Render
如果 GPU 可以直接处理 NV12,那么 CPU 上的:
NV12 → RGB其实完全可以避免。
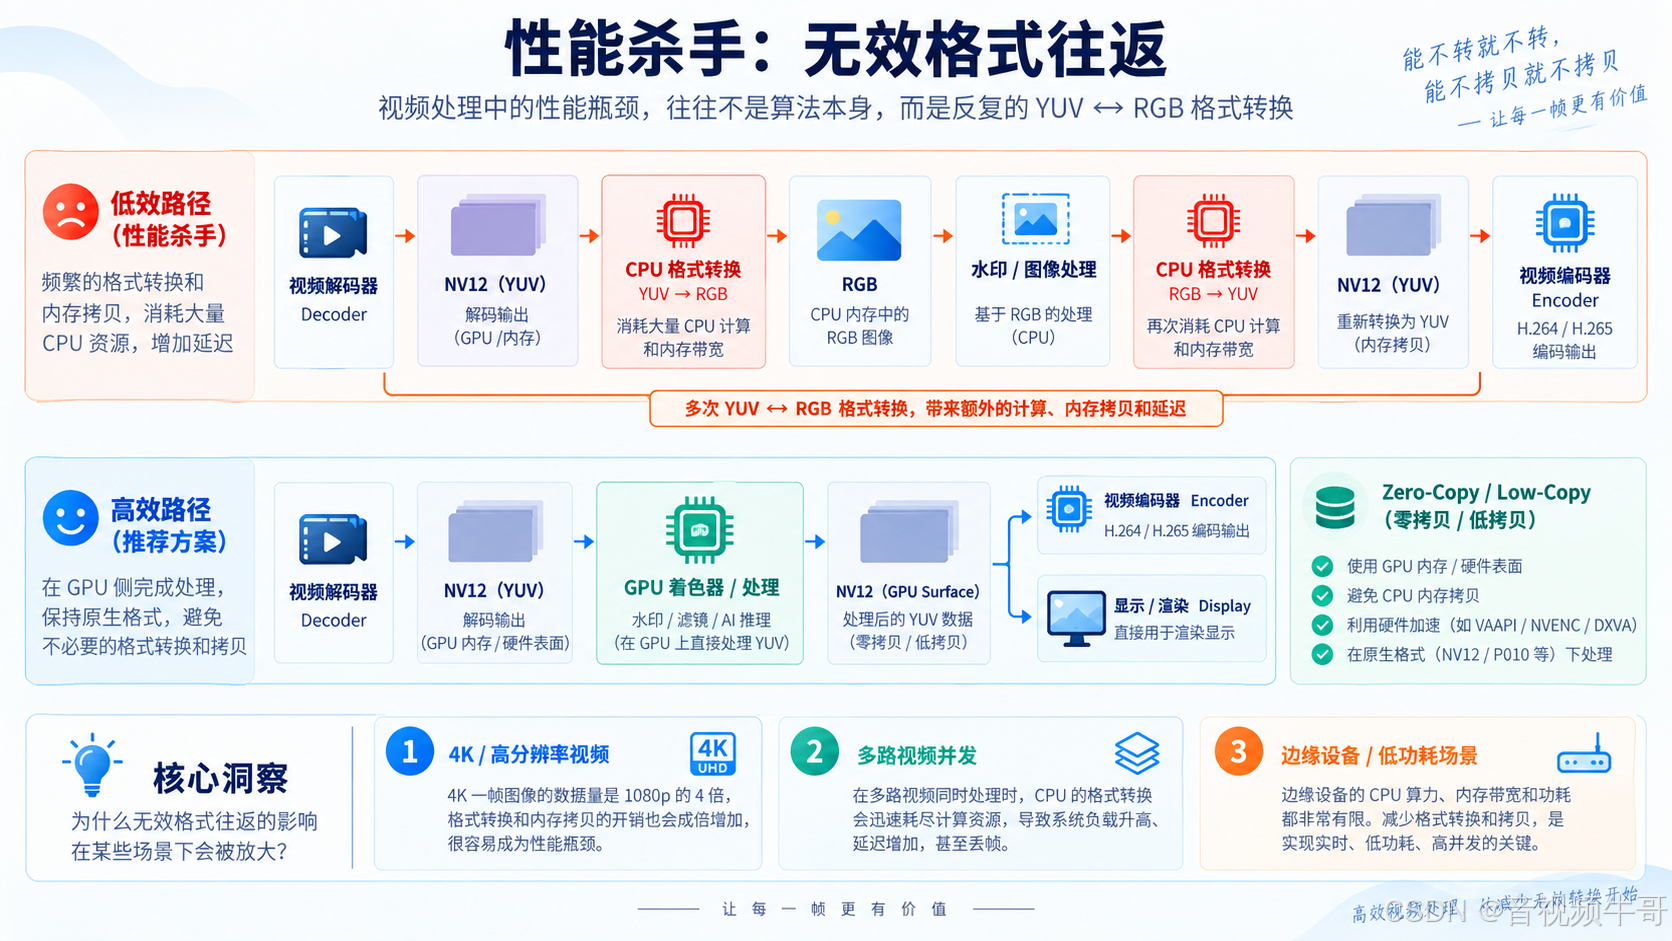
更典型的问题出现在视频处理:
Decoder
 ↓
NV12
 ↓
RGB
 ↓
Watermark
 ↓
YUV
 ↓
Encoder
为了加一个水印,视频经历:
NV12 → RGB → YUV真正合理的路径更接近:
Decoder
 ↓
NV12
 ↓
GPU Shader
 ↓
NV12 / GPU Surface
 ↓
Encoder
播放也可以:
Decoder
 ↓
NV12 Surface
 ↓
GPU Shader
 ↓
Screen
这一思想最终指向音视频系统非常重要的设计方向:
Zero-Copy / Low-Copy Pipeline。
所谓零拷贝,并不是简单理解为程序内部完全没有任何数据复制,而是尽可能避免:
Hardware
 ↓
CPU Memory
 ↓
GPU Memory
 ↓
CPU Memory
这种来回搬运。
更加合理的架构是:
Camera
   ↓
Shared Buffer
   ↓
Hardware Encoder

Decoder
   ↓
GPU Surface
 ┌─┴─────┐
 ↓       ↓
Display  AI
对于 1080P 单路视频,少一次 memcpy 可能看不出巨大差异;对于 4K60、多路解码、AI 分析和边缘设备,Buffer Architecture 往往直接决定系统是否能够稳定运行。
七、YUV 转 RGB 真正复杂的地方,不在转换公式,而在 Color Space
网上常见 YUV→RGB 转换公式,例如:
R = Y + 1.402(V - 128)
G = Y - 0.344(U - 128) - 0.714(V - 128)
B = Y + 1.772(U - 128)
从教学角度没有问题,但真正工程环境远比这复杂。
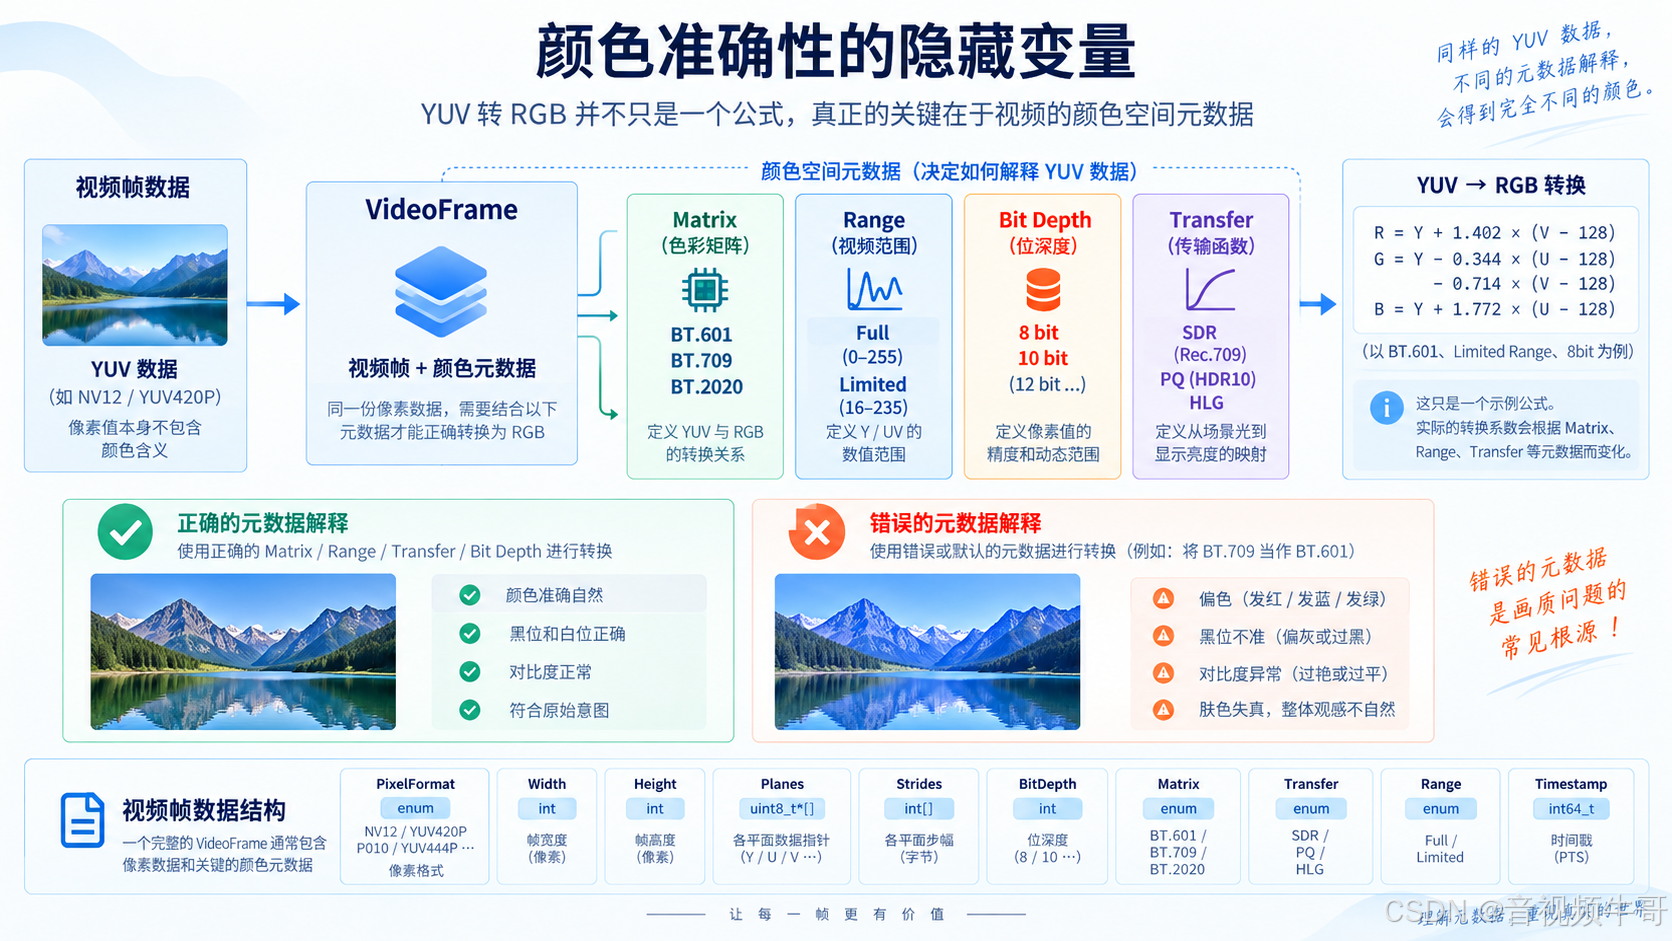
因为至少还需要确定:
BT.601
BT.709
BT.2020

Full Range
Limited Range

8bit
10bit

SDR
HDR
例如视频领域常见 Limited Range:
Y  ≈ 16 ~ 235
Cb ≈ 16 ~ 240
Cr ≈ 16 ~ 240
而图像领域很多时候默认:
0 ~ 255如果范围解释错误,可能出现:
黑色不够黑
白色不够白
对比度异常
如果 Matrix 使用 BT.601,而实际数据是 BT.709,画面通常不会严重花屏,却会产生颜色偏差。
HDR 又进一步增加:
BT.2020
PQ
HLG
所以现代 VideoFrame 从技术上应该不仅描述:
width
height
format
还应该逐步能够表达:
Pixel Format
Bit Depth
Color Primaries
Transfer Characteristics
Matrix Coefficients
Color Range
否则一个 SDK 即使"支持 10bit",也未必意味着它真正建立了完整的 10bit/HDR Pipeline。
八、AI 正在重新定义视频像素格式的价值
传统实时音视频系统主要关注:
Capture
Encode
Transmit
Decode
Render
AI 进入以后,链路开始变成:
Capture / Decode
       ↓
      Frame
   ┌───┴─────┐
   ↓         ↓
Video       AI
   ↓         ↓
Render    Tensor
问题是:摄像头和解码器通常输出 YUV,而大量 AI 模型最终使用:
RGB / BGR
NCHW / NHWC
FP32 / FP16 / INT8
最简单的实现是:
NV12
 ↓
CPU YUV → RGB
 ↓
Resize
 ↓
Normalize
 ↓
Tensor
 ↓
AI
但这意味着 CPU 同时承担:
Color Convert
Resize
Memory Copy
Tensor Packing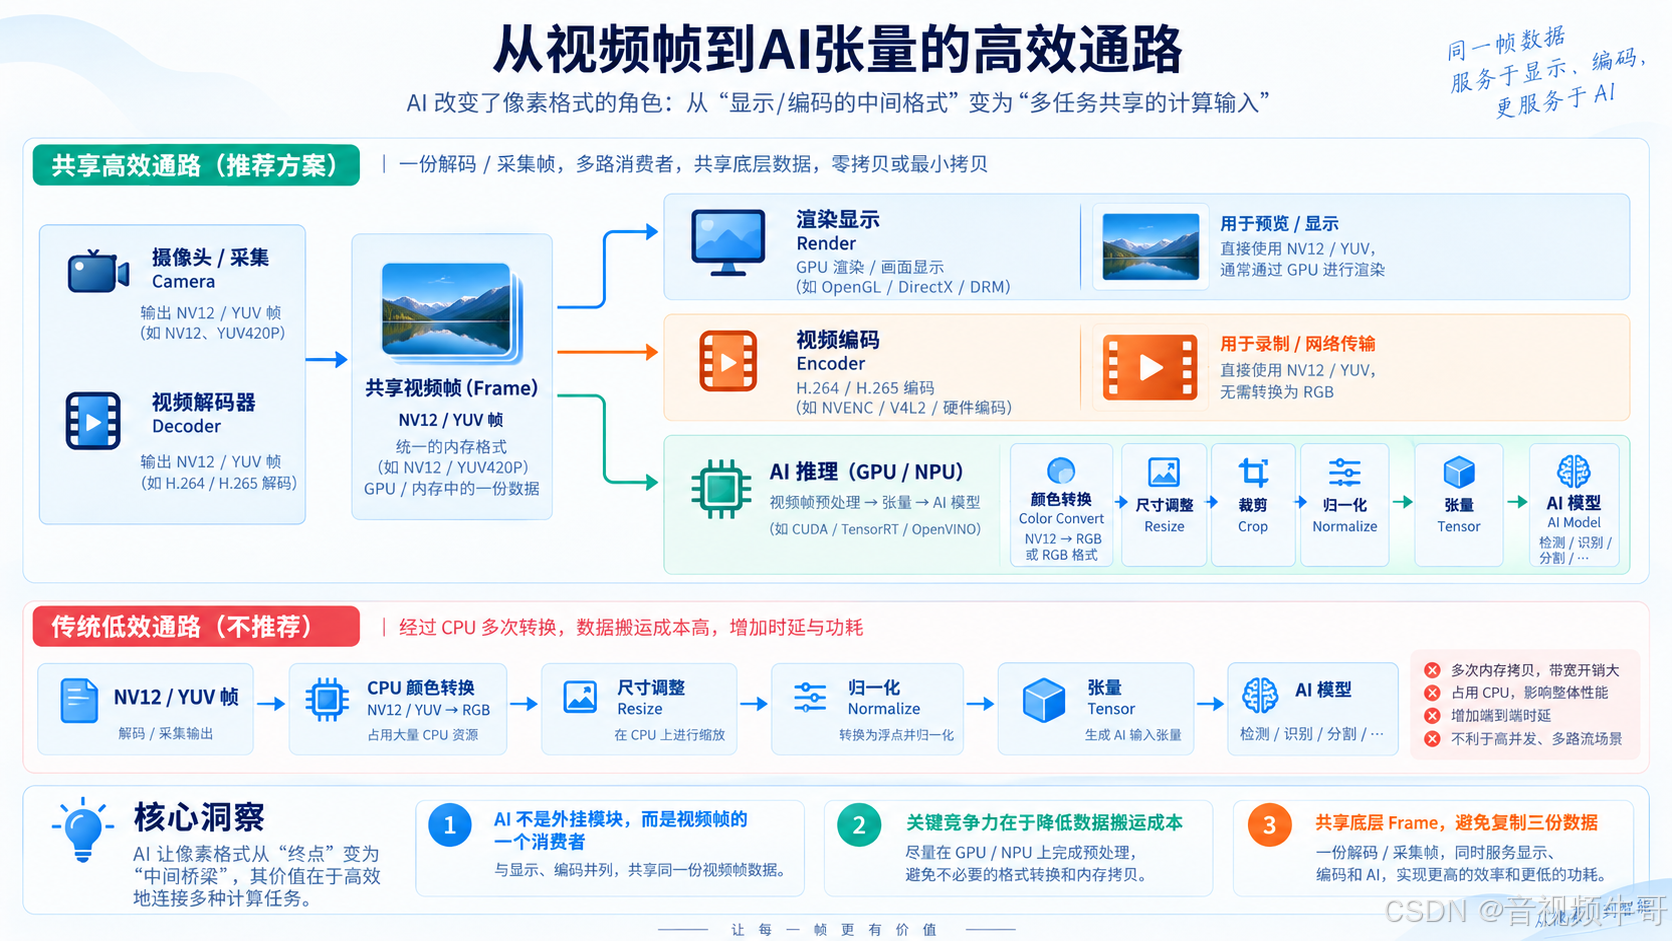
如果未来 SmartMediaKit 或 SmartMediaServer 接入目标检测、分割、OCR、人体姿态或者多模态视觉模型,更合理的架构应该考虑:
NV12
 ↓
GPU / NPU
 ↓
Color Convert
Resize
Crop
Normalize
 ↓
Tensor
甚至进一步:
                ┌→ Render
Decoder → NV12 ─┼→ Encoder
                └→ AI
也就是说,让一份底层视频资源同时服务:
Display
Encode
AI
而不是分别复制三份数据。
这样 AI 就不再是外挂在视频系统上的一个模块,而成为 Video Pipeline 的一个消费者。
这对实时音视频 SDK 的架构意义非常大,因为未来真正高效的视频 AI 系统竞争的,很可能不是"谁能调用更多 AI 模型",而是:
谁能以最低的数据搬运成本,把实时视频喂给计算单元。
九、从 SmartMediaKit 看未来:像素格式最终会演化成统一 VideoFrame 基础设施
随着 H.265、AV1、VVC、HDR 和 AI 的发展,8bit NV12 并不会消失,但系统需要逐渐支持更加复杂的数据形态。
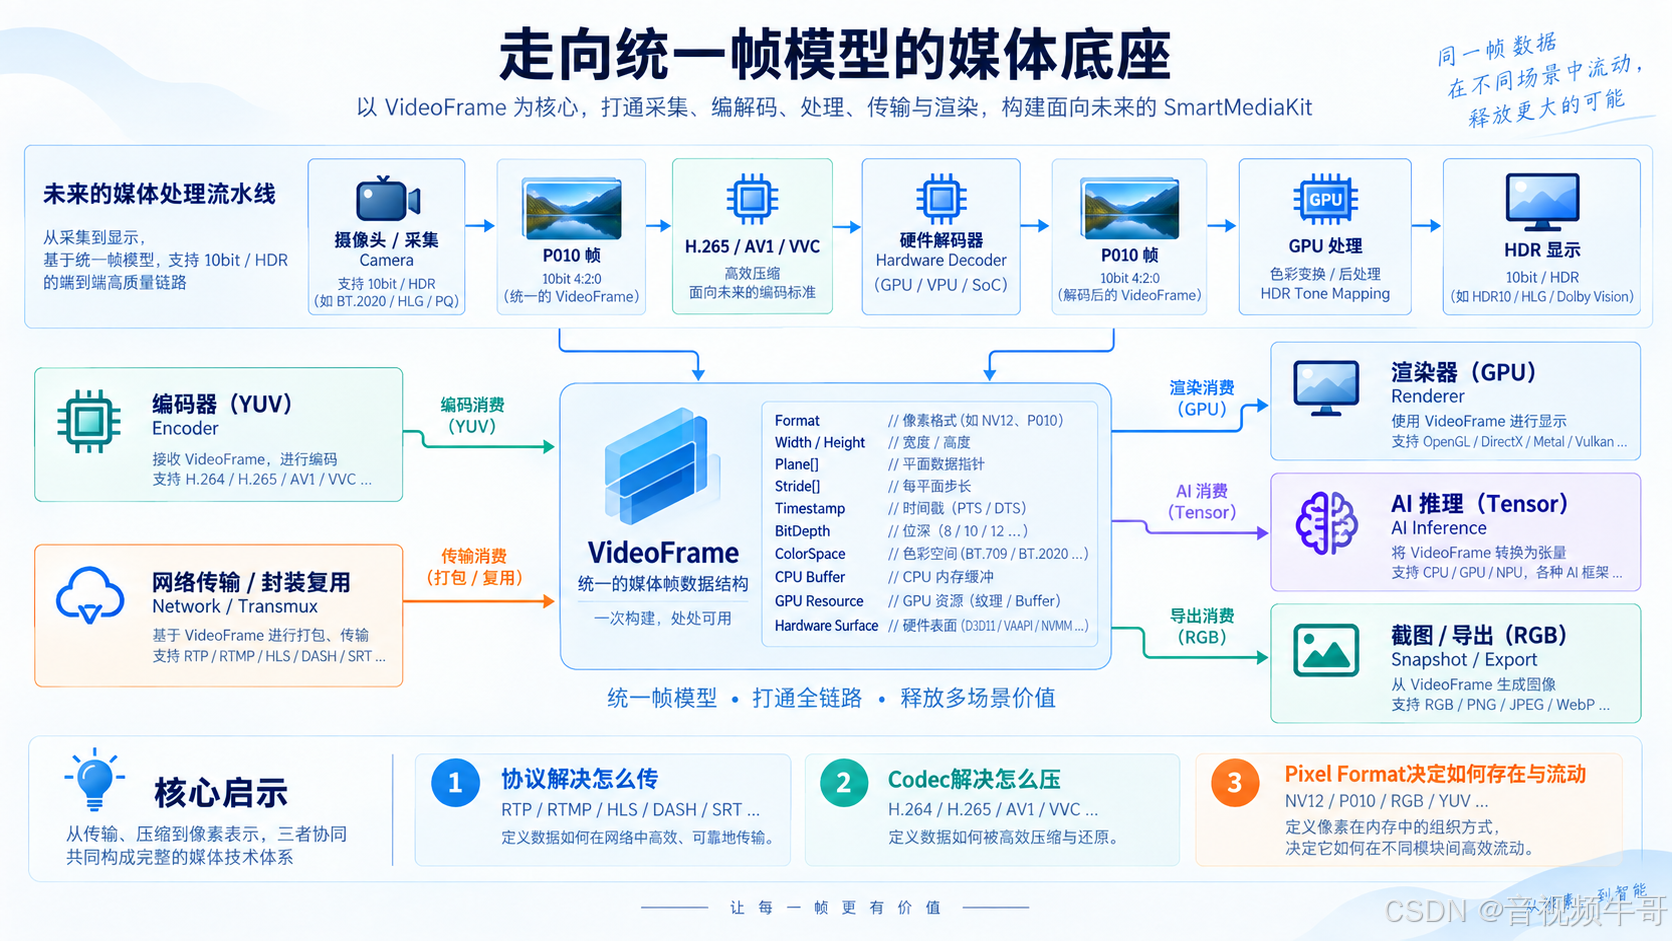
例如 P010,可以简单理解为与 NV12 类似的 Semi-Planar 10bit 视频格式:
Y Plane
UV Interleaved Plane
未来越来越典型的 Pipeline 会变成:
Camera
 ↓
10bit YUV
 ↓
P010
 ↓
H.265 / AV1 / VVC
 ↓
Network
 ↓
Hardware Decoder
 ↓
P010
 ↓
GPU
 ↓
HDR Display
如果系统内部仍然坚持:
Everything → RGB8那么即使编码器升级到了 VVC,视频 Pipeline 本身仍然停留在过去。
因此从 SmartMediaKit 的角度,未来比较理想的媒体基础层应该逐渐从:
YUV Callback
RGB Callback
提升为统一的:
VideoFrame其内部能够描述:
VideoFrame
 ├─ Format
 ├─ Width / Height
 ├─ Plane[]
 ├─ Stride[]
 ├─ Timestamp
 ├─ BitDepth
 ├─ ColorSpace
 ├─ CPU Buffer
 ├─ GPU Resource
 └─ Hardware Surface
上层不同模块根据能力选择不同访问方式:
                VideoFrame
                    │
       ┌────────────┼─────────────┐
       ↓            ↓             ↓
    Encoder       Renderer        AI
       ↓            ↓             ↓
      YUV          GPU          Tensor
如果业务需要截图,再做:
YUV / GPU → RGB如果只是播放,就没有必要把 Frame 拉回 CPU;如果只是转推,也没有必要走 RGB;如果 AI 可以直接消费 GPU Texture,也没有必要先生成 CPU RGB Buffer。
这才是一个成熟实时音视频基础设施真正应该追求的方向。
从表面看,我们讨论的是 YUV、NV12、NV21、RGB565;从更深层看,讨论的其实是实时视频系统的 Data Plane、Memory Architecture 和 Compute Architecture。
协议解决"视频怎么传",Codec 解决"视频怎么压缩",Pixel Format 决定的则是:
视频进入计算设备以后,以怎样的形态存在,又以多大的代价在 CPU、GPU、NPU、编码器和显示设备之间流动。
真正优秀的实时音视频系统,并不是"所有格式都能转",而是尽可能做到:
能保持原格式就不转换,能共享 Buffer 就不复制,能留在 GPU 就不拉回 CPU,让每一帧数据始终存在于最适合当前计算单元的位置。
这看起来只是 YUV 和 RGB 的问题,实际上却是现代实时音视频系统从"功能实现"走向"高性能基础设施"的分水岭。
📎 CSDN官方博客:音视频牛哥-CSDN博客