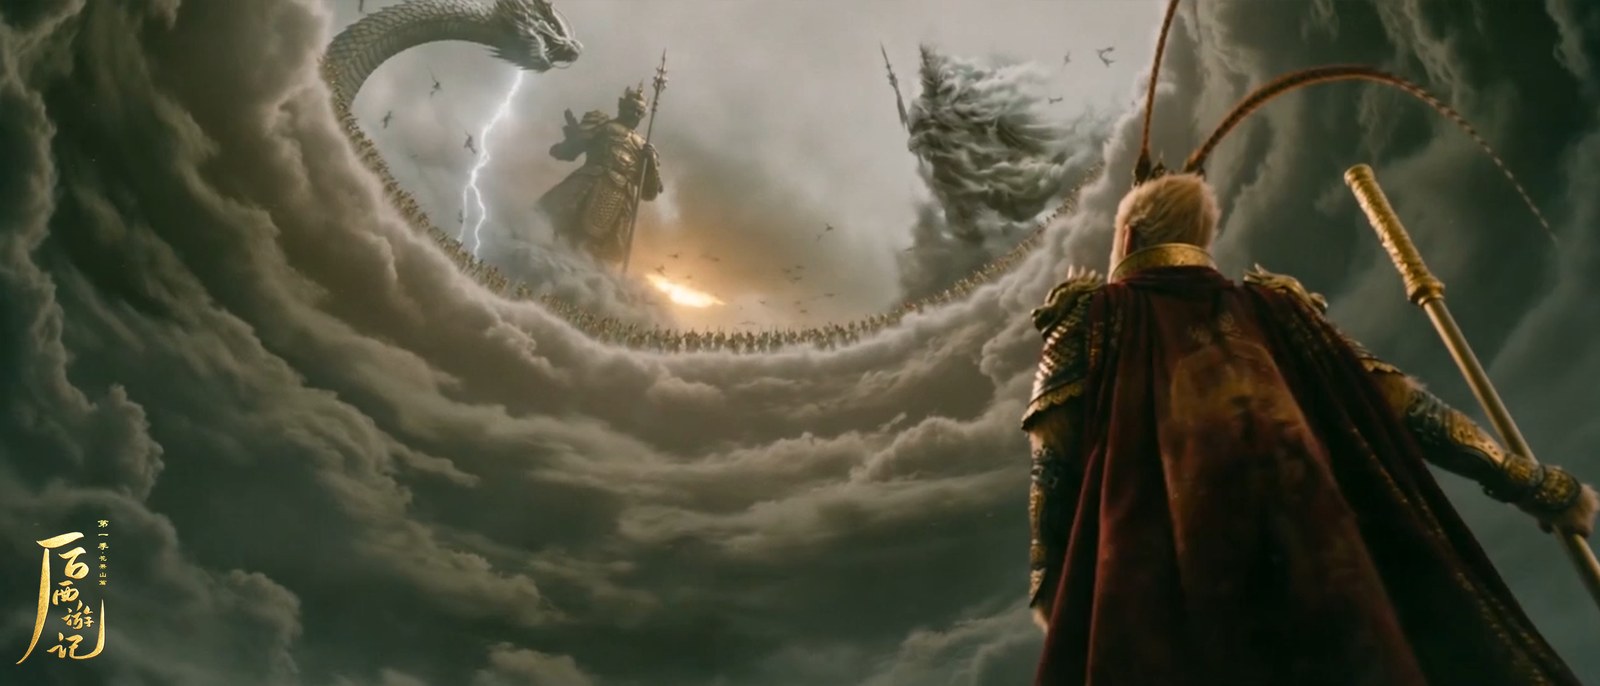
用视频生成模型做一条 15 秒短片,瓶颈在提示词。做一部 30 集、每集 40 分钟的长剧,瓶颈转移到了三个工程问题上------这三条落到实操里,就是从业者最常抱怨的「角色崩脸」「场景对不上」「镜头接不上」:
| 问题 | 表现形式 | 技术根因 |
|---|---|---|
| 角色漂移 | 同一角色跨镜头/跨集形象不一致 | 身份信息仅存在于文本提示词中,无语料锚点 |
| 场景漂移 | 同一空间不同机位不像同一处 | 缺少空间基准帧与光照参数的显式约束 |
| 镜头断点 | 相邻镜头拼接穿帮 | 各镜头独立生成,无帧级接续约束 |
这三个问题的共同点是:都不能在生成阶段解决,必须在生成请求构造之前完成约束设计。
下面按"资产层 → 生成层 → 校验层"三层给出可落地的方案,所有 API 参数以火山方舟上的 Seedance 2.0 / 2.5 为准。
1. 资产层:把角色和场景变成可引用的数据
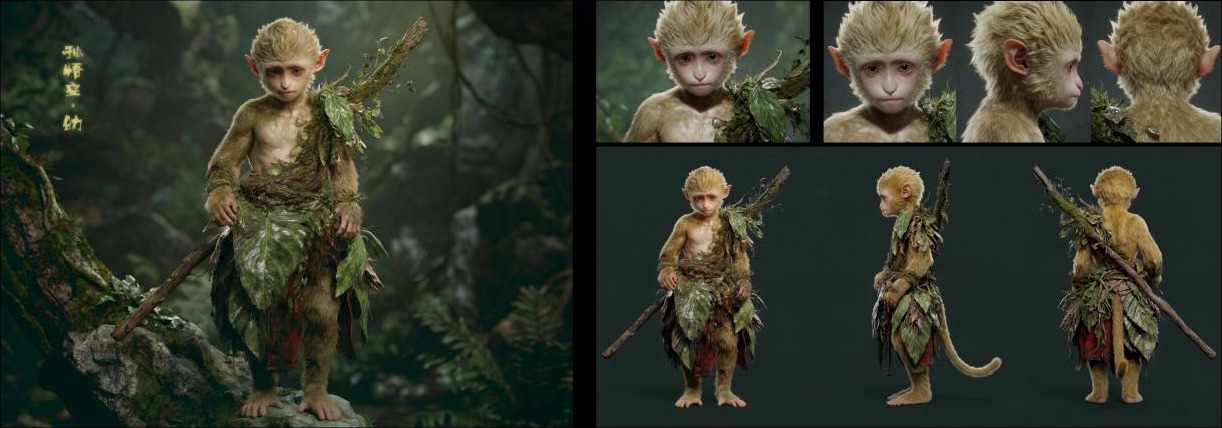
1.1 角色资产卡
{
  "role_id": "ROLE-002",
  "name": "孙小圣",
  "canon": "花果山再生石猴,号齐天小圣,孙悟空点化收服",
  "type": "主角",
  "refs": {
    "front": "assets/role/ROLE-002/front.png",
    "three_quarter": "assets/role/ROLE-002/tq.png",
    "profile": "assets/role/ROLE-002/side.png",
    "details": ["assets/role/ROLE-002/face.png", "assets/role/ROLE-002/tail.png"]
  },
  "prompt_block_id": "BLK-002",
  "skeleton_lock": true,
  "immutable": ["金箍", "虎皮裙", "猴尾(必显)", "猴型面骨"],
  "version": "v2.0",
  "status": "已入库"
}
immutable 字段是这个方案里最关键的设计。 它不是给美术看的,是给生成链路做前置校验用的------请求构造时必须逐项确认这些元素在参考图和提示词中都存在。
1.2 为什么"猴尾"是个必填项
一个真实的生产事故:某角色的设定图漏画了尾巴,导致该角色关键戏份的表演整体僵硬------同样的提示词、同样的模型版本、同样的操作人,产出质量突然劣化,排查耗时十天。
原因:模型把"没有尾巴的猴子"判定为人类演员扮演猴子,进而推断面部覆盖着假体,限制了大表情幅度。
结论:模型不读意图,只读输入。设定图缺失的元素不会触发报错,而会触发一次静默的语义推断。 这类问题必须在资产定稿环节用清单校验拦下来。
1.3 场景资产卡
{
  "scene_id": "SCN-001",
  "name": "花果山灵石崖",
  "base_frame": "assets/scene/SCN-001/base.png",
  "lighting": { "key": "东向45°", "cct": 3200, "ratio": "4:1", "direction": "左前" },
  "time_of_day": "晨曦",
  "coverage": ["大全景", "中景", "仰拍"],
  "status": "已入库"
}
2. 生成层:Seedance 能力矩阵与请求构造
2.1 能力速查
| 能力 | Seedance 2.0 | 说明 |
|---|---|---|
| 文生视频 / 图生视频(首帧) | ✓ | first_frame |
| 图生视频(首尾帧) | ✓ | first_frame + last_frame |
| 参考图 | ✓ | 最多 9 张,role: reference_image |
| 参考视频 | ✓ | 最多 3 条 |
| 参考音频 | ✓ | 最多 3 条,必须与图片或视频参考组合使用 |
| 返回尾帧 | ✓ | return_last_frame: true |
| 有声生成 | ✓ | generate_audio: true |
| 时长 | 4~15 秒 | 整型 |
| 分辨率 | 480p / 720p / 1080p / 4K(10bit) | --- |
| 宽高比 | 21:9 / 16:9 / 4:3 / 1:1 / 3:4 / 9:16 / adaptive | --- |
| 联网检索 | ✓ | 仅纯文本输入时可用 |
Seedance 2.5 额外支持 30 秒超长叙事与更大规模的参考素材。
限流参考(在线推理):非 4K 分辨率下,企业用户 RPM 600 / 并发 10,个人用户 RPM 180 / 并发 3;4K 分辨率下并发降至 1。
2.2 三层约束写进同一条请求
每个镜头的请求应当同时携带四类信息:
[主体]    角色身份块(逐字复用,来自 BLK-xxx)
[空间]    场景基准帧 + 场景锚定块 + 光位参数
[动作]    单镜只做一个主动作
[情绪]    A → B 的推进弧线,禁止单点情绪词
提示词结构建议固定为六段,逐镜只替换可变部分:
| 段位 | 内容 | 是否逐镜可变 |
|---|---|---|
| 1. 镜头目的 | 这场戏要达成什么 | 可变 |
| 2. 可见动作 | 画面里实际发生什么 | 可变 |
| 3. 景别与运镜 | 景别 + 单一运镜 | 可变 |
| 4. 空间与连续性锚 | 场景 ID + 基准帧 + 锚点物件 | 固定 |
| 5. 光照与色彩 | 光位、色温、色彩方向 | 固定 |
| 6. 结束帧 | 尾帧应停在什么画面 | 可变 |
第 4、5 段在同场景内必须逐字不变。这是场景一致性的最小成本保障。
2.3 首尾帧接戏链的代码实现
import os, time, requests

BASE = "https://ark.cn-beijing.volces.com/api/v3"
HEAD = {
    "Authorization": f"Bearer {os.environ['ARK_API_KEY']}",
    "Content-Type": "application/json",
}
MODEL = "doubao-seedance-2-0-260128"

CHAR_BLOCK = "石猴本体,金箍束发,虎皮短裙,保留清晰可辨的猴尾与猴型面骨,面部非人类假体。"
SCENE_ANCHOR = "花果山灵石崖:青灰岩体,苔痕斑驳,晨雾漫溢,东向暖金主光。"
LIGHT = "主光左前45°,色温3200K,光比4:1。"
NEGATIVE = "不改变角色身份、服装形制、道具形状、行进方向与光源方向。"

def build_prompt(action: str, shot: str, end_frame: str) -> str:
    """按六段式结构拼装提示词,4/5 段在同场景内保持逐字不变。"""
    return (
        f"{action}。{CHAR_BLOCK}\n"
        f"{shot},单一主动作,不做复合运镜。\n"
        f"{SCENE_ANCHOR}{LIGHT}\n"
        f"{NEGATIVE}\n"
        f"结束画面:{end_frame}。"
    )

def submit(prompt, first_frame=None, refs=(), duration=8, ratio="16:9", res="720p"):
    imgs = []
    if first_frame:
        imgs.append({"url": first_frame, "role": "first_frame"})
    imgs += [{"url": u, "role": "reference_image"} for u in refs]

    body = {
        "model": MODEL,
        "content": [{"type": "text", "text": prompt}]
        + [{"type": "image_url", "image_url": {"url": i["url"]}, "role": i["role"]} for i in imgs],
        "duration": duration,
        "ratio": ratio,
        "resolution": res,
        "generate_audio": True,
        "watermark": False,
        "return_last_frame": True,      # 关键:返回尾帧用于接戏
    }
    r = requests.post(f"{BASE}/contents/generations/tasks", headers=HEAD, json=body, timeout=60)
    r.raise_for_status()
    return r.json()["id"]

def poll(task_id, interval=8, timeout=600):
    """轮询任务;产物 URL 通常 24 小时内失效,成功后应立即下载。"""
    deadline = time.time() + timeout
    while time.time() < deadline:
        r = requests.get(f"{BASE}/contents/generations/tasks/{task_id}", headers=HEAD, timeout=30)
        data = r.json()
        if data["status"] in ("succeeded", "failed"):
            return data
        time.sleep(interval)
    raise TimeoutError(task_id)

def chain(shots):
    """逐镜接龙:上一镜尾帧 → 下一镜首帧。"""
    last_frame = None
    for s in shots:
        prompt = build_prompt(s["action"], s["shot"], s["end_frame"])
        task_id = submit(prompt, first_frame=last_frame or s.get("first_frame"),
                         refs=s["refs"], duration=s["duration"])
        data = poll(task_id)
        if data["status"] != "succeeded":
            raise RuntimeError(f"{s['shot_id']} 生成失败")

        download(data["video_url"], f"out/{s['shot_id']}.mp4")
        last_frame = data.get("last_frame_url") or last_frame
2.4 接戏链的两个工程约束
约束一:误差会累积。 每经过一次"尾帧→首帧"的重建,身份信息都会有一次有损压缩。建议不超过 3~4 段就回到角色资产卡的参考图重新锚定一次,而不是一条链走到底。
约束二:尾帧要挑,不要取。 视频的最后一帧往往是最差的一帧(运动模糊、半眨眼、口型停在中间)。生产上应当维护一个"干净帧选帧"步骤,而不是机械使用 last_frame_url。
2.5 批量生成的工程实践
长剧是要按"千镜"量级跑的,几个工程细节必须提前处理:
- 任务异步、需要轮询。 创建任务只返回
task_id,标准模型一个 15 秒任务通常需要 2~5 分钟完成。建议轮询间隔 8~15 秒,超时设 10 分钟,避免无谓的请求压力。 - 产物 URL 会失效。 生成的视频地址与尾帧地址都是签名地址,通常在 24 小时内过期。任务成功后必须立即下载落盘,否则第二天回来只剩一个死链------这是最常见的一类事故。
- 参考素材必须公网可达。 本地路径与内网地址不生效。生产环境应先把资产上传到对象存储,拿到可公开访问的地址后再提交任务。
- 并发受限,需要自建队列。 非 4K 分辨率下,个人用户并发 3 / RPM 180,企业用户并发 10 / RPM 600;4K 分辨率下并发降到 1。做批量抽卡时按并发上限做令牌控制,不要一次性打满触发限流。
web_search与参考素材互斥。 开启联网检索时只能传纯文本,同时携带图片/视频/音频会被直接拒绝。以资产驱动的长剧流程基本用不到这个开关。
2.6 抽卡率与成本核算
把"抽卡次数 / 通过数"写进台账并自动计算废片率,是排期与算力预算的直接依据。
一个经验规律:资产库完善之后,单镜头的可用率会显著提升。 前期可能需要几十条里挑一条,成熟阶段能降到几条里出一两条。这正是资产库建设的复利所在------它不只降低返工,还直接降低抽卡成本。
反过来说,如果某个场景的废片率长期居高不下,通常不是模型的问题,而是这个场景的资产没封好:要么缺基准帧,要么光位参数没写死,要么场景本身的细节复杂度超出了当前模型能稳定复现的范围。
3. 校验层:台账化与故障定位
3.1 镜头台账的字段设计
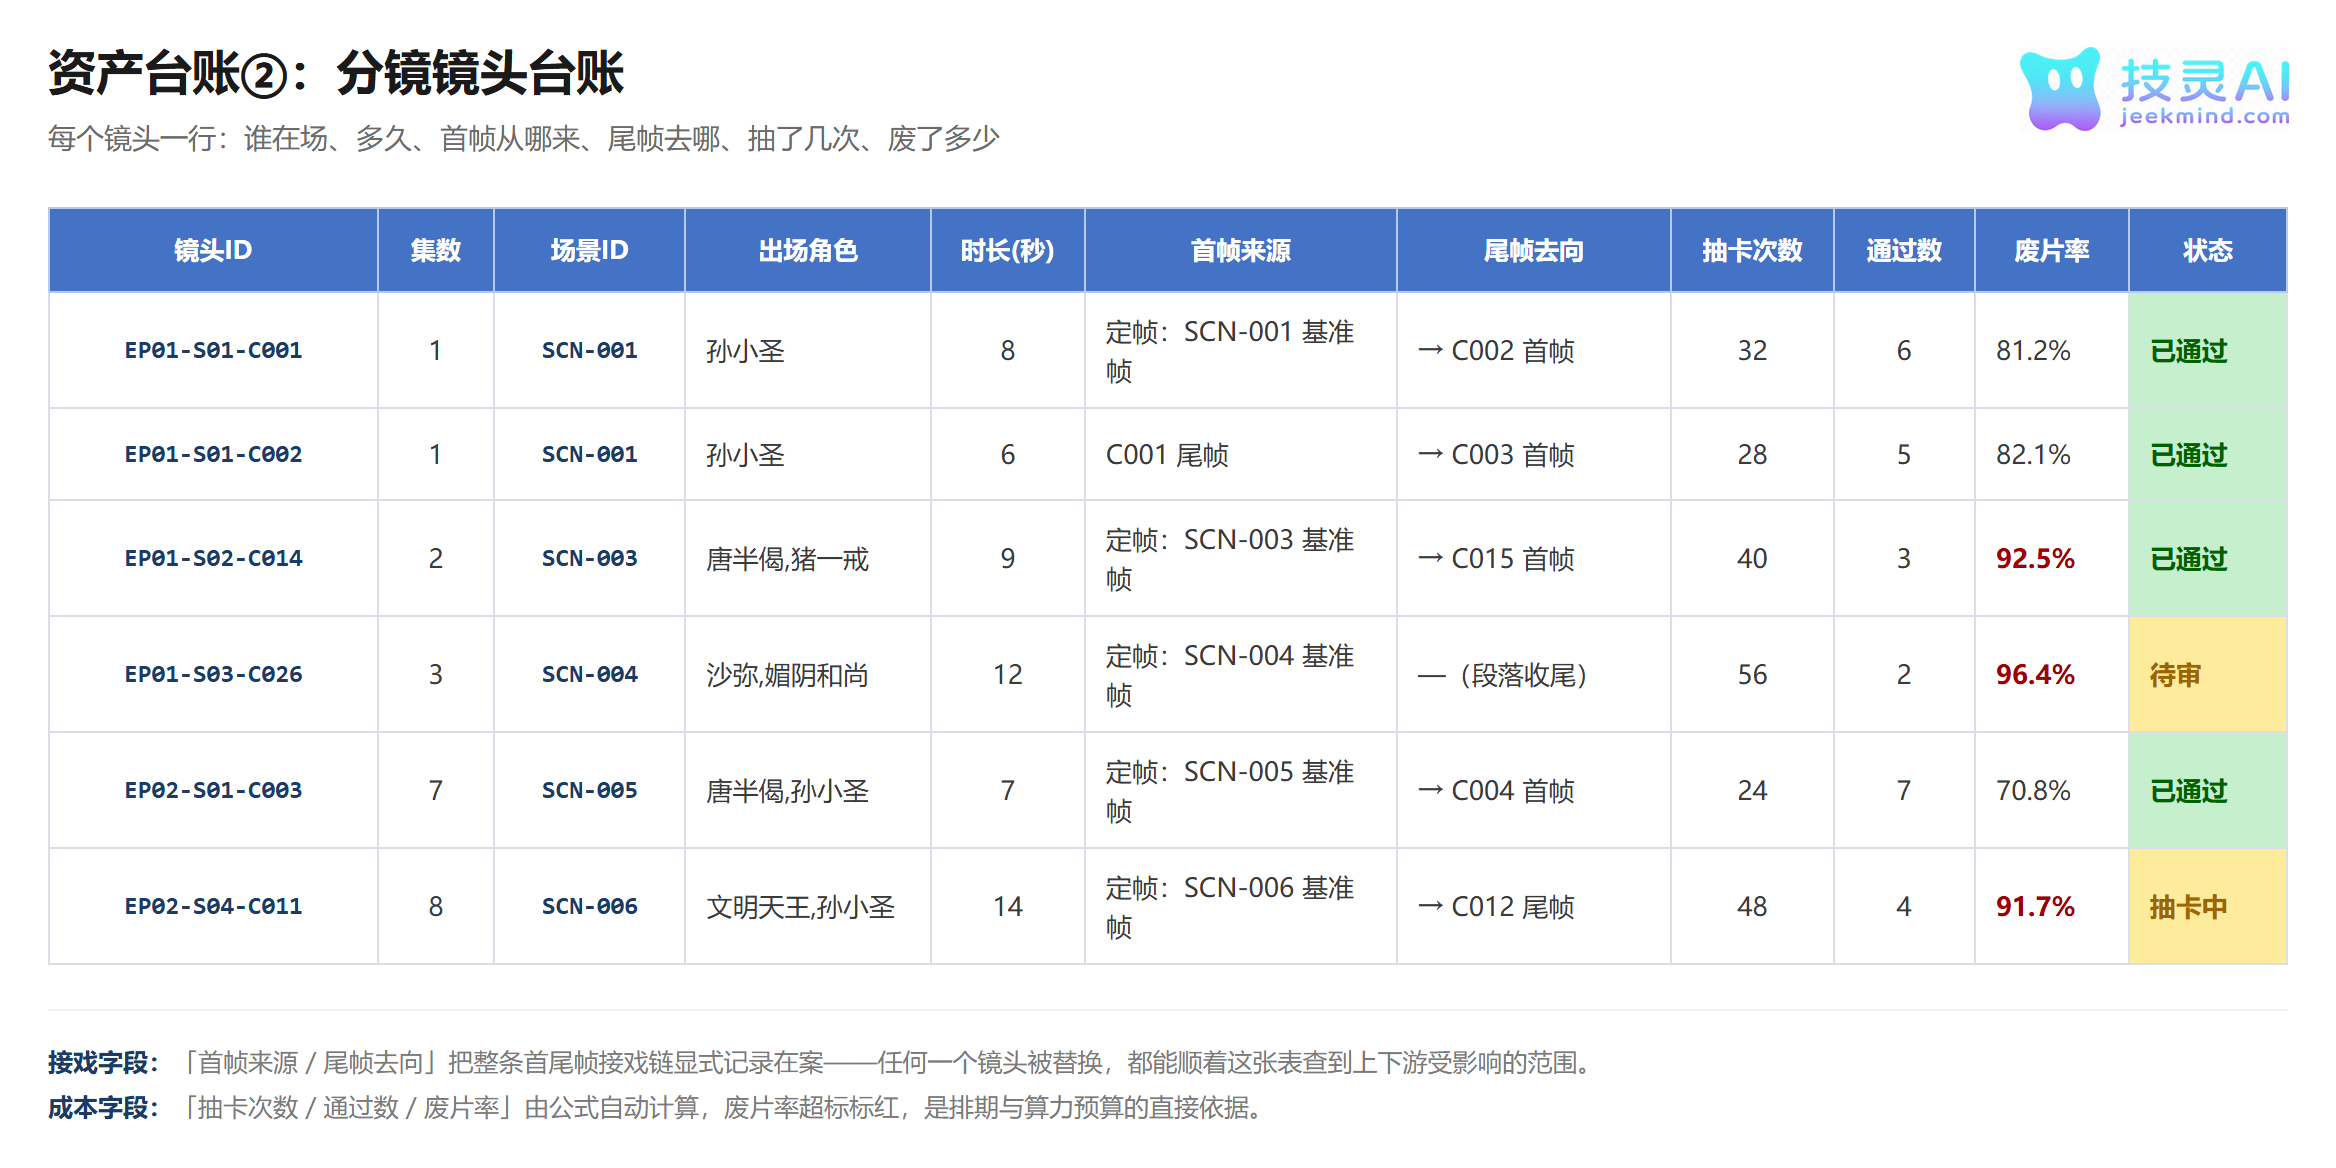
首帧来源 / 尾帧去向 两列是整条接戏链的拓扑记录。有了它,任何一个镜头被替换时都能直接算出上下游受影响范围,而不是全段落重做。
3.2 常见故障速查
| 现象 | 首查项 | 处置 |
|---|---|---|
| 面部漂移 | 参考图是否干净、角度是否够 | 补参考图,减少运动幅度 |
| 表演僵硬、表情受限 | 设定图是否缺关键特征 | 补全 immutable 清单中的元素 |
| 动作断裂 | 单镜是否叠加了多个动作 | 拆分为单主动作镜头 |
| 背景被替换 | 提示词是否过长导致过载 | 精简描述,强化场景锚定块 |
| 风格突变 | 画风块版本是否漂移 | 统一调色与颗粒,锁定画风块版本 |
| 身份/道具变更 | 是否发生过静默版本替换 | 已通过版本进白名单,禁止替换 |
3.3 目录结构建议
project/
├── assets/
│   ├── role/ROLE-002/{front,tq,side,tail}.png
│   └── scene/SCN-001/base.png
├── prompts/
│   └── blocks/BLK-002.txt        # 逐字复用,纳入版本管理
├── ledger/
│   ├── roles.csv                 # 角色资产卡
│   ├── scenes.csv                # 场景资产卡
│   └── shots.csv                 # 分镜镜头台账(含首尾帧拓扑)
└── out/
    └── EP01-S01-C001.mp4
提示词块必须进版本管理。 同义改写一次,角色的脸就可能漂一次------这类改动应该走 diff,而不是随手改。
4. 成本侧的观察
参考公开案例(30 集 AIGC 长剧,单集约 90 万元,算力成本约占总预算 1/5):
- 重资产环节(场景搭建、特效渲染)成本下降 80%+
- 制作周期较传统三维动画缩短 40%~70%
- 一段 3 分钟打戏:传统流程 300~400 万元 → 资产化流程不到 10 万元
降本不来自"生成得便宜",而来自"不用重复搭建"。 这也是为什么资产库的建设优先级要高于模型调参------前者是复利,后者是消耗。
5. 小结
| 层 | 交付物 | 关键约束 |
|---|---|---|
| 资产层 | 角色资产卡 / 场景资产卡 | 四件套齐全 + immutable 清单校验 |
| 生成层 | 六段式提示词 + 接戏链 | 参考图常驻、单主动作、4 段重锚 |
| 校验层 | 镜头台账 + 故障速查表 | 首尾帧拓扑可追溯、版本白名单 |
三层里最容易被跳过的是资产层,但它恰恰是唯一会产生复利的环节。
技灵AI 把上面这三层做成了产品能力:一站式 AI 内容生产平台,视频侧接入 Seedance 2.0 / 2.5、Wan 3.0 等模型,图片侧提供 Mimage、Seedream 5.0。
| 本文层级 | 技灵AI 对应能力 |
|---|---|
| 资产层 | 无限画布:节点式工作流,角色 / 场景 / 风格在同一项目内反复调用,多人协作沉淀资产 |
| 生成层 | 视频生成 :多档位接入 Seedance 系列,支持参考图与首尾帧;图片创作:Mimage / Seedream 5.0 |
| 校验层 | 视频解析 :自动拆解脚本结构与镜头语言;视频高清:生成后画质增强 |
对应的分镜与连续剧情能力,覆盖的正是本文第 2 节那条"定帧 → 生成 → 接戏"的链路。