GitHub Trending 三连观察:AI 编码智能体进入"周边生态"竞争阶段
开篇:一个反直觉的榜单现象
如果只看模型厂商的发布会,容易得出一个印象:Coding Agent 的进步主要来自更强的模型。但如果把观察视角移到开源榜单,会看到另一幅图景。
在掘金聚合的 GitHub 日榜中,2026-09-24 一期收录 17 个项目、合计新增约 7,826 star,综述原文称"本期近三分之一的项目是编码智能体的外挂件------技能、模板、代码记忆和 CLI 适配";前一日 09-23 一期收录 8 个项目、合计新增约 4,169 star,综述称"本期一半项目在给编码智能体补现成能力" 12。更早的 CSDN《GitHub 开源项目日报》中,2026-09-07 一期的主题是"AI 智能体开源生态霸榜",出现了 Context-mode、ECC 等项目;09-10 一期标题直接写作"AI 编码代理技能席卷本期榜单";09-11 一期的判断是"AI 编程 Agent 生态霸榜",Superpowers、GitHub Spec Kit、i-have-adhd 等均在列 345。
把这五次榜单放在一起看,出现频率最高的并不是某个新模型或某个新 IDE,而是一批"给编码智能体补能力"的周边件:技能(skills)、模板、代码记忆、上下文管理、CLI 配置统一工具,以及把软件工程方法论写成 Agent 规则的项目。
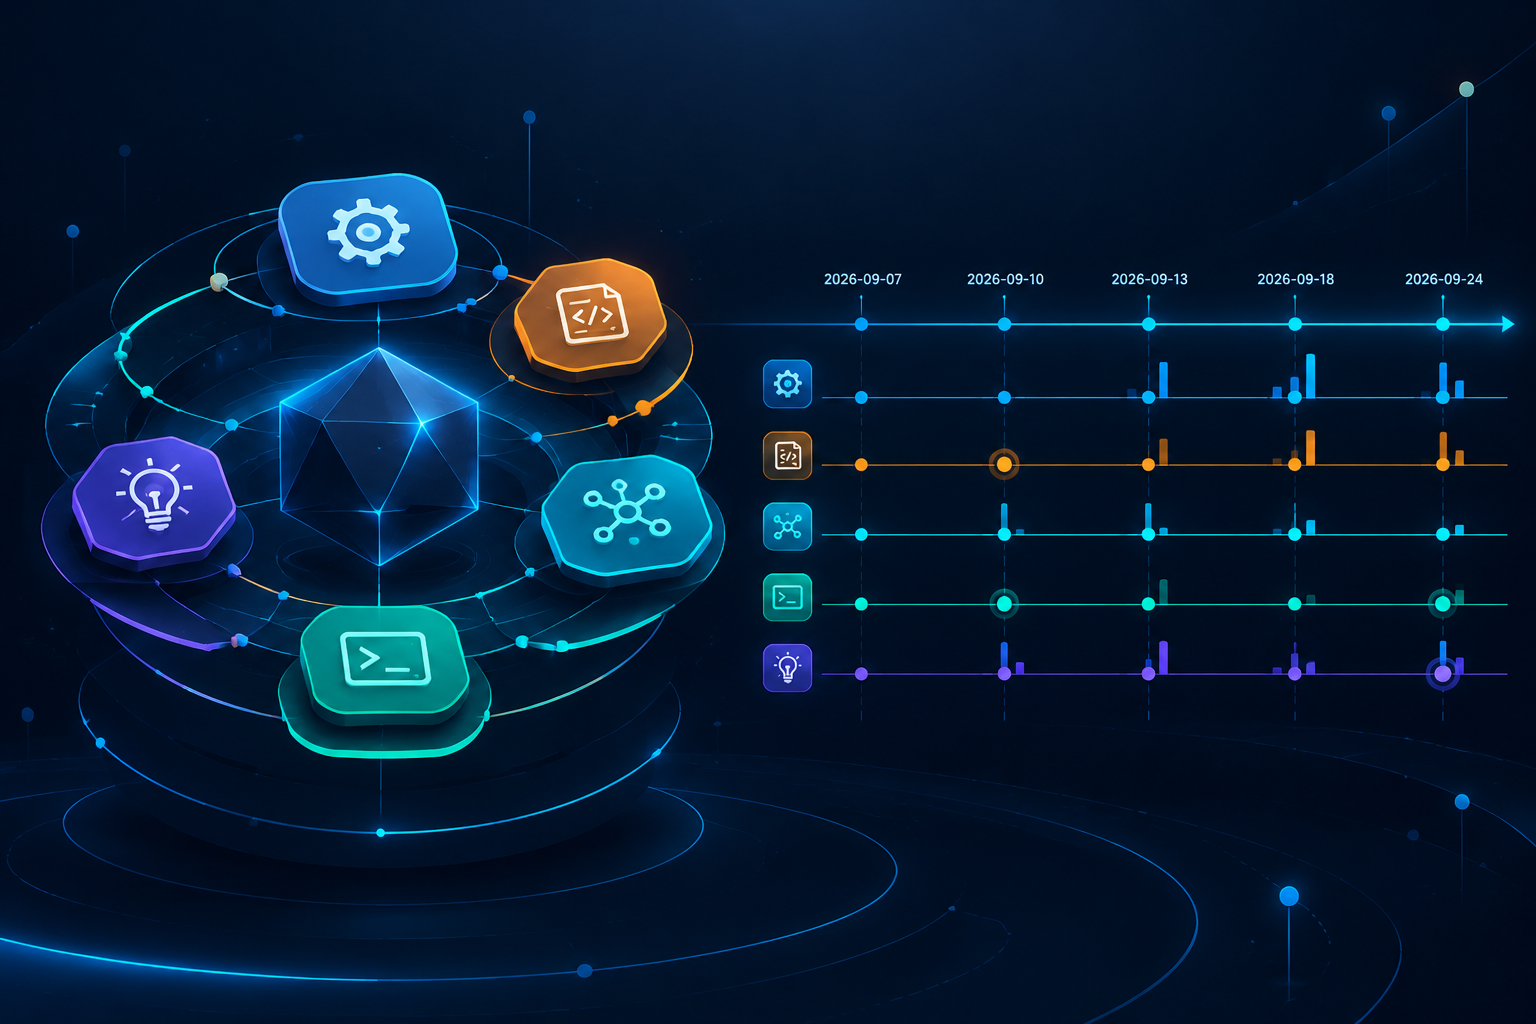
本文的判断是:Coding Agent 的竞争重心正在从"裸模型、裸 Agent"转向"能力外挂层"。这不代表模型能力不重要,而是说,当模型能力差距缩小、而团队真实痛点集中在上下文预算、配置碎片、知识沉淀和需求歧义上时,差异化竞争自然上移到模型之上的那一层。
需要先说明数据口径:掘金两篇日榜由自动聚合脚本整理 12,CSDN 三期日报也是基于 GitHub Trending 的二手汇总 345。其中"近三分之一""一半"属于榜单综述的描述性判断,本文保留原话引用,不自行折算精确百分比;个别星数存在明显冲突(后文有专门清单),因此不作为硬结论使用。
证据切片:五次榜单里到底出现了什么
掘金 09-23 与 09-24:外挂件占比快速上升
09-23 一期共 8 个项目,综述的判断是"一半项目在给编码智能体补现成能力";09-24 一期扩大到 17 个项目,综述称"近三分之一的项目是编码智能体的外挂件------技能、模板、代码记忆和 CLI 适配" 12。两期都出现了 anthropics/financial-services,该仓库被描述为面向金融服务场景的参考智能体、技能和数据连接器,覆盖投资银行、股票研究、私募和财富管理等场景 12。
这个项目值得单独一提:它不是模型,也不是通用 CLI,而是"参考智能体 + 技能 + 数据连接器"的打包形态,即面向一个行业预先组织好的能力外挂包。它进入 Trending 说明市场对"垂直场景开箱即用的能力组合"有明确需求。
CSDN 09-07:上下文与工程化两个方向浮现
09-07 一期中,Context-mode 被描述为"面向 AI 编码代理的上下文优化 MCP 服务器",ECC 被描述为"AI 编程智能体的性能优化与工程化系统" 5。这两类项目解决的不是"Agent 能不能写代码",而是"Agent 在真实仓库里能不能高效、稳定、可控地写代码"。
CSDN 09-10 与 09-11:技能与方法论集中登场
09-10 一期综述称榜单"几乎被 AI 编码代理生态占据",出现的项目包括:Superpowers(被描述为"用一套先澄清需求、再出设计、以 TDD 驱动子代理的方法论")、i-have-adhd(让编码助手先给答案的输出技能)、TeamAI(统一团队多款 AI 编码代理的配置与知识管理 CLI)4。09-11 一期延续这一格局,Superpowers、GitHub Spec Kit 与 i-have-adhd 再次出现 3。
分类归纳:五类"外挂件"
| 类别 | 代表项目(据榜单日报整理) | 主要解决的问题 | 典型形态 |
|---|---|---|---|
| 技能(skills) | i-have-adhd | 输出风格、交互习惯不符合开发者预期 | 技能包 / 提示规则 |
| 模板与代码记忆 | 掘金 09-24 综述提及的模板、代码记忆类项目 | 团队规范、历史代码知识无法沉淀复用 | 模板库、记忆库 |
| 上下文管理 | Context-mode | 上下文预算有限,噪声挤占关键信息 | MCP 服务器 / 上下文策略 |
| CLI 配置统一 | TeamAI-cli、ECC | 多款 Agent CLI 配置与知识重复维护 | 统一 CLI / 工程化系统 |
| 方法论外挂 | Superpowers、GitHub Spec Kit | 需求歧义、验收标准缺失导致返工 | 流程规则、规格驱动工作流 |
需要提醒:以上项目信息均据榜单日报整理,仓库归属、描述与实际功能以各仓库 README 为准。其中 ECC 的完整仓库名在来源中被截断(affaan-...),本文不补全猜测;TeamAI-cli 在来源中被标注为 Tencent/teamai-cli 4,其组织归属、支持的 CLI 范围与许可证均应回 GitHub 原始页面核对。
为什么竞争重心会转移:三个结构性原因
原因一:差异化上移到"怎么用"
笔者的观察是:主流模型在常规编码任务上的差距正在收窄,团队实际遇到的瓶颈越来越多地落在"怎么把模型用好"------给多少上下文、如何组织提示、如何保证结果可复现、如何避免返工。这些都不是换一个更强模型就能自动解决的问题。
需要强调,这一判断属于基于榜单现象的分析推断,并非来自官方 benchmark 数据。同期背景材料中,DeepSeek Harness 以 MIT 协议开源、支持所有 OpenAI 兼容端点 6,OpenSquilla 强调"多模型 agentic routing"并支持 Agent2Agent 协议 7,都从侧面说明"模型绑定"正在弱化、"如何编排模型"正在变强。这些仅作旁证,本文不展开。
原因二:团队痛点是配置与知识碎片化
一个团队同时使用多款编码 Agent CLI 是常见状态。每款 CLI 有自己的规则文件、记忆机制、技能格式,结果是同一套团队规范要写 N 遍、改 N 遍,版本随时间漂移。TeamAI-cli 的存在动机------"统一团队多款 AI 编码代理的配置与知识管理" 4------正是对这个痛点的直接回应。
配置碎片化的成本是隐性的:它不出现在单次开发体验里,却会在团队规模扩大、人员流动、Agent 工具换代时集中爆发。
原因三:外挂件可迁移、可复用、可审计
技能、模板、规格文档、方法论规则本质上是"文本资产",不绑定单一模型。这带来三个优势:换模型时可以迁移;跨团队可以复用;发生问题时可以 diff、review、回滚。相比之下,绑定某一家模型的黑盒插件在可审计性上天然吃亏。
这也解释了为什么"方法论外挂"会受欢迎:它把工程经验以可读、可版本化的形式固化下来,而不是依赖某个模型的即兴发挥。
外挂件地图:五类能力逐一拆解
技能(skills):让 Agent 按你的方式输出
以 i-have-adhd 为例,榜单日报将其描述为"让编码助手先给答案的输出技能",即通过一个小型技能包调整 Agent 的输出习惯:先给结论,再展开解释 34。这类技能的特点是小而专,解决的是交互体验问题,而非能力问题。
它的价值在于成本极低、见效快;局限也很明显:技能过多会互相冲突,且会占用上下文预算。其技能声明格式与生效机制需以目标 Agent 的官方规范为准,本文不虚构具体格式。
模板与代码记忆:把团队知识变成可加载资产
掘金 09-24 综述把"模板"和"代码记忆"列为外挂件的重要组成 1。两者解决的是同一个问题:团队里已经存在的知识------项目约定、架构模式、历史决策、易错点------如何让 Agent 每次都能用上。
需要区分两层:个人偏好 (代码风格、注释习惯)适合做个人记忆;团队规范(分层规则、安全红线、提交约定)适合做模板与共享记忆。混在一起会让记忆库迅速膨胀且难以维护。
上下文管理:把"上下文卫生"当工程问题
Context-mode 被描述为面向 AI 编码代理的上下文优化 MCP 服务器 5。它所处的问题域是:上下文窗口是有限资源,塞进去的每一段内容都在挤占模型对关键信息的注意力。
工程界已经形成一些共识性做法,例如分层上下文(将会话状态与工作上下文分离)、最小权限(每个子代理只看到任务所需内容)、定期清理过期上下文 8。这些实践与 Context-mode 这类工具的目标是一致的:把上下文管理从"随手粘贴"变成可配置、可观测的工程环节。
CLI 配置统一:TeamAI-cli 与 ECC
TeamAI-cli 的定位是统一团队多款编码 Agent 的配置与知识管理 4;ECC 被描述为编码智能体的性能优化与工程化系统 5。两者的共同点是把视角从"单个开发者与单个 Agent"抬升到"团队与工具链"。
配置示意结构如下(仅为说明思路的骨架,实际格式以各工具官方文档为准):
text
team-config/
├── shared-rules/        # 团队级规则,一次性维护
│   ├── code-style.md
│   └── security.md
├── knowledge/           # 共享知识与模板
└── adapters/            # 各 Agent CLI 的适配映射
    ├── agent-a.yaml
    └── agent-b.yaml
核心收益是"一处维护、多处生效"。代价是引入了一层抽象:适配映射需要随各 CLI 版本更新而维护,且并非所有 Agent 的配置项都能无损映射。
方法论外挂:Superpowers 与 GitHub Spec Kit
这类外挂不改 Agent 的能力,改的是 Agent 的工作流程。Superpowers 被描述为"用一套先澄清需求、再出设计、以 TDD 驱动子代理的方法论" 4,GitHub Spec Kit 则代表规格驱动路线 34。两者值得单独深挖,见下一节。
深度案例 A:Superpowers ------ 把软件工程方法论装进 Agent
流程拆解
据 CSDN 日报的描述,Superpowers 的工作流大致是:先澄清需求,再出设计,然后以测试驱动(TDD)组织子代理写代码 4。与"直接让 Agent 写代码"相比,它把两个环节前置了:需求澄清 和测试先行。
这个顺序并非新发明,它与传统软件工程中的需求分析、测试驱动开发一脉相承。新鲜之处在于:它被包装成 Agent 可以执行的规则,从而把人的工程纪律变成 Agent 的默认行为。
为什么有效
编码任务的返工,很多时候不是因为代码写不出来,而是因为一开始就不知道要写什么。把需求澄清前置,可以在动手前消除歧义;把测试前置,等于先定义验收标准,Agent 的每一步都有可验证的目标。
这一思路与行业中对 Agent 质量的评估视角呼应:有报道称 OpenClaw 2.0 以"返工率"作为区分"能写代码的 Agent"和"能写好代码的 Agent"的关键指标 9。返工率下降往往不靠更强的生成能力,而靠更清晰的输入与更明确的验收。
与 GitHub Spec Kit 的对照
| 维度 | Superpowers | GitHub Spec Kit |
|---|---|---|
| 核心定位 | 给编码代理装上软件工程方法论 4 | 规格驱动(SDD)路线 34 |
| 介入阶段 | 需求澄清、设计、TDD、编码全程 | 偏向规格先行与受控实施 |
| 形态 | 方法论/规则包(榜单标注语言为 Shell) | GitHub 官方项目,具体形态待核实 |
| 适用规模 | 多人协作、长周期项目更受益 | 需要可审计交付的项目更受益 |
关于 SDD 的具体实践,一篇 AICoding 工程化文章描述了"提案---对齐---受控应用---知识固化"的四步流程:生成变更骨架、人工审阅规格、对照任务清单实施、将结果归档为标准规格文档 8。这条路径的价值在于可审计、可回滚,代价是前期流程成本更高。
需要注意:Superpowers 在来源中被标注的星数(约 28 万)数量级异常 3,本文不引用该数字作为事实;GitHub Spec Kit 的官方仓库名与具体工作流命令在给定来源中没有完整记录,此处不做补写。
适用边界
方法论外挂并非万能。对于一次性脚本、原型验证、个人小工具,强制"先澄清需求再写测试"反而会显著拖慢节奏。它更适用于:需求复杂、多人协作、生命周期长、错误成本高的项目。判断标准可以简化为一句话:如果这个需求写错了需要返工两天以上,就值得花二十分钟澄清和写测试。
深度案例 B:TeamAI-cli 与 Context-mode ------ 工程化的两块地基
痛点场景
一个典型团队同时使用两款以上编码 Agent。A 的规则写在一种配置文件里,B 的写在另一种;团队的代码规范在两边各存一份;某次规范更新只改了 A 的那份,B 的 Agent 于是持续产出不符合新规范的代码。这类问题不会立刻暴露,但会持续累积。
配置统一与上下文管理
TeamAI-cli 的定位正是解决"配置与知识各写一套"的问题 4;ECC 则从性能优化与工程化角度切入 5。Context-mode 关注另一半问题:即使配置统一了,什么内容进入上下文、什么内容外置为记忆,仍然决定 Agent 的实际表现 5。
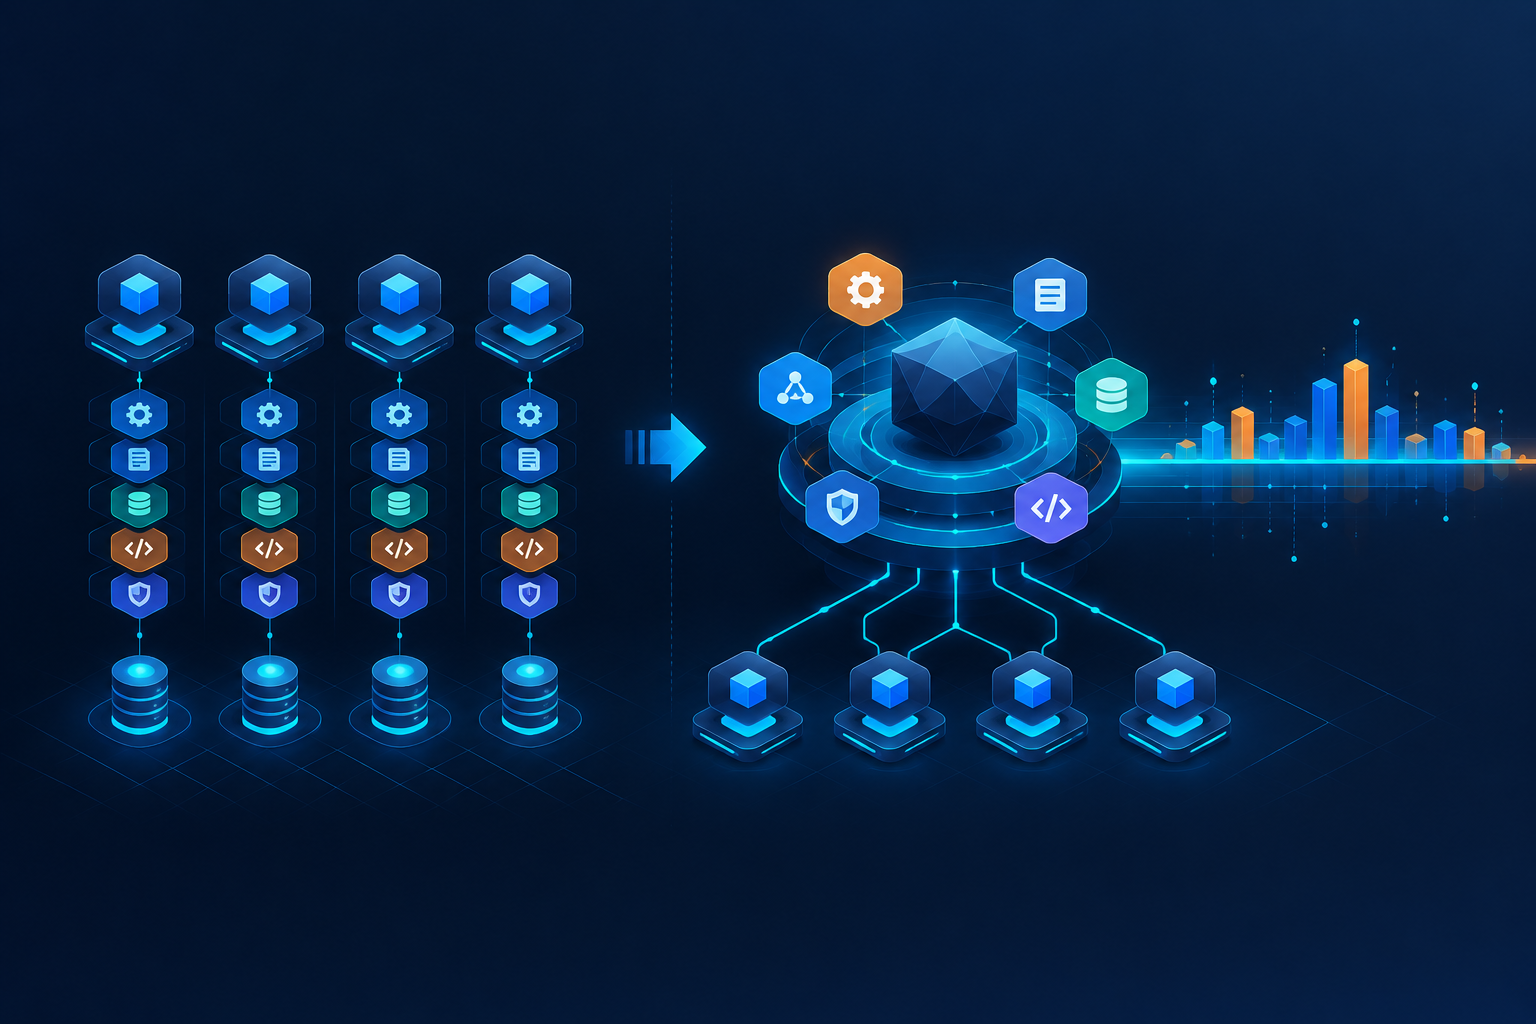
作为"企业级外挂打包形态"的例子,anthropics/financial-services 提供的是面向金融场景的参考智能体、技能和数据连接器 12------即把配置、技能、数据接入按行业预先组织好。这类形态的价值在于落地快,代价是需要评估其对特定厂商生态的依赖程度。
开发者选型建议
按场景选型
| 场景 | 优先引入 | 次优先 | 通常不必 |
|---|---|---|---|
| 个人效率 | 1--2 个技能类外挂 | 输出/交互习惯规则 | 统一 CLI 层 |
| 小团队规范 | 模板与共享记忆 | 方法论外挂(视项目复杂度) | 行业打包方案 |
| 企业级治理 | CLI 配置统一 + 上下文管理 | 行业参考智能体包、SDD 流程 | 一次性随意技能 |
七项评估清单
| # | 检查项 | 关注点 | 实际核查结果 |
|---|---|---|---|
| 1 | 是否绑定单一模型/CLI | 换模型时能否迁移 | 待填 |
| 2 | 是否需要外网或数据外发 | 内部代码是否离开边界 | 待填 |
| 3 | 许可证与商用性 | 能否用于商业项目 | 待填 |
| 4 | 上下文开销 | 加载后占用多少上下文预算 | 待填 |
| 5 | 可审计/可回滚 | 规则是否可读、可 diff、可回退 | 待填 |
| 6 | 维护活跃度与社区 | 提交频率、issue 响应、文档质量 | 待填 |
| 7 | 与已有外挂是否冲突 | 规则重复或相互矛盾 | 待填 |
常见误区
第一,把"星数高"等同于"适合我"。榜单热度反映的是关注度,不是你的场景匹配度,本文涉及的星数本身还存在数据冲突(见文末清单)。第二,把方法论外挂当万能药,对小任务强加重流程只会降低效率。第三,一次性装满技能,导致上下文爆炸、规则互相打架------外挂件的数量应以"每个都能说清为什么装"为上限。
参与生态:从消费者到贡献者
路径一:把团队经验沉淀为 skill 或模板
i-have-adhd 这类"小而专"的技能 34 展示了一个低门槛形态:从你自己反复重复的规则出发------比如"先给结论再解释""所有 SQL 必须带索引说明"------做成可加载的技能或模板并开源。先解决自己的问题,再考虑通用性。
一个最小技能包的示意目录(格式以目标 Agent 官方规范为准):
text
my-skill/
├── SKILL.md          # 技能声明:名称、触发条件、规则正文
└── examples/         # 正例与反例
路径二:做基准与评测
当前生态最缺的不是又一个技能,而是可度量的比较。OpenClaw 2.0 讨论中提到的"返工率" 9 是一个方向;还可以关注上下文命中率(注入的信息有多少真正被使用)、一次通过率、规则遵守率等指标。把评测数据和方法公开,比做一个新插件更有长期价值。
路径三:参与统一层
配置、记忆、上下文这三层的技术门槛更高,但复用价值最大。参与这类项目需要理解多款 Agent CLI 的配置差异,适配成本不低,可一旦形成事实标准,收益也是全生态的。
开源前自查
- 项目名称、仓库 owner、描述是否与 GitHub 原始页面一致;
- 引用的榜单数据是否标注了来源与日期;
- 星数等易变指标是否需要核对,或干脆不写;
- 是否把二手转述(媒体报道、日报综述)当作一手事实;
- 许可证是否明确,示例代码是否标注了"以官方文档为准";
- 是否存在来源截断、名称不确定的内容,宁可留待核实也不猜测补全。
结语:从"谁更聪明"到"谁更可靠"
五次榜单窗口里反复出现的不是更强的模型,而是技能、模板、记忆、上下文、配置与方法论。这不是模型竞争的终结,而是竞争维度的转移:当模型能力趋同,可靠性、可复用性与可审计性成为新的稀缺品。
接下来可以盯三个信号来验证或证伪这一判断:其一,外挂类项目是否持续出现在 Trending 榜单,而非昙花一现;其二,是否出现跨 Agent 的统一技能/记忆规范,终结当前各写一套的割据状态;其三,方法论外挂是否进入企业工程标准------产业侧已有呼应,如 GienCoder 的"四阶十二步"智能软件工厂把软件生产流程化 10、火山引擎 AgentKit 入选智能原生软件标杆实践 11,说明"工程化"正在从开源社区的语言变成采购语言。
对开发者而言,务实的策略是:先看清自己的真实瓶颈在技能、上下文还是流程,再引入一到两个外挂件做小范围验证,用返工率和一次通过率判断收益,最后决定是否扩大。竞争的重心变了,选型的重心也该跟着变。
附:投稿前待核实事实清单
| # | 事项 | 风险等级 | 处理建议 |
|---|---|---|---|
| 1 | anthropics/financial-services 星数在 09-23 与 09-24 两期中出现 25,843 → 49,928 的跳变,且 25,843 与 video-use 星数重合 | 高 | 疑为聚合脚本串行错误,正文不引用具体星数 |
| 2 | Superpowers 被标注为约 28 万星 3 | 高 | 数量级异常,须回 GitHub 原始页核对 |
| 3 | 各来源时间戳与文章 ID 存在不一致 | 高 | 按相对时效表述,慎用绝对日期 |
| 4 | ECC 完整仓库名在来源中被截断(affaan-...) |
高 | 不补全猜测,回原文核对 |
| 5 | TeamAI-cli 的组织归属、支持的 CLI 范围、许可证 | 中 | 以仓库 README 与 LICENSE 为准 |
| 6 | GitHub Spec Kit 的官方仓库名与工作流命令 | 中 | 来源未提供细节,禁止凭印象补写 |
| 7 | Context-mode 是否为 MCP 服务器及具体接入方式 | 中 | 来源描述如此,接入前核对官方文档 |
| 8 | 掘金"近三分之一 / 一半"的统计口径 | 中 | 保留原话,标注为榜单综述观点 |
| 9 | 各项目许可证(Coze 系 Apache 2.0、DeepSeek Harness 为 MIT 均来自二手来源) | 中 | 逐个核对仓库 LICENSE 文件 |
| 10 | 来源多为二次聚合 | 中 | 重要结论处补官方 README / Release Notes |
参考资料
1 GitHub 热榜项目:日榜(2026-09-24)本期共收录 17 个热门开源项目,合计新增 ⭐ 7,826 star,掘金,https://juejin.cn/post/7689030007914496046
2 GitHub 热榜项目:日榜(2026-09-23)本期共收录 8 个热门开源项目,合计新增 ⭐ 4,169 stars,掘金,https://juejin.cn/post/7688531869450780710
3 GitHub 开源项目日报 · 2026 年 9 月 11 日 · AI 编程 Agent 生态霸榜,CSDN 博客,https://blog.csdn.net/xiaoquqi/article/details/165179816
4 GitHub 开源项目日报 · 2026 年 9 月 10 日 · AI 编码代理技能席卷本期榜单,CSDN 博客,https://blog.csdn.net/xiaoquqi/article/details/165179368
5 GitHub 开源项目日报 · 2026 年 9 月 7 日 · AI 智能体开源生态霸榜,CSDN 博客,https://blog.csdn.net/xiaoquqi/article/details/164698936
6 DeepSeek Harness 开源:88 页论文背后的 Agent 野心,CSDN 博客,https://blog.csdn.net/DQQzero/article/details/163785039
7 多模型协作新范式:OpenSquilla 登顶 DRACO 榜单,CSDN 博客,https://blog.csdn.net/XuJL89/article/details/162824626
8 AICoding 工程化:从模型崇拜到规格驱动的实践,CSDN 博客,https://blog.csdn.net/weixin_33624741/article/details/162922541
9 OpenClaw 2.0 发布:302k 星的 Agent 迎来"蜕壳"大更新,CSDN 博客,https://blog.csdn.net/m0_65803419/article/details/165201046
10 中电金信:源启·GienCoder 智能软件工厂把软件生产从"手艺活"变成"工程化",CSDN 博客,https://blog.csdn.net/zhongdianjinxin/article/details/161680353
11 火山引擎 AgentKit 获评中国信通院 2026 智能原生软件"银弹"标杆实践,CSDN 博客,https://blog.csdn.net/volcenginetod/article/details/165889509
12 github-trending-2026-09-13:GitHub Trending 冻结快照(16 仓库),GitHub,https://github.com/jalliance/github-trending-2026-09-13
13 trending-collection:GitHub Trending 静态 JSON/RSS API + 历史归档,GitHub,https://github.com/hanishrao/trending-collection