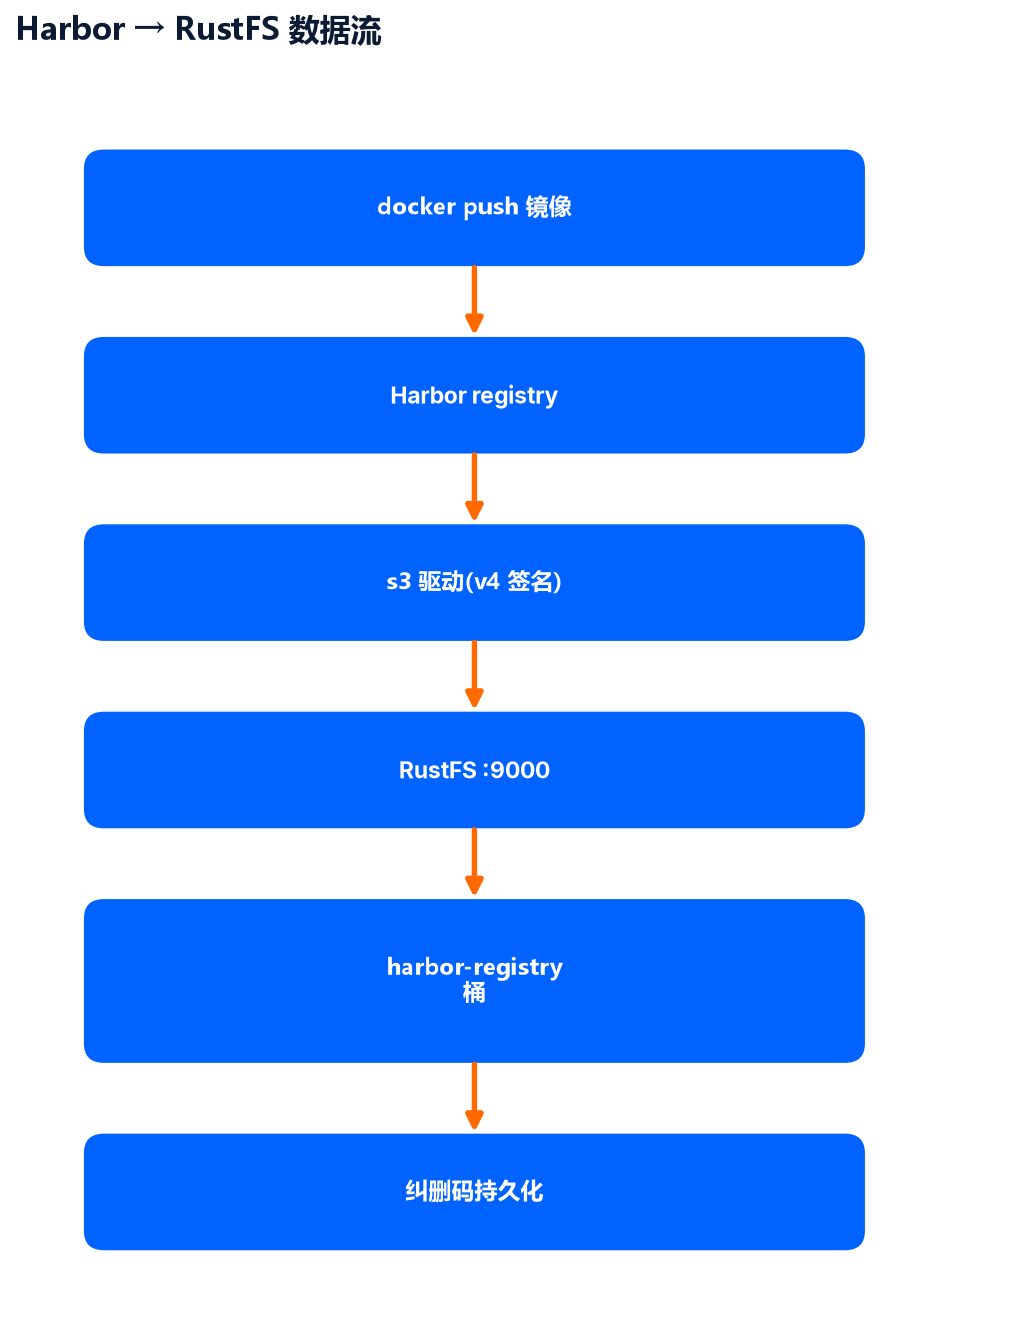
不少团队的 Kubernetes 边上跑着 Harbor 存镜像,另有一套对象存储存 AI 训练数据,两套存储栈各管各的:Harbor 用本地盘或 NFS 挂 /data,对象存储单独养。结果一边磁盘报警,一边对象存储利用率才三成。其实 Harbor 的 registry 存储原生支持 S3 兼容驱动,只要把后端指到现有对象存储,镜像 blob 就直接落进去,容量、冗余、备份都跟着对象存储走。
下面用一份能直接抄的 harbor.yml,把 Harbor 的存储后端切到自建 S3 端点,并说清专用账号、签名版本和验证这几道关。
为什么让 Harbor 用对象存储后端
Harbor 的 storage_service 可以选 filesystem(默认,挂本地盘)或 s3(兼容 S3 的对象存储)。切到 S3 之后:
- 容量跟着对象存储走。不用再给 Harbor 节点单独扩盘,纠删码池多大,镜像仓就能用多大。
- 一套存储栈服务多个系统。Harbor 镜像、CI 产物、AI 训练数据湖如果落在同一个集群,运维、备份、监控都只做一遍。
- 多实例共享后端。Harbor 的 registry 组件本身无状态,多个实例指向同一个 bucket 就能共享镜像层,扩副本不用搬数据。
这不是把对象存储当"网盘"硬塞,而是 registry 官方存储驱动的能力,配置入口就在 harbor.yml 的 storage_service 段。
先把桶和专用身份建好
别用管理员账号直接给 Harbor 用,建一个只管镜像桶的专用 IAM 用户更干净。以 RustFS 为例(rc 客户端):
bash
rc alias set rustfs http://rustfs:9000 "$RUSTFS_ACCESS_KEY" "$RUSTFS_SECRET_KEY"

rc mb rustfs/harbor-registry

rc admin user add rustfs harbor_s3 'ChangeMe-Strong-Secret'

cat > harbor-policy.json <<'EOF'
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["s3:ListBucket", "s3:GetBucketLocation"],
      "Resource": ["arn:aws:s3:::harbor-registry"]
    },
    {
      "Effect": "Allow",
      "Action": ["s3:GetObject", "s3:PutObject", "s3:DeleteObject", "s3:ListMultipartUploadParts"],
      "Resource": ["arn:aws:s3:::harbor-registry/*"]
    }
  ]
}
EOF

rc admin policy create rustfs harbor-policy harbor-policy.json
rc admin policy attach rustfs harbor-policy harbor_s3
内置的 readwrite 策略虽然省事,但它对所有桶开放读写,和"权限收在镜像桶里"矛盾,所以这里用自定义策略。镜像层上传走 multipart,s3:ListMultipartUploadParts 别漏。服务端 1.0.0 已于 2026 年 9 月 16 日 GA;rc 启动的服务必须显式设置 RUSTFS_ACCESS_KEY / RUSTFS_SECRET_KEY,默认口令已废弃。
harbor.yml 的 s3 段怎么写
关键在 storage_service 从 filesystem 换成 s3:
yaml
storage_service:
  s3:
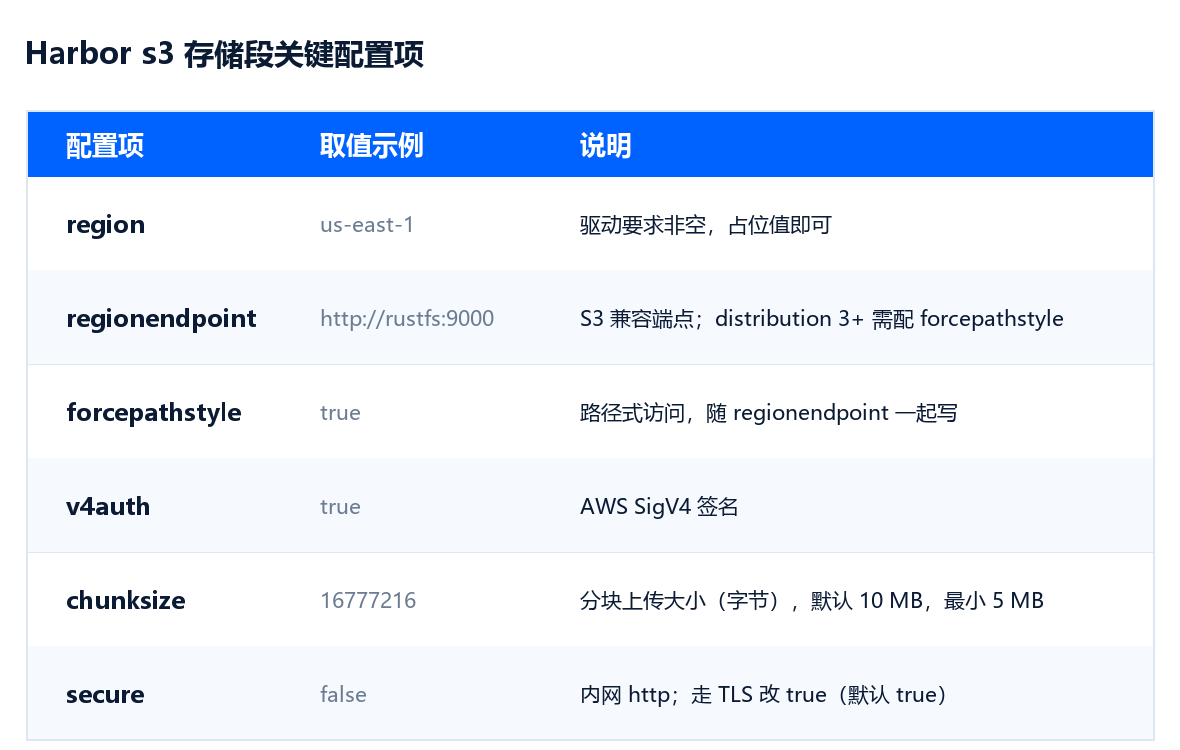
    region: us-east-1                     # 驱动要求非空,占位即可
    regionendpoint: http://rustfs:9000    # S3 端点(注意不是 endpoint)
    forcepathstyle: true                  # distribution 3+ 用 regionendpoint 必须配
    bucket: harbor-registry
    accesskey: harbor_s3
    secretkey: <harbor_s3 的 secret>
    encrypt: false                        # 加密可交给存储侧 SSE,避免双层加密
    secure: false                         # 内网 http;走 TLS 再改 true
    v4auth: true                          # AWS SigV4 签名
    chunksize: 16777216                   # 分块上传大小(字节),默认 10 MB
三个容易踩的点,都以 distribution 官方存储驱动文档为准:
- 参数名是
v4auth,不是网上老教程里的v4signature。较新的 registry 版本里 S3 兼容端点必须走 SigV4 签名,这一项配漏或写错,Harbor 启动后推镜像会报签名不匹配。 - distribution 3 起,
regionendpoint必须和forcepathstyle: true搭配使用,官方文档原话是"强制路径式访问是必要的"。对应较新的 Harbor 版本要把这一行带上;老版本 registry 没有这个字段,不用加。 chunksize的单位是字节,默认 10 MB,S3 API 要求分块至少 5 MB。镜像层普遍是大文件,网络好可以调大。
改完配置执行 ./prepare 重新生成 Compose 文件,然后 docker compose up -d 生效。
部署与验证
bash
cd /path/to/harbor
./prepare
docker compose down && docker compose up -d

docker login harbor.example.com
docker tag nginx:latest harbor.example.com/library/nginx:test
docker push harbor.example.com/library/nginx:test

rc ls rustfs/harbor-registry
注意第 2 步:docker push 的目标是 Harbor 本身(harbor.yml 里的 hostname),存储端点只接收 Harbor 后端写下来的 blob,两者别混。推成功且 rc ls 能在桶里看到 docker/registry/... 键,说明链路通了。Harbor 控制台的镜像列表、标签、复制策略都不用改,只是底层存储换了地方。
边界与代价
- 存量数据不迁移。从
filesystem切到s3只影响新写入的 blob,本地盘上的历史镜像不会自动搬过去;要么走 Harbor 的复制规则同步一次,要么接受旧镜像留在原地。 - GC 不会自动跑。镜像删了,底层 layer blob 不会立刻释放,需要在 Harbor 里触发垃圾回收(或配定时任务)才真正腾出空间。
- 分片碎片会自己长出来。registry 组件内部有个清理未使用分片的任务,默认每 168 小时跑一轮,它是 registry 进程的固有行为,不重启就关不掉。推镜像中断、并发 part 被掐断,残留都堆在 upload 目录。想备份 Harbor 数据卷,把这一轮的间隔调大、或者卡在两轮中间下手,别在清理跑到一半时抓文件。
- 桶里只有镜像层,Harbor 自己的库还得单独备份。对象存储那一侧存的是 registry 的 manifest 和 layer blob,而项目、仓库、artifact、tag、权限、复制任务、扫描结果这些元数据在 Harbor 内置的 PostgreSQL 里(Compose 部署就是 database 那个容器),
harbor.yml、证书和私钥也在安装目录。官方对备份范围的限制写得很明确:只支持 Harbor 内部数据库,外部数据库不在支持范围内;Redis 的卷也不进备份,恢复之后已登录用户的会话会丢。恢复顺序是数据库先、镜像数据后,两边对不上会出现页面上能看到标签但 pull 不到层的状态。 - redirect 模式想清楚再开。开启后 registry 会把对象存储的预签名 URL 直接返回给 docker 客户端,流量绕过 Harbor,registry 压力小很多;代价是客户端必须能直接访问存储端点,内网环境通常把
redirect.disable设为true让流量走注册表。 - 网络与加密。
secure: false假设 Harbor 与存储在同一可信网络;跨网段给存储端点挂 TLS 反向代理,再把secure改true。落盘加密交给存储侧的 SSE 即可,不必在 registry 层重复加密。
镜像仓并入对象存储栈之后,容量规划和备份节奏都归到存储这一层,Harbor 节点自己只剩元数据和 UI。RustFS 1.0.0 已于 2026 年 9 月 16 日 GA,源码和 issue 在 github.com/rustfs/rustfs;Harbor 的配置参考在 goharbor.io,registry s3 驱动的参数细节在 distribution 文档。