这篇学习笔记,我想记的不是"数据能不能存下来"这么简单,而是我这次做一个学习任务管理 Demo 时,怎么把 Preferences、RelationalStore 和页面内存状态拆开来用,最后把"任务数据持久化"和"页面状态恢复"这两件事都串起来。
一、最开始我以为,本地存储就是选一个 API 用到底
刚开始做这种带任务列表的小项目时,我最直觉的想法其实很简单:
- 有任务数据,就存本地;
- 有页面状态,就也存本地;
- 反正都是"本地存储",找一个能力统一搞定就行。
但真的开始写以后,我很快发现,这个想法太粗了。
因为"本地存储"这四个字下面,其实混着完全不同类型的数据:
- 任务实体数据:标题、描述、状态、进度、更新时间;
- 临时表单草稿:用户编辑到一半,还没正式提交的内容;
- 页面状态:当前选中的 Tab、筛选条件、上次打开的任务 ID;
- 内存态:当前页面正选中的对象、当前组件的即时展示状态。
这些东西虽然都和"保存"有关,但生命周期完全不一样。
如果全塞进同一种存储里,短期看可能能跑,长期一定会乱:
- 查询任务列表会很别扭;
- 草稿会和正式数据搅在一起;
- 页面恢复会越来越难解释;
- 后面一旦加筛选、排序、状态同步,结构就会开始散。
所以这次我后来不再问"用哪个 API 最省事",而是换成了另一个问题:不同类型的数据,到底应该落在哪一层。
二、我先把"数据"和"状态"强行拆开,项目思路才开始清楚
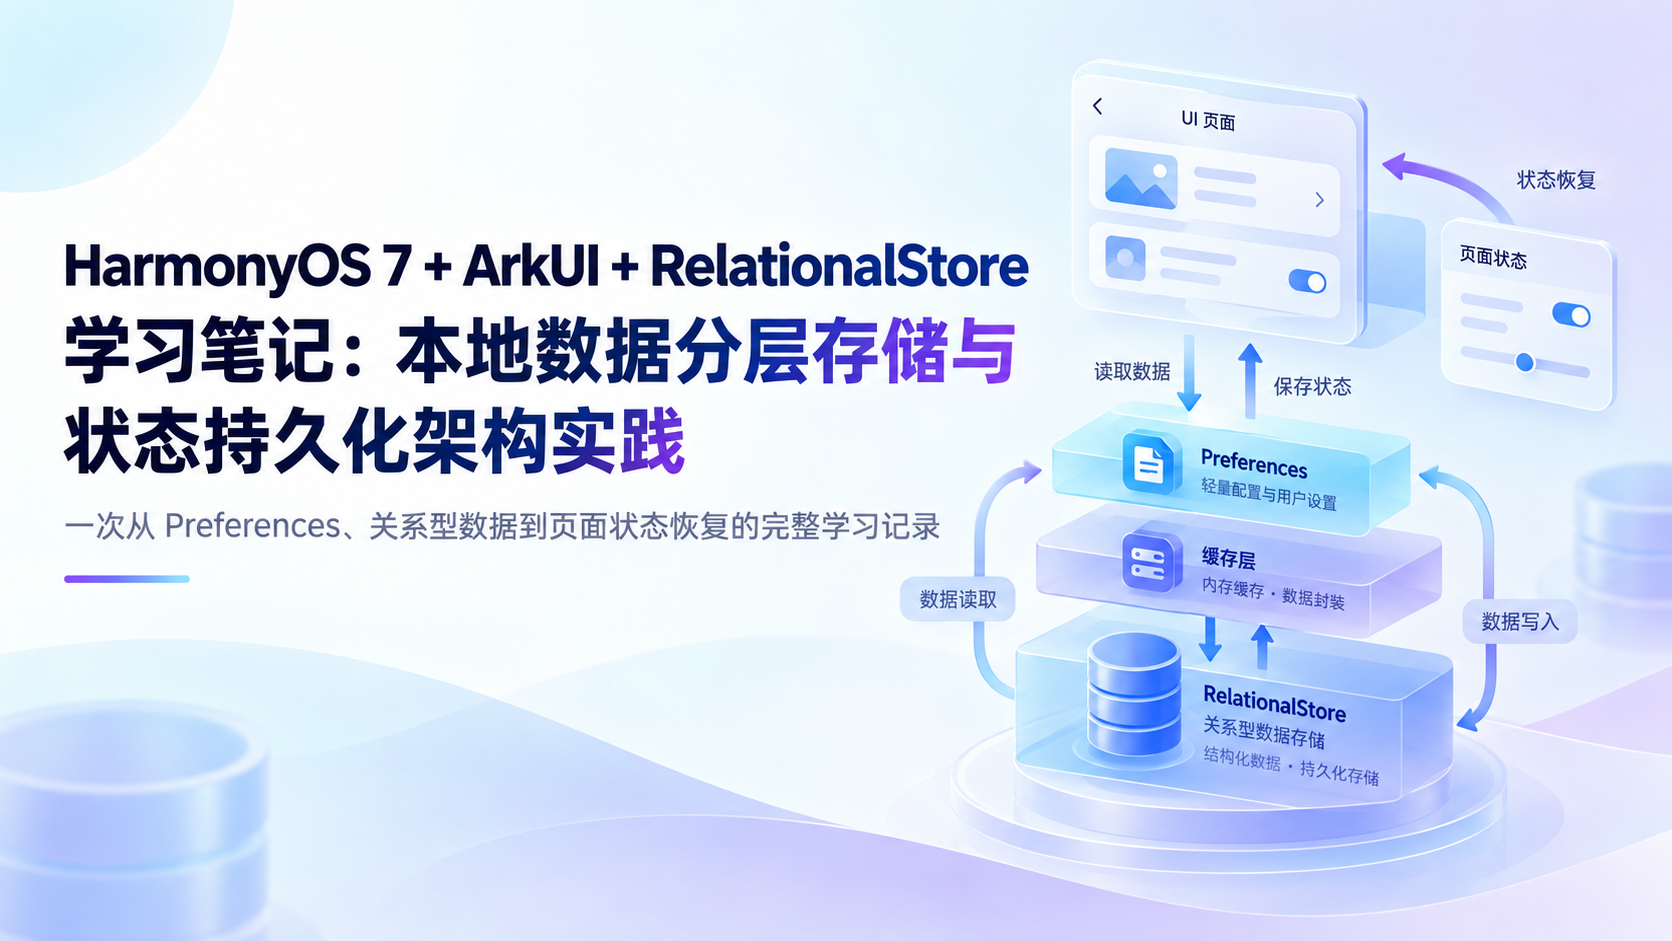
我这次最后把本地数据分成了三层:
- RelationalStore:放任务主数据;
- Preferences:放草稿、筛选条件、页面恢复信息;
- 内存状态:放当前交互中的即时态。
这个拆法看起来有点"故意麻烦自己",但真正做完以后,我反而觉得特别值。
因为一旦层次拆开,很多原本混在一起的问题就能分开处理:
- 列表查询归数据库;
- 轻量配置归 Preferences;
- 界面切换和选中态归内存;
- 页面重新进入时,再决定哪些需要恢复。
也就是说,这个项目真正做的不是"把数据存下来",而是:给不同类型的数据安排不同的归宿。
三、任务主数据这层,我最后还是交给了 RelationalStore
只要是带列表、带状态、带排序、带更新记录的业务数据,我现在基本都会优先考虑关系型存储。
因为这种数据的核心需求,已经不只是"能存",而是:
- 能插入;
- 能更新;
- 能按条件查询;
- 能按更新时间排序;
- 后面还能继续扩展字段。
所以任务表我最后还是落到了 RelationalStore 上。
我当时在仓储层里,先收了一层最基础的插入逻辑:
arkts
async insertTask(task: Task): Promise<number> {
  if (!this.store) {
    await this.initStore()
  }

  const valueBucket: relationalStore.ValuesBucket = {
    title: task.title,
    status: task.status,
    progress: task.progress,
    createTime: task.createTime,
    updateTime: Date.now()
  }

  const rowId = await this.store!.insert('tasks', valueBucket)
  return rowId
}
这段代码本身不复杂,但它让我把思路一下子拧顺了:
- 任务数据是结构化的;
- 它有固定字段;
- 它后续会频繁更新;
- 它天然适合进入表结构。
也就是说,RelationalStore 在这里不是"高级一点的存储",而是它刚好适合任务实体这种结构化数据。
四、草稿和页面恢复信息,我反而没放数据库,而是交给了 Preferences
做完任务表以后,我一开始也犹豫过:既然有数据库了,草稿和页面状态是不是也一并放进去?
后来我试着梳理了一下它们的特征,马上就觉得不该这么做。
像这些数据:
- 编辑中的表单草稿;
- 当前 Tab 索引;
- 上次选中的任务 ID;
- 筛选条件开关;
- 排序方式;
它们有几个共同特点:
- 数据量小;
- 结构轻;
- 大多数按 key 读写就够;
- 不需要复杂查询;
- 更像"偏配置"而不是"偏实体"。
所以我最后把这部分全交给了 Preferences。最常用的一段保存草稿逻辑大概就是这样:
arkts
async saveDraftToPreferences(draft: TaskDraft): Promise<void> {
  const prefs = await preferences.getPreferences(this.context, 'task_prefs')
  await prefs.put('draft_task', JSON.stringify(draft))
  await prefs.flush()
}

async restoreDraftFromPreferences(): Promise<TaskDraft | null> {
  const prefs = await preferences.getPreferences(this.context, 'task_prefs')
  const raw = await prefs.get('draft_task', '') as string
  return raw ? JSON.parse(raw) as TaskDraft : null
}
写到这里以后,我对 Preferences 的定位就变得特别清楚:它不是小型数据库,它更像一个轻量状态仓。
这层一旦想清楚,后面很多状态恢复工作都变简单了。
五、真正让项目顺起来的,不是某个存储 API,而是"仓储层"
如果直接在页面里到处写 insert、update、put、get,项目很快就会变乱。
因为页面最后会同时操心三件事:
- 数据怎么存;
- 状态怎么恢复;
- UI 怎么更新。
这种耦合一旦起来,后面几乎改不动。
所以这次我还是给自己加了一层仓储封装,把本地数据访问集中起来。比如:
- 任务列表相关操作归
TaskRepository; - 草稿读写也归这个仓储;
- 页面恢复用到的 key,同样由仓储统一提供。
这样做有一个特别明显的好处:页面终于只管"我要什么",而不是"我去哪里拿"。
我后来越来越觉得,本地存储项目最容易被低估的一点就是:
不是存储能力本身有多难,而是如果没有一层统一封装,整个页面会很快被存储细节淹没。
六、真正联调时,我更关心"退出再回来以后,状态有没有真的恢复"
这类项目做到一半的时候,最容易产生一种错觉:
- 数据已经能保存;
- 页面也能显示;
- 看起来好像差不多了。
但只要你真的退出页面、重新进入、切换 Tab、切换详情,再回来一轮,很快就会发现问题:
- 草稿有没有丢;
- 上次选中的任务是不是还在;
- 列表排序是不是恢复了;
- 当前筛选条件是不是仍然有效;
- 详情页是不是还能回到刚才那条数据。
所以到了联调阶段,我最常看的反而是 DevEco 里那种"页面状态 + 仓储日志 + 本地存储读写"有没有连起来。
整个开发过程,大概就是这种状态:
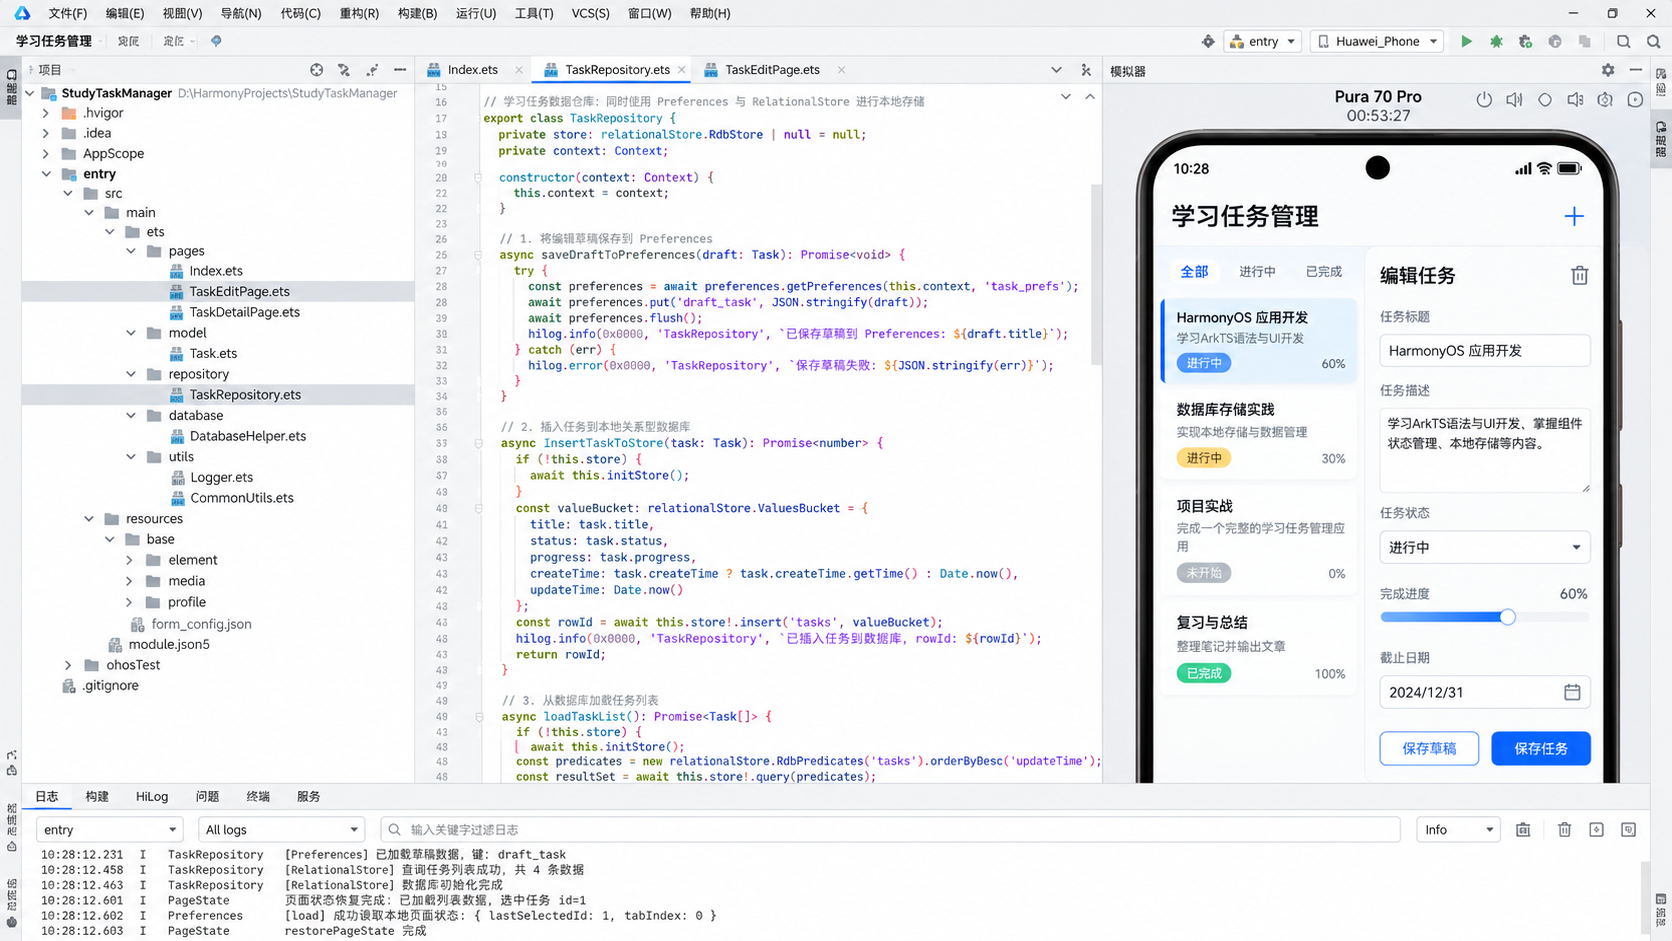
这张图里,我最在意的其实是底部日志那种顺序感:
- Preferences 保存草稿成功;
- RelationalStore 查询任务成功;
- PageState 恢复选中项成功;
- 当前 TabIndex 已恢复。
因为只有这些节点连起来,页面恢复这件事才算真的成立。
七、列表页和详情页跑起来以后,我才意识到"状态持久化"真正值钱的地方
很多时候我们说"状态持久化",听起来像是一个偏底层、偏工具的词。
但这次项目做完以后,我越来越觉得,它真正影响的是体验感。
比如一个学习任务管理页面,如果用户:
- 正在编辑一条任务;
- 只填了一半内容;
- 中途切出应用;
- 再回来的时候什么都没了;
那这个项目哪怕界面很好看,体验也会非常差。
所以我后面刻意把列表页做成了一种"可观察恢复"的结构,让用户能看到:
- 今日任务多少;
- 哪些进行中;
- 哪些已完成;
- 哪个草稿已经自动保存。
我理想里,它应该呈现的是下面这种感觉:
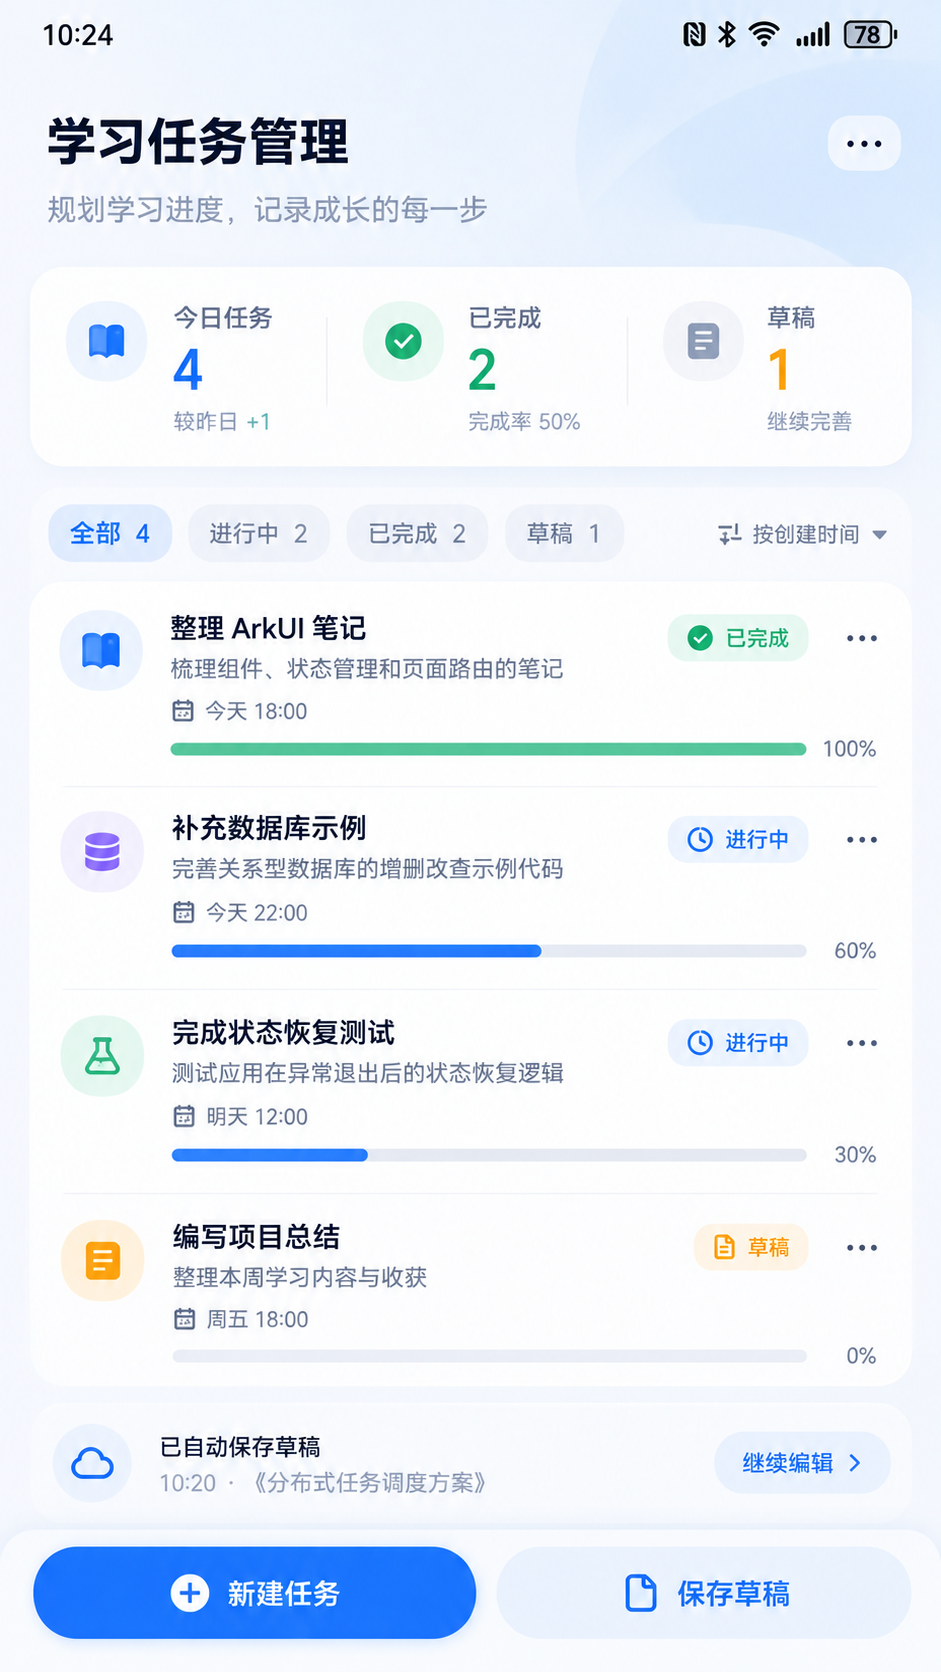
这里最关键的不是视觉排版,而是它把"持久化"这件事从幕后拉到了前台:
- 草稿不是悄悄存了,而是用户能感知;
- 任务进度不是临时状态,而是跨页面保留;
- 页面恢复不是一个抽象概念,而是能在列表结构里看到连续性。
八、后来我又补了一页"存储与恢复详情",因为我想把这条链彻底看清楚
做这种学习项目,如果只留列表页和编辑页,其实还不够。
因为你只能看到"结果像是对了",但很难解释:
- 到底是 Preferences 恢复了什么;
- 到底是数据库拿回了什么;
- 哪些状态还只在内存里;
- 最近一次恢复成功没有。
所以我最后又补了一页更偏诊断型的详情页,把整条恢复链翻出来看,比如:
- 页面状态恢复是否成功;
- Preferences 保存了哪些轻量数据;
- RelationalStore 是否取回了任务列表;
- 最近几次恢复记录是什么;
- 自动保存、退出恢复这些开关是不是打开了。
这类页面,我更希望它是这种"可验证"的状态:
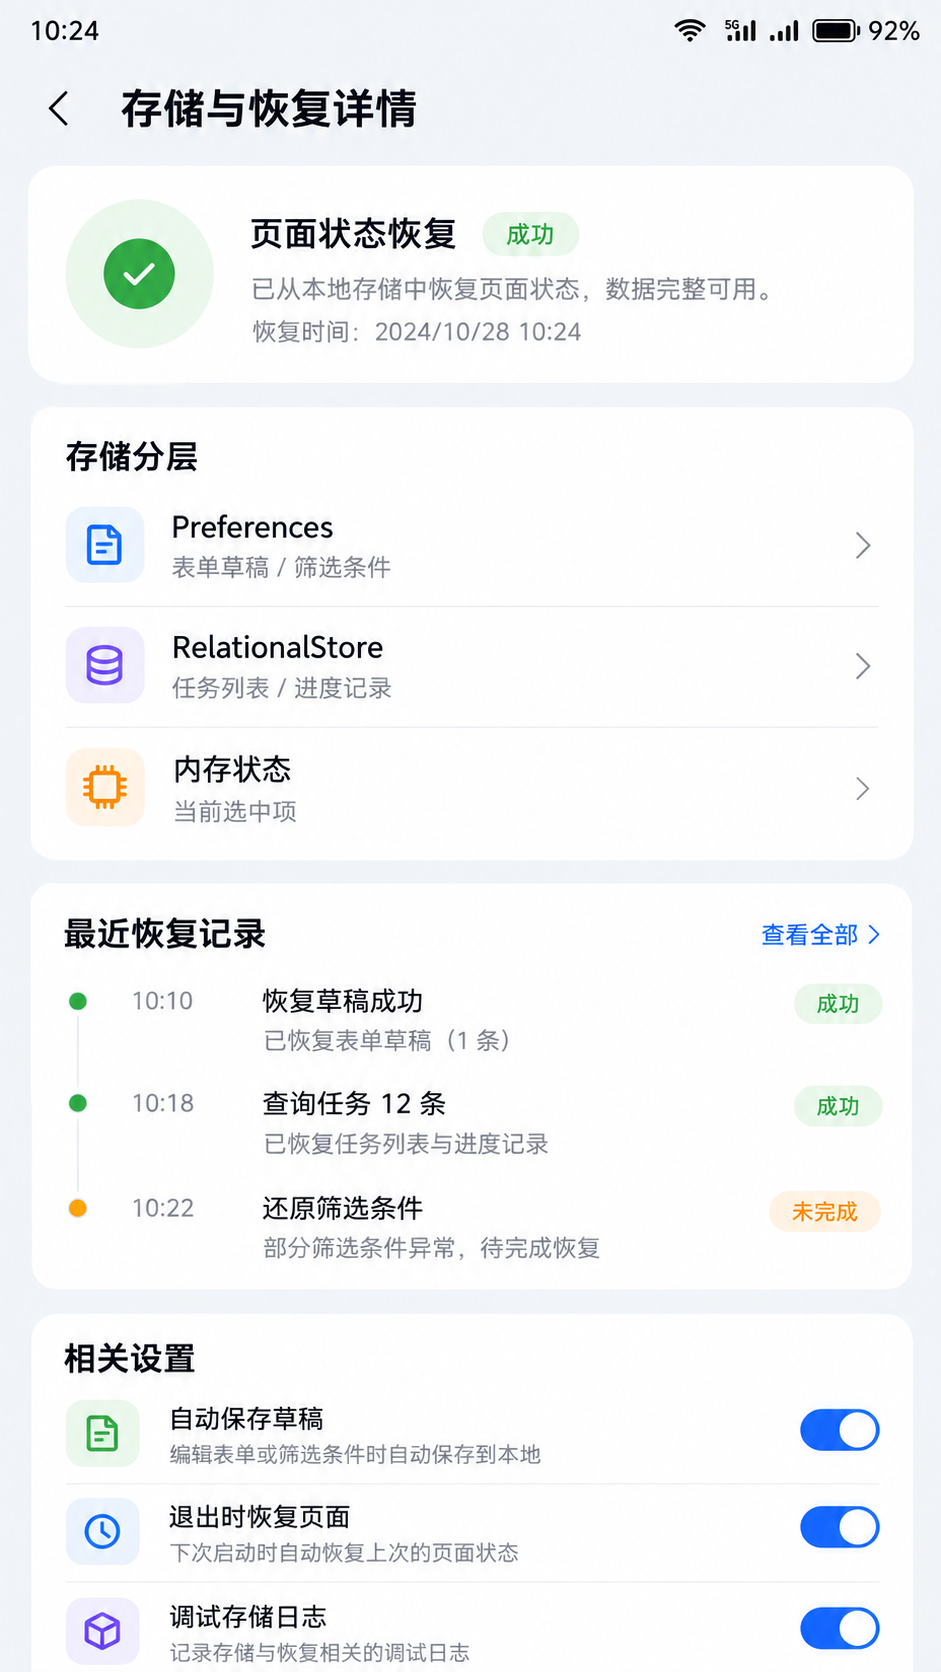
它的价值特别直接:
- 把原本埋在代码和日志里的恢复链,变成了用户和开发者都能看懂的页面结构;
- 让"状态持久化"不再只是概念,而是一个能被验证的过程;
- 以后如果恢复出问题,也能很快知道是 Preferences、数据库还是页面内存态出了问题。
九、这次学习里,我最后真正记住的是"本地存储不是一个 API,而是一种分层思路"
回头看这次练习,我觉得最大的收获,反而不是会用了 Preferences 或 RelationalStore,而是终于把"本地存储"这件事想顺了。
它不是简单问:
- 我该用哪个 API?
而是应该先问:
- 我要存的到底是什么数据?
- 它是实体数据,还是页面状态?
- 它需要复杂查询吗?
- 它需要长期持久化,还是只是恢复一次?
当这些问题想清楚以后,技术方案几乎会自己浮出来:
- 结构化任务数据,用
RelationalStore; - 轻量配置和草稿,用
Preferences; - 当前交互态,先留在内存;
- 页面恢复时,再按优先级把这些状态拼回去。
这个思路一旦立住,项目就不再是"本地能存点东西",而是开始有了很清楚的本地数据架构。
十、本文小记
如果用一句话总结这次学习,我会写成:本地存储真正难的不是保存,而是分层。
数据能存下来,只是开始。真正有工程价值的,是:
- 不同数据是不是放在了合适的位置;
- 页面退出再回来以后,是不是还能保持连续性;
- 恢复链是不是有证据、能调试、可扩展。
对我自己来说,这次练习至少让我把几个判断记牢了:
- Preferences 更适合轻量状态和草稿;
- RelationalStore 更适合结构化业务数据;
- 页面内存态不能和持久化状态混成一层;
- 仓储层非常重要,它能把页面和存储细节隔开;
- 状态恢复页和日志,对这类项目特别有帮助。
后面如果继续往下做,我最想补的两块是:
- 一块是任务与标签、任务与阶段这类更完整的关系型设计;
- 一块是异常退出后的自动恢复和冲突处理策略。
这一篇先把第一阶段的学习过程记到这里。至少到这一步,我已经不再把"本地存储"理解成某个 API 的使用,而是把它理解成一套围绕数据类型、页面状态和恢复链组织起来的分层架构。