训练跑了一整晚,到第 11 小时进程挂了。此时能救你的只有最近一次成功的 checkpoint。如果 checkpoint 是直接写在本地盘上,机器一挂就跟着没了;放在对象存储上才有跨机恢复的可能。但把 checkpoint 写对象存储这件事本身有讲究:大文件怎么传、断了怎么续、没传完的碎片怎么清,任何一个没处理好都会在真正出事的那个晚上掉链子。
分片上传的三个阶段
大文件走 S3 协议上传有专门的一套 API,流程分三步:
CreateMultipartUpload返回一个 upload ID- 循环调
UploadPart传各个分片,每片带一个序号(1 到 10000),每个分片会返回一个 ETag CompleteMultipartUpload提交有序的分片号和 ETag,服务端拼出最终对象
RustFS 官方文档对这套流程的描述与 AWS 一致,也写了一个值得注意的点,原文是:
rc0.1.29 does not expose create, upload-part, complete, list-parts, or abort multipart commands.
这句话容易被读成 RustFS 不支持分片上传,需要把它限定清楚:说的是命令行这一层没有对外封装这几个子命令,同一页紧接着给的建议是"需要显式 multipart 行为时改用 Console 或 S3 SDK"。S3 接口本身没有缺这一块,官方 multipart 页还单独列了一张 S3 操作表,Inspect 对应 ListParts、Cancel 对应 AbortMultipartUpload、Discover 对应 ListMultipartUploads。用 boto3、aws-cli、mc 写分片逻辑不受影响。
同一个坑在版本删除上还出现了一次,值得放在一起看:rc object remove --versions 出现在 rc 0.1.29 的帮助输出里,真去调用返回的是 not implemented。所以判断一个工具的能力边界,看帮助文字和看正文描述都可能落空,以文档明确写的例外为准。
分片上传的上限参考 AWS 的官方规格表:
| 项目 | 规格 |
|---|---|
| 单个对象最大大小 | 48.8 TiB |
| 每次上传最大分片数 | 10,000 |
| 分片序号范围 | 1 到 10,000 |
| 分片大小 | 5 MiB 到 5 GiB(最后一片无最小限制) |
有几个常被中文文章写错的数字需要澄清:对象上限是 48.8 TiB 而不是 5 TiB(5 TiB 是很早以前的规格);分片数量上限 10000 是硬上限,不是 5 MiB 分片 × 5 TiB 对象那种推导结果。按 5 GiB 一片、10000 片算,单文件最多能到 48.8 TiB,公式正好对上。
分片大小怎么定,取决于两件事:并发度和重传成本。片开得小,单片失败重传的代价低,但分片数会逼近 10000 的上限,请求数也跟着涨,元数据层压力大;片开得大,单片失败就要重传几百 MiB 甚至几个 GiB,网络抖动时重试成本很高。实用做法是按对象的典型大小反推:让分片数落在几十片的量级,同时保证单片大小在 5 MiB 到 5 GiB 的合法区间里。checkpoint 这种几十 GiB 级别的对象,片大小选在几百 MiB 一档通常比较平衡。
RustFS 官方的兼容性矩阵里,multipart 的 create、upload、complete、abort 这几项列为已支持。Console 单文件上传最大 512 GB、单次最多选 10000 个文件是另外一回事,那是 Console 侧限制,和 S3 客户端的限制不共享同一套数字。
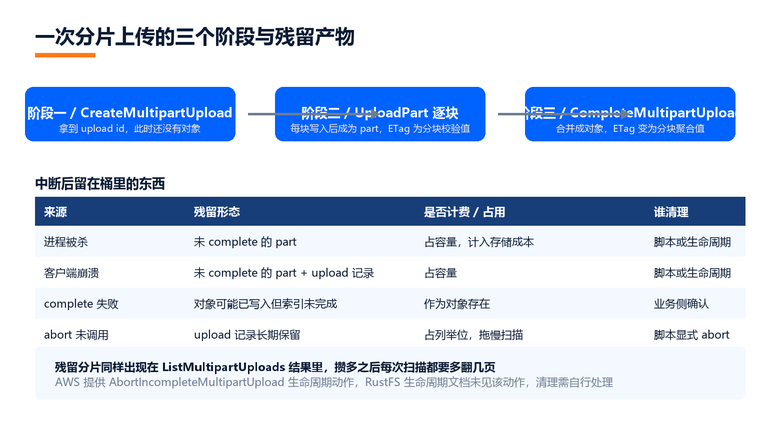
上传流程本身不复杂,复杂的是中断之后留下的东西:
断点续传的真实含义
"断点续传"这个词在 S3 场景下经常被误解,它指的是分片级别的续传而非 HTTP 层的 Range 续传:已经上传成功的分片会被保留,失败的片重传就行,其他片不受影响。AWS 官方文档的原话:
If transmission of any part fails, you can retransmit that part without affecting other parts.
Pause and resume object uploads. You can upload object parts over time. After you initiate a multipart upload, there is no expiry; you must explicitly complete or stop the multipart upload.
两个关键点:分片上传没有过期时间 ,只要你不说停,它就一直留着;必须显式 complete 或 abort 才能结束。这两条放在一起就是后面那笔账的来源。
实际训练任务里做断点续传的正确姿势,第一步是查任务:ListMultipartUploads 按前缀列出未完成的 upload,找到同名 key 的那个就复用它的 upload ID 继续传,找不到再 Create。但只走到这里不算做了断点续传。
问题出在这个接口的返回值上。它给的是任务级信息,字段大致是 key、upload ID、发起时间这几项,里面没有任何分片状态 ,看不出这个 upload 已经传了几片、哪些片成功了、缺哪几片。要拿到分片级进度必须再调一次 ListParts,把已上传分片的 part number 和 ETag 取回来,和本地待传列表做差集,只补缺口那几片。漏掉这一步的效果是分片全部从头重传一遍,断点续传退化成整体重跑,只是比第一次多了几次协议请求。
ListParts 的入参是 bucket、key 和 upload ID,RustFS 官方文档给它的定义是 Inspect,超过一页时需要分页。这个接口还有一条要提前算进去的边界:官方的 S3 兼容性矩阵里,multipart 的 listing 与 part lookup 边缘用例被归在 excluded 列表,不属于默认兼容性门禁。也就是说这套续传逻辑在自己的 RustFS 版本上跑一遍验证再上生产更稳妥,别默认两边对齐。
续传时另有两条约束官方文档写得很直白:不要把 upload ID 用在别的 key 上,一个 upload ID 只对应一次上传;提交分片时要按 part number 升序,并且原样保留 ListParts 返回的每个 ETag,自己重新算一个填进去会导致 complete 失败。训练框架里原生支持这套逻辑的不多,大多数要在自己的上传封装里手工维护分片状态。
python
s3 = boto3.client("s3", endpoint_url="http://localhost:9000")

pending = s3.list_multipart_uploads(Bucket=BUCKET, Prefix=KEY)
upload_id = next((u["UploadId"] for u in pending["Uploads"] if u["Key"] == KEY), None)

if upload_id is None:
    upload_id = s3.create_multipart_upload(Bucket=BUCKET, Key=KEY)["UploadId"]

done = {
    p["PartNumber"]: p["ETag"]
    for p in s3.list_parts(Bucket=BUCKET, Key=KEY, UploadId=upload_id).get("Parts", [])
}
missing = [i for i in range(1, PART_COUNT + 1) if i not in done]
残留分片是一笔看不见的账
分片上传最大的坑其实在断点续传之外:没传完的分片会一直占着存储计费。AWS 官方文档的原话:
After you initiate a multipart upload and upload one or more parts, you must either complete or stop the multipart upload to stop incurring charges for storage of the uploaded parts. Only after you complete or stop a multipart upload will Amazon S3 free up the parts storage and stop billing you for the parts storage.
训练任务异常退出是常态,每次异常退出都可能留下若干个"起了头但没传完"的 multipart upload,每个占着几 GiB 到几十 GiB。这些残留不会自己消失,除非配了清理规则。
清理残留的官方手段是生命周期规则里的 AbortIncompleteMultipartUpload 动作,AWS 的原文:
Amazon S3 supports a bucket lifecycle rule that you can use to direct Amazon S3 to stop multipart uploads that aren't completed within a specified number of days after being initiated.
配置形式是 <DaysAfterInitiation>7</DaysAfterInitiation>,意思是发起后 7 天内没完成的 upload 自动清理。官方还明确写了这条动作的两个边界:只对未完成的 multipart upload 生效,不影响已完成的对象;不能用于带标签过滤的规则。
RustFS 这边的边界要单独说清楚:官方文档的生命周期管理页写着支持 expiration 和 transition 规则,给的 rc 命令示例包括 --expiry-days、--transition-days、--noncurrent-expiry-days 等参数,但官方文档里没有出现 AbortIncompleteMultipartUpload 或 DaysAfterInitiation 相关表述 。也就是说,如果想在 RustFS 上自动清理残留分片,目前这条路径没有官方文档支持,需要业务侧自己定期调 ListMultipartUploads 扫描再逐个 abort,或者用脚本做定时清理。
这个差异迁移时值得专门标注:从 AWS 迁到 RustFS,原来靠生命周期规则自动清理残留分片的方案要重新设计。业务侧自己接手之后,有两个坑比清理本身更容易出事。
第一个坑是把 abort 当成取消上传的普通操作。AWS 对 abort 的定义原文是释放分片占用的存储,落到业务后果上就是当前 upload 下的分片数据全部作废且不可恢复,已经传了几个 GiB 也一并清掉。写清理脚本时一定要带时间条件,只处理发起时间超过阈值的 upload,不加时间条件直接列出全部未完成任务批量 abort,会连此刻正在传的任务一起杀掉。这种事故的表现很有迷惑性:训练进程侧只看到上传失败,看不到自己的 upload 被哪个定时任务清掉了,排查方向会离真正的原因很远。
第二个坑是时间条件本身也不够。训练任务跑得比清理阈值长的场景是存在的,一个 epoch 跑到三十小时,它的 checkpoint 上传就会落在阈值之外。所以清理脚本除了看时间,还要看业务侧的活跃标记:训练进程在上传前落一个标记文件或者在桶对象上打个标签,清理任务跳过当前处于活跃状态的那几个 upload。单靠时间过滤把活跃任务误杀的概率依然存在。
分页也要提前算进去。官方写明 ListMultipartUploads 单次最多返回 1000 条,要用 marker 翻页。checkpoint 桶里攒到几千个残留时只翻第一页就收手,漏掉的那些会一直挂着,清理脚本的覆盖率随残留量增长而下降。
python
import boto3, datetime
s3 = boto3.client("s3", endpoint_url="http://localhost:9000")
cutoff = datetime.datetime.now(datetime.timezone.utc) - datetime.timedelta(hours=24)

trainer_active = read_trainer_active_flag()   # 业务侧维护,别用文件 mtime 猜

tracker = {"next": None, "done": False}
while not tracker["done"]:
    params = {"Bucket": BUCKET, "Prefix": "checkpoints/"}
    if tracker["next"]:
        params["UploadIdMarker"] = tracker["next"]
    page = s3.list_multipart_uploads(**params)
    tracker["next"] = page.get("NextUploadIdMarker")
    tracker["done"] = not tracker["next"]

    for u in page.get("Uploads", []):
        if u["Key"] in trainer_active:
            continue
        started = datetime.datetime.fromisoformat(u["Initiated"].replace("Z", "+00:00"))
        if started >= cutoff:
            continue
        s3.abort_multipart_upload(Bucket=BUCKET, Key=u["Key"], UploadId=u["UploadId"])
自托管场景下的残留成本形态也和公有云不同。公有云是账单变难看,自托管则是磁盘被悄悄吃掉、列举变慢。残留分片一样要进 ListMultipartUploads 的结果里,攒多了之后每次扫描都要多翻几页,列举延迟跟着涨。所以清理脚本不只是省钱,也是让运维动作本身保持可用。
生命周期能配什么
RustFS 的生命周期管理支持几条规则动作,rc 命令的示例形式:
bash
rc bucket lifecycle rule add local/my-bucket --prefix logs/ --expiry-days 30

rc bucket lifecycle rule add local/my-bucket --prefix logs/ \
  --transition-days 90 --storage-class COLDTIER

rc bucket lifecycle rule add local/my-bucket --prefix logs/ \
  --noncurrent-transition-days 30 \
  --noncurrent-transition-storage-class COLDTIER \
  --noncurrent-expiry-days 365
官方文档特别提了一句:生命周期规则不会立刻处理每个符合条件的对象,由 Object Scanner 在后台评估执行。这意味着规则生效到对象真正被清理之间会有延迟,做容量规划时别按"规则到期就腾出空间"来算。
checkpoint 场景最常用的两条规则组合:非当前版本保留 7 天(够回滚到前一两个 epoch)加上当前版本不删(保住最新一次成功的 checkpoint)。配的时候要弄清"非当前版本"的定义。版本控制开启后,每次覆盖写都会把旧版本推到非当前状态;如果没开版本控制,每次覆盖就是直接删旧写新,生命周期的 noncurrent 系列参数都不起作用。
这里还差一种情况,而且它比"没开版本控制"更容易被忽略:版本控制开着,但 checkpoint 的命名方式决定了压根不会产生非当前版本。RustFS 官方文档对版本生成的表述是"每次向已存在的 key 上传或拷贝会产生一个新的 version ID",判据是同一个 key。于是两种命名模式的生命周期行为完全不同。
固定 key 覆盖写的模式(checkpoints/model.bin 每次覆盖),每次训练产出都成为同一 key 的新版本、旧的落入非当前状态,noncurrent-expiry-days 才有对象可管。每个 epoch 一个全新 key 的模式(checkpoints/model-epoch-100.bin 到 model-epoch-200.bin),这些 key 之间不存在覆盖关系,每个都是当前版本,版本控制开了也产不出非当前版本,noncurrent 系列参数一条都不会触发,过期的旧 checkpoint 会一直留在桶里直到占满空间。
选后一种命名,清理判据要换个落点:用同一条带 --prefix 的过期规则,把判据放在"对象创建时间"而不是"版本新旧"上。换句话说,开版本控制不等于自动清理,先确认自己属于哪种命名,再决定配 noncurrent 还是配 prefix,两者混着配会得到一个看起来配了规则、实际什么都不删的桶。
临时停一条规则也不用删了重建,rc bucket lifecycle rule edit local/my-bucket --id <rule-id> --disable true 先关掉,恢复时去掉这个参数即可。
checkpoint 存储的完整方案
把上面几段收成一个可用的方案骨架:
python
def save_checkpoint(model, optimizer, epoch, bucket, key):
    upload_id = get_or_create_upload(bucket, key)   # 先查有没有残留 upload
    parts = upload_parts_parallel(model.state_dict(), upload_id)  # 分片并发上传
    complete_upload(bucket, key, upload_id, parts)

    # 上传成功后,把上一个 epoch 的 checkpoint 打上非当前标记或直接删
    tag_previous_version(bucket, previous_key)
真正的训练框架(PyTorch Lightning、DeepSpeed、Megatron)各自有 checkpoint 管理模块,写的时候对照框架文档比从零写 SDK 调用省事。关键的一条是上传完成后立即删掉本地临时文件,不然本地盘很快会被 checkpoint 撑爆。另一个实操细节是 checkpoint 文件命名里带上 epoch 号和全局步数,出事排查时能立刻定位到"哪一步的状态",不用打开文件反推。
保留策略也要提前定。一个几十 GiB 的 checkpoint,每小时存一次,一周就是几 TiB。常见的做法是只保留最近 N 次加若干个里程碑版本(比如每个阶段的最佳指标那一次),其余交给生命周期规则过期删掉。保留几份够用,取决于训练一次要多久------重跑成本高于存储成本就多留,反之少留。
再补充一个容易被忽略的点:checkpoint 上传和训练循环之间要做异步解耦。同步上传会把训练 loop 卡住(几个 GiB 的模型状态序列化加网络传输要几十秒到几分钟),正规做法是 checkpoint 写到本地 staging 目录后立刻返回,由独立线程或进程负责上传和清理,训练 loop 只管写 staging。这样训练吞吐不受存储网络波动影响,代价是要处理好 staging 目录的两头事。
一头是残留。训练进程崩溃时 staging 目录会留下没传完的模型文件,而崩溃的进程本身不会回来清理,这些文件要一直占到下一次训练起写同名文件才被覆盖掉。得配一个独立定时任务按 mtime 扫,清理阈值要明显大于正常上传耗时,否则会把正在队列里排队的上传目标提前删掉,等上传线程取文件时发现本地已经没有这个文件了。
另一头是磁盘水位。staging 写满了训练一样会失败,只是故障点从对象存储挪到了本地盘,而且更难发现,本地盘打满往往比远端超时更早发生,告警也更晚到,监控上容易留一段空窗。如果 checkpoint 尺寸接近 staging 所在盘的可用空间,这套异步方案反而比同步上传更脆弱,因为本地盘没有 erasure coding 也没有多副本,一块盘写完就没了。给 staging 单独挂盘、单独设水位告警是值得的;删除本地文件的动作交给上传线程在对象确认落地后执行,不要放在训练主线程里做。
出事那晚的恢复顺序
checkpoint 存储的价值要到真出事那天才体现。恢复动作的顺序值得提前写进训练任务的启动脚本,四步:
- 从对象存储侧确认最新可用的 checkpoint(按"最近一次 complete 成功的对象"选,别按文件修改时间,multipart 的 part 写入会更新元数据时间戳,容易误导)
- 下载到本地 staging 目录
- 校验 ETag 或 checksum(可选但建议,尤其跨网络传输后)。这里有个细节:分片上传完成的对象,ETag 不是内容的 MD5,AWS 文档写明这类 ETag 末尾会带
-N后缀标记分片数,不能拿它和本地文件的 MD5 直接比对。要做内容校验有两条路。一条是自建校验值,训练侧算一份写进 checkpoint 的元数据或干脆附在文件里,恢复时读对象的元数据比对,代价是要改训练侧的输出逻辑。另一条是上传时带上 checksum,RustFS 官方兼容性矩阵把 checksum 相关行为列为已支持,CopyObject 那一项明确覆盖十种校验和算法(CRC32、CRC32C、CRC64NVME、SHA1、SHA256、MD5、SHA512、XXHASH3、XXHASH64、XXHASH128),上传侧通过 SDK 的 checksum 参数带上即可,免去了自己算校验值的环节。
RustFS 官方 multipart 页给的那套验证动作不依赖任何校验和头部约定,rc object stat 先看 size_bytes 和本地文件对不对得上,rc object show 把对象取回本地再用 cmp 逐字节比对。多一个下载动作,但在跨网络恢复、怀疑数据被截断的场景里,这是最不含糊的一种确认方式。
- 训练框架加载 checkpoint,从对应 epoch 恢复训练
恢复场景里还有一个坑:如果 checkpoint 上传到一半时任务挂了,multipart 没 complete,对象存储上根本没有这个对象的最终形态,列出来的还是上一个 epoch 的版本。恢复脚本要处理这种"最新的那个其实不可用"的情况,否则训练会从错误的状态恢复,接下来几个小时都在错误的梯度上跑。
RustFS 在 Apache 2.0 许可下开源,multipart 上传和生命周期的官方文档分别在 docs.rustfs.com 与 lifecycle-management。配一套靠谱的 checkpoint 存储不难,难的是把"异常退出"这个常态真正纳入设计。