在上篇的文章中我们学到了IO的基本概念,五种IO模型,高级IO的重要概念,接下来这节内容我们基于开始进行代码的实现
一.阻塞 IO
系统中大部分的接口都是阻塞式接口,如使用 read 函数从标准输入中读取数据。
来看代码:
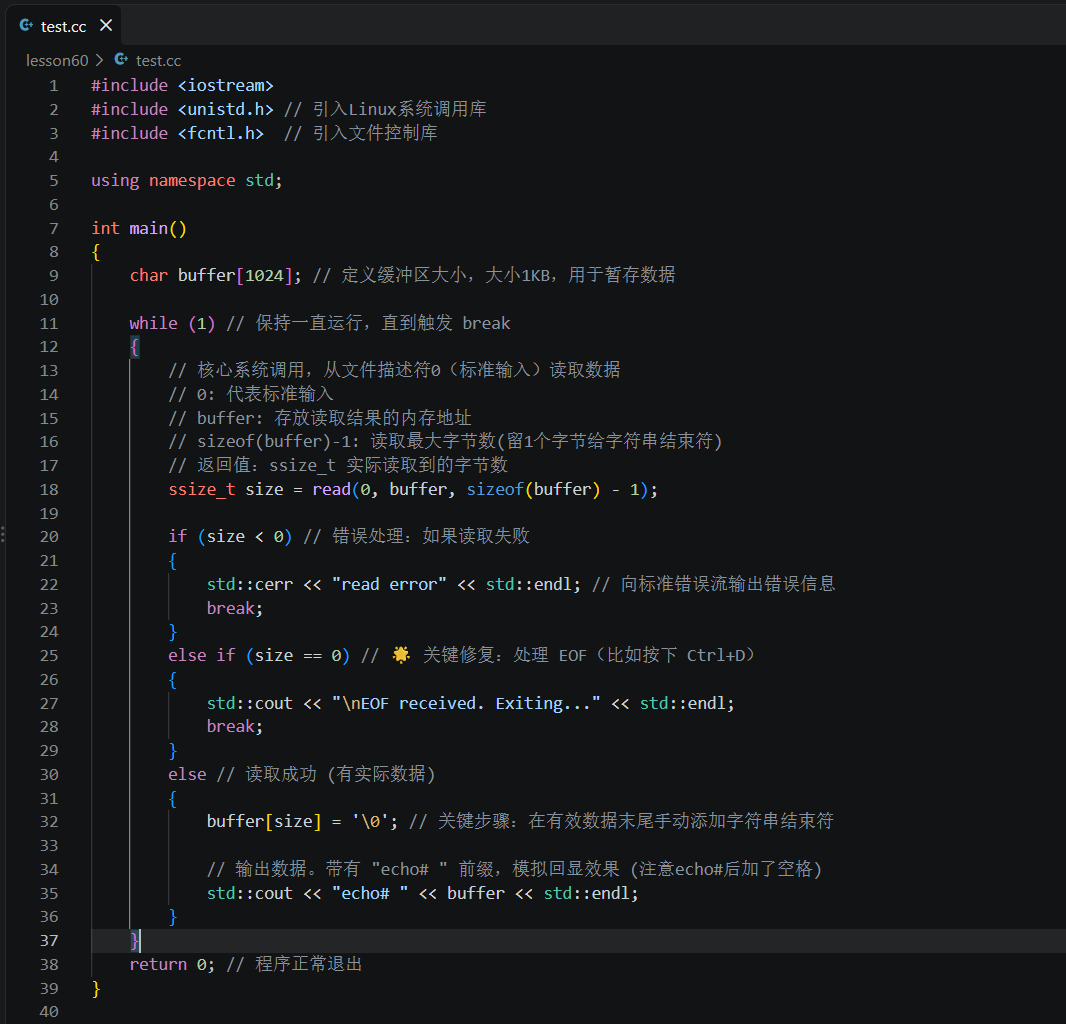
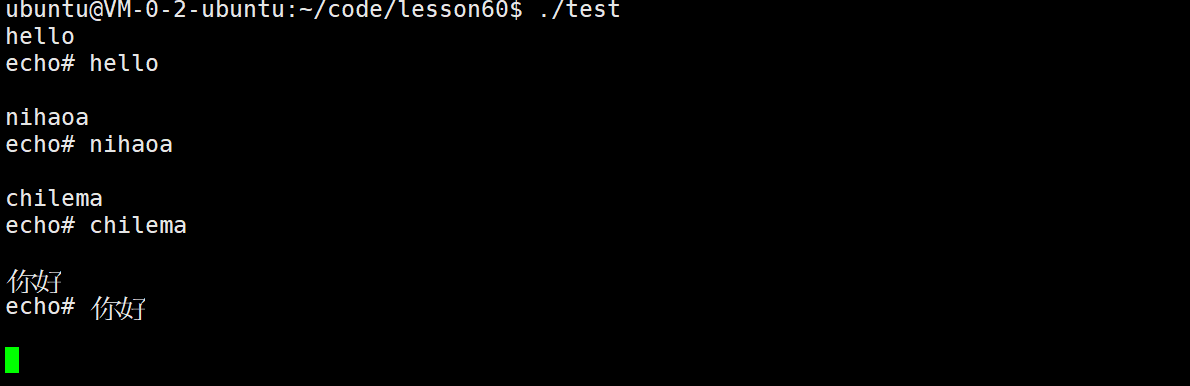
这里我们看,程序运行后,若不进行输入操作,该进程就会阻塞。根本原因就是因为此时底层数据不就绪,所以 read 函数需要进行阻塞等待。

一旦我们进行了输入操作,此时read 函数就会检测到底层数据已经就绪,然后将数据读取到从内核拷贝到程序员传入的 buffer 数组中,并且将读取到的数据输出到显示器上面,最后我们就可以看到输入的字符串了。
二.非阻塞 IO
打开文件时,都是默认以阻塞的方式打开的。Linux 中 open() 默认采用阻塞 I/O。若需非阻塞,需指定 O_NONBLOCK(现代 Linux 下 O_NDELAY 等价,但推荐前者)。非阻塞主要用于 Socket 或管道等慢速设备,对普通磁盘文件通常无效。

1.fcntl
⼀个⽂件描述符, 默认都是阻塞IO.
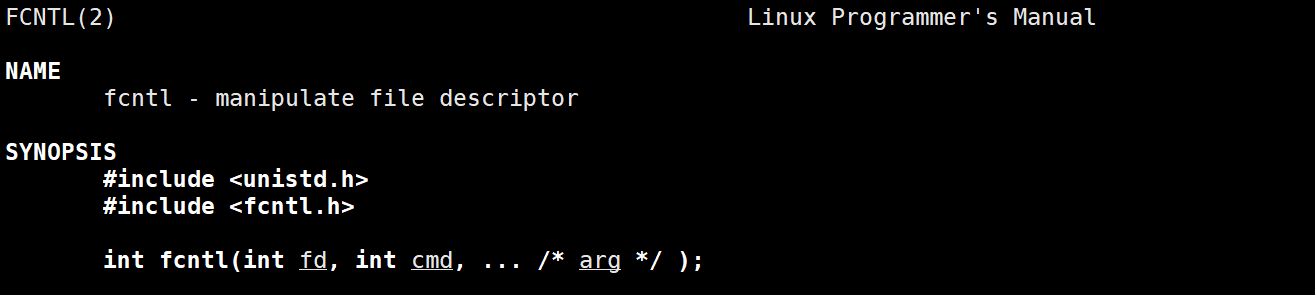
- fd:已打开的文件描述符(你要对哪个文件/设备动手?)
- cmd:需要进行的操作(你想干什么?是查状态还是改状态?)
- ...:可变参数,传入的 cmd 值不同,后面追加的参数也不同(干这件事需要的额外工具,命令不同,带的工具也不同)
传⼊的cmd的值不同, 后⾯追加的参数也不相同.
fcntl函数有5种功能:
- 复制一个现有的描述符(cmd=F_DUPFD)
- 获得 / 设置文件描述符标记(cmd=F_GETFD 或 F_SETFD)
- 获得 / 设置文件状态标记(cmd=F_GETFL 或 F_SETFL)
- 获得 / 设置异步 I/O 所有权(cmd=F_GETOWN 或 F_SETOWN)
- 获得 / 设置记录锁(cmd=F_GETLK, F_SETLK 或 F_SETLKW)
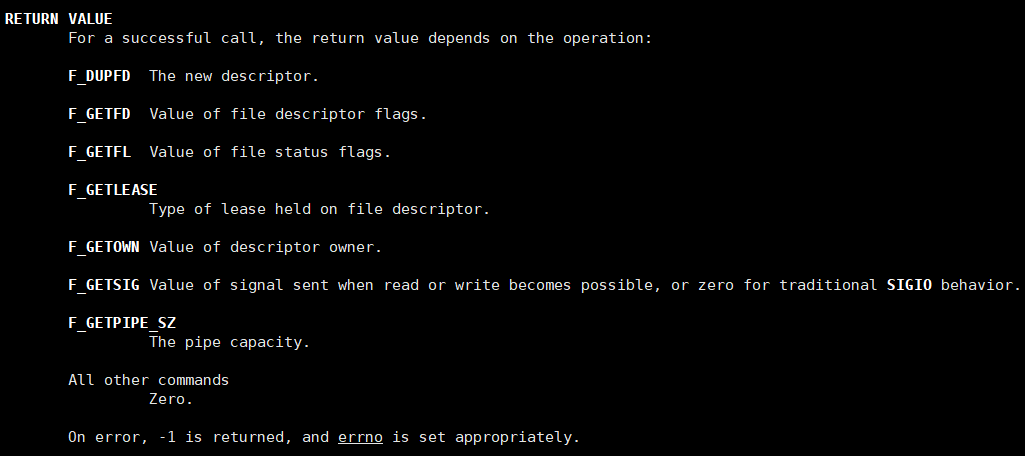
**根据内容跟可知,若函数调用成功,则返回值取决于具体进行的操作;若函数调用失败,则返回 -1,同时错误码被设置。**我们此处只是⽤第三种功能, 获取/设置⽂件状态标记, 就可以将⼀个⽂件描述符设置为⾮阻塞.
2.实现函数 SetNoBlock
基于 fcntl,下面实现一个 SetNoBlock 函数,该函数用于将指定的文件描述符设置为非阻塞状态。
- 先调用 fcntl 函数获取该文件描述符对应的文件状态标记(位图结构),此时调用 fcntl 函数时传入的 cmd 值为 F_GETFL。(简单说就是:先看看这个文件原本带着什么"状态标签",拿到它的底牌。)
- 在获取到的文件状态标记上添加非阻塞标记 O_NONBLOCK,再次调用 fcntl 函数对文件状态标记进行设置,此时调用 fcntl 函数时传入的 cmd 值为 F_SETFL。(简单说就是:在老底牌上强行加一张"非阻塞"的牌,然后重新塞回给文件,覆盖它原来的状态。)
我们来看代码:
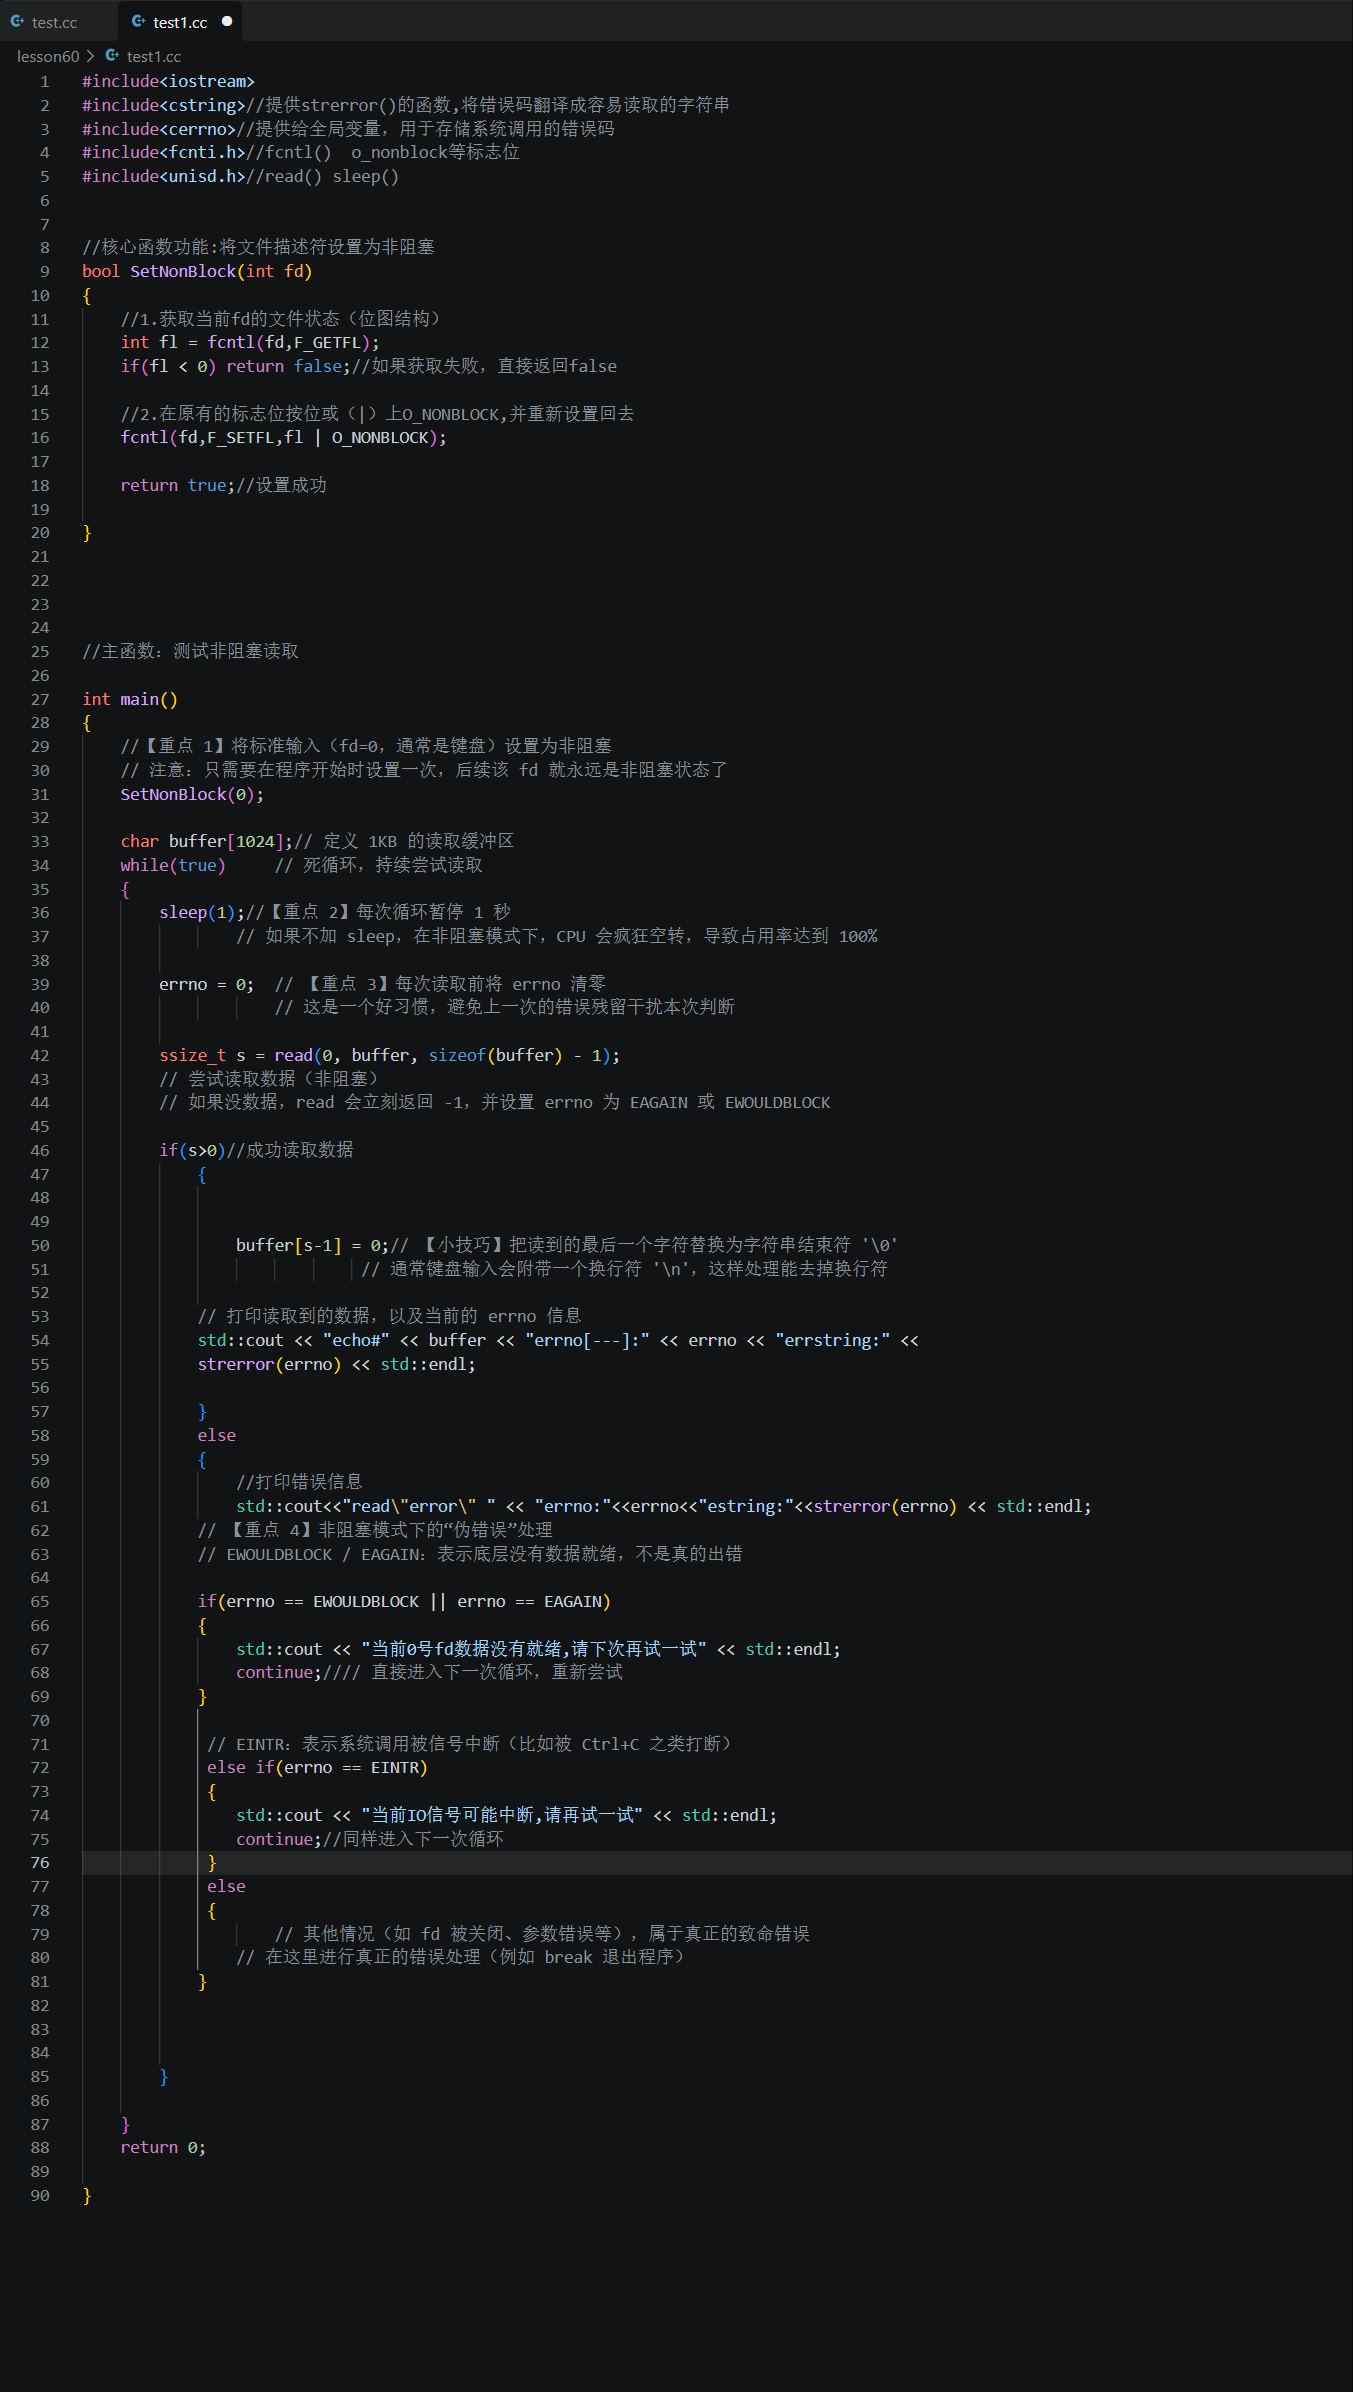
当 read 函数以非阻塞方式读取标准输入时,如果底层数据不就绪,那么 read 函数就会立即返回,并且是以出错的形式返回的,此时的错误码会被设置为 EAGAIN 或 EWOULDBLOCK。
(简单说就是:read 去拿数据,发现没货,它不会傻等,而是立刻返回 -1。但这不是真报错,errno 会告诉你:"暂时没货,等会儿再来"。)
因此在以非阻塞方式读取数据时,如果调用 read 函数时得到的返回值是 -1,此时还需通过错误码进一步进行判断,如果错误码的值是 EAGAIN 或 EWOULDBLOCK,说明本次调用 read 函数出错是因为底层数据还没有就绪,因此后续还应该继续调用 read 函数进行轮询检测数据是否就绪,当数据继续时再进行数据的读取。
(简单说:看到返回 -1 先别慌,赶紧查 errno。如果是 EAGAIN 或 EWOULDBLOCK,说明只是没数据而已,直接 continue 回去继续循环等待,直到真正拿到数据为止。)
调用 read 函数在读取到数据前可能被其他信号中断,此时 read 函数也会以出错的形式返回,此时的错误码会被设置为 EINTR,应重新执行 read 函数进行数据的读取。
(简单说:就算没数据,你在排队等的时候可能也会被其他信号"插队"打断。这时 read 也会返回 -1,同时 errno 被设置为 EINTR。处理方式很简单:别管它,重新 continue 循环,再调一次 read 就行。)
因此在以非阻塞的方式读取数据时,若调用 read 函数读取到的返回值为 -1,此时并不应该直接认为 read 函数在底层读取数据时出错,而应该继续判断错误码,若错误码的值为 EAGAIN、EWOULDBLOCK 或 EINTR 则应该继续调用 read 函数再次进行读取。
(简单理解就是:非阻塞读到了 -1,别急着当成真报错。先看 errno:只要它是 EAGAIN、EWOULDBLOCK 或者 EINTR,都说明只是"没数据"或"被信号打断"这种假故障,直接 continue 循环,重新再读一次就行了。)
三.I/O 多路转接
select
(1)初识 select
select是系统提供的一个多路转接的接口,可以用来实现多路复用输入 / 输出模型。
- select系统调⽤是⽤来让我们的程序监视多个⽂件描述符的状态变化的;
- 程序会停在select这⾥等待,直到被监视的⽂件描述符有⼀个或多个发⽣了状态改变;
(2)select函数原型
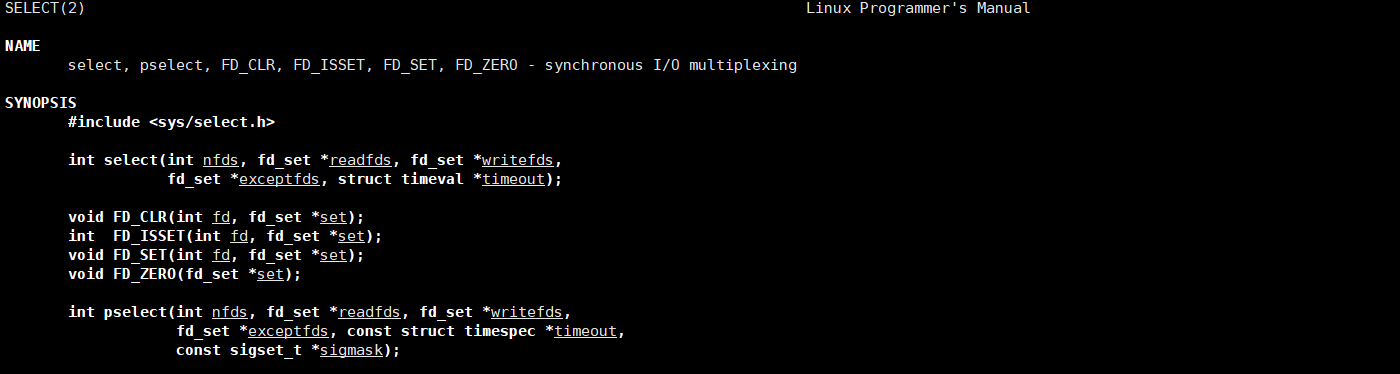
A. 参数解释
- nfds:需要监视的文件描述符中,最大的文件描述符值 +1。
(理解起来就是:告诉内核你要监视的"最大范围",因为文件描述符从 0 开始,所以最大值加 1 就能覆盖全部。注意 Linux 下 select 支持的 fd 最大值通常限制在 1024。)
- readfds:输入输出型参数,调用时用户告知内核需要监视哪些文件描述符的读事件是否就绪,返回时内核告知用户哪些文件描述符的读事件已就绪。(这个参数使用一次过后,需要进行重新设定)
(理解起来就是:这是一张"读事件考勤表"。调用前你把要监视的 fd 打上勾;返回后内核只保留就绪的勾。所以每次重新调用 select 前,都必须重新把表填好,否则第二次就失效了。)
- writefds:输入输出型参数,调用时用户告知内核需要监视哪些文件描述符的写事件是否就绪,返回时内核告知用户哪些文件描述符的写事件已就绪。(这个参数使用一次过后,需要进行重新设定)
(理解起来就是:和上面一样,这是"写事件考勤表"。调用前告诉内核你想监视哪些 fd 的写就绪,返回后内核告诉你哪些 fd 现在能写了。每次调用前都要重新设定。)
- exceptfds:输入输出型参数,调用时用户告知内核需要监视哪些文件描述符的异常事件是否就绪,返回时内核告知用户哪些文件描述符的异常事件已就绪。(这个参数使用一次过后,需要进行重新设定)
(理解起来就是:这是"异常事件考勤表"。比如带外数据到达或某些特殊错误会被捕获。网络编程中较少用到,但同样每次调用前都需要重新设定。)
- timeout:输入输出型参数,调用时由用户设置 select 的等待时间,返回时表示 timeout 的剩余时间。
(理解起来就是:设个闹钟。你想等多久?如果设为 NULL,就是"不设闹钟,死等";如果设为 0,就是"看一眼就回,不等";如果设了具体时间,返回值会告诉你还剩多少时间,方便下次接着用。这也是它作为"输出型参数"的原因。)
B. 参数 timeout 的取值
- NULL / nullptr:select 调用后进行阻塞等待,直到被监视的某个文件描述符上的某个事件就绪。
(理解起来就是:彻底躺平。不设闹钟,死等,直到有人来为止。)
- 0:select 调用后进行非阻塞等待,无论被监视的文件描述符上的事件是否就绪,select 检测后都会立即返回。
(理解起来就是:看一眼就回。不管有没有事件,select 立刻返回,相当于纯粹轮询一次。)
- 特定的时间值:select 调用后在指定的时间内进行阻塞等待,若被监视的文件描述符上一直没有事件就绪,则在该时间后 select 进行超时返回。
(理解起来就是:定个闹钟。在闹钟响之前,如果有人来了就立刻处理;如果一直没人来,等闹钟一响,select 超时返回。)
C. 返回值说明

- 若函数调用成功,则返回事件就绪的文件描述符个数。
- 若 timeout 时间耗尽,则返回 0。
- 若函数调用失败,则返回 -1,同时错误码被设置。
只要有一个 fd 数据就绪或空间就绪,就可以进行返回了。
D. 错误码
select 调用失败时,错误码可能被设置为:
- EBADF:文件描述符为无效的或该文件已关闭。
- EINTR:此调用被信号所中断。
- EINVAL:参数 nfds 为负值。
- ENOMEM:核心内存不足。
E. fd_set 结构
fd_set 结构与 sigset_t 结构类似,其实这个结构就是一个整数数组,更严格的说 fd_set 本质也是一个位图,用位图中对应的位来表示要监视的文件描述符。
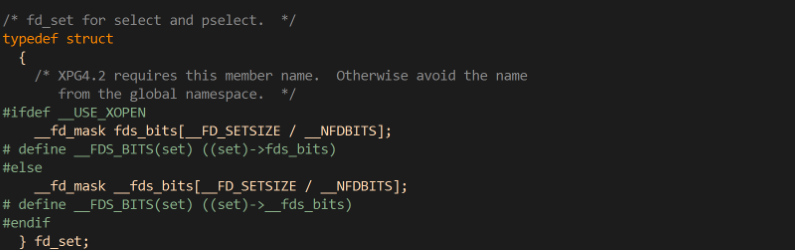
调用 select 函数前,需要通过 fd_set 结构体创建文件描述符集合,再把需要监视的文件描述符添加到这个集合中。添加文件描述符的底层本质是位操作,但这部分位图操作不需要开发者手动实现。系统提供了一组专用宏接口,用来完成对 fd_set 位图的增、删、查、清空等操作。
bash
void FD_CLR(int fd, fd_set *set);  // 用来清除描述词组set中相关fd的位
int FD_ISSET(int fd, fd_set *set); // 用来测试描述词组set中相关fd的位是否为真
void FD_SET(int fd, fd_set *set);  // 用来设置描述词组set中相关fd的位
void FD_ZERO(fd_set *set);         // 用来清除描述词组set的全部位
常用宏:
FD_ZERO:清空集合,位图全部置 0FD_SET:将指定 fd 加入集合,对应位设为 1FD_CLR:将指定 fd 从集合移除,对应位设为 0FD_ISSET:检测 fd 是否在集合中,判断对应位是否为 1
注意:fd_set本质是一个位图,每一位代表一个文件描述符的状态;这几个不是普通函数,是宏定义 。
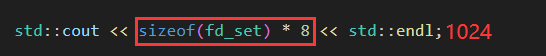
这里一定要注意:fd_set 是一个固定大小的位图,直接决定了 select 能同时关心的 fd 的个数是有上限的。
F. timeval 结构
传给 select 函数的最后一个参数 timeout,是指向 timeval 结构体的指针。timeval 结构体用来设置等待的时间上限:如果在这段时间内,被监视的文件描述符都没有就绪事件,select 就会超时返回,返回值为 0。
该结构体包含两个成员:
- tv_sec:秒
- tv_usec:微秒(1 秒 = 1000000 微秒)
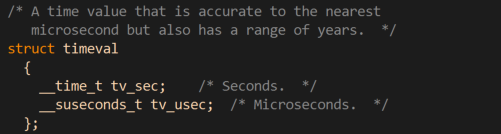
select 可以同时等待多个文件描述符 fd,支持三种等待策略:
- 阻塞等待:timeout 传
nullptr,会一直阻塞,直到有 fd 事件就绪才返回。 - 非阻塞轮询:timeout 设置为
{0, 0},不阻塞,仅检查一次 fd 状态,检测完成立刻返回。 - 限时阻塞:设置 timeout,例如
{5,0},代表最多阻塞 5 秒;如果在超时时间内有 fd 就绪,函数直接返回。
重点:在部分操作系统上,select 返回时会修改 timeout 结构体,此时 timeout 内保存的是剩余还没等待完的时间。这是输出值,不是我们最开始传入的原始超时时间。
a.select 函数返回值
- 调用成功时,返回状态发生变化的文件描述符总数。
- 返回值为 0:代表在超时时间内,所有被监视的文件描述符都没有事件就绪,发生超时。
- 返回值为 -1:代表调用出错,错误码保存在 errno;此时 readfds、writefds、exceptfds 以及 timeout 的值都是不可预测的。
b. 错误值
错误值可能为:
- EBADF:文件描述词为无效的或该文件已关闭。
- EINTR:此调用被信号所中断。
- EINVAL:参数 n 为负值。
- ENOMEM:核心内存不足。
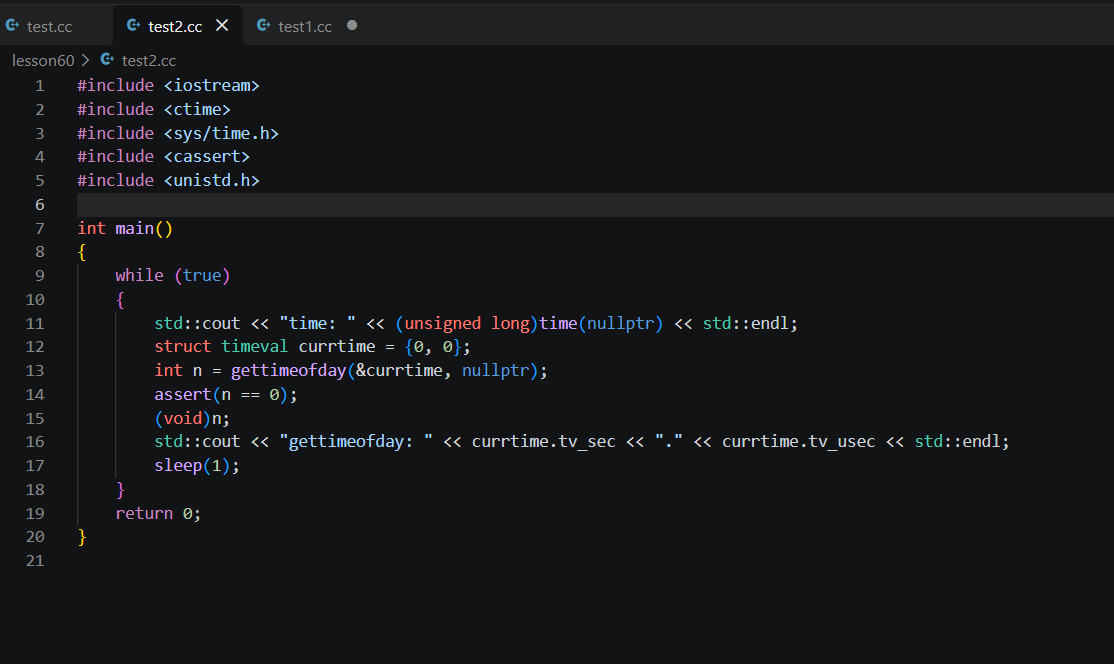
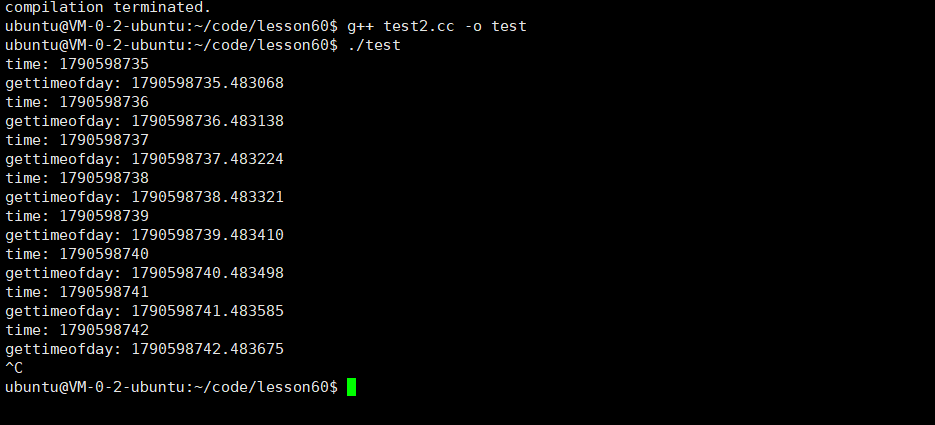
- time(nullptr):返回从 1970-01-01 到现在的总秒数,精度只有秒
- gettimeofday(&currtime, nullptr):拿到tv_sec(秒)+tv_usec(微秒,1 秒 = 1000000 微秒),精度更高
- (void)n;:消除编译器 "变量 n 未使用" 的警告,因为 assert 用完 n 之后没再读它
(3)理解 select 执行过程
理解 select 模型的核心就是理解 fd_set。为方便举例,假设 fd_set 占用 1 字节,fd_set 里的每一个比特位对应一个文件描述符 fd,那么 1 字节长度的 fd_set 最多可以管理 8 个 fd。
- fd_set set; FD_ZERO(&set); 将集合全部清零,位图表示:0000 0000
- 加入 fd=5:FD_SET(5, &set); 把第 5 个比特置 1,位图:0001 0000
- 再加入 fd=2、fd=1:FD_SET(2, &set); FD_SET(1, &set); 位图变成:0001 0011
- 调用 select(6, &set, nullptr, nullptr, nullptr); 阻塞等待事件。
- 等待期间 fd=1、fd=2 产生可读事件,select 函数返回。内核会修改 fd_set,只保留发生就绪事件的 fd 对应的 bit 位,此时 set 的位图变为 0000 0011。
**重点注意:**没有就绪事件的 fd=5,对应的比特位会被内核清空。 这就是 select 的经典坑点:每次 select 返回之后,原来加入集合、但没有就绪的 fd 会被清除。所以循环调用 select 的时候,每次循环都必须重新 FD_ZERO、FD_SET 填充 fd 集合!
(4)socket 就绪条件
A. 读就绪
socket 的读事件就绪条件(select 判定可读):
- socket 内核接收缓冲区的数据字节数 ≥ 接收低水位标记
SO_RCVLOWAT,此时可以无阻塞读取该 fd,read 返回值大于 0。- TCP 通信中,对端关闭连接,此时读取该 socket,read 返回 0。
- 监听 socket(listen 的 fd)上出现新的连接请求。
- socket 上存在未处理的错误。
如何看待 listensock(监听 socket)?
获取新连接的动作,属于 IO 事件,归类为读就绪事件(input 事件) 。 如果没有新连接到达,直接调用
accept就会阻塞。
B. 写就绪
socket 的写事件就绪条件(select 判定可写):
- socket 内核发送缓冲区的空闲空间大小 ≥ 发送低水位标记SO_SNDLOWAT,此时可以无阻塞写入,write 返回值大于 0。
- socket 写通道被关闭(close或shutdown),此时继续写数据,会触发SIGPIPE信号。
- 非阻塞connect完成(连接成功 / 连接失败);或者 socket 上存在尚未读取的错误。
C. 异常就绪(了解)
socket 发生异常就绪的典型场景:收到带外数据。
注意:带外数据依赖 TCP 紧急模式。TCP 报文头部的 URG 标志位,配合 16 位紧急指针,用来实现带外数据的发送与接收。
(5)select 基本工作流程
实现一个简易 select 服务器,功能:读取客户端数据并打印,整体工作流程如下:
- 服务器初始化:完成 socket 创建、bind 绑定、listen 监听。
- 定义_fd_array数组,用来存放监听套接字、以及所有已经和客户端建立好连接的套接字;初始化时,先把监听 fd 放入_fd_array。
- 服务器进入循环,反复调用select,持续检测读就绪事件。
- 每次调用 select 之前: 先定义读文件描述符集合readfds,执行FD_ZERO清空集合,再遍历_fd_array数组,把里面所有 fd 依次通过FD_SET加入readfds,告诉 select 需要监视这些 fd 的读事件。
- select阻塞等待,当检测到 fd 事件就绪后,内核会修改readfds,只保留就绪的 fd。遍历readfds,判断哪些 fd 发生就绪,执行对应逻辑:
- 如果就绪的是监听套接字:调用accept从全连接队列取出新连接,把新客户端 fd 加入_fd_array数组,后续监视这个新 fd。
- 如果就绪的是客户端通信套接字:调用 read 读取客户端数据并打印。
- 特殊情况:read 返回 0,代表客户端关闭连接。服务器调用 close 关闭该 socket,并且把这个 fd 从_fd_array数组移除,不再继续监视。
注意:
- 传给 select 的 readfds、writefds、exceptfds 都是输入输出型参数。select 返回时,这几个集合的内容会被内核修改,所以每次调用 select 前都要重新构建这三个 fd 集合;timeout 也存在同样问题(部分系统会修改该结构体),每次循环同样需要重新赋值。
- 正因为每次调用 select 前都要重新设置 readfds,所以需要定义 _fd_array 数组,用来保存监听套接字以及所有已经和客户端建立好连接的套接字。_fd_array 里面存放的,就是我们希望 select 监视读事件的全部文件描述符。
- 如果 select 服务器只需要读取客户端数据,只需要监视 fd 的读事件即可。如果需要同时监视某些 fd 的读事件和写事件,就要分别维护 readfds 和 writefds 两套集合,并且准备两个独立数组,分别存放待监听读事件、待监听写事件的 fd,方便每次循环前置填充 readfds 和 writefds。
- select 第一个参数要求传入待监视 fd 里的最大文件描述符 +1。因此在每次遍历 _fd_array、填充readfds的同时,还需要记录当前最大的文件描述符。
(6)select 服务器
A. Sock.hpp
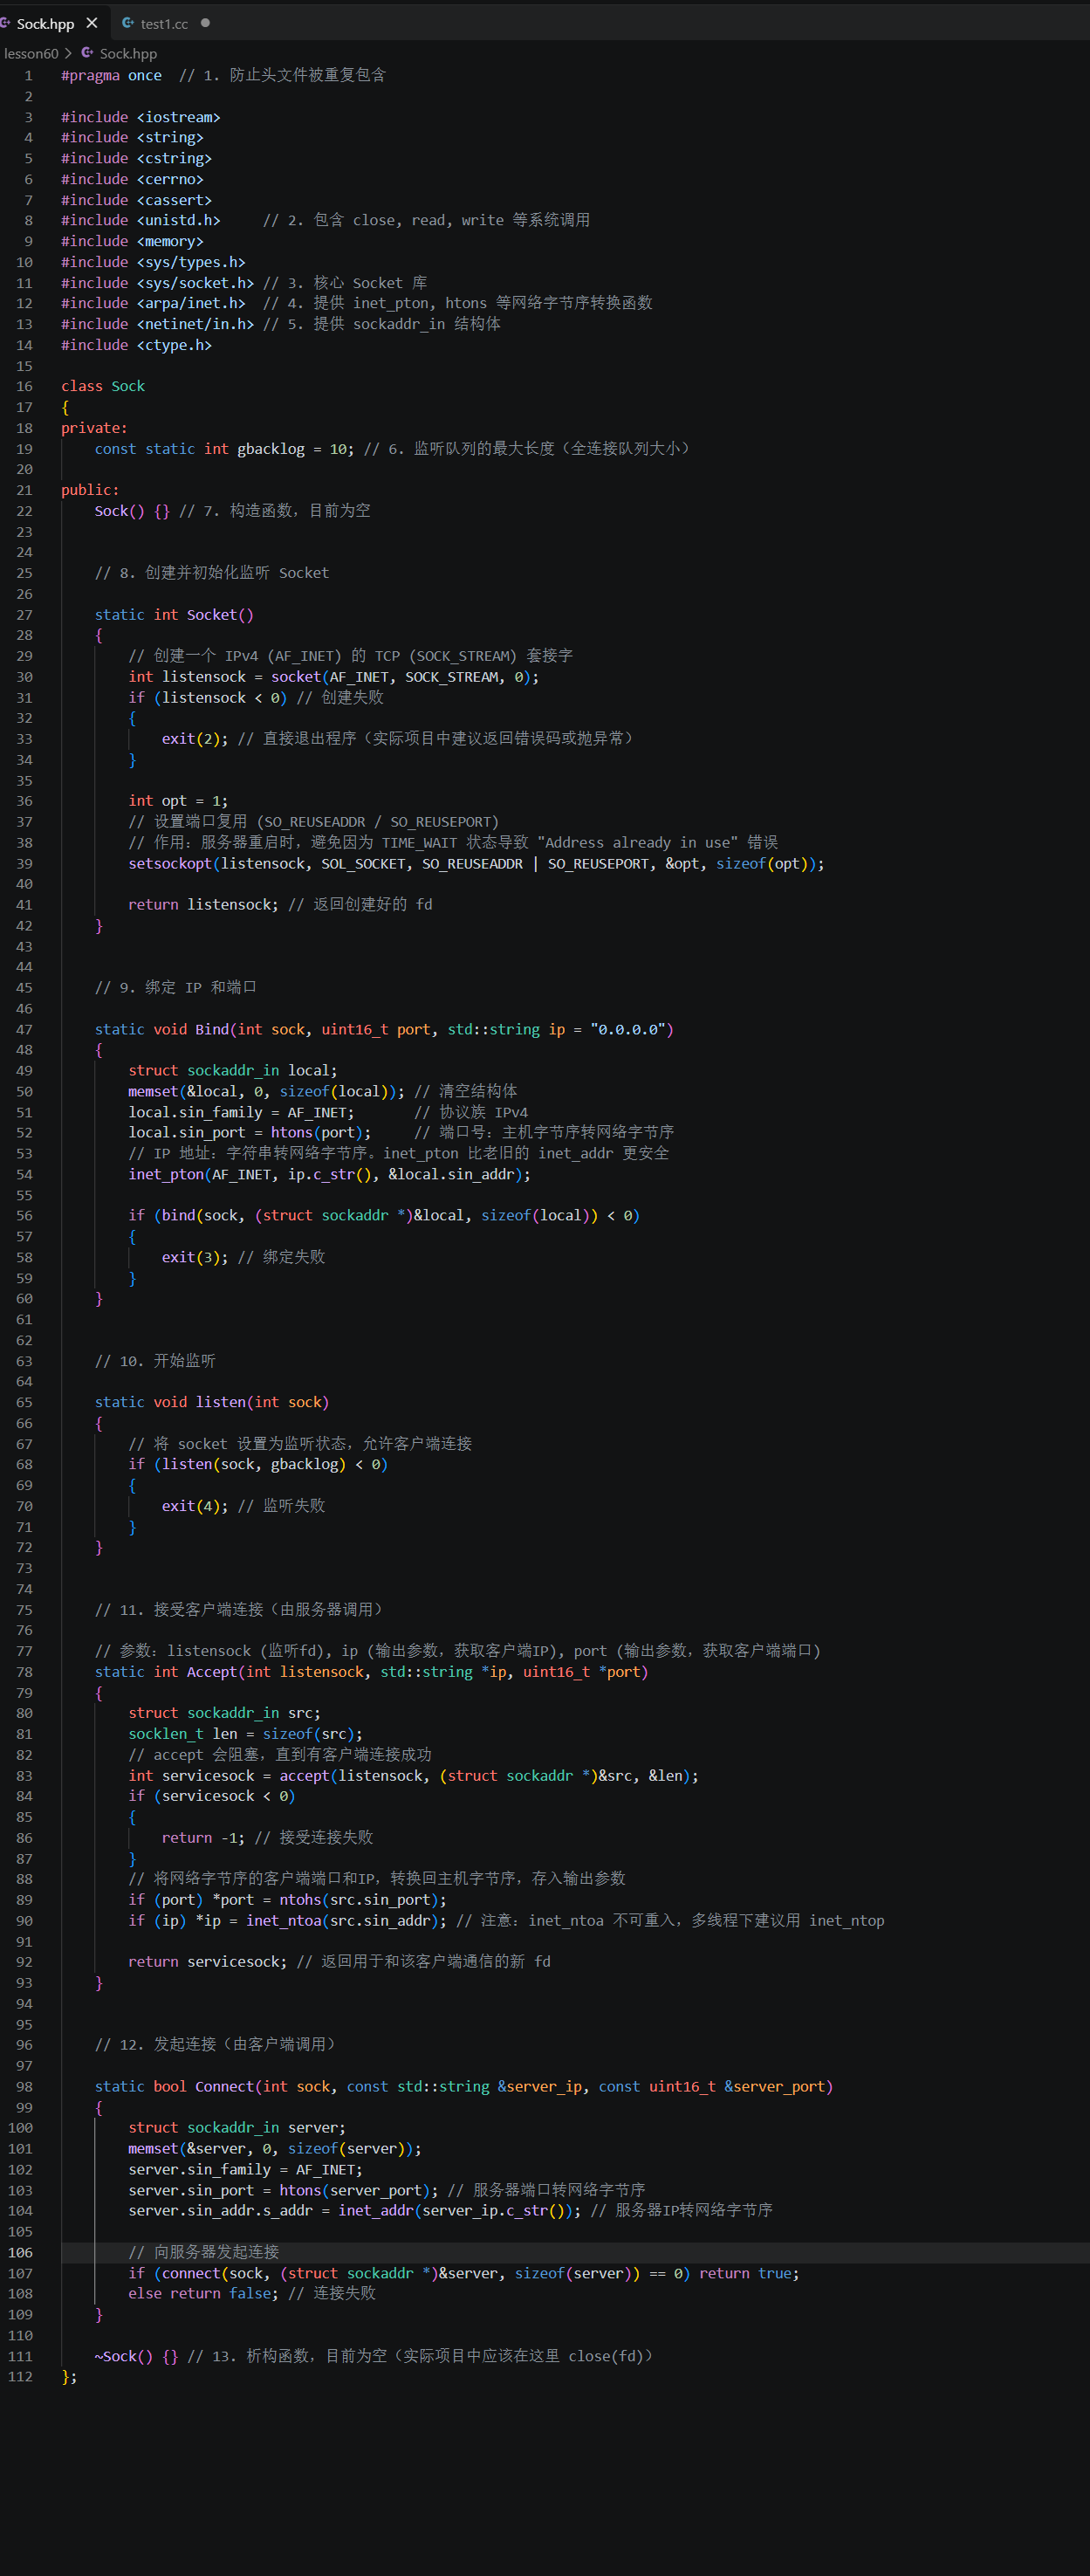
编写一个 Socket 类,对原生套接字系统调用接口做封装。为方便外部直接调用 Socket 类里的封装函数,将部分函数定义为静态成员函数。
代码将 Linux 底层的 Socket 系统调用(如 socket, bind, listen, accept, connect)封装成了一个名为 Sock 的类,方便后续在写服务器或客户端时直接调用,避免重复写繁琐的 sockaddr_in 结构体配置。
B. selectServer.hpp
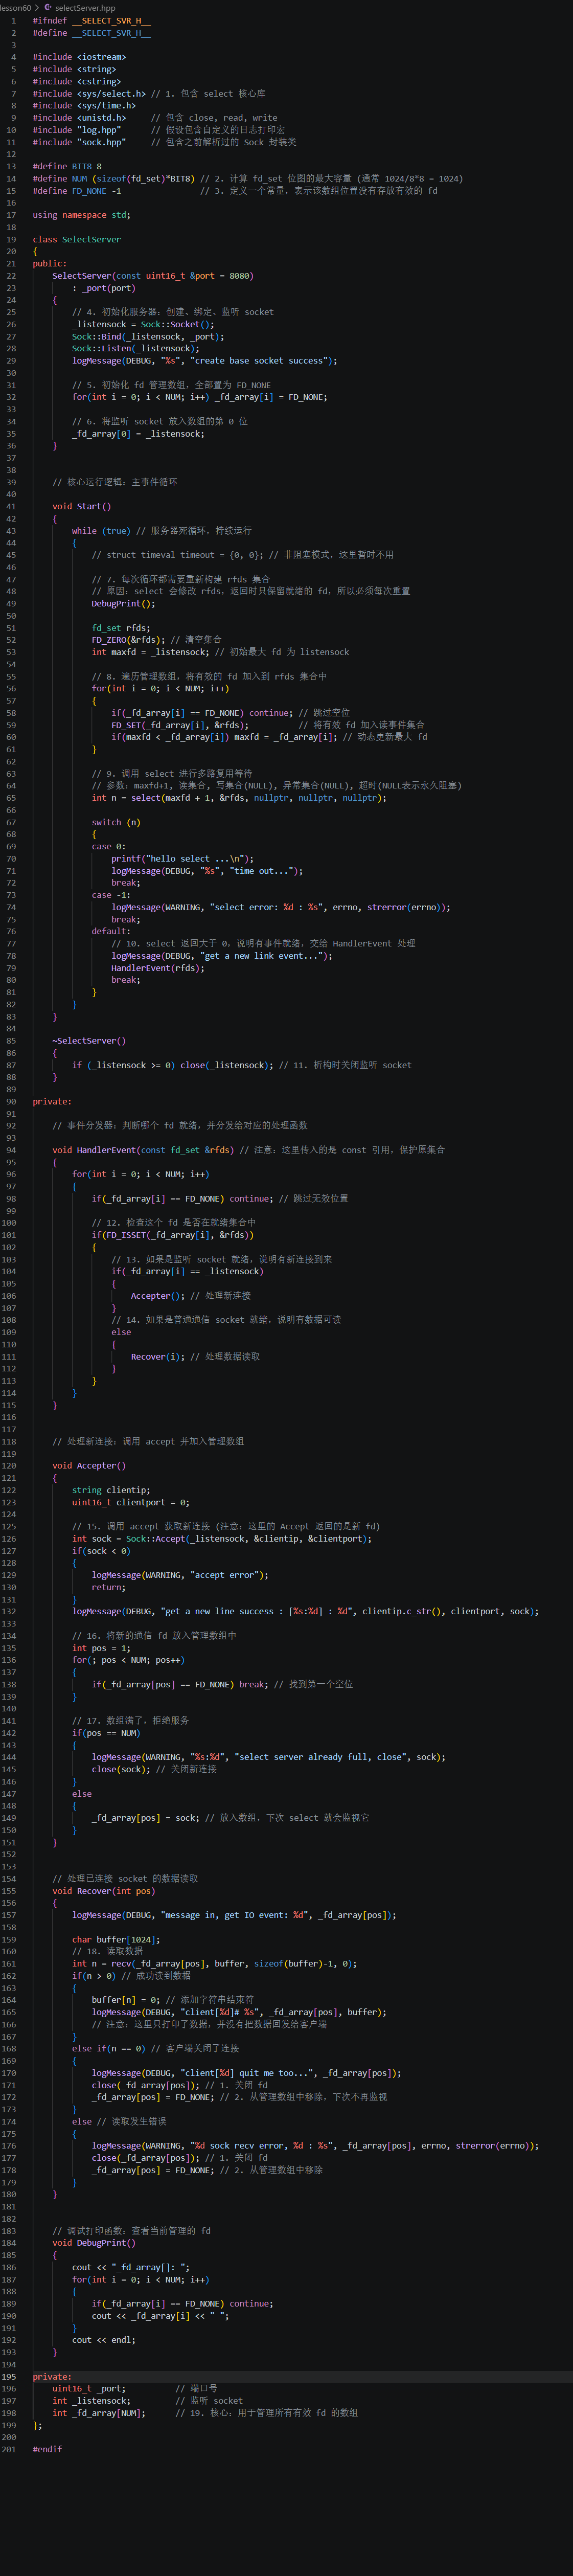
当调用 accept 函数从底层获取上来连接后,不能立即调用 read 函数读取该连接中的数据。因为此时新连接中的数据可能并没有就绪,如果直接调用 read 函数可能发生阻塞,应该将这个等待过程交给 select 函数来完成,因此在获取完连接后直接将该连接对应的文件描述符添加到 _fd_array 数组中即可,当该连接的读事件就绪时再进行数据读取。
(理解就是:刚 accept 上来的新连接,就像刚接通的电话,对方可能还没开口说话。这时候你直接 read 就会卡在那儿死等,影响你处理其他客户端的消息。所以正确的做法是:先把这个新连接的 fd 塞进 _fd_array 里"挂号",然后继续交给 select 去监视。等 select 告诉你这个 fd 有数据了,你再去 read,这就绝对不会阻塞了。
read,这就绝对不会阻塞了。)添加文件描述符到 fd_array 数组中,本质就是遍历 fd_array 数组,找到一个没有被使用的位置将该文件描述符添加进去。但有可能 _fd_array 数组中全部的位置都已被占用,那么文件描述符就会添加失败,此时就只能将刚获取上来的连接对应的套接字进行关闭,因为此时服务器已经没有能力处理这个连接了。
(理解就是:往 _fd_array 里加新 fd,就像去停车场找空车位。从头到尾扫一遍,看到 FD_NONE(空位)就把车停进去。如果扫到最后发现车位全满了(pos == NUM),说明服务器已经到达了处理上限,实在带不动更多连接了。这时候只能狠心拒绝服务,直接 close(sock) 把这个新连接关掉,防止服务器被拖垮)
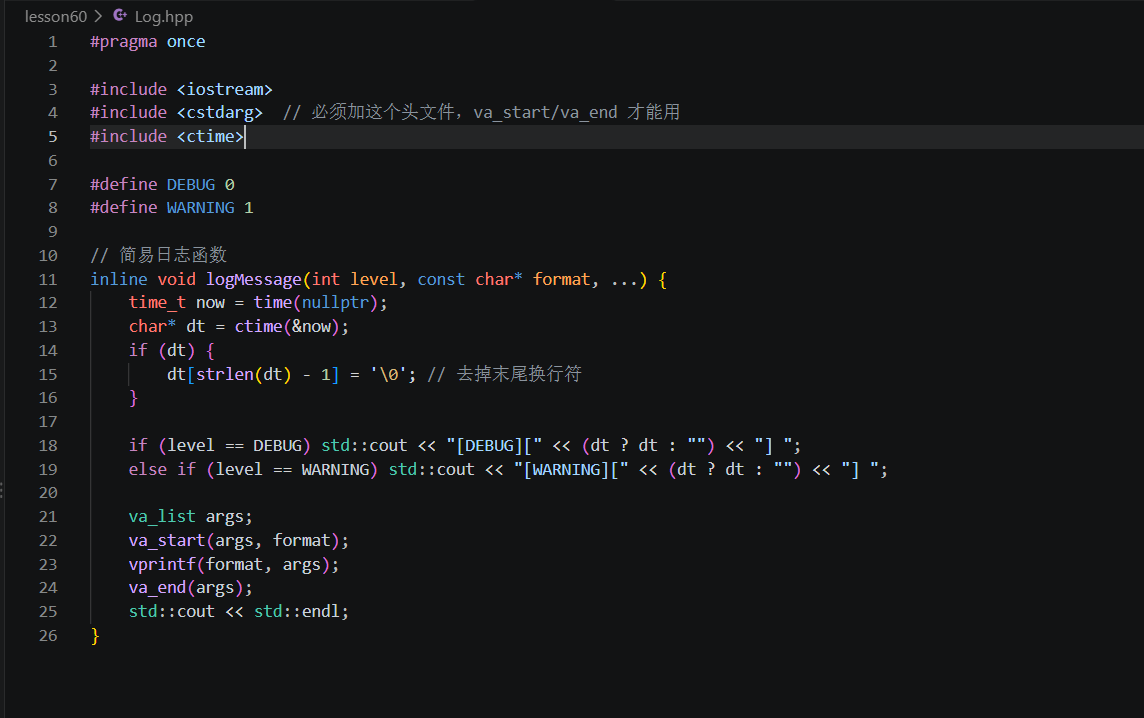
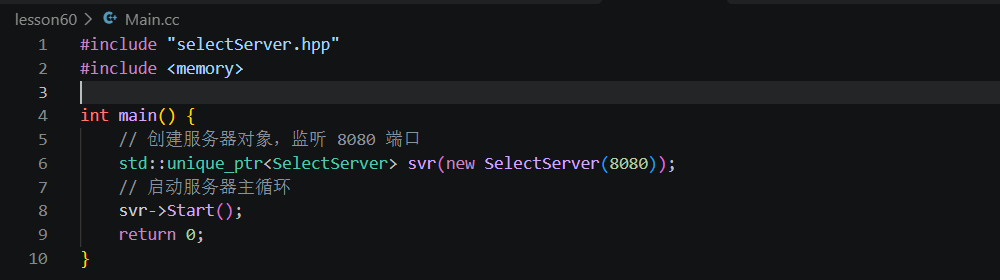
补充接下来的代码:
C. select 服务器测试
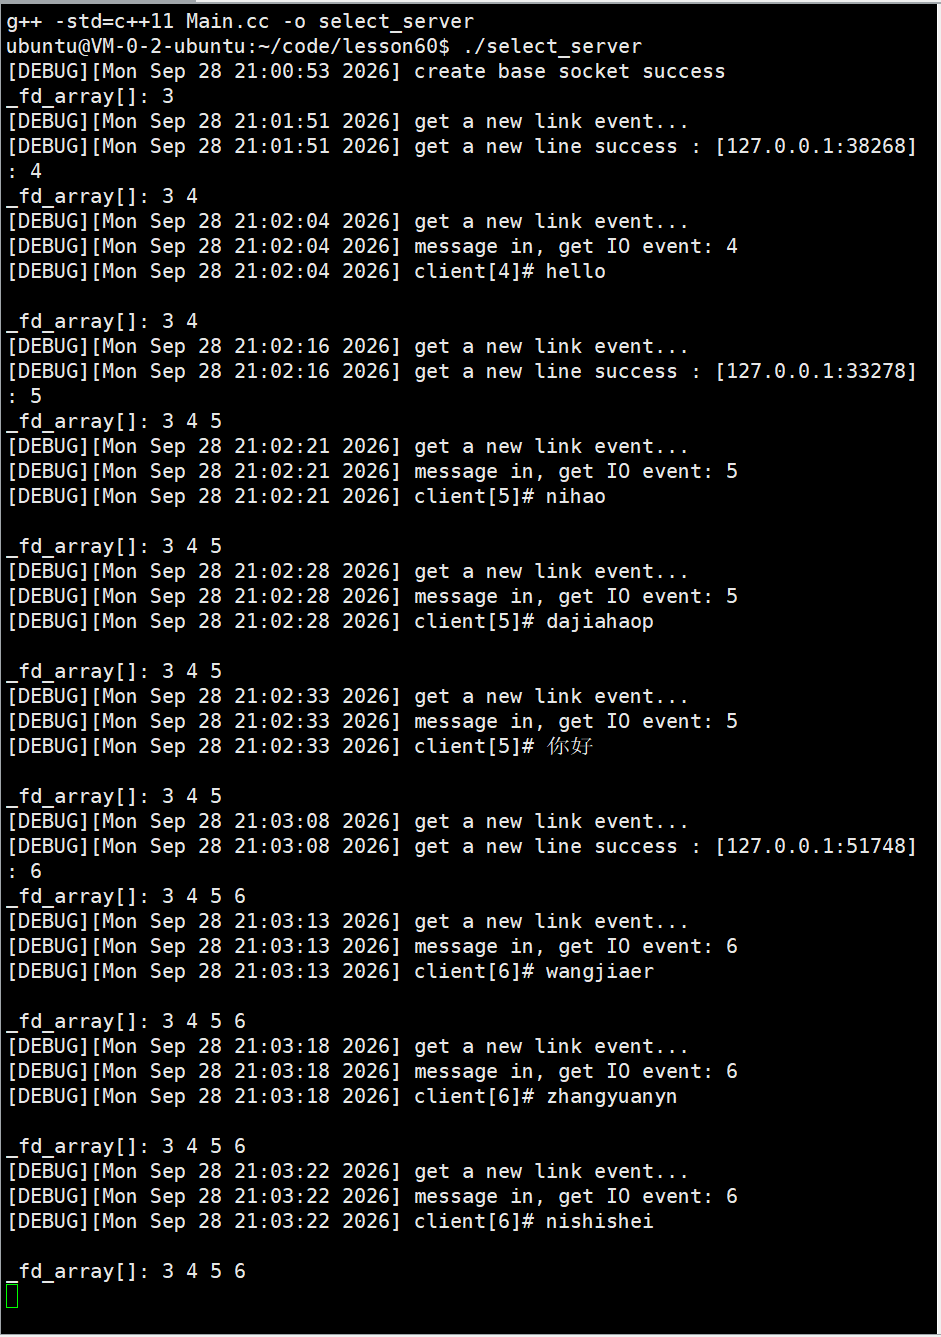
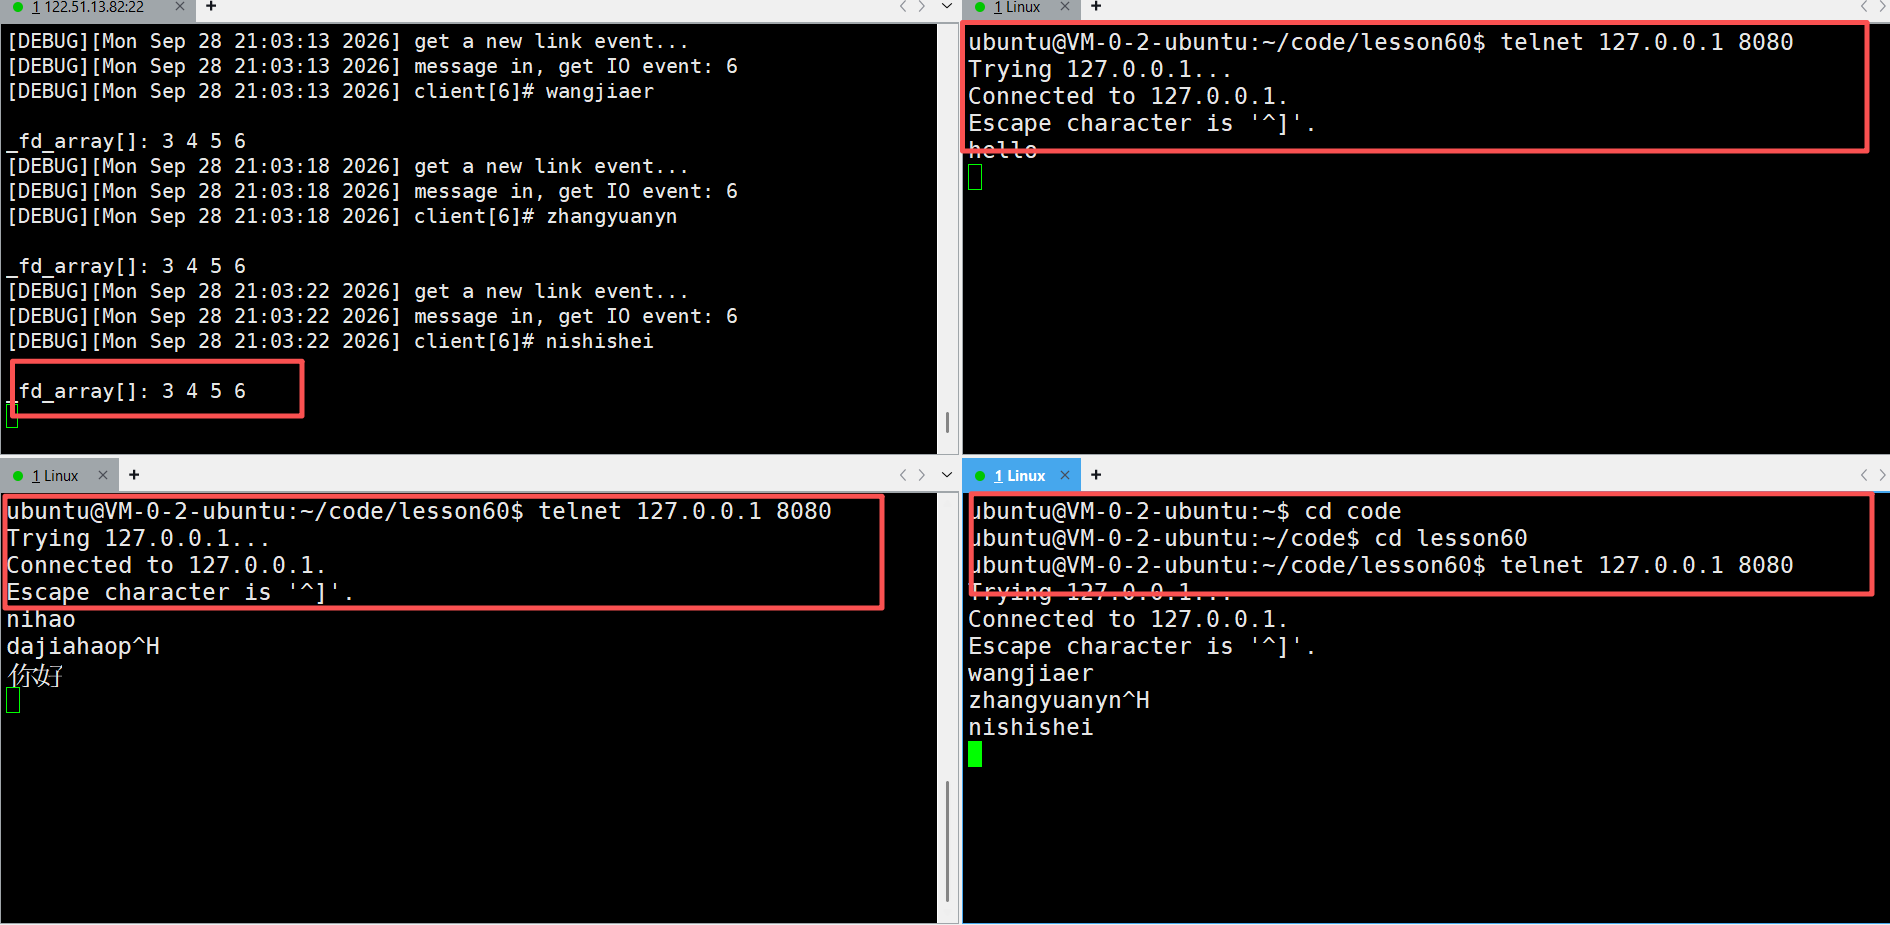
当我关闭一个端口的时候,这里显示quit了,所以数字6也不存在了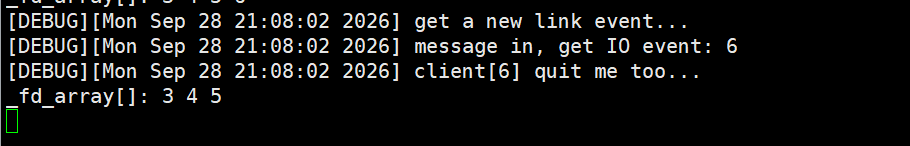
试着关闭其他端口:
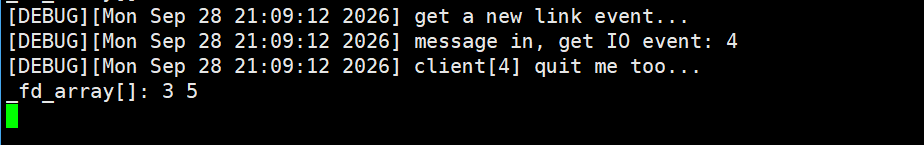
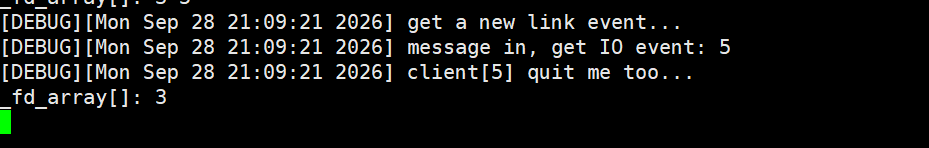
现象分析
现象一:为什么服务器一直打印 _fd_array[]: 3
现象 :程序刚启动,终端会周期性循环打印 _fd_array[]: 3。 原理 :代码是while(true)死循环,每一轮循环都会执行DebugPrint()打印 fd 数组。 程序初始化时,数组内仅有监听套接字_listensock。Linux 中 0、1、2 默认分配给标准输入、标准输出、标准错误,所以第一个创建的 socket 文件描述符一般为 3。
不会卡住的原因:代码给 select 设置了超时。没有客户端事件到来时,select 阻塞等待,超时到期后 select 返回 0,不会一直阻塞,继续进入下一轮循环,因此会反复打印数组内容。
现象二:新客户端连接,服务器可以瞬间响应
现象 :在另一个终端执行
nc 127.0.0.1 8080,服务器立刻打印连接成功信息,并新增 fd(例:4)。 原理 :客户端发起 TCP 连接,三次握手完成后,新连接存入监听 socket 的全连接队列 。 此时监听 fd 的读事件就绪,阻塞在select上的服务器被唤醒,select 返回大于 0 的值,代表存在就绪事件。 代码通过FD_ISSET检测到是监听套接字就绪,调用Accept,从全连接队列取出新连接,得到新的客户端 fd,将其加入_fd_array数组,下一轮 select 就会监视这个新 fd。 所以服务器可以立刻感知新连接,_fd_array内容从3变为3 4。
现象三:客户端发送消息,服务器可以收到数据
现象 :客户端输入nihao,服务器立刻打印
client[4]# nihao。 原理 :客户端发送hello,数据抵达服务器内核接收缓冲区,fd=4 读事件就绪。select被唤醒并返回就绪事件。代码通过FD_ISSET判定就绪 fd 是客户端通信 fd(非监听 fd),调用读取函数,内部执行recv从内核缓冲区读取数据并打印。
现象四:开启两个客户端,服务器能够同时处理
现象 :两个终端分别发送
hello、world,服务器均可即时响应。 原理 :这就是 IO 多路复用 select 模型的核心价值。 服务器是单线程 ,同一时刻只能执行一段代码,但 select 支持同时等待多个 fd 的 IO 事件。 代码将监听 fd (fd3)、客户端 A (fd4)、客户端 B (fd5) 全部放入读集合交给 select 监视。只要任意一个 fd 产生就绪事件,select 就返回,告知程序就绪的 fd,程序再针对性处理该 fd。 单线程就可以轮流处理多个客户端 IO,各个客户端之间不会互相阻塞。
现象五:客户端断开连接,服务器能够感知
现象 :客户端终端退出 nc,服务器打印客户端退出提示,
_fd_array变回3 4。 原理 :客户端关闭连接时,TCP 栈会向服务器发送 FIN 报文。服务器内核收到 FIN 后,将对应的客户端 fd 标记为读就绪。 程序调用recv读取该 fd,对端正常关闭时 recv 返回 0 (不是错误,也不是读到有效数据)。 代码判断返回值 n==0:调用close关闭 socket,将该 fd 从_fd_array管理数组中移除。服务器感知连接断开并释放资源,数组剔除该客户端 fd。
你刚才看到的这一系列现象,就是 select 服务器的完整生命周期 :
初始化:创建监听 socket,放入数组。
主循环 :不断构建
rfds集合,调用select等待事件。事件分发:
监听 socket 就绪 →
accept新连接 → 加入数组。通信 socket 就绪 →
recv读数据 → 打印。通信 socket 断开 →
close+ 从数组移除。无限重复:只要服务器不关,这个循环就永远进行下去。
这就是一个最基础的、基于 select 的多路复用 TCP 服务器模型。
D. 存在的问题
- 写事件处理逻辑不完善 使用select多路 IO 模型时,服务器不能直接调用write向客户端发送数据。write本身包含等待可写、数据拷贝两个阶段,等待可写的过程应当交给select管理。因此每次调用select前,除重置readfds外,还需要重置writefds;同时维护数组记录需要监听写事件的文件描述符,只有文件描述符写就绪时,才调用 write 发送数据。
- 未自定义应用层协议,存在 TCP 粘包风险 代码读取数据没有按照固定规则解析报文,会出现 TCP 粘包问题。
举例:HTTP 协议就是依靠协议规范解决粘包。读到空行代表 HTTP 头部读取完毕,再根据头部Content-Length获取报文正文长度,按长度读取完整报文。依靠协议边界,区分一条条独立报文。
- 缺少输入、输出缓冲区设计 代码直接把读到的数据存入buffer字符数组,设计不严谨。
**输入侧:**单次read读到的数据可能不是完整报文,不能立刻解析处理。应当先存入输入缓冲区,等缓冲区攒出一条完整报文,再交给业务逻辑解析。
**输出侧:**响应数据不可以直接调用write发送。需要先写入输出缓冲区。当数据量较大无法一次性发送时,依靠 select 写事件分批发送。
(7)select 的优点
能够同时监听多个文件描述符,select 仅负责等待事件就绪。当存在大量连接但仅有少量活跃连接时,可以节省系统资源;真正的 IO 读写操作由accept、read、write等函数执行,保证 IO 操作不会发生阻塞。
select 可以并行等待多个文件描述符,实现等待时间的重叠复用,提升 IO 处理效率。
注意:以上优点属于多路转接 IO 接口的共性优点,并非 select 独有。
(8)select 的缺点
- 每次调用 select 都需要手动设置 fd 集合,接口使用繁琐。
- 每次调用 select,需要将 fd 集合从用户态拷贝至内核态,当文件描述符数量较多时,该开销会显著增大。
- 每次调用 select,内核都需要遍历传入的全部文件描述符,fd 数量大时,遍历带来的性能开销较高。
- select 能够监控的文件描述符存在数量上限,可监听 fd 数目有限。
- 服务端代码需要额外维护第三方数组,代码中存在大量遍历操作;在内核监测 fd 就绪时同样需要遍历。
- select 的参数属于输入输出型参数,每次调用前都需要重新设置。
- select 能够同时管理的 fd 的个数是有上限的。
- 频繁在用户态与内核态之间来回拷贝参数,带来额外性能损耗。
- 业务编码实现较为复杂。
A. select 可监控的文件描述符个数
调用 select 函数传入的 readfds、writefds、exceptfds 均为 fd_set 结构体。fd_set本质是位图,使用 1 个 bit 标记一个文件描述符。因此 select 能够监控的文件描述符最大数量,由fd_set所占的 bit 位数决定。
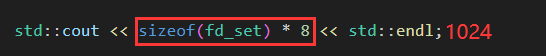
在 Linux 环境下,默认 select 可监控的文件描述符上限为1024。
补充:这个上限是编译期宏FD_SETSIZE固定定义的,不是运行时动态修改,想要扩大上限需要重新编译内核,一般开发中不会这么做。
B. 一个进程能打开的文件描述符个数
进程控制块 task_struct 内存在 files 指针,该指针指向 struct files_struct 结构体,进程的文件描述符表 fd_array 就保存在该结构体中。fd_array 的初始大小由 NR_OPEN_DEFAULT 定义,NR_OPEN_DEFAULT 默认值为 32。
但这不代表一个进程最多只能打开 32 个文件描述符。进程可打开的文件描述符数量支持动态扩展,可以使用 ulimit -a 命令查看当前进程能够打开的文件描述符上限。
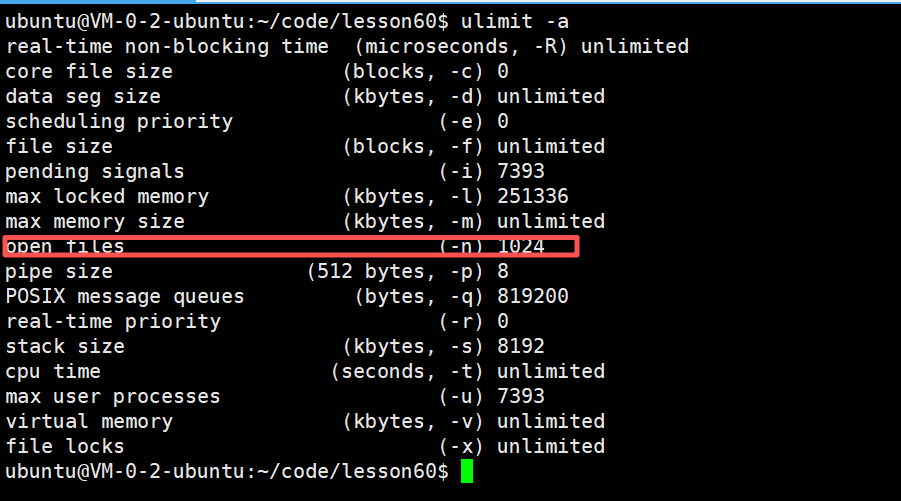
select 可监控的文件描述符个数是 1024,除去监听套接字,那么最多只能连接 1023 个客户端。
(9)select 的适用场景
select、poll、epoll 这类多路转接接口都有对应的适用场景,若使用场景不合适,性能反而会下降。
多路转接接口适合连接数量多,但仅有少量连接处于活跃状态的场景。该场景下绝大多数连接大部分时间都在等待 IO 事件就绪,多路转接能够把多个连接的等待过程重叠,提升 IO 处理效率。
如果大量连接中大部分连接都持续活跃,则不适合使用多路转接。这种场景下各连接的 IO 事件大多随时就绪,不需要等待;而多路转接本身会带来系统时间、空间开销,增加额外损耗。
示例:
- 少量活跃连接:聊天软件。用户登录后长时间不会收发消息,服务器无法对每个连接单独阻塞调用 read 等待数据,适合 select 多路转接。
- 大量活跃连接:企业服务器数据备份。两台服务器持续不断交互数据,连接一直处于活跃状态,几乎不存在等待过程,不需要多路转接。