一、从充分统计量说起
估计一个参数,手上有一串观测 x0,x1,...,xN−1x0,x1,\dots,xN-1x0,x1,...,xN−1。如果能找到一个统计量,知道它的取值就等于知道全部观测里跟参数有关的信息,这个统计量就是充分统计量。这节课的开头先把这条线接了回去。
用查课的场景能把这件事讲得很干净。假设有位督导每天来看上课情况,心情好的时候愿意爬到二楼,心情差的时候就留在一楼;进了教室之后,他挑几位学生看学习情况的方式是固定的。要判断这位督导今天心情如何,需要多少信息?只需要知道他上了一楼还是二楼。他进了哪间教室、点了哪几位学生、这几位学生的学习情况怎么样,这些细节在楼层已知之后就不再提供关于心情的额外信息。楼层就是这个问题的充分统计量。
把这件事拆开看,中间多了一步。原本的任务是从观测反推参数,观测的分布与参数有关,所以样本本身携带信息。插进楼层之后,路线变成观测先归到某一组,再由组别决定参数。组别一旦知道,组内那些样本与参数的条件关系就断了。信息没有被丢掉,只是被挪到了一处,压缩前后的推断能力完全一样。这是充分统计量最根本的一层意思,也是判断一个好统计量的标准:它应当把与参数有关的部分全部留下,把无关的部分全部扔掉。
写成条件密度,就是
p(x∣T(x)=T0;θ)=p(x∣T0)(1-1)p(\mathbf x|T(\mathbf x)=T_0;\theta)=p(\mathbf x|T_0)\tag{1-1}p(x∣T(x)=T0;θ)=p(x∣T0)(1-1)
左端带着参数,右端不带。给定统计量的取值之后,观测的分布与参数无关,参数的全部痕迹都留在统计量的取值里。要验证这件事,直接去算条件密度是一条路;更常用的办法是 Neyman-Fisher 分解,把似然拆成两件事的乘积
p(x;θ)=g(T(x),θ)h(x)(1-2)p(\mathbf x;\theta)=g(T(\mathbf x),\theta)h(\mathbf x)\tag{1-2}p(x;θ)=g(T(x),θ)h(x)(1-2)
一件只通过 T(x)T(\mathbf x)T(x) 与参数发生关系,另一件与参数完全无关。只要似然能拆成这个样子,T(x)T(\mathbf x)T(x) 就是充分统计量。指数族是一眼就能看出分解的样板
f(x;θ)=h(x)expn(θ)T(x)−A(θ)(1-3)f(x;\theta)=h(x)\exp\leftn(\\theta)T(x)-A(\\theta)\\right\tag{1-3}f(x;θ)=h(x)expn(θ)T(x)−A(θ)(1-3)
高斯、二项、泊松这些常用分布都在这个家族里。指数族还附带一条更有用的结论:如果似然的支撑集不随参数移动,而且充分统计量的维数不随样本数增长,那么它必定属于指数族。这一条把充分统计量的存在与不存在划出了一道界线。
有了充分统计量之后,找最优估计器的路子就多了一条,而且是两步走。先随便找一个无偏估计器,不管它有多粗糙;再把这个估计器对充分统计量取条件期望,得到一个新的估计器。这个新的估计器仍然无偏,方差还不会比原来大。原因是条件期望把统计量之外的信息平均掉了,剩下的只有对参数有用的部分。
第二步还可以再收紧。如果充分统计量是完备的,满足期望恒为零的函数只有恒等于零的那一个,那么在它上面能构造出来的无偏函数就只有一个,那个函数就是最小方差无偏估计。坦克问题就是照着这条路线解出来的:最大值是充分统计量,在它上面找无偏函数,找到什么就是什么,不必再跟别的估计器比较。
统计量通常不止一个,其中元素个数最少的那个叫最小充分统计量。判据有两条:它本身是充分统计量;任何别的充分统计量都能写成它的函数。别的统计量都是在它基础上再加工出来的,反过来做不到。
直观的图景可以这么看。统计量把观测空间切成若干组,T(x)T(\mathbf x)T(x) 取值为 1 的那些点是一组,取值为 2 的是另一组,以此类推。组内各点的密度高低之比是固定的,因为式(1-2)里那个与参数无关的因子在组内处处相同。参数一变,整组被一起抬高或者压低,组内的相对形状不动。只要知道观测落在哪一组,参数会怎样影响这组数据就已经完全确定,组内的具体位置不再增加信息。这就是充分统计量的全部含义。
工程上的好处很直接。估计一个直流电平,最优估计是样本均值。不知道充分统计量,采一百万次就得把一百万个样本都存下来,最后一起求平均;知道充分统计量是累加和,那就只需要一个累加器,每来一个样本做一次累加,内存需求从一百万降到一。
二、BLUE:不碰分布,只碰一阶与二阶统计量
前面几讲的办法都有一个共同前提,就是知道观测的概率密度。模型一线性、噪声一高斯,估计器的公式可以直接写出来,而且往往就是有效估计器。剩下的一块是噪声不是高斯的时候怎么办。把这门课到目前为止的结论摆成一张图,位置就清楚了。
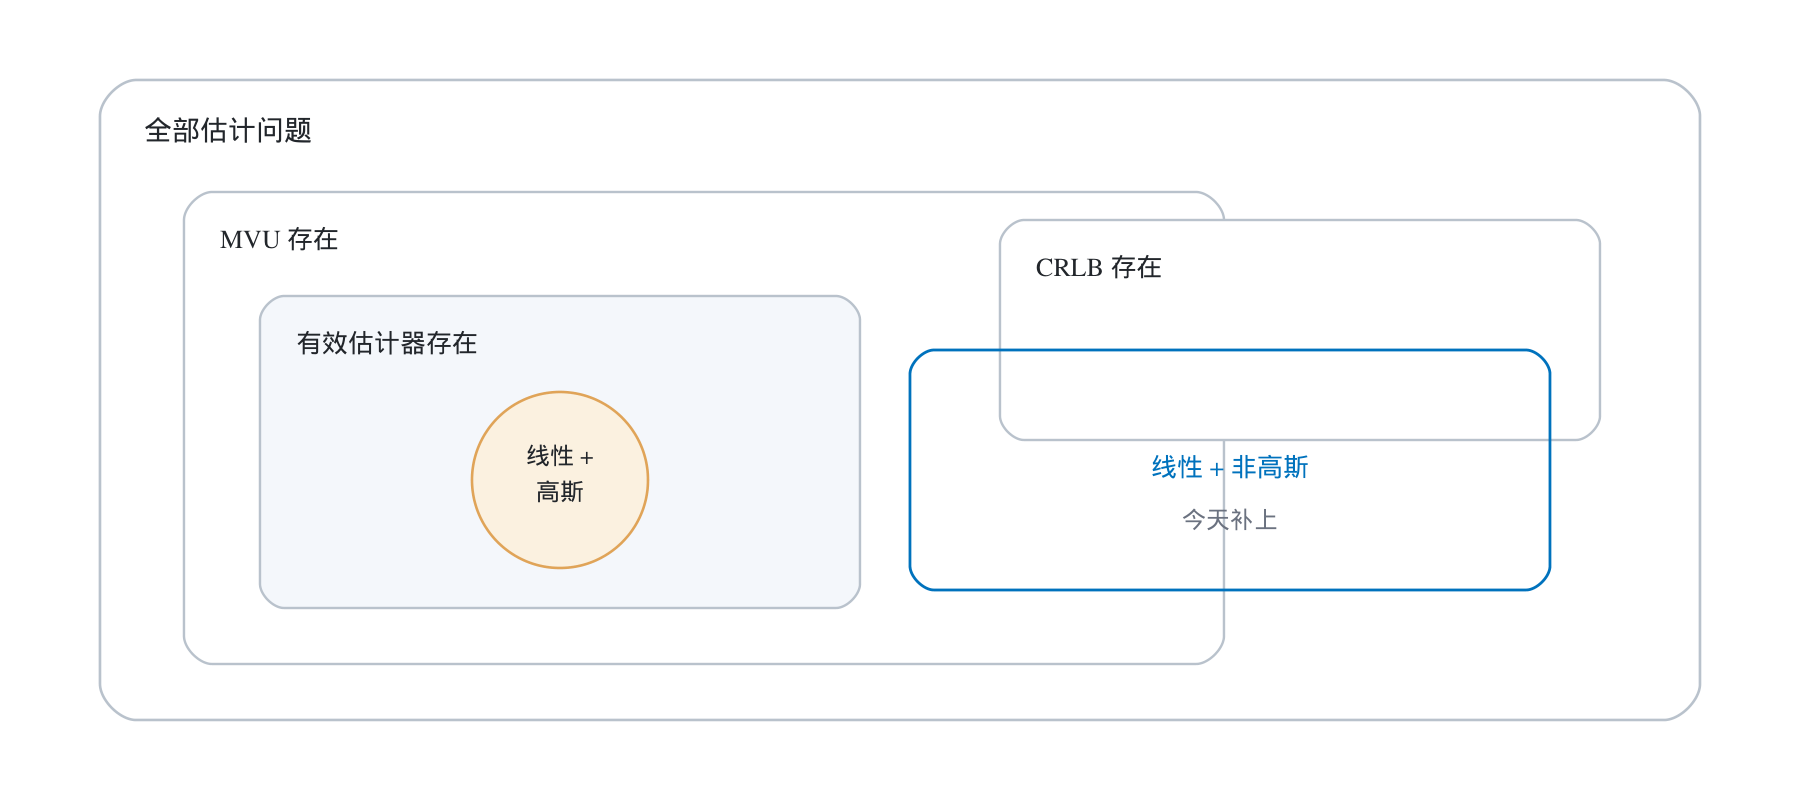
所有估计问题的集合是最大的那一块。里面一块是最小方差无偏估计存在的部分,再往里一块是有效估计器存在的部分;有效估计器一旦存在,它必定是最小方差无偏估计。克拉美罗界是否存在是一条独立的界线,均匀噪声下它不存在,拉普拉斯噪声下它存在。线性模型加高斯噪声这一小块完全落在最里面。要放进去的是线性模型加非高斯噪声,它落在哪一层,取决于把估计器的形式限制住之后还能做到什么。
限制是这样下的
θ^=∑n=0N−1anxn=aTx(2-1)\hat\theta=\sum_{n=0}^{N-1}a_n xn=\mathbf a^T\mathbf x\tag{2-1}θ^=n=0∑N−1anxn=aTx(2-1)
估计值必须是观测的线性组合,系数是一组待定的 ana_nan。在这组限制里满足无偏条件、并且方差最小的那一个,就是最优线性无偏估计器。名字里的三个词分别对应三件事:best 指在所有可能的系数上取方差最小,unbiased 指无偏,linear 指线性的形式。
它什么时候是最优的?如果能证明最小方差无偏估计本身就是数据的线性函数,那么它就等于 BLUE。直流电平加高斯白噪声属于这种情形,最小方差无偏估计是样本均值,本身线性,两者重合。它什么时候是次优的?最小方差无偏估计一旦是非线性的,BLUE 就只是一个折中选择,性能弱于前者。坦克问题属于这种情形。每辆坦克的编号在 0 到总数之间均匀分布,观测到的是一段时间里派出的编号,最小方差无偏估计取观测最大值乘以一个尺度因子,是最大值的函数而不是线性函数;BLUE 只能把这些编号线性地加权起来,得到的估计器与它不同。坦克问题里最小方差无偏估计是怎么来的,可以从一处细节看出来:观测中的最大值是充分统计量,它的期望等于 N/(N+1)N/(N+1)N/(N+1) 乘以总数,偏离恰好是一个只跟样本数有关的因子;把这个因子除掉,估计器就无偏了,得到的就是最大值乘上 (N+1)/N(N+1)/N(N+1)/N。
最小方差无偏估计在多数问题里都不线性,这就是名字里要专门加上 best linear 这个限定的原因。限定一处形式,换来的是求解所需信息的减少,代价是性能上的让步。
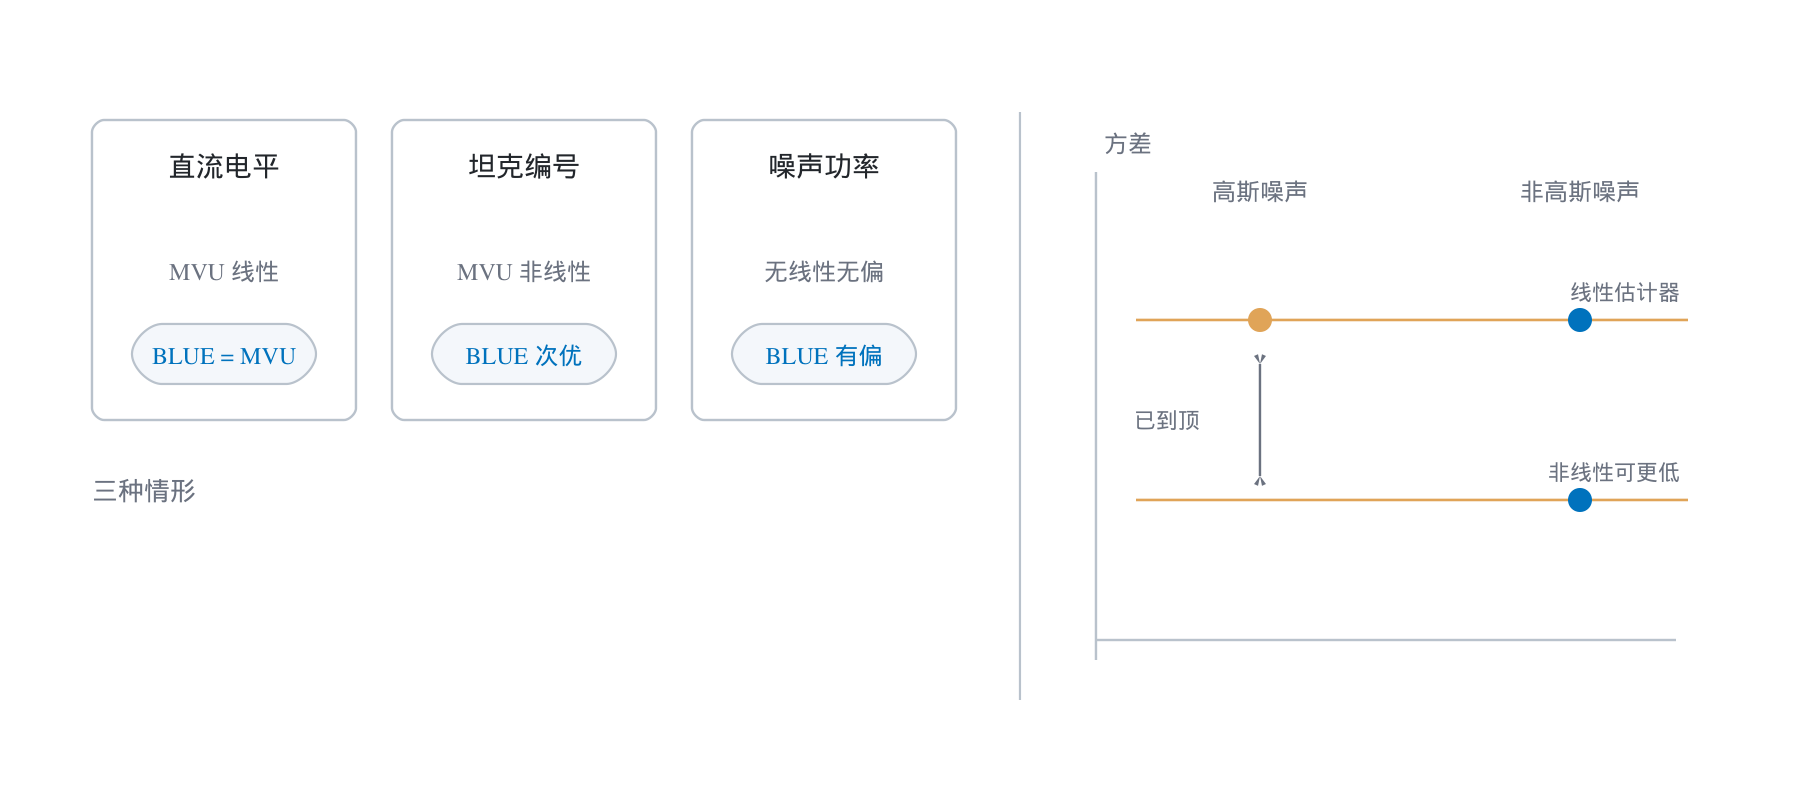
三个例子摆在一起,BLUE 的位置就清楚了。直流电平那一列,最小方差无偏估计是线性的,两者重合;坦克编号那一列,最小方差无偏估计取的是最大值,是非线性的,BLUE 只能落在边界的另一侧;噪声功率那一列更极端,线性的无偏估计根本不存在,硬套公式得到的估计器恒有偏离,方差也压不下去。同一张图的右半部分是性能对照:噪声服从高斯分布时,线性估计器就是最优的,方差落在一个确定的位置;噪声偏离高斯时,线性估计器的方差不变,但非线性估计器还能把方差压得更低,最低点比高斯情形更低。
真正让 BLUE 立得住的是它对信息的需求量。求解它需要知道的东西只有两样,一是每个观测的均值
E(x)=sθ(2-2)E(\mathbf x)=\mathbf s\theta\tag{2-2}E(x)=sθ(2-2)
二是观测之间的协方差矩阵
C=E(x−Ex)(x−Ex)T(2-3)C=E\left(\\mathbf x-E\\mathbf x)(\\mathbf x-E\\mathbf x)\^T\\right\tag{2-3}C=E(x−Ex)(x−Ex)T(2-3)
也就是一阶统计量和二阶统计量。概率密度长什么样完全不用管,它可以是高斯的、均匀的、拉普拉斯的,甚至是根本写不出来的。一阶和二阶统计量在工程上又恰好是好拿的,采一批样本就能估出它们的经验值,代进公式就得到一个估计器。这是 BLUE 存在的全部理由:不是因为它最优,而是因为它对模型的要求最低。
限制住形式当然是要付代价的,代价有时大到不能接受。考虑估计一段高斯白噪声的功率,观测就是噪声本身,xn=wnxn=wnxn=wn,要估的是 σ2\sigma^2σ2。最小方差无偏估计是把观测平方之后求平均
θ^=1N∑n=0N−1x2n(2-4)\hat\theta=\dfrac{1}{N}\sum_{n=0}^{N-1}x^2n\tag{2-4}θ^=N1n=0∑N−1x2n(2-4)
这个估计器显然不是线性的。硬要在线性组合里找一个无偏估计会立刻卡住:噪声的均值是零,任何系数的线性组合的均值都是零,不可能等于要估的功率。公式推到底,得到的那个线性估计器的期望恒为零,与功率没有任何关系,方差还很大。要补上这一步,得先对数据做一次变换,把观测平方成新的观测 yn=x2nyn=x^2nyn=x2n,新观测的均值恰好是 σ2\sigma^2σ2,再对 ynynyn 套 BLUE,得到的正好就是式(2-4)。
这一步相当于先加一次预处理再套公式。预处理的方向来自领域知识:知道功率和观测平方有关系,所以先平方再线性加权。问题复杂到看不出背后是什么的时候,这一步就做不出来。所以 BLUE 的适用范围有边界,它适合模型近似已知、分布写不出来、并且只关心前两阶矩的场合。
三、约束下求最小方差
把 BLUE 的求解过程完整走一遍。无偏条件先写出来
E(θ^)=∑n=0N−1anE(xn)=θ(3-1)E(\hat\theta)=\sum_{n=0}^{N-1}a_nE(xn)=\theta\tag{3-1}E(θ^)=n=0∑N−1anE(xn)=θ(3-1)
左边是各个观测均值的加权和。要想让这个式子对所有的参数值都成立,每个观测的均值必须与参数成比例,也就是 E(xn)=snθE(xn)=sn\thetaE(xn)=snθ。这一步是硬约束,不满足它就没有线性无偏估计。有了它,观测可以改写成
xn=θsn+wn(3-2)xn=\theta sn+wn\tag{3-2}xn=θsn+wn(3-2)
其中 wn=xn−E(xn)wn=xn-E(xn)wn=xn−E(xn) 是零均值的随机部分。这与第四章的线性模型形式相同,区别只在 wnwnwn 不再是高斯的,它可以是任意分布,只要零均值、协方差已知。
目标是让方差最小,方差写成矩阵形式是 aTCa\mathbf a^TC\mathbf aaTCa,约束是 aTs=1\mathbf a^T\mathbf s=1aTs=1。于是问题变成一个带等式约束的二次优化
mina aTCas.t.aTs=1(3-3)\min_{\mathbf a}\ \mathbf a^TC\mathbf a\quad\mathrm{s.t.}\quad\mathbf a^T\mathbf s=1\tag{3-3}amin aTCas.t.aTs=1(3-3)
用拉格朗日乘子把它变成无约束问题
J=aTCa+λ(aTs−1)(3-4)J=\mathbf a^TC\mathbf a+\lambda\left(\mathbf a^T\mathbf s-1\right)\tag{3-4}J=aTCa+λ(aTs−1)(3-4)
对系数向量求偏导并置零,用的是前几讲反复用过的矩阵求导工具
∂J∂a=2Ca+λs=0(3-5)\dfrac{\partial J}{\partial\mathbf a}=2C\mathbf a+\lambda\mathbf s=\mathbf 0\tag{3-5}∂a∂J=2Ca+λs=0(3-5)
解出 a\mathbf aa,它是 λC−1s\lambda C^{-1}\mathbf sλC−1s 的一个倍数。剩下的工作是把 λ\lambdaλ 定下来,办法是回代约束。代入之后约束变成
aTs=−λ2sTC−1s=1(3-6)\mathbf a^T\mathbf s=-\dfrac{\lambda}{2}\mathbf s^TC^{-1}\mathbf s=1\tag{3-6}aTs=−2λsTC−1s=1(3-6)
λ\lambdaλ 由此确定,系数向量也就定了。把系数代回估计式,得到最优线性无偏估计器
θ^=sTC−1xsTC−1s(3-7)\hat\theta=\dfrac{\mathbf s^TC^{-1}\mathbf x}{\mathbf s^TC^{-1}\mathbf s}\tag{3-7}θ^=sTC−1ssTC−1x(3-7)
它的方差随之而来
var(θ^)=1sTC−1s(3-8)\mathrm{var}(\hat\theta)=\dfrac{1}{\mathbf s^TC^{-1}\mathbf s}\tag{3-8}var(θ^)=sTC−1s1(3-8)
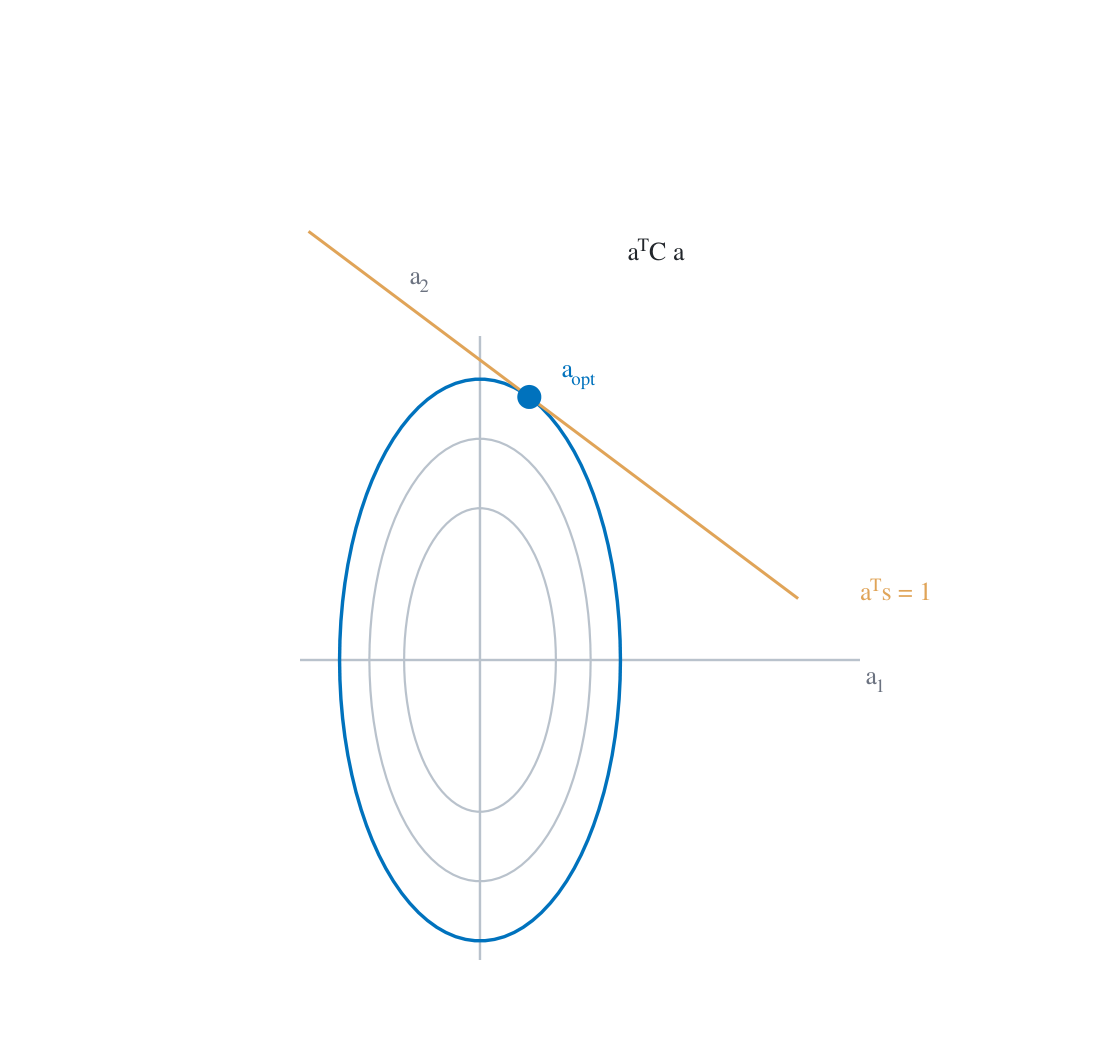
这一步的几何含义在图 3 里。等值椭圆是 aTCa\mathbf a^TC\mathbf aaTCa 的等高线,直线是约束 aTs=1\mathbf a^T\mathbf s=1aTs=1。要在这个约束面上找椭圆最小的那一圈,最优点就是直线与某条等值椭圆的切点。切点位置由协方差矩阵和向量 s\mathbf ss 共同决定,两者都已知,切点就是确定的。
参数是多个的时候,把向量写成矩阵即可。观测的均值写成 E(x)=HθE(\mathbf x)=H\boldsymbol\thetaE(x)=Hθ,无偏条件变成矩阵方程 AH=IAH=IAH=I,代价函数变成每个分量各自的 akTCak\mathbf a_k^TC\mathbf a_kakTCak。同一套拉格朗日方法走下来,结果是
θ^=(HTC−1H)−1HTC−1x(3-9)\hat{\boldsymbol\theta}=(H^TC^{-1}H)^{-1}H^TC^{-1}\mathbf x\tag{3-9}θ^=(HTC−1H)−1HTC−1x(3-9)
它的协方差矩阵是
Cθ^=(HTC−1H)−1(3-10)C_{\hat{\theta}}=(H^TC^{-1}H)^{-1}\tag{3-10}Cθ^=(HTC−1H)−1(3-10)
式(3-9)还有一个更容易记住的等价写法。换一个提法,不去求系数向量,而是直接找一个参数值,让观测与模型之间的加权平方误差最小
minθ (x−Hθ)TC−1(x−Hθ)(3-11)\min_{\boldsymbol\theta}\ (\mathbf x-H\boldsymbol\theta)^TC^{-1}(\mathbf x-H\boldsymbol\theta)\tag{3-11}θmin (x−Hθ)TC−1(x−Hθ)(3-11)
把它对参数求偏导并置零,解出来的正是式(3-9)。两个角度落在同一个答案上:一个是系数约束下的最小方差,一个是加权最小二乘。从约束优化那一侧看,要同时满足的只有两个条件,系数必须落在 aTs=1\mathbf a^T\mathbf s=1aTs=1 这个面上,以及拉格朗日函数对系数的偏导为零,也就是式(3-5)与式(3-6)。带等式约束的最小化问题都要同时满足这两条,别的最优性条件在这个问题里已经被它们包住了。
式(3-9)里的协方差矩阵如果缩成 σ2I\sigma^2Iσ2I,它就退化成 (HTH)−1HTx(H^TH)^{-1}H^Tx(HTH)−1HTx,正好是高斯白噪声下线性模型的最小方差无偏估计,也就是前几讲出现的那个伪逆形式。两条路走到同一个地方,说明线性模型下估计器的形式与噪声分布无关。
还可以换一个角度看这件事。既然噪声不是高斯的,那就对数据先做一个线性变换,把噪声白化,再用高斯白噪声下的结论。算出来的结果与式(3-9)完全一致。结论落在这里:对于一个线性模型,不论噪声服从什么分布,只要协方差矩阵相同,最优线性估计器的形式都一样,差别只在性能。
式(3-7)能写出来,靠的是每个观测的均值都与参数严格成比例,比例系数 snsnsn 已知。这个比例关系不成立,线性无偏估计就根本不存在。至于 s\mathbf ss 与 CCC,它们本身也是可以估的量:采一批样本算出经验均值和经验协方差,代回公式就是一个能用的估计器,不必先写出概率密度。线性方法在工程上受欢迎,原因就在这里,它对模型的要求低到只剩均值结构和二阶矩。
性能的差别在哪里?噪声是高斯的,得到的 BLUE 就是最小方差无偏估计,是最优的;噪声不是高斯的,BLUE 不是最优的,只是线性的里面最好的那一个。非线性的估计器还能把方差压得更低。于是得到一句反直觉的话:在估计问题里,高斯噪声是最坏的噪声。噪声是高斯的,性能已经到顶,没有再往下压的余地;噪声一旦偏离高斯,反而存在比 BLUE 更好的估计器,可达的最小方差比高斯情形更小。把这条结论再证一遍还有两条路可走,一条走变分法,一条借费希尔信息与 KL 距离之间的关系,两条都指向同一个判断。
回到图 1 那张版图。线性信号加非高斯噪声这一块,与有效估计器那一块不相交,因为一般情况下并不存在有效估计器;它与克拉美罗界那一块有交集,均匀噪声下界不存在,拉普拉斯噪声下界存在;它与最小方差无偏估计那一块也可能相交,但最小方差无偏估计是否总存在,这个问题本身还没有明确答案。既有界又没有最小方差无偏估计的那一小片,就是下一节要处理的地带。
四、TDOA:把非线性模型线性化
把 BLUE 的公式用起来,最典型的一个例子是到达时间差定位。
场景是这样:几个基站分布在一片区域里,一个终端在中间。终端到各个基站的传播时间可以测出来,乘以光速就是距离。如果测到的几个距离都准确,终端的位置就是几个圆的交点;如果测的是两两之间的时间差,位置就在双曲线上,几个双曲线相交就是答案。有了噪声之后,每条曲线都会偏一点,交点位置对曲线的偏移极其敏感,稍微偏一点,交点就跑出很远。所以这条路有两个麻烦:几何上解交点本身就不容易,噪声下解的误差还会被放大。
绕开麻烦的办法是在一个已知位置附近把模型线性化。真实位置在上一个时刻的估计位置附近,把每个基站对应的距离在这一点做泰勒展开,只保留一阶项,该基站对应的时延就近似成一个已知量加上位置增量的线性组合
τi≈τi(0)+αi1Δx+αi2Δy(4-1)\tau_i\approx\tau_i^{(0)}+\alpha_{i1}\Delta x+\alpha_{i2}\Delta y\tag{4-1}τi≈τi(0)+αi1Δx+αi2Δy(4-1)
其中 αi\alpha_{i}αi 是该基站的方位余弦,是几何上完全已知的量。式(4-1)已经是线性的,但还不能直接用,因为终端与基站的时钟不同步,测到的时延里含一个固定的钟差。基站之间的同步做起来容易,这个偏差主要来自终端一侧。
消掉它的办法是两两相减
Δτij=τi−τj(4-2)\Delta\tau_{ij}=\tau_i-\tau_j\tag{4-2}Δτij=τi−τj(4-2)
相减之后钟差被抵消,剩下的就是两个基站之间真正的传播时间差,也就是这个定位体制名字里的那个量。把所有配对写在一起,就是一个标准的线性模型
Δτ=HΔp+w(4-3)\Delta\boldsymbol\tau=H\Delta\mathbf p+\mathbf w\tag{4-3}Δτ=HΔp+w(4-3)
待估参数是位置增量 Δp\Delta\mathbf pΔp,观测是测得的时间差,噪声 w\mathbf ww 是原来的噪声两两相减的结果,均值依然为零,协方差矩阵可以由原噪声的协方差推出来。到这里就可以直接套式(3-9)了。期望和协方差都已知,估计器写出来就结束了。
差分会改变噪声的相关结构。两个基站的时间差是两个观测相减的结果,均值仍然为零,协方差则要从原噪声的协方差推出来,元素由原来的自相关与互相关组合而成。这一步是纯矩阵运算,做完之后线性模型的三个量就齐了。
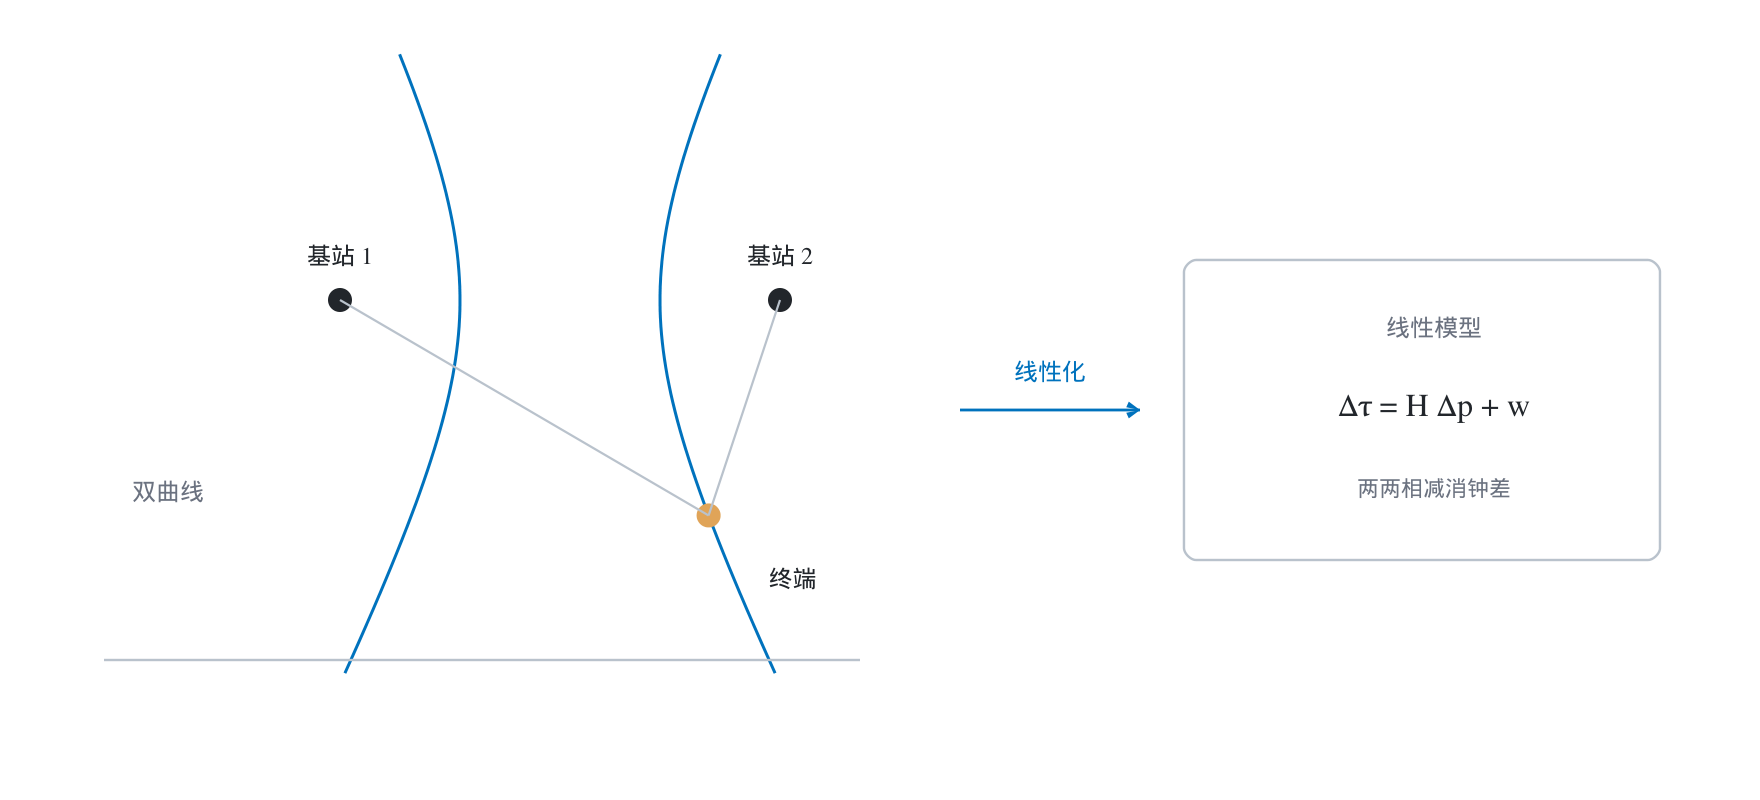
这个例子的价值不只是定位本身。它把两件事绑在了一起:一个几何上难解、噪声下敏感的非线性问题,通过在微小范围内做一阶展开,变成了一个线性问题;线性化之后,前面几节所有的线性工具都能用上。雷达和通信里大量的估计问题都在这个模式上,线性化这一步的分量也在这里。下一节讲极大似然的时候,同一个工具还会再出现一次。
五、老办法都失效之后:极大似然
到这里可以把找估计器的几条路数一遍。第一条是克拉美罗界,如果偏导能写成某种特定形式,估计器就直接看出来了;第二条是充分统计量,把似然分解出 T(x)T(\mathbf x)T(x),再想办法构造一个无偏函数;第三条是 BLUE,把形式限制成线性的,只需要前两阶矩。三条路都不通的时候怎么办?这就是极大似然要解决的问题。
极大似然估计的定义很短
θ^=argmaxθ p(x;θ)(5-1)\hat\theta=\arg\max_{\theta}\ p(\mathbf x;\theta)\tag{5-1}θ^=argθmax p(x;θ)(5-1)
在参数的所有可能取值里,挑出让当前这组观测出现概率最大的那一个。它和第一条路是同一件事的两个方向。对数的偏导在有效估计器存在时有一个固定形状
∂lnp(x;θ)∂θ=I(θ)(g(x)−θ)(5-2)\dfrac{\partial\ln p(\mathbf x;\theta)}{\partial\theta}=I(\theta)\left(g(\mathbf x)-\theta\right)\tag{5-2}∂θ∂lnp(x;θ)=I(θ)(g(x)−θ)(5-2)
其中 I(θ)I(\theta)I(θ) 是费希尔信息。式(5-2)的左端在极大似然估计处为零,而右端的 I(θ)I(\theta)I(θ) 一般不为零,所以括号里必须为零,解出来的正是 g(x)g(\mathbf x)g(x)。于是得到一条定理:如果有效估计器存在,那么它必定是极大似然估计。克拉美罗界指出该选谁,极大似然按自己的定义选出来也是谁,两边对上了。
一个具体的例子能说明什么叫三条路都不通。直流电平加高斯白噪声,但要估的那个电平恰好等于噪声方差。这个设定把参数和方差绑在了一起,似然变成
p(x;A)=1(2πA)N2exp−12A∑n=0N−1(x\[n−A)2](5-3)p(\mathbf x;A)=\dfrac{1}{(2\pi A)^{\dfrac{N}{2}}}\exp\left-\\dfrac{1}{2A}\\sum_{n=0}\^{N-1}\\left(x\[n-A\right)^2\right]\tag{5-3}p(x;A)=(2πA)2N1exp−2A1n=0∑N−1(x\[n−A)2](5-3)
先试第一条路。克拉美罗界那条路要求偏导能写成式(5-2)的样子,把式(5-3)的偏导算出来
∂lnp(x;A)∂A=−N2A+1A∑n=0N−1(xn−A)+12A2∑n=0N−1(xn−A)2(5-4)\dfrac{\partial\ln p(\mathbf x;A)}{\partial A}=-\dfrac{N}{2A}+\dfrac{1}{A}\sum_{n=0}^{N-1}\left(xn-A\right)+\dfrac{1}{2A^2}\sum_{n=0}^{N-1}\left(xn-A\right)^2\tag{5-4}∂A∂lnp(x;A)=−2AN+A1n=0∑N−1(xn−A)+2A21n=0∑N−1(xn−A)2(5-4)
形状对不上,这条路作废。再试第二条路,用 Neyman-Fisher 分解
p(x;A)=1(2πA)N2exp−12(1A∑n=0N−1x2\[n+NA)]exp(Nxˉ)(5-5)p(\mathbf x;A)=\dfrac{1}{(2\pi A)^{\dfrac{N}{2}}}\exp\left-\\dfrac{1}{2}\\left(\\dfrac{1}{A}\\sum_{n=0}\^{N-1}x\^2\[n+NA\right)\right]\exp\left(N\bar{x}\right)\tag{5-5}p(x;A)=(2πA)2N1exp−21(A1n=0∑N−1x2\[n+NA)]exp(Nxˉ)(5-5)
分解是成功的,充分统计量就是平方和 ∑nx2n\sum_n x^2n∑nx2n。但接下来要在这个统计量上找一个无偏函数,一算期望就卡住了:平方和的期望是 NA+A2NA+A^2NA+A2,里面带着参数的平方。坦克问题那里可以做一次简单的缩放把期望拉直,这里不行,需要找的那个函数很难写出来。第三条路是先从任意一个无偏估计出发,再对充分统计量取条件期望,计算量更大,实际算不出来。三条路全部作废,只剩极大似然。
把式(5-4)置零,整理之后得到一个关于参数的二次方程,整理之后得到一个关于参数的二次方程
A2+A−1N∑n=0N−1x2n=0(5-6)A^2+A-\dfrac{1}{N}\sum_{n=0}^{N-1}x^2n=0\tag{5-6}A2+A−N1n=0∑N−1x2n=0(5-6)
取正根就是估计值,另一个根落在参数的取值之外。到这里极大似然的第一个好处已经显现:不管似然长得多别扭,只要写得出来,就有一个明确的求解步骤,剩下的只是它好不好的问题。
六、极大似然的渐近性质与它的边界
极大似然真正被广泛使用,靠的是它在样本量增大时的一串好性质。
第一条是一致性,样本足够多时估计值收敛到真值。证明的路线是这样的:观测独立同分布,整个数据集的对数似然等于各个观测对数似然之和;样本量大到一定程度,这个平均量按大数定律收敛到它的期望;再用一个关于两个概率分布的不等式可以说明,这个期望在参数取真值处达到最大,别处都更小。既然极大似然挑的是让平均对数似然最大的那个参数,样本量一大,它就必然逼近真值。
第二条是渐近有效性,样本量增大时方差逼近克拉美罗界。这一条用的还是线性化。估计值应当落在真值附近,把对数似然的偏导在真值处做一阶展开,用中值定理把展开写成精确形式,展开点取在真值与估计值之间的某一点;样本量大时这两个点越来越近,中间那个点趋近真值,分母趋近费希尔信息,分子由中心极限定理给出高斯分布。整理之后得到
θ^ ∼ N(θ, I−1(θ))(6-1)\hat\theta\ \sim\ \mathcal N\left(\theta,\ I^{-1}(\theta)\right)\tag{6-1}θ^ ∼ N(θ, I−1(θ))(6-1)
均值是真值,方差是费希尔信息的倒数,也就是克拉美罗界。这三条性质成立之前,似然函数要先满足一组正则条件,简单说就是支撑集不随参数移动、对参数可以求导、费希尔信息存在且不为零。第三条性质是渐近高斯,式(6-1)已经把它写了进去。样本量足够大时,不考虑计算复杂度的话,直接上极大似然,得到的基本上就是无偏且渐近有效的估计器。仿真实例取直流电平加白高斯噪声,样本数为 5 时理论分布与实际分布还有可见的差距,样本数为 20 时两者已经贴得很近。
推导里有一个前提,就是估计值落在真值附近的一个小邻域内。这个前提不成立的时候,极大似然达不到克拉美罗界。
在局部做一阶展开这个动作用处很广。卡尔曼滤波里,状态转移和观测更新一旦是非线性的,处理起来极其麻烦,工程上的通用做法就是在当前估计处做一次线性化,把非线性函数换成一阶近似,后面的预测和更新继续沿用线性那套公式。样本量大、后验分布收得很窄的时候,这个近似的误差很小。
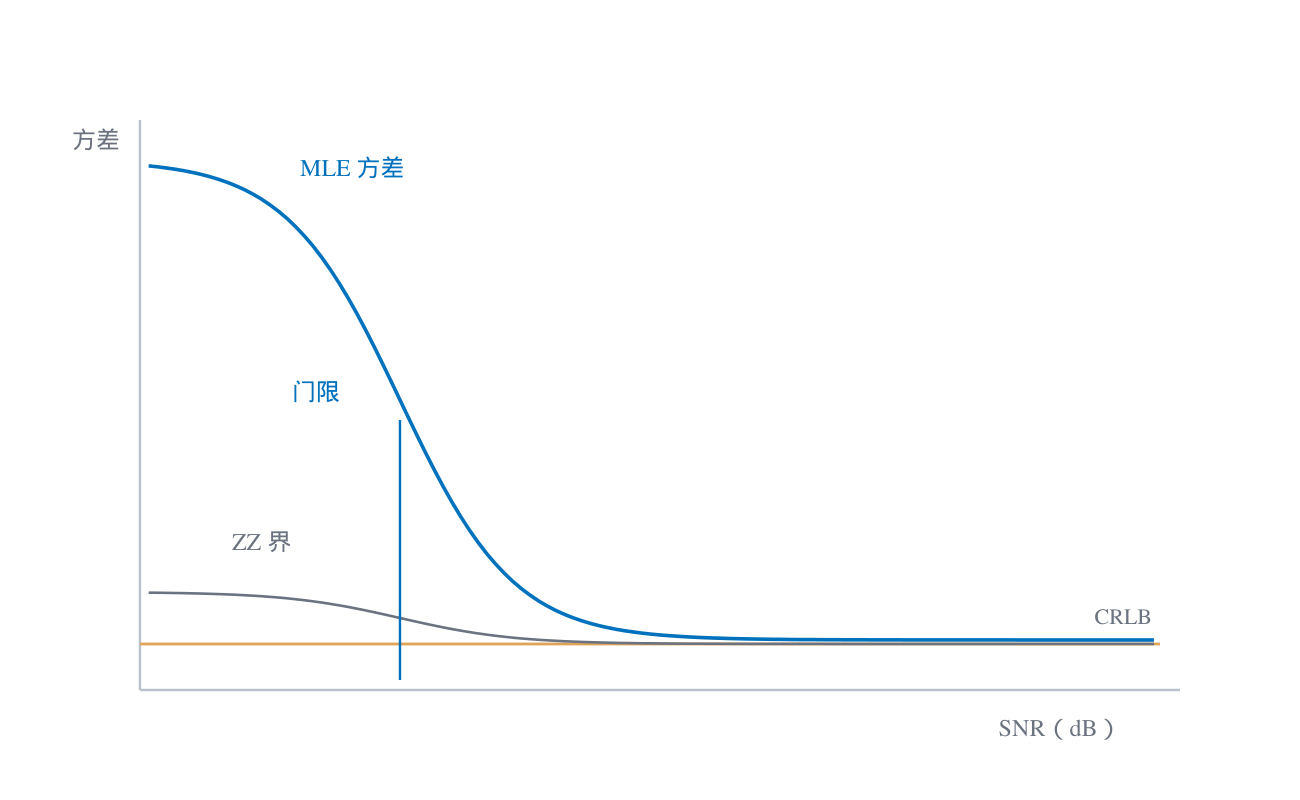
什么时候不成立?似然函数长得尖而单峰,无论怎么估都在峰附近来回,前提自然满足。似然函数出现多个高度接近的峰就不一样了,噪声稍大一点,估计值就会从一个峰跳到另一个峰。通信里的混淆函数、天线旁瓣过高、低信噪比下的阵列测角,都属于这一类。跳峰之后局部一阶近似的假设失效,估计方差会明显高于克拉美罗界。方差随信噪比变化的曲线因此分成两段:高信噪比区间贴着界走,低信噪比区间陡然上翘,中间那个转折叫门限。读文献时看到低信噪比下极大似然方差远大于界,原因就在这里。
处理门限区有一种界叫 Ziv-Zakai 界。它的做法是绕开直接算估计误差,先问一个更基本的问题:参数取两个相近的值,能不能把它们区分开。区分能力用二元检测的最小错误概率来衡量,估计误差的均方值就受这个错误概率限制。这样估计问题被改写成检测问题,界也从信息论那一侧求出来。
它有几个与克拉美罗界不同的地方。推导不要求似然函数可微,适用范围更宽;低信噪比或者似然明显偏离高斯的时候,它比克拉美罗界更紧,更接近实际能达到的误差;信噪比一高,它收敛到克拉美罗界。代价是不能写成解析式,只能数值求解。雷达与阵列信号处理里,主瓣之外还压着高旁瓣、存在模糊的场合,它出现得比较多。
充分统计量在极大似然这里同样有用。似然分解成 g(T(x),θ)h(x)g(T(\mathbf x),\theta)h(\mathbf x)g(T(x),θ)h(x) 之后,观测一旦定下来,h(x)h(\mathbf x)h(x) 就是一个常数,最大化只涉及 g(T(x),θ)g(T(\mathbf x),\theta)g(T(x),θ)。所以极大似然也可以只在充分统计量上做,统计量之外的样本点不再需要。
还有一条不变性。要估的参数是原参数的函数 α=g(θ)\alpha=g(\theta)α=g(θ),可以先按极大似然估出 θ\thetaθ,再把它代入 ggg 得到 α\alphaα 的极大似然估计。映射不是一对一的时候要小心:α=A2\alpha=A^2α=A2 对应两个可能的 AAA,这时要在两个原像里挑让似然更大的那一个。参数是向量时这套结论原样成立,把偏导换成对向量求偏导,把费希尔信息换成矩阵,渐近正态的均值仍是真的参数向量,协方差换成费希尔信息矩阵的逆。
功率的分贝值可以把这条性质验算一遍。观测是 NNN 个高斯白噪声样本,要估的是功率的分贝数
P=10lgσ2(6-2)P=10\lg\sigma^2\tag{6-2}P=10lgσ2(6-2)
先估方差。方差的极大似然估计是观测平方的平均,它的方差恰好等于克拉美罗界,是有效估计器。再按不变性把它代进式(6-2),得到分贝值的估计器。这个估计器不是有效的,因为它做了非线性变换,连无偏性都被破坏;与克拉美罗界比较在有限样本下没有意义。但样本量增大之后,无偏性和有效性都渐近地回来。仿真给出的数字是这样的:样本数为 10 时,实测方差是克拉美罗界的 2.21 倍;50 时为 2.04 倍;150 时为 2 倍。样本数继续加大,倍数继续向 1 靠。
线性模型加高斯噪声是一个把之前所有结论收拢在一起的情形。在这条模型下,最小方差无偏估计、极大似然估计、最优线性无偏估计、有效估计器是同一个式子。模型线性、噪声高斯,四条路走到同一个答案。把高维高斯的密度取对数,与参数无关的常数项全部丢掉,剩下的正是式(3-11)那个加权二次型,最大化它就等于把它最小化。从这个方向看,最小二乘不是另起炉灶,而是高斯噪声下最大似然的一个特例。
最后一个话题是平稳高斯过程下的渐近极大似然。观测的协方差矩阵是托普利茨矩阵,元素就是过程的自相关值;样本量增大时这种矩阵可以做特征分解,分解用的变换矩阵正是离散傅里叶变换;功率谱密度又是自相关序列的傅里叶变换。把这些关系代进对数似然,原本的矩阵形式就变成一个积分形式
lnp(x;θ)=−N2ln2π−N2∫−1212lnPxx(f)+I(f)Pxx(f)df(6-3)\ln p(\mathbf x;\boldsymbol\theta)=-\dfrac{N}{2}\ln 2\pi-\dfrac{N}{2}\int_{-\dfrac{1}{2}}^{\dfrac{1}{2}}\left\\ln P_{xx}(f)+\\dfrac{I(f)}{P_{xx}(f)}\\rightdf\tag{6-3}lnp(x;θ)=−2Nln2π−2N∫−2121lnPxx(f)+Pxx(f)I(f)df(6-3)
I(f)=1N∣∑n=0N−1xnexp(−j2πfn)∣2(6-4)I(f)=\dfrac{1}{N}\left|\sum_{n=0}^{N-1}xn\exp\left(-j2\pi fn\right)\right|^2\tag{6-4}I(f)=N1 n=0∑N−1xnexp(−j2πfn) 2(6-4)
参数藏在功率谱密度里,I(f)I(f)I(f) 是观测的周期图。这个形式只在样本量大时成立,因为推导里用到了冲激响应的近似,边界处的少数几项对不上,样本一多这点误差可以忽略。通信与雷达里按功率谱建模的过程,最后的似然大多写成这个样子。
七、解析式写不出来时的三条路
有了似然,不等于有了估计值。前面几个例子都能把偏导置零之后解出闭式,实际问题里往往解不出来,只能数值地找。
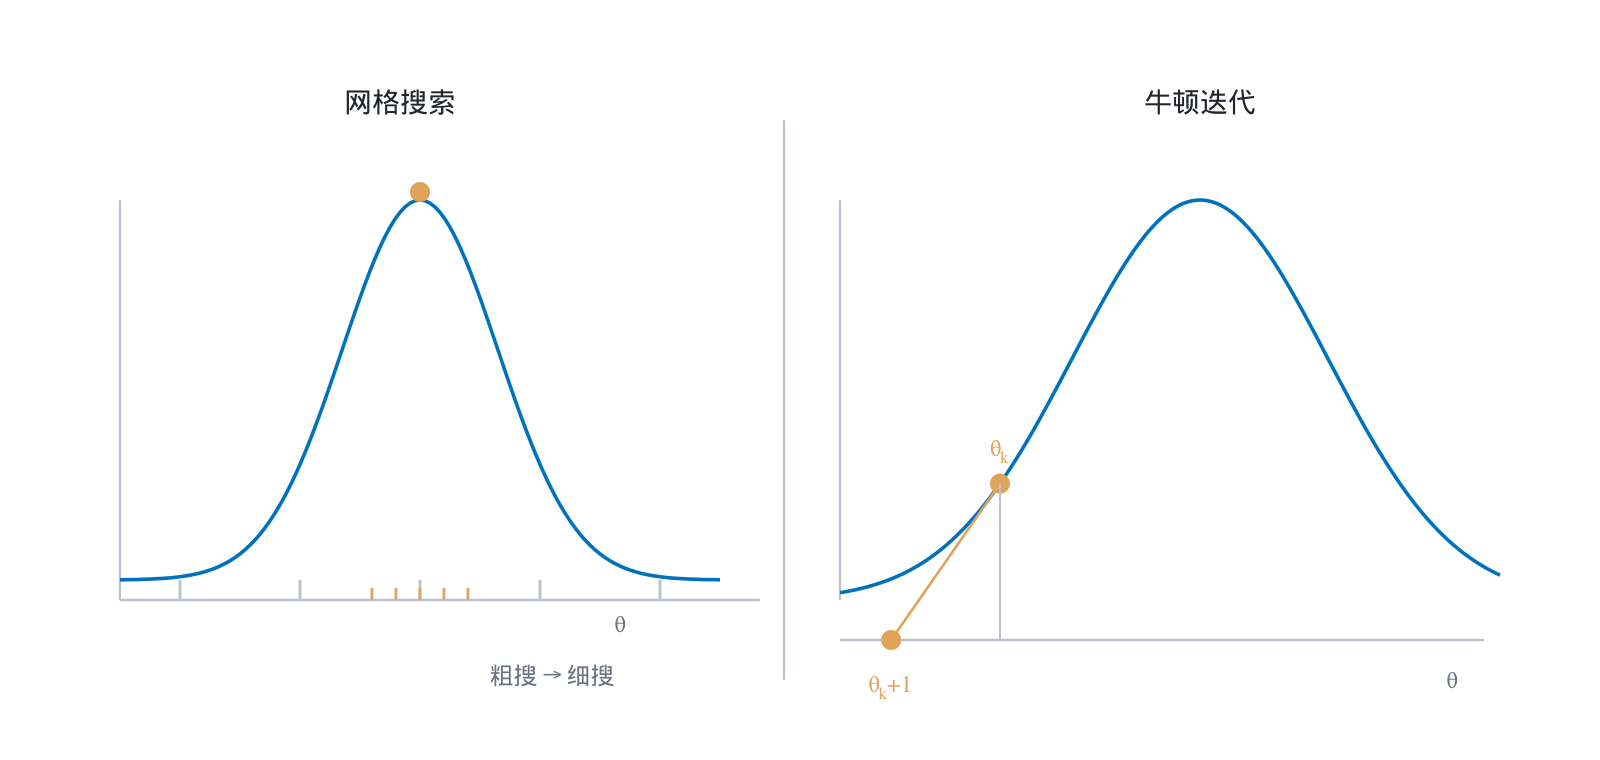
最直接的一条是网格搜索,也叫线搜索。参数的范围如果已知,比如某个角度在 0 到 180 度之间,就把这个区间铺成网格,把每个格点代进对数似然算一遍,画出曲线找峰值。它一定能找到搜索范围内的最大值,代价是计算量。网格间隔是个折中:间隔太大,峰值可能正好落在两点之间被漏掉;间隔太小,点数太多算不动。实用的做法是分层,先用粗网格找到峰值所在的一段,再在这一小段里铺细网格,逐层收缩。
间隔怎么取可以用数字掂量。角度落在 0 到 180 度之间,取 0.01 度一格就是一万八千个点,每个点都要算一遍似然,代价不小;取 3 度一格只剩六十个点,峰值却可能正好落在两格之间被漏掉。分层搜索解决的正是这个矛盾,粗层负责定位,细层负责收敛。
第二条是迭代法。已知当前参数值,把目标函数在这一点做一阶展开,令展开式为零解出下一个参数值
θk+1=θk−∂lnp(x;θ)/∂θ∂2lnp(x;θ)/∂θ2(7-1)\theta_{k+1}=\theta_k-\dfrac{\partial\ln p(\mathbf x;\theta)/\partial\theta}{\partial^2\ln p(\mathbf x;\theta)/\partial\theta^2}\tag{7-1}θk+1=θk−∂2lnp(x;θ)/∂θ2∂lnp(x;θ)/∂θ(7-1)
这就是牛顿法。分子是一阶导,分母是二阶导,每迭代一次就沿着当前点的曲率方向往前推一步,推不动了就说明到了一阶导为零的位置。分母里的二阶导可以换成费希尔信息,得到的版本叫得分法,机器学习里的得分函数就是同一个东西。费希尔信息是对观测取了期望的量,与具体拿到哪一组观测无关,可以在迭代开始前算一次、之后每一步复用,这是它比二阶导省算力的地方;样本量很大时两者本来就趋近相等,用固定的那个不影响收敛结果。这两条迭代法有一个共同问题:不保证收敛。步长没选好,迭代值可能越过极值点跑到别处,再也回不来。
闭式能解出来的时候,上面这两条都不必动用。同一批测量上比较过四种做法,线性模型的闭式解、令偏导为零解出来的闭式解、牛顿迭代与暴力搜索给出的结果一致,区别只在代价。数值方法在闭式写不出来的时候才启动,这是选路的原则。
在这两条之外还有第三条路。
无线信道测量的数据可以用来估计多径参数:每条径的时延、发射端的水平角与俯仰角、接收端的水平角与俯仰角。设备推着走,一路上采很多组数据,每组都能估出这么一组参数,合起来就是一条随位置变化的轨迹。俯仰角这里按 0 到 180 度定义,90 度表示水平方向,直射径就落在 90 度附近,随位置几乎不动;水平角随走动持续变化,来自窗户和墙面的反射径则各有自己的走向。整条链子是三步:信道探测采数据,从数据估计出参数,再用参数建立模型。把这些轨迹和环境对应起来,就能做基于实测的信道建模,进一步还能反过来推接收端的位置、判断环境里有没有遮挡。通信与感知一体化的系统里,这一组参数是共用的:既用来做信道建模与补偿,也用来判断周围有没有目标、目标在哪里。
在这种问题里,克拉美罗界的作用是分辨抖动的来源。估计出来的角度随位置有几度的抖动,这几度究竟是走动时真实的姿态变化,还是估计器自身的误差?如果费希尔信息给出的界只有零点几度,那么几度的抖动就不是估计误差,是真实变化;如果界本身就有七八度,那就分不清了。这是费希尔信息在工程上最实在的一个用途。
回到求解。多径参数估计里的似然是多个高斯分量叠加的形式,参数有五六个,求导之后写不出闭式,牛顿法要处理五维的矩阵,网格搜索要在五维空间铺点,算一天也算不完。极大似然在这种场合变得不可用,需要别的东西。
八、EM:在函数下方架一条更好爬的曲线
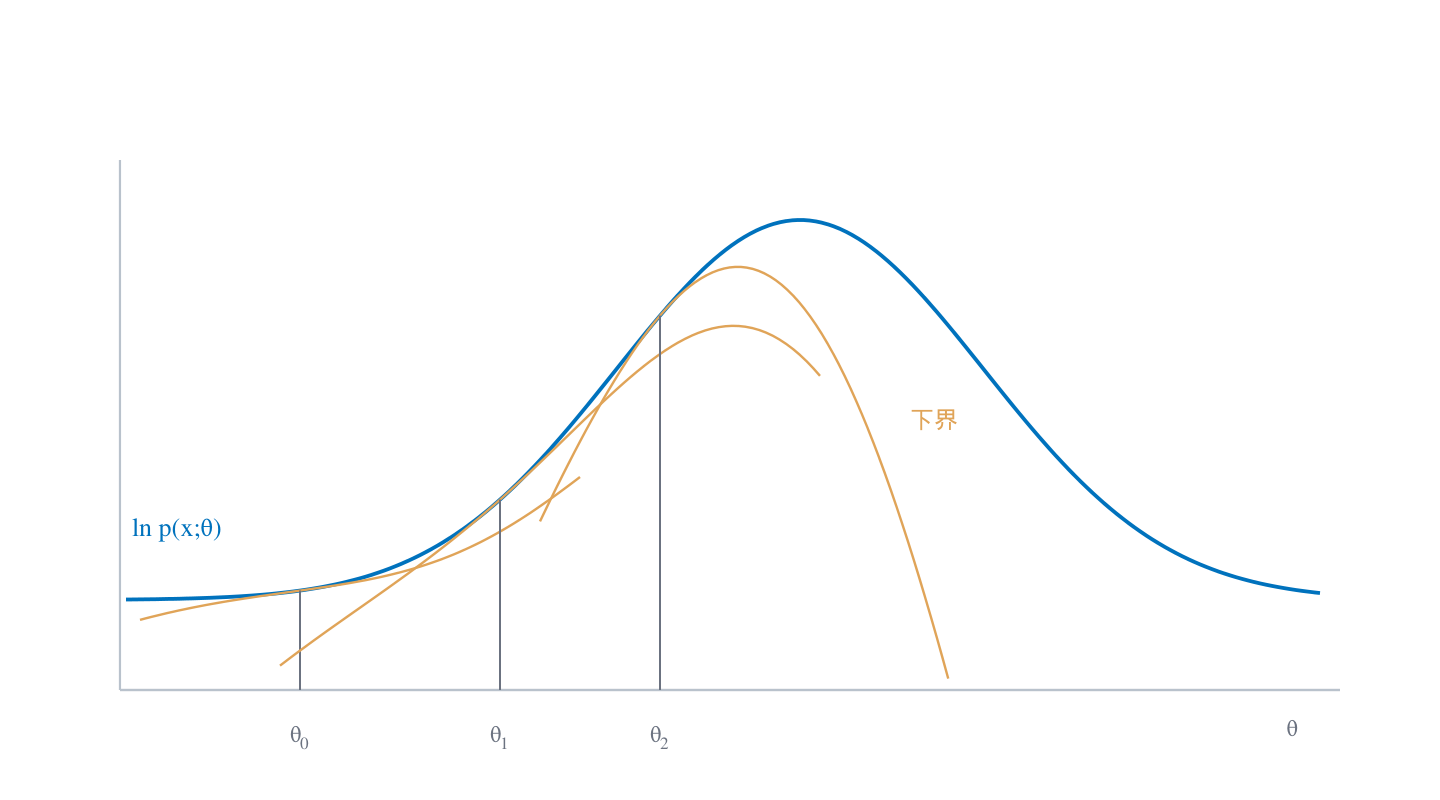
EM 算法的想法,一张图就能说明。原始的对数似然函数形状复杂,可能有多个局部极值,直接往上爬不好爬。那就换一个思路:在当前的参数点上构造一个新的函数,要求它满足三件事。第一,它在整个参数区间上都位于原始函数之下,只是原始函数的一条下界;第二,它在当前参数点上与原始函数相等,两者只在这一处相切;第三,它本身的性质足够好,最大化它很容易。
在这三条之下,迭代就可以进行。在当前点上最大化这条下界,得到一个更好的参数值;在新点上再构造一条新的下界,再最大化,如此反复。因为每一步原始函数都不会下降,这条链只会往上走,不会往回退。当下界函数的最高点与原始函数的最高点重合时,就爬不动了,算法收敛。收敛到的是局部最大值,不是全局最大值;初始值选得好,落到好解的概率就大。
保证不下降这件事,把 EM 和前两条路区分开了。网格搜索一定找得到最值但太慢,牛顿法快但不保证收敛,EM 保证单调上升。这也是它被列入二十世纪十大算法的原因。
三者的差别摆在一起看很清楚:线搜索一定能找到最高点,复杂度常常高得不能接受;牛顿法快,但不保证收敛,步长没设好就会冲出去,冲出去还回不来;EM 至少在这一点上是安全的,它每走一步都不会让目标函数下降。
要构造满足三条性质的下界,用的是 Jensen 不等式。对于凹函数,随机变量先取函数再取期望,结果不小于先取期望再取函数
f(EX) ≥ Ef(X)(8-1)f\left(\mathrm EX\right)\ \ge\ \mathrm E\leftf(X)\\right\tag{8-1}f(EX) ≥ Ef(X)(8-1)
对数函数是凹的,正好可以用。这里的加权函数是一个概率密度,权重加起来等于一,所以右端确实是一个期望,不等式才能套上去。把边缘似然写成含隐变量的联合分布的积分
p(x;θ)=∫p(x,z;θ)dz(8-2)p(\mathbf x;\theta)=\int p(\mathbf x,\mathbf z;\theta)d\mathbf z\tag{8-2}p(x;θ)=∫p(x,z;θ)dz(8-2)
在积分里乘一个任意概率密度 q(z)q(\mathbf z)q(z) 再除回去,值不变,但形式变了
lnp(x;θ)=ln∫q(z)p(x,z;θ)q(z)dz(8-3)\ln p(\mathbf x;\theta)=\ln\int q(\mathbf z)\dfrac{p(\mathbf x,\mathbf z;\theta)}{q(\mathbf z)}d\mathbf z\tag{8-3}lnp(x;θ)=ln∫q(z)q(z)p(x,z;θ)dz(8-3)
右端的对数里是一个关于 q(z)q(\mathbf z)q(z) 的期望,对数是凹函数,用 Jensen 不等式把对数额拎到期望里面,得到的值不超过原值
lnp(x;θ) ≥ ∫q(z)lnp(x,z;θ)q(z)dz(8-4)\ln p(\mathbf x;\theta)\ \ge\ \int q(\mathbf z)\ln\dfrac{p(\mathbf x,\mathbf z;\theta)}{q(\mathbf z)}d\mathbf z\tag{8-4}lnp(x;θ) ≥ ∫q(z)lnq(z)p(x,z;θ)dz(8-4)
右端就是要求的那条下界。它的等号条件也确定:只有当被积里的那个比值对所有的 z\mathbf zz 都取同一个值时等号成立,也就是
q(z)=p(z∣x;θ)(8-5)q(\mathbf z)=p(\mathbf z|\mathbf x;\theta)\tag{8-5}q(z)=p(z∣x;θ)(8-5)
后验密度。把当前参数下的后验代进去,下界就在当前点上与对数似然相切,三条性质全部满足。
把这条下界记作 Q(θ,θk)Q(\theta,\theta_k)Q(θ,θk),下标 kkk 表示它是在第 kkk 轮的参数上算出来的。整个算法就是两步交替:用当前参数算出后验,把下界写出来,这一步叫期望步;对着这条下界把参数最大化,得到下一轮的参数,这一步叫最大化步。两件事的名字合起来就是算法的名字。下界里同时出现了待优化的新参数和算后验时用的旧参数,两者不能混。
把下界里的联合密度拆成先验与生成项两部分的乘积,它就分成两项
L(θ)=∫q(z)lnp(z;θ)q(z)dz+∫q(z)lnp(x∣z;θ)dz(8-6)\mathcal L(\theta)=\int q(\mathbf z)\ln\dfrac{p(\mathbf z;\theta)}{q(\mathbf z)}d\mathbf z+\int q(\mathbf z)\ln p(\mathbf x|\mathbf z;\theta)d\mathbf z\tag{8-6}L(θ)=∫q(z)lnq(z)p(z;θ)dz+∫q(z)lnp(x∣z;θ)dz(8-6)
积分里的 qqq 取上一轮算出来的后验 p(z∣x;θk)p(\mathbf z|\mathbf x;\theta_k)p(z∣x;θk),后验一旦算定,在一轮迭代之内它就是一个已知分布;两个 ppp 里出现的 θ\thetaθ 是这一轮要优化的那个,取到 θk+1\theta_{k+1}θk+1 就完成一次最大化步。第一项是两个分布的对数比,取负号就是 KL 距离,衡量后验偏离先验多远,它只跟隐变量的分布有关;第二项是在后验的加权下,用参数写出的生成密度的对数平均,衡量模型能不能把观测重新生成出来,它跟观测的生成方式有关。两项各管一部分参数:混合模型里,第一项决定混合比例怎么更新,第二项决定各分量的均值与方差怎么更新。两项都在下一节换一套记法再出现一次。
下界与对数似然之间差多远,也有一个精确的式子。用式(8-3)的恒等变形把对数似然写成下界加上另一项,那一项正好是两个分布之间的 KL 距离
lnp(x;θ)−L(θ)=DKL(q(z)∥p(z∣x;θ))(8-7)\ln p(\mathbf x;\theta)-\mathcal L(\theta)=D_{\mathrm{KL}}\left(q(\mathbf z)\Vert p(\mathbf z|\mathbf x;\theta)\right)\tag{8-7}lnp(x;θ)−L(θ)=DKL(q(z)∥p(z∣x;θ))(8-7)
右端恒不为负,下界与对数似然的差距就卡在这里。qqq 取成真实后验,右端为零,下界与对数似然相等,这正是式(8-5)那条等号条件的另一种说法。把 qqq 固定成上一轮的后验,式(8-7)右端就成了一个与当前参数无关的常数,最大化下界与最大化对数似然是同一件事。
式(8-4)里出现了一个新的变量 z\mathbf zz,它不在原始问题里,是人造出来的。造它的原因正是下界好不好算:只要联合密度 p(x,z;θ)p(\mathbf x,\mathbf z;\theta)p(x,z;θ) 和后验 p(z∣x;θ)p(\mathbf z|\mathbf x;\theta)p(z∣x;θ) 都容易写出来,这条下界就比原来的对数似然好对付得多。z\mathbf zz 叫隐变量,原始观测叫不完整数据,观测加上隐变量叫完整数据。这个术语在文献里出现得很多,说的是同一件事。
隐变量最好用的场合是高斯混合模型。观测是一堆点,它们不是来自一个高斯分布,而是来自几个高斯分布的混合:每个点以某个概率来自第一个分量,以另一个概率来自第二个分量,具体来自哪一个不知道。要估的是各个分量的均值、方差和混合比例。
似然写出来是各个分量的加权和
p(x;θ)=∑ip(yn=i)p(xn∣yn=i)(8-8)p(\mathbf x;\boldsymbol\theta)=\sum_{i}p(y_n=i)p(x_n|y_n=i)\tag{8-8}p(x;θ)=i∑p(yn=i)p(xn∣yn=i)(8-8)
隐变量 yny_nyn 标记第 nnn 个点来自哪个分量。把这个似然取对数,求和号在对数里面,没法再化简;求导之后不是线性的,牛顿法要处理二阶导构成的矩阵,网格搜索要在五个维度上铺点。前面说的困难在这里全部出现。
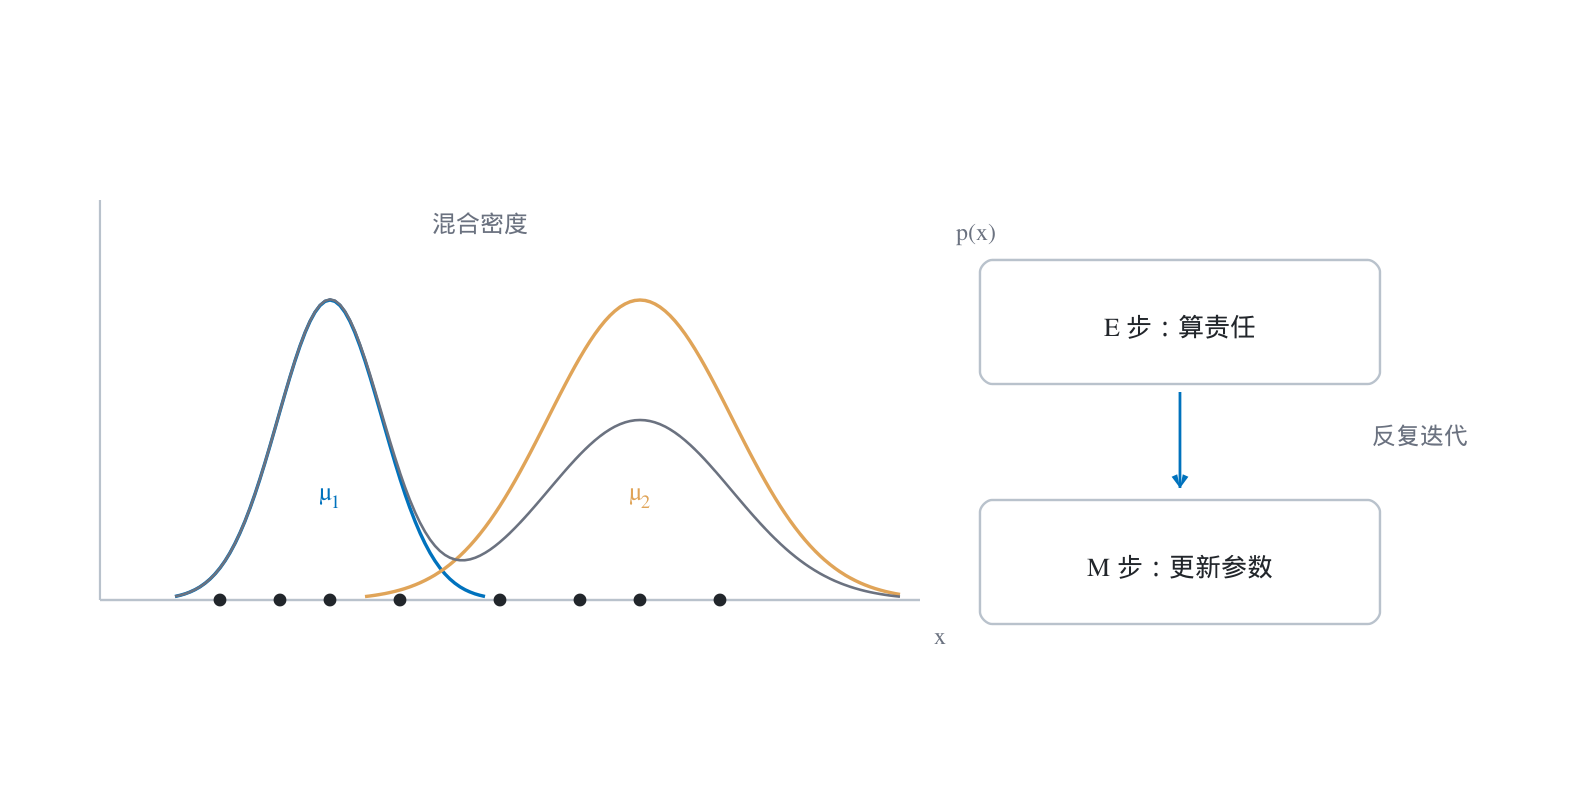
EM 给出的路径很干净。E 步算出在当前参数下每个点属于各个分量的后验概率,也就是责任
ωni=p(yn=i)p(xn∣yn=i)∑jp(yn=j)p(xn∣yn=j)(8-9)\omega_{ni}=\dfrac{p(y_n=i)p(x_n|y_n=i)}{\sum_{j}p(y_n=j)p(x_n|y_n=j)}\tag{8-9}ωni=∑jp(yn=j)p(xn∣yn=j)p(yn=i)p(xn∣yn=i)(8-9)
M 步用这些责任当作权重,重新估计各分量的参数,比如均值的更新就是责任加权的平均
μi=∑nωnixn∑nωni(8-10)\mu_i=\dfrac{\sum_{n}\omega_{ni}x_n}{\sum_{n}\omega_{ni}}\tag{8-10}μi=∑nωni∑nωnixn(8-10)
方差和混合比例的更新形式类似,都是加权平均。更新完之后责任变了,回到 E 步重算,往复迭代。式(8-4)里那条下界在混合模型下化成了责任加权的平方误差形式,最大化它只是解一个加权最小二乘,有闭式解,这才使得 M 步容易做。
这套迭代算完之后,拿到的不仅是参数,还有每个点来自各个分量的概率,也就是数据的分组。做参数估计的同时把聚类也做了,这是高斯混合模型比单个高斯多出来的东西。
同样的思路可以用到别处。观测若由若干个已知形状的分量叠加而成,每个分量带一个待估频率再加噪声,隐变量取分量的编号,EM 的推导会把原来那个高维参数的估计问题化成若干个一维问题:先用当前估计把其他分量减掉,剩下的就是单个分量加噪声,一维的极大似然很容易求;把每个分量轮流更新一遍,再重新做一次减除。这个过程和干扰消除是一回事。
九、从高斯混合模型到 VAE 与扩散模型
式(8-6)那两项,换成变分推断里惯用的记法就是
lnp(x) ≥ Eqlnp(x∣z)−DKL(q(z)∥p(z))(9-1)\ln p(\mathbf x)\ \ge\ \mathrm E_{q}\left\\ln p(\\mathbf x\|\\mathbf z)\\right-D_{\mathrm{KL}}\left(q(\mathbf z)\Vert p(\mathbf z)\right)\tag{9-1}lnp(x) ≥ Eqlnp(x∣z)−DKL(q(z)∥p(z))(9-1)
恢复项写在前面,KL 项写成距离的形式。同一个分解,两种写法,一个服务于迭代求解,一个服务于把两项各自对应到神经网络上去。
第一块是从隐变量重构观测的对数似然,越大说明重构越准;第二块是近似后验与先验之间的 KL 距离,越小说明两者越接近。两块合起来就是变分自编码器的损失函数,取负号之后作为要最小化的目标。
上一节里这两块都是解析算出来的:后验由高斯混合的公式给出,先验由分量的比例给出。VAE 做的事情是把这些解析式换成神经网络。编码器网络吃进观测,输出隐变量的均值与方差,用来近似后验;先验直接取标准正态,什么都不知道的时候假设隐变量服从零均值单位方差;解码器网络吃进隐变量,输出重构的观测。
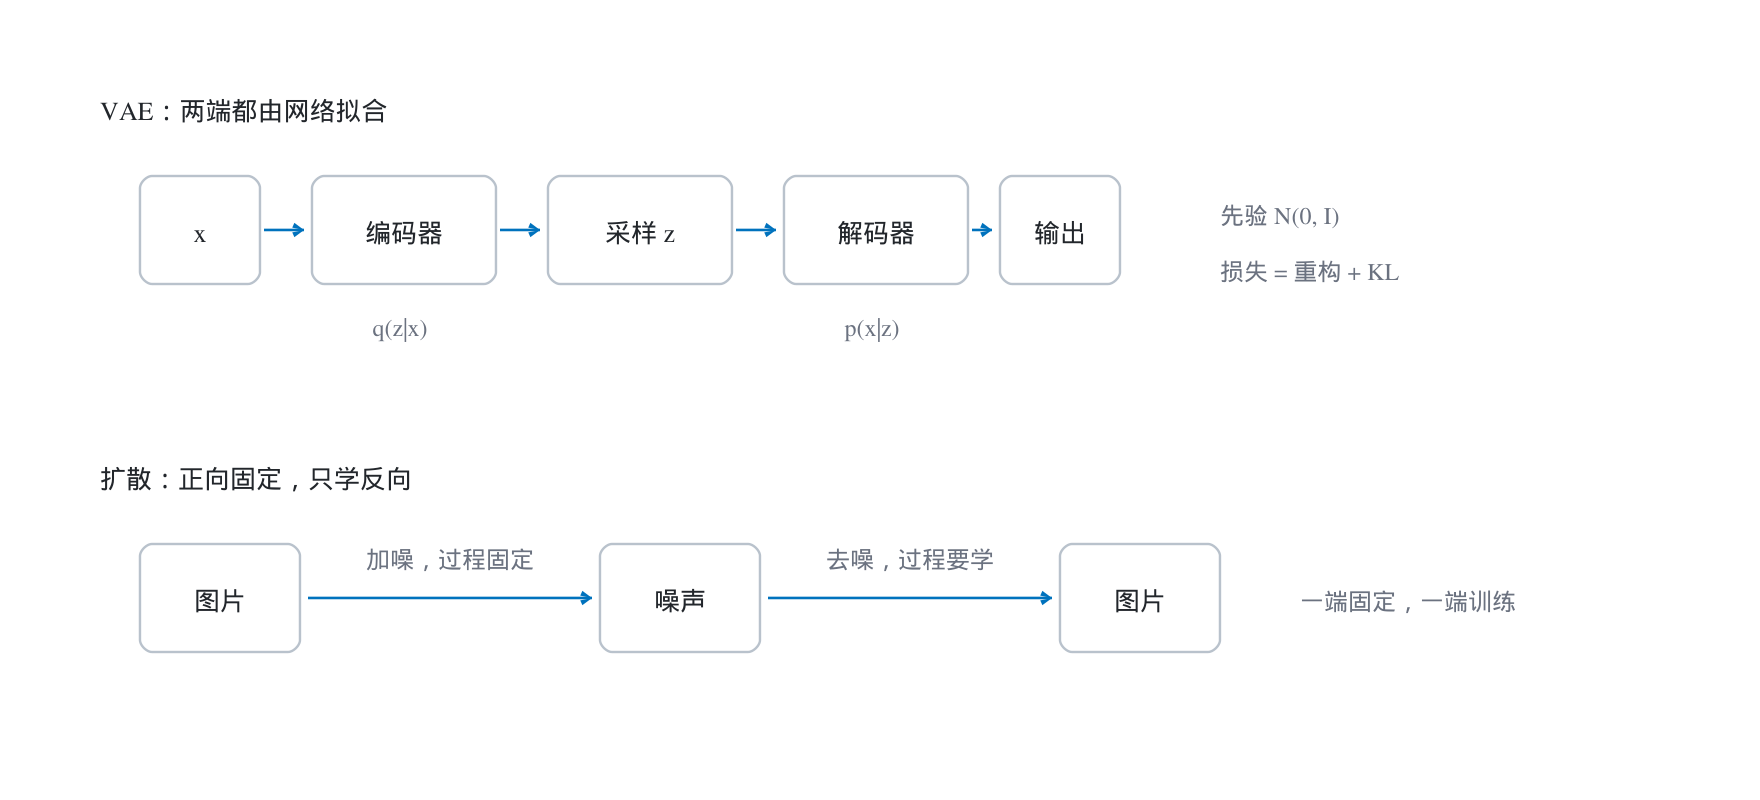
中间有一步采样。从编码器给出的分布里抽一个隐变量出来,再送进解码器。采样本身不可导,梯度传不回去,所以用重参数化把随机性挪出来
z=μ+σ⊙ε,ε∼N(0,I)(9-2)\mathbf z=\boldsymbol\mu+\boldsymbol\sigma\odot\boldsymbol\varepsilon,\qquad \boldsymbol\varepsilon\sim\mathcal N(\mathbf 0,I)\tag{9-2}z=μ+σ⊙ε,ε∼N(0,I)(9-2)
随机性全部集中在与参数无关的噪声项里,网络只需输出确定性的均值和标准差,梯度就能正常回传。训练时每次抽一个隐变量算一次重构误差,多抽几次取平均,作为式(9-1)第一块的估计。
训练时的损失由两块拼起来。第一块是重构误差,也就是负的重构对数似然,抽一个隐变量算一次,多抽几次取平均;第二块是编码器输出分布相对标准正态的 KL 距离,它把隐空间往先验上拉,起正则的作用。两块加在一起,用反向传播同时更新编码器和解码器的参数,中间那条采样路径靠重参数化把梯度接了回去。
这套结构和自编码器的区别就在那对均值和方差上。没有它们,隐空间是不连续的,中间地带的点没有意义,在月牙和满月之间插值,得到的图像既不是月牙也不是满月,只是一个模糊的平均;有了它们,隐变量是一个连续变化的随机变量,把它从小到大连续地改变,解码器输出的图像也连续地从一个月牙长成满月。月相就是现成的例子。代价是先验是假设出来的,如果真实数据的隐变量分布偏离标准正态,训练就会出问题。
扩散模型和 VAE 的差别在于哪一端是固定的。扩散模型的正向过程是把图像一步步加噪直到变成纯噪声,这个过程是定义好的,不需要学;需要学的只有反向过程,也就是从噪声一步步还原图像。VAE 是两端都用神经网络拟合:一个网络拟合后验,一个网络拟合生成分布。最后留了一个问题:既然固定一端、另一端由数据学出来的组合能成立,那么反过来把正向过程也做成要训练的参数、或者让两端各自固定一部分、学习另一部分,是不是也能构造出来,会不会更好。这个问题当时没有答案。
十、还剩几个没解开的问号
一节课讲下来,留下的问题比答案多。
线性模型加非高斯噪声那一块里,没有有效估计器是明确的,克拉美罗界是否存在取决于噪声分布,最小方差无偏估计是否总存在却始终没有定论。图 1 上那一小片区域至今空着,属于需要显式信息的那一类。
极大似然的渐近性质全部建立在估计值落在真值附近这个前提上。前提不成立时方差远高于界,用 Ziv-Zakai 界或者别的手段去补,都是数值方法,没有解析形式。
EM 保证收敛,但只保证收敛到局部极大。初始值决定了落到哪一个解。把它的下界换成神经网络参数化,得到的是 VAE;把生成过程固定成加噪、只学反向,得到的是扩散模型。再往下怎么走,是一个开放的问题。