摘要
「端侧 AI 不花服务器钱」这句话我听过很多遍。我想给自己的小工具站加一个 AI 抠图,动手前先把这句话拆开算了一遍账:省掉的只有推理那台机器。其余开销没有消失而是换了形态:每个新访客的一次下载、用户屏幕前的等待、用户电脑里的内存,外加回退与兼容的成本。这篇全程只拿实测的字节数和耗时做算术。快速 AI 每个新访客首次要下载 50.18 MB,1000 个新访客就是 50.18 GB;其中 44.23 GB 走模型所在的第三方 CDN,5.95 GB 走网站自己。快速 AI 冷启动要等 14.6--16.0 s;专业 AI 要等 34.8 s 和 45.1 s。专业 AI 回退到 WASM 时渲染进程峰值到了 3.58 GB。服务器推理那一侧的账我没测,文中也不编数。
版本声明
数据是 2026-09-28 晚上跑的。机器只有一台:16 GB 统一内存的 Apple M4 Mac,系统 macOS 26.5.2。浏览器用的是 Chromium 149 开源构建(149.0.7827.55)而 WebGPU 走 Metal。跑模型的库是 1.27.0 版 ONNX Runtime Web。网络是我当时那条普通家用宽带。所有耗时只代表这台机器、这条网络和那一个晚上的状态。换 Windows、独显、手机、Safari 或 Firefox 之后数字都可能完全不同;那些环境我一个都没测。文中的 MB 与 GB 按十进制算:1 MB 是 10⁶ 字节而 1 GB 是 10⁹ 字节。
适用边界
这篇只回答一个问题:AI 推理从服务器挪进浏览器以后成本到底挪去了哪里。它不讲 WebGPU 和 WASM 两个后端怎么切换,也不讲模型怎么选型。服务端推理的账我没有测:提到服务器那一侧的地方我只讲账的结构,不给数字也不写任何云厂商的价格。样本是一张程序生成的 1600×1200 瓶子商品图。它不是真实照片也不是哪个客户的图。推理耗时和图片内容关系不大,因为输入会先缩放到模型的固定尺寸;字节数则与图片内容完全无关。
文章目录
一、端侧 AI 真的不用服务器吗
- 1.1 「端侧 AI 省服务器钱」省的是哪一块
- 1.2 我这次量了什么、没量什么
二、端侧 AI 模型多大:每个新访客下载多少字节
- 2.1 快速 AI 第一次打开拉了哪几个文件
- 2.2 代码一:1000 个新访客是多少 GB
- 2.3 专业 AI 和骨灰级 AI 的账
- 2.4 回访为什么是 0 字节:代码二看缓存落在哪
三、模型放 CDN 还是自托管:流量落到谁头上
- 3.1 模型走第三方 CDN 而运行时走本站
- 3.2 代码三:自托管忘开 gzip 要多传多少
- 3.3 代码四:模型文件还能不能再压
四、端侧 AI 冷启动要等多久
- 4.1 快速 AI 冷启动 14.6--16.0 s:慢的不是模型
- 4.2 专业 AI 冷启动 34.8 s 和 45.1 s
- 4.3 回访和同页再跑要多久
五、浏览器跑 AI 模型占多少内存
六、没有 GPU 的访客多付了什么
七、端侧 AI 到底省了什么:一张账单
八、我的小站打算怎么上
九、适用场景 / 不适用场景 / 风险提示
十、测量方法自身的坑
十一、还没解决的
参考资料
一、端侧 AI 真的不用服务器吗
1.1 「端侧 AI 省服务器钱」省的是哪一块
我靠外包和两个小工具站过日子。站上跑的是最便宜那一档云主机,带宽也按最低档买,这台机器连一张 GPU 都没有。家里另有一只橘猫叫「服务器」,它倒是从来不要带宽费。上个月有两个外包客户问我能不能顺手做个商品图去背景。我第一反应是跑不动:抠图模型放服务器上推理就得租带 GPU 的机器或者按次调别人的接口,两条路都是每来一张图多一笔钱。这笔钱我出得心疼。
后来我在好几篇文章里看到同一句话:「端侧 AI 把推理放进用户浏览器,服务器一分钱不花。」前半截我信:模型在用户电脑上跑时我那台主机确实不用管推理。后半截我不太信:做了十几年网站,我知道「不花钱」的东西通常只是把钱挪到了别处。挪到哪了得算。
这件事我换了个问法:我不问「省了多少钱」,因为服务器推理那一侧我没测过。我问的是推理挪走以后哪些东西没有消失而只是换了形态。能换成字节和秒的我都换成字节和秒:字节可以乘访客数而秒可以直接看。钱这一层留给读者按自己的单价去乘。
一开始我以为账很简单:模型文件多大,每个访客就多下载多少。算到一半发现漏了一个文件:它比模型小得多却是冷启动里最慢的一段,第四章细说。
1.2 我这次量了什么、没量什么
我自己手上没有现成的端侧抠图可以量。拿来当样本的我用的是图映 ImgIng(https://imging.cn/)的 AI 智能抠图,机器是 Apple M4 / 16 GB,内核是 Chromium 149 开源构建,模型是快速 AI(ISNet INT8)和专业 AI(BEN2 FP16),样本是上面那张合成的瓶子图。它的模型按需下载并在浏览器里推理,正好是我想做的形态。计时来自直接调用页面里的抠图函数 TYBG.segment,它和点「开始 AI 抠图」按钮调的是同一个函数,但我没有走点击界面。每种情况跑三次:第一次是全新的浏览器配置而什么都要下载;第二次是同一个页面再跑一次;第三次是同一配置下新开页面,这时缓存已经命中。
浏览器状态分两种:一种是开着硬件加速、WebGPU 走 Metal。另一种是没有可用 GPU 适配器的 Chromium(关掉浏览器的「使用图形加速」就是这种状态)。这时 navigator.gpu 还在但申请不到适配器,推理会回退到 WASM。全部六次调用里页面发出的非 GET 请求是 0 次,图片没有离开浏览器。这一点我单独数过,它是这篇的前提:确实没往服务器传图。这点我放心了。
没量的东西先列在这里:服务器推理的耗时、机器占用和费用我都没测。骨灰级 AI(BiRefNet 约 447 MB)我只拿到文件字节而没跑下载和推理。手机、Windows 和其他浏览器都没测。显存也没量到,第五章的内存数字是进程 RSS。
二、端侧 AI 模型多大:每个新访客下载多少字节
2.1 快速 AI 第一次打开拉了哪几个文件
先看第一次打开:快速 AI 用的模型是 ISNet INT8,文件 44 229 662 字节,界面上写的是「约 42 MB」。我拿 44 229 662 连除两次 1024 得到 42.18。快速档这个数是按 1024 进制标的。我这篇统一按十进制写成 44.23 MB。两种写法差了两 MB 多;第一次看我还以为下错了文件。
光有模型还跑不起来:浏览器里还得有一个推理运行时,这里是 ONNX Runtime Web。它的主体是一个解压后 24 254 953 字节的 WASM 文件,走 gzip 传输是 5 953 924 字节即 5.95 MB。我原先完全没把它算进去。第一次冷启动的网络记录里就这几样:20 KB 量级的运行时入口脚本、17 KB 量级的 .mjs 胶水脚本、44 MB 的模型和这个 5.95 MB 的 WASM。两个小脚本加起来不到 40 KB,下文的算术里我把它们略掉。
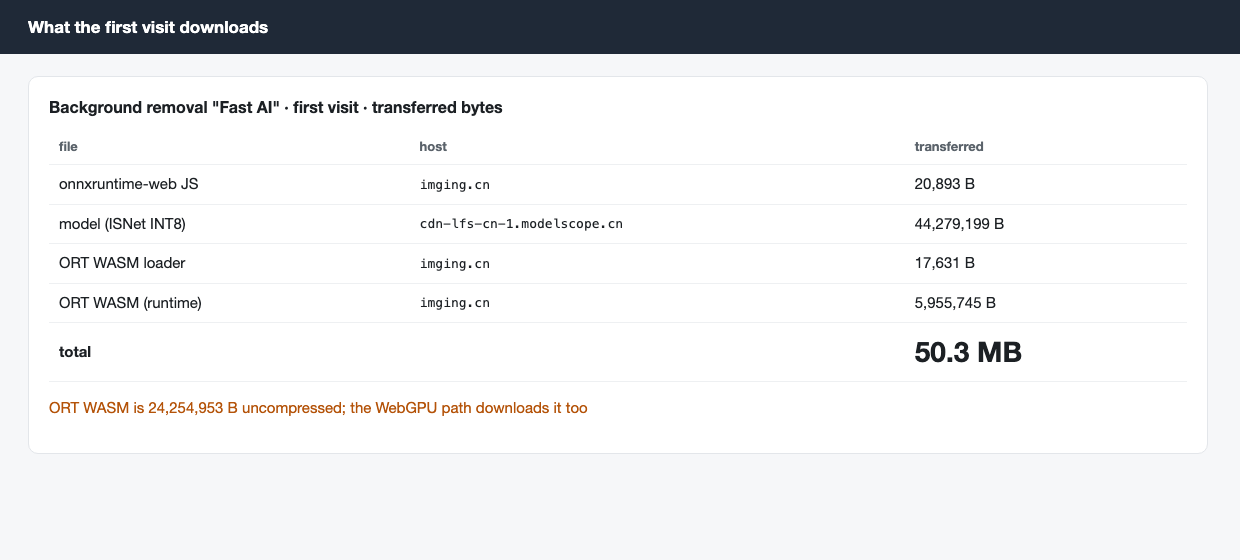
这张图要看什么。只看字节那一列:两个大文件是模型和运行时 WASM,它们占了首次下载的几乎全部。另外两个小脚本加起来不到 40 KB,算账时可以忽略。合计一栏是 50.3 MB,这是首访真正要付的量。表里四个文件三个来自图映自己的站点,只有模型走 ModelScope 的 CDN。
WebGPU 路径也要下这个 WASM;我原本以为走 GPU 就用不着它。网络记录里开着硬件加速的那次同样请求了这个文件。ORT 的 WebGPU 执行提供程序就在同一个 WASM 里。不管访客有没有 GPU 这 5.95 MB 都跑不掉。
2.2 代码一:1000 个新访客是多少 GB
字节有了剩下的就是乘法。我写了个很土的脚本:三档模型的文件字节和运行时的 gzip 字节写死在里面,再乘访客数。
python
MODEL_BYTES = {
    "quick_isnet_int8": 44_229_662,
    "pro_ben2_fp16": 219_121_675,
    "ultimate_birefnet_fp16": 447_261_189,
}
ORT_WASM_GZIP = 5_953_924

def bill(tier, visitors):
    return MODEL_BYTES[tier] * visitors, ORT_WASM_GZIP * visitors

for tier in MODEL_BYTES:
    m, r = bill(tier, 1)
    print(f"{tier}: 每个新访客 {(m+r)/1e6:.2f} MB(模型 {m/1e6:.2f} + 运行时 {r/1e6:.2f})")
    for n in (1000, 10000):
        m, r = bill(tier, n)
print(f" {n:>6} 人 模型 {m/1e9:8.2f} GB 运行时 {r/1e9:6.2f} GB 合计 {(m+r)/1e9:8.2f} GB")quick_isnet_int8: 每个新访客 50.18 MB(模型 44.23 + 运行时 5.95)
1000 人 模型 44.23 GB 运行时 5.95 GB 合计 50.18 GB
10000 人 模型 442.30 GB 运行时 59.54 GB 合计 501.84 GB
pro_ben2_fp16: 每个新访客 225.08 MB(模型 219.12 + 运行时 5.95)
1000 人 模型 219.12 GB 运行时 5.95 GB 合计 225.08 GB
10000 人 模型 2191.22 GB 运行时 59.54 GB 合计 2250.76 GB
ultimate_birefnet_fp16: 每个新访客 453.22 MB(模型 447.26 + 运行时 5.95)
1000 人 模型 447.26 GB 运行时 5.95 GB 合计 453.22 GB
10000 人 模型 4472.61 GB 运行时 59.54 GB 合计 4532.15 GB代码说明。字节全部来自实测:模型取文件字节,运行时取 gzip 后的传输字节。这里的「新访客」指第一次用这个功能、浏览器里没有缓存的人。脚本把模型和运行时分开算,因为这两份流量落在不同的地方,第三章要用。快速 AI 这一档 1000 个新访客是 50.18 GB,其中模型那 44.23 GB 占了八成八。我盯着这个数看了挺久:我那个站一个月的全部流量也就是它的零头。这账我原先没想过。
这个数还有一个容易漏的前提:它只算「用了 AI 抠图的新访客」。只打开页面不点抠图的人不会触发下载,因为模型是按需拉的。要是把模型放在页面加载时预取,这个数就得换成「所有新访客」。两种写法差多少取决于你站上多大比例的人真会点那个按钮。这个比例我没有数据也没法替你估。
2.3 专业 AI 和骨灰级 AI 的账
快速 AI 是最小的一档;专业 AI 用 BEN2 FP16,文件 219 121 675 字节。骨灰级 AI 用 BiRefNet HR-Matting FP16,文件 447 261 189 字节。同样按新访客乘:专业 AI 每人 225.08 MB 而 1000 人就是 225.08 GB;骨灰级每人 453.22 MB 而 1000 人就是 453.22 GB。骨灰级这一档我只有文件字节,下文的耗时都只到专业 AI 为止。
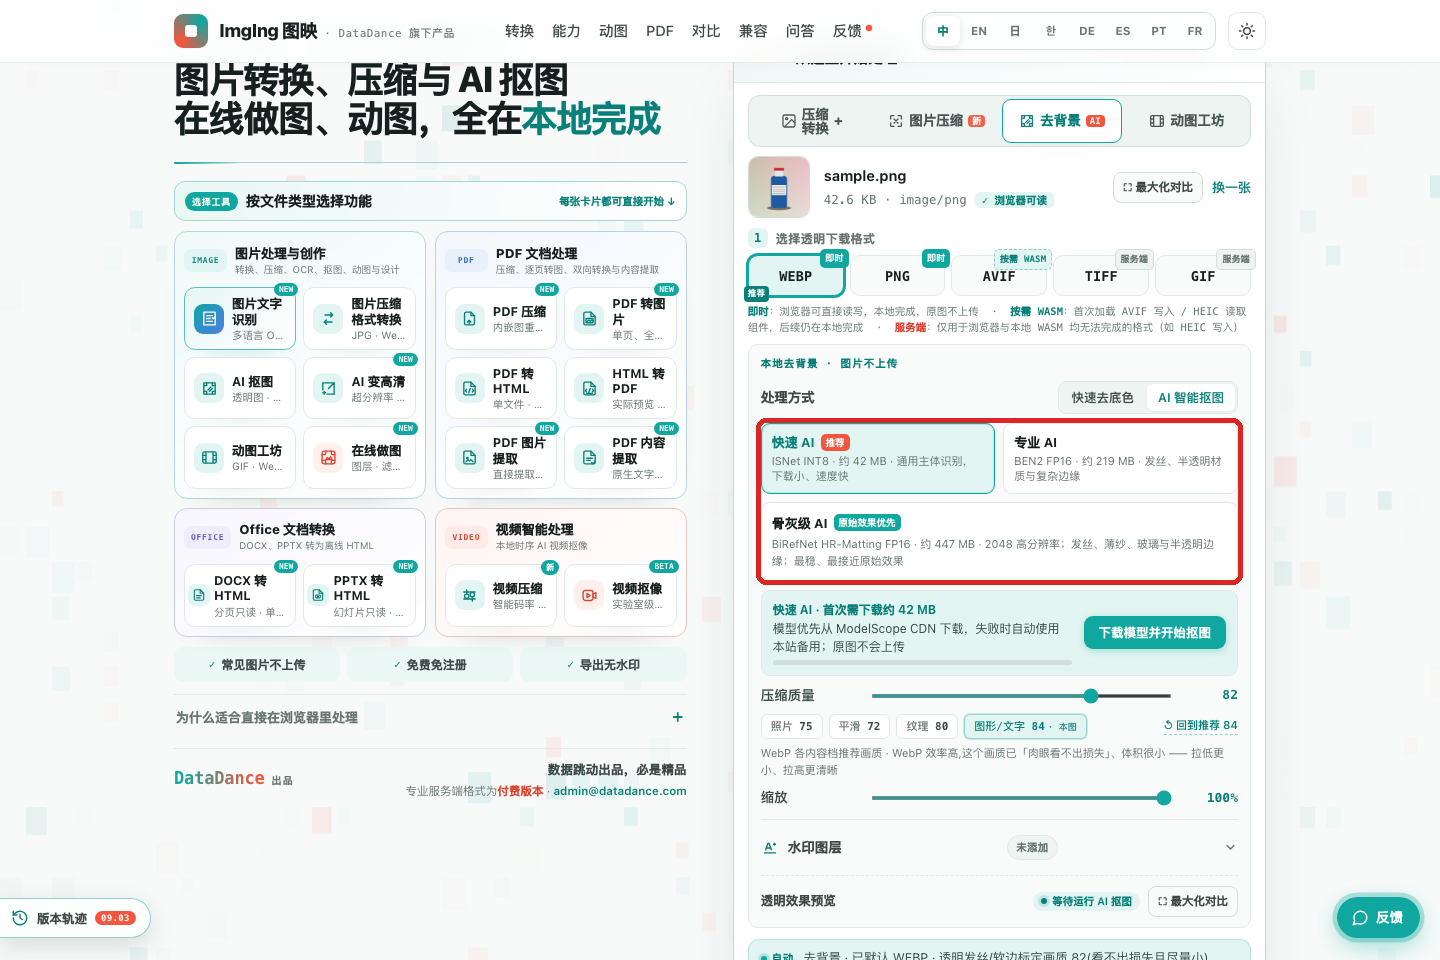
这张图要看什么。看三档模型旁边标的体积:从约 42 MB 到约 447 MB 差了十倍多。再看它的组织方式:档位由用户自己选而不选就不下。这对账很重要。用户默认停在快速档的话大部分人付的就是 50.18 MB。只有主动切到专业档的人才会多付那 170 多 MB。我拿文件字节对了一下这三个标注。快速档的约 42 MB 对得上 1024 进制;专业档的约 219 MB 和骨灰级的约 447 MB 却对得上十进制(219.12 和 447.26)。三个数用的不是同一种进制。差得不多,但自己算账时我不再直接抄界面上的数。
还有一个细节我没想到。图映在手机上只开放快速 AI,专业和骨灰级在手机端直接不支持。我在页面脚本里看到的判断是「移动端且不是快速档就不支持」。它为什么这么定我不知道;我猜和第五章的内存有关但这只是推测。
2.4 回访为什么是 0 字节:代码二看缓存落在哪
同一个人第二次来时网络记录里模型那一行没了,模型改从浏览器的 Cache Storage 里读。运行时文件带的是 Cache-Control: public, max-age=31536000, immutable,缓存命中后也不再请求。回访的首次下载是 0 字节。听着很美。
这 0 字节不是凭空来的:模型没有消失而是躺在了访客的硬盘上。为了知道到底占多少,我在自己本地的测试页上做了一遍同样的事:把 INT8 模型取下来塞进 Cache Storage,前后各读一次存储用量。
js
(async () => {
  const before = (await navigator.storage.estimate()).usage;
  const box = await caches.open('my-model-cache');
  await box.put('isnet-int8', await fetch('models/isnet-general-int8.onnx'));
  const after = (await navigator.storage.estimate()).usage;
  const hit = await box.match('isnet-int8');
  console.log({
    before, after, grew: after - before,
    cached_body: hit ? (await hit.arrayBuffer()).byteLength : 0,
    persisted: await navigator.storage.persisted(),
    device_memory: navigator.deviceMemory,
  });
})();{
"before": 0,
"after": 44230153,
"grew": 44230153,
"cached_body": 44229662,
"persisted": false,
"device_memory": 16
}代码说明 。这段在浏览器控制台里就能跑,模型路径换成你自己站上的文件即可。存进缓存以后这个源的用量多了 44 230 153 字节,比模型文件多出的 491 字节是缓存条目本身的开销。真正要看的是 persisted: false。它的意思是这块存储属于「尽力而为」:磁盘紧张时浏览器可以把它清掉。清掉以后这个访客下次来又是新访客,又要下 50.18 MB。浏览器在什么条件下会清我这轮没测。device_memory 顺手打出来是 16,和这台机器的内存一致,第八章我会用到它。
算到这里第一笔换形态的账就清楚了。推理机器省掉了;换来的是每个新访客一次 50 MB 起步的下载外加访客硬盘上一块随时可能被清的 44 MB 缓存。
三、模型放 CDN 还是自托管:流量落到谁头上
3.1 模型走第三方 CDN 而运行时走本站
50.18 MB 是访客下载的量;它从谁的服务器出去决定了这份流量记在谁的账上。我读了图映线上的抠图脚本。里面写了三个源。下载源的顺序是先 ModelScope 的 CDN、再 ModelScope 的备用域名、最后才是本站的 models/background-removal/ 目录。下完按字节数和 SHA-256 校验,不过就不用。
网络记录印证了这个顺序:模型请求先打到 modelscope.cn 再 302 跳到 cdn-lfs-cn-1.modelscope.cn,响应体 44 279 201 字节。运行时 WASM 走的是 imging.cn 本站,网络记录里是 5 955 745 字节。它比 curl 量到的 5 953 924 略多一点,两种记录的口径不完全一样。
拿 1000 个新访客那一行来分:44.23 GB 从第三方 CDN 出去而不在网站自己的账上;5.95 GB 从本站出去,这份是网站自己出的。模型那份到底谁付、付多少要看模型托管方的政策。这我不知道也不替任何一方表态。我只能说字节确实是从那边的域名出去的。
换成我自己的站就是两条路:第一条是模型也放自己站上,那 1000 个新访客的 50.18 GB 全从我的带宽出去。我那台最低配主机上一个 44 MB 的文件同时被几个人下,别的页面基本就打不开了。第二条是模型放到公开的模型托管平台而我只托管运行时,这样我自己出的是每人 5.95 MB。代价是多了一个依赖:对方的 CDN 慢了、改了规则或者挂了,我的功能就跟着坏。图映的做法是三个源轮着试,最后回到本站兜底。它为什么这么排我只能推测:大概是想让大头流量走外面,外面挂了还能用。
3.2 代码三:自托管忘开 gzip 要多传多少
运行时这 5.95 MB 是 gzip 以后的数。要是自托管时忘了开压缩它会是多少?我在本地起了一个不压缩的静态服务,再用浏览器的 Resource Timing 看实际走了多少线上字节。
js
(async () => {
  await (await fetch('rt/ort-wasm-simd-threaded.asyncify.wasm')).arrayBuffer();
  await (await fetch('models/isnet-general-int8.onnx')).arrayBuffer();
  const heavy = performance.getEntriesByType('resource').filter(e => e.transferSize > 1e6);
  console.table(heavy.map(e => ({
    file: e.name.split('/').pop(),
    wire_mb: +(e.transferSize / 1e6).toFixed(2),
    body_mb: +(e.decodedBodySize / 1e6).toFixed(2),
  })));
})();┌─────────┬────────────────────────────────────────┬─────────┬─────────┐
│ (index) │ file │ wire_mb │ body_mb │
├─────────┼────────────────────────────────────────┼─────────┼─────────┤
│ 0 │ 'ort-wasm-simd-threaded.asyncify.wasm' │ 24.26 │ 24.25 │
│ 1 │ 'isnet-general-int8.onnx' │ 44.23 │ 44.23 │
└─────────┴────────────────────────────────────────┴─────────┴─────────┘代码说明 。transferSize 是这次请求在网络上实际走的字节(含响应头),decodedBodySize 是解压后的内容大小。两列几乎一样,说明这个本地服务什么都没压,运行时原样传了 24.26 MB。图映站上同一个文件 gzip 后是 5.95 MB,差了四倍多。这是白扔的带宽。放回 1000 个新访客那一行,运行时这一项就从 5.95 GB 变成 24.25 GB 左右。这段代码在你自己站上跑一遍就知道压没压,比翻服务器配置快。跨域资源要对方带 Timing-Allow-Origin 头才读得到 transferSize,否则读出来是 0。
我拿 curl 对图映站上那个运行时文件又核了一遍。带 Accept-Encoding: gzip 下回来 5 953 924 字节,响应头有 Content-Encoding: gzip;不带就是 24 254 953 字节。它的站上开了压缩。Nginx 的 gzip_types 默认只管 text/html。WASM 要自己把 application/wasm 加进去才会压。我以前一直以为写了 gzip on 就全压了,这回才去翻文档确认。
3.3 代码四:模型文件还能不能再压
运行时压完只剩四分之一。模型能不能也压一压?我在本地对两个文件跑了一遍 gzip。
bash
for f in isnet-general-int8.onnx ort-wasm-simd-threaded.asyncify.wasm; do
  printf "%s raw=%s gzip6=%s\n" "$f" "$(stat -f %z "$f")" "$(gzip -6 -c "$f" | wc -c | tr -d ' ')"
doneisnet-general-int8.onnx raw=44229662 gzip6=30293896
ort-wasm-simd-threaded.asyncify.wasm raw=24254953 gzip6=5953961代码说明 。stat -f %z 是 macOS 的写法,Linux 上换成 stat -c %s。运行时 gzip -6 以后是 5 953 961 字节,和线上传输的 5 953 924 几乎一样,线上用的应该就是差不多的压缩级别。模型压完是 30 293 896 字节,剩原来的 68.5%。INT8 的权重是一堆小整数,还能压掉三成。这我没想到。FP16 的模型我这轮没压,那个比例我不知道,68.5% 不能拿去套。
再对照网络记录:模型那条从 ModelScope CDN 回来的响应体是 44 279 201 字节,比文件本身还略大。按字节数推断这条链路上模型没有走压缩传输。这是我从字节数推的而没去看那个响应的 Content-Encoding 头。我要是自托管模型就预压一份 .gz 放着,每个新访客能少下约 14 MB。服务器实时压 44 MB 的文件会吃 CPU,预压更省。这一条是按经验判断,服务器那一侧的占用我没量。
四、端侧 AI 冷启动要等多久
4.1 快速 AI 冷启动 14.6--16.0 s:慢的不是模型
字节换形态以后第二笔账是时间。服务器推理时用户等的是上传、排队和推理。端侧推理时用户第一次等的是下载、建会话和推理,这些全发生在他自己的屏幕前。
快速 AI 的冷启动:开着硬件加速是 14 594 ms;没有可用 GPU 适配器的 Chromium 是 16 015 ms。两者都从调用抠图函数那一刻起算。
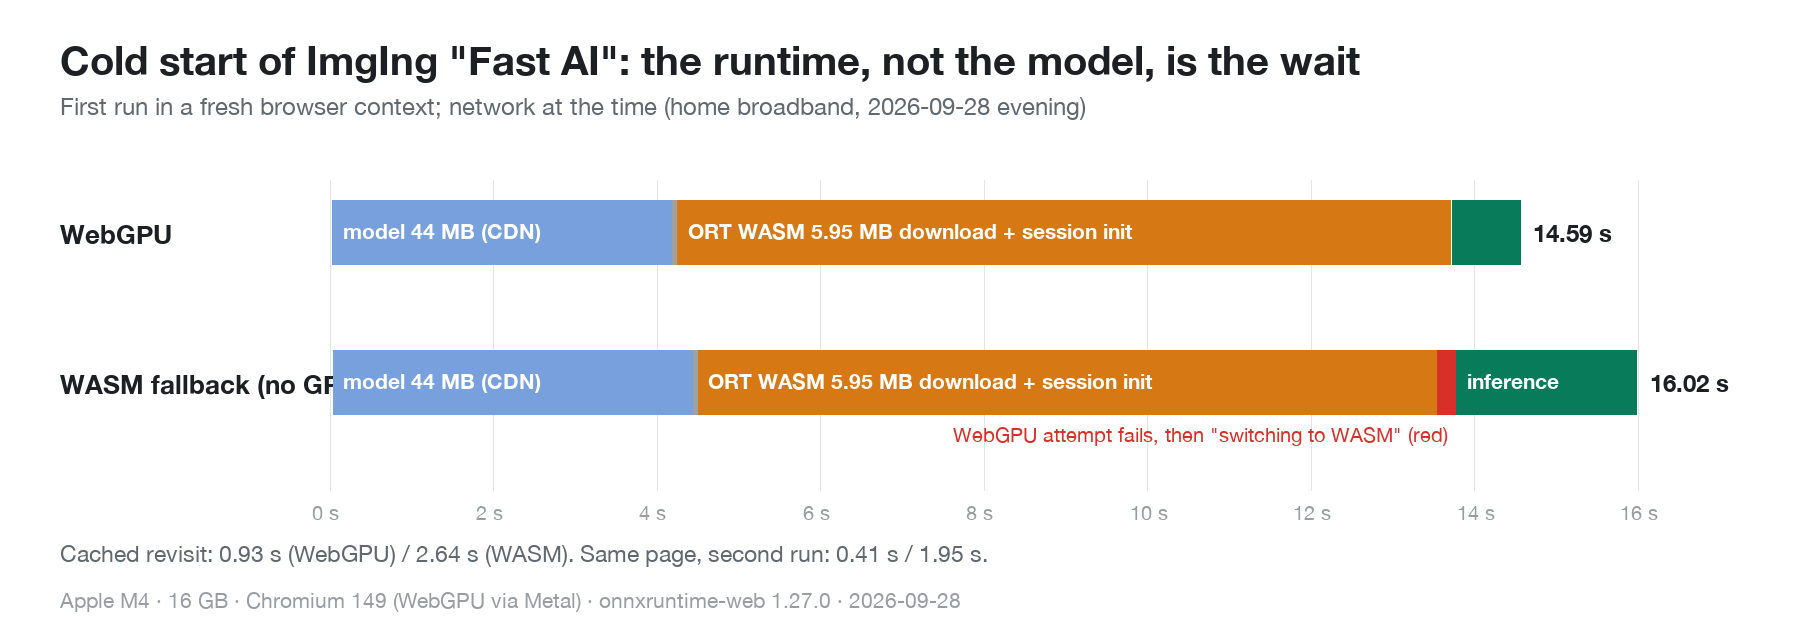
这张图要看什么。先看蓝色段:44 MB 的模型在 4.2 s 左右就下完了。再看橙色段:它从模型下完才开始并一直拖到 13 s 以后。这一段主要在等那个 5.95 MB 的运行时 WASM。最后看下面那条的红色小段。没有 GPU 适配器时先试 WebGPU 失败再切到 WASM,这段本身很短。绿色的推理段在 WASM 那条明显更长。图底部那行小字是缓存命中和同页再跑的耗时。
这张图是我这篇最意外的地方:44 279 201 字节的模型在 +4.2 s 下完。随后才开始请求运行时 WASM,到 +13.2 s 才下完。一个不到 6 MB 的文件比 44 MB 的模型慢了一倍多。我一开始不信。我用 curl 单独复测了那个运行时文件两次:9.19 s 和 10.78 s,折合 552--648 KB/s。同一时段 curl 下 ModelScope 上的 44 MB 模型只要 4.20 s(大约 10.5 MB/s)。
这只是那一晚那条家用宽带的速度。不同地区、不同运营商到这两个源的速度可能完全不一样。后来有一轮在关掉 GPU 的浏览器里重跑:运行时 WASM 到 +34.2 s 才下完,模型还是 +4.3 s。同一个文件前后差了三倍多。我不替任何一方判断这是哪里的问题。我只陈述看到的:这一晚冷启动的等待大头压在运行时文件上,而它和模型是一前一后串着下的。
对我自己的站这条的意思很直接:我原以为冷启动只要盯模型大小。实际上运行时文件放在哪台机器、那台机器出口多快、它能不能和模型并行下,这几件事比模型小几兆重要得多。我那台最低配主机的出口恐怕比这一晚测到的 552--648 KB/s 好不到哪去。
4.2 专业 AI 冷启动 34.8 s 和 45.1 s
专业 AI 的模型在网络记录里是 219 363 264 字节。开着硬件加速时模型 +20.5 s 下完、运行时 WASM +29.8 s 下完,冷启动总共 34.8 s。没有可用 GPU 适配器时模型 +21.4 s、运行时 +30.8 s,总共 45.1 s。
两者差的 10 秒主要在推理。同页再跑一次时 WebGPU 是 1 987 ms 而回退到 WASM 是 13 645 ms。拆出来的推理段 WebGPU 约 1.93 s、WASM 约 13.6 s,差了 7 倍。这个 7 倍只在这台 M4 和这个模型上成立,换机器换模型我不敢说。
四十五秒是什么概念?我给客户做的上传页超过五秒没反应客户就会发微信问「是不是卡了」。图映的进度会分阶段报文字:先是「正在从 ModelScope CDN 下载 快速 AI模型」,带已下载的字节数;然后是校验 SHA-256;再然后是「正在初始化 快速 AI」。我把快速 AI 那次的进度事件逐条对了一遍时间。「正在初始化」这一句从 +4.5 s 一直挂到 +13.6 s,这 9 秒里页面实际在等那个运行时 WASM 下完。用户看到的是「初始化」而其实是在下载。有进度文字能缓解一点,等待本身还是实打实记在用户那边。
4.3 回访和同页再跑要多久
冷启动只发生在第一次。缓存命中后新开一个页面,快速 AI 开着硬件加速是 930 ms 而没有 GPU 适配器是 2 643 ms。同一个页面再跑一次(会话已经建好)分别是 409 ms 和 1 951 ms,也就是 0.41 s 和 1.95 s。专业 AI 缓存命中的新页面是 2 891 ms 和 14 334 ms。
这组数说明端侧 AI 的等待账很不均匀。第一次要十几秒到四十几秒,之后只要零点几秒到一两秒。第一次的等待是「下载加建会话」的固定成本,之后只剩推理本身。一个用户只来抠一张图就走的话他付的全是固定成本。一个用户一次抠二十张的话固定成本就摊薄了。我站上的访客大多是前一种:搜进来、处理一张、关掉。这一点让我对端侧方案的热情降了一截。
五、浏览器跑 AI 模型占多少内存
第三笔换形态的是内存:服务器推理时内存是我那台机器的,端侧推理时内存是用户那台电脑的。
我记的是整个过程里浏览器进程的 RSS 峰值。快速 AI 开着硬件加速时渲染进程峰值 976 MB、GPU 进程 147 MB;没有 GPU 适配器时渲染进程 1 217 MB、GPU 进程 102 MB。专业 AI 开着硬件加速时渲染进程 1 637 MB、GPU 进程 232 MB;回退到 WASM 时渲染进程 3 580 MB、GPU 进程 99 MB。
3.58 GB 是这篇里我最想让同行记住的数。一个网页标签页为了抠一张图峰值吃掉了 3.58 GB。就为一张图。这是回退到 WASM 的专业 AI,是开着硬件加速时的 2.2 倍。16 GB 的 Mac 扛得住。别的机器难说。8 GB 内存又同时开着几十个标签页和一个微信的办公电脑会怎样,我没测也不敢下结论。图映在手机上直接不开放专业 AI,我猜跟这个数有关,但这只是猜。
这组数得带一个限定:它是进程 RSS 而不是显存。M4 的 CPU 和 GPU 共用一块内存,Metal 申请的缓冲区未必记在进程 RSS 头上。开着硬件加速时渲染进程更低未必是真的省,也可能是有一部分挪到了没被计进来的地方。显存到底占多少我没量到。这组数只能看趋势:同一个模型回退到 WASM 以后渲染进程明显更胖。
内存这笔账放在服务器上是我付而放在端侧是用户付。用户不会收到账单,他只会觉得电脑变卡、风扇转了、别的标签页被系统回收了。这种成本不出现在任何报表里,但会出现在跳出率里。
六、没有 GPU 的访客多付了什么
第四笔是回退与兼容:这里我只讲账而不讲回退代码怎么写。
navigator.gpu 存在不等于 WebGPU 能用。关掉浏览器的硬件加速以后 navigator.gpu 还在,requestAdapter() 却返回 null。普通用户真会遇到这种状态:有人关过硬件加速,也有的显卡会被浏览器拉黑。遇到这种访客时图映先试 WebGPU,失败了再切 WASM。缓存命中时这个判定本身只花 130 ms 左右,在关掉 GPU 的有界面浏览器里重测是 160 ms。判定本身不贵。
贵的是切过去以后:同样是快速 AI 同页再跑,WebGPU 是 0.41 s 而 WASM 是 1.95 s。专业 AI 的推理段是 1.93 s 对 13.6 s。内存是 1 637 MB 对 3 580 MB。没有 GPU 的访客下载一样多,却等得更久、内存吃得更多。
还有一笔是隐性的:页面没配 COOP/COEP 这两个响应头时浏览器不让 WASM 开多线程。ORT 只在控制台打一条 warning 然后单线程跑。基准里 ISNet INT8 在这种页面上是 6 318 ms,而配了头的四线程是 2 133 ms。慢三倍而且不报错。这一条最坑。图映的站点头是配了的。我自己的站要上端侧 AI 就得先加上这两个头。加了以后站上所有跨域资源都得带对应的头,不然会被拦。这个改动的工作量我估计比写抠图那段代码还大。这就是兼容成本:它不是钱而是我的工时。
七、端侧 AI 到底省了什么:一张账单
把前面的数摆在一起。下面这张表只有字节和秒而没有钱。
| 项 | 服务器推理 | 端侧推理(快速 AI) | 记在谁头上 |
|---|---|---|---|
| 推理机器 | 要 | 不要 | 端侧省掉的就是这一项 |
| 新访客首次下载 | 不需要模型 | 50.18 MB / 人 | 模型托管方 + 本站 |
| 1000 个新访客 | 我没测 | 50.18 GB | 44.23 GB 第三方 CDN;5.95 GB 本站 |
| 访客硬盘 | 无 | 约 44.23 MB 缓存 | 访客 |
| 冷启动等待 | 我没测 | 14.6--16.0 s | 访客 |
| 回访等待 | 我没测 | 0.93 / 2.64 s | 访客 |
| 同页再跑 | 我没测 | 0.41 / 1.95 s | 访客 |
| 渲染进程内存峰值 | 我没测 | 976 / 1 217 MB | 访客 |
| 回退与兼容 | 基本没有 | COOP/COEP、两套后端 | 开发者的工时 |
服务器推理那一列我大面积写了「我没测」。那一侧的耗时、机器、费用我一样都没跑过,这里不编数。能确定的只有结构:服务器推理是「每张图一笔」而端侧推理是「每个新访客一笔」。前者按图数涨而后者按新访客数涨。
两种账的交点我能给一个式子却给不了答案。设你站上一张图上传加结果回传的平均字节是 B,端侧首次下载是 D(快速 AI 是 50 183 586 字节)。一个新访客处理的图超过 D ÷ B 张,端侧在流量上才开始划算。我那张合成样本只有 43 670 字节。这种压得特别小的图代进去没有意义。你得拿自己站上真实图片的平均大小去算。这还只是流量:服务器推理的机器费用在另一边,我没测也放不进这个式子。
算完我对那句话的理解改了。「端侧 AI 不花服务器钱」不算错,它只说了推理机器那一格。剩下几格的账没有消失而是大部分挪到了用户身上:他的带宽、他的等待、他的内存。挪到用户身上的成本不会出现在我的账单里。这就是它看起来「省」的原因。我原先只算了第一格。
八、我的小站打算怎么上
账算完我给自己定了几条;它们只对我这种小站成立。
第一条是默认只给快速档而且不预取。用户点了抠图按钮才开始下载,按钮旁边直接写「首次需下载约 50 MB」。专业档放在要主动展开的地方,旁边写「首次约 225 MB,内存吃得多」。我宁可少几个人用专业档也不想让误点的人白下 225 MB。
第二条是模型不放自己的主机。我的出口扛不住 44 MB 的并发下载,这一份交给公开的模型托管平台。运行时我自己托管:开 gzip、加上 application/wasm、设成 immutable 长缓存。托管平台挂了怎么办我还没想好,也没定要不要像图映那样留一个本站兜底。留了的话兜底那一刻的流量又回到我头上。
第三条是运行时和模型并行下。冷启动那张图让我记住了:两个文件串着下时等待是相加的。我的页面会在用户点按钮的同时把两个请求都发出去。这一条的效果我还没实测过。
第四条是看内存再决定开不开专业档。navigator.deviceMemory 在这台机器上报的是 16。低于某个值我就不显示专业档。阈值定多少我还没数据,先拍一个 8 以后看反馈再改。
第五条是服务器推理的方案我不删。先留着对照。等我真把两边都跑起来再拿同一批图算一次完整的账。那时候才轮得到钱。
九、适用场景 / 不适用场景 / 风险提示
9.1 适用场景
- 访客大多一次处理很多张图,冷启动的固定成本能被摊薄。
- 你没有 GPU 服务器也不想按次调接口,愿意让用户承担一次下载。
- 模型能交给第三方托管,自己只出运行时那 5.95 MB。
- 用户主要在内存不太紧的桌面浏览器上。
9.2 不适用场景
- 访客大多搜进来、处理一张就走。每个人都付 50 MB 和十几秒的固定成本,却只用一次。
- 目标用户在手机上。图映自己在手机上都只开放快速档;手机上的表现我没测。
- 打算自托管大模型而主机出口很窄。1000 个新访客的专业档就是 225.08 GB 从你这里出去。
9.3 风险提示
- 缓存是 best-effort 的:
persisted()为 false。被浏览器清掉以后老访客会重新变成新访客。 - 第三方模型托管的规则可能变。变了以后流量会落回你自己的源站。
- 没配 COOP/COEP 时 WASM 静默降成单线程。慢三倍也不报错。
- 这篇的耗时全部来自一台 M4 Mac 和一条家用宽带。别把倍数当成普适结论。
十、测量方法自身的坑
量的过程中我踩了几个坑,有的差点让结论跑偏。挑六个说。
第一个是 MB 的进制:界面写「约 42 MB」而文件是 44 229 662 字节。按 1024 进制是 42.18 MiB,按十进制是 44.23 MB。我一开始混着用,算出来的 1000 个访客差了两 GB 多。后来我统一按十进制而界面的数只拿来对照。
第二个是字节有好几个版本:模型的文件字节是 44 229 662;网络记录里的响应体是 44 279 201;存进缓存后用量增长是 44 230 153。运行时 WASM 的 gzip 传输 curl 量到 5 953 924 而网络记录里是 5 955 745。差额我猜是头部、分块和缓存条目开销,但没有逐项拆。我的算术统一取文件字节和 curl 的 gzip 字节,这样别人能复现。
第三个是网速:那一晚运行时文件要 9 s 多,另一轮到了 34.2 s。冷启动的 14.6--16.0 s 是那一刻的网络给的而不是这个方案固有的。评估自己的站得在自己的服务器和自己用户所在的网络上量。
第四个是 RSS 不等于显存:统一内存的机器上 GPU 那部分分配不一定算进进程 RSS。开着硬件加速时渲染进程更低,但我不敢说它就更省内存。
第五个是计时方式:耗时来自直接调用页面里的抠图函数而不是点按钮。两者调的是同一个函数。点按钮还会多一点界面层的开销,这部分我没算。
第六个是样本:那张瓶子图是程序生成的。推理耗时和图片内容关系不大,但第七章交点公式里的 B 完全取决于真实图片。我没拿合成图的 43 670 字节去算交点就是这个原因。
十一、还没解决的
服务器推理那一侧的账我一直没算。那一侧的耗时、机器占用、费用这篇里一个数都没有。没有它第七章那张表永远只有半张。我打算用同一张图、同一个模型在服务器上跑一遍,把「每张图一笔」那一格也换成秒和字节。
骨灰级 AI 我只有文件字节。它下载要多久、推理吃多少内存都没测。按字节看它每个新访客要 453.22 MB。我不太会在自己站上开这一档。
缓存什么时候会被浏览器清掉我也没测。这直接决定「新访客」到底有多少。清得勤的话 2.2 节那个 50.18 GB 会被低估。
还有一件事让我拿不准。关掉硬件加速的用户到底占多少?我手上没有任何数据。一条都没有。占比很小的话第六章那些回退成本只是小概率事件;占比不小的话 3.58 GB 的内存峰值就得认真对待。
在那之前我能做的很具体:先把代码三在自己站上跑一遍,看运行时和模型到底压没压。再拿代码一把模型字节换成你打算用的那个文件,乘上你站上每月的新访客数。最后对照第七章那张表,把「我没测」那一列换成你自己服务器上的实测。
参考资料
- ONNX Runtime Web 文档:执行提供程序(WebGPU / WASM)与
env.wasm.numThreads说明 - MDN:
StorageManager.estimate()、StorageManager.persisted() - MDN:
PerformanceResourceTiming.transferSize、Timing-Allow-Origin - MDN:
Cross-Origin-Opener-Policy、Cross-Origin-Embedder-Policy与crossOriginIsolated - MDN:
Navigator.deviceMemory - 模型:ISNet(IS-Net / DIS)、BEN2、BiRefNet 各自的开源仓库与许可说明