作者:来自 Elastic Iraklis Psaroudakis, Eugene Cistiakovas
Elasticsearch Serverless 中空闲的索引 shards 现在会从内存中释放其 Lucene writers 和 segment readers,直到下一次写入,从而释放索引层 heap,但代价是首次写入时的中位等待时间为 218ms。
通过 Elastic Cloud Serverless 将自己从运维工作中解放出来。自动扩展、应对负载峰值,并专注于构建 ------ 开始 14 天的免费试用,亲自测试一下!
你可以参考这些指南来构建 AI 驱动的搜索体验,或者跨业务系统和软件进行搜索。
Elasticsearch Serverless 现在会将空闲的索引 shards 从内存中卸载。我们称之为 hollow shards;shard 仍然保持分配状态,但其Lucene IndexWriter 和 segment readers 会被移除,直到下一次写入到达。Hollow shards 建立在 thin indexing shards 之上,后者已经将 Lucene 文件从本地磁盘移走。在生产环境的第一个月中,整个集群在高百分位上的 indexing-node 关闭时间最多降低了 30%,并且有数十万个 shards 进入 hollow 状态。在一个拥有大量空闲 data stream backing indices 的项目中,关闭时间和索引层 heap 最多改善了 3 倍。搜索延迟保持不变,而 hollow shard 的首次写入需要等待 shard 重新加载,中位等待时间为 218ms。
Thin shards 会在本地写入 Lucene(Elasticsearch 用于索引和搜索的搜索库)segments,并将它们作为批量 compound commits 上传到 对象存储 。然后再将它们从磁盘中删除。
一个没有接收数据、并且预计近期也不会接收数据的 thin shard,仍然会持有一个 IndexWriter、segment readers、mappings 以及其 engine 的其他部分。在data stream规模下,这些空闲 engine 占据了大部分索引 heap,并增加了我们为了负载均衡以及在 autoscaling 期间关闭节点而执行 relocation 所需的时间。
Hollow indexing shard 是一个已分配的 thin primary,它只保留最近一次 commit 的 metadata,并且在下一次写入之前不会创建自己的 IndexWriter 或 segment readers。无论如何,搜索从来不会在 indexing node 上使用它们。
为什么 Elasticsearch Serverless 中空闲的索引 shards 会占用内存?
Elasticsearch Serverless 会将 Lucene commits 和 translogs 与 cluster state 一起存储在对象存储中。索引节点和搜索节点属于不同的层级。持久性不再依赖 replica shards,并且迁移 indexing shard 时也不需要在节点之间复制文件。Symposium on Cloud Computing(SoCC)论文介绍了这一架构。
文件离开节点后,Lucene 在内存中对这些文件的视图仍然存在:
-
标准的
IndexEngine会持有一个IndexWriter(即使 RAM buffer 为空),以及一个DirectoryReader和其打开的SegmentReader,这样 writer 就可以看到现有文档,以便执行更新和删除,同时还可以进行版本检查。 -
它还会保留每个 index 的 mappings 和 field infos,同时保留 shard commit state。
对空闲 primary shards 进行 heap dump 后发现,大部分保留的内存来自 engine 的 segment readers,每个大约占用几 MB。writer 和 mappings 占据的内存较少。Hollow engine 可以削减这部分内存占用,节点的 retained heap 也会随之下降。
对于大量使用 data stream 并拥有许多 backing indices 的项目来说,这意味着空闲状态下实际需要的 indexing node,与根据运行中 engine 的公式预测出的 indexing node 之间存在明显差异。
Ingest autoscaling 仍然根据假设 engine 处于运行状态的内存公式来确定 indexing tier 的规模。Hollow shards 的存在,就是为了让我们在这些公式更新之后,不再需要继续做这样的假设。
Hollow shards 与完全物化的 indexing shards 有何不同
完全物化的 indexing shard 会运行一个 IndexEngine。Hollow shard 则在相同的 Lucene 文件之上运行一个 HollowIndexEngine,不具备搜索或写入路径。表 1 对两者进行了比较:
| 项目 | IndexEngine(完全物化) | HollowIndexEngine(hollow) |
|---|---|---|
Lucene IndexWriter |
打开 | 无 |
| Segment readers | 打开 | 无 |
| 接受写入 | 是 | 否;在 shard 变为 unhollow 之前,ingestion 会被阻止 |
| 本地搜索 | 理论上可行 | 不可行 |
| Merges | 在 indexing node 上运行 | 需要先 unhollow |
| Engine stats | 实时计算 | 从 hollow commit 中存储的 stats 提供 |
| Recovery | Translog replay 和 cache 预热 | 无 replay、无预热、无 blob store LIST |
| Commit 中的 Translog node ID | 已设置 | 为空(这就是 hollow 标志) |
| [表 1。索引节点上的 IndexEngine 与 HollowIndexEngine 对比] |
当我们将 shard 变为 hollow 时,会将所有内容 flush 到 Lucene,执行 commit,然后带着 hollow 标志上传到对象存储。我们复用一个现有的 metadata 字段,即"translog node ID",并将其留空。_为空_意味着这是一个 hollow commit,并且 recovery 没有需要 replay 的 translog,因此它会打开 HollowIndexEngine,而不是标准的 IndexEngine。
没有 readers 使 HollowIndexEngine 成为一个很有用的触发器:如果某个调用点尝试在 indexing tier 上执行搜索,它就会暴露这个问题。如果尝试对它执行索引操作,它同样会抛出异常,但 ingestion 在到达 engine 之前就已经被阻止,因此我们可以先将 shard 变为 unhollow,然后重新加载 IndexEngine。
Search routing 保持不变;查询仍然会在 search tier 上运行。Indexing routing 仍然指向这个 primary。由于 ingestion 被阻止,写入会排队,直到我们将 shard 变为 unhollow。
Elasticsearch Serverless 何时将 shard 变为 hollow
只有满足以下所有条件时,shard 才可以变为 hollow:
-
该 index 不是 system index。
-
它已经空闲足够长的时间,具体取决于其类型。(普通 index 或 data stream 当前的 write index 默认需要空闲一天,而较旧的 data stream backing indices 需要空闲 15 分钟。)
-
没有正在进行的 ingest 或 translog 上传。
-
没有正在运行或已经计划执行的 merge。
为什么对 hollow shard 的首次写入会更慢
首次写入会比对 warm engine 的写入更慢,因为我们需要先将 shard 变为 unhollow。这样可以减少空闲时的 heap 占用并加快关闭速度,同时接受对 cold backing index 执行第一次 bulk 时产生的一次性延迟。在 data stream 上,这种延迟几乎不会发生,因为发生 rollover 后的 backing indices 已经不是 write index。它们会一直保持 hollow,直到有人执行 update-by-query 或类似的修正操作。
在 relocation 期间将 shard 变为 hollow
我们只会在 shard 进行 relocation 时将其变为 hollow。Relocation 本身已经会阻止 ingestion,并且本身也会执行 flush,因此我们可以复用这个时间窗口。
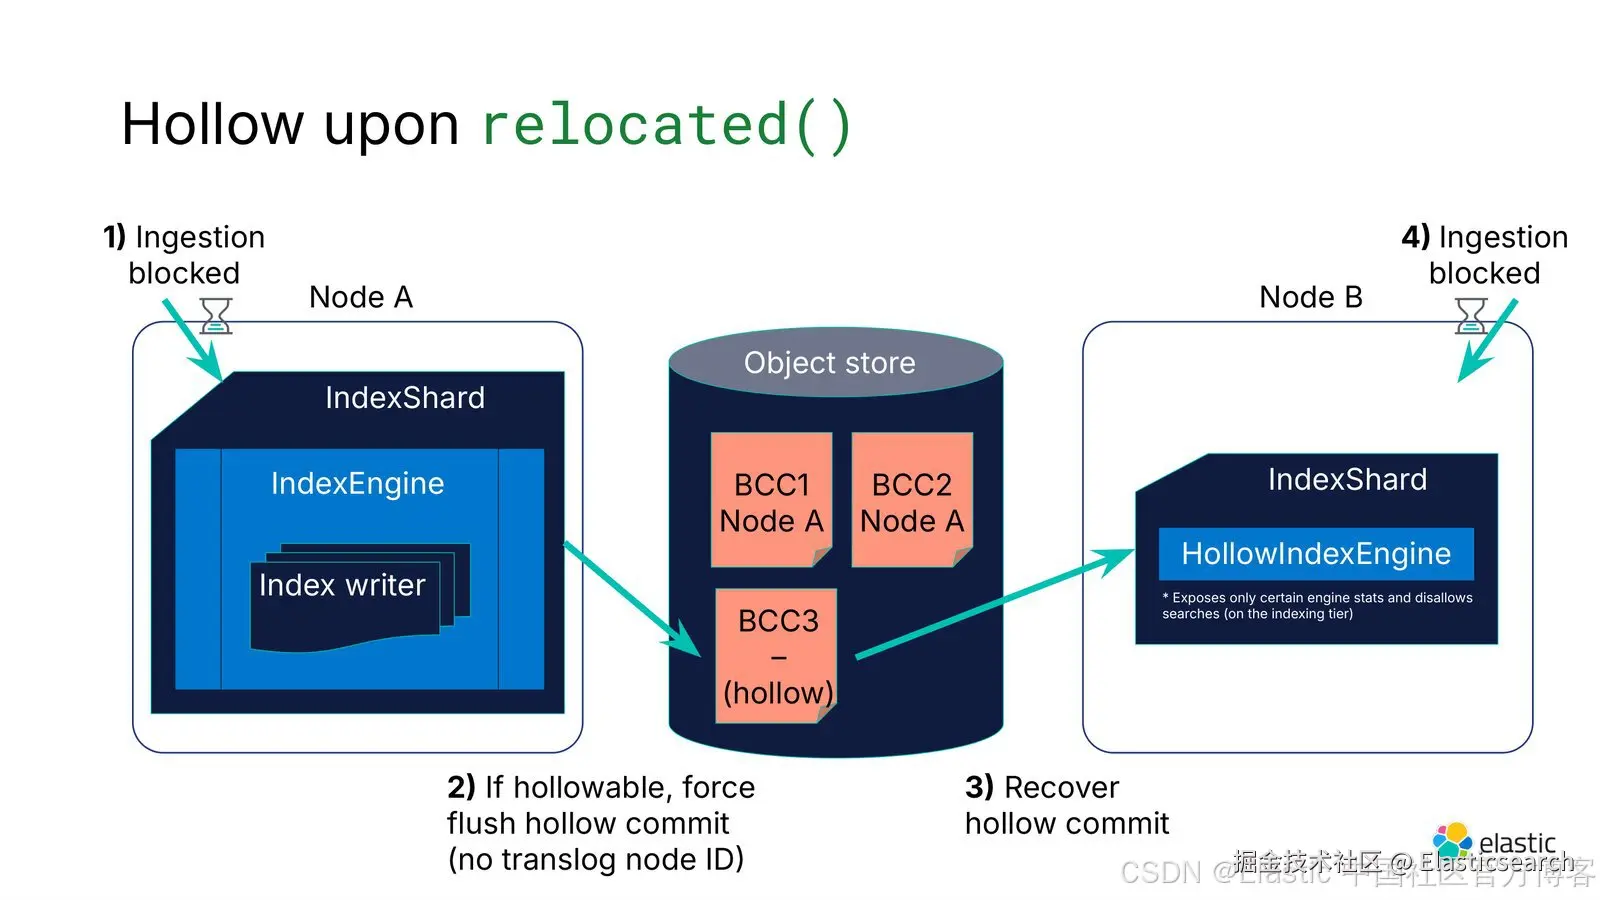 图 1。 在 relocation 期间将 indexing shard 变为 hollow。源节点 A 将 hollow commit flush 到对象存储。目标节点 B 加载 hollow engine。
在源节点上:
-
Ingestion 会被阻止(因为正在进行 relocation)。
-
如果 shard 可以变为 hollow,我们会强制 flush 一个 hollow commit 并上传它。如果它已经是 hollow,则跳过 flush。
-
目标节点会恢复该 commit,并发现为空的 translog node ID(即 hollow 标志)。随后它会加载一个
HollowIndexEngine。 -
我们会继续在目标节点上阻止 ingestion,以防第一次写入偷偷进入 hollow engine。
Hollow recovery 会跳过 translog replay 和 cache 预热,因为一个空闲 shard 不需要它们。如果 indexing node 重启,对象存储中的 hollow commit 会以 hollow engine 的形式重新加载。
首次写入如何将 shard 变为 unhollow
Hollow engine 无法执行索引操作。第一次 ingest 或 force- merge 都必须重新加载一个 IndexEngine。
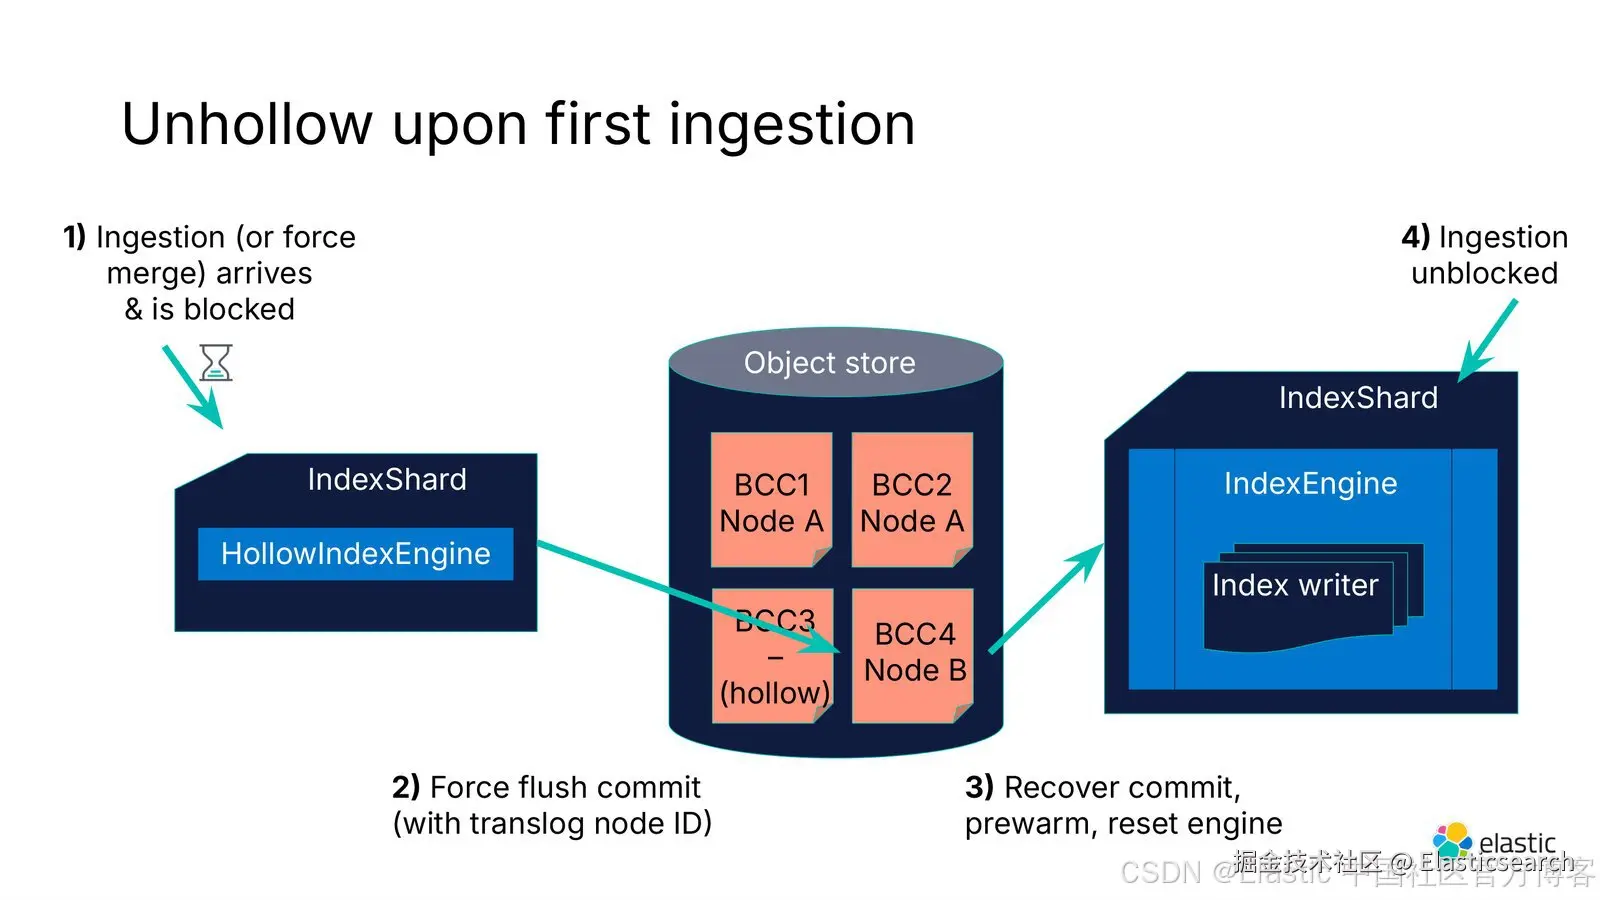 图 2。 首次 ingest 或 force-merge 时将 shard 变为 unhollow。我们 flush 一个包含真实 translog node ID 的 commit,恢复它、进行预热、换入一个 IndexEngine,然后解除 ingestion 阻止。
传入的写入会在 ingestion 阻塞之后等待,并触发一次异步 unhollow 操作,该操作会:
-
执行我们在 hollow 状态下跳过的 recovery 工作,包括 blob cache 预热。
-
关闭
HollowIndexEngine并打开IndexEngine,Lucene 的IndexWriter和DirectoryReader就是在这里创建的。 -
跳过 translog replay。Hollow commit 是干净的;没有需要 replay 的内容。
-
强制 flush 一个非 hollow commit,并写入当前节点的 translog ID,这样即使在下一次常规 commit 上传之前发生崩溃,也能知道 translog 位于何处。
-
解除 ingestion 阻塞。等待中的 ingest 会继续使用真实的 writer 执行。
读取不会触发 unhollow,而且通常也不会到达 indexing tier。实时 get 可以从 search tier 获取结果。数据已经存在于最近一次 hollow commit 中。
Force-merge 是另一个明确的物化节点。Serverless 不会向用户提供 force-merge API,但我们内部仍然会使用它;例如,对 data stream backing indices 使用时。Merge 需要一个 IndexWriter,因此我们会将 shard 变为 unhollow 并执行操作。之后,在下一次 relocation 时,我们会让 shard 再次变为 hollow。
在运行中的 shard 上切换 engine
最困难的部分是一个 Elasticsearch 长期以来一直存在的不变量:一旦 IndexShard 启动并处于运行状态,它打开的 engine 就是它一直使用的 engine。
此前并不存在在一个已经启动的 shard 下更换 engine 类型的概念。Hollowing 和 unhollowing 必须在运行中的 shard 上切换 engine。执行 getEngine().foo() 的调用点都假设,刚刚获取的引用在几行代码之后仍然会保持打开状态。两个失败模式立即出现:
-
在 reset 过程中执行一次单独的 engine 调用(例如,实时 get 上出现
AlreadyClosedException)。 -
某个调用点获取 engine 后多次调用它,在切换发生期间跨越了多个调用(flush、阻止 ingestion,然后再次 flush)。
我们在 IndexShard 上加入了新的 resetEngine(),它会获取 shard 和 engine mutex,并加入 withEngine 读写锁,使 reset 成为唯一的 writer。实现这一点意味着我们需要追踪 refresh listeners 引发的死锁问题;现在这些 listener 会直接接收所需的 reader ,而无需重新进入 engine;同时,我们还在那些假设 engine 不会消失的调用点加入了 withEngine 保护。最终的结果实现了隔离,但确实有些丑陋。
让 stats 和 recovery 不依赖 Lucene readers
Telemetry 会重新打开我们已经释放的 readers。Doc stats 需要打开 searcher。将 shard 变为 hollow 后,我们会计算基本 stats 并将它们存储在 hollow commit 中。之后直接从那里提供这些 stats,不需要在 indexing node 上执行读取。
过去,恢复 hollow commit 时会对 blob store 执行 LIST,并为 hollow engine 永远不会读取的文件预热 cache chunks。现在我们跳过 LIST,并将最小所需的文件 chunks 保存在 hollow commit 中。除非正在执行 unhollow,否则我们会跳过预热。
Hollow shards 的当前限制
我们针对两个尚未完全解决的运维风险进行了设计:
-
Autoscaling 在确定 indexing tier 规模时,仍然将 hollow shards 按完整 shard 计算,这是一个保守的做法。之后,我们会根据它们实际占用的较小 footprint 为其计费,同时为可能变为 unhollow 的 shards 保留预留空间。
-
相关问题是 burst。在 autoscaling 公式能够真实反映情况之后,如果一次大规模更新同时唤醒大量 backing indices,可能会尝试物化超过节点实际拥有的 heap。我们计划根据预留的 heap 对并发 unhollow 操作进行限流。
生产环境中的关闭时间和内存使用
在 rollout 后的第一个月中,如图 3 所示,整个集群的 indexing-node 关闭时间在高百分位上最多改善了 30%。Unhollow 操作仍然很少发生,而数十万个 shards 已经随着时间推移进入 hollow 状态。
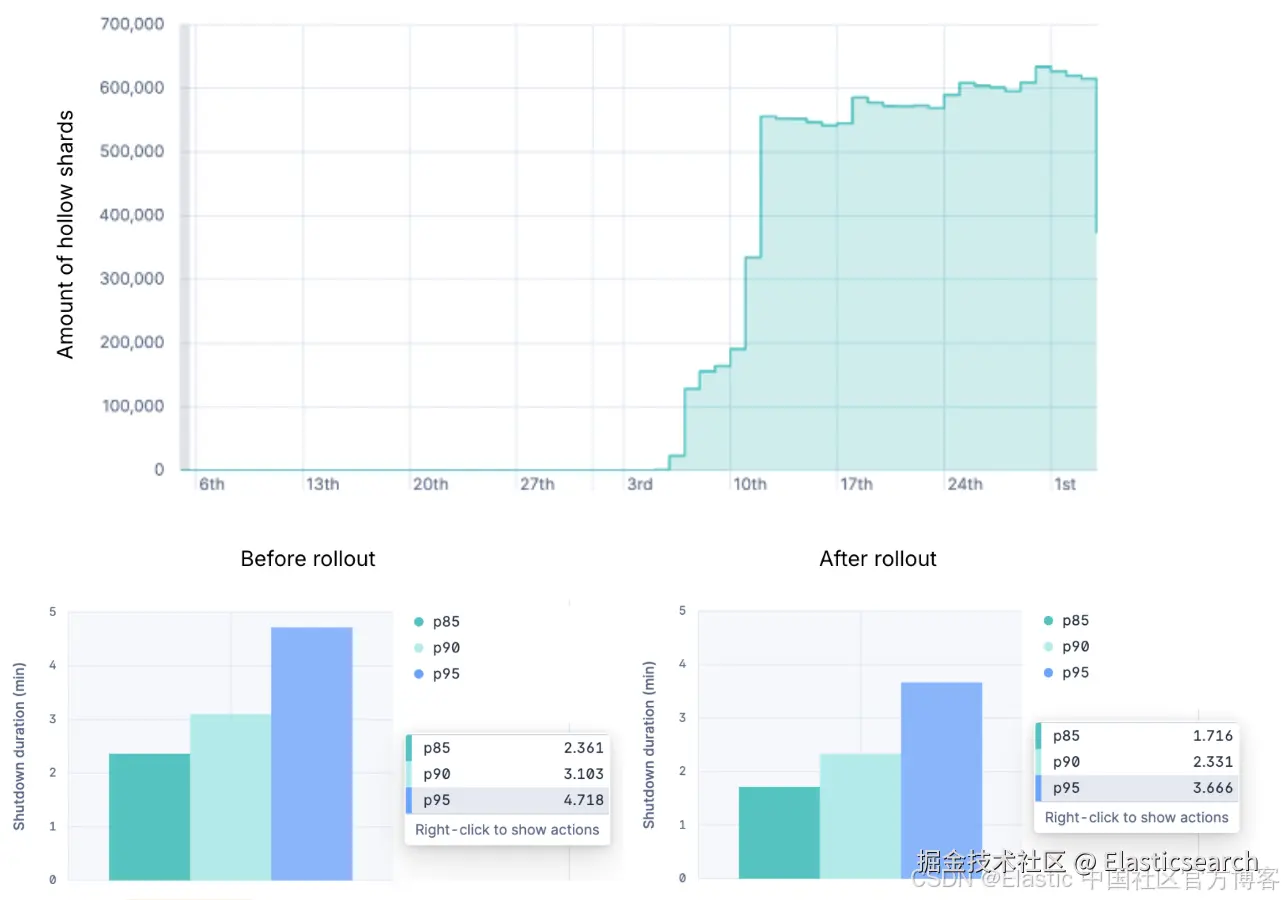 图 3。 Rollout 前后整个集群 indexing tier 的关闭时间
整个集群的 indexing tier heap 使用量也有所下降,不过我们仍在研究如何将这一 footprint 发布给 autoscaler。我们真正感受到的稳定性改善来自关闭时间。节点可以更快地完成从集群中退出,这正是 autoscaling 所需要的。
在其中一个项目中,关闭时间和 indexing tier heap 最多改善了 3 倍,如图 4 所示:
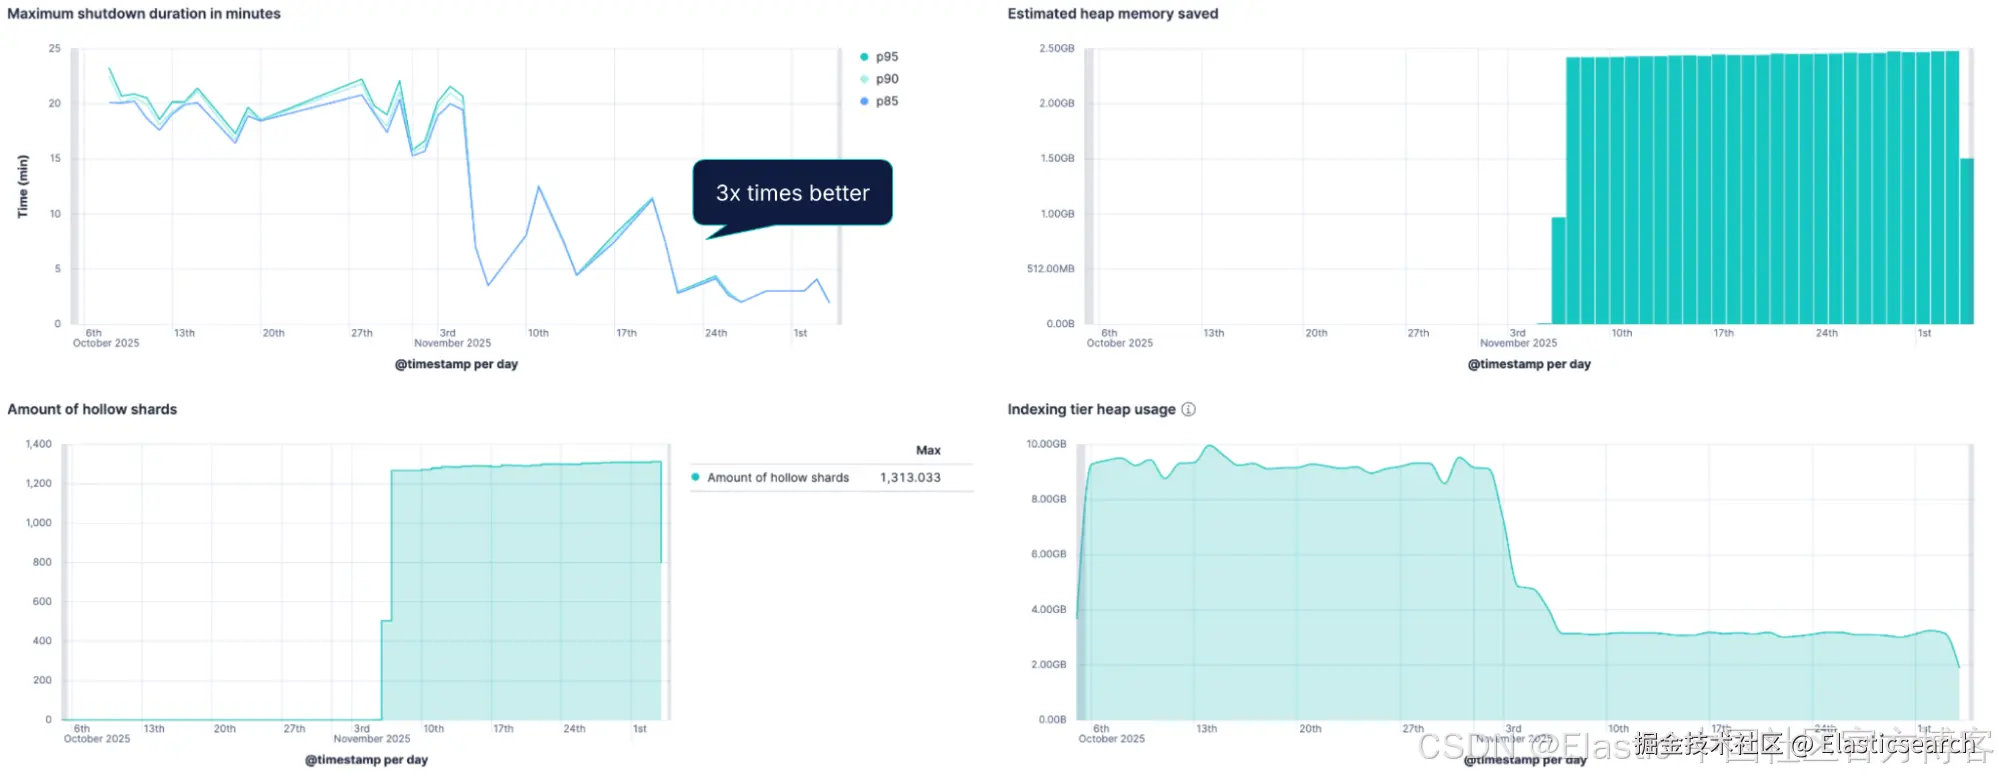 图 4。 一个关闭时间和 indexing tier heap 使用量改善了 3 倍的项目。
我们还对该项目进行了 heap dump。在 rollout 之前,segment readers 占据了 retained heap 的大部分。rollout 之后,这些类型从 dump 的前列消失了,indexing tier 也缩减到了更小的 pods。
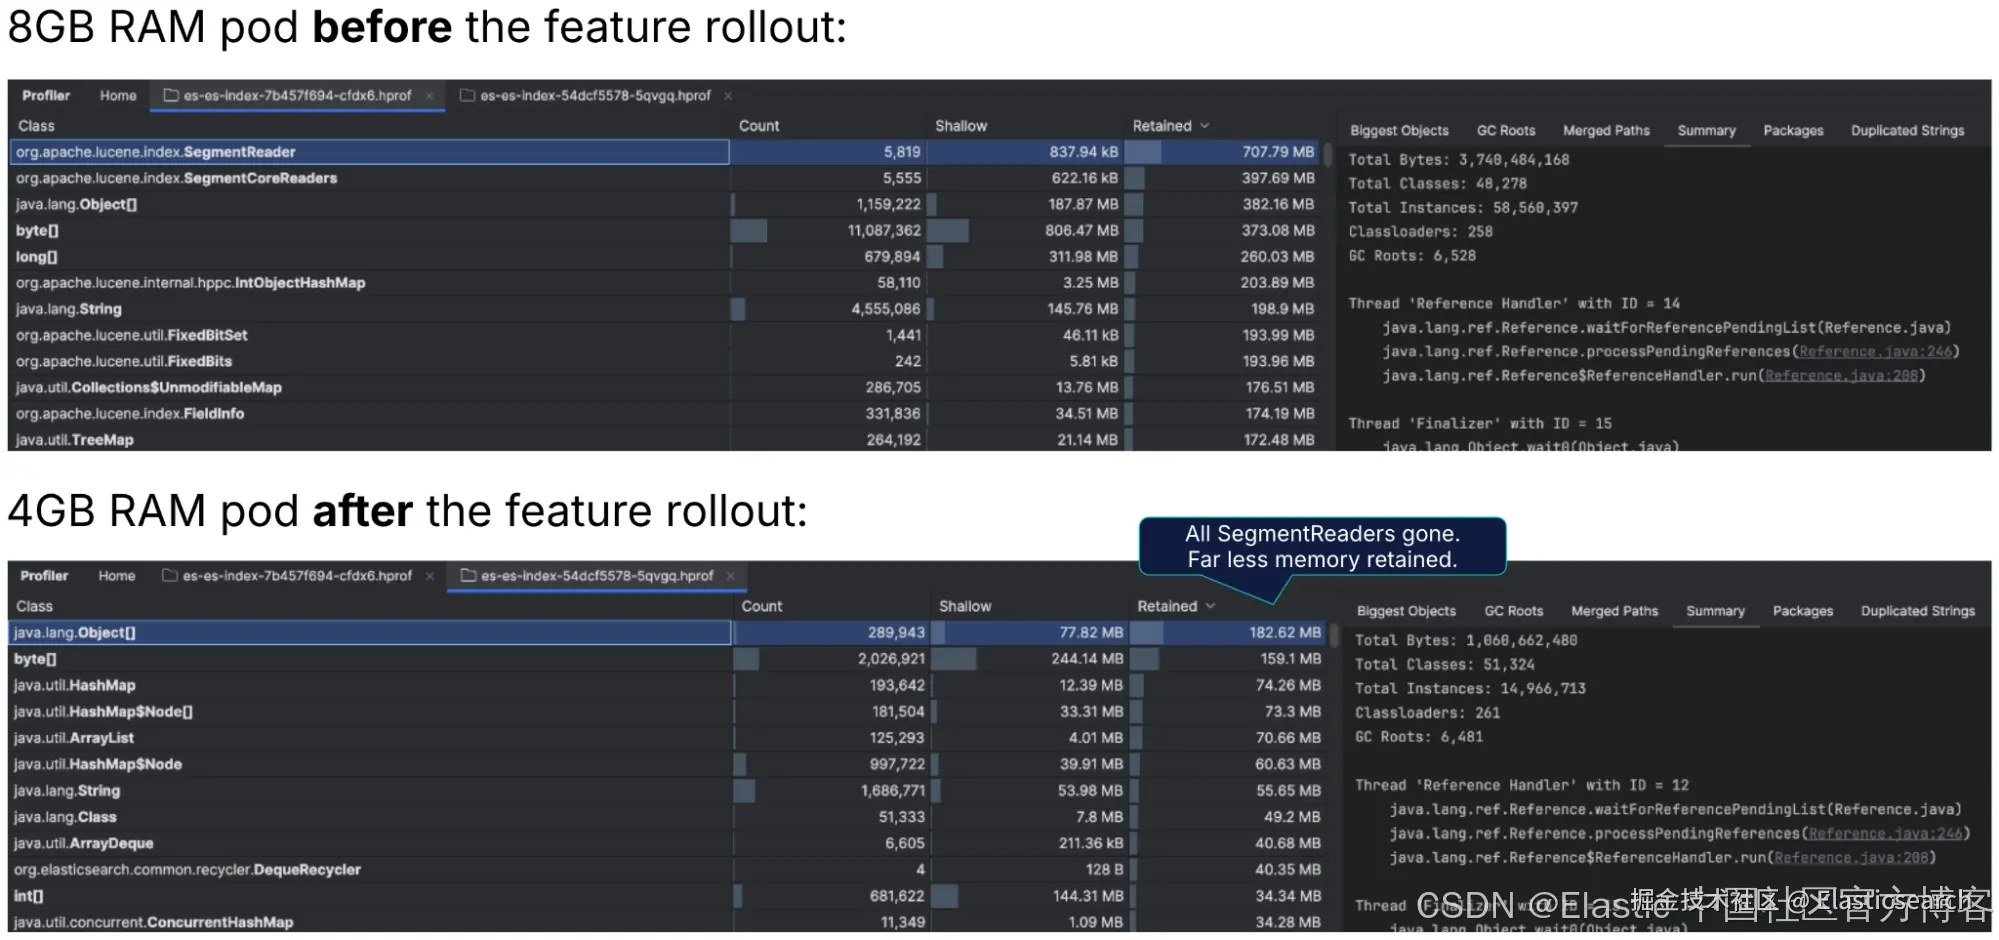 图 5。 hollow shards 之后某个项目的 heap dump,Lucene readers 已从 retained heap 的前列消失。
hollow shards 对 Elasticsearch Serverless 项目意味着什么
Thin indexing shards 将 Lucene 文件从本地磁盘移到了对象存储。Hollow shards 则会将 Lucene 对象从 heap 中移出,直到某次写入需要它们。Hollow commit 是一个批量复合提交(batched compound commit)(BCC),其为空的 translog node ID 表示_恢复元数据,而不是 writer_。它还使用了 live engine swap,而 IndexShard 此前不允许在一个已经启动的 shard 上执行这种操作,因此首次 bulk 会等待,而不是与 swap 发生竞争。
在生产环境中,整个集群高百分位的关闭时间最多降低了 30%,我们也释放出了一部分 indexing tier heap。代价则出现在对空闲 shard 的罕见首次写入时,或者我们运行 merge 时。
如果你正在运行 Elasticsearch Serverless,你的一些 shards 可能已经是 hollow 状态。空闲的 backing indices 应该能够在升级和扩展事件期间更快地进行 relocation,这与图 3 中关闭时间的下降一致;在等待下一次写入(或者永远不会再有写入)的同时,它们也应该以更低的成本占用 indexing tier。
致谢
Hollow shards 由 Elasticsearch Distributed 团队构建。除了作者之外,我们还要感谢 Francisco Fernández Castaño、Tanguy Leroux、Benjamin Lerer、Albert Zaharovits、Artem Prigoda 和 Henning Andersen,他们设计、实现并将这项工作投入生产。我们也要感谢更广泛的 Elasticsearch 工程团队。
常见问题
hollow shards 会影响搜索延迟吗?
不会。搜索在 search tier 上运行,使用来自对象存储的 commit 和 blob cache。Hollowing 只会改变 indexing node 在内存中保留的内容。
对旧 backing index 的首次写入会变慢吗?
会。这次写入会将 shard 从 hollow 状态恢复(recover、prewarm、打开 IndexWriter)。我们已经尽可能降低了这一路径的开销。在一个月的内部可观测性数据中,unhollowing 的中位时间为 218ms。
原文:Elasticsearch Serverless hollow shards: Freeing idle memory | Elasticsearch Labs