作者:来自 Elastic Jeffrey Rengifo
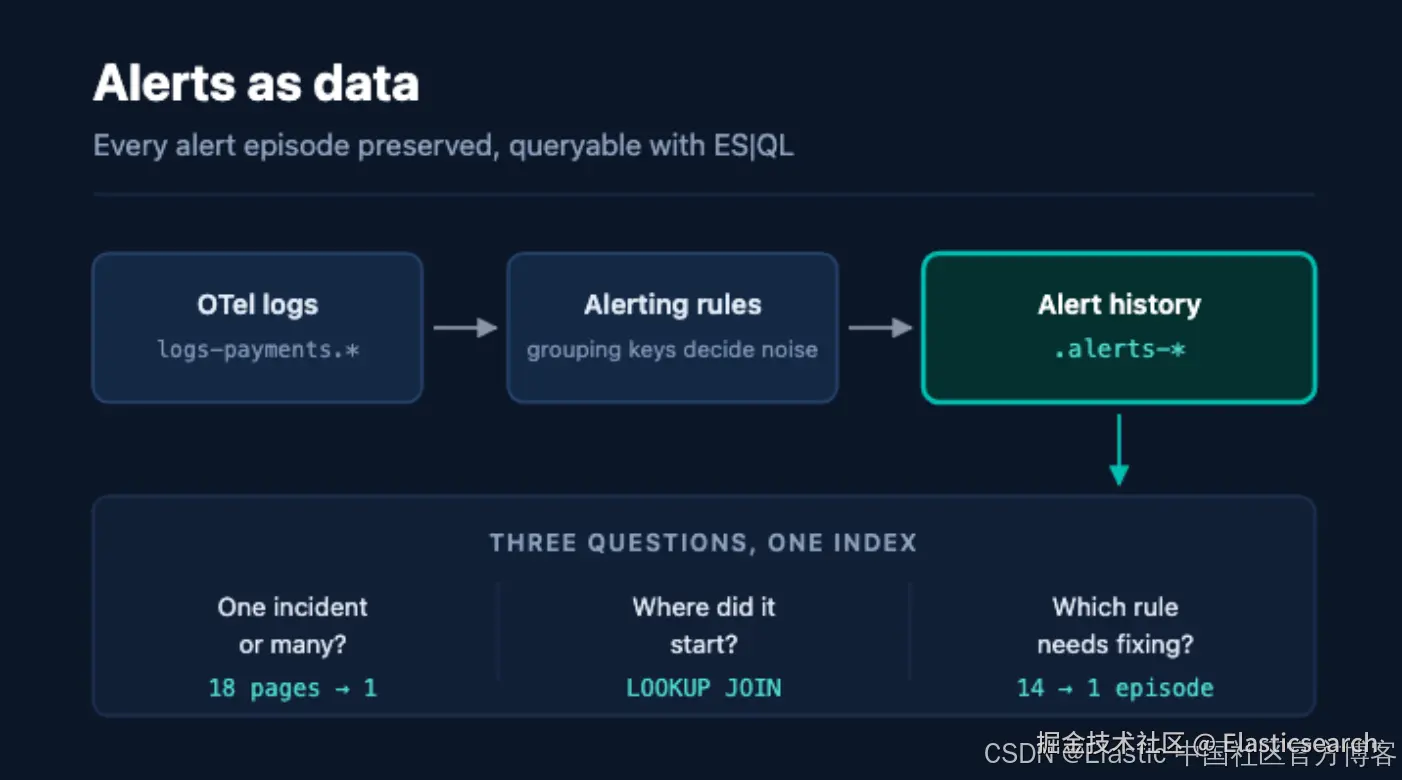
分组键决定一个 incident 会产生多少个 alerts,而由于 Kibana 会为每个 alert document 添加 rule revision,你可以针对最初导致这些 alerts 的同一个 incident,衡量 alert 噪声的减少程度。
在用户发现问题之前就发现问题。从 synthetic monitoring 和 SLO 文档 开始。你也可以立即开始 Elastic Cloud 免费试用。
一次 payments 平台上的糟糕部署在 7 分钟内开启了 18 个 alert episodes,而它们全部来自同一个 incident。一个校准不当的 rule 在仅 7 个 alert instances 中产生了其中 14 个 episodes。episode 持续时间的中位数为 1 分钟,因此其中大多数在任何人能够打开页面之前就已经恢复了。
这是一次通过查询完成的 alert 噪声减少练习。Kibana 会将每个 alert 写入一个隐藏 index,并在 alert 恢复后继续保留在那里,因此我们使用 ES|QL 向这个 alert history 提出三个问题:这是一个 incident 还是多个 incidents,它从哪里开始,以及哪个 rule 产生的噪声多于信号?然后我们更改产生噪声的 rule 的 grouping key,并重新执行相同的故障,此时相同的查询返回一个持续 7 分钟的 episode。
Kibana 会为每个 alert document 添加 rule revision,因此这次调优更改前后的数据都位于同一个 index 中。最后,一个 Agent Builder agent 会针对相同的 alert history 回答相同的问题。
下面的所有内容都在 Elastic Cloud 上的 Elasticsearch 和 Kibana 9.5.2,以及 OpenTelemetry Collector Contrib 0.157.0 上进行了测试。
前置条件
-
Elasticsearch 和 Kibana 9.5 或更高版本,运行在 Elastic Cloud 或 自托管 环境中。
-
具有创建和编辑 Elasticsearch query rules 和 Observability custom threshold rules 的 Kibana 权限,以及对
.alerts-*indices 的读取权限。 -
OpenTelemetry Collector Contrib 0.157.0 或更高版本,以及一个具有 OTLP endpoint ingest 权限的 Elasticsearch API key。
-
已启用 Agent Builder,仅最后一节需要。此前的所有内容都是纯 ES|QL,无需 Agent Builder 即可运行。
为什么 alert history 胜过 alert notifications
通知回答的是一个短暂的问题:现在谁应该关注这个问题?
而大多数能够让 alerting 变得更好的问题都会在之后出现,并且它们都是关于数据的问题:
-
18 个 alert episodes 代表 18 个问题,还是从 18 个角度评估的同一个 incident?
-
哪个 service 最先出现症状,故障是否沿着依赖链传播?
-
哪些 rules 会产生没人能够采取行动的短暂、重复 episodes?
-
上个月调整 threshold 后,是否真的减少了噪声?
在 Elastic 内部,这种思路有一个名称:alerts as data。
其理念是,每个 alert 和每次状态转换都是时间中的一个事实,以明确的语义进行 存储 ,因此 correlation 可以通过跨 streams 的查询来完成,而不需要专门开发的功能。
这也符合实际运维渠道中出现的情况:一次基础设施故障可以在几秒钟内开启数十个 alerts,而阈值校准不当导致的 alerts flapping 也是造成页面疲劳的常见来源。
这两个问题都很难通过 notifications 解决,但通过保留下来的 alert history 进行研究则很直接。
Kibana alerting 在每个 alert document 中存储的内容
Kibana alerting rules 会将 alerts-as-data documents 写入隐藏 indices,你可以像查询任何其他 index 一样对它们进行查询。
本文使用的两个 aliases 分别是.alerts-stack.alerts-default(用于 Elasticsearch query rules)和.alerts-observability.threshold.alerts-default(用于 Observability custom threshold rule)。
我们将存储单元称为 episode:一个 document,覆盖一个 alert instance 从变为 active 到恢复的整个过程。
调查时需要关注的字段:
| 字段 | 它告诉你的信息 |
|---|---|
kibana.alert.instance.id |
此 episode 所属的 grouping-key 值 |
kibana.alert.start、kibana.alert.end |
episode 开始和恢复的时间 |
kibana.alert.duration.us |
它保持 active 的时长 |
kibana.alert.status |
active 或 recovered |
kibana.alert.flapping、kibana.alert.flapping_history |
Kibana 是否将其标记为状态快速变化 |
kibana.alert.rule.name、kibana.alert.rule.revision |
使用的是哪个 rule,以及哪个版本的 rule |
kibana.alert.grouping |
结构化的 grouping 值,例如 service.name |
kibana.alert.reason |
触发时人类可读的条件 |
kibana.alert.url |
返回 rule 数据视图的深层链接 |
有两个属性让本文其余部分成为可能。
首先,同一个 instance 的新 episode 会创建一个新的 document,因此统计 documents 就是在统计 episodes。
alert documents 和 notifications 是解耦的:一个 episode 是否也会向某人发送 page,取决于附加到 rule 的 actions 以及它们的 frequency,可以是每次检查时、仅在状态发生变化时,或者按照自定义 interval 发送 summary。
我们的三个 rules 都没有附加 actions,因此在实验过程中没有人收到 page;从这里开始我们统计的所有内容都是 alert document。
其次,具有 ECS 名称的 grouping fields,例如service.name,会被复制到 alert document 的顶层,这意味着 alert history 可以与其他 indices 进行 join。
在开始查询之前,还有一个注意事项:alert indices 很宽。
此部署中的 alerts index 大约映射了 1,400 个 fields,因此本文中的每个 ES|QL 查询都会使用KEEP投影出一组较窄的 columns,你也应该这样做,尤其是在将结果提供给 LLM 的 tools 中。
由于这些是隐藏的 system indices,Discover editor 并不总能检查到它们的 fields,因此它可能会为查询显示 warning,甚至显示 error badge,同时仍然执行查询并返回 rows。请相信工具栏中的结果数量,而不是 badge。
还有一点需要说明:下面的 Kibana screenshots 会使用浏览器的 local time 渲染 timestamps(本实验中为 UTC-5),而正文中的 query result tables 使用 UTC。
实验:一次糟糕的部署如何产生 alert storm
为了生成一个真实的 storm,我们需要的是一组以链式方式发生故障的 services,而不是一次单独的 threshold breach。
场景是这样的:fraud-scorer 2.3.0 由于 model loading 缓慢而上线,payments queue 开始堆积,payment-gateway requests 开始超时,而客户在payments-web上看到 checkout 失败。
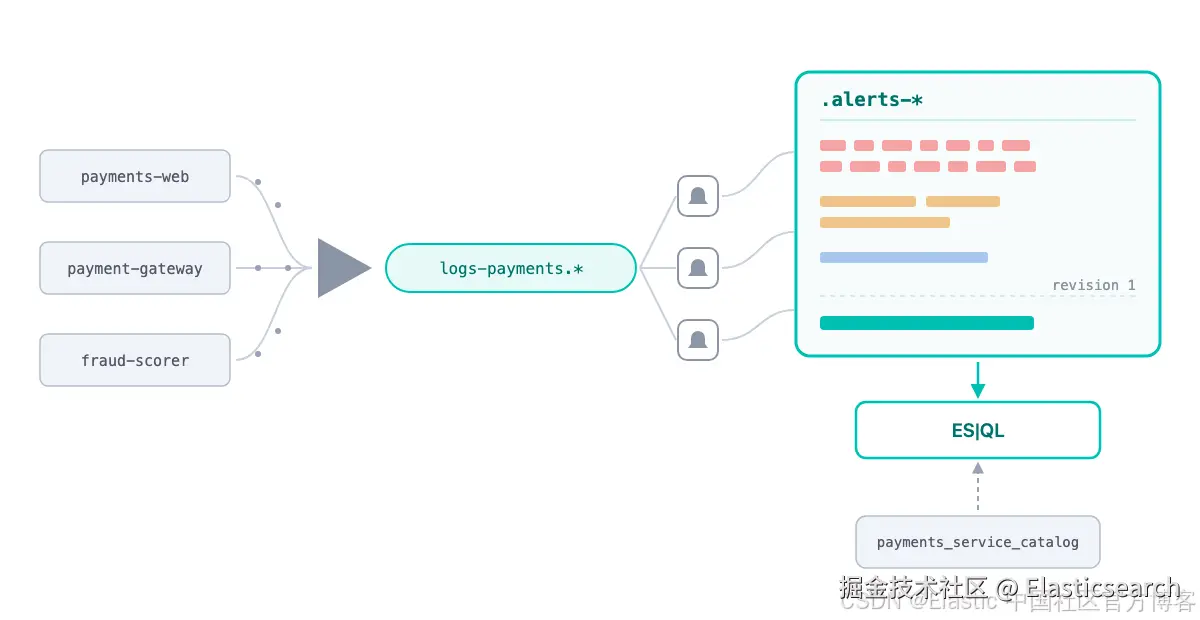
每个 service 都会写入结构化 JSON logs,并且一个 OpenTelemetry Collector 使用filelog receiver 对这些 logs 进行 tail,然后通过 OTLP/HTTP 使用 API key 将它们发送到部署的 Elastic OpenTelemetry endpoint。
yaml
`
1. receivers:
2. filelog/payment_gateway:
3. include:
4. - ${env:LAB_DIR}/events/payment-gateway.jsonl
5. start_at: end
6. resource:
7. service.name: payment-gateway
8. service.namespace: payments
9. service.version: 5.1.2
10. cloud.region: us-central1
11. operators:
12. - id: parse_json
13. type: json_parser
14. parse_from: body
15. - id: parse_severity
16. type: severity_parser
17. parse_from: attributes.severity_text
18. - id: use_message_as_body
19. type: move
20. from: attributes.message
21. to: body
23. exporters:
24. otlphttp/elasticsearch:
25. endpoint: ${env:OTEL_EXPORTER_OTLP_ENDPOINT}
26. headers:
27. Authorization: ApiKey ${env:ES_API_KEY}
`AI写代码一个 transform processor 会将所有内容路由到一个 data stream:logs-payments.stormlab-default。这些 records 最终包含service.name、log.level、labels.*下的自定义字符串 attributes,以及numeric_labels.*下的数值 attributes。
三个 services 的完整 collector 配置,以及一个可以复现整个实验的 notebook,都位于companion repository。
我们还会加载一个稍后将发挥很大作用的小型 index:service catalog。
bash
`
1. PUT payments_service_catalog
2. {
3. "settings": { "index.mode": "lookup" },
4. "mappings": {
5. "properties": {
6. "service.name": { "type": "keyword" },
7. "team": { "type": "keyword" },
8. "tier": { "type": "keyword" },
9. "depends_on": { "type": "keyword" }
10. }
11. }
12. }
`AI写代码三个 documents 将每个 service 映射到其负责的 team、tier 和上游 dependency:fraud-scorer依赖payments-queue,payment-gateway依赖fraud-scorer,而payments-web依赖payment-gateway。
bash
`

1.  POST payments_service_catalog/_bulk
2.  { "index": {} }
3.  { "service.name": "fraud-scorer",    "team": "risk-ml",       "tier": "backend",  "depends_on": "payments-queue" }
4.  { "index": {} }
5.  { "service.name": "payment-gateway", "team": "payments-core", "tier": "edge",     "depends_on": "fraud-scorer" }
6.  { "index": {} }
7.  { "service.name": "payments-web",    "team": "storefront",    "tier": "frontend", "depends_on": "payment-gateway" }

`AI写代码
index.mode: lookup使我们稍后能够从 ES|QL 执行LOOKUP JOIN。
grouping keys 如何决定你会获得多少个 alerts
这个 storm 由三个 alerting rules 进行观测,而它们的 grouping keys 才是本文真正关注的主题。
| Rule | Rule type | Grouping key | Window | Threshold |
|---|---|---|---|---|
gateway-5xx-per-endpoint-status |
Elasticsearch query rule(ES|QL 模式) | labels.endpoint、labels.status_code、cloud.region |
1 分钟 | 3 个或更多 errors |
fraud-scorer-queue-lag |
Elasticsearch query rule(ES|QL 模式) | service.name、cloud.region |
1 分钟 | 最大 lag 为 30 秒或更长 |
payments-error-rate-per-service |
Observability custom threshold rule | service.name |
2 分钟 | 超过 5 个ERROR documents |
第一个 rule 是故意校准不当的,采用了一种我们都曾在某个时候上线过的配置:在 1 分钟的 window 内,按照 endpoint 和 status code 对 gateway errors 进行分组,并设置了较低的 threshold。
ini
`

1.  FROM logs-payments.stormlab*
2.  | WHERE service.name == "payment-gateway" AND log.level == "ERROR"
3.  | STATS error_count = COUNT(*) BY labels.endpoint, labels.status_code, cloud.region
4.  | WHERE error_count >= 3

`AI写代码
它作为 ES|QL 模式下的 Elasticsearch query rule 每分钟运行一次,并且每个返回的 row 都会成为一个 alert instance,因此/api/payments,503,us-central1和/api/payments/confirm,504,us-central1会分别触发 alert。
第二个 rule 直接监控第一个多米诺骨牌:fraud queue 上的 consumer lag,由 service 通过numeric_labels.queue_lag_seconds报告。
sql
`

1.  FROM logs-payments.stormlab*
2.  | WHERE service.name == "fraud-scorer" AND numeric_labels.queue_lag_seconds IS NOT NULL
3.  | STATS max_lag_seconds = MAX(numeric_labels.queue_lag_seconds) BY service.name, cloud.region
4.  | WHERE max_lag_seconds >= 30

`AI写代码
第三个 rule 是一个 Observability custom threshold rule:在两分钟内超过 5 个ERROR documents,并按照service.name进行分组。
它代表合理的默认配置:每个受影响的 service 保持一个稳定的 alert instance。它还演示了不同类型的 rules 可以为同一个调查提供数据,因为它们都会写入 alerts-as-data documents。
三个 rules 都带有alerts-as-data-v2标签,这就是下面每个查询隔离它们的方式。
Rules 上的 tags 并不是装饰性的:kibana.alert.rule.tags会存储在每个 alert document 中,因此一个 tag 实际上就是 alert history 中一个可查询的数据集标签。
重放 incident:7 分钟内产生 18 个 alert episodes
我们重放这个 incident:3 分钟的健康基线、2.3.0 部署、queue lag 超过 threshold、持续 6 分钟不断轮换的 gateway 5xx bursts、用户可见的 errors,然后回滚并恢复。
storm 期间的 Alerts 页面看起来,就像 pager 当时感受到的那样。
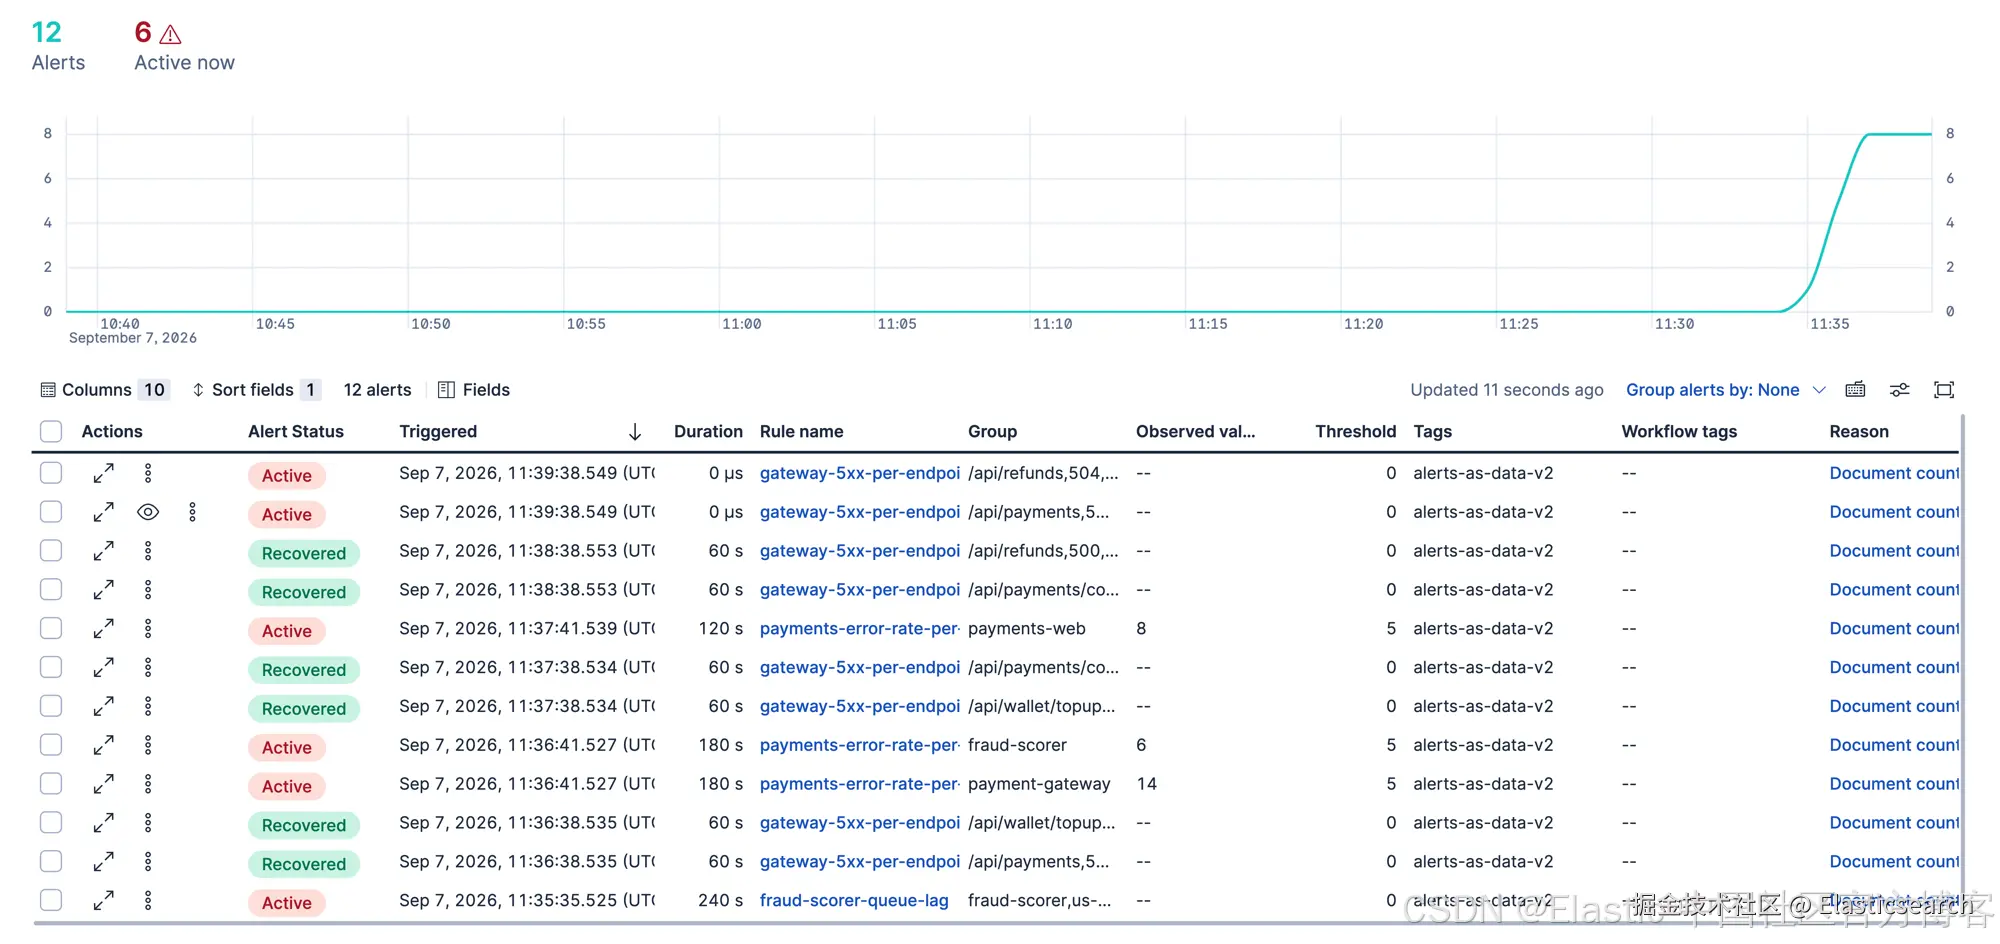
注意这个表格,而不仅仅是数量。
相同的 instance IDs 会在几分钟内同时以Active和Recovered出现,这就是你可以看到、但还无法衡量的 churn。
当一切尘埃落定后,保留下来的 history 可以在 Discover 的 ES|QL 模式中进行查询。
storm 的原始材料,也就是 error logs 本身,证实了这种级联形态:
less
`

1.  FROM logs-payments.stormlab*
2.  | WHERE labels.incident_id == "payments-brownout-20260722" AND log.level == "ERROR"
3.  | STATS errors = COUNT(*) BY minute = DATE_TRUNC(1 minutes, @timestamp), service.name
4.  | SORT minute

`AI写代码!每分钟按 service 统计 error 数量的 Discover ES\|QL 视图:首先是 fraud-scorer errors,然后是 payment-gateway 每分钟 7 个,最后是 payments-web3
现在我们不再关注 logs,而只分析 alert history。
如何判断一次 alert storm 是一个 incident 还是多个 incidents
ini
`

1.  FROM .alerts-*
2.  | WHERE kibana.alert.rule.tags == "alerts-as-data-v2"
3.  | STATS episodes = COUNT(*),
4.          alert_instances = COUNT_DISTINCT(kibana.alert.instance.id),
5.          first_episode = MIN(kibana.alert.start),
6.          last_episode = MAX(kibana.alert.start)
7.    BY rule = kibana.alert.rule.name
8.  | SORT episodes DESC

`AI写代码| rule | episodes | alert_instances | first_episode | last_episode |
|---|---|---|---|---|
| gateway-5xx-per-endpoint-status | 14 | 7 | 16:36:38 | 16:42:38 |
| payments-error-rate-per-service | 3 | 3 | 16:36:41 | 16:37:41 |
| fraud-scorer-queue-lag | 1 | 1 | 16:35:35 | 16:35:35 |
18 个 episodes、一个 incident,而且每一个都在 7 分钟的时间窗口内开启。
仅 gateway rule 就产生了 18 个 episodes 中的 14 个,同时只跟踪了 7 个不同的 instances,这意味着其中一半的 episodes 都是在某个刚刚恢复的 instance 上重新开启的。
这一行数据将一个通常停留在主观描述层面的抱怨量化了:这个 rule 触发得比它提供的帮助更多。
如何使用 ES|QL 找出哪个 service 最先发生故障
由于 grouping fields 使用的是 ECS 名称,每个 episode 都会在顶层携带service.name,因此我们可以将 alert history 与 service catalog 进行 join。
vbnet
`

1.  FROM .alerts-*
2.  | WHERE kibana.alert.rule.tags == "alerts-as-data-v2" AND service.name IS NOT NULL
3.  | STATS first_symptom = MIN(kibana.alert.start) BY service.name
4.  | LOOKUP JOIN payments_service_catalog ON service.name
5.  | KEEP first_symptom, service.name, team, tier, depends_on
6.  | SORT first_symptom

`AI写代码| first_symptom | service.name | team | tier | depends_on |
|---|---|---|---|---|
| 16:35:35 | fraud-scorer | risk-ml | backend | payments-queue |
| 16:36:41 | payment-gateway | payments-core | edge | fraud-scorer |
| 16:37:41 | payments-web | storefront | frontend | payment-gateway |
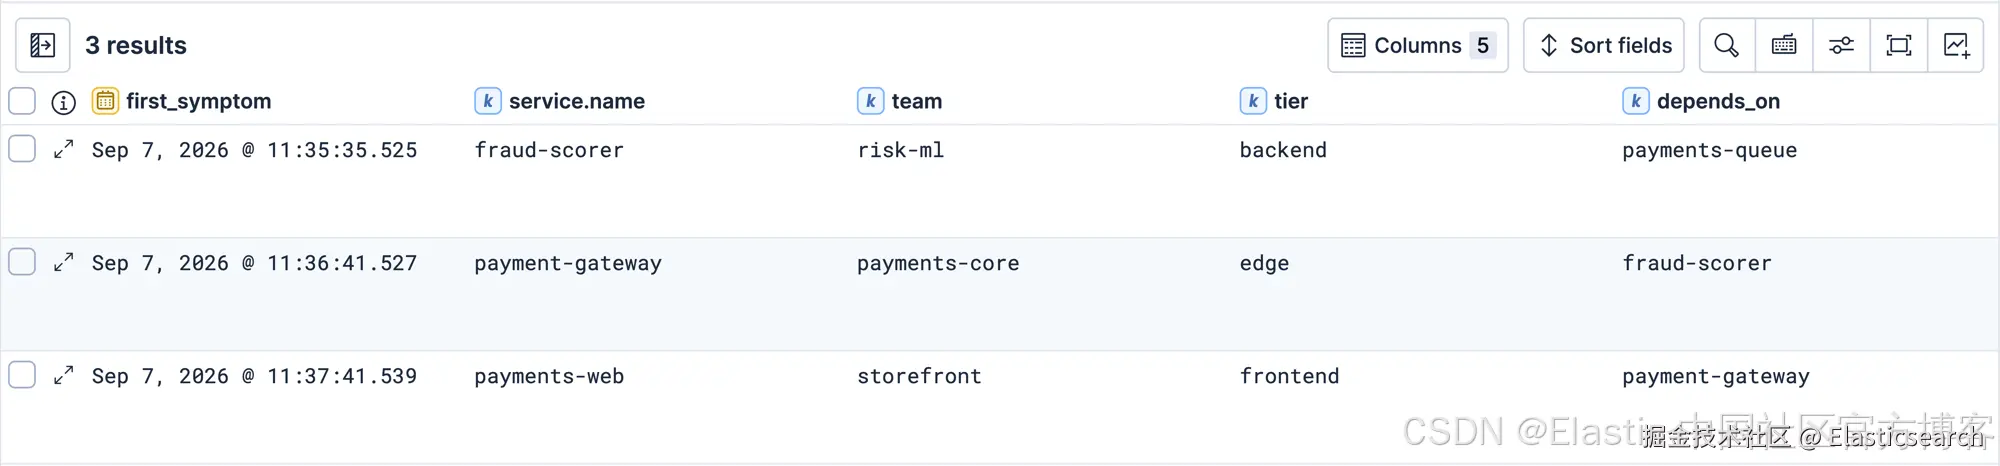
alert 的顺序与 dependency chain 完全一致:第一个 symptom 属于 risk-ml team,66 秒后 edge 出现 degraded,又过了 1 分钟客户才发现问题。
从这个表格中还可以得出一个更微妙的结论。
最早产生 alert 的 service 依赖于payments-queue,而payments-queue从未产生 alert,因此最可能的真正 origin 位于第一个可见 symptom 的上游一跳,而这正是 post-incident review 应该开始查看 logs 的地方。
还要注意这个分析中缺少哪个 rule:按 endpoint 和 status code 分组的 noisy gateway rule,因此它的 episodes 不包含service.name,无法参与 topology join。
Grouping key 是你未来进行调查时的数据契约。
如何评估哪个 alerting rule 的噪声最大
一个 noise scorecard 查询可以将 rule quality 汇总到一个表格中。
ini
`

1.  FROM .alerts-*
2.  | WHERE kibana.alert.rule.tags == "alerts-as-data-v2"
3.  | EVAL minutes_active = COALESCE(kibana.alert.duration.us, 0) / 60000000.0
4.  | STATS episodes = COUNT(*),
5.          alert_instances = COUNT_DISTINCT(kibana.alert.instance.id),
6.          flapping_episodes = SUM(CASE(kibana.alert.flapping == true, 1, 0)),
7.          median_minutes_active = MEDIAN(minutes_active)
8.    BY rule = kibana.alert.rule.name, revision = kibana.alert.rule.revision
9.  | SORT episodes DESC

`AI写代码| rule | revision | episodes | instances | flapping | median minutes active |
|---|---|---|---|---|---|
| gateway-5xx-per-endpoint-status | 0 | 14 | 7 | 0 | 1.0 |
| payments-error-rate-per-service | 0 | 3 | 3 | 0 | 7.0 |
| fraud-scorer-queue-lag | 0 | 1 | 1 | 0 | 9.0 |
先看最后一列。
1 分钟的 median active time 意味着 gateway rule 的典型 episode 在 on-call 甚至来得及登录之前就已经自行恢复,而两个 grouping 合理的 rules 产生的 episodes 持续时间足够长,可以代表实际的 incident。
flapping列是 Kibana 针对同一个问题的处理方式,而它属于事后补救。
真正的修复发生在上游,也就是 rule definition 中,而 alert history 刚刚已经准确告诉我们需要修改什么:grouping key 制造了 instances,而 1 分钟的 window 制造了重新开启。
减少 alert 噪声:修复 rule 并验证它是否生效
rule 自己的 detail page 已经总结了这个问题:24 小时内有 14 个 alerts,它们全部来自同一个 incident,而产生这些 alerts 的正是右侧显示的 definition。
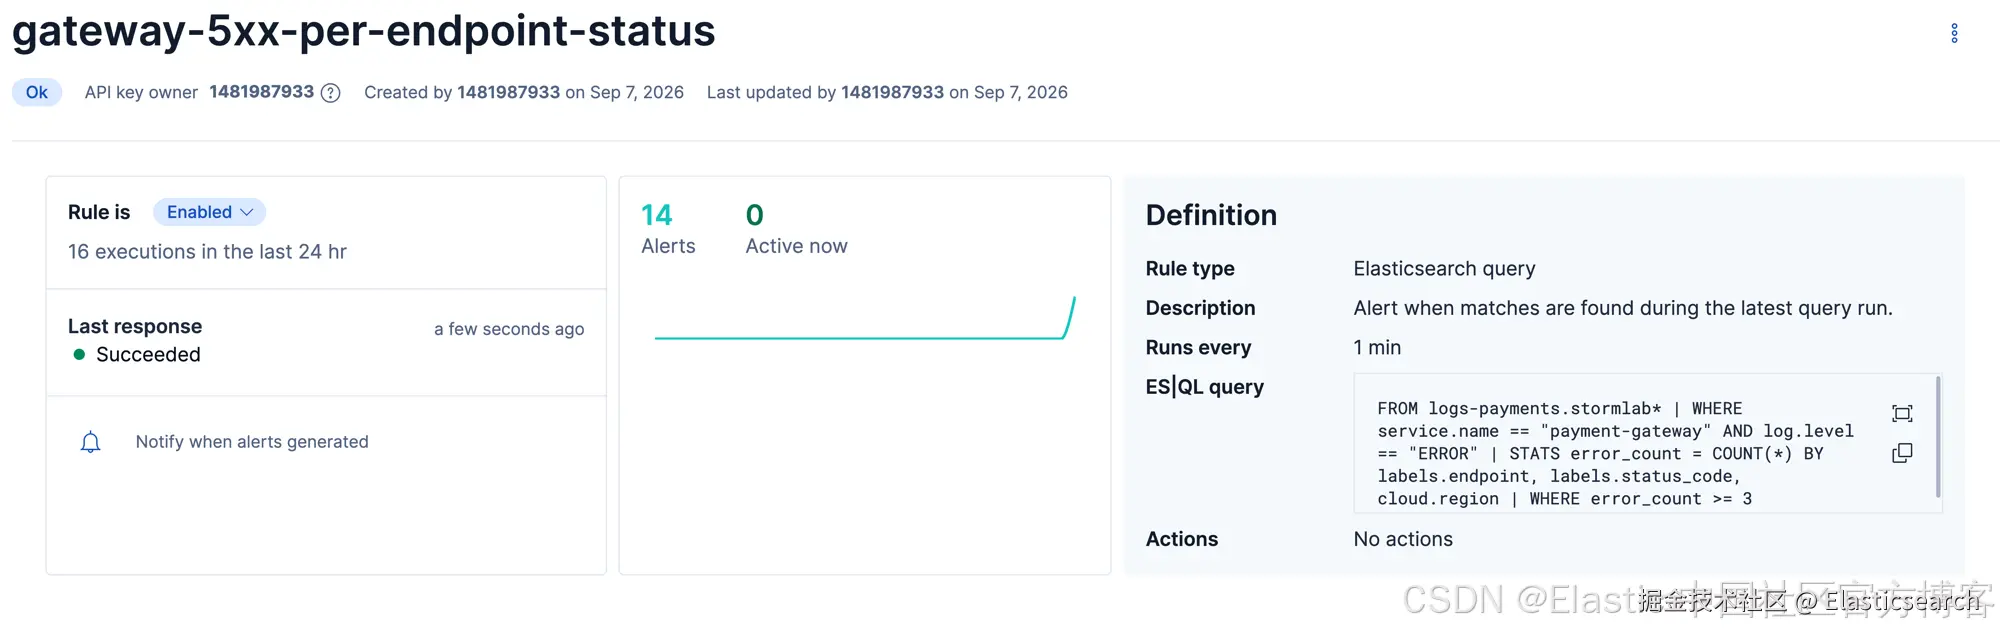
我们更新 rule,而不是替换它,将 grouping 更改为service.name,将 window 扩大到 5 分钟,并提高 threshold。
ini
`

1.  FROM logs-payments.stormlab*
2.  | WHERE service.name == "payment-gateway" AND log.level == "ERROR"
3.  | STATS error_count = COUNT(*) BY service.name, cloud.region
4.  | WHERE error_count >= 10

`AI写代码
以原地方式更新 rule 很重要,原因只有一个:Kibana 会为每个 alert document 添加kibana.alert.rule.revision,因此调优更改前后的数据可以在同一个 index 中进行区分,而无需我们自己做任何记录。
然后我们重放同一个故障的压缩版本:相同的部署、相同的 lag 上升过程、相同的 gateway bursts 轮换、相同的客户影响,在 7 分钟后回滚。
scorecard 查询无需修改,现在 revision 列体现出了它的价值:
| rule | revision | episodes | instances | flapping | median minutes active |
|---|---|---|---|---|---|
| gateway-5xx-per-endpoint-status | 0 | 14 | 7 | 0 | 1.0 |
| payments-error-rate-per-service | 0 | 6 | 3 | 0 | 6.0 |
| fraud-scorer-queue-lag | 0 | 2 | 1 | 0 | 8.0 |
| gateway-5xx-per-endpoint-status | 1 | 1 | 1 | 0 | 7.0 |
未发生更改的 rules 现在会在各自的 rows 中同时显示两个 incidents,即 6 个和 2 个 episodes,这正是稳定的 rules 应该表现出的情况。
gateway rule 被拆分成两行,因为 revision 发生了变化,而这种对比用 4 个数字就完整呈现了本文的核心论点。
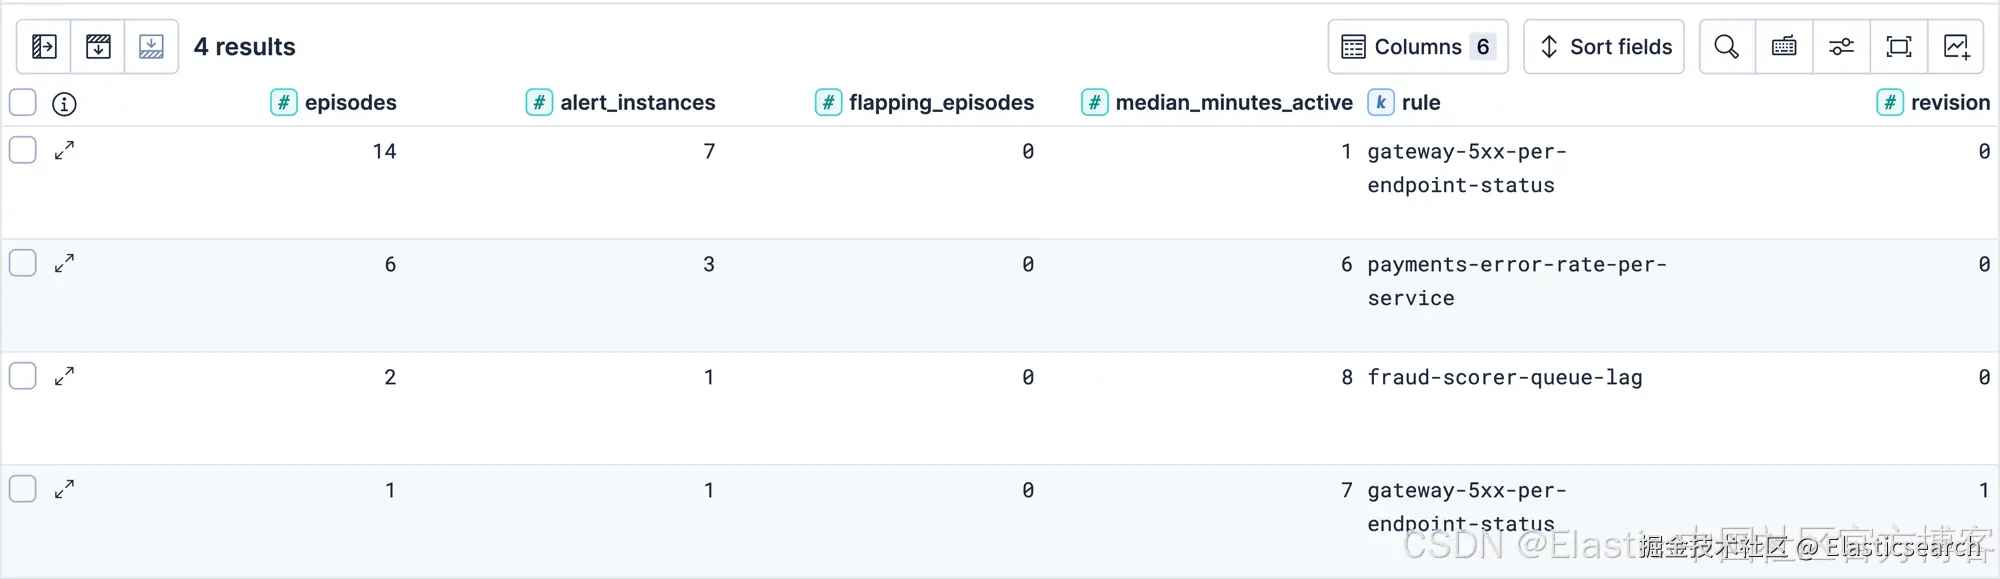
相同的故障形态,从 14 个 episodes 变成了 1 个 episode,而现在 episode 的中位持续时间从 1 分钟变成了 7 分钟,因此它覆盖了整个 incident,而不再只是其中的一小部分。
这正是 alerting 工作中通常依赖经验判断的部分,而在这里,它变成了一个查询结果:我们使用相同的 ES|QL,在相同的 index 中,针对相同的 incident 模式验证了这次调优更改。
这个循环中的任何部分都不是我们的 lab rule 所特有的。
任何为其 alerts 添加 tag 的 rule 都可以通过这种方式进行评估、调优和重新评估,从而将 alert 调优从一种主观意见转变为一种可量化的测量。
使用 Agent Builder agent 查询 alert history
上面的每个查询都是确定性的,因此非常适合作为 AI agent 的 tools。
我们在 Agent Builder 中注册 3 个 ES|QL tools,每个 tool 都是本文某个查询的参数化版本,并带有明确的KEEP投影,然后将它们连接到一个名为 Alert Historian 的 agent。
swift
`
1. POST kbn:/api/agent_builder/tools
2. {
3. "id": "alert_noise_scorecard",
4. "type": "esql",
5. "description": "Noise scorecard per alerting rule and revision: episodes, distinct instances, flapping episodes, median minutes active.",
6. "configuration": {
7. "query": "FROM .alerts-* | WHERE kibana.alert.rule.tags == \"alerts-as-data-v2\" AND DATE_DIFF(\"hours\", kibana.alert.start, NOW()) <= ?lookback_hours | EVAL minutes_active = COALESCE(kibana.alert.duration.us, 0) / 60000000.0 | STATS episodes = COUNT(*), alert_instances = COUNT_DISTINCT(kibana.alert.instance.id), flapping_episodes = SUM(CASE(kibana.alert.flapping == true, 1, 0)), median_minutes_active = MEDIAN(minutes_active) BY rule = kibana.alert.rule.name, revision = kibana.alert.rule.revision | KEEP rule, revision, episodes, alert_instances, flapping_episodes, median_minutes_active | SORT episodes DESC",
8. "params": {
9. "lookback_hours": {
10. "type": "integer",
11. "description": "How many hours of alert history to analyze, for example 6"
12. }
13. }
14. }
15. }
`AI写代码agent 的 instructions 定义了术语(一个 episode 就是一个 alert document)、方法(先看 timeline,然后看 propagation,最后看 scorecard),以及诚实性规则(报告 tool output 中的 numbers 和 timestamps,绝不编造 alerts)。
我们向它提出一个问题:过去 3 小时发生了什么,这是一个 incident 还是多个 incidents,第一个 symptom 由哪个 team 负责,以及 gateway rule 的调优是否减少了噪声?
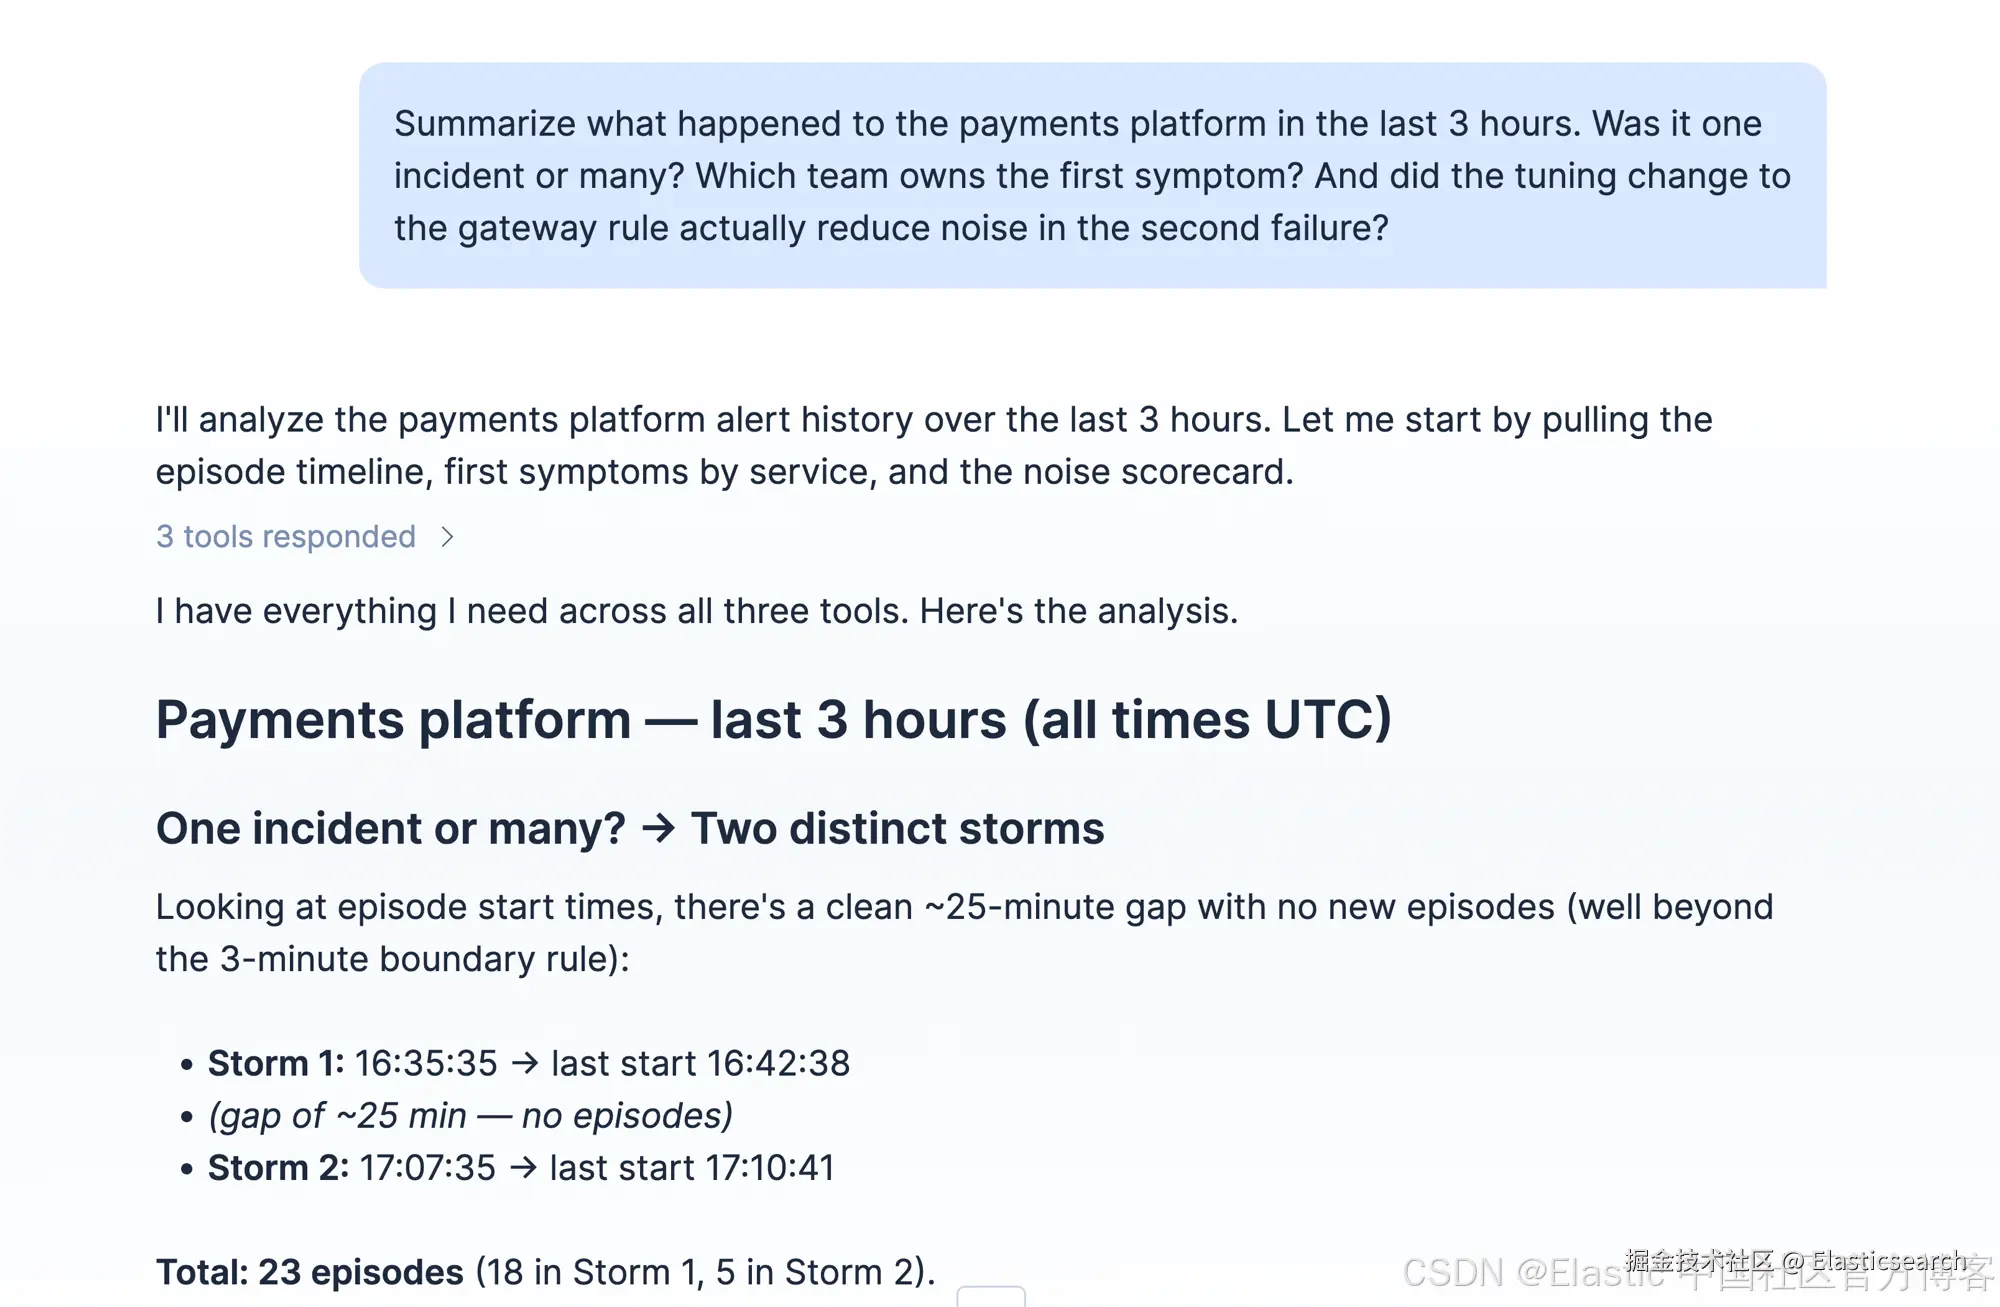
agent 调用了全部 3 个 tools,并正确理解了数据结构:它将 history 分成两个中间存在安静间隔的 storms,每个 storm 对应一轮故障,而不是将它们混合成一个 event。
它将第一个 symptom 归因于 risk-ml team,复现了关于从未产生 alert 的 queue 的上游推断,然后通过 revision table 回答了调优问题。
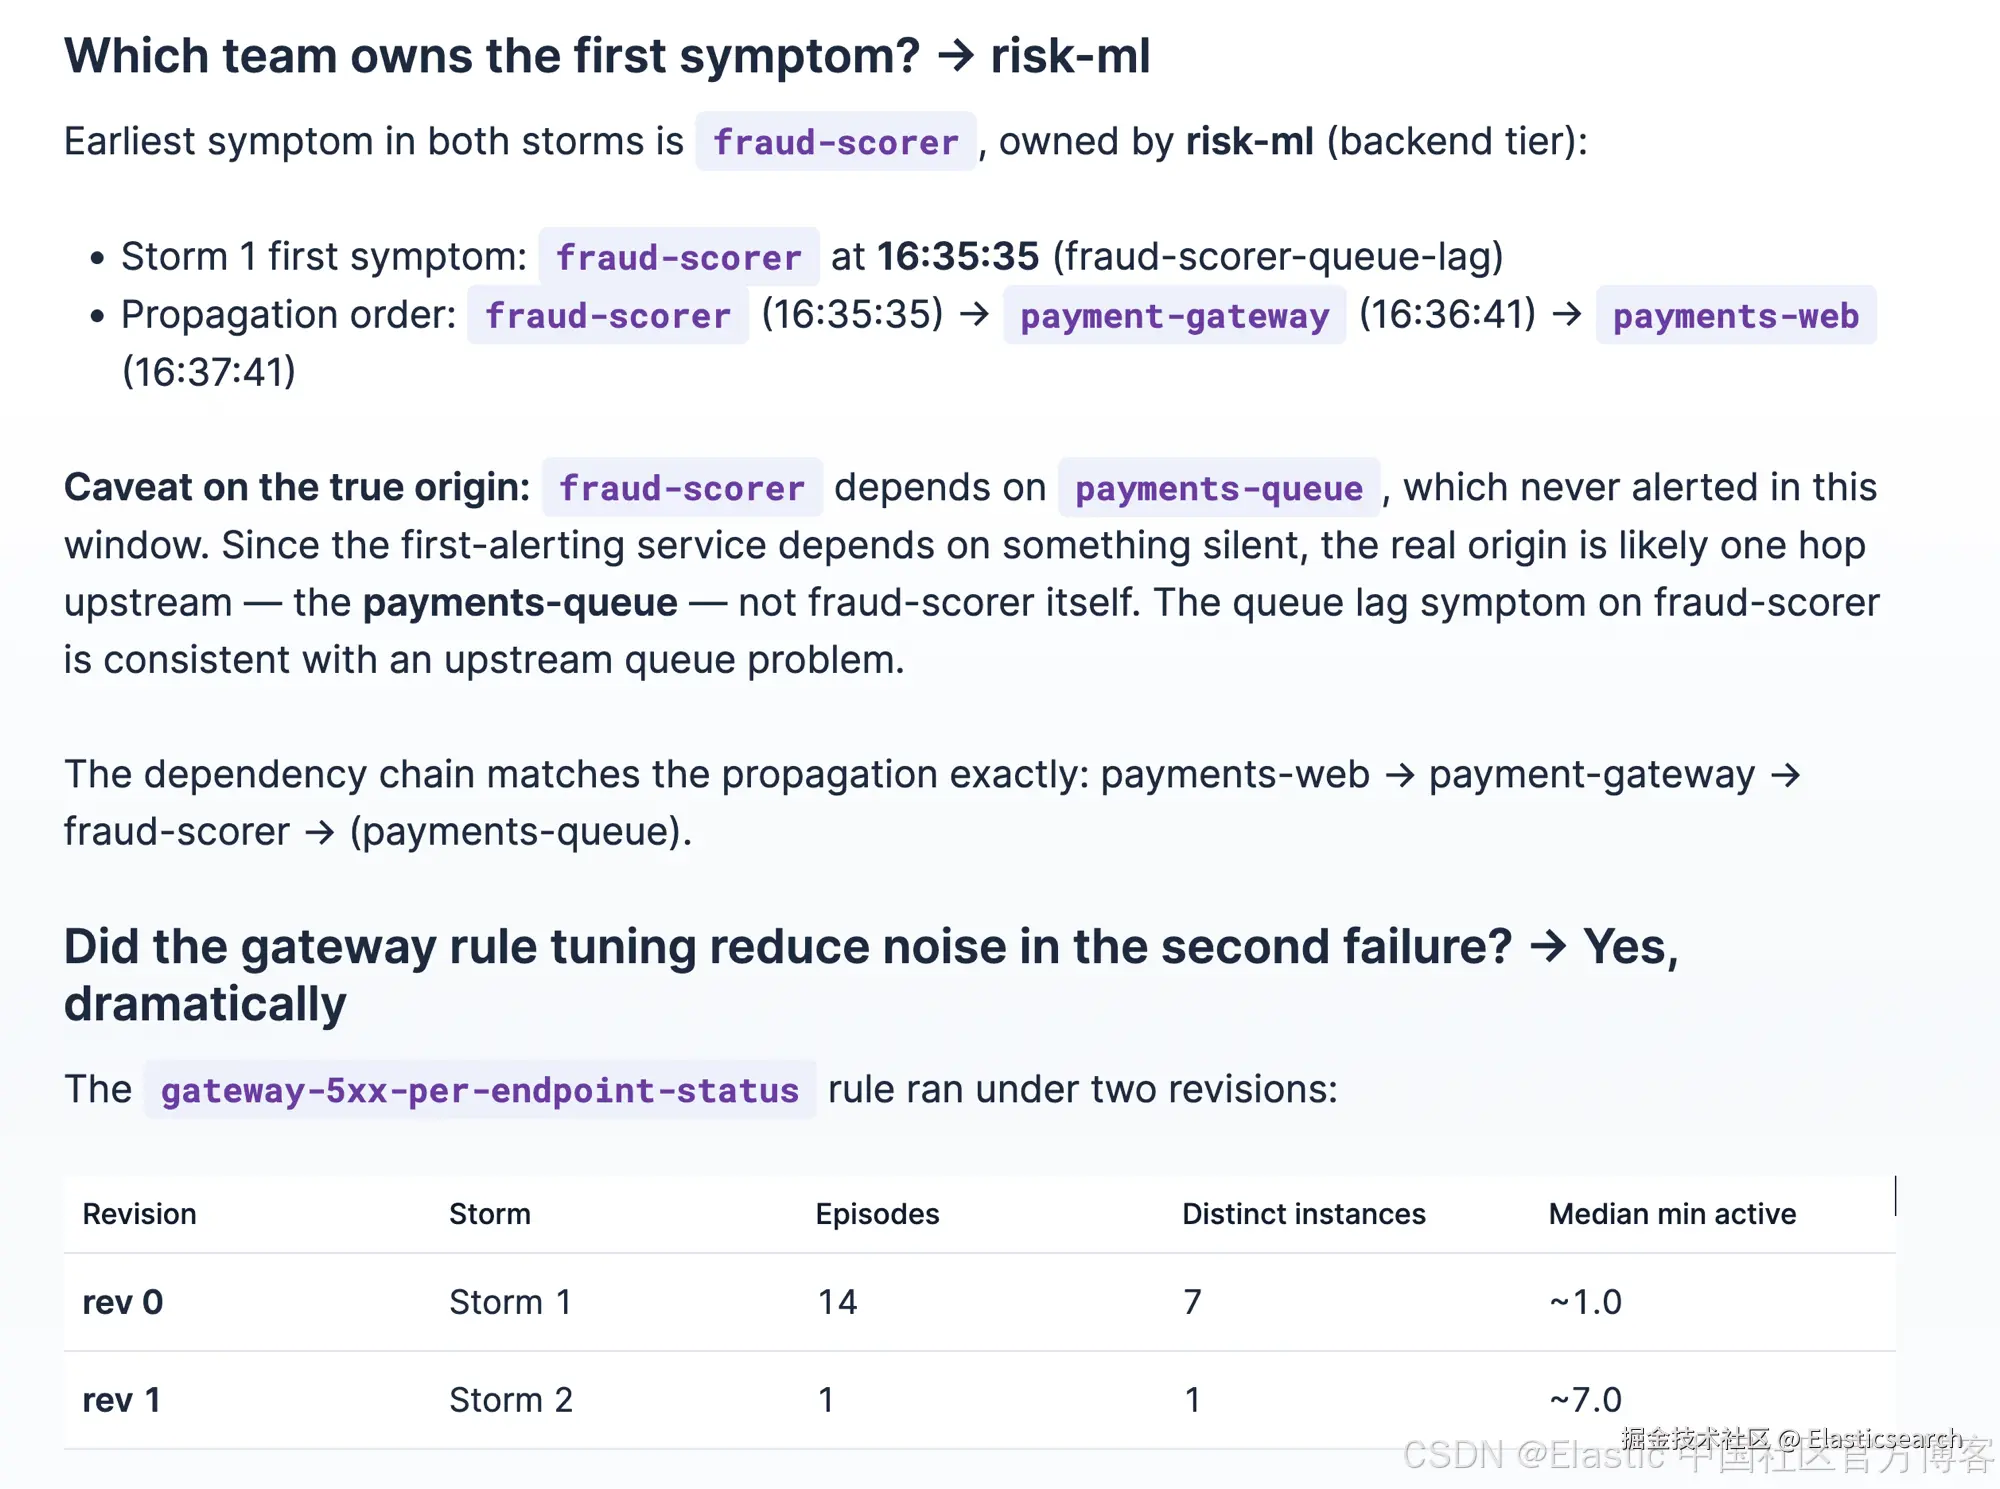
它对这次修复的结论读起来就像一条有数据支撑的 review comment:revision 0 有 14 个 episodes,而 revision 1 只有 1 个稳定的 episode,同时 episode 的中位持续时间从 1 分钟变成了 7 分钟。
agent 并没有做任何我们手动无法完成的事情。
这正是关键所在:由于 alerts 是具有明确语义的持久化结构化数据,language model 可以针对 patterns 和 histories 进行推理,而不是对单个 notification 做出反应,并且它陈述的每一个数字都可以追溯到一个可以重新运行的 tool call。
在生产环境中运行 alert history 查询
在生产环境中依赖 alert history 之前,需要考虑以下几点。
Retention 是一个学习窗口的决策
Alert indices 遵循 ILM policy,默认保留的数据远多于本实验所需的几个小时,但如果你希望分析不同季度之间的 rule quality trends,就应该有意识地让 policy 与这一目标保持一致。
严格限制 alert index 的读取权限范围
Alert documents 中包含 rule parameters、reasons 和 deep links,因此应像对待其他 operational datasets 一样对待.alerts-*的读取权限,并授予能够满足需求的最窄 index patterns,例如仅授予 observability alert aliases。
Grouping keys 是数据契约
在BY子句中,只要存在 ECS field names 就使用它们,保持 cardinality 有界,并且绝不要将 secrets 或 personal data 放入 grouping values,因为它们会成为kibana.alert.instance.id,并在 retention window 内持续存在。
使用KEEP积极投影 columns
Alert indices 中大约映射了 1,400 个 fields,因此不进行 projection 的 query 对人类来说很难处理,在 LLM tools 中则会造成实际危害,所以每个可复用的 query 都应该以KEEP结束。
Alert storms 也会给 automation 带来压力
如果一个 rule 每个 alert 都触发一次 workflow,那么 14 个 episodes 就意味着 14 次执行相同工作的 executions,这也是应该让 automation 面向聚合后的 alert dataset,而不是面向每个 notification 的另一个理由。
从你自己噪声最大的 rule 开始
本文中的实验是有意设计得很小,但其中每一个部分都可以推广。
使用 scorecard query 对你实际噪声最大的 rule 进行评估,修复它的 grouping 或 window,然后让kibana.alert.rule.revision告诉你这次修复是否保持有效。
将你的 alert history 与现有的任何 catalog 进行 join;lookup index 中的一份 CMDB export 就足够了,而 propagation order 就可以通过 query 得到。
如果你使用 Agent Builder,可以将最常用的两三个 investigation queries 封装成 tools,那么下一次 storm review 就可以从一次对话开始,而不是面对一整面 notification。
companion notebook构建了本文使用的全部内容:catalog index、log data stream、三个 rules、两次 incident replays、queries,以及 Agent Builder tools 和 agent。整个过程大约需要 25 分钟,因为 rules 每分钟评估一次,而 episode durations 就是我们要获取的数据。
Notification 会告诉你出了问题。
Alert history 会告诉你 detection 的表现如何,而它已经存在于一个 index 中,正等待被查询。