////////////////////////////////////////////////////////////
内存管理策略
Direct3D 12的内存管理器由于支持层级多样,包括UMA或离散(非UMA)适配器,以及GPU适配器间的架构差异,可能会很快变得非常复杂。
本节描述的Direct3D 12内存管理推荐策略是"分类、预算和流"。
资源类型
"已承诺资源"的基本概念(创建虚拟和物理地址空间,初始化于托管物理内存)自Direct3D 9以来就已存在,尽管虚拟寻址(VA)和物理寻址可以在Direct3D 12中逐步区分,以便应用程序仔细管理物理内存。
除了已承诺的资源外,Direct3D 12的堆构造还支持两种资源类型:"放置"和"保留"资源。在Direct3D 11中,"保留"资源被称为"磁贴资源"。
保留资源与放置资源的不同之处在于保留资源拥有各自独特的GPU虚拟地址空间。这允许前期分配大量 VA 空间,之后将 VA 页面映射到堆的某些部分,应用程序会实时重新配置该配置。VA空间是连续的,可以被稀疏映射到。
保留资源可以通过 API 调用如 UpdateTileMappings 来引用堆中的区域,并且通过实时更新页面表,应用可以将其设为常驻资源。当VA区间映射为NULL或非驻留堆时,该部分资源被视为非驻留堆。当VA范围映射到驻留堆时,该资源部分被视为驻留堆。堆在创建时即为常驻。
放置资源的设计要简单得多,它只是指向堆中某个区域的指针(例如,5Mb堆中纹理的1Mb区域)。别名屏障允许使用重叠的放置资源(参见 CreatePlacedResource 和 ResourceBarrier)。
保留资源并非所有Direct3D 12硬件都可用,放置资源是合理的备选方案,但放置资源必须是连续的,且不能部分驻留。
内存预算
在 Direct3D 12 中,当你分配一个堆时,你是在创建已提交资源的物理内存部分。Direct3D 12 提供了更明确的内存段选择(在视频内存和系统内存之间选择)。UMA适配器只有一个内存段,即系统内存。
GPU不支持页面错误,因此开发者必须注意不要过度承诺,尤其是对于只有1GB系统内存的系统。如果应用过度提交,操作系统会根据进程对物理内存的需求进行更粗粒度的调度。调度器会冻结前台进程,基本上将部分内容分页,以便分页进入想要运行的后台进程。可用的物理内存会根据用户在后台的操作(如运行浏览器或观看视频)而有很大差异。
内存预算的API是QueryVideoMemoryInfo。对于离散适配器,"本地"指视频内存,"非本地"指系统内存。对于UMA适配器来说,非本地值总是为零。设计上的问题是你的发动机是否能同时管理预算,还是仅仅本地预算。仅管理地方预算更简单,但有一些限制;例如,假设最大本地预算为1Gb,那么UMA系统中所有堆都将来自该1Gb,系统内存不会溢出(显然,因为根本没有溢出)。
由于Direct3D11管理应用程序内存,未使用的资源基本上会被分页出去。
选择最合适的资源维度。考虑资源大小是否适合应用程序实际运行的情境。有些用户可能在窗口中运行该应用,或屏幕分辨率为800x600。
分类策略
为了在内存受限场景中有效管理资源,请考虑将资源分类如下:
| 分类 | 示例 | 对象和API特性 | 管理笔记 |
|---|---|---|---|
| 批判 | 游戏界面 | 命令分配器、命令队列、查询堆、资源和资源堆。 | 这些元素应存储在不可分页/始终提交的内存中。 |
| 可调节/可选 | 关卡专用模型和贴图、交换链条、天空盒、第一人称玩家角色模型 | 资源和大量资源。投入资源,但部署和预留资源也可能同样有效。 | 将内存驻留预算整合进渲染算法中。选择合适的可用细节水平,每帧重新评估少于一次。技术包括使用可变规模资源和交换链扩展。 |
| 重复利用的资源 | 阴影缓冲区、延迟渲染资源、后期处理资源、光照数据缓存 | 资源和大量资源。重叠的资源堆叠并形成锯齿屏障。 | 在帧内重用大资源或堆区,以减少整个帧的需求。使用帧内存重用技术。在Direct3D 11中,应用程序只能重用同类型且尺寸可能足够大的资源。Direct3D 12堆允许资源重叠,实现更简单且更广泛的重用。 |
| 流媒体资源 | 地形、开放世界纹理与几何体 | 资源和大量资源。自由线程创建、后台 CPU 线程以及后台复制命令队列和列表。 | 部分驻留,通常基于可见度(使用视锥体或基于距离的评估),并每帧重新评估驻留需求。 当GPU适配器支持堆内的保留资源时,可以使用每瓦片部分驻留管理和帧间重用的技术。 利用帧间内存重用技术,可以实现部分子资源驻留,但效果不那么理想。与堆一起放置资源应能加快回收速度,但已投入资源也可以作为备选方案。 |
应用越多依赖流资源完成大部分工作,就越能利用已放置和保留资源,从而最大化这四类之间的内存再利用。应用流越多,他们就越会预算和优先考虑带宽。
通常Direct3D的12图形引擎需要尊重更多样化和动态的预算,并且比过去更严格。最佳应用会将这四类都纳入预算,将游戏玩法从后台移动应用扩展到全屏独立预算。但许多应用可能会因为一开始就拥有过多关键类别的资源而遇到困难。Direct3D 11使资源能够匿名创建并处于关键状态,而不影响性能。然而,对于Direct3D 12,开发者必须在引擎和中间件中认真搜索随机生成的资源,并将其重新分配到其他类别。
其他问题领域包括中间件组件、用户控制和帧内流式传输。中间件组件可能不受预算限制,也不必紧密协作。中间件组件可能将特征暴露为渲染技术;应用程序还可以依赖于暴露中间件和引擎设置。开发者可以依靠Direct3D 11来完成分页并获得合适的帧率。在某些情况下,Direct3D 11 应用可能每帧都对资源内容进行分页进出;这也带来了用户可接受的帧率。大多数引擎仅将资源数据作为后台活动流式流式传输,且没有优雅的缓冲方式支持高优先级的帧内流式传输。要求引擎实现这些功能,会削弱他们通过转向Direct3D 12所获得的CPU开销收益。引擎开发者可以考虑将框架分阶段进行预告,以增加可重用资源的机会;并且很可能与中间件厂商合作,支持已放置的资源和堆,以便帧内存重用。
////////////////////////////////////////////////////////////
缓冲区内的子分配
缓冲区具备D3D12中应用传输大量瞬态数据从CPU到GPU所需的所有功能。本节涵盖了资源及缓冲区的四种常见使用与管理情景。
与 D3D11 类似,D3D12 中的应用程序在分配缓冲区时仍需声明内存使用情况,而 D3D11 中的动态/临时资源则不同,但开发者对内存使用拥有更灵活和更严格的控制。缓冲区通过子分配,具备低层内存管理所需的所有功能。
上传不同类型的资源
展示了如何用一个缓冲区同时上传常量缓冲区数据和顶点缓冲区数据到GPU,以及如何正确地将数据子分配和放置在缓冲区内。使用单一缓冲区提高了内存使用灵活性,并为应用程序提供了更严格的内存使用控制。还展示了Direct3D 11和Direct3D 12模型在上传不同资源时的区别。
上传不同类型的资源
在Direct3D 12中,你创建一个缓冲区来上传不同类型的资源数据,同时以类似方式将资源数据复制到同一缓冲区以处理不同的资源数据。然后创建单独视图,将这些资源数据绑定到Direct3D 12资源绑定模型中的图形管道。
在 Direct3D 11 中,你为不同类型的资源数据创建独立缓冲区(注意下面 Direct3D 11 示例代码中使用的不同),显式将每个资源缓冲区绑定到图形管道,并根据不同资源类型用不同方法更新资源数据。BindFlags
在Direct3D 12和Direct3D 11中,你应该只使用上传资源,CPU写入一次数据,GPU读取一次。
在某些情况下,
- GPU会多次读取数据,或者
- GPU无法线性读取数据,或者
- 渲染本身就受GPU限制很大。
在这种情况下,更好的选择可能是使用 ID3D12GraphicsCommandList::CopyTextureRegion 或 ID3D12GraphicsCommandList::CopyBufferRegion 将上传缓冲区数据复制到默认资源。
默认资源可以存在于独立GPU的物理视频内存中。
代码示例:Direct3D 11
C++
inner-focus
<span style="background-color:#fafafa"><span style="color:#161616"><code><span style="color:green">// Direct3D 11: Separate buffers for each resource type.</span>

<span style="color:#0101fd">void</span> <span style="color:#006881">main</span>()
{
    <span style="color:green">// ...</span>

    <span style="color:green">// Create a constant buffer.</span>
    <span style="color:#0101fd">float</span> constantBufferData[] = ...;

    D3D11_BUFFER_DESC constantBufferDesc = {0};
    constantBufferDesc.ByteWidth = <span style="color:#0101fd">sizeof</span>(constantBufferData);
    constantBufferDesc.Usage = D3D11_USAGE_DYNAMIC;
    constantBufferDesc.BindFlags = D3D11_BIND_CONSTANT_BUFFER;
    constantBufferDesc.CPUAccessFlags = D3D11_CPU_ACCESS_WRITE;

    ComPtr<ID3D11Buffer> constantBuffer;
    d3dDevice->CreateBuffer(
        &constantBufferDesc,
        <span style="color:#07704a">NULL</span>,
        &constantBuffer
        );

    <span style="color:green">// Create a vertex buffer.</span>
    <span style="color:#0101fd">float</span> vertexBufferData[] = ...;

    D3D11_BUFFER_DESC vertexBufferDesc = { 0 };
    vertexBufferDesc.ByteWidth = <span style="color:#0101fd">sizeof</span>(vertexBufferData);
    vertexBufferDesc.Usage = D3D11_USAGE_DYNAMIC;
    vertexBufferDesc.BindFlags = D3D11_BIND_VERTEX_BUFFER;

    ComPtr<ID3D11Buffer> vertexBuffer;
    d3dDevice->CreateBuffer(
        &vertexBufferDesc,
        <span style="color:#07704a">NULL</span>,
        &vertexBuffer
        );

    <span style="color:green">// ...</span>
}

<span style="color:#0101fd">void</span> <span style="color:#006881">DrawFrame</span>()
{
    <span style="color:green">// ...</span>

    <span style="color:green">// Bind buffers to the graphics pipeline.</span>
    d3dDeviceContext->VSSetConstantBuffers(0, 1, constantBuffer.Get());
    d3dDeviceContext->IASetVertexBuffers(0, 1, vertexBuffer.Get(), ...);

    <span style="color:green">// Update the constant buffer.</span>
    D3D11_MAPPED_SUBRESOURCE mappedResource;
    d3dDeviceContext->Map(
        constantBuffer.Get(),
        0,
        D3D11_MAP_WRITE_DISCARD,
        0,
        &mappedResource
        );
    <span style="color:#0101fd">memcpy</span>(mappedResource.pData, constantBufferData,
        <span style="color:#0101fd">sizeof</span>(contatnBufferData));
    d3dDeviceContext->Unmap(constantBuffer.Get(), 0);

    <span style="color:green">// Update the vertex buffer.</span>
    d3dDeviceContext->UpdateSubresource(
        vertexBuffer.Get(),
        0,
        <span style="color:#07704a">NULL</span>,
        vertexBufferData,
        <span style="color:#0101fd">sizeof</span>(vertexBufferData),
        0
    );

    <span style="color:green">// ...</span>
}
</code></span></span>
代码示例:Direct3D 12
C++
inner-focus
<span style="background-color:#fafafa"><span style="color:#161616"><code><span style="color:green">// Direct3D 12: One buffer to accommodate different types of resources</span>

ComPtr<ID3D12Resource> m_spUploadBuffer;
UINT8* m_pDataBegin = <span style="color:#07704a">nullptr</span>;    <span style="color:green">// starting position of upload buffer</span>
UINT8* m_pDataCur = <span style="color:#07704a">nullptr</span>;      <span style="color:green">// current position of upload buffer</span>
UINT8* m_pDataEnd = <span style="color:#07704a">nullptr</span>;      <span style="color:green">// ending position of upload buffer</span>

<span style="color:#0101fd">void</span> <span style="color:#006881">main</span>()
{
    <span style="color:green">//</span>
    <span style="color:green">// Initialize an upload buffer</span>
    <span style="color:green">//</span>

    InitializeUploadBuffer(64 * 1024);

    <span style="color:green">// ...</span>
}

<span style="color:#0101fd">void</span> <span style="color:#006881">DrawFrame</span>()
{
    <span style="color:green">// ...</span>

    <span style="color:green">// Set vertices data to the upload buffer.</span>

    <span style="color:#0101fd">float</span> vertices[] = ...;
    UINT verticesOffset = 0;
    ThrowIfFailed(
        SetDataToUploadBuffer(
            vertices, <span style="color:#0101fd">sizeof</span>(<span style="color:#0101fd">float</span>), <span style="color:#0101fd">sizeof</span>(vertices) / <span style="color:#0101fd">sizeof</span>(<span style="color:#0101fd">float</span>),
            <span style="color:#0101fd">sizeof</span>(<span style="color:#0101fd">float</span>),
            verticesOffset
            ));

    <span style="color:green">// Set constant data to the upload buffer.</span>

    <span style="color:#0101fd">float</span> constants[] = ...;
    UINT constantsOffset = 0;
    ThrowIfFailed(
        SetDataToUploadBuffer(
            constants, <span style="color:#0101fd">sizeof</span>(<span style="color:#0101fd">float</span>), <span style="color:#0101fd">sizeof</span>(constants) / <span style="color:#0101fd">sizeof</span>(<span style="color:#0101fd">float</span>),
            D3D12_CONSTANT_BUFFER_DATA_PLACEMENT_ALIGNMENT,
            constantsOffset
            ));

    <span style="color:green">// Create vertex buffer views for the new binding model.</span>

    D3D12_VERTEX_BUFFER_VIEW vertexBufferViewDesc = {
        m_spUploadBuffer->GetGPUVirtualAddress() + verticesOffset,
        <span style="color:#0101fd">sizeof</span>(vertices), <span style="color:green">// size</span>
        <span style="color:#0101fd">sizeof</span>(<span style="color:#0101fd">float</span>) * 4,  <span style="color:green">// stride</span>
    };

    commandList->IASetVertexBuffers(
        0,
        1,
        &vertexBufferViewDesc,
        ));

    <span style="color:green">// Create constant buffer views for the new binding model.</span>

    D3D12_CONSTANT_BUFFER_VIEW_DESC constantBufferViewDesc = {
        m_spUploadBuffer->GetGPUVirtualAddress() + constantsOffset,
        <span style="color:#0101fd">sizeof</span>(constants) <span style="color:green">// size</span>
         };

    d3dDevice->CreateConstantBufferView(
        &constantBufferViewDesc,
        ...
        ));

    <span style="color:green">// Continue command list building and execution ...</span>
}

<span style="color:green">//</span>
<span style="color:green">// Create an upload buffer and keep it always mapped.</span>
<span style="color:green">//</span>

HRESULT <span style="color:#006881">InitializeUploadBuffer</span>(SIZE_T uSize)
{
    HRESULT hr = d3dDevice->CreateCommittedResource(
         &CD3DX12_HEAP_PROPERTIES( D3D12_HEAP_TYPE_UPLOAD ),
               D3D12_HEAP_FLAG_NONE,
               &CD3DX12_RESOURCE_DESC::Buffer( uSize ),
               D3D12_RESOURCE_STATE_GENERIC_READ, <span style="color:#07704a">nullptr</span>,
               IID_PPV_ARGS( &m_spUploadBuffer ) );

    <span style="color:#0101fd">if</span> (SUCCEEDED(hr))
    {
        <span style="color:#0101fd">void</span>* pData;
        <span style="color:green">//</span>
        <span style="color:green">// No CPU reads will be done from the resource.</span>
        <span style="color:green">//</span>
        CD3DX12_RANGE <span style="color:#006881">readRange</span>(0, 0);
        m_spUploadBuffer->Map( 0, &readRange, &pData );
        m_pDataCur = m_pDataBegin = <span style="color:#0101fd">reinterpret_cast</span>< UINT8* >( pData );
        m_pDataEnd = m_pDataBegin + uSize;
    }
    <span style="color:#0101fd">return</span> hr;
}

<span style="color:green">//</span>
<span style="color:green">// Sub-allocate from the buffer, with offset aligned.</span>
<span style="color:green">//</span>

HRESULT <span style="color:#006881">SuballocateFromBuffer</span>(SIZE_T uSize, UINT uAlign)
{
    m_pDataCur = <span style="color:#0101fd">reinterpret_cast</span>< UINT8* >(
        Align(<span style="color:#0101fd">reinterpret_cast</span>< SIZE_T >(m_pDataCur), uAlign)
        );

    <span style="color:#0101fd">return</span> (m_pDataCur + uSize > m_pDataEnd) ? E_INVALIDARG : S_OK;
}

<span style="color:green">//</span>
<span style="color:green">// Place and copy data to the upload buffer.</span>
<span style="color:green">//</span>

HRESULT <span style="color:#006881">SetDataToUploadBuffer</span>(
    <span style="color:#0101fd">const</span> <span style="color:#0101fd">void</span>* pData,
    UINT bytesPerData,
    UINT dataCount,
    UINT alignment,
    UINT& byteOffset
    )
{
    SIZE_T byteSize = bytesPerData * dataCount;
    HRESULT hr = SuballocateFromBuffer(byteSize, alignment);
    <span style="color:#0101fd">if</span> (SUCCEEDED(hr))
    {
        byteOffset = UINT(m_pDataCur - m_pDataBegin);
        <span style="color:#0101fd">memcpy</span>(m_pDataCur, pData, byteSize);
        m_pDataCur += byteSize;
    }
    <span style="color:#0101fd">return</span> hr;
}

<span style="color:green">//</span>
<span style="color:green">// Align uLocation to the next multiple of uAlign.</span>
<span style="color:green">//</span>

UINT <span style="color:#006881">Align</span>(UINT uLocation, UINT uAlign)
{
    <span style="color:#0101fd">if</span> ( (0 == uAlign) || (uAlign & (uAlign-1)) )
    {
        ThrowException(<span style="color:#a31515">"non-pow2 alignment"</span>);
    }

    <span style="color:#0101fd">return</span> ( (uLocation + (uAlign-1)) & ~(uAlign-1) );
}
</code></span></span>
Note the use of the helper structures CD3DX12_HEAP_PROPERTIES and CD3DX12_RESOURCE_DESC.
Constants
To set constants, vertices, and indexes within an upload or readback heap, use the following APIs.
- ID3D12Device::CreateConstantBufferView
- ID3D12GraphicsCommandList::IASetVertexBuffers
- ID3D12GraphicsCommandList::IASetIndexBuffer
Resources
资源是Direct3D中抽象GPU物理内存使用的概念。资源需要GPU虚拟地址空间来访问物理内存。资源创建是自由线程的。
Direct3D 12 中关于虚拟地址创建和灵活性的资源有三种类型。
承诺资源
承诺资源是Direct3D资源中历代最常见的概念。创建此类资源分配虚拟地址范围,即一个足够大的隐式堆,以容纳整个资源,并将虚拟地址范围提交到堆封装的物理内存。必须传递隐式堆属性以匹配与之前 Direct3D 版本的功能奇偶性。参考 ID3D12Device::CreateCommittedResource。
保留资源
保留资源相当于 Direct3D 的 11 块资源。创建时,只分配一个虚拟地址区间,且不映射到任何堆。应用程序会在之后将这些资源映射到堆。这些资源的能力目前与 Direct3D 11 保持一致,因为它们可以通过 UpdateTileMappings 映射到 64KB 瓦片粒度的堆。请参考ID3D12Device::CreateReservedResource。
资源配置
Direct3D 12 新增了可以创建与资源分开的堆。之后,你可以在同一堆中找到多个资源。你可以在不创建磁贴或预留资源的情况下实现这一点,从而使所有资源类型的功能都能由你的应用程序直接创建。多个资源可能重叠,您必须使用 ID3D12GraphicsCommandList::ResourceBarrier 才能正确重用物理内存。参考 ID3D12Device::CreatePlacedResource。
资源规模反射
你必须利用资源大小反射来理解带有未知纹理布局的纹理堆需要多少空间。缓冲区也被支持,但主要是方便使用。
你应该注意主要的阵营差异,以便更密集地打包资源。
例如,一个单元素数组的一字节缓冲区返回大小为 64KB,对齐为64KB,因为缓冲区只能进行64KB对齐。
此外,一个包含两个单像素64KB对齐纹理和一个单纹素4MB对齐纹理的三元素数组,会根据数组的顺序报告不同的大小。如果4MB对齐的纹理在中间,那么最终的大小是12MB。否则,最终的大小为8MB。返回的对齐总是4MB,即资源数组中所有对齐的超集。
请参考以下API。
缓冲区对齐
缓冲区对齐限制自 Direct3D 11 以来未变,值得注意的是:
- 多采样纹理需要4MB。
- 单采样纹理和缓冲区则有64 KB。
通过缓冲区上传纹理数据
上传二维或三维纹理数据与上传一维数据类似,但应用程序需要更关注与行间距相关的数据对齐。缓冲区可以正交且同时从图形管线的多个部分使用,且非常灵活。
通过缓冲区上传纹理数据
应用程序必须通过ID3D12GraphicsCommandList::CopyTextureRegion或ID3D12GraphicsCommandList::CopyBufferRegion上传数据。纹理数据更可能体积更大,需要反复访问,并且比其他资源数据更能受益于非线性内存布局的缓存一致性。当缓冲区在D3D12中使用时,应用程序可以完全控制与资源数据复制相关的数据放置和排列,只要满足内存对齐要求。
样本突出显示了应用程序在放置缓冲区前将二维数据扁平为一维的过程。对于mipmap二维场景,应用可以选择使用一维子分配算法,快速离散地将每个子资源展开平整,或者采用更复杂的二维子分配技术以最小化视频内存使用。第一种技术因更简单,预计会被更频繁地使用。第二种技术在将数据打包到磁盘或跨网络时可能有用。无论哪种情况,应用程序仍需调用每个子资源的复制API。
C++
inner-focus
<span style="background-color:#fafafa"><span style="color:#161616"><code><span style="color:green">// Prepare a pBitmap in memory, with bitmapWidth, bitmapHeight, and pixel format of DXGI_FORMAT_B8G8R8A8_UNORM. </span>
<span style="color:green">//</span>
<span style="color:green">// Sub-allocate from the buffer for texture data.</span>
<span style="color:green">//</span>

D3D12_SUBRESOURCE_FOOTPRINT pitchedDesc = { 0 };
pitchedDesc.Format = DXGI_FORMAT_B8G8R8A8_UNORM;
pitchedDesc.Width = bitmapWidth;
pitchedDesc.Height = bitmapHeight;
pitchedDesc.Depth = 1;
pitchedDesc.RowPitch = Align(bitmapWidth * <span style="color:#0101fd">sizeof</span>(DWORD), D3D12_TEXTURE_DATA_PITCH_ALIGNMENT);

<span style="color:green">//</span>
<span style="color:green">// Note that the helper function UpdateSubresource in D3DX12.h, and ID3D12Device::GetCopyableFootprints </span>
<span style="color:green">// can help applications fill out D3D12_SUBRESOURCE_FOOTPRINT and D3D12_PLACED_SUBRESOURCE_FOOTPRINT structures.</span>
<span style="color:green">//</span>
<span style="color:green">// Refer to the D3D12 Code example for the previous section "Uploading Different Types of Resources"</span>
<span style="color:green">// for the code for SuballocateFromBuffer.</span>
<span style="color:green">//</span>

SuballocateFromBuffer(
    pitchedDesc.Height * pitchedDesc.RowPitch,
    D3D12_TEXTURE_DATA_PLACEMENT_ALIGNMENT
    );

D3D12_PLACED_SUBRESOURCE_FOOTPRINT placedTexture2D = { 0 };
placedTexture2D.Offset = m_pDataCur -- m_pDataBegin;
placedTexture2D.Footprint = pitchedDesc;

<span style="color:green">//</span>
<span style="color:green">// Copy texture data from DWORD* pBitmap->pixels to the buffer</span>
<span style="color:green">//</span>

<span style="color:#0101fd">for</span> (UINT y = 0; y < bitmapHeight; y++)
{
  UINT8 *pScan = m_pDataBegin + placedTexture2D.Offset + y * pitchedDesc.RowPitch;
  <span style="color:#0101fd">memcpy</span>( pScan, &(pBitmap->pixels[y * bitmapWidth]), <span style="color:#0101fd">sizeof</span>(DWORD) * bitmapWidth );
}

<span style="color:green">//</span>
<span style="color:green">// Create default texture2D resource.</span>
<span style="color:green">//</span>

D3D12_RESOURCE_DESC  textureDesc { ... };

CComPtr<ID3D12Resource> texture2D;
d3dDevice->CreateCommittedResource(
        &CD3DX12_HEAP_PROPERTIES(D3D12_HEAP_TYPE_DEFAULT),
        D3D12_HEAP_FLAG_NONE, &textureDesc,
        D3D12_RESOURCE_STATE_COPY_DEST,
        <span style="color:#07704a">nullptr</span>,
        IID_PPV_ARGS(&texture2D) );

<span style="color:green">//</span>
<span style="color:green">// Copy heap data to texture2D.</span>
<span style="color:green">//</span>

commandList->CopyTextureRegion(
        &CD3DX12_TEXTURE_COPY_LOCATION( texture2D, 0 ),
        0, 0, 0,
        &CD3DX12_TEXTURE_COPY_LOCATION( m_spUploadHeap, placedTexture2D ),
        <span style="color:#07704a">nullptr</span> );
</code></span></span>
注意辅助结构 CD3DX12_HEAP_PROPERTIES 和 CD3DX12_TEXTURE_COPY_LOCATION,以及 CreateCommittedResource 和 CopyTextureRegion 这两个方法的使用。
复制
D3D12 methods enable applications to replace D3D11 UpdateSubresource, CopySubresourceRegion, and resource initial data. A single 3D subresource worth of row-major texture data may be located in buffer resources. CopyTextureRegion can copy that texture data from the buffer to a texture resource with an unknown texture layout, and vice versa. Applications should prefer this type of technique to populate frequently accessed GPU resources, by creating large buffers in an UPLOAD heap while creating the frequently accessed GPU resources in a DEFAULT heap that has no CPU access. Such a technique efficiently supports discrete GPUs and their large amounts of CPU-inaccessible memory, without commonly impairing UMA architectures.
Note the following two constants:
C++
inner-focus
<span style="background-color:#fafafa"><span style="color:#161616"><code><span style="color:#0101fd">const</span> UINT D3D12_TEXTURE_DATA_PITCH_ALIGNMENT = 256;
<span style="color:#0101fd">const</span> UINT D3D12_TEXTURE_DATA_PLACEMENT_ALIGNMENT = 512;
</code></span></span>每个子资源的行间距必须对齐到D3D12_TEXTURE_DATA_PITCH_ALIGNMENT的倍数(256),每个子资源的起始偏移量必须对齐到D3D12_TEXTURE_DATA_PLACEMENT_ALIGNMENT的倍数(512),除非D3D12_FEATURE_DATA_D3D12_OPTIONS13:::UnrestrictedBufferTextureCopyPitchSupported为真。
当行间距小于D3D12_TEXTURE_DATA_PITCH_ALIGNMENT(256),这通常是纹理最小的mips时,子资源偏移对齐(D3D12_TEXTURE_DATA_PLACEMENT_ALIGNMENT 512)很可能会在子资源之间增加额外的填充,超过通过对齐行间距添加的填充。
- D3D12_SUBRESOURCE_FOOTPRINT
- D3D12_PLACED_SUBRESOURCE_FOOTPRINT
- D3D12_TEXTURE_COPY_LOCATION
- D3D12_TEXTURE_COPY_TYPE
- ID3D12Device::GetCopyableFootprints
- ID3D12GraphicsCommandList::CopyResource
- ID3D12GraphicsCommandList::CopyTextureRegion
- ID3D12GraphicsCommandList::CopyBufferRegion
- ID3D12GraphicsCommandList::CopyTiles
- ID3D12CommandQueue::UpdateTileMappings
映射与解映射
Map 和 Unmap 可以被多个线程安全地调用。第一次调用Map 时,为该资源分配了一个CPU虚拟地址范围。最后一次调用Unmap会释放CPU虚拟地址范围。CPU 虚拟地址通常会返回给应用程序。
每当CPU和GPU之间通过资源在读回堆中传递数据时,必须使用Map和Unmap来支持所有支持D3D12的系统。保持距离尽可能紧凑,可以最大化需要距离系统的效率(参见 D3D12_RANGE)。
调试工具的性能不仅受益于所有Map/Unmap调用中准确使用范围,还得益于应用程序在CPU不再修改时解映射资源。
D3D11 中使用 Map(设置 DISCARD 参数)重命名资源的方法在 D3D12 中不被支持。应用程序必须自行实现资源重命名。所有 Map 调用都是隐式NO_OVERWRITE且多线程的。应用程序有责任确保命令列表中包含的任何相关GPU工作在CPU访问数据之前完成。D3D12 对 Map 的调用不会隐式刷新任何命令缓冲区,也不会阻止等待 GPU 完成工作。因此,在某些情况下,Map 和Unmap甚至可能被优化。
缓冲区对齐
缓冲区对齐限制:
- 线性子资源复制必须对齐到D3D12_TEXTURE_DATA_PLACEMENT_ALIGNMENT(512)字节(行音高对齐到D3D12_TEXTURE_DATA_PITCH_ALIGNMENT(256)字节)。
- 常量数据读取必须是堆起始256字节的倍数(即仅限256字节对齐的地址)。
- 索引数据读取必须是索引数据类型大小的整数倍(即仅读取来自自然对齐数据的地址)。
- ID3D12GraphicsCommandList::ExecuteIndirect 数据必须来自偏移量为 4 的倍数(即仅来自与 DWORD 对齐的地址)。
通过缓冲区读取数据
要从GPU读取数据(例如截屏),你会使用readback heap。这种技术与通过缓冲区上传纹理数据有关,但有一些区别。
- 要读取数据,你需要创建一个堆,D3D12_HEAP_TYPE 设置为D3D12_HEAP_TYPE_READBACK,而不是D3D12_HEAP_TYPE_UPLOAD。
- 回读堆上的资源必须始终是D3D12_RESOURCE_DIMENSION_BUFFER。
- 你用围栏来检测GPU是否完成了帧处理(即数据写入输出缓冲区)。这很重要,因为ID3D12Resource::Map方法不会与GPU同步(相反,Direct3D 11的对应方法会 同步)。Direct3D 12 映射调用的行为就像你用 NO_OVERWRITE 标志调用了 Direct3D 11 的等效代码。
- 数据准备好(包括任何必要的资源屏障)后,调用 ID3D12Resource::Map,使回读数据对 CPU 可见。
代码示例
下面的代码示例展示了通过缓冲区从GPU读取数据到CPU的大致流程。
C++/WinRT
inner-focus
<span style="background-color:#fafafa"><span style="color:#161616"><code>
<span style="color:green">// The output buffer (created below) is on a default heap, so only the GPU can access it.</span>

D3D12_HEAP_PROPERTIES defaultHeapProperties{ CD3DX12_HEAP_PROPERTIES(D3D12_HEAP_TYPE_DEFAULT) };
D3D12_RESOURCE_DESC outputBufferDesc{ CD3DX12_RESOURCE_DESC::Buffer(outputBufferSize, D3D12_RESOURCE_FLAG_ALLOW_UNORDERED_ACCESS) };
winrt::com_ptr<::ID3D12Resource> outputBuffer;
winrt::check_hresult(d3d12Device->CreateCommittedResource(
    &defaultHeapProperties,
    D3D12_HEAP_FLAG_NONE,
    &outputBufferDesc,
    D3D12_RESOURCE_STATE_COPY_DEST,
    <span style="color:#07704a">nullptr</span>,
    __uuidof(outputBuffer),
    outputBuffer.put_void()));

<span style="color:green">// The readback buffer (created below) is on a readback heap, so that the CPU can access it.</span>

D3D12_HEAP_PROPERTIES readbackHeapProperties{ CD3DX12_HEAP_PROPERTIES(D3D12_HEAP_TYPE_READBACK) };
D3D12_RESOURCE_DESC readbackBufferDesc{ CD3DX12_RESOURCE_DESC::Buffer(outputBufferSize) };
winrt::com_ptr<::ID3D12Resource> readbackBuffer;
winrt::check_hresult(d3d12Device->CreateCommittedResource(
    &readbackHeapProperties,
    D3D12_HEAP_FLAG_NONE,
    &readbackBufferDesc,
    D3D12_RESOURCE_STATE_COPY_DEST,
    <span style="color:#07704a">nullptr</span>,
    __uuidof(readbackBuffer),
    readbackBuffer.put_void()));

{
    D3D12_RESOURCE_BARRIER outputBufferResourceBarrier
    {
        CD3DX12_RESOURCE_BARRIER::Transition(
            outputBuffer.get(),
            D3D12_RESOURCE_STATE_COPY_DEST,
            D3D12_RESOURCE_STATE_COPY_SOURCE)
    };
    commandList->ResourceBarrier(1, &outputBufferResourceBarrier);
}

commandList->CopyResource(readbackBuffer.get(), outputBuffer.get());

<span style="color:green">// Code goes here to close, execute (and optionally reset) the command list, and also</span>
<span style="color:green">// to use a fence to wait for the command queue.</span>

<span style="color:green">// The code below assumes that the GPU wrote FLOATs to the buffer.</span>

D3D12_RANGE readbackBufferRange{ 0, outputBufferSize };
FLOAT * pReadbackBufferData{};
winrt::check_hresult(
    readbackBuffer->Map
    (
        0,
        &readbackBufferRange,
        <span style="color:#0101fd">reinterpret_cast</span><<span style="color:#0101fd">void</span>**>(&pReadbackBufferData)
    )
);

<span style="color:green">// Code goes here to access the data via pReadbackBufferData.</span>

D3D12_RANGE emptyRange{ 0, 0 };
readbackBuffer->Unmap
(
    0,
    &emptyRange
);
</code></span></span>关于读取渲染目标纹理并将其写入磁盘文件的完整截图程序,请参见DX12 的ScreenGrab工具包。
基于围栏的资源管理
展示了如何通过围栏跟踪GPU进度来管理资源数据寿命。内存可以通过严格管理内存中空闲空间的隔离措施进行有效重复利用,例如上传堆的环形缓冲实现。
环缓冲场景
以下是一个应用程序出现罕见上传堆内存需求的例子。
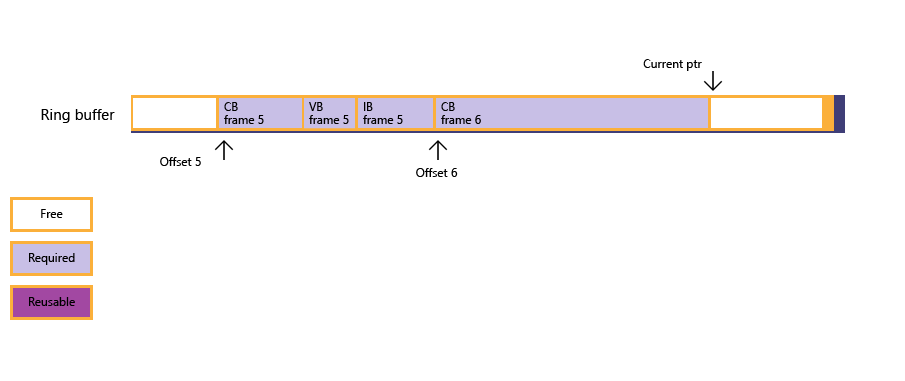
环形缓冲区是管理上传堆的一种方式。环形缓冲区保存接下来几帧所需的数据。应用维护当前的数据输入指针和帧偏移队列,用于记录该帧的每个帧及起始资源偏移量数据。
应用程序基于缓冲区创建一个环形缓冲区,用于为每一帧上传数据到GPU。目前第2帧已经渲染完毕,环形缓冲区环绕着第4帧的数据,第5帧所需的所有数据都已具备,并且第6帧所需的大型常量缓冲区需要被子分配。
图1:应用尝试为常量缓冲区子分配,但发现剩余内存不足。
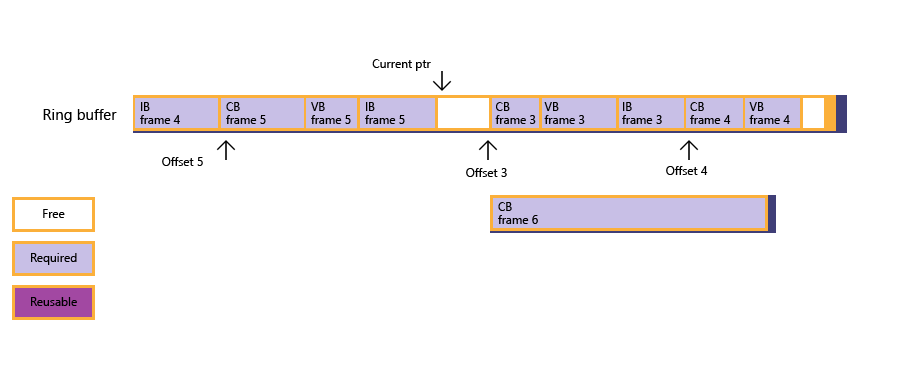
图2:通过围栏轮询,应用发现第3帧已被渲染,随后更新帧偏移队列,环形缓冲区当前状态随之而来------但可用内存仍不足以容纳常量缓冲区。
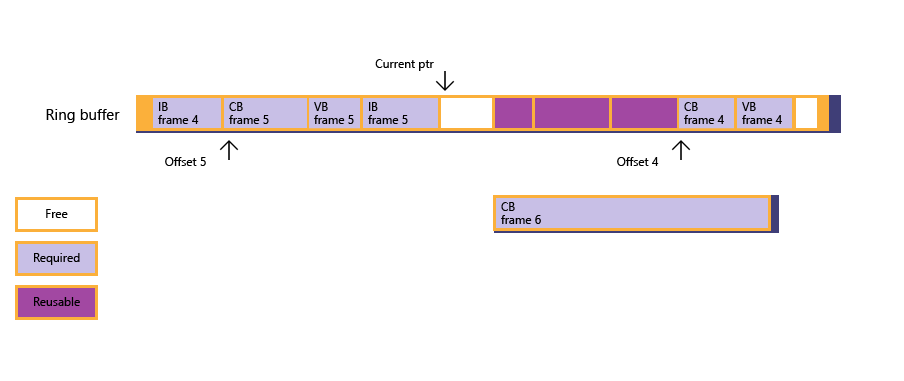
图3:在这种情况下,CPU会通过围栏等待来阻挡自己,直到第4帧渲染完毕,这释放了分配给第4帧的内存子区域。
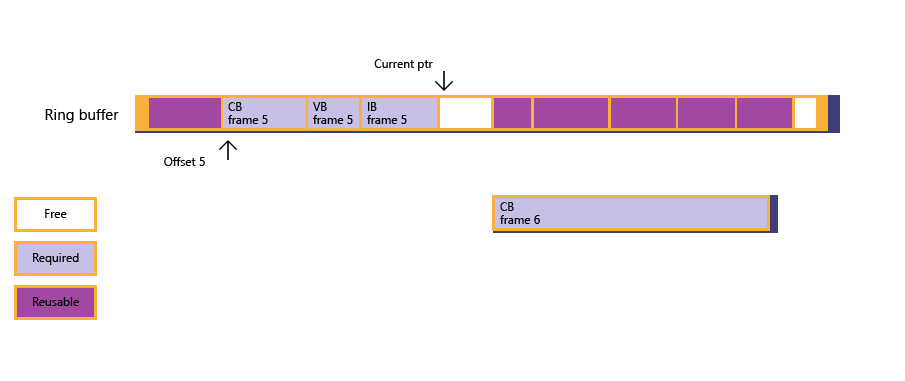
图4:此时空闲内存足够大以容纳常缓冲区,子分配成功;应用将大常量缓冲区数据复制到资源数据之前用于帧3和4的内存中。当前输入指针终于更新了。
如果应用实现了环形缓冲区,环形缓冲区必须足够大,以应对资源数据大小的最坏情况。
环形缓冲样品
以下示例代码展示了如何管理环形缓冲区,关注处理围栏轮询和等待的子分配程序。为了简化,示例使用NOT_SUFFICIENT_MEMORY来隐藏"堆中空闲内存不足"的细节,因为该逻辑(基于FrameOffsetQueue 中的m_pDataCur和偏移)与堆或围栏关系不紧密。样本简化为牺牲帧率而非内存使用率。
请注意,环形缓冲支持预计将成为一种流行的场景;然而,堆的设计并不排除其他用途,如命令列表参数化和重用。
语法
inner-focus
<span style="background-color:#fafafa"><span style="color:#161616"><code>struct FrameResourceOffset
{
    UINT frameIndex;
    UINT8* pResourceOffset;
};
std::queue<FrameResourceOffset> frameOffsetQueue;

void DrawFrame()
{
    float vertices[] = ...;
    UINT verticesOffset = 0;
    ThrowIfFailed(
        SetDataToUploadHeap(
            vertices, sizeof(float), sizeof(vertices) / sizeof(float),
            4, // Max alignment requirement for vertex data is 4 bytes.
            verticesOffset
            ));

    float constants[] = ...;
    UINT constantsOffset = 0;
    ThrowIfFailed(
        SetDataToUploadHeap(
            constants, sizeof(float), sizeof(constants) / sizeof(float),
            D3D12_CONSTANT_BUFFER_DATA_PLACEMENT_ALIGNMENT,
            constantsOffset
            ));

    // Create vertex buffer views for the new binding model.
    // Create constant buffer views for the new binding model.
    // ...

    commandQueue->Execute(commandList);
    commandQueue->AdvanceFence();
}

HRESULT SuballocateFromHeap(SIZE_T uSize, UINT uAlign)
{
    if (NOT_SUFFICIENT_MEMORY(uSize, uAlign))
    {
        // Free up resources for frames processed by GPU; see Figure 2.
        UINT lastCompletedFrame = commandQueue->GetLastCompletedFence();
        FreeUpMemoryUntilFrame( lastCompletedFrame );

        while ( NOT_SUFFICIENT_MEMORY(uSize, uAlign)
            && !frameOffsetQueue.empty() )
        {
            // Block until a new frame is processed by GPU, then free up more memory; see Figure 3.
            UINT nextGPUFrame = frameOffsetQueue.front().frameIndex;
            commandQueue->SetEventOnFenceCompletion(nextGPUFrame, hEvent);
            WaitForSingleObject(hEvent, INFINITE);
            FreeUpMemoryUntilFrame( nextGPUFrame );
        }
    }

    if (NOT_SUFFICIENT_MEMORY(uSize, uAlign))
    {
        // Apps need to create a new Heap that is large enough for this resource.
        return E_HEAPNOTLARGEENOUGH;
    }
    else
    {
        // Update current data pointer for the new resource.
        m_pDataCur = reinterpret_cast<UINT8*>(
            Align(reinterpret_cast<SIZE_T>(m_pHDataCur), uAlign)
            );

        // Update frame offset queue if this is the first resource for a new frame; see Figure 4.
        UINT currentFrame = commandQueue->GetCurrentFence();
        if ( frameOffsetQueue.empty()
            || frameOffsetQueue.back().frameIndex < currentFrame )
        {
            FrameResourceOffset offset = {currentFrame, m_pDataCur};
            frameOffsetQueue.push(offset);
        }

        return S_OK;
    }
}

void FreeUpMemoryUntilFrame(UINT lastCompletedFrame)
{
    while ( !frameOffsetQueue.empty()
        && frameOffsetQueue.first().frameIndex <= lastCompletedFrame )
    {
        frameOffsetQueue.pop();
    }
}</code></span></span>
堆内的子分配
资源堆是从CPU传输数据到GPU(上传),再从GPU传输到CPU(读取回传)。
内存混叠与数据继承
放置和保留资源可能会在堆中与物理内存混称。当堆设置了共享标志或别名资源拥有完全定义的内存布局时,放置资源比保留资源更多的数据继承场景。
混叠
必须在共享同一物理内存的两个资源之间设置别名屏障,即使不希望数据继承。简单的使用模型至少必须表示该操作所涉及的目标资源。更多详情和高级使用模型请参见 CreatePlacedResource。
资源被访问后,任何与该资源共享物理内存的资源都会被废止,除非允许数据继承。对失效资源的读取会导致资源内容未定义。对无效资源的写入也会导致资源内容未定义,除非发生以下两种情况:
- 该资源既没有 D3D12_RESOURCE_FLAG_ALLOW_RENDER_TARGET,也没有 D3D12_RESOURCE_FLAG_ALLOW_DEPTH_STENCIL。
- 写入是对整个子资源或瓦片的复制或清除操作。瓦片初始化仅适用于拥有64KB_TILE_UNDEFINED_SWIZZLE和64KB_TILE_STANDARD_SWIZZLE的资源。
当布局提供了关于纹素数据位置的信息以及资源处于某些过渡屏障状态时,重叠失效的范围会被限制在更小的粒度范围内。但失效的范围不能小于资源对齐的粒度。
缓冲区比对粒度为64KB,较大的比对粒度优先。这在考虑4KB纹理时非常重要,因为多个4KB纹理可以存在于一个64KB区域内而不重叠。但对同一64KB区域进行缓冲区锯齿,不能与任何4KB纹理一起使用。应用程序无法可靠地阻止缓冲区访问与4KB纹理相交,因为GPU允许在64KB区域内以未定义的模式横扫4KB纹理数据。
64KB_TILE_UNDEFINED_SWIZZLE、64KB_TILE_STANDARD_SWIZZLE和ROW_MAJOR纹理布局会告知应用哪些重叠的对齐粒度已失效。例如:应用程序可以创建一个包含2个数组切片、单个MIP级别和64KB_TILE_UNDEFINED_SWIZZLE布局的2D渲染目标纹理数组。假设应用程序理解每个数组切片占用100个64KB的瓦片。应用程序可以放弃使用数组切片0,而是将该内存用于~6MB缓冲区、~6MB且布局未定义的纹理等。进一步假设应用程序不再需要数组切片1的第一块。然后,应用程序还可以在那里找到一个64KB的缓冲区,直到渲染时再次需要数组切片1的第一个瓦片。应用程序必须完成完整的瓦片清除或复制,才能再次使用带有纹理数组的第一个瓦片。
然而,即使是具有明确布局的纹理,仍然存在一些问题。纹理资源大小可能与应用程序自身计算的大小有显著差异,因为某些适配器架构会为纹理分配额外内存,以降低常见渲染场景下的有效带宽。任何对该额外内存区域的失效会导致整个资源失效。详情请参见GetResourceAllocationInfo。
数据继承
放置资源能够实现纹理最多的数据继承,即使内存布局未定义。应用程序可以通过在共享堆中将两个具有相同资源属性的纹理定位在同一偏移量,来模拟共享提交资源所实现的数据继承能力。整个资源描述必须完全相同,包括优化的净值和资源创建方法类型(放置或保留)。但这两种资源可能在初期的过渡屏障状态不同。
保留资源支持每块数据继承;但资源转移障碍状态通常存在限制。
要继承数据,两个资源必须处于兼容的资源转移障碍状态:
- 对于缓冲区、同时访问纹理和跨适配器纹理,资源转换状态并不重要,所有状态都是"兼容"的。
- 对于没有前述属性或其他通过64KB_TILE_UNDEFINED_SWIZZLE或 64KB_TILE_STANDARD_SWIZZLE 继承的保留纹理,资源转移障碍状态(包括图块)必须处于公共状态。
- 对于所有其他纹理,当资源描述完全匹配时,每对对应子资源的资源转移障碍状态必须:
- 住在公共州。
- 当州内有相同的GPU写入标志时,则保持平等。
当GPU支持标准滑动时,缓冲区和标准滑动纹理可以被锯齿化到同一内存,并在它们之间继承数据。该应用程序可以从缓冲区表示中操作像素,因为标准的旋转图案描述了像素在内存中的布局方式。CPU可见的滑动模式等同于缓冲区中GPU可见的滑动模式。
共享堆
共享对于多进程和多适配器架构非常有用。
分享概述
共享堆实现了两件事:一是在一个或多个进程中共享堆中的数据,二是避免了堆中资源非确定性地选择未定义的纹理布局。跨适配器共享堆也消除了CPU对数据编组的需求。
堆积和投入资源都可以共享。共享已提交资源实际上会共享隐式堆和已提交的资源描述,因此可以从其他设备映射兼容的资源描述到该堆。
所有方法均为自由线程,继承了NT句柄共享设计中现有的D3D11语义。
- ID3D12Device::CreateSharedHandle
- ID3D12Device::OpenSharedHandle
- ID3D12Device::OpenSharedHandleByName
跨进程共享堆
共享堆与D3D12_HEAP_FLAGS枚举的D3D12_HEAP_FLAG_SHARED成员指定。
共享堆不支持CPU可访问的堆:D3D12_HEAP_TYPE_UPLOAD、D3D12_HEAP_TYPE_READBACK和D3D12_HEAP_TYPE_CUSTOM,无需D3D12_CPU_PAGE_PROPERTY_NOT_AVAILABLE。
排除非确定性未定义纹理布局会显著影响某些GPU延迟渲染场景,因此这并非已放置和承诺资源的默认行为。延迟渲染在某些GPU架构上受影响,因为确定性纹理布局降低了同时渲染多个相同格式和大小的渲染目标纹理时所获得的有效内存带宽。GPU 架构正逐渐远离利用非确定性纹理布局,以支持标准化的滑动图案和标准化布局,以实现延迟渲染。
共享堆还会带来其他一些小成本:
- 由于信息披露问题,共享堆的数据无法像进程中堆那样灵活回收,因此物理内存被归零的频率更高。
- 在创建和销毁共享堆时,会增加轻微的CPU开销和系统内存使用。
跨适配器共享大量数据
跨适配器的共享堆由D3D12_HEAP_FLAGS枚举的D3D12_HEAP_FLAG_SHARED_CROSS_ADAPTER成员指定。
跨适配器共享堆允许多个适配器共享数据,而无需CPU在它们之间编组数据。虽然不同适配器能力决定了适配器之间的数据传递效率,但仅启用GPU副本就能提升有效带宽。某些纹理布局允许在交叉适配器堆上支持纹理数据的交换,即使这些纹理布局本身不支持。这些纹理可能受到某些限制,比如仅支持复制。
跨适配器共享适用于调用 ID3D12Device::CreateHeap 创建的堆。你的应用程序随后可以通过 CreatePlacedResource 创建资源。CreateCommittedResource 创建的资源/堆也允许使用,但仅限于行主要的 D3D12_RESOURCE_DIMENSION_TEXTURE2D 资源(参见 D3D12_RESOURCE_DIMENSION)。CreateReservedResource无法实现跨适配器共享。
对于跨适配器共享,所有通常的跨队列资源共享规则仍然适用。你的应用必须设置适当的屏障,以确保两个适配器之间的正确同步和一致性。你的应用应使用跨适配器围栏来协调提交给多个适配器的命令列表的调度。没有机制可以在不同 D3D API 版本之间共享跨适配器资源。跨适配器共享资源仅支持系统内存中。跨适配器共享堆/资源支持在D3D12_HEAP_TYPE_DEFAULT堆和D3D12_HEAP_TYPE_CUSTOM堆中(带有L0内存池和写合并CPU页面属性)。驱动程序必须确保 GPU 对跨适配器共享堆的读写操作与系统上其他 GPU 保持一致。例如,驱动程序可能需要排除堆数据存在于GPU缓存中,而这些缓存通常在CPU无法直接访问堆数据时不需要刷新。
你的应用应将跨适配器堆的使用限制在需要其功能的情况下。交叉适配器堆位于D3D12_MEMORY_POOL_L0,这并不总是GetCustomHeapProperties建议的那样。该内存池对于离散/NUMA适配器架构来说效率不高。而且,最高效的纹理布局并不总是可用。
以下限制也适用:
- 堆层相关的堆标志必须D3D12_HEAP_FLAG_ALLOW_ALL_BUFFERS_AND_TEXTURES。
- D3D12_HEAP_FLAG_SHARED也必须设置好。
- 必须设置D3D12_HEAP_TYPE_DEFAULT或D3D12_HEAP_TYPE_CUSTOM D3D12_MEMORY_POOL_L0和D3D12_CPU_PAGE_PROPERTY_NOT_AVAILABLE。
- 只有带有D3D12_RESOURCE_FLAG_ALLOW_CROSS_ADAPTER的资源才能放置在交叉适配器堆上。
- 当指定D3D12_HEAP_FLAG_SHARED_CROSS_ADAPTER时,受保护会话无法被传递到堆的创建中
有关使用多适配器的更多信息,请参阅多适配器系统部分。
驻地
当一个对象被GPU访问时,它被视为驻留对象。
驻地预算
GPU尚未支持页故障,因此应用程序必须在GPU能够访问数据时将数据提交到物理内存中。这一过程称为"使某物驻留",必须同时针对物理系统内存和物理离散视频内存。在 D3D12 中,大多数 API 对象封装了一定数量的 GPU 可访问内存。该GPU可访问的内存在创建API对象时被永久驻留,API对象销毁时被驱逐。
该进程可用的物理内存量称为视频内存预算。预算可能会随着背景进程的唤醒和睡眠而明显波动;当用户切换到其他应用时,价格会大幅波动。当预算发生变化时,应用程序可以收到通知,并轮询当前预算和当前消耗的内存量。如果应用未能控制在预算内,进程将间歇性冻结以允许其他应用运行,或者创建API会返回失败。IDXGIAdapter3 接口提供了与此功能相关的方法,特别是 QueryVideoMemoryInfo 和 RegisterVideoMemoryBudgetChangeNotificationEvent。
鼓励应用程序使用预留来表示他们无法缺少的内存量。理想情况下,用户指定的"低"图形设置,甚至更低的设置,才是此类预留的正确数值。设置预订不会给申请带来比正常预算更高的预算。相反,预留信息帮助操作系统内核快速减少大内存压力对外的影响。即使是预留,也无法保证当应用不是前景应用时。
堆资源
虽然许多API对象封装了一些GPU可访问的内存,但堆和资源预计是应用程序消耗和管理物理内存的最重要方式。堆是管理物理内存的最低级别单元,所以熟悉它们的驻留属性会很有帮助。
- 堆不能部分驻留,但存在利用保留资源的变通方法。
- 堆应该作为特定池的一部分进行预算。UMA适配器有一个池,而分立适配器有两个池。虽然内核确实可以在独立适配器上将部分堆从视频内存转移到系统内存,但这只是在极端的最后手段。应用程序不应依赖内核的超预算行为,应专注于良好的预算管理。
- 堆可以被从驻留点中逐出,这使得其内容可以被分页到磁盘。但是,销毁堆是释放所有适配器架构驻留权的更可靠技术。在MaxGPUVirtualAddressBitsPerProcess D3D12_FEATURE_DATA_GPU_VIRTUAL_ADDRESS_SUPPORT字段接近预算大小的适配器上,驱逐无法可靠地恢复居住权。
- 堆的创建可能很慢;但它针对后台线程处理进行了优化。建议在后台线程上创建堆积,以避免渲染线出现故障。在 D3D12 中,多个线程可以安全地同时调用创建例程。
D3D12 在其资源模型中引入了更多的灵活性和正交性,以实现更多应用选项。D3D12中有三种高级资源类型:承诺的、放置的和保留的。
- 承诺资源同时创建资源和堆。堆是隐式的,无法直接访问。堆的大小适中,能够将整个资源集中在堆中。
- 放置资源允许在堆中以非零偏移量放置资源。偏移量通常必须对齐到64KB;但双方都存在一些例外。MSAA资源需要4MB的偏移对齐,而小纹理则支持4KB的偏移对齐。放置的资源不能直接重新定位或映射到另一个堆;但它们允许资源数据在堆之间简单地重定位。在创建新放置的资源到不同堆并复制资源数据后,需要为新的资源数据位置使用新的资源描述符。
- 保留资源仅在适配器支持一级或更高等级的铺砌资源时可用。在可获得的情况下,他们提供最先进的住院医师管理技术;但并非所有适配器目前都支持这些功能。它们使资源能够重新映射,而无需重新生成资源描述符、部分 MIP 级别驻留和稀疏纹理场景等。即使有保留资源,也并非所有资源类型都支持,因此完全通用的基于页面的驻地管理器尚不可行。
住院医师优先事项
Windows 10 创作者更新使开发者能够影响在内存压力要求降级部分资源时,优先保留哪些堆和资源。这帮助开发者通过利用运行时无法从API中推断出的知识,创建更高性能的应用。预计开发者在从使用承诺资源转向保留和磁贴资源的过渡过程中,会变得更加自信和能够明确优先级。
应用这些优先级必定比管理两个动态内存预算、手动降级和提升它们之间的资源要容易,因为应用程序已经可以做到这一点。因此,驻留优先级 API 的设计是粗粒度的,每个堆或资源在创建时都为其分配了合理的默认优先级。更多信息请参见ID3D12Device1::SetResidencyPriority和D3D12_RESIDENCY_PRIORITY枚举。
在优先级方面,开发者通常需要:
- 提高少数特殊堆的优先级,以更好地减轻这些堆被降级的经验影响,比它们自然访问模式所需的更早或更频繁。这种方法预计将被从图形 API 移植而来的应用采用,如 Direct3D 11 或 OpenGL,其资源管理模型与 Direct3D 12 有显著不同。
- 几乎所有堆优先级都被应用自身的桶化方案覆盖,这种方案要么是固定的,基于程序员对访问频率的了解,要么是动态的;固定方案比动态方案更易管理,但由于使用模式在开发过程中变化,效果可能较低,且需要程序员介入。这种方法预计会被以Direct3D 12风格资源管理为核心构建的应用所采用,比如使用驻地库的应用(尤其是动态方案)。
默认优先级算法
应用程序无法在不了解默认优先级算法的情况下,为其试图管理的任何堆指定有用的优先级。这是因为赋予堆特定优先级的价值是根据堆与其他优先级堆的相对优先级关系推导出来的。
生成默认优先级的策略是将堆分类为两个桶,优先考虑(给予)GPU假设经常写入的堆,而非未写入的堆。
高优先级桶包含堆和资源,这些堆和资源通过标识为渲染目标、深度模板缓冲区或无序访问视图(UAV)来创建。这些优先级值在从D3D12_RESIDENCY_PRIORITY_HIGH开始的范围内分配;为了进一步在这些堆和资源中优先级排序,优先级中最低的16位设置为堆或资源的大小除以10MB(对于极大的堆则饱和到0xFFFF)。这种额外的优先级让堆积和资源更为丰富。
低优先级桶包含所有其他堆和资源,这些堆被赋予优先级值D3D12_RESIDENCY_PRIORITY_NORMAL。在这些堆积物和资源中,没有进一步的优先级排序。
驻地项目管理
简单的应用程序可能仅通过创建已提交的资源就能应付,直到出现内存不足的故障。失败时,应用程序可以销毁其他提交的资源或 API 对象,以使后续资源创建成功。但即使是简单的应用程序,也强烈建议注意负值预算变化,并每帧大约销毁一次未使用的API对象。
当尝试优化适配器架构或纳入驻地优先级时,驻地管理设计的复杂度会增加。离散预算和管理两个离散内存池比只管理一个更复杂,且如果使用模式演变,大规模分配固定优先级可能会成为维护负担。系统内存中溢出的纹理增加了复杂度,因为错误的资源会严重影响帧率。而且,没有简单的功能来帮助识别哪些资源需要更高的GPU带宽,哪些资源需要更高的GPU带宽,哪些资源需要更低的GPU带宽。
更复杂的设计会查询当前适配器的功能。这些信息以D3D12_FEATURE_DATA_GPU_VIRTUAL_ADDRESS_SUPPORT、D3D12_FEATURE_DATA_ARCHITECTURE、D3D12_TILED_RESOURCES_TIER和D3D12_RESOURCE_HEAP_TIER形式提供。
应用的多个部分很可能会使用不同的技术。例如,一些大型纹理和很少执行的代码路径可能使用已提交的资源,而许多纹理可能被指定为流属性,并采用通用的放置资源技术。
////////////////////////////////////////////////////////////
////////////////////////////////////////////////////////////
////////////////////////////////////////////////////////////上传不同类型的资源