NumPy 检查与诊断
深入理解数组、数据类型、内存布局和调试方法
1. 为什么需要检查 NumPy 数组
NumPy 数组不仅是数值的容器。数组的 shape、维度数量、dtype、strides、flags 以及数据所有权共同决定表达式如何解释、需要多少内存,以及操作返回的是视图还是副本。因此,检查数组是调试和性能优化的基础能力,而不只是把数组打印出来。
- 在计算前确认假设:shape、ndim、size、dtype,以及缺失值的表示方式。
- 解释性能差异:itemsize、nbytes、连续性和 strides 可以说明数据的内存布局。
- 避免隐蔽错误:广播、别名、符号整数和不安全类型转换可能改变结果而不抛出异常。
- 让 Notebook 和生产流水线具有可观察性:记录紧凑的元数据,而不是打印巨大数组。
基本检查模式
import numpy as np
x = np.arange(12, dtype=np.float32).reshape(3, 4)
print("type:", type(x))
print("shape:", x.shape)
print("ndim:", x.ndim)
print("size:", x.size)
print("dtype:", x.dtype)
print("itemsize:", x.itemsize)
print("nbytes:", x.nbytes)
print("strides:", x.strides)
print("flags:\n", x.flags)
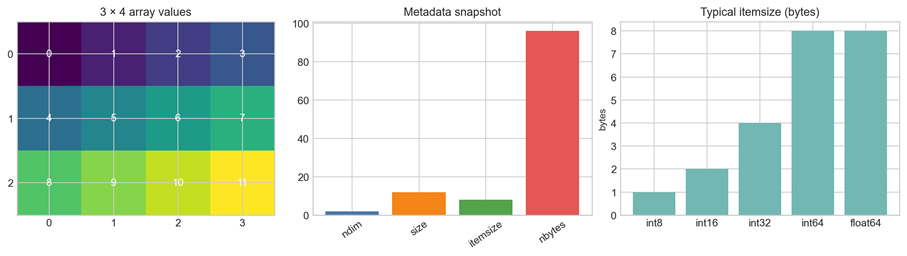
图 1 。检查面板把可见数值与结构元数据联系起来。
2. shape、维度和元素数量
shape、ndim 和 size 描述数组的不同方面。shape 是每个轴长度组成的元组;ndim 是轴的数量;size 是元素总数。例如,shape 为 (3, 4) 的二维数组 ndim 等于 2,size 等于 12。这些属性检查成本很低,应当在函数和接口边界处进行验证。
| 属性 | 含义 | shape 为 (3, 4) 时的示例 | 典型用途 |
|---|---|---|---|
| shape | 每个轴的长度 | (3, 4) | 验证矩阵和批次维度 |
| ndim | 轴的数量 | 2 | 区分标量、向量和矩阵逻辑 |
| size | 元素总数 | 12 | 估算工作量和归约规模 |
| len(x) | 第一个轴的长度 | 3 | 遍历最外层维度 |
| x.shapeaxis | 某个轴的长度 | x.shape1 == 4 | 验证特征数量 |
不改变数据的重塑
当目标 shape 与原数组的元素总数相同,reshape 会改变元素序列的解释方式。只要内存布局允许,它可能返回视图;但是,除非明确检查,否则不要依赖这种视图行为。某一维使用 -1 可以让 NumPy 自动推导长度;shape 重要时,应立即检查结果。
x = np.arange(24)
batch = x.reshape(2, 3, 4)
flat = batch.reshape(-1)
assert batch.size == flat.size == 24
assert batch.shape == (2, 3, 4)
- 当轴的语义发生变化时使用 x.T 或 swapaxes;不要把 transpose 与 reshape 混为一谈。
- 有意识地使用 expand_dims 和 squeeze,因为删除长度为 1 的轴可能影响后续广播。
- 在 sum、mean、max 等归约中明确指定 axis;如果要保留轴,可以使用 keepdims。
3. dtype 与数值表示
dtype 描述每个元素的表示方式,包括整数宽度、浮点精度、布尔、复数、字符串、日期时间、结构化记录或对象引用。它会影响数值范围、精度、内存占用、类型提升规则,以及与其他库的互操作性。在转换数据或比较结果前,应先检查 dtype。
| 检查项 | 示例 | 可以了解什么 |
|---|---|---|
| x.dtype | dtype('float32') | 元素类型和精度 |
| x.itemsize | 4 | 每个元素占用的字节数 |
| x.nbytes | x.size * x.itemsize | 数据载荷占用的内存 |
| np.issubdtype | np.issubdtype(x.dtype, np.number) | dtype 是否属于某个类别 |
| np.can_cast | np.can_cast(np.int32, np.float64) | 按指定规则判断转换是否安全 |
| np.result_type | np.result_type(a, b) | 表达式使用的公共 dtype |
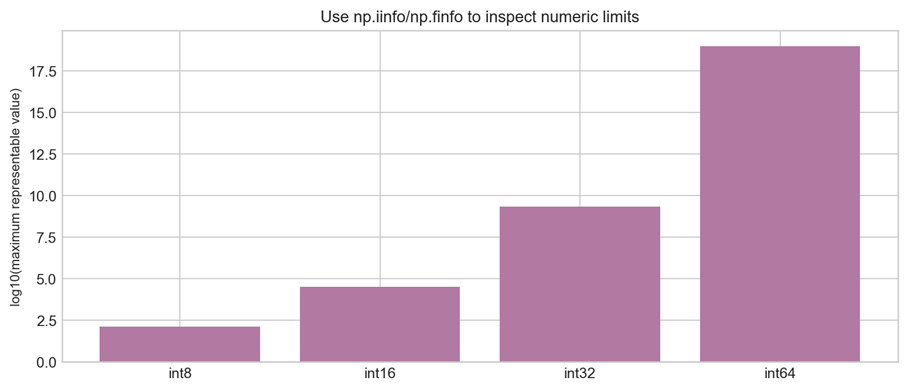
图 2 。整数范围说明了为什么应在运算和存储决策前检查 dtype 。
检查数值范围
int_info = np.iinfo(np.int16)
float_info = np.finfo(np.float32)
print(int_info.min, int_info.max)
print(float_info.eps, float_info.tiny, float_info.max)
np.iinfo 用于整数类型,np.finfo 用于浮点类型。eps 是 1.0 附近的间隔,tiny 是较小的正规正数,max 是最大的有限值。这些对象有助于解释溢出、下溢、容差选择以及存储类型的选择。
- 多数浮点计算不应使用精确相等比较;应检查数量级,并使用 np.isclose 或 np.allclose 以及有文档说明的容差。
- 注意整数减法和乘法:定宽整数可能溢出,但 dtype 不一定改变。
- object dtype 往往意味着数据异构或发生了意外转换,性能通常低于原生数值 dtype。
4. 内存布局、strides 和 flags
数组由数据缓冲区和索引到字节偏移的元数据组成。strides 表示沿某个轴增加一个索引时需要移动的字节数。对于 C 连续的二维数组,最后一个轴通常变化最快;对于 Fortran 连续数组,第一个轴通常变化最快。flags 对象汇总了连续性、数据所有权、可写性、对齐等属性。
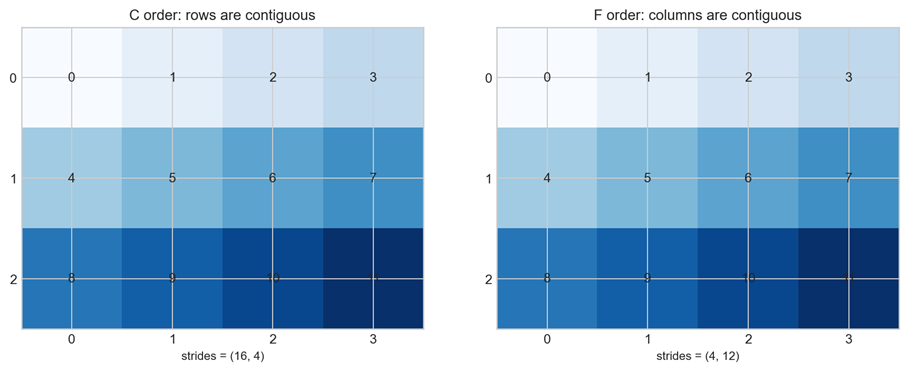
图 3 。相同数值在 C-order 和 Fortran-order 布局下可能具有不同的遍历模式。
| 属性 | 检查方式 | 解释 |
|---|---|---|
| C 连续 | x.flags.c_contiguous | 行或最后一个轴采用 C 风格连续布局 |
| F 连续 | x.flags.f_contiguous | 列或第一个轴采用 Fortran 风格连续布局 |
| 拥有数据 | x.flags.owndata | 数组拥有其数据指针所表示的缓冲区 |
| 可写 | x.flags.writeable | 数组标志允许修改数据 |
| 已对齐 | x.flags.aligned | 数据满足 dtype 的对齐要求 |
| 原始步长 | x.strides | 沿各轴增加索引时的字节移动量 |
x = np.arange(12, dtype=np.int64).reshape(3, 4)
print(x.strides) # C order 下通常为 (32, 8)
print(x.flags.c_contiguous)
print(x.flags.f_contiguous)
print(x.array_interface"data") # 指针和只读标志
指针的具体数值与进程有关,不应作为持久化标识符。它适合用于诊断;而 strides 和 flags 更适合用来解释为什么某个操作快速或需要创建副本。
5. 视图、副本与别名
视图是不同的数组对象,但引用相同的底层数据;副本拥有独立的存储空间。切片通常产生视图,而布尔索引和高级索引通常产生副本;许多变换是否共享内存取决于布局。别名有利于性能,但如果一个函数修改了另一个模块仍然依赖的数据,就可能造成难以发现的错误。
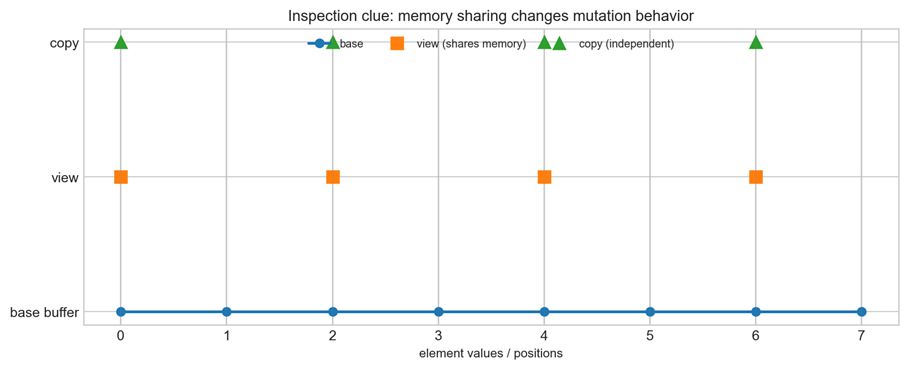
图 4 。通过内存共享检查,可以区分视图与独立副本。
base = np.arange(8)
view = base::2
copied = base::2.copy()
print(np.shares_memory(base, view)) # True
print(np.shares_memory(base, copied)) # False
print(np.may_share_memory(base, view)) # 保守的可能性检查
view0 = 100
print(base) # 因为视图别名,base 也发生改变
print(copied) # copied 数据彼此独立
| 情况 | 可能结果 | 检查方法 |
|---|---|---|
| 基本切片 | 通常是视图 | np.shares_memory(a, b) |
| 布尔索引或高级索引 | 通常是副本 | 检查 shares_memory,不要假设 |
| reshape | 布局允许时可能是视图 | 检查 b.base 和 shares_memory |
| astype(copy=True) | 独立副本 | 检查 dtype 和 shares_memory |
| 只读源数组 | 可能限制写入 | 检查 flags.writeable |
- 在所有权边界使用 copy(),确保函数可以安全修改自己的工作数据。
- 在实际需要精确判断时使用 np.shares_memory;np.may_share_memory 只是保守的可能性判断。
- .base 可以作为线索,但不能单独证明是否别名;视图链和复杂的所有权关系都可能存在。
6. 广播与迭代诊断
广播从最后一个轴开始向前比较形状。两个维度相等,或者其中一个为 1 时,它们兼容。NumPy 会在概念上扩展单例维度,而不一定实际复制数据。检查输入 shape 是理解异常结果形状的最快方法。
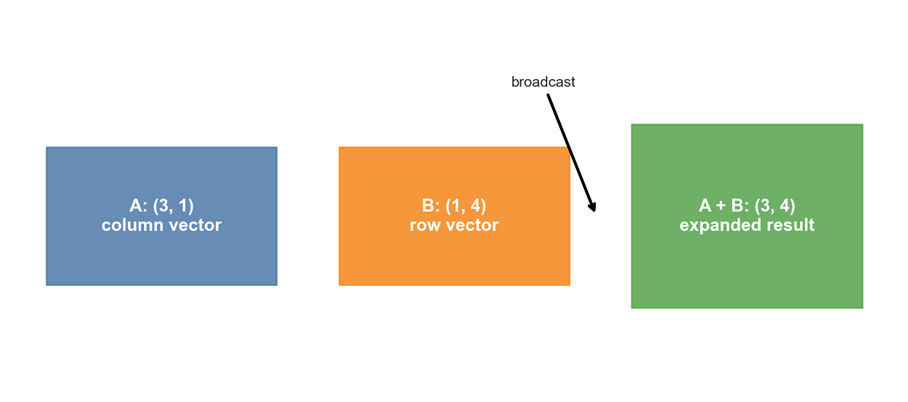
图 5 。 (3, 1) 数组和 (1, 4) 数组广播后得到 (3, 4) 结果。
a = np.arange(3).reshape(3, 1)
b = np.arange(4).reshape(1, 4)
print(a.shape, b.shape)
print(np.broadcast_shapes(a.shape, b.shape))
result = a + b
print(result.shape)
有用的遍历工具
| 工具 | 适用场景 | 示例 |
|---|---|---|
| np.ndenumerate | 可读的索引和值遍历 | for index, value in np.ndenumerate(x) |
| np.nditer | 可控制的迭代和 dtype 处理 | for value in np.nditer(x) |
| flat / flatiter | 一维顺序遍历 | for value in x.flat |
| np.array2string | 紧凑且可控制的显示 | np.array2string(x, threshold=20) |
| np.printoptions | 临时打印格式设置 | with np.printoptions(precision=3): ... |
x = np.linspace(0, 1, 12).reshape(3, 4)
with np.printoptions(precision=2, suppress=True, threshold=8):
print(x)
for index, value in np.ndenumerate(x):
if value > 0.75:
print(index, value)
7. 可复用的数组检查报告
通过小型报告函数,可以在 Notebook、测试和数据流水线中保持统一的检查方式。报告应包含稳定的元数据,避免打印大型数组,并让可选检查具有明确开关。下面的函数接受任意 array-like 输入,输出最有用的诊断信息。
def inspect_array(obj, name="array", preview=6):
x = np.asanyarray(obj)
flat = x.ravel()
print(f"{name}: type={type(x).name}")
print(f" shape={x.shape}, ndim={x.ndim}, size={x.size}")
print(f" dtype={x.dtype}, itemsize={x.itemsize}, nbytes={x.nbytes}")
print(f" strides={x.strides}")
print(f" C={x.flags.c_contiguous}, F={x.flags.f_contiguous}")
print(f" writeable={x.flags.writeable}, owns_data={x.flags.owndata}")
print(" preview:", flat:preview)
return x
inspect_array(np.arange(20).reshape(4, 5), "samples")
推荐工作流
- 在函数入口检查输入的 shape 和 dtype。
- 动态维度参与多数组表达式时,先检查广播后的 shape。
- 性能或修改行为异常时,检查 flags、strides 和内存共享情况。
- 改变精度或序列化数据前,检查数值范围和类型转换规则。
- 在测试或日志中记录紧凑报告;完整数组输出应设计为可选功能。
| 问题 | 最小诊断 |
|---|---|
| 为什么结果是这个 shape? | 打印各操作数 shape,并使用 np.broadcast_shapes |
| 为什么内存占用很高? | 检查 dtype、itemsize、nbytes 和意外副本 |
| 为什么源数组被改变? | 检查 np.shares_memory 和可写标志 |
| 为什么类型转换结果意外? | 检查 dtype、np.result_type 和 np.can_cast |
| 为什么数值不稳定? | 检查 np.finfo/np.iinfo,并使用 isclose 诊断 |
结束检查清单
-
shape 和轴语义已经记录并验证。
-
dtype 和数值范围适合当前数据。
-
内存布局和别名关系是有意设计的,而非偶然产生。
-
显示设置能够提供足够信息,同时避免输出过量。
-
检查代码可复用、可测试,并能安全处理大型数组。
通信与计算Adv链路/系统/网络仿真05:SimPy 与移动网络:蜂窝系统的离散事件仿真-CSDN博客
通信与计算Adv链路/系统/网络仿真04:SimPy 与 IP 网络:分组系统的离散事件仿真-CSDN博客
通信与计算Adv链路/系统/网络仿真03:SimPy 实用指南-Python 离散事件仿真-CSDN博客