手上有一台四盘机器,跑了大半年读写都正常,什么时候该往上加机器?这件事在没有出事之前很难回答,出事之后再回答就晚了。RustFS 文档把部署模式划成三条线,每条线的容错能力和典型用途都写得很清楚。看完之后你会发现,真正卡人的地方在后面:得先想清楚,自己能接受哪一种故障直接让数据读不出来。
三种部署模式划出的三条容错线
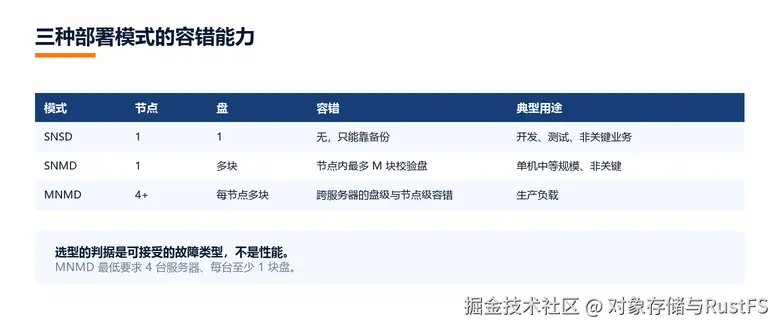
RustFS 的安装文档里有一张部署模式对比表,把节点数、盘数、容错能力和典型用途放在一行里:
| 模式 | 节点 | 盘 | 容错 | 典型用途 |
|---|---|---|---|---|
| SNSD | 1 | 1 | 无,只能靠备份 | 开发、测试、低密度非关键业务 |
| SNMD | 1 | 多块 | 节点内最多 M 块校验盘 | 单机上的中等、非关键业务 |
| MNMD | 4+ | 每节点多块 | 跨服务器的盘级与节点级容错 | 生产负载 |
SNSD 那一行写的是 None --- rely on backups。意思很直接:可靠性整个交给了备份。磁盘坏了靠备份恢复,主机挂了也靠备份恢复。用它当然可以,只是得清楚自己换来了什么。
SNMD 强在一点:同一个纠删集里坏掉最多 M 块盘,照样能重建,用不上备份。但它的容错范围只到"这一台机器",不到"这一排机器"。电源、主板、网卡、机柜断电,任何一项出问题,都是同一时间把这个节点上的全部分片一起带走。
这一点最容易让人误判。它扛得住盘坏,扛不住整机坏,可企业内部不少测试环境恰恰拿 SNMD 放"准生产"数据,觉得多盘就等于有生产级可靠性了。真等整机挂掉,能兜底的还是那一份备份。SNMD 只适合非关键业务,这句话不要打折。
四台机器这条线是怎么定下来的
MNMD 是官方给出的生产部署模式,安装文档对它的最低要求是至少 4 台服务器、每台至少 1 块盘,才能安全启动一个分布式对象存储集群。这个 4 不是随便定下来的。
需要先把一个数字说清楚:12+4 是系统的默认纠删集布局,MNMD 模式并不强制用它,换别的宽度也可以。一个对象被切成 12 个数据分片加 4 个校验片、散到不同服务器的不同盘上,说的就是默认状态下会出现的样子。
官方对这套布局给了两条保证:任意一台服务器的故障或维护不影响数据安全;最多 4 块盘的损坏也不影响数据安全。两条要合起来看。少提第一条会让人低估校验片的分量:服务器不掉、只坏盘的那部分情况,靠的就是那 4 个校验片。
要 4 台的原因就在那两条保证里:一个纠删集里的分片得落到不同机器上,才有"坏一台还剩三台"这回事。机器不够,容错域就只剩一个,再多盘也堆不回节点级容错。
硬件清单页给了一份按压测结果整理的参考矩阵,可以作为采购的起点而不必当作承诺:
| 档位 | 节点数 | 存储 | 网络 | CPU | 内存 |
|---|---|---|---|---|---|
| 基础 | 4 | 4× NVMe SSD | 双 25GbE 聚合 | 2× Intel Silver 4310(16 核) | 64 GB DDR4-3200 ECC |
| 生产标准 | 8 | 8× NVMe SSD | 双 100GbE | 2× AMD EPYC 7313(32 核) | 256 GB DDR5-4800 ECC |
| 高性能 | 16+ | 12× NVMe SSD | 200GbE | 2× Intel Platinum 8461Y(48 核) | 512 GB DDR5-5600 ECC |
这份清单末尾自己标注了一句:内容基于最新的 RustFS 开发版本,实际部署要按具体厂商白皮书调参。这类数字给的是建议区间,不是 SLA。拿它当参考线、别当验收线,采购时能少跑一趟。
再看网络和磁盘的配速。文档给了一张对应关系:10GbE 大约只喂得动 8 块 7.2K HDD,25GbE 约 6 块 SATA SSD,100GbE 能让 2 块 Gen4 NVMe 跑满。给 NVMe 配千兆网的部署,瓶颈会清清楚楚落在网络那一边,磁盘和 CPU 都在旁边闲着。
这套比值有个前提:按磁盘吞吐上限算。业务如果是海量小对象,瓶颈会转到 CPU 和元数据上,不再受磁盘带宽约束,这时候照这张表配网络就没意义了。
上分布式之前要先补齐的三件小事
从单机走向多机,环境层面的准备比参数配置更容易出问题。MNMD 文档里写明,安装前要确保所有节点满足生产检查项,下面这三件不做,轻则行为异常,重则集群起不来。
第一件是主机名。RustFS 集群要求各节点主机名相同且连续,实现方式只有两条路:DNS 里做解析,或者写 /etc/hosts。文档给的示例是给四个节点依次配 node1 到 node4,保证名字连续。
第二件是时钟和端口。所有节点要用同一个监听端口,时钟也要同步。多节点环境下,证书有效期、复制延迟的判断、审计事件的先后顺序,全都跟着时钟走。时钟漂移一般不直接报错,它表现出来的样子通常是"有些请求会莫名失败",查起来很费时间。
第三件是环境变量的一致性。多节点部署下每个节点都要有一份完全相同的环境文件,任何一项差异都可能表现为"集群起来了但某些操作失败"。
RUSTFS_VOLUMES 用花括号枚举所有节点和挂载点,文档给的四节点四盘示例是:
ini
RUSTFS_VOLUMES="http://node{1...4}:9000/data/rustfs{0...3}"
RUSTFS_ADDRESS=":9000"
RUSTFS_CONSOLE_ENABLE=true
RUSTFS_CONSOLE_ADDRESS=":9001"
RUSTFS_OBS_LOGGER_LEVEL=error
RUSTFS_OBS_LOG_DIRECTORY="/var/log/rustfs/"
访问密钥、秘密密钥和 RUSTFS_VOLUMES 的取值,在所有节点上必须一模一样;主机名要和上面那份 /etc/hosts 对得上。目录也要提前建好并限定属主:
bash
sudo mkdir -p /data/rustfs{0..3} /var/log/rustfs /opt/tls
sudo chmod -R 750 /data/rustfs* /var/log/rustfs
上面配置块里的 {1...4}、{0...3} 是 RustFS 自己解析的展开语法,不是 shell 的花括号展开。这个文件由 systemd 加载,那一层不会替你把花括号拼开,最后是服务启动时读原文展开的。别拿 bash 的习惯往这边套,也别把花括号写成字面的 {1...4} 塞进引号。
顺带说一个容易看漏的点:多节点之间的 RPC 复用的就是 9000 端口,没有独立的集群端口。也就是说防火墙上只要开了 9000,节点之间就已经互相连通了,排查连通性时可以少跳一层。反过来,9000 得当成对外端口认真对待;控制台那个 9001 只放到可信网络里,用不上就直接关掉。
参数和拓扑是两件事,别只调参数
很多人把"能不能扛住整机故障"理解成纠删码参数问题。RustFS 的 EC 配置页专门写了一条反向提醒:M 描述的是单个纠删集内的不可用分片数,节点级容错取决于这个纠删集的盘怎么分布到各节点上,不要假设 EC:4 总能扛住四整台节点失效,一个节点完全可以放同一个纠删集的多个盘。
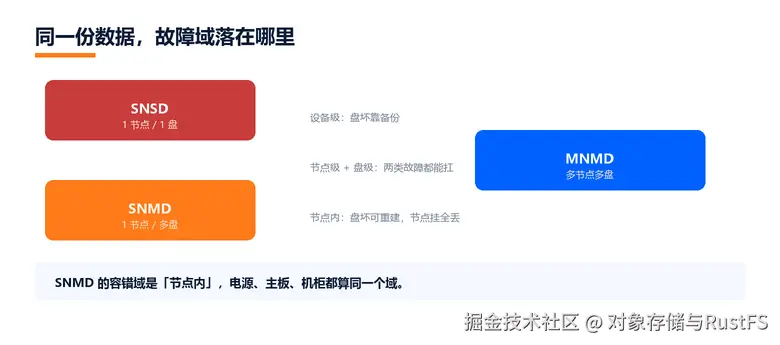
同一份 EC:4,四块盘分散在四台机器上,和四块盘全塞进一台机器,参数一字不差,容错能力差一个档次。前者能扛住一台整机掉电,后者坏一块盘之后的重建余量就没了。这也是拓扑规划要在定 EC 参数之前做完的原因。
参数能改,能改的和动不了的还是两回事。调整存储类奇偶校验,对已经写进去的对象没有影响,每个对象的几何记在自己那份 xl.meta 里;RUSTFS_ERASURE_SET_DRIVE_COUNT 不一样,池初始化之后就改不了了,想把 /data{1...4} 改成 /data{1...8},系统会认为你在重定义这个池,直接拒绝启动。要做只能原池不动、另加一个池。
带宽和内存这两个数字先算出来
硬件清单页给了一组按有效数据量折算的经验值,选型阶段用得上:
- 网络:每 1 TB 有效数据预留 0.5 Gbps 带宽,100 TB 数据对应 50 Gbps 专用带宽;节点间 P99 延迟建议 ≤ 2ms,跨机架 ≤ 5ms
- 内存 :以
data_tb为自变量的经验公式,读密集32 + data_tb × 0.8、写密集32 + data_tb × 1.2、混合32 + data_tb × 1.0。按这个表,100 TB 混合负载对应 132 GB,500 TB 写密集对应 632 GB - 对象规模:平均对象大小建议落在 128 KB 到 1 MB 区间,超过 1 亿个对象时文档建议单独做优化评估
上面这几条有个共同前提:都按"有效数据"算,不是按裸容量。备份归档、副本冗余、未完成的上传都会把实际占用推高,照裸容量去配带宽和内存,通常会在半年后遇到一次说不清理由的扩容。
内存那一行还要打个折。这套公式是按有效数据量线性外推的,对象偏大时算得比较准;换成海量小对象,元数据会吃掉不少内存,实际用量明显高于公式结果。小对象为主的场景,内存按公式算出来的值往上留一截余量,别按公式卡死上限。
上线之前文档还建议做一轮 72 小时的压测,至少覆盖节点故障切换、网络分区演练,以及达到理论值 120% 的突发写压力。这三项里任何一项没跑过就进生产,出问题时的第一手材料是缺的。
网络分区这一项单独提一句:这类演练放测试环境做就够了。生产集群上没有"模拟一下"这回事,手一抖打出真实分区,业务那边就是一次实打实的故障。
判断清单
把上面几节并排看,选择的顺序其实很清楚:先看能接受的故障类型,再看节点数够不够,最后才轮到性能和预算。反过来的做法(先定预算再倒推拓扑)在多数情况下会得到"能省则省"的结论,而这个结论往往在第一次硬盘故障的时候被推翻。
回到开头那个问题。给一个可以直接照着走的顺序:
| 你的情况 | 建议模式 |
|---|---|
| 开发、测试、非关键数据,有备份 | SNSD |
| 单机承载中等规模非关键业务 | SNMD |
| 生产负载,业务不能接受停机 | MNMD |
| 单机 CPU 或内存已经吃紧 | 先凑够 4 台再谈扩容,别在单机上一直加盘 |
中间那两档的边界本来就模糊,判断依据只有一条:这台机器上如果整机挂掉,业务能不能扛过去。能扛就留在单机,扛不住就得上 MNMD。SNMD 换不来节点级容错,这是布局决定的,加内存加盘都绕不过去。
真正让人吃亏的情形是"单机跑得挺好,就先不加机器了",加到某天数据已经几百 TB,再想扩成四节点分布式。这里要把话说死:不存在在线原地迁移这回事。已经格式化的单盘部署不能靠追加端点或存储池来扩容,启动时直接报 UnsupportedSnsdExpansion;已经初始化的多盘池,驱动器数和集合宽度同样写死了,改了就报 PoolTopologyMismatch。两条路都指向同一个做法------新建一套部署,把数据通过 S3 迁过去。
从单机到分布式的那一步,实际是另外搭一套,再把数据搬过去。回头改的成本,远高于起步时多花的两天。
决定之前先做一件事:在现有集群上跑 rc admin info cluster rustfs --json,把后端布局、纠删奇偶、盘可用性和池成员这四项看清楚。它报出来的几何跟你脑子里那张图对不上时,先查拓扑,再回头查参数。