摘 要
在全球气候变化的大背景下,极端天气事件如暴雨、干旱等频繁发生,对人类社会经济活动和生态环境造成了严重影响。准确预测降水量对于防灾减灾、水资源管理、农业生产等方面具有重要意义。本系统采用先进的深度学习技术,包括CNN、LSTM和Transformer模型,对气象数据进行深入分析和降水量预测。CNN模型通过卷积层自动提取气象数据中的空间特征,适用于降水量等气象要素的预测。LSTM模型作为一种特殊的循环神经网络,能够有效处理和预测时间序列数据,适用于降水量等气象数据的预测。Transformer模型通过自注意力机制和并行计算,能够更好地捕捉长距离依赖关系,提高预测的准确性。系统还包括数据采集与处理模块,负责从多种气象数据源自动采集原始数据,并进行清洗、格式转换等预处理操作,以确保数据的质量和一致性,适合模型训练和预测。此外,系统还提供模型评估模块,对各模型的性能进行评估,以确定在特定条件下表现最佳的模型。
关键词****:****CNN模型;LSMT;Transformer;预测;降雨
Abstract
Under the background of global climate change, extreme weather events such as rainstorm and drought occur frequently, which have a serious impact on human social and economic activities and ecological environment. Accurate prediction of precipitation is of great significance for disaster prevention and mitigation, water resources management, and agricultural production. The system uses advanced deep learning technologies, including CNN, LSTM and Transformer models, to conduct in-depth analysis of meteorological data and precipitation prediction. The CNN model automatically extracts the spatial features in meteorological data through the convolutional layer, which is suitable for the prediction of meteorological elements such as precipitation. As a special recurrent neural network, the LSTM model can effectively process and predict time series data, and is suitable for the prediction of meteorological data such as precipitation. The Transformer model can better capture long-distance dependencies and improve the accuracy of prediction through self-attention mechanism and parallel computing. The system also includes a data acquisition and processing module, which is responsible for automatically collecting raw data from a variety of meteorological data sources, and performing preprocessing operations such as cleaning and format conversion to ensure data quality and consistency, which is suitable for model training and prediction.In addition, the system also provides a model evaluation module to evaluate the performance of each model to determine the model that performs best under certain conditions.
****Keywords :****CNN model ; lSMT ; transformer ; prediction ; rainfall
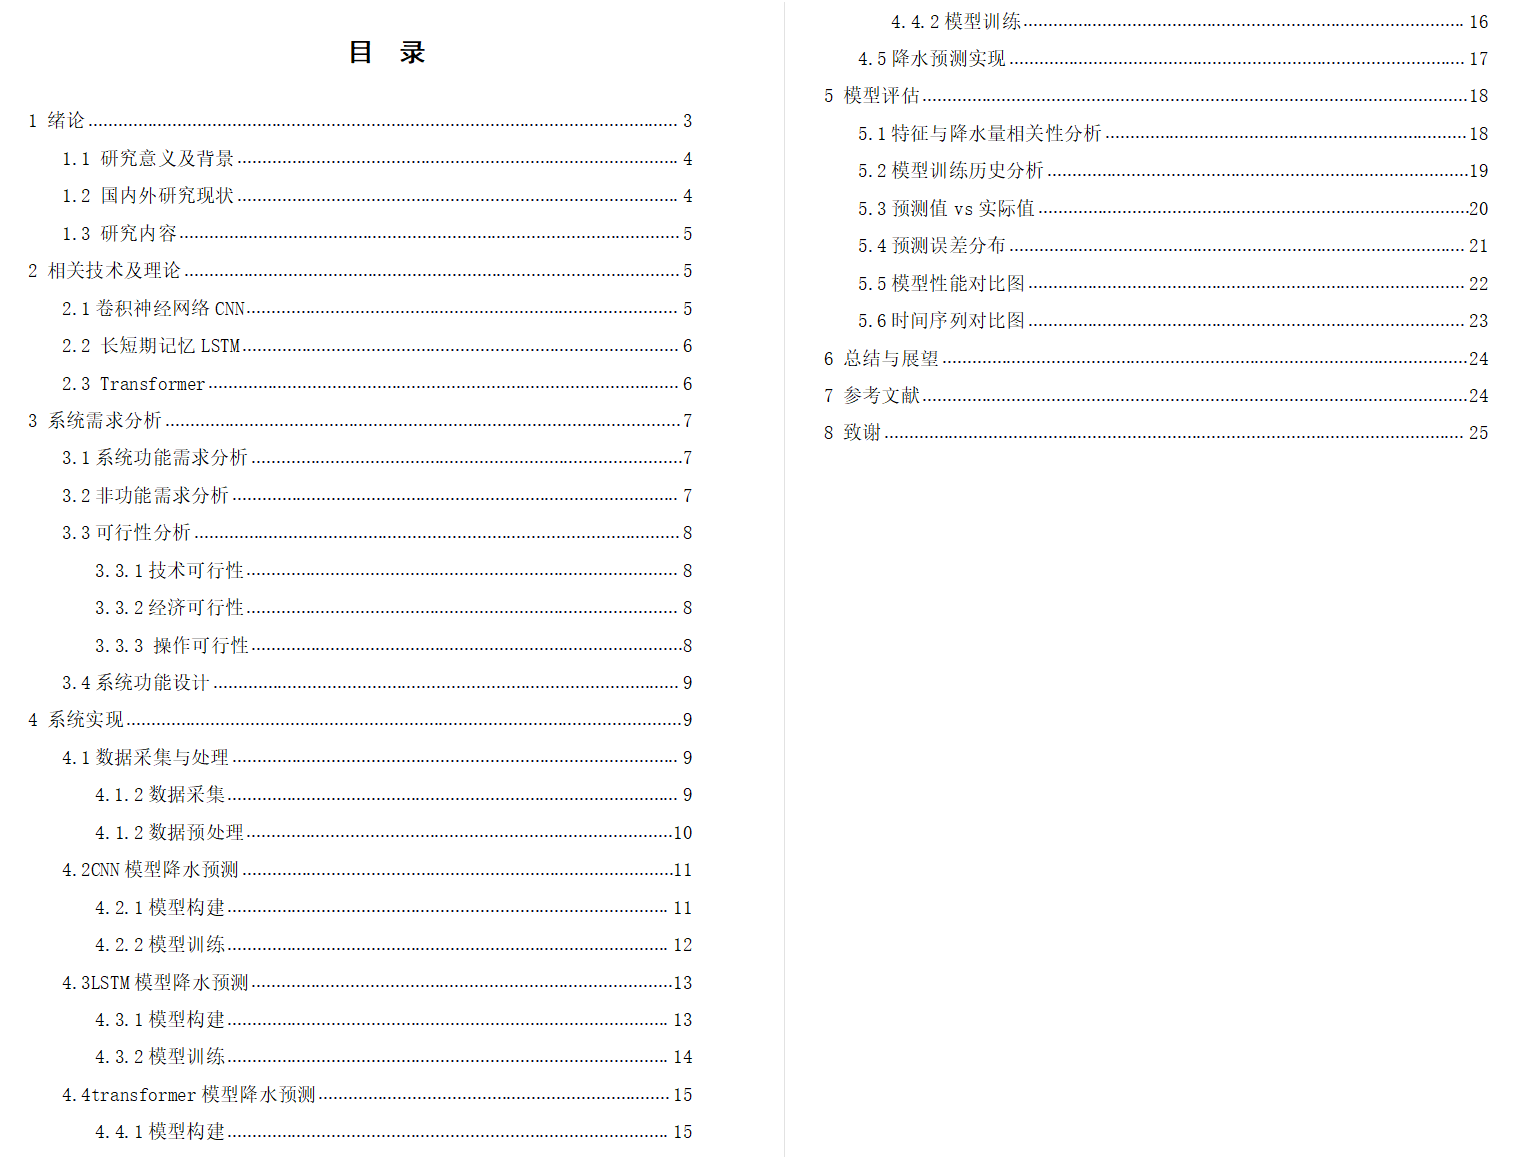
目 录
[1 绪论](#1 绪论)
[1.1 研究意义及背景](#1.1 研究意义及背景)
[1.2 国内外研究现状](#1.2 国内外研究现状)
[1.3 研究内容](#1.3 研究内容)
[2 相关技术及理论](#2 相关技术及理论)
[2.2 长短期记忆LSTM](#2.2 长短期记忆LSTM)
[2.3 Transformer](#2.3 Transformer)
[3 系统需求分析](#3 系统需求分析)
[3.3.3 操作可行性](#3.3.3 操作可行性)
[4 系统实现](#4 系统实现)
[5 模型评估](#5 模型评估)
[6 总结与展望](#6 总结与展望)
[7 参考文献](#7 参考文献)
[8 致谢](#8 致谢)
- 绪论
- 研究意义及背景
随着全球气候变化的加剧,极端天气事件如暴雨、干旱等发生的频率和强度不断增加,对人类社会经济活动和生态环境造成了严重影响。准确预测降水量对于防灾减灾、水资源管理、农业生产等方面具有重要意义。传统的降水量预测方法主要依赖于物理模型和统计模型,但这些方法在处理复杂非线性关系和高维数据时存在局限性。近年来,深度学习技术在图像识别、自然语言处理等领域取得了显著成果,其强大的特征提取能力和非线性建模能力为降水量预测提供了新的解决方案。本研究旨在探索基于CNN、LSTM和Transformer等深度学习模型的降水量预测方法,以期提高预测的准确性和可靠性,为相关领域提供科学依据和技术支持。
气象数据具有时间序列特性,传统的气象预测方法往往难以捕捉到数据中的长期依赖关系和复杂的时空动态变化。LSTM模型作为一种特殊的循环神经网络,能够有效处理和预测时间序列数据,适用于降水量等气象数据的预测。然而,LSTM模型在处理长序列数据时可能会遇到梯度消失或梯度爆炸的问题,影响模型性能。Transformer模型通过自注意力机制和并行计算,能够更好地捕捉长距离依赖关系,提高预测的准确性。CNN模型通过卷积层能够自动提取气象数据中的空间特征,适用于降水量等气象要素的预测。然而,单一模型可能难以捕捉到降水量预测中的所有关键因素,如地形、气候模式等。本研究通过构建和评估CNN、LSTM和Transformer等不同深度学习模型,旨在探索不同模型预测的降水量的准确性,为气象服务和决策支持提供更加科学和可靠的依据。
-
- 国内外研究现状
在国外,基于深度学习的降雨量预测研究起步较早且成果丰富。众多科研机构和高校积极投身其中,运用先进技术开展相关研究。在模型应用方面,卷积神经网络(CNN)凭借其强大的特征提取能力,被广泛用于挖掘降雨量数据中的空间特征。例如,一些研究利用 CNN 对气象卫星图像数据进行处理,从而获取与降雨量相关的云系特征信息,提升预测精度。长短期记忆网络(LSTM)则因其擅长处理时间序列中的长期依赖关系,在降雨量时间序列预测中表现出色。不少研究团队使用 LSTM 对历史降雨量数据进行建模,有效捕捉降雨量在时间维度上的变化规律。Transformer 模型自提出后,也迅速在降雨量预测领域得到应用,其多头自注意力机制能捕捉数据中复杂的依赖关系,为降雨量预测提供了新的视角和方法。在数据处理与融合上,国外研究注重多源气象数据的整合,将卫星遥感数据、地面气象站监测数据以及雷达数据等相结合,以丰富数据特征,提高预测准确性。同时,在模型评估方面,采用严格且多样化的评估指标体系,除了常见的均方误差(MSE)、平均绝对误差(MAE)等,还引入了更能反映实际应用需求的指标,全面衡量模型性能。
在模型研究上,国内学者对 CNN、LSTM 和 Transformer 等模型进行了深入探索与改进。针对 CNN 模型,通过优化卷积核的设计、调整网络层数和结构等方式,提高其对降雨量数据特征的提取效率。对于 LSTM 模型,改进其门控机制,增强对复杂时间序列信息的处理能力。在模型融合方面,国内研究积极尝试将不同模型进行组合,充分发挥各模型的优势,如将 CNN 与 LSTM 融合,利用 CNN 提取空间特征,LSTM 捕捉时间特征,实现降雨量的精准预测。在实际应用中,结合我国地域特点和气象特征开展研究。例如,针对我国地形复杂、气候多样的特点,在不同地区开展针对性的降雨量预测研究,为当地的农业生产、水利工程建设和城市防洪排涝等提供决策支持。
国内研究在应用创新上表现突出,更侧重于结合国内实际需求和场景,将深度学习模型应用于解决具体的气象业务问题和社会发展需求。在数据资源整合与利用上,国外一些发达国家在气象数据的采集、管理和共享机制方面相对成熟,能够更高效地整合多源数据。国内虽然在数据采集和存储方面取得了很大进步,但在数据共享和跨部门合作上还有提升空间。
-
- 研究内容
第一章阐述基于深度学习模型进行陕西降雨量气象分析系统的研究意义与背景,梳理国内外在利用深度学习模型(如 CNN、LSTM、Transformer )进行降雨量预测研究的进展、成果及差异。
第二章介绍了卷积神经网络 CNN,长短期记忆 LSTM以及Transforme的技术原理与特点。
第三章系统需求分析,主要剖析系统在数据采集与处理、各模型构建训练、降水量预测及模型评估等模块的具体功能要求。
第四章系统实现,介绍采集陕西降雨量相关数据及对采集数据进行清洗、特征提取等预处理操作的具体实现过程。说明构建适用于降雨量预测的 CNN 模型结构及LSTM 模型,Transformer 模型并对其训练用于降雨量预测的技术要点。
第五章模型评估,从特征与降水量相关性分析, 模型训练历史分析、 预测值 vs 实际值、对比模型预测降雨量值与实际观测值等多个维度,清晰呈现各模型的优劣。
第六章总结与展望,总结基于多模型的陕西降雨量气象分析系统的研究成果,分析不足,并对未来研究方向和系统优化改进提出展望。
- 相关技术及理论
2.1卷积神经网络CNN
卷积神经网络(CNN)是一种深度学习模型,独具匠心地设计了卷积层、池化层和全连接层。卷积层通过卷积核在数据上滑动进行特征提取,能自动学习数据中的局部模式和特征,如同敏锐的探测器,精准捕捉关键信息;池化层则对卷积层输出的特征图进行下采样,减少数据量的同时保留重要特征,起到简化数据、降低计算复杂度的作用;全连接层将提取到的特征进行整合,完成最终的分类或回归任务。这种分层结构使CNN在处理具有网格结构的数据,如图像、音频和时间序列数据时表现出色。
CNN作为深度学习中重要的模型之一,被广泛应用于图像分类、目标检测、图像分割、自然语言处理等领域。卷积层是CNN的核心组成部分,它通过卷积操作从输入数据中提取特征。池化层通常紧跟在卷积层后面,用于降低特征图的维度和参数数量,同时保留重要的特征信息。在卷积层和池化层之间,通常会添加激活函数来引入非线性变换,从而增强模型的表达能力。在经过多个卷积层和池化层的处理之后,通常会添加全连接层来进行分类或回归。
CNN具有诸多显著优势。它具备强大的特征学习能力,无需人工手动设计特征,能够自动从大量数据中学习到有效的特征表示,大大提高了模型的适应性和准确性;参数共享机制使得CNN在处理高维数据时,减少了需要训练的参数数量,降低了模型的复杂度,提高了训练效率,同时也增强了模型的泛化能力;此外,CNN对输入数据的平移、缩放和旋转等变换具有一定的鲁棒性,能够在不同条件下稳定地工作。
2.2 长短期记忆LSTM
LSTM属于循环神经网络(RecurrentNeuralNetwork,RNN)的一个变体,它通过结构上的改进成功克服了标准RNN面临的梯度消散和梯度爆炸的问题21,特别是在处理长时间数据序列时,对处理时间序列信号具有显著优势。LSTM的核心在于其门控机制,包括遗忘门、输入门和输出门,这些门控结构使得网络能够学习到何时忘记旧的信息、何时接受新的信息以及何时输出信息。这种机制使得LSTM特别适合于处理和预测含有时间依赖性的时序数据。因此,LSTM具有较好的预测性能,能够基于当前和过去的振动数据预测未来一段时间内电梯的运行状态,这对于预防性维护和故障预警非常关键。
LSTM在众多需要处理时间序列数据的领域有着广泛的应用。在自然语言处理中,它可用于机器翻译、文本生成和情感分析等任务,通过对句子中词语的顺序和上下文信息进行建模,生成更准确、连贯的结果;在语音识别领域,LSTM能够处理语音信号的时间序列特征,将语音准确地转换为文本;在时间序列预测方面,如股票价格预测、电力负荷预测和降雨量预测等,LSTM凭借其捕捉长期依赖的能力,能够提供更精准的预测结果。
2.3 Transformer
Transformer是一种基于自注意力机制(Self - Attention Mechanism)构建的深度学习模型架构,彻底革新了序列建模的方式。它摒弃了传统的循环结构,采用编码器 - 解码器(Encoder - Decoder)架构。编码器负责将输入序列转换为一系列连续的表示,捕捉输入中的语义信息;解码器则根据编码器的输出和自身先前生成的序列,逐步生成目标序列。自注意力机制是Transformer的核心,它允许模型在处理序列中的每个元素时,能够动态地关注序列中其他所有元素,从而有效地捕捉长距离依赖关系和全局信息,极大地提升了模型对复杂序列数据的处理能力。
在机器翻译任务中,它能够精准地理解源语言的语义,并将其准确、流畅地转换为目标语言,大幅提高了翻译的质量和准确性;在文本生成方面,如对话生成、故事创作等,Transformer可以生成连贯、富有逻辑且多样化的文本内容;在语言理解任务,如文本分类、情感分析等,它也能凭借强大的语义捕捉能力,准确地对文本进行分类和情感判断。此外,Transformer还拓展到计算机视觉、语音处理等其他领域,展现出强大的跨领域适应性。
- 系统需求分析
3.1系统功能需求分析
功能需求分析围绕基于CNN、LSTM和Transformer模型的陕西降雨量气象分析系统展开。旨在清晰界定系统各模块功能,为系统设计、开发、测试及维护提供全面且明确的指导依据,确保系统能够精准、高效地实现陕西降雨量的分析与预测目标。
(一)数据采集与处理
数据采集:从网上获取陕西地区降雨量相关数据,涵盖季节/时段、降水量、时段开始日期、时段结束日期、地点等。
数据预处理:对采集到的原始数据进行深度清洗,通过数据验证算法去除重复数据记录,使用IQR方法检测并移除降水量的异常值,确保数据的准确性和一致性。
(二)模型构建与训练
CNN模型:搭建模型结构,设置卷积、池化等层参数,引入技术优化。用预处理数据训练,调整超参数,监控指标防过拟合,保存最优参数。
LSTM模型:构建适合时序数据的模型,确定层和单元参数,结合Dropout。用数据训练,关注损失和指标,学习降雨时间规律。
Transformer模型:设计多头自注意力等结构,确定位置编码。用数据训练,调控超参数,监控指标,保存最佳参数。
(三)降水预测实现
整合训练好的CNN模型,依用户需求输入特征数据预测降雨量,输出数值及置信区间,以图表可视化展示。
(四)模型评估
分析特征与降水量相关性,展示结果辅助模型优化。
记录模型训练指标变化,对比收敛和泛化能力。
对比预测值与实际值,计算指标评估准确性。
统计预测误差,分析分布特征。
对比各模型性能指标,助于模型选择与融合。
绘制时间序列对比图,评估模型对降雨趋势捕捉能力。
3.2非功能需求分析
性能需求:系统应具备高效的数据处理和模型计算能力,在规定时间内(如对于短期预测任务,应在数秒至数分钟内完成;对于长期预测任务,可适当延长但也应在可接受的时间范围内)完成降雨量数据的采集、处理、模型训练和预测任务。同时,系统应能够支持一定规模的数据量和用户并发访问,确保在大数据量和高并发情况下的性能稳定,避免出现响应延迟、卡顿甚至系统崩溃等问题。
可靠性需求:系统应具备高度的可靠性,确保数据的准确性、完整性和一致性。采用数据备份和恢复机制,定期对重要数据进行备份,防止数据丢失或损坏。同时,系统应具备错误处理和异常恢复能力,在遇到硬件故障、软件错误、网络中断等异常情况时,能够快速检测并采取相应的恢复措施,保证系统的正常运行和服务的连续性。
可扩展性需求:系统应具备良好的可扩展性,能够方便地添加新的数据源、数据处理算法、模型结构或功能模块。随着气象数据的不断丰富和技术的不断发展,系统应能够适应新的需求和变化,如接入更多类型的气象传感器数据、引入更先进的深度学习模型架构、增加新的降雨量分析和预测功能等,以保持系统的先进性和实用性。
可维护性需求:系统应具备良好的可维护性,代码应具有清晰的结构和良好的注释,便于开发人员进行代码阅读、理解和修改。系统应提供方便的配置管理功能,能够轻松调整系统参数、模型超参数等设置。同时,系统应具备完善的日志记录和监控功能,能够实时记录系统运行过程中的关键信息和事件,方便开发人员进行故障排查、性能优化和系统维护。
安全性需求:系统应保障数据的安全性,对采集到的气象数据进行严格的访问控制和权限管理,防止数据泄露、篡改和非法访问。采用加密技术对敏感数据进行加密存储和传输,确保数据在存储和传输过程中的安全性。同时,系统应具备安全审计功能,能够记录用户的操作行为和系统的安全事件,便于进行安全追溯和审计。
3.3可行性分析
3.3.1技术可行性
当前深度学习技术在气象预测领域已取得显著进展,CNN、LSTM 和 Transformer 等模型在处理时间序列数据和空间特征方面表现出色。已有许多研究和应用案例表明,这些模型能够有效捕捉降雨量的复杂模式和时空依赖关系,为降雨量预测提供技术支持。
3.3.2经济可行性
项目的主要成本来自于数据采集、模型训练和系统维护。考虑到开源工具和框架的使用,可以降低软件许可费用。系统投入使用后,可为气象部门、农业部门、水利部门等提供准确的降雨量预测服务,帮助其优化决策,减少因降雨灾害造成的经济损失。
3.3.3 操作可行性
通过前期的用户调研和需求分析,系统的功能设计充分考虑了用户的实际需求,能够为用户提供准确、及时的降雨量预测信息和分析结果。系统界面设计简洁直观,操作方便快捷,用户无需具备专业的技术知识即可轻松使用系统,满足用户的操作需求。
3.4系统功能设计
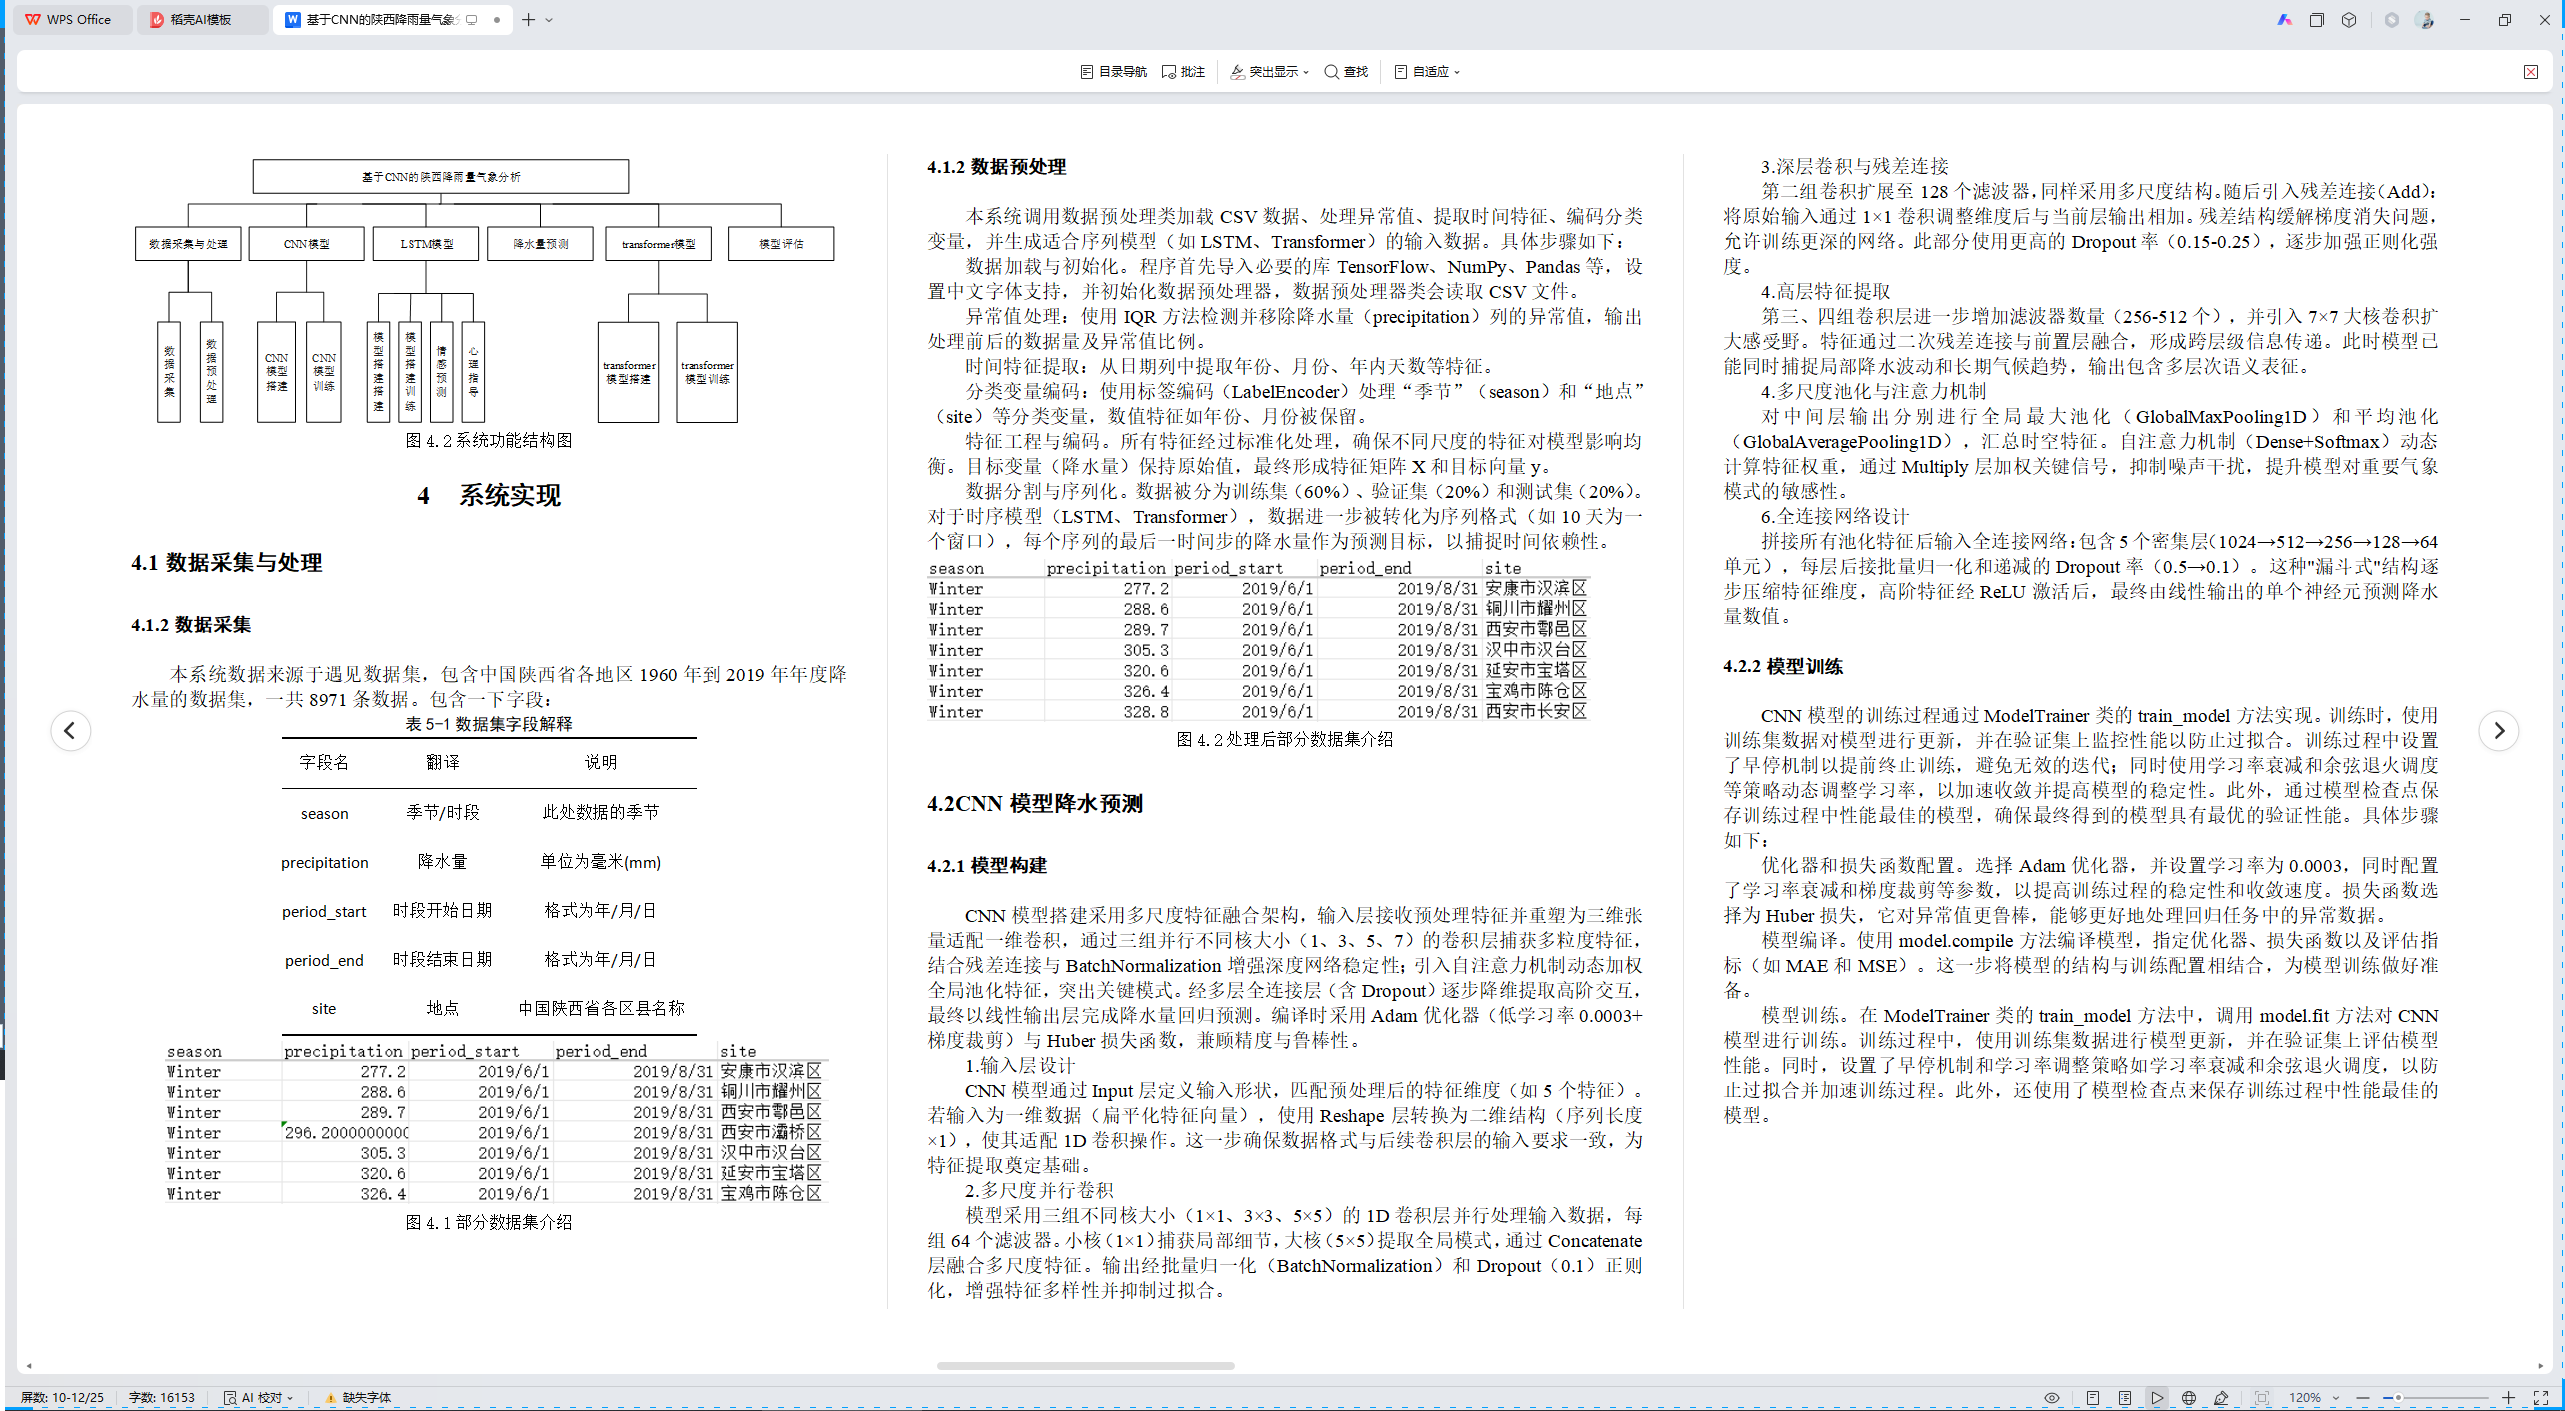
本系统分为五个主要模块,分别是数据采集与处理、CNN模型、LSTM模型、transformer模型和模型评估。在数据采集与处理模块下,又细分数据采集和数据预处理两个子项;CNN模型模块包含CNN模型搭建和CNN模型训练;LSTM模型模块有模型搭建训练以及降雨预测;transformer模型模块包括transformer模型搭建和transformer模型训练;模型评估则独立作为一个模块,用于对各模型的性能等进行评估。此架构图清晰地展示了基于不同模型进行陕西降雨量气象分析的整体流程和各部分组成。
图4.2系统功能结构图
- 系统实现
4.1数据采集与处理
4. 1.2 数据采集
本系统数据来源于遇见数据集,包含中国陕西省各地区1960年到2019年年度降水量的数据集,一共8971条数据。包含一下字段:
表5-1数据集字段解释
|---------------|--------|------------|
| 字段名 | 翻译 | 说明 |
| season | 季节/时段 | 此处数据的季节 |
| precipitation | 降水量 | 单位为毫米(mm) |
| period_start | 时段开始日期 | 格式为年/月/日 |
| period_end | 时段结束日期 | 格式为年/月/日 |
| site | 地点 | 中国陕西省各区县名称 |
图4.1部分数据集介绍
4.1.2数据预处理
本系统调用数据预处理类加载CSV数据、处理异常值、提取时间特征、编码分类变量,并生成适合序列模型(如LSTM、Transformer)的输入数据。具体步骤如下:
数据加载与初始化。程序首先导入必要的库TensorFlow、NumPy、Pandas等,设置中文字体支持,并初始化数据预处理器,数据预处理器类会读取CSV文件。
异常值处理:使用IQR方法检测并移除降水量(precipitation)列的异常值,输出处理前后的数据量及异常值比例。
时间特征提取:从日期列中提取年份、月份、年内天数等特征。
分类变量编码:使用标签编码(LabelEncoder)处理"季节"(season)和"地点"(site)等分类变量,数值特征如年份、月份被保留。
特征工程与编码。所有特征经过标准化处理,确保不同尺度的特征对模型影响均衡。目标变量(降水量)保持原始值,最终形成特征矩阵X和目标向量y。
数据分割与序列化。数据被分为训练集(60%)、验证集(20%)和测试集(20%)。对于时序模型(LSTM、Transformer),数据进一步被转化为序列格式(如10天为一个窗口),每个序列的最后一时间步的降水量作为预测目标,以捕捉时间依赖性。
图4.2处理后部分数据集介绍
4.2CNN模型降水预测
4.2 . 1模型构建
CNN模型搭建采用多尺度特征融合架构,输入层接收预处理特征并重塑为三维张量适配一维卷积,通过三组并行不同核大小(1、3、5、7)的卷积层捕获多粒度特征,结合残差连接与BatchNormalization增强深度网络稳定性;引入自注意力机制动态加权全局池化特征,突出关键模式。经多层全连接层(含Dropout)逐步降维提取高阶交互,最终以线性输出层完成降水量回归预测。编译时采用Adam优化器(低学习率0.0003+梯度裁剪)与Huber损失函数,兼顾精度与鲁棒性。
1.输入层设计
CNN模型通过Input层定义输入形状,匹配预处理后的特征维度(如5个特征)。若输入为一维数据(扁平化特征向量),使用Reshape层转换为二维结构(序列长度×1),使其适配1D卷积操作。这一步确保数据格式与后续卷积层的输入要求一致,为特征提取奠定基础。
2.多尺度并行卷积
模型采用三组不同核大小(1×1、3×3、5×5)的1D卷积层并行处理输入数据,每组64个滤波器。小核(1×1)捕获局部细节,大核(5×5)提取全局模式,通过Concatenate层融合多尺度特征。输出经批量归一化(BatchNormalization)和Dropout(0.1)正则化,增强特征多样性并抑制过拟合。
3.深层卷积与残差连接
第二组卷积扩展至128个滤波器,同样采用多尺度结构。随后引入残差连接(Add):将原始输入通过1×1卷积调整维度后与当前层输出相加。残差结构缓解梯度消失问题,允许训练更深的网络。此部分使用更高的Dropout率(0.15-0.25),逐步加强正则化强度。
4.高层特征提取
第三、四组卷积层进一步增加滤波器数量(256-512个),并引入7×7大核卷积扩大感受野。特征通过二次残差连接与前置层融合,形成跨层级信息传递。此时模型已能同时捕捉局部降水波动和长期气候趋势,输出包含多层次语义表征。
4.多尺度池化与注意力机制
对中间层输出分别进行全局最大池化(GlobalMaxPooling1D)和平均池化(GlobalAveragePooling1D),汇总时空特征。自注意力机制(Dense+Softmax)动态计算特征权重,通过Multiply层加权关键信号,抑制噪声干扰,提升模型对重要气象模式的敏感性。
6.全连接网络设计
拼接所有池化特征后输入全连接网络:包含5个密集层(1024→512→256→128→64单元),每层后接批量归一化和递减的Dropout率(0.5→0.1)。这种"漏斗式"结构逐步压缩特征维度,高阶特征经ReLU激活后,最终由线性输出的单个神经元预测降水量数值。
4.2.2模型训练
CNN模型的训练过程通过ModelTrainer类的train_model方法实现。训练时,使用训练集数据对模型进行更新,并在验证集上监控性能以防止过拟合。训练过程中设置了早停机制以提前终止训练,避免无效的迭代;同时使用学习率衰减和余弦退火调度等策略动态调整学习率,以加速收敛并提高模型的稳定性。此外,通过模型检查点保存训练过程中性能最佳的模型,确保最终得到的模型具有最优的验证性能。具体步骤如下:
优化器和损失函数配置。选择Adam优化器,并设置学习率为0.0003,同时配置了学习率衰减和梯度裁剪等参数,以提高训练过程的稳定性和收敛速度。损失函数选择为Huber损失,它对异常值更鲁棒,能够更好地处理回归任务中的异常数据。
模型编译。使用model.compile方法编译模型,指定优化器、损失函数以及评估指标(如MAE和MSE)。这一步将模型的结构与训练配置相结合,为模型训练做好准备。
模型训练。在ModelTrainer类的train_model方法中,调用model.fit方法对CNN模型进行训练。训练过程中,使用训练集数据进行模型更新,并在验证集上评估模型性能。同时,设置了早停机制和学习率调整策略如学习率衰减和余弦退火调度,以防止过拟合并加速训练过程。此外,还使用了模型检查点来保存训练过程中性能最佳的模型。
图4.3CNN训练流程图
4.3LSTM模型降水预测
4.3 . 1模型构建
LSTM模型的搭建首先定义输入层以接收序列数据,构建两层LSTM层,分别设置单元数为64和32,并在每层后添加Dropout层以防止过拟合。通过两层全连接层进一步提取特征,分别设置单元数为50和25,并继续使用Dropout进行正则化。最后,定义输出层,使用线性激活函数输出预测值,并编译模型,选择Adam优化器和均方误差损失函数。整个过程简洁高效,能够有效处理时间序列数据并进行预测。具体步骤如下:
1.初始化LSTM模型
在LSTMModel类的初始化方法中,接收输入数据的形状作为参数,并调用build_model方法来构建模型。这一步为模型搭建提供了输入数据的维度信息,确保模型能够正确处理输入数据。
2.定义输入层
使用Input层定义模型的输入,输入形状与传入的input_shape参数一致。这一步明确了模型接收的数据格式,为后续的LSTM层处理序列数据做好准备。
3.构建LSTM层
第一层LSTM:定义一个LSTM层,设置单元数为64,return_sequences=True表示该层会返回整个序列,而不仅仅是最后的输出。这允许后续的LSTM层能够接收序列数据并继续处理。
第二层LSTM:再定义一个LSTM层,单元数为32,return_sequences=False表示该层只返回最后的输出。这一步进一步提取序列数据中的特征,并将输出传递给后续的全连接层。
4.添加Dropout层
在每个LSTM层后添加Dropout层,用于防止过拟合。Dropout层会随机丢弃一部分神经元的输出,从而增强模型的泛化能力。
4.构建全连接层
第一层全连接:定义一个Dense层,单元数为50,激活函数为relu。这一步将LSTM层提取的特征进一步加工,提取更高级的特征表示。
第二层全连接:再定义一个Dense层,单元数为25,激活函数为relu。这一步进一步细化特征,为最终的输出做准备。
6.添加Dropout层
在全连接层后再次添加Dropout层,进一步防止过拟合。这一步确保了模型在训练过程中不会过度依赖某些特定的特征,从而提高模型的鲁棒性。
7.定义输出层
定义输出层,使用一个Dense层,单元数为1,激活函数为linear。这一步将模型的输出转换为预测的降水量值,完成了从输入序列到预测值的映射。
8.编译模型
使用model.compile方法编译模型,指定优化器为adam,损失函数为均方误差(mse),评估指标为平均绝对误差(mae)。这一步将模型的结构与训练配置相结合,为模型训练做好准备。
4.3.2模型训练
LSTM模型的训练过程通过早停机制和学习率动态衰减防止过拟合,同时使用模型检查点保存验证损失最小的权重。在训练过程中,模型在训练集和验证集上同时监控损失和MAE指标,最终在测试集上评估性能,输出MSE、MAE、R²等关键指标,确保模型具备稳定性和预测准确性。
1.初始化训练器
通过ModelTrainer类初始化一个训练器对象,用于管理和训练模型。训练器对象内部维护了模型、训练历史、预测结果和性能指标等信息,方便后续对模型进行评估和比较。
2.设置训练回调函数
在train_model方法中,根据模型类型(如LSTM)设置不同的回调函数。对于LSTM模型,设置了早停机制(EarlyStopping)以监控验证集损失并提前终止训练,避免过拟合;同时设置了学习率调整器(ReduceLROnPlateau)以动态降低学习率,加速收敛;还设置了模型检查点(ModelCheckpoint)以保存验证损失最低的模型。
3.调用训练方法
调用train_model方法开始训练LSTM模型。训练过程中,模型会根据训练集数据进行参数更新,并在每个epoch结束时使用验证集数据评估模型性能。训练器会记录每个epoch的损失值和评估指标(如MAE、MSE),以便后续分析训练过程。
4.训练模型
在每个epoch中,模型对训练集数据进行前向传播和反向传播,更新模型参数。验证集上的性能指标(如损失和MAE)会被计算并记录,用于监控模型的训练情况。如果验证集损失在连续多个epoch中没有改善,则触发早停机制,提前终止训练。
4.动态调整学习率
如果验证集损失在连续多个epoch中没有改善,学习率调整器会自动降低学习率。这有助于模型在训练后期更精细地调整参数,避免陷入局部最优解,从而提高模型的收敛速度和性能。
6.保存最佳模型
在训练过程中,模型检查点会监控验证集损失,并在每个epoch结束时保存验证损失最低的模型。即使训练提前终止,也能确保保存的是性能最佳的模型版本。
4.4transformer模型降水预测
4.4 . 1模型构建
Transformer模型能够有效地处理时间序列数据,提取序列中的时间依赖关系,并输出预测结果。整个模型结构结合了多头注意力机制和前馈网络,能够捕捉复杂的特征交互,适用于处理具有时间依赖性的回归问题。模型搭建具体步骤如下:
1.初始化Transformer模型
在TransformerModel类的初始化方法中,接收输入数据的形状作为参数,并调用build_model方法来构建模型。这一步为模型搭建提供了输入数据的维度信息,确保模型能够正确处理输入数据。
2.定义输入层
使用Input层定义模型的输入,输入形状与传入的input_shape参数一致。这一步明确了模型接收的数据格式,为后续的Transformer编码器处理序列数据做好准备。
3.位置编码
通过一个全连接层(Dense)对输入数据进行线性变换,将其映射到一个固定维度的空间。这一步可以看作是一种简化的位置编码方式,为后续的Transformer编码器提供初始特征表示。
4.构建Transformer编码器
定义一个transformer_encoder方法,用于构建单个Transformer编码器单元。每个编码器单元包含以下部分:
多头注意力机制:使用MultiHeadAttention层实现多头注意力机制,允许模型在不同子空间中学习特征的依赖关系。
残差连接与归一化:将多头注意力的输出与输入相加,然后通过LayerNormalization进行归一化处理,增强模型的稳定性和训练效果。
前馈网络:通过两个全连接层(Dense)实现前馈网络,进一步提取特征。
残差连接与归一化:将前馈网络的输出与输入相加,再次通过LayerNormalization进行归一化处理。
4.堆叠Transformer编码器
在build_model方法中,调用transformer_encoder方法两次,堆叠两个Transformer编码器单元。这一步通过多层编码器逐步提取输入序列的高级特征表示。
6.全局平均池化
使用GlobalAveragePooling1D层对Transformer编码器的输出进行全局平均池化操作,将序列数据压缩为固定长度的特征向量。这一步有助于提取序列的整体特征,为后续的全连接层提供输入。
7.构建全连接层
第一层全连接:定义一个Dense层,单元数为50,激活函数为relu。这一步将Transformer编码器提取的特征进一步加工,提取更高级的特征表示。
第二层全连接:再定义一个Dense层,单元数为25,激活函数为relu。这一步进一步细化特征,为最终的输出做准备。
8.添加Dropout层
在全连接层后添加Dropout层,用于防止过拟合。Dropout层会随机丢弃一部分神经元的输出,从而增强模型的泛化能力。
9.定义输出层
定义输出层,使用一个Dense层,单元数为1,激活函数为linear。这一步将模型的输出转换为预测的降水量值,完成了从输入序列到预测值的映射。
10.编译模型
使用model.compile方法编译模型,指定优化器为adam,损失函数为均方误差(mse),评估指标为平均绝对误差(mae)。这一步将模型的结构与训练配置相结合,为模型训练做好准备。
4.4.2模型训练
Transformer模型的训练过程通过ModelTrainer类的train_model方法实现,使用训练集数据对模型进行参数更新,并在验证集上监控性能以防止过拟合。训练过程中设置了早停机制以提前终止训练,避免无效迭代。同时使用学习率调整器动态降低学习率,加速收敛。模型检查点会保存验证损失最低的模型版本。训练完成后,使用测试集数据评估模型性能,计算MSE、MAE等指标,并将训练历史和最佳模型保存到指定路径,确保模型能够在测试数据上表现出良好的预测性能。具体步骤如下:
1.初始化训练器
通过ModelTrainer类初始化一个训练器对象,用于管理和训练模型。训练器对象内部维护了模型、训练历史、预测结果和性能指标等信息,方便后续对模型进行评估和比较。
2.设置训练回调函数
在train_model方法中,根据模型类型设置不同的回调函数。对于Transformer模型,设置了早停机制以监控验证集损失并提前终止训练,避免过拟合;同时设置了学习率调整器以动态降低学习率,加速收敛;还设置了模型检查点以保存验证损失最低的模型。
3.调用训练方法
调用train_model方法开始训练Transformer模型。训练过程中,模型会根据训练集数据进行参数更新,并在每个epoch结束时使用验证集数据评估模型性能。训练器会记录每个epoch的损失值和评估指标(如MAE、MSE),以便后续分析训练过程。
4.训练模型
在每个epoch中,模型对训练集数据进行前向传播和反向传播,更新模型参数。验证集上的性能指标会被计算并记录,用于监控模型的训练情况。如果验证集损失在连续多个epoch中没有改善,则触发早停机制,提前终止训练。
4.动态调整学习率
如果验证集损失在连续多个epoch中没有改善,学习率调整器会自动降低学习率。这有助于模型在训练后期更精细地调整参数,避免陷入局部最优解,从而提高模型的收敛速度和性能。
6.保存最佳模型
在训练过程中,模型检查点会监控验证集损失,并在每个epoch结束时保存验证损失最低的模型。即使训练提前终止,也能确保保存的是性能最佳的模型版本。
7.保存训练历史和模型
训练完成后,训练器会将模型的训练历史保存到self.histories中,并将训练好的模型保存到self.models中。同时,将验证损失最低的模型保存到指定路径(如results/models/best_Transformer_model.keras),以便后续加载和使用。
4.5降水预测实现
用户可以通过选择特定的地点、年份、月份以及年内天数来请求降水量预测,系统会分析输入参数并利用训练好的模型进行计算,最终在界面上显示预测结果,例如预测的降水量数值,以及具体的预测地点和时间信息,为用户提供智能化的降水量预测服务。
本系统以Flask框架搭建Web应用,启动时先调用函数加载预训练的CNN降水预测模型以及数据预处理器,包括用于特征标准化的StandardScaler和用于类别编码的LabelEncoder,为后续预测做准备。若加载失败,会提示检查相关文件。
当用户通过访问应用主页,在前端界面输入预测所需的地点、年份、月份等信息并提交。Flask的predict路由接收请求数据,在predict函数中,先对输入数据进行预处理,如根据月份确定季节、对季节和地点进行编码、构建并标准化特征向量,使其符合模型输入要求。
然后将预处理后的数据输入CNN模型进行预测,得到降水量预测值,确保其为非负数后,把预测结果与输入信息封装成JSON格式返回给前端展示。若过程中出现异常,会捕获并返回错误信息,保障应用的稳定性。
- 模型评估
5.1 特征与降水量相关性分析
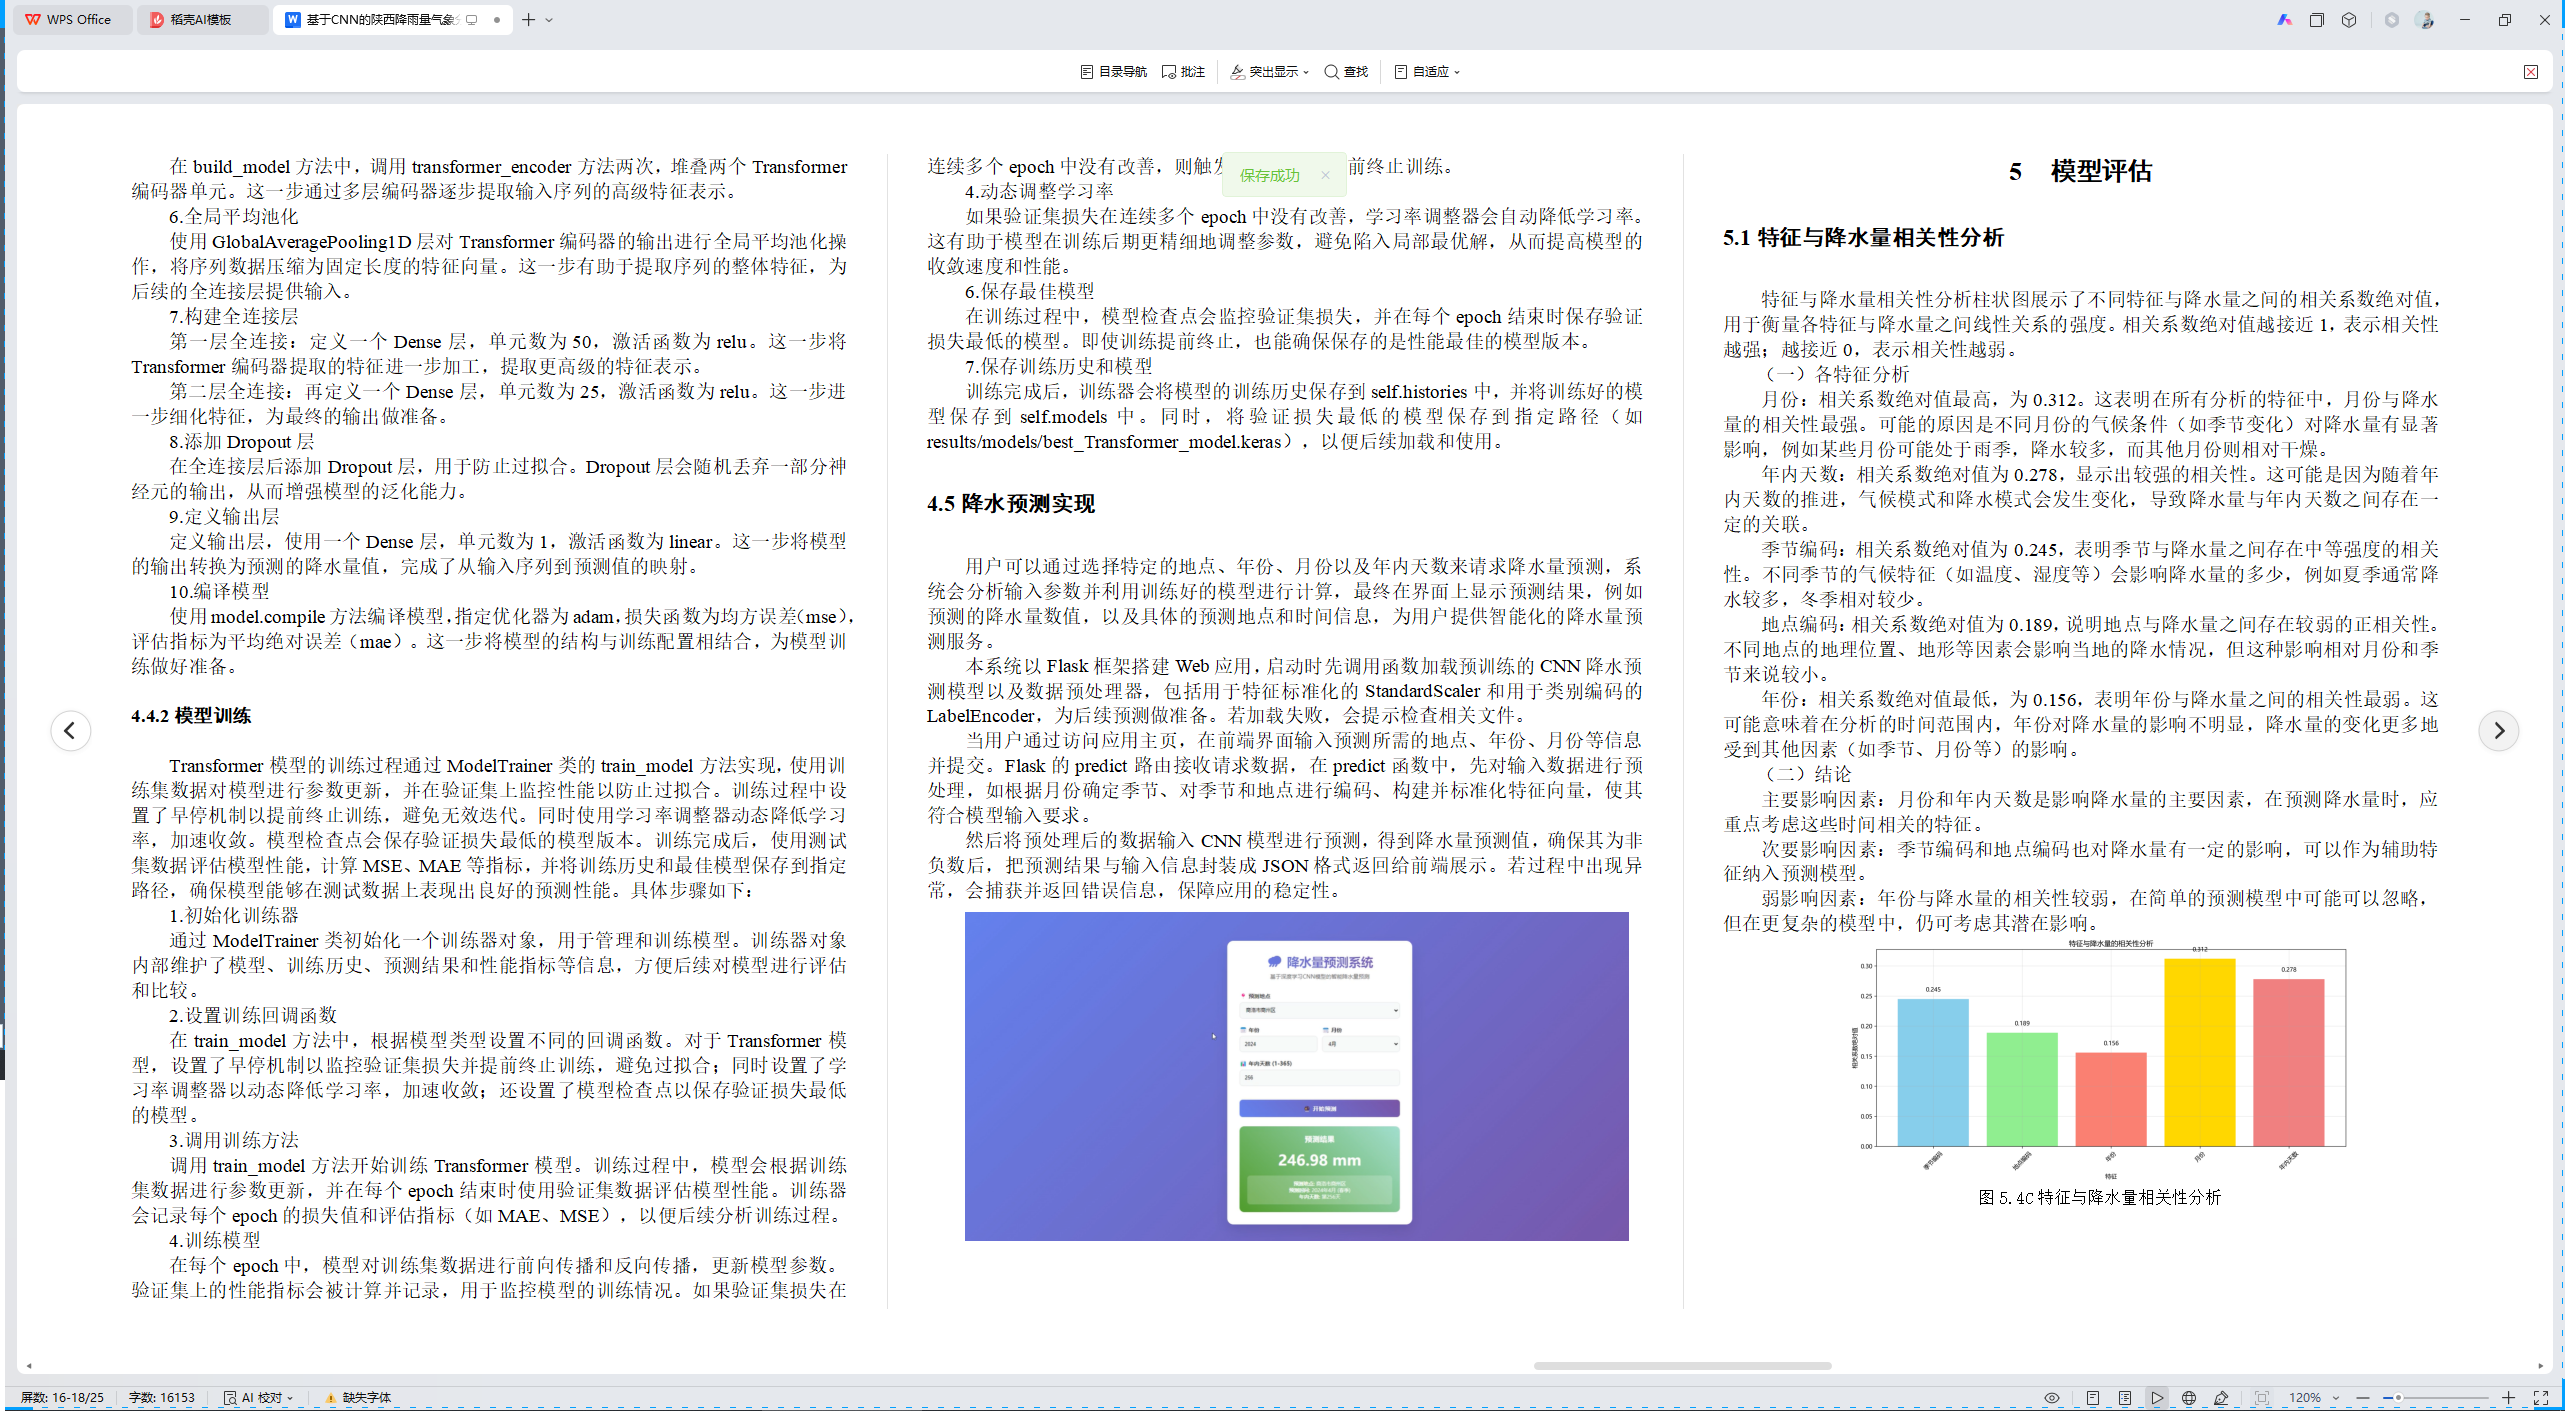
特征与降水量相关性分析柱状图展示了不同特征与降水量之间的相关系数绝对值,用于衡量各特征与降水量之间线性关系的强度。相关系数绝对值越接近1,表示相关性越强;越接近0,表示相关性越弱。
- 各特征分析
月份:相关系数绝对值最高,为0.312。这表明在所有分析的特征中,月份与降水量的相关性最强。可能的原因是不同月份的气候条件(如季节变化)对降水量有显著影响,例如某些月份可能处于雨季,降水较多,而其他月份则相对干燥。
年内天数:相关系数绝对值为0.278,显示出较强的相关性。这可能是因为随着年内天数的推进,气候模式和降水模式会发生变化,导致降水量与年内天数之间存在一定的关联。
季节编码:相关系数绝对值为0.245,表明季节与降水量之间存在中等强度的相关性。不同季节的气候特征(如温度、湿度等)会影响降水量的多少,例如夏季通常降水较多,冬季相对较少。
地点编码:相关系数绝对值为0.189,说明地点与降水量之间存在较弱的正相关性。不同地点的地理位置、地形等因素会影响当地的降水情况,但这种影响相对月份和季节来说较小。
年份:相关系数绝对值最低,为0.156,表明年份与降水量之间的相关性最弱。这可能意味着在分析的时间范围内,年份对降水量的影响不明显,降水量的变化更多地受到其他因素(如季节、月份等)的影响。
- 结论
主要影响因素:月份和年内天数是影响降水量的主要因素,在预测降水量时,应重点考虑这些时间相关的特征。
次要影响因素:季节编码和地点编码也对降水量有一定的影响,可以作为辅助特征纳入预测模型。
弱影响因素:年份与降水量的相关性较弱,在简单的预测模型中可能可以忽略,但在更复杂的模型中,仍可考虑其潜在影响。
图5.4C特征与降水量相关性分析
5.2模型训练历史分析
模型训练历史图表展示了CNN、LSTM和Transformer三种模型在训练过程中的损失(Loss)和平均绝对误差(MAE)变化情况,分别绘制了训练集和验证集的指标曲线。通过对这些曲线的分析,可以评估模型的训练效果、收敛情况以及泛化能力。
- 模型比较
收敛速度:Transformer模型在初始阶段的损失和MAE下降速度最快,表明其收敛速度较快;CNN模型次之;LSTM模型相对较慢。
稳定性:CNN模型的损失和MAE曲线最为平滑,训练过程最为稳定;LSTM模型波动较大,稳定性较差;Transformer模型虽然波动较大,但整体趋势向好。
泛化能力:Transformer模型的验证损失和MAE在某些轮次低于训练损失,表现出较好的泛化能力;CNN模型的泛化能力次之;LSTM模型的泛化能力相对较弱。
- 结论与建议
模型选择:如果注重模型的预测精度和泛化能力,Transformer模型是较好的选择;如果需要更稳定的训练过程,CNN模型可能更合适;LSTM模型在稳定性和泛化能力上相对较弱,可考虑优化或与其他模型结合使用。
优化方向:对于LSTM模型,可以尝试调整学习率、增加训练轮次或使用更复杂的优化器来提高稳定性和预测精度。对于所有模型,可以进一步调整超参数(如批量大小、层数等)以获得更好的性能。
数据增强:可以考虑对训练数据进行增强,以提高模型的泛化能力,尤其是在处理时间序列数据时,数据增强技术可能有助于模型更好地学习数据的特征。
图5.5模型训练历史图
5.3预测值vs实际值
预测值vs实际值图展示三种不同模型(CNN、LSTM、Transformer)预测值与实际值对比的散点图。图中横轴表示实际值,纵轴表示预测值,理想情况下所有点应分布在虚线(y=x)上,即预测值与实际值完全相等。所有模型的预测值与实际值呈现出明显的正相关关系,随着实际值的增加,预测值也相应增加,表明三种模型都能在一定程度上捕捉到数据中的模式和趋势。散点大致分布在虚线附近,说明模型的预测结果与实际值较为接近。
Transformer模型优势明显:从图中可以明显看出,Transformer模型在降水量预测任务中表现最佳,能够更准确地预测实际值,具有较高的预测精度和可靠性。
数据可视化问题:图中LSTM和CNN模型的散点未显示,可能需要检查数据或绘图代码,以确保所有模型的预测结果都能正确展示,从而进行更全面的对比分析。
图5.6预测值vs实际值图
5.4预测误差分布
预测误差分布图展示三种不同模型(CNN、LSTM、Transformer)预测误差分布的柱状图。横轴表示预测误差的范围,从-2.0到1.5;纵轴表示频数,即落在各个误差区间内的样本数量。图例中,红色代表CNN模型,蓝色代表LSTM模型,绿色代表Transformer模型。
Transformer模型表现最佳:从预测误差的分布来看,Transformer模型的误差最小且最为集中,说明其在降水量预测任务中具有较高的准确性和稳定性。
LSTM模型次之:LSTM模型的预测误差分布与Transformer模型类似,但相对稍差一些,仍具有较好的预测性能。
CNN模型相对较差:CNN模型的预测误差分布较为分散,且存在较多极端误差,说明其在该预测任务中的表现不如Transformer和LSTM模型。
图5.7预测误差分布图
5.5模型性能对比图
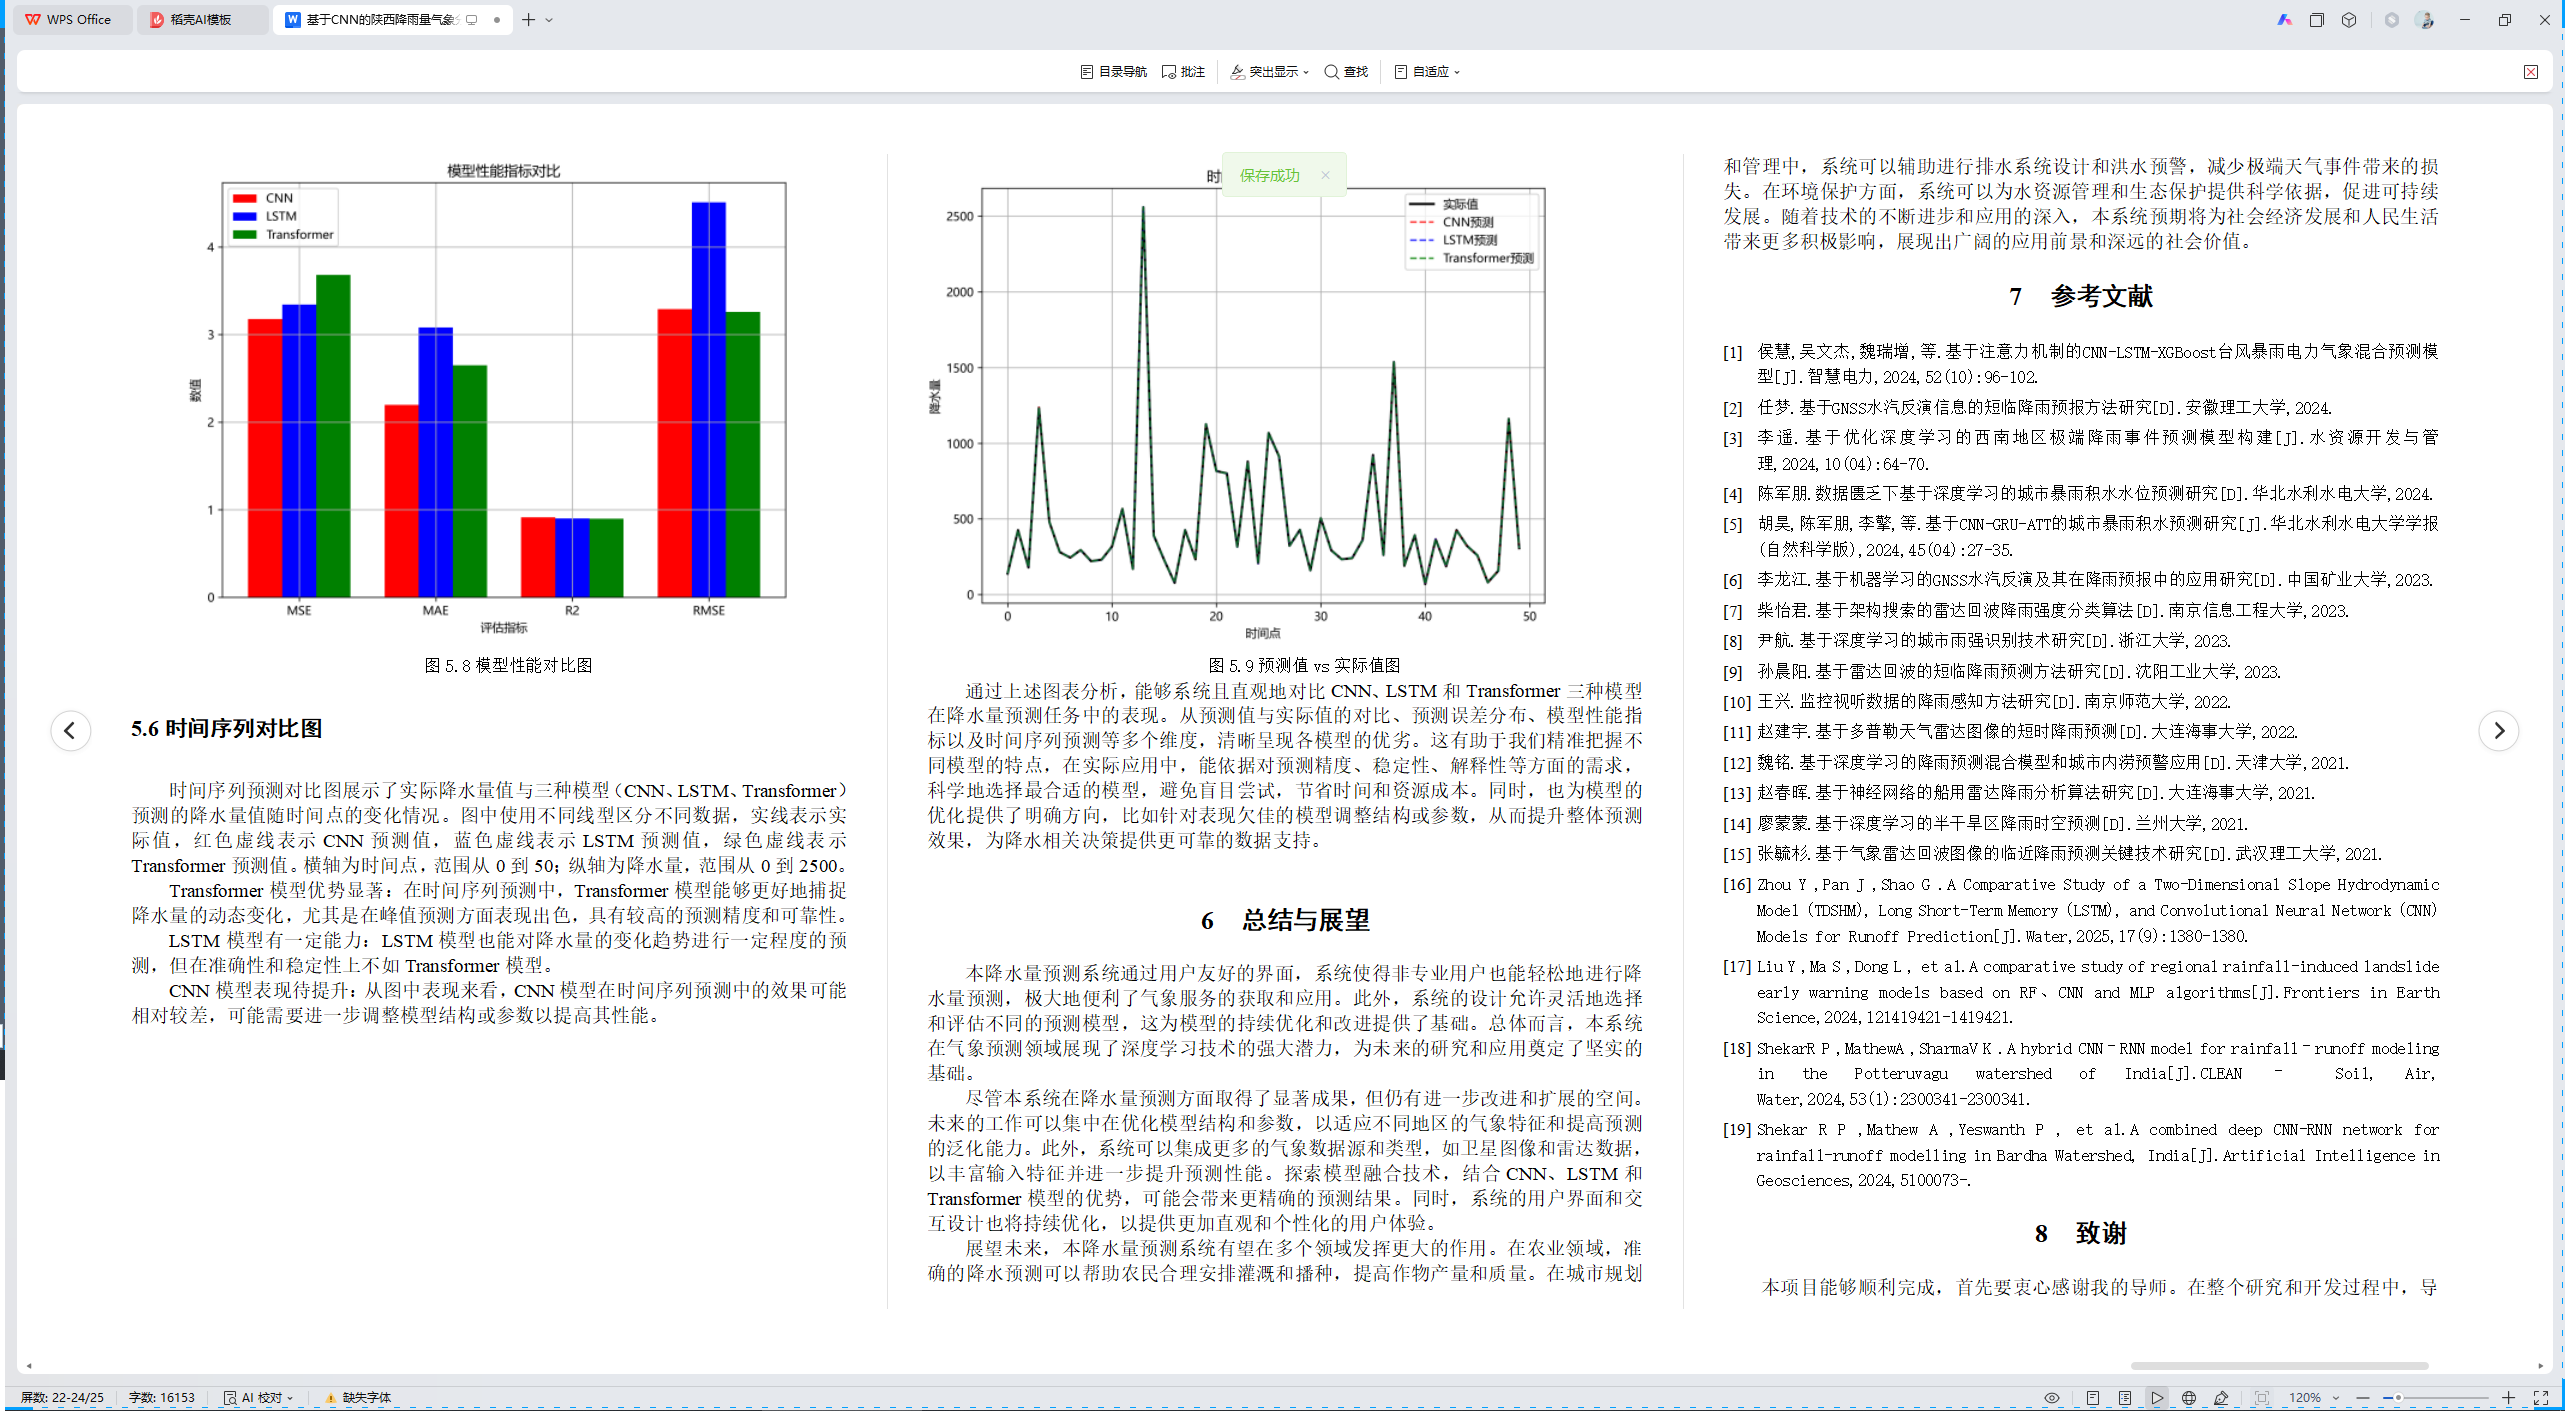
模型性能指标对比图用于对比三种模型(CNN、LSTM、Transformer)在四个评估指标(MSE、MAE、R²、RMSE)上的表现。图中使用不同颜色区分模型:红色代表CNN,蓝色代表LSTM,绿色代表Transformer。横轴表示评估指标,纵轴表示指标数值。
最佳模型:综合来看,Transformer模型在MSE、MAE(根据图中柱子高度判断)、R²和RMSE指标上表现最优,具有最高的预测精度和最强的解释能力。
LSTM模型:在MAE指标上表现较好,但在RMSE指标上表现较差,且R²值较低,说明其在某些方面表现不稳定。
CNN模型:各项指标表现居中,整体预测精度和解释能力不如Transformer模型。
图5.8模型性能对比图
5.6时间序列对比图
时间序列预测对比图展示了实际降水量值与三种模型(CNN、LSTM、Transformer)预测的降水量值随时间点的变化情况。图中使用不同线型区分不同数据,实线表示实际值,红色虚线表示CNN预测值,蓝色虚线表示LSTM预测值,绿色虚线表示Transformer预测值。横轴为时间点,范围从0到50;纵轴为降水量,范围从0到2500。
Transformer模型优势显著:在时间序列预测中,Transformer模型能够更好地捕捉降水量的动态变化,尤其是在峰值预测方面表现出色,具有较高的预测精度和可靠性。
LSTM模型有一定能力:LSTM模型也能对降水量的变化趋势进行一定程度的预测,但在准确性和稳定性上不如Transformer模型。
CNN模型表现待提升:从图中表现来看,CNN模型在时间序列预测中的效果可能相对较差,可能需要进一步调整模型结构或参数以提高其性能。
图5.9预测值vs实际值图
通过上述图表分析,能够系统且直观地对比CNN、LSTM和Transformer三种模型在降水量预测任务中的表现。从预测值与实际值的对比、预测误差分布、模型性能指标以及时间序列预测等多个维度,清晰呈现各模型的优劣。这有助于我们精准把握不同模型的特点,在实际应用中,能依据对预测精度、稳定性、解释性等方面的需求,科学地选择最合适的模型,避免盲目尝试,节省时间和资源成本。同时,也为模型的优化提供了明确方向,比如针对表现欠佳的模型调整结构或参数,从而提升整体预测效果,为降水相关决策提供更可靠的数据支持。