本文分享一篇2026年人工智能领域国际期刊Knowledge-Based Systems发表的论文《TRDA-TS: Text reinforcement and regularized diffusion alignment for LLM-empowered multimodal time series forecasting》。该论文针对大语言模型用于多模态时间序列预测时,外部事件文本利用不足以及文本与数值时序之间存在跨模态错配等问题,提出了TRDA-TS预测框架。该模型首先在数值分支中提取多尺度和多频率时间模式,再通过长期趋势语义聚合机制,将预测时点之前可获得的外部事件重组为精炼的趋势描述,随后利用文本感知正则扩散过程和目标感知跨模态对齐损失完成语义与时序表示的融合。实验结果表明,TRDA-TS在农业、气候、经济、能源、环境、健康、安全、社会公益和交通九个领域的数据集上取得了较好的预测表现,相比先进基线,所有数据集上的平均MSE和MAE分别降低18.22%和12.55%。
论文链接:https://doi.org/10.1016/j.knosys.2026.116790
代码链接:https://github.com/zhaixiao214/TRDA-TS
本推文作者为韩煦,审校为邓镝。
一、研究背景
时间序列预测广泛应用于金融、能源、环境、健康和交通等领域。一个准确的预测模型,不仅需要从历史数值中识别周期变化、局部波动和长期趋势,还需要理解可能推动这些变化的外部事件。例如,能源价格会受到供需信息和政策变化影响,流感比例会受到季节性疾病报告影响,交通量也可能受到出行趋势和突发事件影响。如果仅依赖历史数值序列,往往难以完整刻画这些外部驱动因素。
近年来,大语言模型逐渐被用于时间序列预测,但已有研究更多关注提示词设计,或者把数值序列转换为文本后输入LLM。对于带有时间戳的外部事件文本,现有方法仍面临两个问题。一方面,不同时刻的文本往往包含大量零散事件,直接输入模型容易使长期趋势被短期的噪声淹没;另一方面,文本表示与数值时序表示具有不同的结构,简单拼接或直接注意力融合容易造成语义错配。因此,如何从外部文本中提取与预测目标有关的趋势信息,并将其稳定地对齐到数值时序空间,是本文重点解决的问题。
二、研究方法
论文提出的TRDA-TS框架主要包含三个部分。一是时序域建模模块,用于提取数值序列中的多频率和多尺度变化模式。二是长期趋势语义聚合模块,用于将多个时间片中的外部事件整理为面向预测的趋势文本。三是跨模态融合模块,通过正则扩散和目标感知约束,将文本信息稳定地映射到未来预测位置。数值分支与文本分支分别完成特征提取,再由融合模块生成最终的多步预测结果。
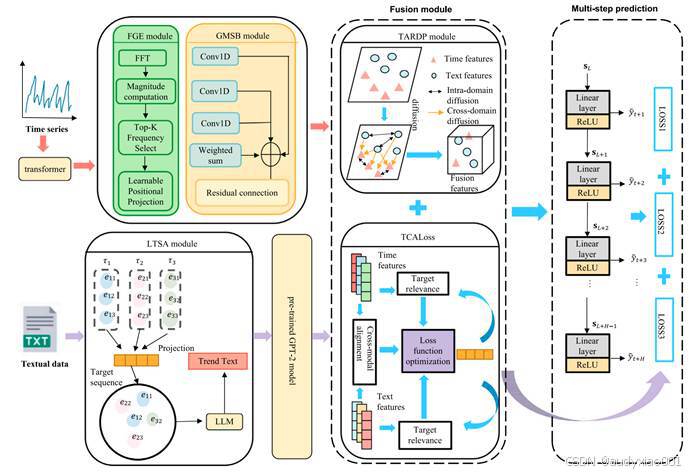
图 1 TRDA-TS 总体框架
2.1多频率与多尺度时序建模
数值时间序列中通常同时存在长期趋势、周期模式和短时扰动。TRDA-TS首先设计了频率引导嵌入模块FGE。该模块对输入序列进行快速傅里叶变换,根据幅值选取前k个主要频率分量,再通过多层感知机把频域信息投影回时间嵌入空间。这样得到的频率先验会与数值嵌入和位置编码相加,使模型在进入Transformer之前,就能够感知序列中的主要周期。
为了进一步补充Transformer对局部变化建模不足的问题,论文又设计了全局多尺度模块GMSB。该模块使用卷积核大小为1、3和5的并行一维卷积分支,从不同感受野提取局部特征,并通过可学习的门控权重完成融合。融合结果以残差方式返回原表示,使时序分支能够同时保留局部波动和较大范围的趋势信息。经过编码器和解码器后,模型得到与未来各预测位置对应的时序表示。
2.2长期趋势语义聚合模块
文本分支的核心是LTSA,也就是长期趋势语义聚合。对于每一个预测起点,LTSA只保留观测窗口内、发布时间不晚于该预测起点的外部事件文本,并屏蔽预测区间中的全部文本,避免未来信息泄漏。保留下来的事件先由冻结的BERT编码,再结合时间衰减、语义方向一致性和因果时间掩码计算权重。距离预测时点更近且与总体趋势方向更一致的事件会获得更高权重,相反方向的事件则起到反向作用。
在此基础上,LTSA计算每条事件对当前趋势状态的贡献,并选取贡献最高的若干事件,按照时间顺序组织到固定提示模板中。LTSA以离线方式完成文本构建并进行缓存。外部语言模型仅调用一次,生成趋势描述、关键观察事件和关键驱动短语。用于下游预测时,模型保留趋势描述和驱动短语,并在之后附加数值序列的文本化上下文,再交给冻结的GPT-2生成文本表示。
2.3文本感知正则扩散过程
得到时序表示和文本表示后,模型还需要解决两个模态之间的结构差异。论文提出文本感知正则扩散过程,先把两类表示投影到同一维度,再分别构建时序域和文本域的相似度图。同时,模型建立一个文本节点到未来预测位置的矩阵,用来描述每个文本token与每个预测位置之间的相关程度。在两个模态各自的内部结构约束下,反复更新跨模态矩阵。只有当文本节点和时序节点在各自邻域中都具有一致结构时,它们之间的对应关系才会被增强。扩散结束后,矩阵经过转置和归一化,为每一个预测位置聚合相关的文本上下文,再与原时序表示拼接并投影到预测空间。相比简单拼接或孤立的点对点匹配,这一过程能够降低相关文本节点对预测结果的干扰。
2.4目标感知跨模态对齐与预测
为了使两种模态在共享空间中保持稳定,论文进一步设计了TCALoss损失函数。该损失函数先分别对时序序列和文本token进行全局池化,通过表示距离限制两个模态之间过大的整体差异。同时,又把两类表示投影到预测空间,要求它们保留与真实预测目标有关的信息。TCALoss损失函数在保留各自结构的同时,同时使共同的预测因素在潜在空间中保持兼容。
最终训练目标由预测MSE和TCALoss共同组成。训练过程中,时序分支、跨模态融合模块、投影层和预测头参与参数更新,离线LTSA文本构建过程以及GPT-2编码器保持冻结。这样既保留了预训练语言模型的文本表示能力,也避免了对大模型进行完整微调带来的额外开销。
三、实验结果
为了验证TRDA-TS的有效性,论文在Time-MMD-LTSA数据集上进行了实验。该数据集覆盖农业、气候、经济、能源、环境、健康、安全、社会公益和交通九个领域,采样频率包括日、周和月。模型统一使用过去24个时间步作为输入,并根据采样频率设置不同的预测跨度。评价指标包括MSE和MAE。对比模型包括Timer-XL、TimeCMA、GPT4MTS、DLinear、iTransformer、Crossformer、PatchTST和FreTS。除TimeCMA和GPT4MTS外,其余基线均使用相同的冻结GPT-2文本编码器和简单拼接融合头,以减少文本输入设置不同带来的影响。
3.1与基线模型的性能对比
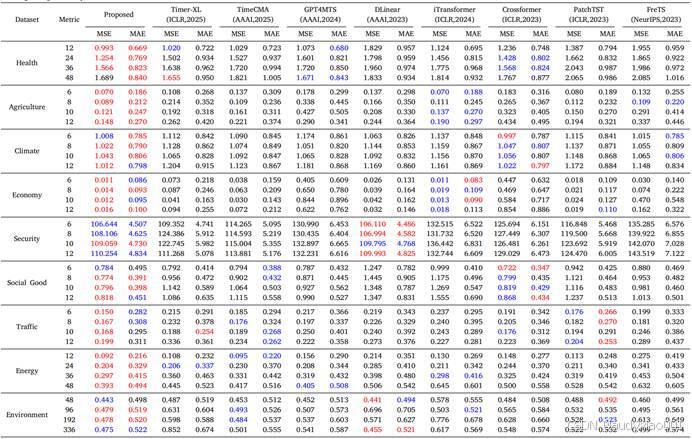
如表1所示,TRDA-TS在九个数据集中的四个数据集上取得了最优MSE,并在多数设置中保持最优或次优表现。该方法在健康、农业、气候、经济和能源等具有明显长期趋势或外部语义驱动的数据上优势较为稳定。例如,在农业数据集12步预测中,TRDA-TS的MAE为0.270,相比Timer-XL的0.420和TimeCMA的0.374分别降低35.7%和27.8%。在健康数据集上,该方法在四个预测跨度下均取得最低MAE。
在社会公益数据集12步预测中,TRDA-TS的MAE为0.451,低于GPT4MTS的0.527、FreTS的0.501和PatchTST的0.513。对于更偏向短期局部波动的安全数据集,TRDA-TS在部分预测跨度上略低于DLinear,但仍优于多数基线。综合所有数据集,论文报告TRDA-TS相较先进方法的平均MSE和MAE分别降低18.22%和12.55%,说明外部文本的趋势化处理和结构化融合能够为数值预测提供有效补充。
表 1 TRDA-TS 与基线模型的长期预测性能对比
3.2 文本处理与融合方式对比
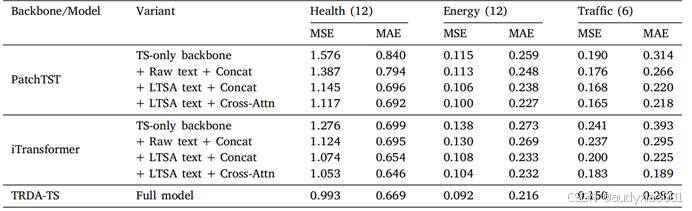
论文进一步在PatchTST和iTransformer上构造了版本。所有版本使用相同的历史数值输入、文本来源、冻结GPT-2和预测头,仅改变文本处理和融合方式。结果显示,在纯时序模型上加入原始文本后,多数数据集的误差已经下降;将原始文本替换为LTSA生成的趋势文本后,性能进一步提高。例如,健康数据集上,PatchTST的MSE从1.387下降到1.145,iTransformer从1.124下降到1.074。
在LTSA文本基础上使用标准交叉注意力,只带来相对有限的进一步改善。完整TRDA-TS在健康、能源和交通三个代表性数据集上的MSE分别为0.993、0.092和0.150,均优于对应的拼接和交叉注意力版本。这说明模型的收益并非只来自加入文本,而是来自LTSA趋势重组、TARDP结构扩散和TCALoss对齐约束的共同作用。对比如表2所示。
表 2 不同文本处理与跨模态融合方式的性能对比
3.3 文本有效性与因果约束分析
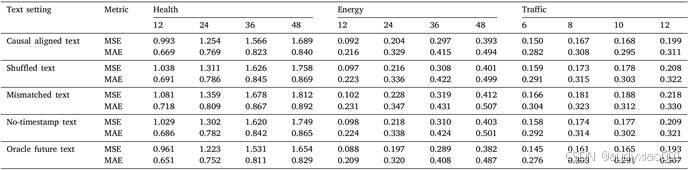
为了分析外部文本在什么情况下可能失效,论文比较了因果对齐文本、时间顺序打乱文本、样本错配文本、去除时间戳文本和使用未来文本的诊断设置。如表3所示在健康数据集上,标准因果对齐文本的四个预测跨度平均MSE为1.376。打乱时间顺序后升至1.433,替换为其他样本的文本后升至1.483,去除时间戳后升至1.425。能源和交通数据集也呈现相同趋势。
其中,样本错配带来的下降最明显,说明错误的语义对应关系比同一样本中的文本噪声更容易破坏预测。加入预测区间内的未来文本可以进一步降低误差,但这一设置只用于说明未来事件包含额外预测信号,并不是有效的真实预测方案。该实验同时说明,外部文本只有在时间上可用、与当前样本匹配,并保留明确时间结构时,才能稳定改善多模态预测。
表 3 不同文本有效性与因果约束设置下的诊断结果
3.4 消融实验与效率分析
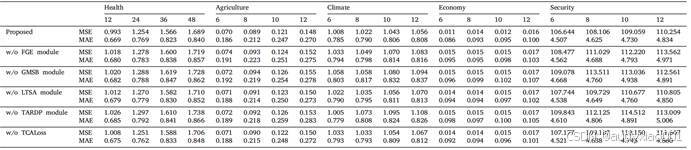
表4展示了消融实验的结果。消融实验显示,移除FGE、GMSB、LTSA、TARDP或TCALoss后,模型在多个数据集和预测跨度上的误差都会上升。FGE主要影响周期性明显的数据,GMSB负责补充局部和多尺度变化,LTSA决定外部事件能否形成紧凑的长期趋势表示。TARDP的影响较为明显,以健康数据集12步预测为例,去掉TARDP后MSE从0.993上升到1.026。去掉TCALoss也会使整体性能下降,说明跨模态全局兼容性和目标相关性约束具有实际作用。
论文还比较了BERT、GPT-2、LLaMA-3-8B和Mistral-7B作为下游文本编码器的结果。不同数据集对应的最优模型并不相同,更大或更新的语言模型没有形成一致优势。GPT-2在交通数据集上的平均MSE最低,并在计算成本与预测精度之间保持较好的平衡。效率实验同样表明,TRDA-TS的推理时间和显存开销低于GPT4MTS和Timer-XL,同时在预测跨度增加时保持相对稳定的误差变化。
表 4 TRDA-TS 核心模块的消融实验结果
四、总结
本推文介绍了一种面向多模态时间序列预测的LLM框架TRDA-TS。该方法的核心思想是先通过频率引导嵌入和全局多尺度模块提取数值序列中的周期、局部变化和长期依赖,再利用LTSA从预测时点之前可获得的外部事件中生成趋势描述和关键驱动短语,最后通过TARDP和TCALoss完成文本语义与未来预测位置之间的结构化对齐。实验结果表明,TRDA-TS在九个不同领域的数据集上取得了较好的综合表现,文本有效性分析和消融实验进一步验证了趋势文本构建、因果时间约束和跨模态扩散融合的作用。