引子:主流多智能体系统的潜规则是「有个 Boss」------编排者(orchestrator)拆分任务、下发、回收结果。Codex sub-agent、Claude Code sub-agent 都是这个结构。但当 Agent 数量冲到上千,这个 Boss 自己成了瓶颈。微软研究院 9 月 22 日放出的 Agensh(arXiv 2609.26781)干了一件激进的事:把中心调度器彻底删掉,让 1024 个编码 Agent 只通过「共享状态」自组织协作。结果很刺激------pandoc 重建任务上通过率从 33.89% 拉到 55.06%。但更耐人寻味的,是那条到后面越来越平的增长曲线:加 8 倍 Agent,只多拿 4 个点。
一、旧范式的原罪:编排者-工作者结构的天花板
多智能体 Harness 的默认形态是「编排者-工作者(orchestrator-worker)」:一个中央协调者把大任务拆成子任务,分发给工作者,再整合它们的产出。它在几十个 Agent 规模下很好用,但有两个绕不开的硬伤:
- 协调容量是串行瓶颈:编排者必须跟踪所有工作者的进度、解决依赖、合并贡献。工作者越多,它的管理开销越大,最终其吞吐决定了整个系统的上限。
- 单点脆弱性:一旦编排者策略失当(拆错、合并错),所有工作者的努力可能一起报废;而且它把「全局一致性」押在一个中心节点的判断上。
当系统从「几十个」扩到「成百上千个」,这两个问题会从「不舒服」变成「致命」。Agensh 的核心赌注是:与其给 Boss 扩容,不如把 Boss 删了。
二、Agensh 的原理:没有 Boss,只有共享状态
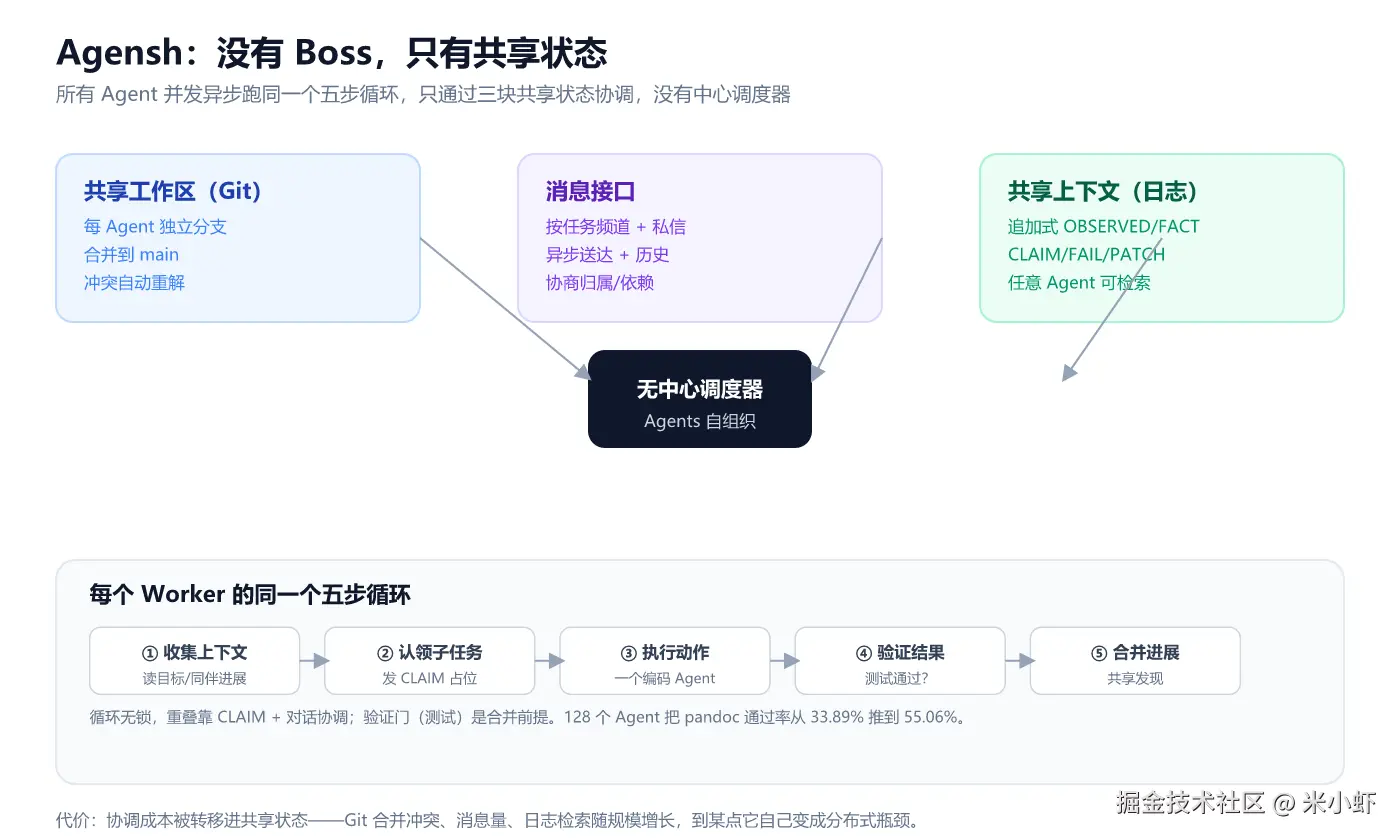
Agensh 去掉了中央编排器,让所有工作者并发、异步运行,彼此只通过三块「共享状态」协调:
css
                 ┌───────────── 共享工作区(Git)─────────────┐
                 │  每 Agent 独立分支 → 合并 main → 冲突重解   │
   Agent A ──────┤                                           ├──────┐
   Agent B ──────┤  消息接口:按任务频道 + 私信,异步 + 历史   │      │
   Agent C ──────┤                                           │      │
        ...        │  共享上下文:追加式日志 OBSERVED/FACT/      │      │
   Agent N ──────┤  CLAIM/FAIL/PATCH_SUMMARY,任意 Agent 可检索│      │
                 └───────────────────────────────────────────┘
↑ 无中心调度器,协调成本被推进共享状态每个工作者跑的是同一个五步循环,无锁、靠声明(CLAIM)+ 对话解决重叠:
- 收集上下文:读共享目标、当前状态、同伴进展、累积发现,弄清哪些待做;
- 认领子任务:发一条 CLAIM 声明自己要做的范围(占位,避免撞车);
- 执行动作:一个独立的编码 Agent 去干活;
- 验证结果:对照该子任务的验收标准跑测试,通过才继续;
- 合并进展:把改动合并进共享代码,并发布「改了什么、为什么」。
「啊哈」时刻 :传统架构把协调成本压在一个中心节点上;Agensh 把它摊进了共享状态(Git 仓库、消息频道、上下文日志)。因为没有串行瓶颈,组织理论上能随 Agent 数量线性扩展------只要共享状态撑得住。
三、N 个优势(都用数据说话)
任务用的是 ProgramBench:给一个已编译程序,要求 6 小时内、断网从零重建出行为一致、能编译的代码,分数是隐藏测试通过率。最难的五道题用 GPT-5.6-sol(高推理强度)跑:
| Agent 数量 | 五道难题均值通过率 | 相对前一级增量 |
|---|---|---|
| 1 | 19.31% | --- |
| 8 | 20.68% | +1.37 |
| 32 | 26.52% | +5.84 |
| 128 | 28.78% | +2.26 |
从 1 到 128 个 Agent,均值提升约 9.5 个点,相对 +49%。
pandoc 文档转换任务(唯一跑到 1024 的规模)更直观:
| Agent 数量 | pandoc 通过率 |
|---|---|
| 1 | 33.89% |
| 8 | 41.75% |
| 32 | 43.11% |
| 128 | 50.94% |
| 1024 | 55.06% |
还有两个容易被忽略但更实用的数字:
- 时间维度收益最大 :128 个 Agent 在 30 分钟就达到 30% 通过率;32 个要 60 分钟;8 个要 90 分钟。并行真正买到的是「更快到达可用水位」,而不是只抬天花板。
- 涌现协作:论文记录到 Agent 会自发形成协作惯例,规模变大后甚至涌现出「整合者」之类的角色------这是设计之外的发现,不是写死的。
四、理想丰满,现实骨感:N 个工程死结
- 收益严重次线性、且变平 :从 128 到 1024(8 倍 Agent),pandoc 只多了约 4 个点。每多买一个点的成本急剧上升------规模不是免费的。
- 缺一个关键数字:每点的 token 成本 :论文没给出「每个通过率点花了多少 token / 多少钱」。1024 个前沿模型 Agent 跑 6 小时,账单一目了然地贵。没有和「同等开销下的强编排基线」做成本归一化对比,所以「去中心化更划算」这条结论本身并未被证明------只证明了「天花板更高、到达更快」。
- 评测面窄:五道 ProgramBench 难题 + 一个 pandoc,单一模型(GPT-5.6-sol)、6 小时预算。能否推广到需要强全局一致性、或验收标准模糊的任务,证据不足。
- 共享状态会反噬:协调成本只是被「挪了位置」。Git 合并冲突、消息洪流、上下文日志检索,全都随 Agent 数增长------到某个规模,这个分布式「共享状态」自己会变成新的瓶颈,正是当年那个中心编排器被删掉的原因的分布式翻版。
- 验证门是命门:合并前提是「测试通过」。如果测试弱(覆盖不全、互相独立),两个冲突的补丁可能都「通过」却一起搞垮整体。去中心化放大了「弱验收」的破坏性。
五、生产现实:真正值得用在哪里
markdown
你的任务能拆成「可独立验收的子块」吗?
├─ 否(需要单一连贯设计 / 强全局一致性)→ 别用,共享状态会互相踩
└─ 是 → 你卡的是延迟还是天花板?
         ├─ 卡延迟(硬时间预算)→ Agensh 类是首选,并行买到的就是时间
         └─ 卡天花板但成本敏感 → 谨慎,次线性收益会让账单失控
你还提供得了好测试吗?
├─ 否(验收模糊)→ 验证门失效,合并即灾难
└─ 是 → 可以上,并盯紧「每点成本」而非只看通过率
什么场景赚 :任务可分解为独立子任务、且每个子任务有可测验收(代码重建、格式转换、仓库级改动);有硬延迟约束或时间预算;能接受大量并行前沿 Agent 的开销。 什么场景亏:成本天花板很紧(次线性收益注定贵)、任务需要统一架构决策而非独立补丁、或你给不出可靠测试(验证门形同虚设)。
六、我的判断
「Agent 数量是一个新的 scaling 维度」这句话没错,但它和所有 scaling 一样,曲线会变平 。Agensh 真正的贡献不是「更多 Agent」,而是架构:用去中心化 + 共享状态,移除了编排者那道串行天花板,从而打开了一个新的规模区间。
对从业者更实在的启示是:多智能体系统的瓶颈,会从「单个编排器的能力」转移到「共享状态基础设施的质量」------你的 Git 合并策略、消息路由、上下文检索,才是下一阶段的工程主战场。别只盯着「加多少个 Agent」。
最值得盯的下一个信号:在成本归一化(每通过率点的开销)下,去中心化是否还能赢;以及随团队变大,涌现的角色专业化能否被显式利用,把「自组织」变成可预测的「自分工」。
参考与数据来源:arXiv 2609.26781(Agensh: Scaling Organizational Intelligence to 1,024 Agents,Microsoft Research,Zhan/Song/Dong 等,2026-09-22 提交,预印本未 peer-review);项目页 aka.ms/Agensh。关键数字(ProgramBench 19.31%→28.78%、pandoc 33.89%→55.06%、时间-水位对比、涌现协作)来自论文正文与公开解读。评测基于 GPT-5.6-sol、6 小时断网预算、ProgramBench 五道难题 + pandoc,成本归一化对比论文未给出。本文为技术解读,落地前请以原论文与你的实测为准。