文章目录
-
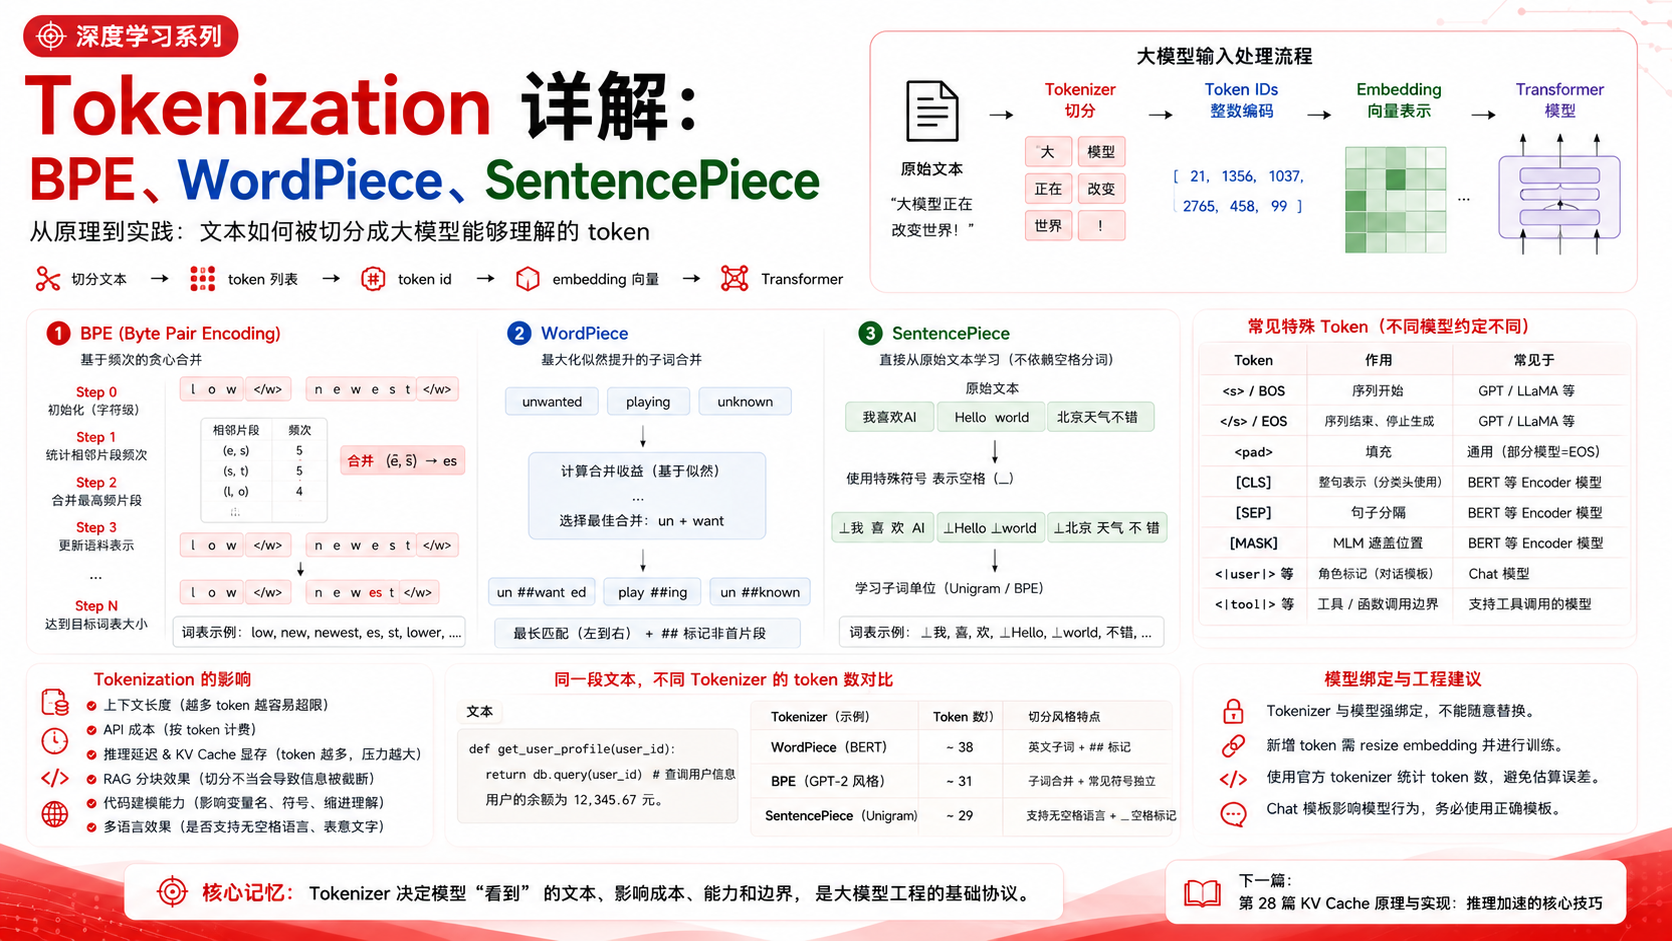
- [一、token、token id、vocab 和 embedding 的关系](#一、token、token id、vocab 和 embedding 的关系)
- 二、为什么不能直接按词切分
- 三、BPE:从字符开始,不断合并高频片段
- 四、WordPiece:不只看频次,还看合并价值
- 五、SentencePiece:不依赖空格分词
- [六、token 数为什么影响成本和上下文](#六、token 数为什么影响成本和上下文)
- [七、特殊 token:模型协议的一部分](#七、特殊 token:模型协议的一部分)
- [八、tokenizer 和模型为什么绑定](#八、tokenizer 和模型为什么绑定)
- [九、tokenizer 对 RAG 和代码模型的影响](#九、tokenizer 对 RAG 和代码模型的影响)
- 十、常见误区
- 总结
- 大模型视角
- 下一篇
摘要:大模型处理的不是"字"或"词",而是 token。Tokenization 决定一段文本会被切成多少 token,直接影响上下文长度、API 成本、训练效率、KV Cache、RAG 分块、代码能力和多语言效果。本文从"为什么不能直接按词切分"讲起,解释 token、token id、vocab、embedding 的关系,再用可运行的小实验讲清 BPE、WordPiece、SentencePiece 的直觉,最后讨论特殊 token、chat template、token 成本和 tokenizer 绑定模型的工程边界。
前置知识 : Embedding, Transformer, GPT 路线
阅读时间 :约 55-70 分钟
代码环境:Python 3.10+,示例只依赖标准库
入门导读:先抓住主线
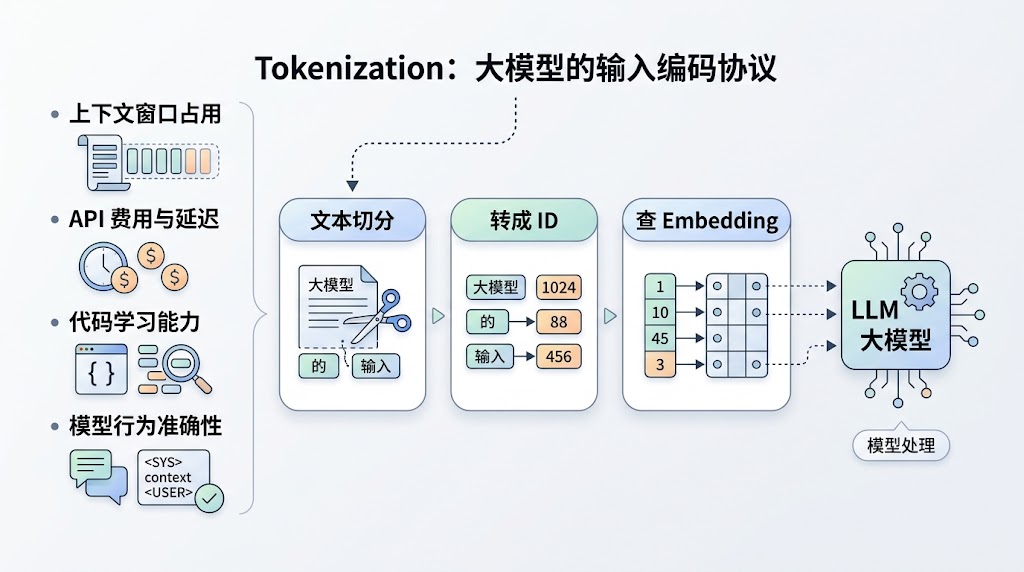
如果你第一次读 Tokenization,把它理解成"大模型的输入编码协议"。文本必须先被切成 token,再转成 token id,最后查 embedding 表,模型才能处理。
Tokenization 看起来像预处理,实际上会影响很多工程问题:
text
同样一篇文档,token 数越多,上下文越容易不够;
同样一个 API,token 数越多,费用和延迟越高;
同样一段代码,切分越差,模型越难学习变量和符号;
同样一个 chat 模型,模板和特殊 token 错了,行为就可能错。
读完本文,你应该能回答:token 是什么,BPE/WordPiece/SentencePiece 大概怎么构建词表,为什么不能随便替换 tokenizer。
一、token、token id、vocab 和 embedding 的关系
大模型不能直接处理字符串。输入文本要经过下面流程:
text
文本 -> tokenizer -> token 列表 -> token ids -> embedding vectors -> Transformer几个概念要分清:
| 概念 | 含义 |
|---|---|
| token | tokenizer 切出来的文本片段,可以是字、子词、词、符号或字节片段 |
| token id | token 在词表里的整数编号 |
| vocab | tokenizer 的词表,记录 token 到 id 的映射 |
| embedding | 模型中每个 token id 对应的向量 |
一个玩具例子:
python
# Python 3.10+

vocab = {
    "<pad>": 0,
    "大": 1,
    "模型": 2,
    "很": 3,
    "强": 4,
}

tokens = ["大", "模型", "很", "强"]
ids = [vocab[t] for t in tokens]
print(tokens)
print(ids)
真实 tokenizer 的词表可能有几万到几十万个 token。模型的 embedding 表行数通常等于词表大小。token id 不是随便编号,它和模型参数绑定。
二、为什么不能直接按词切分
按词切分听起来直观,但很快会遇到问题:
text
英文有 run/running/runner/runs 等词形变化;
中文没有天然空格;
代码有变量名、缩进、括号、路径;
新词、产品名、人名、术语不断出现;
emoji、URL、数字、公式很难按词处理;
如果每个词都进词表,词表会巨大。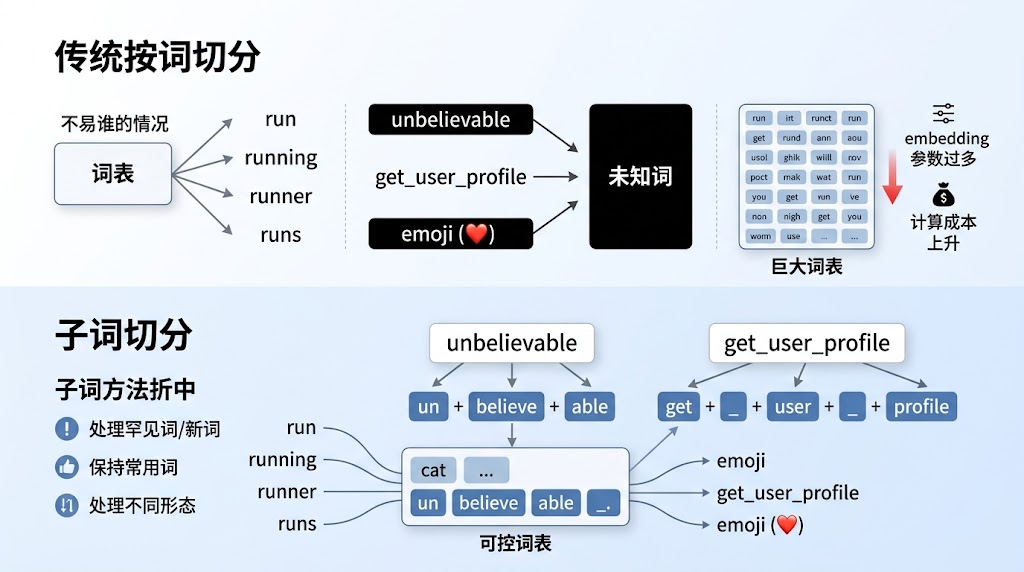
如果词表太小,很多词会变成 unknown;如果词表太大,embedding 和输出层参数会变多,训练和推理成本上升。
子词切分是折中:常见词可以整体表示,罕见词拆成更小片段。例如:
text
unbelievable -> un + believe + able
get_user_profile -> get + _ + user + _ + profile
子词方法既能处理新词,又能控制词表大小。
三、BPE:从字符开始,不断合并高频片段
BPE(Byte Pair Encoding)的大致思路是:先把文本拆成很小单位,再反复合并最常见的相邻片段。
流程:
text
1. 初始词表:字符或字节;
2. 统计语料中相邻片段的频率;
3. 选择最常见的一对合并成新 token;
4. 更新语料表示;
5. 重复直到达到目标词表大小。
用一个极简 BPE 训练过程演示。下面不是生产级 tokenizer,只展示合并思想:
python
# Python 3.10+
from collections import Counter


def get_pairs(words):
    pairs = Counter()
    for symbols, freq in words.items():
        for a, b in zip(symbols, symbols[1:]):
            pairs[(a, b)] += freq
    return pairs


def merge_pair(words, pair):
    merged_words = {}
    bigram = "".join(pair)
    for symbols, freq in words.items():
        new_symbols = []
        i = 0
        while i < len(symbols):
            if i < len(symbols) - 1 and (symbols[i], symbols[i + 1]) == pair:
                new_symbols.append(bigram)
                i += 2
            else:
                new_symbols.append(symbols[i])
                i += 1
        merged_words[tuple(new_symbols)] = freq
    return merged_words

words = {
    tuple("low") + ("</w>",): 5,
    tuple("lower") + ("</w>",): 2,
    tuple("newest") + ("</w>",): 6,
    tuple("widest") + ("</w>",): 3,
}

for step in range(5):
    pairs = get_pairs(words)
    best = pairs.most_common(1)[0][0]
    print("step", step, "merge", best)
    words = merge_pair(words, best)
    print([" ".join(w) for w in words])
观察输出,你会看到高频相邻片段逐步变成更长 token。BPE 的核心就是让常见片段短路径表示,罕见词仍可拆开。
四、WordPiece:不只看频次,还看合并价值
WordPiece 和 BPE 很像,也构建子词词表。但 WordPiece 在选择合并时更关注合并后对语言模型似然的提升,常见解释中会考虑片段之间的统计关联,而不是只看相邻频次。
BERT 使用 WordPiece。你经常会看到 ## 前缀:
text
unwanted -> un ##want ##ed
playing -> play ##ing
## 表示这个子词不是词开头,而是接在前面片段后面。
可以用一个简单规则模拟 WordPiece 的输出风格:
python
# Python 3.10+

vocab = {"un", "want", "ed", "play", "ing", "##want", "##ed", "##ing"}


def toy_wordpiece(word):
    pieces = []
    start = 0
    while start < len(word):
        found = None
        for end in range(len(word), start, -1):
            piece = word[start:end]
            candidate = piece if start == 0 else "##" + piece
            if candidate in vocab:
                found = candidate
                break
        if found is None:
            return ["[UNK]"]
        pieces.append(found)
        start = end
    return pieces

for w in ["unwanted", "playing", "unknown"]:
    print(w, "->", toy_wordpiece(w))
这个 toy tokenizer 很粗糙,但能说明 WordPiece 的两个特点:最长匹配和非开头子词标记。
五、SentencePiece:不依赖空格分词
SentencePiece 常用于多语言模型。它的一个重要特点是:可以直接从原始文本训练 tokenizer,不需要先按语言规则分词;空格也会作为普通符号处理。
这对中文、日文、多语言混合文本很有帮助,因为不是所有语言都有天然空格。
SentencePiece 常用特殊符号表示空格,例如 ▁。直觉上:
text
Hello world -> ▁Hello ▁world
我喜欢AI -> ▁我 喜欢 AI
下面用一个简化函数模拟"把空格显式保留"的直觉:
python
# Python 3.10+

texts = ["Hello world", "我 喜欢 AI", "北京weather不错"]
for text in texts:
    marked = "▁" + text.replace(" ", " ▁")
    print(text, "->", marked)
真实 SentencePiece 有 Unigram 或 BPE 等训练算法,这里不展开。入门阶段先抓住:它把原始文本统一看待,适合多语言和无空格语言。
六、token 数为什么影响成本和上下文
模型上下文长度按 token 计,不按字符计。如果上下文是 8K token,系统提示、用户输入、历史对话、检索文档、工具结果、模型输出都要共享这 8K 预算。
token 数会影响:
text
1. API 费用;
2. prefill 延迟;
3. KV Cache 显存;
4. RAG 能放多少证据;
5. 训练样本长度;
6. batch size 和吞吐。
用一个粗略 tokenizer 对比不同文本:
python
# Python 3.10+
import re

pattern = r"[A-Za-z_][A-Za-z0-9_]*|\d+(?:\.\d+)?|[\u4e00-\u9fff]|[^\s]"

samples = [
    "大模型正在改变软件开发。",
    "Large language models are changing software development.",
    "def get_user_profile(user_id): return db.query(user_id)",
    "退款金额为12,345.67元,状态为pending。",
]

for text in samples:
    tokens = re.findall(pattern, text)
    print(text)
    print(tokens)
    print("rough_count=", len(tokens), "\n")
这个例子不代表真实模型 token 数,但能提醒你:中文、英文、代码、数字、符号会被不同方式切分。正式工程必须使用目标模型 tokenizer 统计。
七、特殊 token:模型协议的一部分
特殊 token 用来表示结构,不只是普通文本。不同模型架构的特殊 token 约定并不通用,一定要以目标模型自己的 tokenizer 为准。下表按"常见于哪类模型"归类:
| token | 作用 | 常见于 |
|---|---|---|
BOS (<s>, `< |
begin_of_text | >`) |
EOS (</s>, `< |
endoftext | >`) |
| PAD | padding 填充 | 通用(部分模型直接复用 EOS 作为 PAD) |
| UNK | 未知 token(无法切分时的兜底) | 传统 tokenizer 更常见;BPE/字节级 BPE 通常不需要 |
[CLS] |
序列开头,代表整段的池化表示 | Encoder-Only(BERT/RoBERTa 等);Decoder-Only 里通常没有 |
[SEP] |
句子分隔 / 段落分隔 | Encoder-Only |
[MASK] |
MLM 训练里被遮住需要预测的位置 | Encoder-Only(专门为 MLM 任务设计) |
system / user / assistant |
对话角色(一般由 chat template 展开成若干普通 token) | Chat 模型 |
tool / function |
工具/函数调用边界 | 支持 function calling 的模型 |
image / audio |
多模态输入占位 | 多模态模型 |
关键区分 :[CLS]、[SEP]、[MASK] 是 BERT 系 Encoder-Only 模型专用的(第 25 篇讲过),GPT / LLaMA / Qwen 等 Decoder-Only 模型的 tokenizer 里没有 这些 token,它们的输入约定是 BOS + 文本 + EOS,多轮对话通过 chat template(本质上仍是普通 token 序列)来编码角色。所以你不能拿 BERT 那套 [CLS]...[SEP]... 去喂 LLaMA,反过来也不行。
对聊天模型来说,特殊 token 和 chat template 是训练时学到的协议。如果你在推理或 SFT 时乱改,模型可能角色混乱、输出残留标记或不知道何时停止。
一个 toy chat template:
python
# Python 3.10+

def apply_chat_template(messages):
    text = ""
    for m in messages:
        text += f"<|{m['role']}|>\n{m['content']}\n"
    text += "<|assistant|>\n"
    return text

messages = [
    {"role": "system", "content": "你是一个技术助手。"},
    {"role": "user", "content": "解释 KV Cache。"},
]
print(apply_chat_template(messages))
真实项目必须使用模型官方 tokenizer 提供的 chat template。模板不是美化格式,而是模型接口协议。
八、tokenizer 和模型为什么绑定
Embedding 表的行数通常等于词表大小。token id 直接决定查哪一行 embedding。
如果模型 A 的 token id 100 表示"模型",模型 B 的 token id 100 表示"apple",你把 A 的 tokenizer 配给 B,输入就会错位。模型看到的不是你以为的文本。
因此不能随便替换 tokenizer。除非你明确知道两个模型 tokenizer 兼容。
新增 token 也不是只改词表。你需要 resize embedding,并训练新 token 对应的向量。否则新 token 的 embedding 随机初始化,模型不知道它是什么意思。
九、tokenizer 对 RAG 和代码模型的影响
RAG 分块通常按 token 控制长度。如果你按字符切块,可能出现:
text
1. 某些块 token 超长,被截断;
2. 中文和英文块成本差异大;
3. 代码块被切断,语法破坏;
4. 表格行被拆散;
5. 引用证据不完整。
代码模型也很依赖 tokenizer。变量名、缩进、括号、路径、下划线、驼峰命名,如果切分过碎,会增加学习和推理成本。
例如:
text
get_user_profile_by_account_id如果能合理拆成 get、user、profile、account、id,模型更容易理解;如果拆成很多不稳定片段,代码能力会受影响。
十、常见误区
误区一:token 等于中文一个字或英文一个词。 不一定。token 是 tokenizer 定义的子词、字节或符号单位。
误区二:字符数可以准确估算 token 数。 只能粗略估计。正式计费、上下文控制和 RAG 分块必须用目标 tokenizer。
误区三:chat template 只是提示词格式。 它是模型对话协议的一部分,影响训练和推理行为。
误区四:tokenizer 可以随便替换。 通常不行。tokenizer 和 embedding/LM head 强绑定。
误区五:词表越大越好。 词表大可能减少切分长度,但会增加 embedding 和输出层参数,也可能影响泛化。
总结
Tokenization 把文本切成模型可处理的 token ids。BPE 从字符/字节开始合并高频片段,WordPiece 更关注子词合并的统计价值,SentencePiece 直接处理原始文本并适合多语言场景。token 数影响成本、上下文长度、KV Cache、RAG 分块和训练效率;特殊 token 和 chat template 则影响模型是否正确理解输入结构。
第一遍记住一句话:大模型不是按字数工作,而是按 tokenizer 切出来的 token 工作;tokenizer 是模型接口的一部分,不是随手可换的预处理脚本。
大模型视角
后面讲上下文长度、API 成本、SFT 数据格式、RAG 分块、代码模型和多模态模型时,tokenization 都是基础。很多"为什么上下文不够用""为什么费用变高""为什么微调后格式乱"的问题,本质上都和 token 预算或模板协议有关。
下一篇
KV Cache 原理与实现:推理加速的核心技巧 ------ token 是模型生成的单位。下一篇看自回归生成时,为什么缓存历史 Key/Value 能大幅加速推理,同时又带来显存压力。