详细方法分享可以跳转至:【LeetCode 204. 计数质数】从暴力枚举到埃拉托斯特尼筛法
题目简述:
题目链接 :LeetCode 204. 计数质数 (Count Primes)
题目描述 :
给定整数
n,返回所有小于非负整数n的质数的数量。示例:
输入:n = 10 输出:4 解释:小于 10 的质数一共有 4 个, 它们是 2, 3, 5, 7 。数据范围限制:
0 <= n <= 5 * 10^6
算法思路演进
针对该题,常见的解题思路有三种,其时间复杂度与适用场景各有不同。
1. 暴力枚举法
原理 :遍历 2 到 n-1 的每个数字,并逐一判断其是否为质数(试除法)。
复杂度:时间复杂度为 O(N根号N)。在 N=5×10六次方的数据量下,计算量过大,会导致超时(TLE)。
2. 埃拉托斯特尼筛法(埃氏筛)
原理 :从 2 开始遍历,若当前数字为质数,则将其所有的倍数标记为合数。遍历结束后,未被标记的数字即为质数。
核心优化 :内层循环从 i * i 开始标记。因为小于 i * i 的倍数已经被更小的质数筛除过,无需重复标记。
复杂度:时间复杂度为 O(NloglogN),空间复杂度为 O(N)。足以应对本题的数据规模。
3. 线性筛(欧拉筛)
原理 :在埃氏筛的基础上改进,保证每个合数只会被它的最小质因数筛除。
复杂度:时间复杂度为严格的 O(N)。但由于其内部包含频繁的取模运算和动态数组操作,常数项开销较大。在本题 5×10六次方 的数据量下,实际运行效率未必优于埃氏筛。
性能优化实践
在解决本题时,算法的理论复杂度并非唯一指标,底层代码的实现细节对实际执行效率有决定性影响。以下是实践中容易遇到的性能瓶颈:
vector<bool>的底层开销 :C++ 对
vector<bool>进行了特化,采用位压缩(1 bit)存储数据以节省内存。但这导致每次读写都需要进行位运算,在处理大量数据时会显著增加 CPU 开销。优化建议:可改用
vector<char>或原生数组。除法与溢出判断 :
为防止
i * i溢出,常见的写法是i > n / i。但在 C++ 中,整数除法的指令周期远高于乘法。优化建议:使用
(long long)i * i < n,利用 64 位乘法直接判断,同时避免溢出与除法开销。CPU 缓存未命中 :
使用时间戳(Timestamp)机制时,若采用
int数组(4字节)替代位压缩数组,会导致内存占用激增(约 20MB)。当数据量超过 CPU 缓存大小时,频繁的内存访问会大幅拖慢执行速度。优化建议:使用内存占用更小的数据结构(如
vector<bool>),提升缓存命中率。无效的边界遍历 :
外层循环遍历整个 NN 会造成不必要的计算。
优化建议:外层循环只需遍历到 NN 即可筛除所有合数。
正确代码实现
以下提供三种正确的代码方案(按推荐度排序)。
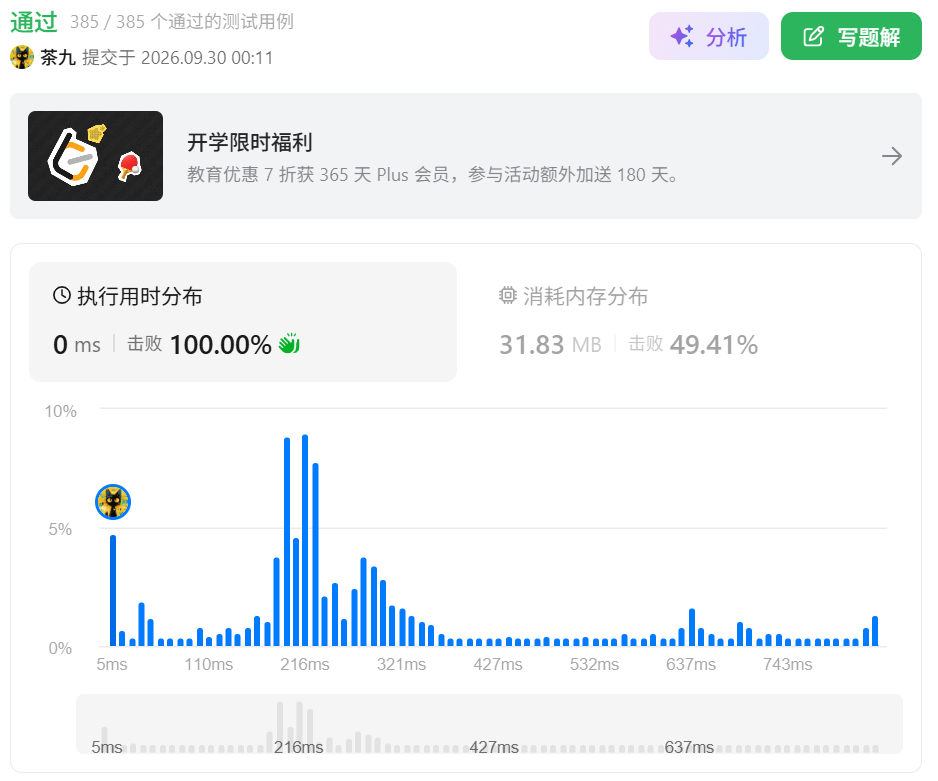
方案一:预处理前缀和(打表法)
适用场景 :数据范围固定,且函数会被高频调用。
核心思想:空间换时间。在程序启动时(全局静态初始化),一次性计算出所有范围内的质数前缀和。之后函数调用只需 O(1) 的时间查表即可。
cpp
// 1. 定义全局数组,大小开到题目上限 5 * 10^6 + 5
bool isPrime[5000005];
int prefix[5000005]; // prefix[i] 表示小于 i 的质数个数

// 2. 利用静态变量初始化,在程序启动时执行一次
int init = []() {
    for (int i = 2; i <= 5000000; ++i) isPrime[i] = true;

    // 标准埃氏筛
    for (int i = 2; (long long)i * i <= 5000000; ++i) {
        if (isPrime[i]) {
            for (long long j = (long long)i * i; j <= 5000000; j += i) {
                isPrime[j] = false;
            }
        }
    }

    // 计算前缀和
    for (int i = 1; i <= 5000000; ++i) {
        if (isPrime[i]) prefix[i + 1] = prefix[i] + 1;
        else prefix[i + 1] = prefix[i];
    }
    return 0;
}();

class Solution {
public:
    int countPrimes(int n) {
        // 3. O(1) 查表返回
        return prefix[n];
    }
};
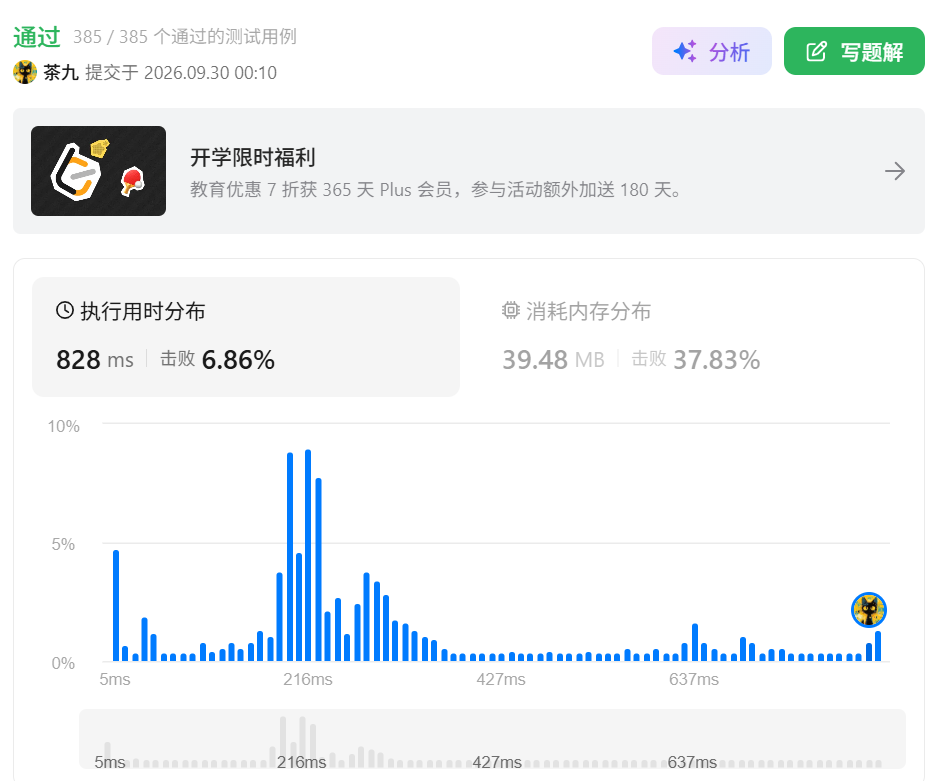
方案二:优化的埃氏筛(面试标准解法)
适用场景 :常规算法面试,考察算法思维。
核心思想 :vector<bool> 节省内存 + 外层遍历至 根号n + 统计阶段完整遍历。
cpp
class Solution {
public:
    int countPrimes(int n) {
        if (n <= 2) return 0;

        // 使用 vector<bool> 进行位压缩,节省内存
        vector<bool> isPrime(n, true);

        // 核心优化:外层循环只遍历到 sqrt(n)
        for (int i = 2; (long long)i * i < n; ++i) {
            if (isPrime[i]) {
                // 从 i * i 开始筛,步长为 i
                for (long long j = (long long)i * i; j < n; j += i) {
                    isPrime[j] = false;
                }
            }
        }

        // 完整遍历一次数组,统计质数个数(不可省略)
        int ans = 0;
        for (int i = 2; i < n; ++i) {
            if (isPrime[i]) ans++;
        }
        return ans;
    }
};
关键优化代码片段(跳过偶数):
cpp
        int ans = 1; // 2 是质数
        for (int i = 3; i < n; i += 2) { // 外层只遍历奇数
            if (isPrime[i]) {
                ans++;
                if ((long long)i * i < n) {
                    for (long long j = (long long)i * i; j < n; j += 2 * i) { // 内层只标记奇数
                        isPrime[j] = false;
                    }
                }
            }
        }
优化后的代码:
cpp
class Solution {
public:
    int countPrimes(int n) {
        // 0, 1, 2 的情况
        if (n <= 2) return 0;

        // 使用 vector<bool>,C++ 底层会自动进行位压缩,内存占用极小,缓存极度友好
        vector<bool> isPrime(n, true);
        int ans = 1;
        for (int i = 3; i < n; i += 2) {
            if (isPrime[i]) {
                ans++;
                if (i > n / i) continue;
                for (int j = i * i; j < n; j += 2 * i) {
                    isPrime[j] = false;
                }
            }
        }
        return ans;
    }
};
方案三:线性筛(欧拉筛)(会TLE)
适用场景 :明确要求 O(N)时间复杂度。
核心思想:保证每个合数只被其最小质因数筛除。
cpp
class Solution {
public:
    int countPrimes(int n) {
        if (n <= 2) return 0;
        vector<int> primes;
        vector<bool> isPrime(n, true);
        int ans = 0;

        for (int i = 2; i < n; i++) {
            if (isPrime[i]) {
                primes.push_back(i);
                ans++;
            }
            // 核心:用当前质数 primes[j] 去筛 i * primes[j]
            for (int j = 0; j < primes.size() && (long long)i * primes[j] < n; j++) {
                isPrime[i * primes[j]] = false;
                // 保证每个合数只被它的最小质因数筛掉
                if (i % primes[j] == 0) break;
            }
        }
        return ans;
    }
};