假设你在做一个客服系统,一封邮件进来:
我的 Stripe 接了三天了一直接不上,我在丢订单,求尽快处理。
你需要三个判断:转给哪个组、客户有多生气、要不要立刻处理。
过去的做法是问大模型。
它会先回你三段分析,最后给一句结论,然后你写正则去解析这段话,解析失败了还得重试。
整个过程少则十几秒钟,每次少说要几毛钱。
现在有另一种做法:你把邮件原文和三个预先定义好的问题一起发过去,70 毫秒后收到一个 JSON,里面是每个问题的答案,附带概率。你的代码可以直接写 if-else。
后面这个,就是 Jev。
一、一个不会说话的模型
Jev 由 TypeSafe AI 在 2026 年 9 月 15 日发布。它不写文章,不翻译,不陪人聊天,也不生成哪怕一个字的解释。它只做一件事:判断。
发布后一周内,产品演示视频在社交平台拿到 4000 万次播放,14 万人在 36 小时内从等待名单里被放出来,一度把 API 打到服务不过来。Vercel 说它上线 24 小时内,付费开发者账户产生的关注度超过此前任何一次模型发布,包括 OpenAI 和 Anthropic 的旗舰模型。公司同期披露 4000 万美元种子轮,估值约 2 亿美元,之后传出有投资方给出可能到 100 亿美元量级的报价。
这些数字里有一部分是热钱的情绪,不必全信。但有一个反差是真的,而且很值得琢磨:
创始人 Diogo Almeida 曾是 OpenAI 的研究员,是 InstructGPT 论文的作者之一------那篇论文的方法后来成了 ChatGPT 的关键技术。换句话说,他以前的工作是教模型学会跟人对话。
现在他做了个拒绝对话的模型。
一个教模型说话的人,转过头来说:很多根本不需要说话。
二、它到底把什么砍掉了
要理解 Jev,得先看一眼大模型是怎么"回答"的。
大模型输出是逐字往外蹦的。你问它这个工单归哪个组,它先吐"根",再吐"据",再吐"您"......每个字都要等前一个字算完才能算。
这叫自回归生成。
这个机制是为了"把想法翻译成人类能读的文字"。
但很多场景下,你的程序根本不需要读文字,它只需要一个能拿来做分支的值。
有个比喻流传很广:让大模型做分类,相当于雇一个小说家来按电梯按钮------他会在按 3 之前先打一份草稿。
Jev 干的事就是把草稿这一步砍掉。它保留模型"读进去"的过程,跳过"往外吐"的过程,直接在内部状态上算出结果。
结果只有三种形态:
Choice:从你给的一组选项里挑一个。最多 255 个选项。返回选中项、每个选项各自的概率、以及一个置信度。
Score:在你定义的有序档位上打分,最少 2 档、最多 10 档。返回的是一个概率加权值------注意这个值可以落在档位之间,比如 1.05,意思是"大概在烦躁和暴怒之间偏烦躁一点"。
Noul:是非判断,返回一个 0 到 1 的概率。名字取自伯努利分布。
三种可以在一次请求里混着问,而且几乎不增加响应时间。因为所有问题是一次前向并行算完的,彼此隔离。官方的说法是"加问题几乎不改变响应时间,也不会造成上下文腐坏"。
这点很重要,它意味着提问的边际成本接近于零------你可以把一件事拆成二十个原子问题一次问完,然后在代码里用自己的公式加权。
官方也明确推荐这种写法:别问"这份创业简报送审吗",改成分别问市场空间、技术可行性、差异化,再用代码合成。优先级变了就改系数,不用重写提示词。
三、请求和响应长什么样
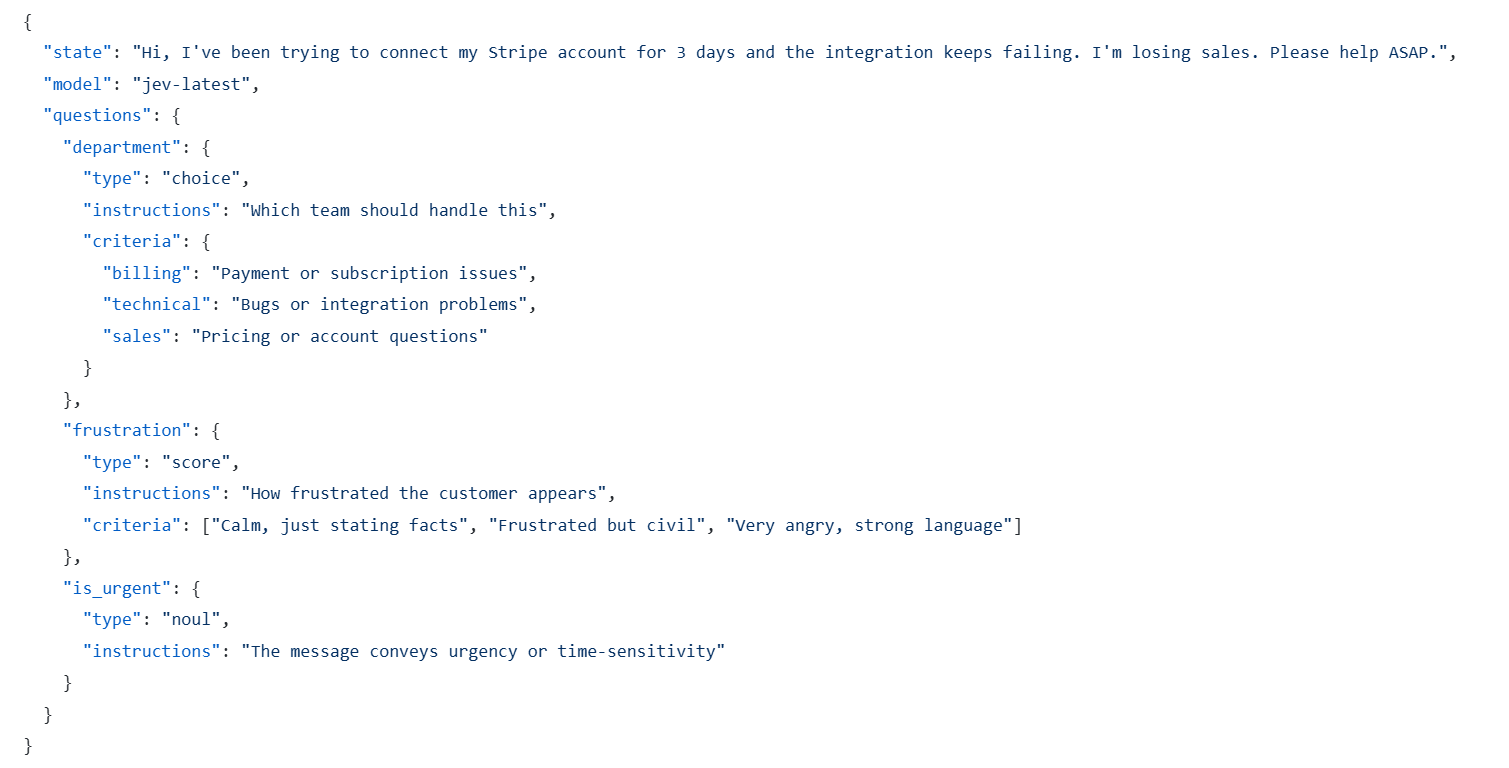
这是官方示例,一张工单同时问三个问题。
请求:
响应:
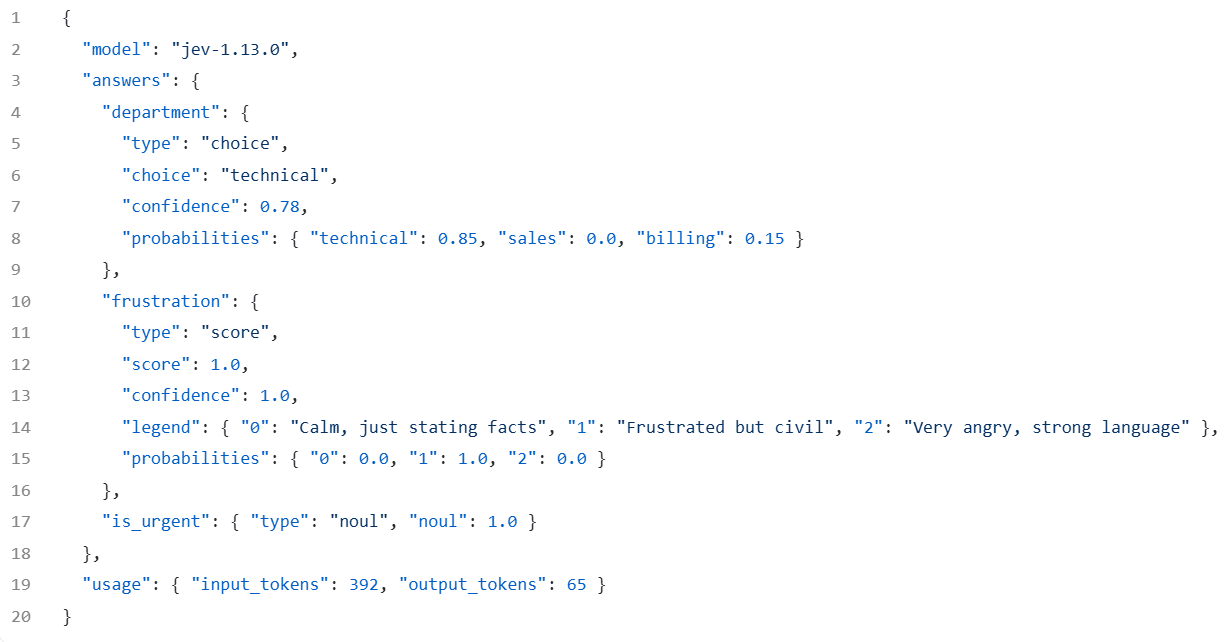
几个容易忽略的细节:
state 不一定是字符串,可以是对象或数组。聊天记录、数据库记录、应用的当前状态,直接塞进去。
questions 里你自己起的 key 不参与推理,也不会送给模型,只用来对齐返回。
confidence 是从概率分布派生出来的,不是模型另外自评了一句"我有几成把握"。所以它和 probabilities 是同一个东西的两种表达,不是两份独立证据。
Noul 类型的答案里没有 confidence 字段。道理也简单:单点概率本身就已经表达了确定性。
output_tokens 有数字,但输出不收费,只对输入收费。官方定价是输入每百万 token 4.2 美分。
(emm,因为这个模型本身输出就很少,所以干脆免费了就。)
四、快在哪里,以及要打几折
官方宣称比前沿大模型快 20 到 200 倍、便宜 40 到 400 倍。但第三方独立实测,实际加速大约在 5 到 25 倍。
但即便是 5 倍,也足够改变经济性。
快的原因有三条,而且都跟"更聪明"无关:
第一,不生成文本,相当于只吐第一个 token。
第二,计算范围小。原来是开放生成,要在十几二十万的词表里算全量概率;现在你给它的可能只有几个或几十个候选。
第三,候选之间彼此独立,可以并行。自回归生成有前后依赖,每个 token 必须等前一个算完。
有个更准确的描述方式:一次大模型调用分两步,第一步 prefill,模型把你输入的内容读进去,内部的隐状态其实已经"理解"了;第二步 decode,一个字一个字往外吐,这一步纯粹是翻译给人看的。Jev 只做第一步,然后直接从隐状态里拿结果。
这个思路并不孤立。
它属于一个更大的方向:既然模型内部已经有这些信息,为什么一定要先翻译成人类语言,再拿语言继续处理?两个 Agent 之间通信,它们都不是人,为什么非要把第一个脑子里的东西写成文字让第二个读一遍?DeepSeek 的 V4.1 Flash 已经在尝试解耦 prefill 和 decode,业界讨论的 Loop Transformer 本质是让思维链在隐空间里循环而不转成文字。Jev 是这个方向里第一个把中间结果直接拿出来卖的产品。
五、它不是多模态,那怎么打游戏
这是最容易被误会的一点。官方 API 的 state 只接受字符串、对象、数组,没有图像入口,Jev 不看画面。
那开发者用它操作浏览器、打《毁灭战士》、操控无人机,是怎么做到的?
答案是:看画面的活由外部代码干了,Jev 只接最后那一段。
浏览器场景的做法(以 APUS 开源的 fast-browser-use 为例):页面加载完,一个轻量扫描器检查渲染后的布局树,只提取当前可见、可交互的元素,整理成候选动作,比如:
("CLICK", "btn_search")("SELECT", "opt_timezone_sg")("TYPE_TEXT", "input_query") ("DONE", "task_completed")然后每个候选被动态映射到词表里的一个单 token,比如 A、B、C、D。一次前向,取 next-token logits 做温度 softmax,谁的概率高就执行谁。
用图来表示下:
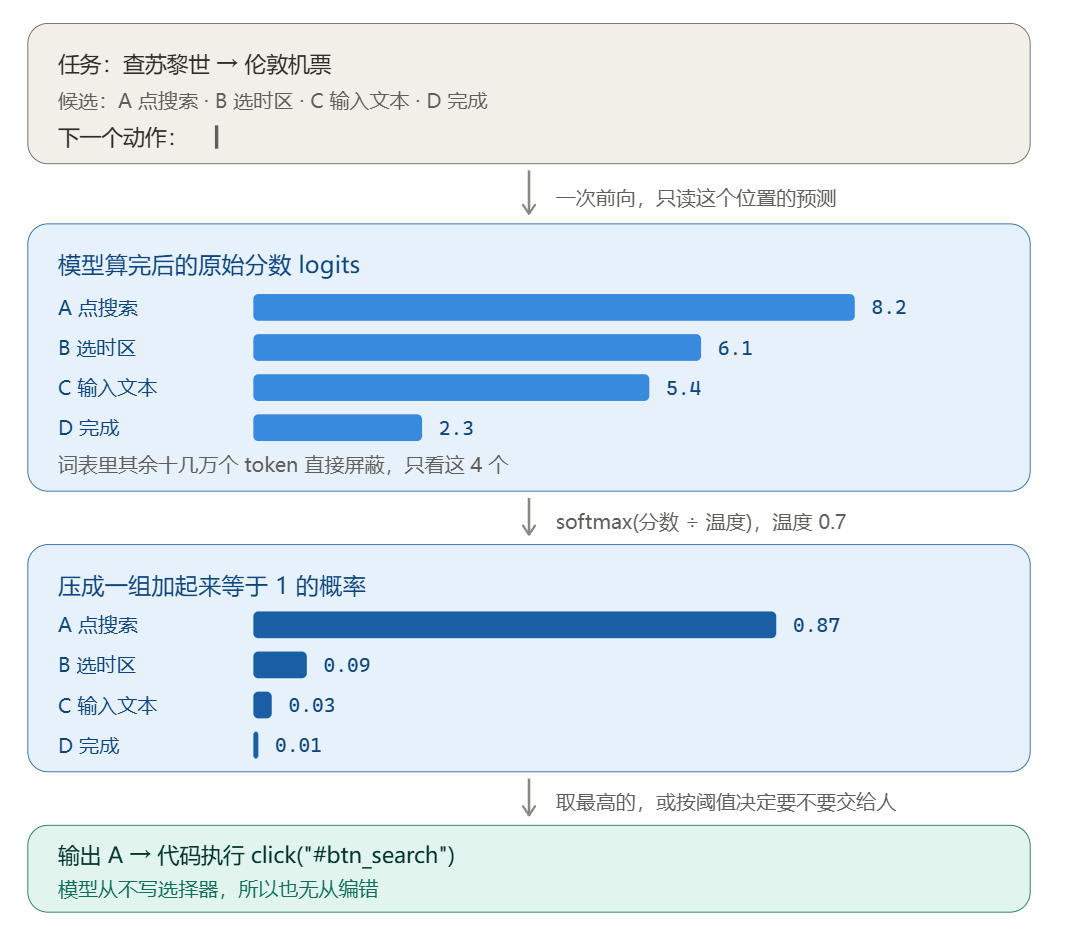
模型从头到尾不写选择器,也不写 Playwright 代码。所以项目文档里那句"选择器幻觉和语法错误在数学上不可能"是成立的------它不是吹牛,是因为输出空间被结构性锁死了。
只有选中"输入文本"这个动作时,才会调用一次小模型来写要填的字。写字这件事仍然外包。
桌面操作有另一种取巧办法:走操作系统的 accessibility tree,那本来就是结构化的文本,连视觉模型都不需要。
游戏更明显。论文收录的 TypeSafe Mario 项目,是把游戏状态转成结构化输入,再让 Jev 从预定义的合法控制器宏里选一个。那个被传得很广的《毁灭战士》演示,后来被人拆穿:它拿到的 wall vision(前方墙面距离)和敌人坐标,是直接从游戏引擎里读出来的数值------它根本没有"看"画面。
所以"零幻觉"的真相值得说清楚:不是模型更可靠,是候选集合由你的代码给定,它在实现原理上无法凭空编出一个不存在的东西。
代价同样清楚:拿不到结构化信息的地方它就失效。canvas 渲染的游戏、图片里的文字、自定义绘制的控件,都得先有别的方法转成文本。这套方案能否迁移,取决于目标系统愿不愿意暴露结构。
六、真正有新意的应用:用"筛选"代替"生成"
前面那些都是"更快更便宜地做原来就有的事"。真正有意思的用法是换掉了动作本身。
目前星标最高的 Jev 项目叫 fast-jev-compaction(7.2kstar, 截至2026.9.30),做的是 Agent 的上下文压缩。
老办法是让大模型把历史对话压缩成摘要。
问题在于摘要是一种有损重写------文件路径、报错码、参数值这些细节,很容易在重写过程中走样,而恰恰是这些细节后面排查问题时最有用。
这个项目的做法是对每一条历史工具调用问两个是非问题:
-
这次调用本身,对继续任务还有用吗?
-
这个调用的完整返回结果,还需要保留吗?
然后三种处置:两个都高,完整保留;调用高、结果低,保留调用但把结果截断;两个都低,整条删掉。
关键在于:保留下来的内容一字不改,是原文。
实测数据:Claude Code 的上下文从 156,000 token 压到 62,000,利用率从 78% 降到 31%,16 条历史里 10 条保留了原文。另一个 demo 里,10,029 字符压到 852 个,减少 91.5%。
这个思路有个通用形态:凡是你的系统里出现"让大模型重写已有内容"的地方,都可以考虑改成"让判断模型决定每一块留不留"。RAG 里不再生成摘要而是给每条检索结果打分后丢弃弱项;代码审查里不写评语而是输出风险信号、证据位置、严重性分数------后者是另一个项目 jev-review,19 个以上维度打分,150 毫秒,低置信度的判定被当成疑似误报先滤掉,减少人读无效段落的时间。
也有反对意见:上下文压缩本质是重构而不是过滤,"从根本上误解了上下文管理"。这个反对有分量,值得实测后自己判断。
另一类新用法是把判断塞进数据层。有开发者做了 PostgreSQL 扩展,可以直接写:
SELECT * FROM people WHERE jev(people, 'could work from home');不需要建索引,不需要向量库。
还有一类是成本翻转带来的"从抽样到全量"。以前只能抽样做的事,现在可以全量做:
-
1018 篇研究论文做分类:0.08 美元,中位延迟 256 毫秒
-
724 条广告拆解成 37 个品牌,检查文案和落地页是否匹配:0.09 美元
-
300 万条用户行为回放事件,识别出 3247 个会话、132 次愤怒点击,产出 213 个修复 PR:2.17 美元
-
384 条新闻里给 15 个品牌挑今日可跟的选题:0.19 美元(同期用 Opus 5 做同样的事,只跑了 4 条就花了 0.77 美元)
-
1000 封邮件处理完:15.6 秒,0.0177 美元
七、更大的背景:模型开始分层了
Jev 能火,一半原因不在它自己,而在时点。
过去行业的主线是把一个旗舰模型做得尽可能全能,用户的选择也很简单------选当下最强的那个。所以价值全压在模型本身,新模型一出来就整体替换旧的。
现在模型开始按复杂度、调用频次、延迟和成本被切成不同档位。Google的 Gemini 3.5 Flash、DeepSeek 的 V4 Flash、Qwen 的 Flash-Next、GLM 的 Flash,扎堆出现。这些不是把能力砍掉的阉割版,是为高频简单任务专门优化的档位。DeepSeek 甚至宣布在下一代 Pro 上线前,把 Pro 的请求路由到 Flash 并按 Flash 计费。
这带来一个新问题:可选变多了,但"该派谁上场"的判断成本转嫁到了用户头上。你提一个任务时,其实不该由你来决定它值多少钱。
于是多出一层:路由。
Cursor 的 Router 在每个请求交给模型之前先判断任务类型、复杂度、上下文,简单任务给快而便宜的,长周期困难任务给前沿模型。WorkBuddy的 Auto 模式同理。
这一层为什么重要,有三条:
它是成本闸门。Agent 一天调几万次,路由选错一次贵一档,规模化之后差距是数量级的。
它是新的黏性来源。当后端模型可以自由混搭、随时替换,模型就变成了可插拔的供应商;而调度逻辑、对用户任务的理解、历史上下文,全留在入口这一层。用户认的是入口,不是背后的某个模型。
它让模型之间的关系从替换变成协作。同一个 Agent 里,强模型做规划,快模型做判断,专用模型处理垂类。
所以对 OpenAI、Anthropic 这类厂商来说,Jev 代表的不只是一个竞品,而是"最赚钱的那批调用可能不再需要前沿模型"。
顺带解释这个名字。Jev 取自 19 世纪经济学家杰文斯,对应"杰文斯悖论":一种资源变得更便宜高效之后,总消耗量反而上升,因为新的使用场景不断出现。用在 AI 上的意思是------判断变便宜了,判断的用量会暴涨。这既是命名,也是它的商业逻辑。