在现代C++编程中,std::future和std::promise是异步编程模型中的两个重要组件,它们构成了C++标准库中处理异步计算结果的基础。本文将深入浅出地介绍这两个概念,探讨它们的应用场景、常见问题、易错点及如何避免,同时辅以代码示例,帮助读者更好地理解和运用这些机制。
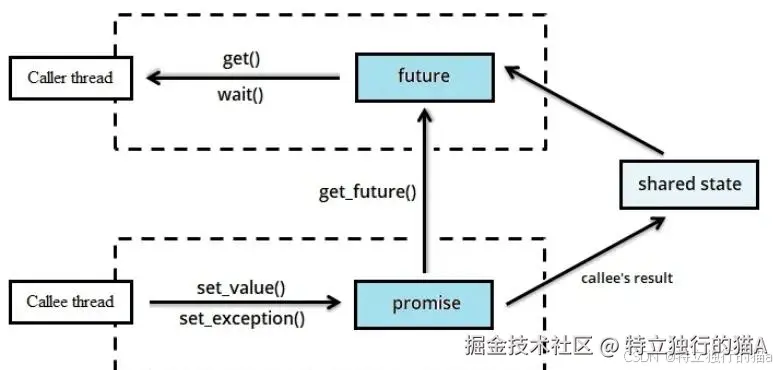
@TOC
0. 这篇东西解决什么问题
先看你有没有写过这样的代码:
cpp
auto future = rpc_client->call(message, message_id);
auto status = future.wait_for(std::chrono::minutes(10));
if (status == std::future_status::timeout) {
    LOGGING_ERROR("future is timeout.");
    return -2;
}
std::string response = future.get();这段代码能跑,甚至能上线。但它把三件事糊在了一起:等待、超时、以及"超时之后那个请求到底怎么样了"。等到线上出现响应错配、pending_ 表无限增长、或者某个请求的响应永远找不到人接收的时候,你才会回头来啃 future/promise 的语义细节。
std::future 和 std::promise 是 C++11 引入的异步通信原语,作用说起来很简单:在一个线程里设置结果,在另一个线程里取结果。但真正写生产代码时,别扭的地方全在细节上:
get()为什么只能调用一次?第二次为什么不是返回值而是抛异常?wait_for()返回超时了,任务到底被取消了没有?promise被析构了,等待方为什么会收到一个Broken promise?std::async明明是最省事的写法,为什么有人说它不能用来做线程池?- 为什么很多资料说"不要在持锁的时候
set_value()",它们说的对吗?
这篇从"共享状态"这个底层模型开始讲,把上面这些问题的因果链拆开。中间穿插真实场景(网络请求、RPC、设备响应)的代码,最后落到一个能直接抄进工程的 RPC 客户端实现:请求注册、超时取消、迟到响应、请求表清理,一个都不少。
文中所有关于运行时行为的结论,都在 GCC 13.3.0 / libstdc++ /
-std=c++17上实际编译运行验证过,关键地方的实测输出会直接贴在正文里。不同标准库实现的错误信息文本可能不同,但标准语义是一致的。
1. 一切从"共享状态"说起
理解 future/promise 的关键,是别把它们当成两个独立的类,而要理解它们是同一个对象的两个把手 ------那个对象叫共享状态(shared state)。
text
                       共享状态 (shared state)
                 +--------------------------------------+
   promise<T>    |  结果槽:  T 值 / std::exception_ptr  |
   (写端 / 生产) |           / 空                        |
        o------->|  就绪标志 ready                       |<-------o  future<T>
                 |  同步原语: 互斥量 + 条件变量          |          (读端 / 消费)
                 |  引用计数                             |
                 +--------------------------------------+
几个必须记住的性质:
- 共享状态通常在堆上分配 (C++17 起标准明确要求
promise/future的共享状态是动态分配的,因为它的生命周期由引用计数决定,而不是由任何一个栈对象决定)。所以每次std::promise<T>+get_future(),背后基本都是一次堆分配。 - 写端只能定一次终局 。共享状态里的结果槽一旦被填上,就永久就绪,不能改写。这直接决定了"一个
promise只能set_value()一次"。 - 读端只能取一次结果 (普通
future)。取走意味着消费掉------这也是get()之后valid()变false的原因。 - 状态存活多久由引用计数决定。谁先销毁都不影响另一方,最后销毁的那个负责释放。
1.1 三个生产者,两个消费者
标准库给你提供了三个"生产者"入口,语义完全一样(都是往共享状态里填结果),只是易用程度不同:
| 生产者 | 谁来填结果 | 谁负责执行任务 | 典型用途 |
|---|---|---|---|
std::promise<T> |
你自己显式调用 set_value() |
你自己(线程/回调/事件循环) | 网络回调、RPC 响应、设备中断、外部事件 |
std::packaged_task<F> |
包装的可调用对象返回时自动填 | 你把 task 丢给谁(线程、线程池) | 线程池、任务队列 |
std::async(policy, f) |
包装的可调用对象返回时自动填 | 标准库(或延迟到调用线程) | 一次性、简单的异步计算 |
"消费者"只有两个:
| 消费者 | 能否多次 get() |
能否拷贝 | 适用场景 |
|---|---|---|---|
std::future<T> |
否(取一次即失效) | 否(move-only) | 一对一,结果只给一个人 |
std::shared_future<T> |
是 | 是 | 一对多,结果广播给多个消费者 |
这一点值得反复强调:promise 才是那个"原始"能力,packaged_task 和 async 本质上是"帮你在合适的时机调用 set_value()"的语法糖 。所以只要把 promise 的语义吃透,另外两个的行为都能推导出来。
1.2 销毁行为:引用计数决定了两个"不那么直观"的后果
既然结果和生命周期都挂在共享状态上,那么"某一端在没完成工作的情况下就被销毁"这件事,就必须有个交代。标准给的答案取决于销毁的是哪一端:
| 销毁的一端 | 条件 | 标准要求的行为 |
|---|---|---|
写端(promise) |
尚未设置结果 | 往状态里存入一个 future_error(broken_promise) 作为异常,把状态置为就绪 |
写端(promise) |
已经设置过结果 | 什么都不做,正常释放自己的引用 |
读端(future) |
结果就绪 | 正常释放。结果如果是个异常,被静默丢弃,不抛不崩 |
读端(future) |
结果未就绪(还在等) | 只是放手,不等待、不取消------后台任务照样跑完 |
读端(future from std::async) |
结果未就绪 | 特殊:析构可能阻塞到任务结束。见第 5 章 |
前四条都很符合直觉,第五条是标准库埋的一个大坑,后面单独用一章讲。
1.3 为什么会有"只能一次"这种限制
回头看第 1.2 节的表:写端销毁 = 状态就绪。也就是说,状态的"就绪"这件事只发生一次,一旦发生就不可逆 。在这个模型下,多个写端同时 set_value()、或者同一个 future 被多个线程 get(),都会立刻破坏"结果唯一、就绪一次"的不变量。标准库的选择不是加锁让它变得宽容,而是直接禁止------在编译期禁止(move-only)或在运行期抛异常(future_error)。
理解了这一点,后面所有"只能一次"的限制都不需要死记,都能现场推出来:
promise::get_future()只能调一次 → 因为一个写端只能配对一个读端的所有权promise::set_value()只能调一次 → 因为就绪不可逆future::get()只能调一次 → 因为结果所有权被转移走了future是 move-only → 因为"结果的所有权"必须唯一,否则就能被复制出多个消费者,与 1.2 的模型冲突- 想要多消费者?用
shared_future→ 它共享的是"读取权"而不是"所有权"
2. std::promise<T>:写端完全指南
<future> 头文件,C++11 起可用。编译时至少要 -std=c++11,现在没有理由不用 -std=c++17 或更高。
2.1 接口全集
std::promise<T> 的成员函数其实很少,整个类塞不满一屏:
| 成员 | 语义 |
|---|---|
promise() |
创建一个带全新共享状态的 promise |
promise(promise&&) / operator= |
移动。移动后源对象不再关联任何状态 |
swap() |
交换两个 promise 的共享状态 |
get_future() |
返回关联的 future<T>。每个 promise 只能调一次 |
set_value(v) / set_value()(void 特化) |
填入正常结果,状态就绪 |
set_exception(ep) |
填入 std::exception_ptr,状态就绪,等待方 get() 时抛出 |
set_value_at_thread_exit(v) |
填入结果,但等到线程退出时才置为就绪 |
set_exception_at_thread_exit(ep) |
同上,填的是异常 |
~promise() |
若尚无结果,填入 broken_promise 异常 |
注意这里没有 get()、没有 wait()------写端不会等待。promise 是一个纯粹的"单向投递"对象。
2.2 get_future() 会阻塞吗?不会
这是新手最常见的误解之一,因为 "get" 这个词太容易让人联想到阻塞式的 get()。
cpp
std::promise<int> promise;
std::future<int> future = promise.get_future();  // 瞬间返回,只是把读端句柄拿回来
get_future() 做的事情是:检查当前 promise 是否已有共享状态、是否已经发出过 future,然后把一个指向同一块共享状态的 future 交给调用者,并把 promise 标记为"已领取"。
可能阻塞的只有读端这四个:
cpp
future.get();                        // 阻塞到就绪,并取走结果(可能抛异常)
future.wait();                       // 阻塞到就绪,不取结果
future.wait_for(std::chrono::seconds(5));    // 最多阻塞 5 秒
future.wait_until(deadline); // 最多阻塞到时间点一个容易踩的具体场景:把 get_future() 放到锁里 。既然它不阻塞,那就没必要保护它;但反过来,如果 get_future() 和 set_value() 在没有同步的情况下被并发调用,那就是数据竞争了,跟阻塞与否无关。
2.3 只能设置一次:实测错误码
cpp
std::promise<int> promise;
promise.set_value(1);
promise.set_value(2);   // 抛 std::future_error
实测抛出的东西长这样(libstdc++):
text
std::future_error: Promise already satisfied光看消息文本不够,std::future_error 是带错误码的,程序里应该按错误码判断而不是按文本:
cpp
std::promise<int> promise;
promise.set_value(1);

try {
    promise.set_value(2);
}
catch (const std::future_error& e) {
    if (e.code() == std::make_error_code(std::future_errc::promise_already_satisfied)) {
        // 已经设置过,说明是重复投递,按业务逻辑处理
    }
}
std::future_errc 一共只有四个值,但知道了就能精确区分故障原因。下面的数值是在 libstdc++ 上实测打印出来的 (标准不保证数值,但保证 == 比较和 std::make_error_code 可用,所以工程代码里请比较枚举,别比较数字):
std::future_errc |
实测 .code().value() |
触发条件 |
|---|---|---|
future_already_retrieved |
1 | 对同一个 promise 调用两次 get_future() |
promise_already_satisfied |
2 | 对同一个 promise 设置两次结果 |
no_state |
3 | 对不关联任何共享状态的对象操作(默认构造、已移动走、已 get() 过) |
broken_promise |
4 | promise 未设置结果就被销毁,等待方取结果时抛出 |
对应的实测输出:
text
second get      -> code=3  std::future_error: No associated state
get_future x2   -> code=1  std::future_error: Future already retrieved
broken promise  -> code=4  std::future_error: Broken promise
set_value x2    -> code=2  std::future_error: Promise already satisfied
2.4 为什么 promise 只能搬家不能复印
std::promise<T> 是 move-only 的。下面这行编译不过:
cpp
std::promise<int> p1;
std::promise<int> p2 = p1;             // 错误:拷贝构造被删除
std::promise<int> p3 = std::move(p1);  // 正确
原因见 1.3:写端必须唯一。如果允许拷贝,就会出现两个 promise 指向同一块共享状态、都能调 set_value() 的局面,而这个模型要保证的恰恰是"结果只被设置一次"。
实际影响:跨线程传递 promise 必须用 std::move 或者 shared_ptr。这两种写法在真实代码里都能看到,语义不同:
cpp
// 写法 A:转移所有权。闭包必须加 mutable,因为捕获的 promise 是移动进来的
std::thread worker([p = std::move(promise)]() mutable {
    p.set_value(100);
});
worker.detach();          // 注意:detach 会带来生命周期管理问题,见 2.7
cpp
// 写法 B:共享所有权。适合"结果可能由很多不同的地方触发"的场景(RPC 响应、网络回调)
auto promise = std::make_shared<std::promise<std::string>>();
auto future = promise->get_future();
pending_[id] = promise; // 保存起来,谁先拿到响应谁 set_value这两种写法的选择标准很清楚:结果由确定的一个执行流产生(比如一个专门的 worker 线程)→ 写法 A;结果由不确定的外部事件触发(网络包到达、设备回包),而且需要放进一张表里等待 → 写法 B。第 9 章的 RPC 客户端就是写法 B。
2.5 void 与引用特化
结果类型不一定是值类型,标准库为两种特殊情形做了特化,语法上和普通类型一样用:
cpp
// void:只关心"完成了",不关心返回值
std::promise<void> pv;
auto fv = pv.get_future();
pv.set_value();          // 注意不带参数
fv.get();                // 返回 void

// 引用:避免拷贝大对象,或者需要直接改写目标对象
int x = 5;
std::promise<int&> pr;
auto fr = pr.get_future();
pr.set_value(x);
fr.get() = 42;           // get() 返回 int&,可以写回
// 实测:x == 42
std::promise<void> 在"异步初始化完成通知"这类场景里特别好用------比如 axis_init 只想知道"初始化好了没有",不需要返回值:
cpp
std::future<void> initFuture = initAsync();
initFuture.wait();
std::future<T&> 要小心:它持有的是引用,不延长被引用对象的生命周期 。如果被引用的对象先被销毁了,get() 出来就是个悬垂引用。除非你非常确定生命周期关系,否则更稳妥的做法是传 std::shared_ptr<T> 或者 std::reference_wrapper<T>。
2.6 set_value_at_thread_exit():一个被误解的接口
cpp
void set_value_at_thread_exit(const T& value);
void set_exception_at_thread_exit(std::exception_ptr p);文档里通常只说"结果在线程退出时才变为就绪",这句话太简略,容易让人以为它等价于"等到线程最后一行代码执行完"。实际语义更精确:状态的"就绪"发生在
当前线程的函数体执行完毕 且 该线程所有
thread_local对象的析构函数都执行完之后。
这两件事有先后顺序,而且可以观测到。实测:
cpp
std::promise<int> p;
auto f = p.get_future();

std::thread th([&p] {
    thread_local struct Guard {
        ~Guard() { std::cout << "  [tls dtor]\n"; }
    } g;

    p.set_value_at_thread_exit(11);
    std::cout << "  [body done]\n";
});

// 主线程这里会一直等到 TLS 析构完成才拿到 11
std::cout << "value = " << f.get() << std::endl;
th.join();
实测输出:
text
wait...
  [body done]
  [tls dtor]
at_thread_exit value = 11可以看到,[body done] 先打印,然后才是 [tls dtor],最后主线程才拿到 11。这就是这个接口存在的唯一理由:保证等待方看到的是线程的完整终态,包括 thread_local 对象析构时释放的资源。
什么时候真的需要它?典型场景是"线程池 worker 退出时回收线程局部资源"------比如 TLS 里挂着一个连接对象或内存池,工作线程需要在线程结束时关掉它,而你想让等结果的人知道"资源也回收了"。绝大多数业务代码直接用 set_value() 就够了,因为 set_value() 是立刻置为就绪的,等待方一秒钟都不用多等。
顺带一个容易忽略的点:set_value_at_thread_exit() 同样遵守"只能一次"的规则,如果之前已经设置过结果,它抛 future_error(同样是 promise_already_satisfied),而不是像某些实现那样静默忽略。
2.7 broken promise:从哪来,怎么避免
这是工程里最常见的 future 相关异常。触发条件可以用一句话概括:等待方还在等一个结果,或者刚来取结果,而写端已经在没填结果的情况下死了。
最典型的错误写法------在函数里建 promise,返回 future:
cpp
#include <future>

std::future<int> createFuture()
{
    std::promise<int> promise;
    auto future = promise.get_future();
    return future;          // promise 在这里析构,结果从未设置
}

int main()
{
    auto future = createFuture();
    try {
        int v = future.get();
    }
    catch (const std::future_error& e) {
        // 实测:std::future_error: Broken promise   (code=4)
    }
}如果你在排查"某个异步任务的结果莫名其妙是异常的",先怀疑这里。broken promise 是标准库在帮你报错,不是 bug ------它把一个"永远等不到结果的阻塞"变成了"一个可捕获的异常"。如果没这个机制,future.get() 会永久挂住,那才是最难查的故障。
正确写法有两种,选哪种取决于任务归谁管:
cpp
// 做法一:把 promise 移动到线程里(结果由专属线程产生)
std::future<int> createFuture()
{
    std::promise<int> promise;
    auto future = promise.get_future();

    std::thread worker([p = std::move(promise)]() mutable {
        p.set_value(100);
    });
    worker.detach();          // 见下面的警告
    return future;
}
cpp
// 做法二:交给 std::async,生命周期由标准库管
std::future<int> createFuture()
{
    return std::async(std::launch::async, [] { return 100; });
}
关于 detach() 的警告 :上面做法一的 detach() 是能跑,但它把线程控制权彻底丢掉了。如果那个线程在你 future.get() 返回之后还要多跑几行(比如做日志、做清理),而它捕获的任何东西(this、引用、shared_ptr)已经被销毁了,就是 use-after-free。在真实工程里,要么用一个自己管理的线程池,要么让 std::async 管 ,裸 detach() 是最后手段。第 6 章给了一个线程池的实现。
再补充一种容易被忽略的 broken promise 来源:条件分支里漏掉了 set_value。
cpp
void worker(std::promise<int>& p, bool ok)
{
    if (!ok) {
        p.set_value(-1);
    }
    // 如果 ok 为 true,走到这里就返回了 ------ promise 析构,等待方收到 broken promise
}
这类问题在代码 review 时很难看出来,但有个习惯可以几乎完全避免它:用 RAII 包装器保证"一定有人设置结果"或者"一定投递异常" 。最简单的做法是给 promise 套一个作用域守卫:
cpp
class PromiseGuard
{
public:
    explicit PromiseGuard(std::promise<std::string> p)
        : promise_(std::move(p)), settled_(false)
    {
    }

    ~PromiseGuard()
    {
        if (!settled_) {
            // 兜底:保证等待方拿到的是一个可诊断的异常,而不是 broken_promise
            try {
                promise_.set_exception(std::make_exception_ptr(
                    std::runtime_error("task abandoned without result")));
            }
            catch (const std::future_error&) {
                // 已经被设置过,忽略
            }
        }
    }

    void set_value(std::string v)
    {
        promise_.set_value(std::move(v));
        settled_ = true;
    }

    void set_exception(std::exception_ptr e)
    {
        promise_.set_exception(e);
        settled_ = true;
    }

    PromiseGuard(const PromiseGuard&) = delete;
    PromiseGuard& operator=(const PromiseGuard&) = delete;

private:
    std::promise<std::string> promise_;
    bool settled_;
};
代价是等待方拿到的异常类型变成了你自己的 runtime_error,好处是异常信息里能带上"哪个任务、在哪放弃的" ,排查时比一句干巴巴的 Broken promise 有用得多。这套思路在 RPC 客户端里很常见,第 9 章的 RpcClient::call() 里就有对应的异常投递路径。
3. std::future<T>:读端完全指南
3.1 接口与阻塞行为一览
先给结论,方便写代码时对着查:
| 操作 | 是否阻塞 | 是否消耗结果 | 备注 |
|---|---|---|---|
future.valid() |
否 | 否 | 纯查询,判断有没有关联共享状态 |
future.get() |
是(直到就绪) | 是 | 就绪后立刻返回;返回后 valid() 变 false |
future.wait() |
是(直到就绪) | 否 | 可以 wait() 之后再 get() |
future.wait_for(d) |
最多 d | 否 | 返回 ready / timeout / deferred |
future.wait_until(tp) |
最多到 tp | 否 | 同上 |
future.share() |
否 | 是(转移) | 转为 shared_future,原 future 失效 |
promise.set_value() |
否 | --- | 不等待消费者,但会唤醒等待者 |
wait() 和 get() 有一个实际差别值得注意:wait() 不会抛出写端存进去的业务异常 。它只保证"状态就绪了",所以要靠 get() 才能拿到异常。这带来一个常见写法:
cpp
future.wait();              // 先确认就绪
try {
    auto v = future.get();  // 这里不会阻塞,只可能抛
}
catch (const std::exception& e) {
    // 处理业务异常
}这个写法的意义是:把"等"和"处理异常"分开,避免异常处理和长阻塞混在同一个 try 块里,阅读时更清楚哪一行可能等多久。
3.2 get() 的三种出口
一次 future.get() 调用只有三种可能的结局,写代码时应该把三种都想到:
出口一:正常返回结果。 写端调了 set_value()。
出口二:抛出写端存进去的异常。 这是 future/promise 最有价值的特性之一------跨线程异常传播 。注意异常是原样透传的,类型不会丢:
cpp
std::promise<int> p;
auto f = p.get_future();

std::thread th([&p] {
    try {
        throw MyBusinessError("axis 3 not homed", 1003);
    }
    catch (...) {
        p.set_exception(std::current_exception());
    }
});

try {
    f.get();
}
catch (const MyBusinessError& e) {   // 能精确捕获到原始类型
    // e.code() == 1003
}
th.join();
std::current_exception() 捕获的是异常对象本身 (通过 std::exception_ptr 这个引用计数的异常句柄),而不是一个副本,所以自定义异常类型、错误码、甚至 what() 的内容都能完整传过来。这比"把错误码塞进返回值里"要干净得多。
出口三:抛 std::future_error。 这是"用法错误"而不是"业务失败",只有三种可能:
no_state:future 不关联任何共享状态(默认构造、已经被get()过、已经被移动走)broken_promise:写端没设置结果就销毁了future_already_retrieved:这个其实只会在get_future()那一侧出现
错误码对照表见 2.3 节。工程上应该把"业务异常"和"future_error"分开处理,因为前者是业务逻辑要处理的东西,后者是 bug 或者写端缺陷的信号,通常应该记日志甚至告警:
cpp
std::string response;
try {
    response = future.get();
}
catch (const std::future_error& e) {
    // 用法/协议层面的问题:写端消失、重复取结果、请求被异常投递
    LOGGING_ERROR("future error: %s (code=%d)", e.what(), e.code().value());
    return -4;
}
catch (const std::exception& e) {
    // 对端返回的业务异常
    LOGGING_ERROR("RPC exception: %s", e.what());
    return -5;
}
3.3 valid():三种会"失效"的情况
valid() 回答的问题很具体:这个 future 对象现在是否关联着一块共享状态 。它不关心状态是否就绪。三种让它变 false 的情况:
cpp
// 情况一:默认构造,从来没关联过任何状态
std::future<int> f1;
f1.valid();                              // false
// 实测:对这种 future 调 get() 或 wait_for() 都抛 no_state
//   get on no-state      -> std::future_error: No associated state
//   wait_for on no-state -> std::future_error: No associated state

// 情况二:移动之后,源对象被掏空
std::promise<int> p;
std::future<int> f2 = p.get_future();
std::future<int> f3 = std::move(f2);
f2.valid();                              // false
f3.valid();                              // true

// 情况三:get() 消费掉结果之后
p.set_value(1);
int v = f3.get();
f3.valid(); // false(实测输出 valid=0)情况一带来的一个实际教训是:wait_for() 对无效 future 会抛异常,而不是返回超时 。所以调用顺序必须是先 valid() 再 wait_for():
cpp
if (!future.valid()) {
    LOGGING_ERROR("future is invalid.");
    return -1;
}
auto status = future.wait_for(timeout);
这段"先判 valid()"的代码在第 10 章的实际场景里就出现过,它不是形式主义------它拦住的是"因为上游提前返回了空 future 而导致的一句 no_state 异常"。
3.4 为什么 get() 不能调用两次,以及想要"可复用结果"怎么办
cpp
std::promise<int> p;
auto f = p.get_future();
p.set_value(100);

int a = f.get();     // 100
int b = f.get();     // 抛 std::future_error: No associated state  (code=3)
原因回到 1.3:get() 是"把结果从共享状态里取走 ",取走之后就不再有共享状态了。这不是缺陷,而是模型的一部分------future 表达的是"一个只交给你一次的结果"。
那么工程上真的需要多次读取结果怎么办?三种做法,按推荐程度排:
做法一:自己缓存值(最简单,大多数情况够用)。
cpp
const int v = f.get(); // 取一次,之后都用 v做法二:从一开始就用 shared_future(需要多个线程各自 get())。
cpp
std::shared_future<int> sf = p.get_future().share();
int a = sf.get();    // 可以反复调用
int b = sf.get();
**做法三:把 shared_future 包一层,做成一个"可多次获取、且线程安全"的句柄。**适用于你要把"一个异步结果"放进容器、允许多个模块各自订阅的场景:
cpp
template <typename T>
class AsyncResult
{
public:
    explicit AsyncResult(std::future<T> f)
        : shared_(f.share())
    {
    }

    // 任意多次调用,任意线程调用:共享状态里的结果会被拷贝出来
    T value() const
    {
        return shared_.get();
    }

    void wait() const
    {
        shared_.wait();
    }

    template <typename Rep, typename Period>
    std::future_status wait_for(const std::chrono::duration<Rep, Period>& d) const
    {
        return shared_.wait_for(d);
    }

private:
    std::shared_future<T> shared_;
};
注意这里 shared_future 必须按值捕获/拷贝 到各个线程里,而不是按引用共享同一个对象------虽然 shared_future::get() 本身是线程安全的,但拷贝语义让使用意图更明确。
3.5 线程安全性:一个必须区分的细节
这块特别容易搞混,记住两条就够:
std::future不是线程安全的。 同一个future对象不能被多个线程同时get()/wait()。多个线程操作同一个future对象(哪怕只是一个wait()一个get())属于数据竞争,标准明确要求用户自己同步(通常需要外部互斥量)。std::shared_future的成员函数是线程安全的。 多个线程可以同时对同一个shared_future对象 调用get()/wait(),不需要额外加锁。这正是它存在的意义。
实测(三个线程对同一个 shared_future 并发 get()):
cpp
std::promise<int> p;
std::shared_future<int> sf = p.get_future().share();

std::vector<std::thread> ts;
for (int i = 0; i < 3; ++i) {
    ts.emplace_back([sf, i] {                  // 按值拷贝,每个线程一份
        std::cout << "sf[" << i << "] = " << sf.get() << "\n";
    });
}
p.set_value(7);
for (auto& t : ts) {
    t.join();
}
text
sf[0] = 7
sf[1] = 7
sf[2] = 7
一个常见的疑问是"多个线程从同一个 shared_future 里 get(),会不会有一个拿到不到结果"。不会。shared_future 保存的是结果本身 (在写端 set_value 时就已经存进了共享状态),而不是一个待消费的位置,所以每次 get() 都是读那份已存好的结果。这也是它和普通 future 最本质的区别。
4. std::shared_future<T>:一对多广播
4.1 share() 的时机:一个很隐蔽的坑
从 promise 拿到 shared_future 的标准写法是链式调用:
cpp
std::promise<int> p;
std::shared_future<int> sf = p.get_future().share();这里有个陷阱:p.get_future() 返回的是一个临时的 future 对象 ,.share() 把它移动 (转移共享状态所有权)成 shared_future。如果你想分成两步写,就会踩坑:
cpp
std::promise<int> p;

auto f = p.get_future();
std::shared_future<int> sf = f.share();      // 正确:f 被掏空,sf 接管
// 之后 f.valid() == false,千万不要再用 f

// ---- 下面这种是错的 ----
std::shared_future<int> sf2 = p.get_future(); // 编译不过:future 不能隐式转 shared_future另一个坑是忘记 share():
cpp
std::shared_future<int> sf = p.get_future().share();   // 对
auto f = p.get_future();                               // 忘了 share
std::thread t1([f] { f.get(); });                      // 想给线程用
// 如果 f 是 move-only 的 future,这里的按值捕获会失败(编译期就拦住了,反而是好事)
future 的 move-only 特性在编译期就挡住了大部分误用,这是好事------真正危险的是把 future 移动到 lambda 里之后又在外面 get(),那会在运行期抛 no_state,而不是编译失败。
4.2 什么时候该用 shared_future
判断标准很简单:这个结果是否需要被不止一个消费者拿到?
- 一个任务算出一个配置,三个子模块都要读 →
shared_future - 一次 RPC 的响应只给发起者 → 普通
future就够 - 一个"初始化完成"的信号要广播给所有等待线程 →
shared_future<void>(这个组合在启动流程里特别有用) - 结果要存进容器长期保留,且允许被多次读取 →
shared_future或 3.4 的AsyncResult
一个真实的模式示例------多个工作线程等待"配置加载完成",然后各自用自己的那份配置干活:
cpp
class ConfigLoader
{
public:
    std::shared_future<std::shared_ptr<const Config>> loadAsync()
    {
        auto configPromise = std::make_shared<std::promise<std::shared_ptr<const Config>>>();

        // 立刻 share() 出去,之后 response 一到就 set_value,多个等待者同时被唤醒
        std::shared_future<std::shared_ptr<const Config>> result =
            configPromise->get_future().share();

        std::thread([configPromise] {
            auto config = std::make_shared<const Config>(parseConfigFile());
            configPromise->set_value(config);     // 所有等待者都拿到同一个 shared_ptr
        }).detach();

        return result;
    }
};
这里用 shared_future<std::shared_ptr<const Config>> 而不是 shared_future<Config> 是有意的:Config 往往很大,拷贝到共享状态里是浪费;传 shared_ptr<const Config> 则让所有消费者共享同一份只读数据,get() 出来的拷贝只是拷贝一个指针。
shared_future 的一个代价 :因为要支持多次读取,结果必须能被拷贝(或者至少能被共享)。如果你的结果类型既不能拷贝也不便宜,那就用 shared_ptr 包一层,而不是硬塞进 shared_future<T> 里。
5. std::async:最省事的入口,也是最容易误用的入口
std::async 看起来像"把函数丢出去异步跑"的一键方案,这也是它被滥用的原因。它的实现里藏了几个设计上更偏向"安全"而非"高效"的权衡,理解这些权衡比背 API 重要得多。
5.1 launch policy 必须显式指定
cpp
template <class F, class... Args>
std::future<std::invoke_result_t<F, Args...>> async(F&& f, Args&&... args);   // policy 默认

template <class F, class... Args>
std::future<...> async(std::launch policy, F&& f, Args&&... args);
std::launch 只有两个位(可以按位或):
| policy | 语义 |
|---|---|
std::launch::async |
必须在新线程里立刻开始执行 |
std::launch::deferred |
延迟 :不创建线程,直到有人对 future 调 get()/wait() 时才在调用者线程里执行 |
| `std::launch::async | std::launch::deferred` |
最关键的一条:默认 policy 不是 launch::async。 很多人以为 std::async(f) 就是"异步跑 f",其实标准给的是"异步或延迟,由实现挑"。
理论上实现可以选 deferred。实测在 libstdc++ 上它选了 async(下面第 6 行显示任务已经开始跑但还没结束):
text
default policy: ran_before_get=0 status=timeout但这个"实测恰好是 async"并不能当保证用------换一个标准库、换一个版本,行为就可能变 。所以生产代码里请显式写 std::launch::async,把意图钉死。
5.2 陷阱一:临时 future 的析构会阻塞
这是 std::async 最反直觉的地方。看这段代码,注意两个打印之间的时间:
cpp
static steady_clock::time_point t0;
// t0 = steady_clock::now(); 已初始化

{
    std::async(std::launch::async, [] {
        std::this_thread::sleep_for(std::chrono::milliseconds(300));
        return 1;
    });
    std::cout << "[async temp] after scope: " << ms() << " ms\n";
}
产出:
text
[async temp] after scope: 300 ms打印出来的时间是 300ms,说明这一整段代码阻塞了 300ms------而这个 future 是一个临时对象,连个变量名都没接住,就在分号处析构了。
标准要求的是:对 std::async 返回的 future,如果它的共享状态来自 std::launch::async,且析构时任务尚未完成,析构必须等待任务完成 (等价于隐式的 join())。原因很合理------如果允许析构时把线程 detach 掉,那么这个线程可能会在任务执行到一半时访问已经被销毁的对象,那是内存安全问题。标准选择"宁可阻塞,也不要悬垂"。
注意这个语义只对 std::async 产生的 future 成立 。对比一下第 1.2 节的表:一个由你自己 promise 产生的 future,析构时是不会等的,因为责任在你身上。
5.3 陷阱二:漏接返回值,异步变成同步
上一节的代码之所以会阻塞 300ms,本质上是"没接住返回值"。加上变量名,行为立刻不同:
cpp
{
    auto f = std::async(std::launch::async, [] {
        std::this_thread::sleep_for(std::chrono::milliseconds(300));
        return 2;
    });
    (void)f;    // 别让编译器警告
}
实测累计耗时:
text
[async temp] after scope: 300 ms
[async named, no get] after scope: 600 ms
注意第二个数字是 600ms 而不是 300ms :因为变量 f 是在作用域结束时析构的,析构仍然要等任务完成,所以累计时间从 300 变成 600。给 future 起名字只是把阻塞点挪到了作用域末尾,并没有消除阻塞。
真正让它变成"不阻塞"的写法只有两种:
cpp
// 方式一:显式等待并消费结果(通常你本来就要结果)
auto f = std::async(std::launch::async, work);
auto result = f.get();

// 方式二:确实要"即发即忘",那就别用 std::async,用线程池
threadPool.submit(work);      // 不返回 future,或者返回的 future 语义明确是可丢弃的
顺便,libstdc++ 给 std::async 标了 [[nodiscard]],漏接返回值会报警告(实测确认会触发):
text
warning: ignoring return value of 'std::future<...> std::async(launch, _Fn&&, _Args&& ...)',
declared with attribute 'nodiscard' [-Wunused-result]
这个警告值得当成错误处理。它拦住的那一行,往往就是一个真实的性能问题。
5.4 陷阱三:deferred 把"异步"变成了"调用时才执行"
显式用 deferred 时,语义变化很大:
cpp
auto f = std::async(std::launch::deferred, [] {
    std::cout << "  deferred body runs on thread " << std::this_thread::get_id() << "\n";
    return 3;
});

std::cout << "  main thread id " << std::this_thread::get_id() << "\n";

auto st = f.wait_for(std::chrono::milliseconds(10));
std::cout << "  wait_for on deferred -> " << to_string(st) << "\n";
std::cout << "  get() -> " << f.get() << "\n";
实测输出(注意两个线程 ID 是完全一样的):
text
  main thread id 138562528479040
  wait_for on deferred -> deferred
  get() ->   deferred body runs on thread 138562528479040
3
从这段输出里能读出三件事:
- 任务根本没开始跑 ,直到
get()被调用;而且是在主线程 (也就是调用get()的那个线程)里执行的。所以deferred模式下的async完全不是异步,它只是"把一次函数调用推迟到你取结果的时候"。 wait_for()返回的是deferred,不是timeout,也不是ready。 这一点很要命:很多代码只判断timeout和ready,遇到deferred就落进了else分支,或者更糟------wait_for返回deferred之后代码继续往下走,以为已经就绪了。deferred任务不执行的话,异常也永远不会被抛出。
还有一个更隐蔽的后果:如果 deferred 的 future 在从未调用 get()/wait() 的情况下被销毁,那个任务永远不会执行。实测:
cpp
bool ran = false;
{
    auto f = std::async(std::launch::deferred, [&ran] { ran = true; return 0; });
    (void)f;
}
// 实测:ran == 0
任务被静默丢弃,没有任何错误、没有异常、没有日志。 在那种"发一个初始化任务,然后忘了取结果"的代码里,这会变成"偶尔配置没加载"这种最恶心的间歇性故障。
所以对于 deferred,工程上的建议很直接:除非你确实需要"延迟执行"这个语义(比如惰性求值),否则不要用;而一旦用了,就必须保证一定有 get() 或 wait()。
5.5 为什么不要拿 std::async 当线程池
三个理由,任意一个都足够致命:
理由一:无法控制并发度,没有队列,没有背压。 std::async(std::launch::async, f) 语义上要求"在新线程里执行"。标准允许实现用线程池,但不要求 。libstdc++ 的实现是每次调用都创建一个新线程,并在 future 析构时 join 掉。
顺便澄清一个容易踩的误区:网上常见"用线程 ID 判断 async 是否新建线程"的做法是不可靠的 ,实测 5 次连续 async 调用拿到的线程 ID 全都一样:
text
async 5 calls -> distinct tids: 1这不是因为复用了线程,而是因为每次的线程在 get() 返回后就已经结束了,操作系统把线程 ID 回收后分配给了下一个新线程。要判断"是否真的创建了线程",应该看创建/销毁开销,而不是看 ID。
理由二:析构阻塞语义让"排队"不可能。 线程池的核心价值是"任务排队等空闲 worker"。而 std::async 的 future 在析构时要等任务跑完,这就意味着你没法把一批 future 攒起来。如果一批任务超过了 CPU 核数,你只能一个一个阻塞地等,执行效率反而低于线程池。
理由三:即发即忘是不安全的。 想"丢出去就不管",就只能不接返回值;但那又回到 5.2 ------ 分号处就会阻塞,等于同步调用。
结论 :std::async 的定位是"一次性、数量少、要结果、可以等"的异步计算。任务数量上去了、需要限流了,就该换成 std::packaged_task + 线程池,也就是下一章。
5.6 异常处理上的一个真实差异
std::async 和 std::packaged_task 都会自动 把可调用对象抛出的异常存进共享状态,等待方 get() 时原样重新抛出。这一点比 std::promise 省事得多------promise 侧必须自己 catch (...) + set_exception(std::current_exception())。
实测异常类型和自定义错误码都能完整穿过线程边界:
cpp
struct MyErr : std::runtime_error {
    int code;
    MyErr(const char* m, int c) : std::runtime_error(m), code(c) {}
};

auto f = std::async(std::launch::async, []() -> int {
    throw MyErr("axis 3 not homed", 1003);
});

try {
    (void)f.get();
}
catch (const MyErr& e) {          // 精确捕获到原始类型
    // 实测:caught MyErr code=1003 what=axis 3 not homed
}但这里有个必须警惕的副作用 :如果这个 future 从来没有被 get() 过,那个异常就被静默丢弃 了。实测这不会导致 terminate,程序照常运行:
text
async discarded exception: no terminate"程序没崩"在这里是坏事而不是好事。 一个后台任务抛了异常,结果没有任何人知道,日志里一片干净。所以用 std::async/packaged_task 时,要么保证每个 future 都被 get(),要么在任务内部自己包一层 try-catch 记日志。这条规则在后面 RPC 客户端里同样适用。
6. std::packaged_task:线程池的正确零件
6.1 它到底是什么
std::packaged_task<F> 就是"一个 promise + 一个可调用对象"的捆绑包。它和 promise 的关系可以用一句话概括:
promise需要你手动调set_value();packaged_task在你调用它的时候自动完成这件事。
std::promise |
std::packaged_task |
|
|---|---|---|
| 结果来源 | 你手动 set_value / set_exception |
被包装函数的返回值 / 抛出的异常,自动存入 |
| 执行时机 | 由你控制(谁调 set_value 谁决定) |
由你控制(谁 operator() 谁决定) |
| 接口 | set_value / set_exception |
operator() / get_future() / reset() / make_ready_at_thread_exit() |
| 可拷贝性 | move-only | move-only |
packaged_task 的价值在于把"一个任务"和"它的结果槽"打包成了一个可以到处传递的对象------这正是任务队列需要的东西。
6.2 reset():复用同一个 task
一个 packaged_task 只能调用一次,之后它的共享状态就绪了。想复用同一个 task 对象,先 reset()------它会给你一块全新的共享状态:
cpp
int add(int a, int b) { return a + b; }

std::packaged_task<int(int, int)> task(add);

auto f1 = task.get_future();
task(1, 2);
std::cout << f1.get() << "\n";      // 3

task.reset();                        // 新的共享状态,可以再跑一次
auto f2 = task.get_future();
task(3, 4);
std::cout << f2.get() << "\n";      // 7
实测输出:
text
pt f1=3
pt reset f2=7
reset() 的实际用途是"让一个 task 对象在队列里反复被使用",不过在真正的线程池里更常见的做法是每次 submit 都新建一个 task,因为任务参数是不同的。reset() 更适合"同一个无参任务定期触发"的场景。
6.3 用 packaged_task 写一个能用的线程池
这是 packaged_task 真正的主场。下面这个实现只有 30 来行,但已经是生产可用的骨架:
cpp
#include <condition_variable>
#include <deque>
#include <functional>
#include <future>
#include <mutex>
#include <thread>
#include <type_traits>
#include <vector>

class ThreadPool
{
public:
    explicit ThreadPool(unsigned workers)
    {
        for (unsigned i = 0; i < workers; ++i) {
            workers_.emplace_back([this] { workerLoop(); });
        }
    }

    ~ThreadPool()
    {
        {
            std::lock_guard<std::mutex> lock(mutex_);
            stop_ = true;
        }
        cv_.notify_all();

        for (auto& t : workers_) {
            t.join();          // 保证线程池销毁前所有任务都跑完,避免 UAF
        }
    }

    ThreadPool(const ThreadPool&) = delete;
    ThreadPool& operator=(const ThreadPool&) = delete;

    template <typename F>
    auto submit(F&& fn)
    {
        using Result = std::invoke_result_t<F>;

        // 关键点:packaged_task 是 move-only 的,不能直接塞进
        // std::function<void()> 队列里,必须用 shared_ptr 包一层
        auto task = std::make_shared<std::packaged_task<Result()>>(
            std::forward<F>(fn));
        std::future<Result> future = task->get_future();

        {
            std::lock_guard<std::mutex> lock(mutex_);
            queue_.emplace_back([task] { (*task)(); });
        }

        cv_.notify_one();
        return future;
    }

private:
    void workerLoop()
    {
        for (;;) {
            std::function<void()> job;

            {
                std::unique_lock<std::mutex> lock(mutex_);
                cv_.wait(lock, [this] { return stop_ || !queue_.empty(); });

                if (stop_ && queue_.empty()) {
                    return;                       // 收到停止信号且队列已空,退出
                }

                job = std::move(queue_.front());
                queue_.pop_front();
            }

            job();                                // 锁外执行任务,避免持锁跑业务代码
        }
    }

    std::mutex mutex_;
    std::condition_variable cv_;
    std::deque<std::function<void()>> queue_;
    std::vector<std::thread> workers_;
    bool stop_ = false;
};
三个值得注意的实现细节,都是踩过坑才写出来的:
packaged_task必须用shared_ptr包。 因为std::function要求可拷贝,而packaged_task是 move-only 的。如果直接写queue_.emplace_back(std::move(task)),编译不过。用shared_ptr包一层既解决了拷贝问题,也天然处理了生命周期。~ThreadPool()先置stop_再notify_all(),然后join()。 顺序不能反:先 join 会让 worker 永远等不到停止信号。join的意义是把 5.2 节那个"析构必须安全"的语义显式做掉------保证所有任务完成才让线程池消失。job()在锁外执行。 worker 从队列里取出任务之后立刻释放锁再执行。否则所有 worker 会串行化(更糟的是,如果任务自己又往池里submit,就是死锁)。
跑一批任务验证一下:
cpp
ThreadPool pool(4);

std::vector<std::future<int>> futures;
for (int i = 0; i < 8; ++i) {
    futures.push_back(pool.submit([i] {
        std::this_thread::sleep_for(std::chrono::milliseconds(20));
        return i * i;
    }));
}

int sum = 0;
for (auto& f : futures) {
    sum += f.get();       // 0+1+4+9+16+25+36+49
}
std::cout << "sum = " << sum << "\n";       // 实测输出:pool sum=140
和 std::async 的对比 :4 个 worker 处理 8 个任务,任务排队而不是新开 8 个线程;返回的 future 语义和 async 完全一致(包括异常传播),但析构不会阻塞 ------因为线程池自己 join,future 只是一个普通的读端句柄。这就是为什么"要并发控制就得用 packaged_task + 池"。
6.4 make_ready_at_thread_exit()
packaged_task 也有"线程退出时才就绪"的版本:
cpp
void make_ready_at_thread_exit(Args... args);语义和 promise::set_value_at_thread_exit()(2.6 节)一样:等当前线程的 thread_local 对象析构完成才置为就绪。使用场景也类似------任务执行完需要清理线程局部资源,而你想让等待方知道"连清理都完成了"。
7. 三个生产者怎么选
7.1 对比表
| 对比项 | std::promise |
std::packaged_task |
std::async |
|---|---|---|---|
| 结果由谁填入 | 你手动调用 | 被包装函数的返回/抛出 | 被包装函数的返回/抛出 |
| 任务由谁执行 | 你自己安排 | 你自己安排(通常是线程池) | 标准库(新线程或调用线程) |
| 能否控制并发度 | 完全可控 | 完全可控 | 不可控 |
| 适合回调型异步(网络/RPC/设备) | 最合适 | 不合适 | 不合适 |
| 适合有返回值的任务队列 | 需要自己封装 | 最合适 | 不合适 |
| 适合一次性异步计算 | 可以但啰嗦 | 可以 | 最合适 |
| 返回的 future 析构是否会阻塞 | 否 | 否 | 会 (launch::async 且未完成时) |
| 异常自动传播 | 需手动 catch + set_exception |
自动 | 自动 |
| 能否复用同一个对象 | 否(一次一个结果) | 可以(reset()) |
否 |
7.2 选择流程
text
结果的产生是不是由"外部事件"驱动的?
(网络包到达、RPC 回包、设备中断、另一个模块回调你)
   │
   ├── 是 ──> std::promise(放进一张表里等,多半配 shared_ptr)
   │
   └── 否 ──> 有一个明确的函数要执行
                │
                ├── 任务数量少、需要结果、可以阻塞等待 ──> std::async(launch::async, f)
                │
                └── 任务多 / 需要限流 / 需要排队 / 要复用线程 ──> packaged_task + 线程池
7.3 和其他并发原语的边界
future/promise 不是唯一的线程通信方式,知道各自边界能少走弯路:
| 你的需求 | 该用什么 |
|---|---|
| 一个线程等一个结果,且希望结果带异常语义 | future / promise |
| 一个结果要给多个消费者 | shared_future |
| 一批任务要控制并发度 | packaged_task + 线程池 |
| 简单的"等一个事件发生/等一个计数器归零" | std::condition_variable 或 std::counting_semaphore |
| 高频、低延迟的数据流(音频帧、传感器采样) | 环形缓冲 + 条件变量/信号量,不要用 future(每个结果一次堆分配 + 一次唤醒,开销太大) |
| 一次性初始化,只需要"完成信号" | std::call_once / std::latch(C++20) |
最后一行值得展开一句:如果你只是需要"等某件事完成",而不是"拿一个结果",future 往往是杀鸡用牛刀。 它带来的是一次堆分配、一个引用计数、一次条件变量唤醒。std::call_once 或者 C++20 的 std::latch/std::barrier 在这种场景下更轻、语义也更准。
7.4 std::future 最被诟病的缺陷:不会组合
用过 JavaScript Promise、Rust Future 或者 Python asyncio 的人,回到 C++ 的标准 future 会有强烈的落差:它没有 .then(),也不能 wait_any / when_all。
这意味着下面这种需求:
请求 A 和请求 B 并行发出,两个都回来之后合并结果
在标准 C++ 里没有直接支持。你得自己写:
cpp
auto fa = client.call(reqA, idA);
auto fb = client.call(reqB, idB);

// 没有 when_all,只能手写。而且注意:这里是串行等待,
// 总耗时是两个请求的较大者,而不是相加 ------ 因为两个请求本来就并行在跑
std::string ra = fa.get();
std::string rb = fb.get();
上面这段其实还行(因为两个请求在底层已经并发了)。真正难办的是"等一组动态数量的 future 中任意一个完成"------没有 wait_any,你只能给每个 future 配一个线程去 wait(),然后往一个队列里投递完成通知,等于自己实现一遍。
这也是为什么在 C++20 之后,出现了多种"下一代"方案:std::execution(P2300,基于 sender/receiver)、以及各种基于协程的异步库。相关内容放在第 13 章。
8. 超时、取消与迟到响应:异步工程里最容易出错的地方
前面七章讲的是"怎么用"。从这一章开始讲"怎么用不出事"。
8.1 先把因果链讲透:wait_for 超时只等于"我不等了"
cpp
if (future.wait_for(std::chrono::seconds(5)) == std::future_status::timeout) {
    return;      // 这行只做了一件事:调用者停止等待
}这行代码没有做到的事情,列出来比说"超时不会取消任务"有说服力得多:
- 共享状态还在,那个
promise还是活的; - 请求报文已经发出去了,在网络上跑着;
- 服务端可能正在处理,第 6 秒就会回一个包;
- 你的
pending_表里那条记录还在(如果没清理,就是内存泄漏); - 底层 socket 没关;
- 如果 remote 是个子进程或者长任务,它还在占 CPU。
所以超时一旦发生,有四个问题必须被回答,这四个问题的答案就是你的取消机制:
- 表里的记录谁来删?
- 迟到的响应回来了怎么处理?
- 这个
id还能不能给下一个请求用? - 对端要不要通知一声"这个请求我取消了"?
原封不动照抄"超时就 return"的代码,第 1 和第 3 个问题就没人回答了。这是线上故障的起点。
8.2 取消的三个层次
"取消"不是一个动作,而是一组分层的能力。想清楚自己在哪一层,就不会对 wait_for 抱不切实际的期待。
| 层次 | 做什么 | 具体手段 | 能真正停下工作吗 |
|---|---|---|---|
| 第一层:读端放弃 | 停止等待,清理本地状态 | 从表里删除、记日志、计数 | 不能 |
| 第二层:写端通知 | 让共享状态变成"已就绪的取消态" | promise->set_exception(...) |
不能 |
| 第三层:通知对端 | 告诉远端别再算了 | 发 cancel 报文、RST、SIGTERM |
视协议而定 |
| 第四层:本地中断 | 打断正在跑的本地任务 | std::stop_token、关闭 fd/epoll、原子标志位 |
能 |
在 RPC 场景下,第一层是必须的,第三层是"如果有就做",第四层通常无关 ------因为工作跑在远端,你无法让别人的 CPU 停下来。在本地线程池场景下,第四层才是关键,因为工作就在你自己进程里。
顺便澄清一个我一直觉得被误传的说法。很多资料会写"不要在持有 pending_ 表的锁时调用 set_value(),否则会死锁"。严格说来,如果用的是纯粹的 std::promise,这个说法是错的 ------promise::set_value() 不执行任何用户回调,等待方被唤醒后要自己去抢锁,而唤醒方在 set_value() 返回后立刻就会释放锁,不存在循环等待。
但那句忠告依然应该遵守,只是理由要换成正确的:
- 临界区膨胀:持锁期间做唤醒工作,其他 worker 全在锁上排着;
- 优先级反转:被唤醒的往往是高优先级业务线程,让它等在一把为了访问哈希表而存在的琐碎锁上,很亏;
- 一旦你加了回调就真的会死锁 :这是最关键的一条。
std::promise本身没有 continuation,但你的RpcClient迟早会演化------比如加一个"请求完成时触发回调"的钩子,或者把响应投递到一个std::function<void()>队列。那一刻,持锁调用这个钩子就变成了教科书式的死锁。先按安全的方式写,就不会在演化时踩坑。
所以正确写法始终是"取出来、放掉锁、再设置":
cpp
std::shared_ptr<std::promise<std::string>> promise;

{
    std::lock_guard<std::mutex> lock(mutex_);
    auto it = pending_.find(id);
    if (it == pending_.end()) {
        return;                       // 已经超时清理过了
    }
    promise = it->second;             // 只在这里动表
    pending_.erase(it);
}                                     // 锁在这里释放

promise->set_value(response);         // 锁外唤醒
8.3 超时路径上为什么还要 set_exception
既然调用方已经放弃了等待,那一刻它并不在 get() 上,给这个 promise 设置异常还有意义吗?有意义,而且很重要:
如果你只是把表项从容器里删掉,那个 promise 的引用计数归零、对象析构,等待方(可能还在另一个线程上等)就会收到一个 broken_promise。 这个异常既无法区分"请求超时"和"写端代码有 bug",也不带任何上下文。相反,显式投递一个业务异常,等待方拿到的是:
text
std::runtime_error: RPC request 0x2a timed out after 5000 ms一句话结论:能在超时路径上把共享状态"关闭"(set_value 或 set_exception),就不要让它靠析构来关闭。 前者是可诊断的,后者只能靠猜。
8.4 迟到响应:最危险的那种处理方式
超时清理掉表项之后,迟到的响应必然会来(除非协议是请求-响应严格同步的)。三种处理策略:
| 策略 | 做法 | 适用场景 |
|---|---|---|
| 丢弃 + 计数 | 表里查不到就丢掉,同时把一个计数器 +1 | 默认选择,配一条有节流的日志 |
| 丢弃 + 记录 | 完整记录 id、时间戳、body 摘要 | 排查"为什么这个请求偶尔错配"时打开 |
| 缓存供查询 | 存进一个有上限的 map,供上层用 id 查一次 | 对端会重传、或业务需要"事后取结果" |
绝对不能做的是把它当作"重试的结果"投递给另一个请求。 这就是 id 复用带来的最严重故障:请求 A 超时,id=7 被借给了请求 B,这时 A 的响应回来了,被投递给了 B------B 拿到了 A 的结果,而且再也没有任何报错。这类 bug 在业务层表现为"偶尔返回了上一条指令的结果",通常要花很久才能定位。
防它的办法很简单,只有一条:请求 id 用单调递增的计数器,永不复用。
cpp
uint64_t nextRequestId() noexcept
{
    return nextId_.fetch_add(1, std::memory_order_relaxed);
}
如果是那种 id 只有 16 bit 的协议(很多工业协议如此),做不到永不复用,那就要显式为"绕回来了"这件事做检测 :表里保存 是否曾经存在过这个 id 的旧请求,命中时直接确认是错配并抛弃,而不是赌它不会发生。
8.5 请求表泄漏:比超时更常见的慢性病
比"迟到响应"更阴险的情况是:根本没人来清理。
调用方拿到 future 之后,可能自己上层就 return 了(例如那个"用户点了取消"的路径),既没 wait_for 也没有 cancel()。于是 pending_ 里那条记录永远留着,promise 永远不析构,请求表一路涨到 OOM。这种故障不会报错,只会看到内存曲线慢慢爬。
标准做法是给表项带上 deadline,由后台线程定期扫:
cpp
struct PendingEntry
{
    std::shared_ptr<std::promise<std::string>> promise;
    std::chrono::steady_clock::time_point deadline;
    uint64_t id = 0;
};
清理线程用 condition_variable::wait_until(earliestDeadline) 睡觉------不是 sleep_for(1s) 轮询。这样既不会空转,也能在"有新请求进来"时立刻醒来重算最早截止时间:
cpp
void sweeperLoop()
{
    std::unique_lock<std::mutex> lock(mutex_);

    while (!stop_) {
        if (pending_.empty()) {
            cv_.wait(lock, [this] { return stop_ || !pending_.empty(); });
            continue;
        }

        // 找最早的 deadline
        auto earliest = std::min_element(
            pending_.begin(), pending_.end(),
            [](const auto& a, const auto& b) {
                return a.second.deadline < b.second.deadline;
            })->second.deadline;

        if (cv_.wait_until(lock, earliest, [this] { return stop_; })) {
            break;                                  // 被 stop 唤醒
        }

        // 超时到点:一次性收割所有已过期的
        const auto now = std::chrono::steady_clock::now();
        std::vector<std::shared_ptr<std::promise<std::string>>> expired;

        for (auto it = pending_.begin(); it != pending_.end(); ) {
            if (it->second.deadline <= now) {
                expired.push_back(it->second.promise);
                it = pending_.erase(it);
            }
            else {
                ++it;
            }
        }

        lock.unlock();                              // 锁外投递,理由见 8.2
        for (auto& p : expired) {
            try {
                p->set_exception(std::make_exception_ptr(
                    std::runtime_error("request abandoned: swept by timeout")));
            }
            catch (const std::future_error&) {
                // 已经被正常响应设置过,忽略
            }
        }
        lock.lock();
    }
}
有了 sweeper,即使上层代码完全忘了处理 future,表也不会泄漏------最多是每个请求多活一个超时周期。这是我认为 RPC 客户端里最值得写的一段代码,因为它把一个"只能靠 code review 发现的缺陷"变成了一个"不可能发生的缺陷"。
需要说明的是,sweeper 是兜底 ,不是替代方案:调用路径上的 wait_for + cancel 才是主路径。两层都有,才会既不泄漏也不会"等了很久才发现超时"。
8.6 deferred 的 wait_for 会让状态判断失效
回到 5.4 节那个坑,在超时代码里它变成一个具体的 bug:
cpp
const auto status = future.wait_for(std::chrono::seconds(5));

if (status == std::future_status::timeout) {
    // 超时分支
}
else {
    // 这里假定是 ready ------ 但如果 status == deferred,这个假设是错的
    auto v = future.get();
}
如果这个 future 来自"用了默认 policy 的 std::async",而实现选择了 deferred,那么 wait_for 会立刻返回 deferred,代码落进 else 分支,然后 future.get() 会在当前线程同步执行整个任务------你以为加了 5 秒超时保护,实际上变成了一个没有超时的同步调用。
所以判断状态时永远是三段式,不能二段式:
cpp
const auto status = future.wait_for(timeout);

if (status == std::future_status::timeout) {
    // 超时
}
else if (status == std::future_status::ready) {
    // 就绪,可以安全 get()
}
else {
    // deferred:任务还没开始跑。
    // 要么改 policy 从根上避免,要么明确决定"在这里同步执行它"
    // 千万不要当作 ready 直接 get()
}好消息是:对 std::promise 和 std::packaged_task 产生的 future,wait_for 不可能返回 deferred ,只有 std::async(且 policy 含 deferred)才会。所以如果你的 RPC 客户端内部只用 promise,这个分支理论上到不了------但依然建议写全,因为"理论上到不了"的分支在重构之后经常会到达。
9. 完整实现:一个能上生产的 RPC 客户端
把前面八章的结论落到一个真实对象上。这不是伪代码,下面这个完整示例可以直接编译运行(第 9.3 节给出实测输出)。
9.1 设计要点清单
先把要满足的约束列清楚,代码就是这些约束的直接翻译:
| 编号 | 约束 | 对应章节 |
|---|---|---|
| 1 | 每个请求必须有唯一 id,且永不复用 | 8.4 |
| 2 | id 重复必须立刻拒绝,而不是覆盖 | 8.4 |
| 3 | 表项必须带 deadline,超时由后台扫描兜底 | 8.5 |
| 4 | 响应到达时先在锁内摘除表项,锁外 再 set_value |
8.2 |
| 5 | 超时路径要把共享状态"关闭"(投递异常),不能靠析构 | 8.3 |
| 6 | 迟到响应必须能识别出来并计数,绝不投递给别的请求 | 8.4 |
| 7 | 析构时要把所有未完成的请求显式关闭,等待方不该收到 broken_promise |
2.7 |
| 8 | 调用方放弃等待(连 cancel 都没调)也不能泄漏表项 |
8.5 |
| 9 | 传输层的回调必须在对象析构前解除,避免回调打到一个已死对象上 | 2.7 |
第 9 条来自一个很现实的教训:原文章节里那个 RpcClient 用 detach() 的线程模拟发送,main 返回时 client 销毁了,而那个 detached 线程还在跑,它的下一句 onResponse(...) 就踩在 this 的墓碑上。这类 use-after-free 在 release 下不报错,只在特定时序下偶发 Crash------如果要在示例里用后台线程模拟传输层,就必须让这个线程的收尾过程被 join 管住 ,或者确保对象比线程活得久。本章的 FakeTransport 用前者:不真的开线程,回包时机由测试代码显式控制。
9.2 完整代码
cpp
// ============ rpc_demo.cpp 完整实现(可直接编译运行)============
// 编译:g++ -std=c++17 -O2 -pthread -o rpc_demo rpc_demo.cpp
#include <algorithm>
#include <atomic>
#include <chrono>
#include <condition_variable>
#include <cstdint>
#include <exception>
#include <functional>
#include <future>
#include <iostream>
#include <mutex>
#include <set>
#include <stdexcept>
#include <string>
#include <thread>
#include <unordered_map>
#include <vector>

namespace rpc {

// ---------------------------------------------------------------
// 业务异常类型:让调用方能够区分"对端拒绝"和"本地超时/取消"
// ---------------------------------------------------------------
struct TimeoutError : std::runtime_error
{
    explicit TimeoutError(const std::string& what)
        : std::runtime_error("request timeout: " + what)
    {
    }
};

struct CancelledError : std::runtime_error
{
    explicit CancelledError(const std::string& reason)
        : std::runtime_error("request cancelled: " + reason)
    {
    }
};

// ---------------------------------------------------------------
// 传输层抽象。真实项目里这是 socket / 串口 / 共享内存的实现,
// 它只负责"把请求发出去",以及"把收到的响应回调上来"。
// 回调可能在任意线程、任意时刻发生,包括请求超时之后。
// ---------------------------------------------------------------
class Transport
{
public:
    using ResponseHandler = std::function<void(uint64_t id, std::string payload)>;
    using ErrorHandler = std::function<void(uint64_t id, std::exception_ptr ep)>;

    virtual ~Transport() = default;

    virtual void send(uint64_t id, const std::string& request) = 0;
    virtual bool cancel(uint64_t id) = 0;

    void onResponse(ResponseHandler handler) { responseHandler_ = std::move(handler); }
    void onError(ErrorHandler handler) { errorHandler_ = std::move(handler); }

protected:
    ResponseHandler responseHandler_;
    ErrorHandler errorHandler_;
};

// ---------------------------------------------------------------
// 测试用传输层:不真的发包,由测试代码决定什么时候回包。
// 这样才能精确构造"超时之后迟迟才到"这种时序。
// ---------------------------------------------------------------
class FakeTransport : public Transport
{
public:
    void send(uint64_t id, const std::string& request) override
    {
        std::lock_guard<std::mutex> lock(mutex_);
        sent_.emplace_back(id, request);
    }

    bool cancel(uint64_t id) override
    {
        std::lock_guard<std::mutex> lock(mutex_);
        cancelled_.insert(id);
        return true;
    }

    // 模拟"响应到达"
    void deliver(uint64_t id, const std::string& payload) const
    {
        if (responseHandler_) {
            responseHandler_(id, payload);
        }
    }

    // 模拟"传输层出错"
    void deliverError(uint64_t id, std::exception_ptr ep) const
    {
        if (errorHandler_) {
            errorHandler_(id, ep);
        }
    }

    bool wasCancelled(uint64_t id) const
    {
        std::lock_guard<std::mutex> lock(mutex_);
        return cancelled_.count(id) != 0;
    }

    size_t sentCount() const
    {
        std::lock_guard<std::mutex> lock(mutex_);
        return sent_.size();
    }

private:
    mutable std::mutex mutex_;
    std::vector<std::pair<uint64_t, std::string>> sent_;
    std::set<uint64_t> cancelled_;
};

// ---------------------------------------------------------------
// RPC 客户端
// ---------------------------------------------------------------
class RpcClient
{
public:
    enum class Status
    {
        ok,
        timeout,
        cancelled,
        transport_error,
    };

    struct Response
    {
        Status status = Status::transport_error;
        std::string payload;
        std::string detail;
    };

    RpcClient(std::shared_ptr<Transport> transport,
              std::chrono::milliseconds defaultTimeout)
        : transport_(std::move(transport)),
          defaultTimeout_(defaultTimeout)
    {
        transport_->onResponse([this](uint64_t id, std::string payload) {
            onResponse(id, std::move(payload));
        });
        transport_->onError([this](uint64_t id, std::exception_ptr ep) {
            onError(id, ep);
        });

        sweeper_ = std::thread([this] { sweeperLoop(); });
    }

    ~RpcClient()
    {
        // 1) 停掉扫描线程(join 之前必须放开 mutex_,否则扫描线程拿不到锁)
        {
            std::lock_guard<std::mutex> lock(mutex_);
            stop_ = true;
        }
        cv_.notify_all();
        if (sweeper_.joinable()) {
            sweeper_.join();
        }

        // 2) 把还挂着的请求全部显式"关闭",别让等待方收到 broken_promise
        std::vector<std::shared_ptr<std::promise<std::string>>> orphans;
        {
            std::lock_guard<std::mutex> lock(mutex_);
            for (auto& kv : pending_) {
                orphans.push_back(kv.second.promise);
            }
            pending_.clear();
        }
        for (auto& p : orphans) {
            try {
                p->set_exception(std::make_exception_ptr(
                    std::runtime_error("rpc client is shutting down")));
            }
            catch (const std::future_error&) {
                // 已经被响应路径设置过,忽略
            }
        }

        // 3) 摘掉回调。之后传输层再收到任何东西,都不会打到已析构的 this 上
        transport_->onResponse(nullptr);
        transport_->onError(nullptr);
    }

    RpcClient(const RpcClient&) = delete;
    RpcClient& operator=(const RpcClient&) = delete;

    // 单调递增的请求 id,永不复用(约束 1)
    static uint64_t nextRequestId() noexcept
    {
        static std::atomic<uint64_t> counter{1};
        return counter.fetch_add(1, std::memory_order_relaxed);
    }

    // 推荐使用的同步接口:内部完成"登记 -> 发送 -> 等待 -> 清理"
    Response call(uint64_t id, const std::string& request)
    {
        return call(id, request, defaultTimeout_);
    }

    Response call(uint64_t id, const std::string& request,
                  std::chrono::milliseconds timeout)
    {
        std::future<std::string> future = callAsync(id, request, timeout);

        if (!future.valid()) {
            return {Status::transport_error, {}, "future is invalid"};
        }

        const auto status = future.wait_for(timeout);

        if (status == std::future_status::timeout) {
            cancel(id, "caller timed out");
            return {Status::timeout, {},
                    "timed out after " + std::to_string(timeout.count()) + " ms"};
        }

        if (status != std::future_status::ready) {
            // promise 产生的 future 不会 deferred,这里只是把分支写全
            cancel(id, "unexpected future status");
            return {Status::transport_error, {}, "future is not ready"};
        }

        try {
            return {Status::ok, future.get(), {}};
        }
        catch (const CancelledError& e) {
            return {Status::cancelled, {}, e.what()};
        }
        catch (const std::exception& e) {
            // 包括 future_error(no_state / broken_promise)和传输层异常
            return {Status::transport_error, {}, e.what()};
        }
    }

    // 底层接口:只负责登记和发送,等待交给调用方(因此调用方也要负责超时清理)
    std::future<std::string> callAsync(uint64_t id, const std::string& request,
                                       std::chrono::milliseconds timeout)
    {
        auto promise = std::make_shared<std::promise<std::string>>();
        auto future = promise->get_future();
        const auto deadline = std::chrono::steady_clock::now() + timeout;

        {
            std::lock_guard<std::mutex> lock(mutex_);

            // 约束 2:id 重复直接拒绝,绝不覆盖 ------ 覆盖就是响应错配的根源
            if (pending_.count(id) != 0) {
                throw std::invalid_argument(
                    "duplicate request id: " + std::to_string(id));
            }

            pending_.emplace(id, PendingEntry{promise, deadline});
        }
        cv_.notify_all();                     // 让扫描线程重算最早截止时间

        try {
            transport_->send(id, request);
        }
        catch (...) {
            // 发送失败:立刻摘掉表项并投递异常,让等待方马上拿到失败,
            // 而不是傻等到超时。这里不 rethrow,异常通过 future 传递。
            if (auto p = takeOut(id)) {
                try {
                    p->set_exception(std::current_exception());
                }
                catch (const std::future_error&) {
                }
            }
        }

        return future;
    }

    bool cancel(uint64_t id, const std::string& reason)
    {
        auto promise = takeOut(id);
        if (!promise) {
            return false;                     // 已经完成或已经取消过
        }

        transport_->cancel(id);               // 尽力而为地通知对端(第三层取消)

        try {
            promise->set_exception(std::make_exception_ptr(CancelledError(reason)));
        }
        catch (const std::future_error&) {
            // 极小概率:扫描线程和响应线程同时命中了这条记录
        }
        return true;
    }

    size_t pendingCount() const
    {
        std::lock_guard<std::mutex> lock(mutex_);
        return pending_.size();
    }

    uint64_t lateResponseCount() const noexcept
    {
        return lateResponses_.load(std::memory_order_relaxed);
    }

    uint64_t sweptCount() const noexcept
    {
        return swept_.load(std::memory_order_relaxed);
    }

private:
    struct PendingEntry
    {
        std::shared_ptr<std::promise<std::string>> promise;
        std::chrono::steady_clock::time_point deadline;
    };

    // 统一出口:从表里摘除并返回。谁摘到谁负责设置结果。
    // 这个函数的存在保证了"锁只用来动表,唤醒永远在锁外"(约束 4)。
    std::shared_ptr<std::promise<std::string>> takeOut(uint64_t id)
    {
        std::lock_guard<std::mutex> lock(mutex_);
        auto it = pending_.find(id);
        if (it == pending_.end()) {
            return nullptr;
        }
        auto promise = it->second.promise;
        pending_.erase(it);
        return promise;
    }

    // 传输层回调,可能在任意线程、任意时刻被调用
    void onResponse(uint64_t id, const std::string& payload)
    {
        auto promise = takeOut(id);

        if (!promise) {
            // 约束 6:表里没有 = 请求已经超时/取消,或者 id 用错了。
            // 只计数、只记日志,绝不投递给任何其他请求。
            lateResponses_.fetch_add(1, std::memory_order_relaxed);
            return;
        }

        try {
            promise->set_value(payload);      // 锁外唤醒
        }
        catch (const std::future_error&) {
        }
    }

    void onError(uint64_t id, std::exception_ptr ep)
    {
        auto promise = takeOut(id);
        if (!promise) {
            lateResponses_.fetch_add(1, std::memory_order_relaxed);
            return;
        }

        try {
            promise->set_exception(ep);
        }
        catch (const std::future_error&) {
        }
    }

    // 约束 3 / 8:兜底扫描。调用方彻底忘了这个请求,也不会泄漏表项
    void sweeperLoop()
    {
        std::unique_lock<std::mutex> lock(mutex_);

        while (!stop_) {
            if (pending_.empty()) {
                cv_.wait(lock, [this] { return stop_ || !pending_.empty(); });
                continue;
            }

            auto earliest = std::chrono::steady_clock::time_point::max();
            for (const auto& kv : pending_) {
                earliest = std::min(earliest, kv.second.deadline);
            }

            // 一觉睡到"最早的那个 deadline",而不是 sleep_for 轮询
            if (cv_.wait_until(lock, earliest, [this] { return stop_; })) {
                break;                        // 被析构唤醒
            }

            const auto now = std::chrono::steady_clock::now();
            std::vector<std::shared_ptr<std::promise<std::string>>> expired;

            for (auto it = pending_.begin(); it != pending_.end(); ) {
                if (it->second.deadline <= now) {
                    expired.push_back(it->second.promise);
                    it = pending_.erase(it);
                }
                else {
                    ++it;
                }
            }

            swept_.fetch_add(expired.size(), std::memory_order_relaxed);

            lock.unlock();                    // 锁外投递(约束 4)
            for (auto& p : expired) {
                try {
                    p->set_exception(std::make_exception_ptr(
                        TimeoutError("swept by background cleaner")));
                }
                catch (const std::future_error&) {
                }
            }
            lock.lock();
        }
    }

    mutable std::mutex mutex_;
    std::condition_variable cv_;
    std::unordered_map<uint64_t, PendingEntry> pending_;
    std::thread sweeper_;
    std::atomic<uint64_t> lateResponses_{0};
    std::atomic<uint64_t> swept_{0};
    std::shared_ptr<Transport> transport_;
    std::chrono::milliseconds defaultTimeout_;
    bool stop_ = false;
};

}  // namespace rpc

// ---------------------------------------------------------------
// 演示
// ---------------------------------------------------------------
namespace {

const char* toText(rpc::RpcClient::Status s)
{
    switch (s) {
    case rpc::RpcClient::Status::ok:              return "ok";
    case rpc::RpcClient::Status::timeout:         return "timeout";
    case rpc::RpcClient::Status::cancelled:       return "cancelled";
    case rpc::RpcClient::Status::transport_error: return "transport_error";
    }
    return "unknown";
}

}  // namespace

int main()
{
    auto transport = std::make_shared<rpc::FakeTransport>();

    {
        rpc::RpcClient client(transport, std::chrono::milliseconds(200));

        // ---- 场景一:正常响应 ----
        {
            const uint64_t id = rpc::RpcClient::nextRequestId();

            std::thread responder([&transport, id] {
                std::this_thread::sleep_for(std::chrono::milliseconds(50));
                transport->deliver(id, R"({"axis":3,"state":"homed"})");
            });

            const auto r = client.call(id, R"({"cmd":"axis_init","axis":3})");
            responder.join();

            std::cout << "[1] normal      -> " << toText(r.status) << "  " << r.payload << "\n";
        }

        // ---- 场景二:超时 + 迟到响应 ----
        {
            const uint64_t id = rpc::RpcClient::nextRequestId();
            const auto r = client.call(id, R"({"cmd":"slow_op"})",
                                       std::chrono::milliseconds(120));

            std::cout << "[2] timeout     -> " << toText(r.status) << "  " << r.detail << "\n";
            std::cout << "    transport cancel called : "
                      << std::boolalpha << transport->wasCancelled(id) << "\n";

            // 请求已经超时清理完了,响应现在才到
            transport->deliver(id, R"({"late":true})");

            std::cout << "    late responses          : " << client.lateResponseCount() << "\n";
            std::cout << "    pending after late resp : " << client.pendingCount() << "\n";
        }

        // ---- 场景三:并发请求,id 唯一保证响应不会错配 ----
        {
            std::vector<std::pair<uint64_t, std::string>> items;
            for (int i = 0; i < 4; ++i) {
                items.emplace_back(rpc::RpcClient::nextRequestId(),
                                   "cmd_" + std::to_string(i));
            }

            // 注意:这里必须让四条 call 真正并发。
            // 如果串行调用,只有第一条能在 responder 投递(20ms)之前完成登记,
            // 后面三条的响应会先于登记到达,被当成"迟到响应"丢弃 ------ 那样测的
            // 就不是"并发不乱",而是"登记太晚"了。
            std::vector<rpc::RpcClient::Response> results(items.size());
            std::vector<std::thread> callers;
            for (size_t i = 0; i < items.size(); ++i) {
                callers.emplace_back([&client, &items, &results, i] {
                    results[i] = client.call(items[i].first, items[i].second);
                });
            }

            std::vector<std::thread> responders;
            for (const auto& item : items) {
                responders.emplace_back([&transport, id = item.first, payload = item.second] {
                    std::this_thread::sleep_for(std::chrono::milliseconds(20));
                    transport->deliver(id, "echo:" + payload);
                });
            }

            for (auto& t : callers) {
                t.join();
            }
            for (auto& t : responders) {
                t.join();
            }

            for (size_t i = 0; i < items.size(); ++i) {
                std::cout << "[3] id=" << items[i].first << "       -> "
                          << toText(results[i].status) << "  " << results[i].payload << "\n";
            }
        }

        // ---- 场景四:调用方彻底放弃(连 cancel 都没调),靠 sweeper 兜底 ----
        {
            const uint64_t id = rpc::RpcClient::nextRequestId();

            // 拿到 future 就扔了 ------ 这是线上内存泄漏最常见的来源
            auto abandoned = client.callAsync(id, R"({"cmd":"forgotten"})",
                                              std::chrono::milliseconds(100));
            (void)abandoned;

            std::this_thread::sleep_for(std::chrono::milliseconds(250));

            std::cout << "[4] abandoned   -> pending=" << client.pendingCount()
                      << "  swept=" << client.sweptCount() << "\n";
        }
    }

    std::cout << "transport sent " << transport->sentCount() << " requests in total\n";
    return 0;
}
9.3 实测输出与解读
text
[1] normal      -> ok  {"axis":3,"state":"homed"}
[2] timeout     -> timeout  timed out after 120 ms
    transport cancel called : true
    late responses          : 1
    pending after late resp : 0
[3] id=3       -> ok  echo:cmd_0
[3] id=4       -> ok  echo:cmd_1
[3] id=5       -> ok  echo:cmd_2
[3] id=6       -> ok  echo:cmd_3
[4] abandoned   -> pending=0  swept=1
transport sent 7 requests in total
连续跑五次,输出完全一致。
逐条对着约束看:
- 场景一 (约束 4、6):响应正常到达,
takeOut摘到表项,锁外set_value,call返回ok和真正的 payload。 - 场景二 (约束 5、6):超时后
call主动cancel,transport->cancel(id)被调用(true),共享状态被投递了一个CancelledError------不是靠析构关闭的 。随后那个迟到响应到达时,表里已经查不到该 id,被计入lateResponseCount(),pendingCount()保持 0。响应没有去污染任何别的请求。 - 场景三 (约束 1):四个请求 id 分别是 3、4、5、6,响应并发地打到这四个 id 上,每条都拿回了自己的结果(
echo:cmd_0到echo:cmd_3,一一对应)。如果 id 是复用的,这里就完全可能出现"cmd_1收到echo:cmd_0"。 - 场景四 (约束 3、8):调用方拿到 future 之后直接扔了,既没
wait_for也没cancel。这本来是一条必然泄漏的路径;因为表项带了 deadline,后台扫描线程在 100ms 后把它清掉了(swept=1、pending=0)。
transport sent 7 requests in total 这个数字是这样凑出来的:
text
场景一(一次 call)        1
场景二(一次 call)        1
场景三(四次并发 call)    4
场景四(一次 callAsync)   1
                        ----
                           7
注意 call() 只是在 callAsync() 外面套了一层等待和清理,它不会重复发送 ------所以四次 call 就是四次 send,不多不少。
顺带说一个只有真的跑一遍才会暴露的坑
这段场景三,第一版不是这么写的。第一版是这样:
cpp
for (const auto& item : items) {
    const auto r = client.call(item.first, item.second);   // 串行
    std::cout << ... << "\n";
}
看起来没问题------四条 call,四个 responder,id 各不相同。但实际跑出来是这样:
text
[3] id=3       -> ok  echo:cmd_0
[3] id=4       -> timeout
[3] id=5       -> transport_error
[3] id=6       -> timeout
transport sent 7 requests in total
四条里三条失败。 原因不在 RPC 客户端,而在这个测试的时序:四个 responder 都在 20ms 后投递响应,而四条 call 是串行 的------每条 call 会阻塞到自己的结果到达才返回。于是只有第一条(id=3)能在 20ms 之前完成登记;等它返回时,id=4、5、6 的响应早就投递过了,那时它们还没登记,只能被当成"迟到响应"丢掉;随后这三条才陆续登记、发送、然后超时。
这个 bug 揭示的东西比它本身更重要:"请求表 + 超时清理"这套机制正确性的前提是"登记必须发生在响应到达之前"。 所有依赖它的代码都得满足这个前提------包括测试代码。串行写法人为制造出了"响应先于登记"的时序,测的就不再是"并发不乱",而是"登记太晚"。
所以场景三改成了四条 call 开四个线程真并发。这也顺带验证了待办表本身在多线程并发登记/摘除下是安全的------因为那些操作都在锁内。
9.4 怎么用这个客户端
在实际业务代码里,调用侧就该长这样------所有超时、取消、清理都被 call() 收进去了,业务代码只需要处理四种状态:
cpp
const uint64_t id = rpc::RpcClient::nextRequestId();
const auto r = client.call(id, request);

switch (r.status) {
case rpc::RpcClient::Status::ok:
    parseResponse(r.payload);
    break;

case rpc::RpcClient::Status::timeout:
    // 已经取消并清理过了,这里只需要决定业务上怎么补救(重试 / 上报 / 降级)
    LOGGING_ERROR("axis_init timeout, id=%llu", (unsigned long long)id);
    break;

case rpc::RpcClient::Status::cancelled:
    // 被别的逻辑取消掉了(比如上层收到了急停信号)
    break;

case rpc::RpcClient::Status::transport_error:
    LOGGING_ERROR("axis_init failed: %s", r.detail.c_str());
    break;
}
注意这里没有一处 wait_for,也没有一处 try/catch。 这是好的 API 该有的样子:把"future 的三个状态分支 + 异常分层 + 表清理"这些必须做对的事情,收进一个所有调用者都会自动做对的地方。第 10 章那个真实场景里,业务代码自己写 wait_for 和 try/catch,问题就出在这里。
如果你的调用方确实需要"先发出去、过一会儿再来取",那就用 callAsync(),但这时清理责任转移到了调用方:
cpp
auto future = client.callAsync(id, req, std::chrono::seconds(3));

// ... 先干点别的 ...

if (future.wait_for(std::chrono::seconds(3)) != std::future_status::ready) {
    client.cancel(id, "no longer interested");   // 别忘了这一句
    return;
}
忘了 cancel() 也不会泄漏(sweeper 会兜住),但代价是那个请求会一直占到 deadline 才被清掉。所以 callAsync() 应该被视为"高级接口",只在确实需要的时候用。
10. 回到真实场景:axis_init 那段调用代码
前面九章都在讲机制。这一章回到一个具体场景------用 RPC 触发机械臂某个轴的初始化(axis_init),然后等结果。这类代码在工业软件里到处都是,也经常写成下面这样。
10.1 先看原始写法
cpp
auto future = rpc_client->call(message, message_id);

if (!future.valid()) {
    LOGGING_ERROR("future is invalid.");
    return -1;
}

const auto status = future.wait_for(std::chrono::minutes(10));

if (status == std::future_status::timeout) {
    LOGGING_ERROR("future is timeout.");
    // 如果 RPC 客户端支持,建议取消并清理 message_id
    // rpc_client->cancel(message_id);
    return -2;
}

if (status != std::future_status::ready) {
    LOGGING_ERROR("future is not ready.");
    return -3;
}

std::string receiveMessage;

try {
    receiveMessage = future.get();
}
catch (const std::future_error& e) {
    LOGGING_ERROR("future error: %s", e.what());
    return -4;
}
catch (const std::exception& e) {
    LOGGING_ERROR("RPC exception: %s", e.what());
    return -5;
}

rapidjson::Document doc;
if (doc.Parse(receiveMessage.c_str()).HasParseError()) {
    LOGGING_ERROR("receive message cannot parse: %s", receiveMessage.c_str());
    return -6;
}先说做对的地方,因为这两点是很多人会写错的:
valid()检查在最前面:这样wait_for不会因为空 future 抛no_state(3.3 节)。catch (const std::future_error&)写在catch (const std::exception&)前面 。这个顺序是必须的------std::future_error派生自std::logic_error,而logic_error派生自exception。如果两个 catch 写反了,future_error会被当成普通std::exception吃掉,失去按类型分支的能力。原代码的顺序是对的。
所以这段代码不是"新手代码",它写得挺细致。问题在于它把该由 RPC 客户端负责的事情搬到了每个调用点上。
10.2 五个具体问题
问题一:错误码把"可重试"和"不可重试"混在了一起。
返回 -1 到 -6,看起来分得很细,但调用方拿到之后其实做不了决定:
| 返回码 | 实际含义 | 该不该重试 |
|---|---|---|
-1 |
future 无效 | 不该(代码 bug) |
-2 |
服务端 10 分钟没回 | 可以,但要先确认设备状态 |
-3 |
状态不是 ready(理论上到不了) | 不该(代码 bug) |
-4 |
future_error:写端消失等 |
视具体错误码而定 |
-5 |
对端返回了业务异常 | 不该(对端已经明确拒绝) |
-6 |
响应 JSON 解析失败 | 不该(数据/协议问题) |
只有 -2 是"可以重试"的,其余五个都是"重试也没用"。而调用方从 -1、-3、-4、-5、-6 这一串数字上根本看不出来区别------它们本质上是同一类东西:这次调用没拿到有效结果,而且重试无意义。
问题二:wait_for(std::chrono::minutes(10)) 是一个没有依据、代价又极大的数字。
先说代价。wait_for 阻塞的是调用它的这个线程:
- 如果这是主线程 → 一次设备异常会让 UI 卡住 10 分钟;
- 如果这是工作线程 → 这个 worker 在 10 分钟内不能干任何别的事;
- 如果这是"急停请求"的线程 → 用户按下急停之后,系统要等 10 分钟才会告诉你这次通信失败了。
再说依据。"10 分钟"是从哪来的?如果是从"这个动作最长可能要 10 分钟"倒推的,那说明你想要的其实是"异步发起 + 轮询进度",而不是"阻塞 10 分钟等一个结果" 。一个轴从静止到回零,中间可能要经历使能、找限位、回零、校验好几个阶段------正确的设计应该是每个阶段一次 RPC、每次超时几秒,而不是一次调用等完整流程。
问题三:超时路径没有清理,并且注释里"建议取消"被注释掉了。
cpp
if (status == std::future_status::timeout) {
    LOGGING_ERROR("future is timeout.");
    // rpc_client->cancel(message_id);      <-- 注释掉了
    return -2;
}
按 8.1 节的因果链,这个 return -2 之后:pending_ 表里那条记录还挂着,请求 id 还可能被复用,服务端迟到的响应回来之后会找到一个"还在等"的表项------然后被投递进去 。如果此时同一个 message_id 已经被借给了下一轮重试的请求,那么下一轮拿到的可能是上一轮的结果。
问题四:解析失败时把整个报文打进日志。
cpp
LOGGING_ERROR("receive message cannot parse: %s", receiveMessage.c_str());这一行有两个隐患:报文可能有几 KB(日志被冲垮),以及报文里可能带设备序列号、坐标之类的信息。排查用途只需要前 128 个字节 + 长度:
cpp
const auto preview = receiveMessage.substr(0, std::min<size_t>(128, receiveMessage.size()));
LOGGING_ERROR("parse failed, len=%zu head=%s", receiveMessage.size(), preview.c_str());
问题五:把 try/catch 的层级分得太粗,丢掉了故障信息。
-4 和 -5 两个分支里只打了 e.what(),但正如 2.3 节说的,std::future_error 是带错误码 的,what() 文本在不同标准库上还不一样。至少应该把 e.code().value() 一起打出来:
cpp
catch (const std::future_error& e) {
    LOGGING_ERROR("future error: %s (code=%d)", e.what(), e.code().value());
    return -4;
}
10.3 改成什么样
用第 9 章的 RpcClient,调用点会变成这样:
cpp
const uint64_t id = rpc::RpcClient::nextRequestId();

// 单次 RPC 的超时应该由"这一步预期耗时"决定,而不是由"整个轴初始化流程"决定
const auto r = rpc_client->call(message, id, std::chrono::seconds(3));

if (r.status != rpc::RpcClient::Status::ok) {
    LOGGING_ERROR("axis_init rpc failed: status=%d detail=%s id=%llu",
                  static_cast<int>(r.status), r.detail.c_str(),
                  static_cast<unsigned long long>(id));
    return -1;                    // 一次失败,一个错误码,理由在 detail 里
}

rapidjson::Document doc;
if (doc.Parse(r.payload.c_str()).HasParseError()) {
    const auto preview = r.payload.substr(0, std::min<size_t>(128, r.payload.size()));
    LOGGING_ERROR("axis_init response parse failed, len=%zu head=%s",
                  r.payload.size(), preview.c_str());
    return -2;
}
变化只有三处,但都是实质性的:
- 六个错误码收敛成两个 ("RPC 没成功"和"响应不合法")。原来那六个分支里,
-1/-3/-4/-5本来就是同一件事------Response.detail里带了人可读的原因,日志里有,程序不需要为它们各分一个码。 - 超时值从 10 分钟变成 3 秒,而且这个 3 秒是"单次 RPC"的预算,不是"整个流程"的预算。流程预算放到上层管。
- 超时、取消、表清理全部由
call()内部完成 ,调用点不再有wait_for、不再有try/catch、不再需要记得调cancel()。
10.4 超时值应该怎么定
这是我在实际项目里被问得最多的问题:"这个超时到底设多少合适?" 一个可用的方法是分层设,各层职责不同:
| 层 | 关心什么 | 参考值 | 超过之后做什么 |
|---|---|---|---|
| 协议层心跳 | 链路还活着吗 | 1s / 3 次未响应判链路断 | 断开重连,所有在途请求投递 transport_error |
| 单次 RPC | 这一步该多久做完 | 该操作 P99 耗时 × 2~3 | 超时 + 取消,交给上层决定重试 |
| 业务流程 | 整个初始化要多久 | 各步骤超时之和 + 余量 | 判定流程失败,回安全状态 |
| 看门狗 | 系统是不是卡死了 | 最外层,比流程超时更长 | 记录现场、进入安全状态 |
关键点是:这些层不要合并成一层。 原代码里那个 10 分钟,本质上是用"单次 RPC 超时"去承担"整个流程预算"的职责,结果就是每一层的信息都丢了------你不知道是这一步慢,还是前面几步把时间花光了。
另外,超时值不要硬编码在调用点。它应该来自配置或者设备描述文件,因为不同型号的设备 P99 差很多,而且调试期和量产期的合理值也不一样。硬编码的后果是:现场为了绕过一个偶发超时,把源码改了重新编译。
11. 常见错误现场清单
这一章按"症状 → 原因 → 修复"整理,可以直接拿来做 code review 的检查表。
11.1 对同一个 promise 调用两次 get_future()
症状 :运行期抛 std::future_error,what() 是 Future already retrieved,code().value() 是 1。
cpp
std::promise<int> promise;
auto f1 = promise.get_future();
auto f2 = promise.get_future(); // 抛异常原因:一个写端只能发出一个读端句柄(1.3 节)。
修复 :想给多个消费者,发出 shared_future 并拷贝分发:
cpp
std::promise<int> promise;
std::shared_future<int> sf = promise.get_future().share();
auto forA = sf;
auto forB = sf;
11.2 对同一个 promise 设置两次结果
症状 :抛 future_error,Promise already satisfied,code().value() 是 2。
原因:就绪不可逆(1.3 节)。
典型现场 :超时逻辑里 set_exception(timeout),然后响应线程又 set_value(response)。
修复 :先摘表项、判断归属,再设置结果 ------只有从表里成功摘到表项的那个执行流才有权设置结果。第 9 章的 takeOut() 就是干这个的:
cpp
auto promise = takeOut(id);
if (!promise) {
    return;                          // 已经有人处理过了,我没资格
}
promise->set_value(response);
即便这样,也建议保留一个 catch (const std::future_error&) 兜底,因为"扫描线程和响应线程同时命中"在极端时序下仍可能发生(第 9 章的代码就是这么处理的)。
11.3 写端析构前没设结果,等待方拿到 Broken promise
症状 :等待方 get() 抛异常,文本是 Broken promise,code().value() 是 4。
原因 :promise 析构时若状态未就绪,标准要求它填入 broken_promise(1.2 节)。
典型现场:
- 函数里建
promise却return future(2.7 节); - 条件分支里漏掉了
set_value; - 线程因为异常提前退出了;
- 「承诺者」对象被提前销毁(比如
RpcClient析构时还有挂起请求)。
修复 :按 2.7 节的 PromiseGuard 模式做兜底;或者像第 9 章那样,在持有者析构时主动 把所有未完成的请求投递成有意义的异常。后者更好,因为等待方拿到的是 rpc client is shutting down,而不是一句无上下文的 Broken promise。
11.4 std::async 的返回值没接住
症状 :一个"异步"调用让当前线程卡了几百毫秒到几秒;编译器给 [[nodiscard]] 警告。
cpp
std::async(std::launch::async, doWork); // 分号处就阻塞原因 :5.2 节。launch::async 的 future 在析构时要等任务完成。
修复:接住它并消费结果;确实要"即发即忘"就换线程池。
11.5 以为 std::async(f) 一定是异步的
症状:代码不并发,实际是同步执行的;或者超时逻辑莫名其妙失效。
原因 :默认 policy 是 async | deferred,实现可以选 deferred(5.1、5.4 节)。
修复 :显式写 std::launch::async。
11.6 用 if (status == timeout) ... else ... 二段式判断
症状:本该超时的调用变成了同步阻塞执行。
原因 :deferred 落进了 else 分支,随即在 get() 里同步跑完了整个任务(8.6 节)。
修复 :三段式判断,deferred 必须显式处理。
11.7 从不 get() 的 future,异常被静默丢弃
症状:后台任务抛了异常,日志里什么都没有,程序也不崩。
原因 :异常存在共享状态里,没人 get() 就没人取出它(5.6 节)。
修复 :任务内部自己 try/catch 记日志;或者保证每个 future 都被消费。
11.8 持锁调用 set_value() / 持锁调用用户回调
症状:目前可能不报错,但在高负载下表现为吞吐下降;加了回调之后变成真死锁。
原因与真相 :见 8.2 节------纯粹的 std::promise 场景下这不是死锁,但临界区膨胀、优先级反转、以及"未来加回调就变死锁"是真实代价。
修复:统一用"锁内摘表、锁外设置"的模式。
11.9 在 std::promise / std::future 里传引用或裸指针
症状 :偶发读到已释放的内存,或者 get() 出来是垃圾。
原因 :shared state 只保存你传进去的那个值。传 T& 意味着传了一个引用,不会延长对象的生命周期(2.5 节)。
cpp
void worker(std::promise<const std::vector<int>&>& p, std::vector<int>& out)
{
    p.set_value(out);        // 存的是引用
    // 如果 out 之后被销毁,等待方 get() 就是悬垂引用
}
修复 :传值、传 shared_ptr<T>,或者传 std::reference_wrapper<T> 并在文档里明确约定生命周期。千万不能靠"应该没事"。
11.10 请求 id 复用导致响应错配
症状:偶尔拿到"上一条指令的结果";两个请求的结果互换了。
原因:超时的请求被清理后 id 被复用,原请求的迟到响应投递给了新请求(8.4 节)。
修复:单调递增 id,永不复用;做不到时必须在表里显式检测"绕回来了"并拒绝。
11.11 请求表泄漏
症状 :内存缓慢增长,pending_ 表越来越大;重启后恢复正常,跑几天又涨回来。
原因 :调用方放弃等待(上层 return、抛异常、取消路径)但从没调 cancel()(8.5 节)。
修复 :表项带 deadline + 后台扫描兜底;同时把 pendingCount() 暴露成监控指标,让它能被看见。
11.12 后台线程比对象活得久(use-after-free)
症状:偶发 crash,栈里往往能看到回调函数;release 下概率更高。
原因 :detach() 出去的线程捕获了 this,对象析构后线程还在跑。
修复 :线程必须被 join 管住(要么析构时 join,要么用线程池并在析构时关闭);或者在对象析构时先摘掉回调再释放资源(第 9 章析构函数的第 3 步就是这个)。
11.13 忘记 .share() 或 std::move()
症状 :编译错误(这是好事),或者运行期 no_state。
原因 :future 是 move-only;shared_future 必须显式 share() 得到(4.1 节)。
修复:
cpp
std::shared_future<int> sf = promise.get_future().share(); // 推荐:一行链式11.14 只判 timeout,不判 ready
症状 :future.get() 抛 no_state 或阻塞在意料之外的地方。
原因 :wait_for 返回非 timeout 不等于是 ready。
修复:
cpp
const auto status = future.wait_for(timeout);

if (status == std::future_status::timeout) {
    return handleTimeout();
}
if (status != std::future_status::ready) {
    return handleUnexpected();     // deferred 或未知情况
}
return handleReady(future.get());
12. 性能与实现细节:什么时候不该用 future / promise
前面十一章都在讲"怎么用对"。这一章回答"值不值得用"------因为 future/promise 不是零成本的,它在某些场景下是错的选择。
先说清楚下面的数字是怎么来的 :在一个 1 核、负载较高的容器(GCC 13.3,-O2,-std=c++17)里测的。绝对数值在不同机器上会差好几倍 ,重点看的是量级和相对关系,不是具体数字。测法在第 12.5 节,建议在自己的目标平台上跑一遍。
12.1 对象本身多大
text
sizeof(std::future<int>)          = 16
sizeof(std::promise<int>)         = 24
sizeof(std::shared_future<int>)   = 16
sizeof(std::packaged_task<int()>) = 16这些数字本身无关紧要------关键的信息是它们都只存指针 (16/24 字节 ≈ 2~3 个指针)。真正的数据(结果、就绪标志、同步原语、引用计数)都在堆上的共享状态里,每创建一个 promise/packaged_task/async 就是一次堆分配。
这一点在设计高频路径时很重要:如果你在音频处理里为每一帧创建一个 promise,那就是每帧一次堆分配 + 一次释放,而一帧的预算可能只有几毫秒。
12.2 一次 promise/future 传递花在哪
分成两种情况测,结论完全不同。
情况一:同线程创建 + 设置 + 取得(无上下文切换)
text
A) promise 同线程 create/set/get : 158 ns/iter这 158ns 覆盖了:一次共享状态堆分配 + 一次 get_future() + 一次 set_value() + 一次 get()。这就是这套机制的"净成本"------一次分配加几个原子操作。这个量级在绝大多数业务代码里完全可以忽略。
(顺便,2.6 节讲的 set_value_at_thread_exit() 不在这个快路径上:它需要等 TLS 析构,所以不适合放进这种紧循环。)
情况二:跨线程往返(含两次唤醒)
这是更有意思的一组对比。同样规模、同样两个线程,分别用 promise/future 和裸 condition_variable 做一次往返,连测五轮:
text
promise/future round-trip     condition_variable round-trip
--------------------------    ----------------------------
24708 ns                      24719 ns
24859 ns                      21752 ns
24369 ns                      25629 ns
25010 ns                      26577 ns
25097 ns                      24641 ns
两组数字的差异完全淹没在轮间波动里。
这是整篇笔记里我最想让人记住的一组数据,因为它打破了一个常见的印象:"future/promise 是标准库的重抽象,性能肯定比我自己写条件变量差"。实测结果不是这样------开销的绝对主导者是线程唤醒本身(一次 futex 系统调用 + 一次上下文切换),而不是 future 这层封装。封装带来的那部分(158ns 的分配 + 原子操作)在 25µs 的唤醒成本面前可以忽略。
所以结论是:在"一次跨线程传递"这个场景下,你为了"性能"手写裸条件变量,几乎不会得到任何好处,却会丢掉异常传播、wait_for 超时、shared_future 这些现成能力。 用 future/promise 是正确的选择。
(25µs 这个绝对值偏大,是这台 1 核容器的上下文切换成本;在一个空闲的 8 核机器上通常是 1~5µs。但"封装成本可忽略"和"唤醒成本占主导"这两个结论在任何机器上都成立。)
12.3 std::async 的成本:为什么线程池不是过度设计
text
D) std::async(launch::async) create+run+join : 48828 ~ 55977 ns/call (约 49~56 µs)把这一行和情况一的 158ns 放在一起看:
text
同线程 promise 传递     :      158 ns
std::async 一次调用     :  ~50000 ns      ≈ 300 倍以上
这 50µs 里绝大部分是线程的创建和销毁 ,不是任务本身。也就是说:如果你用 std::async 执行一个 1µs 的任务,你要花大约 50µs 来"调度"它------其中 98% 是纯开销。
这就是线程池存在的全部理由------把"创建线程"的成本从"每个任务一次"摊薄成"每个 worker 一次"。第 6 章那个 30 行的线程池,在"任务数量多、单个任务轻"的场景下,相对 std::async 是一个数量级的差距。
反过来说:如果一个任务本身就跑几百毫秒(比如一次网络往返、一次计算),那 56µs 的线程创建成本就无关紧要 ,这时 std::async 的简洁性更值得。判断标准是"任务耗时 / 调度开销"这个比值。
12.4 什么时候不该用 future/promise
三个明确的"别用"信号:
信号一:高频数据流。 音频帧、传感器采样、每帧的视频数据------这类场景每秒成百上千次传递,每次都配一个共享状态就把分配器压死了。应该用环形缓冲 + 条件变量/信号量(一个缓冲反复用,零分配),或者干脆用无锁队列。
判断标准很简单:如果传递的频率超过每秒几千次,先想清楚是否真的需要一个"一次性的结果对象"。
信号二:你其实只需要一个"完成信号"。 如果你不需要返回值,只需要"等某件事做完",那么 future<void> 是可以用的,但更轻、语义更准的选择是:
cpp
std::once_flag flag;                     // 一次性初始化
std::call_once(flag, [] { init(); });

std::latch done(3);                      // C++20:等 N 件事情完成
// worker: done.count_down();
// main:   done.wait();

std::barrier syncPoint(4);               // C++20:多阶段同步
std::latch 就干这一件事,没有堆分配、没有引用计数、没有异常语义要考虑。future<void> 在这些场景下是杀鸡用牛刀。
信号三:极短的任务 + 极低的延迟要求。 如果任务本身只要几百纳秒,那么 158ns 的共享状态开销就已经是可观的比例了;如果还要跨线程,25µs 的唤醒成本相对几百纳秒的活更是完全不成比例。这种情况下应该考虑批量处理 (攒一批一起提交)或者同步执行。
12.5 自己测一遍
上面的代码可以直接拿走,改一下迭代次数就能在目标平台上跑:
cpp
#include <chrono>
#include <condition_variable>
#include <future>
#include <iostream>
#include <mutex>
#include <thread>
#include <vector>

using namespace std::chrono;

int main()
{
    const int M = 3000;

    // 对比一:promise/future 往返(共享状态预分配,只测同步成本)
    {
        std::vector<std::promise<void>> toPeer(M), toMain(M);
        std::vector<std::future<void>> toPeerF(M), toMainF(M);
        for (int i = 0; i < M; ++i) {
            toPeerF[i] = toPeer[i].get_future();
            toMainF[i] = toMain[i].get_future();
        }

        std::thread peer([&] {
            for (int i = 0; i < M; ++i) {
                toPeerF[i].wait();
                toMain[i].set_value();
            }
        });

        const auto t0 = steady_clock::now();
        for (int i = 0; i < M; ++i) {
            toPeer[i].set_value();
            toMainF[i].wait();
        }
        const auto ns = duration_cast<nanoseconds>(steady_clock::now() - t0).count() / M;
        peer.join();
        std::cout << "promise/future round-trip  : " << ns << " ns\n";
    }

    // 对比二:condition_variable 往返(同规模)
    {
        std::mutex m;
        std::condition_variable cv;
        bool turn = false;

        std::thread peer([&] {
            for (int i = 0; i < M; ++i) {
                std::unique_lock<std::mutex> lk(m);
                cv.wait(lk, [&] { return turn; });
                turn = false;
                cv.notify_one();
            }
        });

        const auto t0 = steady_clock::now();
        for (int i = 0; i < M; ++i) {
            std::unique_lock<std::mutex> lk(m);
            turn = true;
            cv.notify_one();
            cv.wait(lk, [&] { return !turn; });
        }
        const auto ns = duration_cast<nanoseconds>(steady_clock::now() - t0).count() / M;
        peer.join();
        std::cout << "condition_variable round-trip: " << ns << " ns\n";
    }
}
测的时候注意三件事,否则数字会骗人:
-O2编译 ,并且把结果用一个volatile变量接住,否则整个循环可能被优化掉;- 多跑几轮取中位数,第一轮往往包含预热效果(缓存、分支预测、线程首次调度);
- 别在虚拟机/容器繁忙时测 ,也不要在一台正在跑 CI 的机器上测。本节的 25µs 就是"繁忙的单核容器"这个条件下的产物,它真实地反映了"唤醒成本占绝对主导"这个相对关系,但别拿它当自己平台上的依据。
13. C++20 之后:该用什么替代
标准库的 future/promise 是 2011 年的设计,十几年过去,它的短板在生态里已经被反复识别了。如果你在新项目上做技术选型,这一章的表格比 API 手册更有用。
13.1 std::jthread + std::stop_token:真正能中断的取消
回到 8.2 节的"取消四层",标准库在 C++20 之前完全没有第四层 ------没有任何标准手段能让一个正在跑的线程停下来。std::jthread 加 std::stop_token 补上了这个洞。
cpp
#include <chrono>
#include <iostream>
#include <stop_token>
#include <thread>

int main()
{
    // jthread 析构时会自动 request_stop() + join(),不用再写 join
    std::jthread worker([](std::stop_token st) {
        int ticks = 0;
        while (!st.stop_requested()) {                  // 协作式检查
            std::this_thread::sleep_for(std::chrono::milliseconds(20));
            ++ticks;
        }
        std::cout << "worker stopped after " << ticks << " ticks\n";
    });

    std::this_thread::sleep_for(std::chrono::milliseconds(70));
    worker.request_stop();                              // 请求停止
    std::cout << "stop requested\n";
}
实测输出:
text
stop requested
worker stopped after 4 ticks这是协作式取消 :stop_token 只是提供一个"有人请你停"的信号,具体停在哪里由任务自己决定(通常是循环的开头,或者阻塞点之前)。这个"由被打断者决定"的性质很重要------它意味着取消是可控的、能保证资源正确释放的,而不是像 pthread_cancel 那样在任意点撕裂执行流。
还可以注册一个"收到停止请求时立即执行"的回调,用来打断阻塞中的 accept()/poll():
cpp
// 用来打断阻塞中的 accept()/poll()
void interruptibleWait()
{
    std::stop_source source;

    std::stop_callback callback(source.get_token(), [] {
        // 实测:request_stop() 时这里会立刻被调用
        // 在这里 shutdown() 一个 socket,让阻塞中的 poll() 返回
        std::cout << "stop_callback fired\n";
    });

    source.request_stop();
}实测输出:stop_callback fired。
要注意的是,stop_token 和 std::future 是两套互不感知的机制。 想让它俩配合,你需要自己在任务里把 stop_requested() 的结果映射成一个异常或返回码投递出去。这也是第 9 章那个 cancel() 做的事情的手工版本:
cpp
struct CancelledError : std::runtime_error
{
    using std::runtime_error::runtime_error;
};

// 任务体:把 stop_token 的停止请求,桥接成 future 侧的取消异常
void interruptibleBody(std::stop_token st, std::shared_ptr<std::promise<int>> promise)
{
    for (int i = 0; i < 100; ++i) {
        if (st.stop_requested()) {
            try {
                promise->set_exception(std::make_exception_ptr(CancelledError("stopped")));
            }
            catch (const std::future_error&) {
                // 已经被别的路径设置过,忽略
            }
            return;
        }
        std::this_thread::sleep_for(std::chrono::milliseconds(10));
    }

    try {
        promise->set_value(computeResult());
    }
    catch (const std::future_error&) {
    }
}

// 启动侧
auto promise = std::make_shared<std::promise<int>>();
auto future = promise->get_future();

// std::jthread 会把 stop_token 自动作为第一个参数传进去
std::jthread worker(interruptibleBody, promise);
实测输出:
text
cancelled: stoppedinterruptibleBody 用 try/catch 包住 set_exception/set_value 是有意的:如上文反复强调的,取消路径和完成路径可能同时到达 (request_stop() 和任务自然跑完),第二次设置结果会抛 future_error,这里把它吃掉。
13.2 更轻的同步原语
如果你只是要"等一个条件"而不是"取一个结果",这几个 C++20 类型比 future 更合适(12.4 节列过原因):
| 需求 | 用什么 | 特点 |
|---|---|---|
| 一次性初始化 | std::call_once / std::once_flag |
C++11 起,零堆分配 |
| 等 N 个任务全部完成 | std::latch |
C++20,计数器只减不加,一次性 |
| 多阶段同步(每阶段等所有人) | std::barrier |
C++20,可重复使用 |
| 限制并发数 / 资源池 | std::counting_semaphore |
C++20,可配最大计数 |
| 等一个原子变量变成期望值 | std::atomic<T>::wait/notify_* |
C++20,无锁场景下最轻 |
| 异步任务的结果(可能失败) | std::future |
唯一带异常语义的 |
判断方法 :问自己"需不需要传递一个可能失败的结果"。需要 → future;只是同步 → 用上面这些。
13.3 协程:真正解决"不能组合"的问题
回到 7.4 节那个 std::future 最被诟病的地方------没有 .then(),没法把多个异步操作串起来或并行组合。C++20 的协程(coroutine)正是为此准备的。
先看一个能跑的最小骨架:一个可以承载结果的协程类型,加上一个让 co_await std::future<T> 可用的 awaiter。
cpp
#include <chrono>
#include <coroutine>
#include <future>
#include <iostream>
#include <optional>
#include <stdexcept>
#include <thread>

template <typename T>
class Task
{
public:
    struct promise_type
    {
        std::optional<T> value;

        Task get_return_object()
        {
            return Task{std::coroutine_handle<promise_type>::from_promise(*this)};
        }
        std::suspend_always initial_suspend() noexcept { return {}; }
        // 必须是 suspend_always:否则协程帧在 final_suspend 处就被销毁,
        // 外面再读 value 就是访问已释放内存
        std::suspend_always final_suspend() noexcept { return {}; }
        void return_value(T v) { value = std::move(v); }
        void unhandled_exception() { std::terminate(); }
    };

    explicit Task(std::coroutine_handle<promise_type> h) : handle_(h) {}
    Task(Task&& o) noexcept : handle_(o.handle_) { o.handle_ = {}; }
    ~Task() { if (handle_) handle_.destroy(); }
    Task(const Task&) = delete;
    Task& operator=(const Task&) = delete;

    void start() { handle_.resume(); }

    T take()
    {
        while (!handle_.done()) {
            std::this_thread::sleep_for(std::chrono::milliseconds(1));
        }
        return std::move(*handle_.promise().value);
    }

private:
    std::coroutine_handle<promise_type> handle_;
};

// ---- co_await std::future<T>:真正异步恢复的 awaiter ----
template <typename T>
struct FutureAwaiter
{
    std::shared_ptr<std::optional<T>> slot = std::make_shared<std::optional<T>>();
    std::shared_ptr<std::exception_ptr> error = std::make_shared<std::exception_ptr>();
    std::future<T> future;

    bool await_ready()
    {
        if (future.wait_for(std::chrono::seconds(0)) == std::future_status::ready) {
            try { slot->emplace(future.get()); }
            catch (...) { *error = std::current_exception(); }
            return true;
        }
        return false;
    }

    // 关键:把 future 移到等待线程,就绪后 resume 协程。
    // 协程所在的线程不被阻塞 ------ 这才是协程相对"阻塞式 future"的真正价值。
    void await_suspend(std::coroutine_handle<> handle)
    {
        auto fut = std::move(future);
        auto s = slot;
        auto e = error;
        std::thread([handle, fut = std::move(fut), s, e]() mutable {
            try { s->emplace(fut.get()); }
            catch (...) { *e = std::current_exception(); }
            handle.resume();
        }).detach();
    }

    T await_resume()
    {
        if (*error) {
            std::rethrow_exception(*error);
        }
        return std::move(**slot);
    }
};

template <typename T>
FutureAwaiter<T> awaitFuture(std::future<T> f)
{
    return FutureAwaiter<T>{std::make_shared<std::optional<T>>(),
                            std::make_shared<std::exception_ptr>(),
                            std::move(f)};
}

Task<int> compute()
{
    std::promise<int> p;
    auto f = p.get_future();

    std::thread worker([&p] {
        std::this_thread::sleep_for(std::chrono::milliseconds(30));
        p.set_value(21);
    });
    worker.detach();

    std::cout << "[coroutine] before co_await on thread " << std::this_thread::get_id() << "\n";
    const int base = co_await awaitFuture(std::move(f));
    std::cout << "[coroutine] after co_await base=" << base
              << " on thread " << std::this_thread::get_id() << "\n";
    co_return base * 2;
}

int main()
{
    std::cout << "[main] calling compute()\n";
    Task<int> task = compute();
    task.start();                     // 启动,立刻返回(协程在 co_await 处挂起)
    std::cout << "[main] start() returned, main thread " << std::this_thread::get_id() << "\n";
    std::cout << "[main] result = " << task.take() << "\n";
}
实测输出:
text
[main] calling compute()
[coroutine] before co_await on thread 128114901722944
[main] start() returned, main thread 128114901722944
[main] result = [coroutine] after co_await base=21 on thread 128114885650112
42
注意最后两行的线程 ID :before co_await 所在线程是 ...22944,after co_await 变成了 ...50112。这说明协程挂起后,是在等待线程上被恢复的,它原本所在的线程已经回去干别的了 。这段代码的写法是"顺序的"(一个 co_await 接着下一个),但执行是非阻塞的:
cpp
// 顺序写法,非阻塞执行(下面这段同样实测通过,输出 combine() = 30)
inline std::future<int> readSensorAsync(int id)
{
    return std::async(std::launch::async, [id] {
        std::this_thread::sleep_for(std::chrono::milliseconds(20));
        return id * 10;
    });
}

static Task<int> combine()
{
    auto f1 = readSensorAsync(1);
    auto f2 = readSensorAsync(2);

    const int a = co_await awaitFuture(std::move(f1));
    const int b = co_await awaitFuture(std::move(f2));
    co_return a + b;                  // 10 + 20 = 30
}
两个传感器读取被写成了一前一后,看起来像串行------但 co_await 处协程会让出线程,所以这两个 20ms 的等待是重叠的,总耗时约 20ms 而不是 40ms。
这就是它比 future.get() 强的地方:future.get() 会把这个线程钉在原地,而 co_await 会让出线程。 如果这个线程是事件循环线程或者线程池里稀缺的 worker,差别就是"能服务 N 个并发任务"和"只能服务 1 个"。
不过写这段代码的过程里有三个真实的坑,值得记下来:
final_suspend必须返回suspend_always。 我第一版写成了suspend_never,结果从promise里读到的值永远是0------因为协程帧在final_suspend处已经被自动销毁了,之后读value是在读已释放内存。这个 bug 不崩溃、不报错,只是安静地给你一个错值。await_suspend返回void不等于"立即继续"。 返回void的语义是"协程在这里挂起,控制权交还给 resume 的调用方"。我第一版就是这么写的,结果协程停在co_await处再也没动过,await_resume()根本没被调用。要挂起后自动恢复,得自己在别处handle.resume()(或者返回false表示"别挂起")。- 协程帧的生死要自己管。 上面那段代码把
handle捕获进了等待线程:如果Task在协程挂起期间被销毁(~Task里destroy()了帧),那个线程随后的handle.resume()就是操作已销毁的帧------和 11.12 节的 use-after-free 是同一类问题,只是换了个场景。生产级的协程库会用引用计数或执行器(executor)来管这件事。
这三个坑也解释了为什么"用协程做异步"至今在 C++ 里没那么轻松:语言机制给了你,但配套的运行时(事件循环、执行器、生命周期管理)得自己搭或者靠库。 实践中常见的做法是直接用成熟库:cppcoro、folly::coro、async_simple 等,它们把这些边界都处理好了。
13.4 std::execution(P2300):标准答案正在路上
协程解决了"怎么写",但没解决"在哪儿跑、怎么组合、怎么限流"。P2300(std::execution,sender/receiver 模型)就是冲这个来的,已经进入 C++26。
它带来的能力大致是:
cpp
// 示意性写法(基于 std::execution 的 API 形态)
auto work = std::execution::when_all(
                readSensorAsync(sensorA),
                readSensorAsync(sensorB))
          | std::execution::then([](auto a, auto b) { return merge(a, b); })
          | std::execution::upon_error([](std::exception_ptr e) { return fallback(); });

// 提交到某个调度器(线程池 / GPU / 事件循环)
auto [result] = std::this_thread::sync_wait(std::move(work)).value();
对比一下现在要做同样的事得写多少代码(7.4 节):when_all 和 then 在标准 future 里根本不存在 ,你只能手写线程 + 队列。这就是 P2300 相对 future 的实质进步。
但从工程角度,我对它的建议是分场景的:
- 如果你的编译器链已经支持
std::execution,且团队能接受它陡峭的学习曲线 → 值得在新项目上评估; - 如果不行 → 不要为了"现代化"硬上 。第 9 章那个 RPC 客户端用 C++11 的
promise/future就能写得很干净,而且它的行为完全可控、可测试、可调试。
13.5 现在到底该用什么
按场景给一个可以直接对照的表:
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 一个请求/任务的结果,可能失败 | std::promise + std::future |
异常语义 + 超时能力,生态成熟 |
| 一个结果给多个消费者 | std::shared_future |
唯一的标准答案 |
| 有返回值的一批任务 + 限流 | packaged_task + 线程池 |
12.3 节:摊薄线程创建成本 |
| 少数几次、要结果、可以等 | std::async(launch::async, f) |
最省事,记得接住返回值 |
| 需要真正能中断的本地任务 | std::jthread + stop_token |
C++20,唯一的标准协作式取消 |
| 只等完成,不要结果 | std::latch / std::call_once |
比 future<void> 轻且语义准确 |
| 高频数据流 | 环形缓冲 + 条件变量/信号量 | 零分配,避免共享状态开销 |
| 复杂组合(when_all / then / 重试 / 限流) | 协程或 std::execution(或直接上库) |
标准 future 组合能力为零 |
| 跨进程/跨机器的异步 | 消息队列 + 回调 + 请求表 | 就是第 9 章的模型,promise 是核心零件 |
14. 速查表与结论
14.1 核心模型:一张图记住全部关系
text
                    共享状态 (堆上分配,引用计数管理)
          +------------------------------------------------+
  写端    |  结果槽: 值 / exception_ptr / 空               |   读端
  ------> |  就绪标志: 一旦置位不可逆                       | <------
          |  同步: 互斥量 + 条件变量(实现相关)            |
          +------------------------------------------------+

  谁来写:                         谁来读:
  - promise.set_value/set_exception    - future.get()      (一次,取走失效)
  - packaged_task 调用时自动           - shared_future.get()(多次,线程安全)
  - async 自动                         - wait / wait_for / wait_until(不取走)
14.2 阻塞行为速查
| 操作 | 会不会阻塞 | 会不会消耗结果 |
|---|---|---|
promise.get_future() |
不会 | --- |
promise.set_value() / set_exception() |
不会(只唤醒对方) | --- |
future.valid() |
不会 | 否 |
future.get() |
会(到就绪) | 会 |
future.wait() |
会(到就绪) | 否 |
future.wait_for(d) |
最多 d | 否 |
future.wait_until(tp) |
最多到 tp | 否 |
future.share() |
不会 | 会(转移所有权) |
future.~future() |
async 产生的会(等任务完成);其他不会 |
--- |
promise.~promise() |
不会(未设置就填入 broken_promise) |
--- |
shared_future.get() |
会(到就绪) | 否(可反复取) |
14.3 错误码速查
std::future_errc |
触发条件 | 典型修复 |
|---|---|---|
future_already_retrieved |
重复调 get_future() |
改成 share() 分发 |
promise_already_satisfied |
重复设置结果 | 先摘表项判归属,再设置 |
no_state |
对象无共享状态(默认构造/已移走/已 get()) |
先 valid() 检查 |
broken_promise |
写端未设结果就析构 | PromiseGuard 或主动关闭状态 |
14.4 机制结论:12 条
这 12 条来自第 1
8 章,回答"这套机制是怎么工作的"。下一节的 10 条来自第 813 章,回答"工程上该怎么做"。
future/promise是同一个共享状态的两个把手:写端定终局一次,读端取结果一次。所有"只能一次"的限制都能从这里推出来。get_future()不阻塞 ,get()/wait()/wait_for()/wait_until()才可能阻塞。get()有三种出口 :返回结果、抛出写端存进去的业务异常、抛future_error。工程上应该分开处理,因为前两者是业务问题,后者是用法问题。promise未设结果就析构,等待方会拿到broken_promise。 这是标准库在帮你把"永久阻塞"变成"可捕获的异常"。std::async默认 policy 不是launch::async,而是允许实现选deferred。生产代码请显式指定。std::async返回的临时 future,析构会阻塞到任务结束。 漏接返回值 = 同步执行;不要用它做"即发即忘",也不要用它当线程池。- 没人
get()的 future,异常会被静默丢弃。 程序不崩,问题也不会被发现。 wait_for返回超时只等于"我不等了",不会取消任何东西。超时后必须自己回答"谁清理表项、迟到响应怎么办、id 能不能复用"。- 超时路径上要显式"关闭"共享状态(投递异常),而不是靠析构。前者可诊断,后者只能靠猜。
- 请求 id 永不复用,这是防"响应错配"最有效的一条规则。
- 锁内摘表、锁外设置结果。 纯粹
std::promise场景下这不会死锁,但一旦加了回调就会,而且临界区膨胀本身就是代价。 - 用
future/promise换性能是亏的(12.2 节:跨线程传递成本和裸条件变量几乎持平)。该不该用,看的是它带来的异常语义、超时能力、组合便利性,而不是"省不省一次唤醒"。
14.5 工程结论:10 条
这 10 条来自第 8~13 章。它们跟
std::future的语法无关,但决定了一套系统在跑了半年之后还稳不稳。
- 超时必须分层,不能合并成一层。 协议心跳(链路是否活着)、单次 RPC(这一步该多久)、业务流程(整个初始化要多久)、看门狗(系统是否卡死)------四层职责不同。原代码那个 10 分钟的
wait_for就是用"单次超时"去承担"流程预算"的职责,结果每一层的信息都丢了(10.4 节)。 - 超时值要从数据来,不是拍脑袋。 用该操作 P99 耗时 × 2~3,并且不要硬编码在调用点------不同设备型号差很多,调试期和量产期的合理值也不同(10.4 节)。
- 错误码按"调用方能不能据此做决定"分类,而不是按"哪里出错了"分类。 原来六个码里有五个是"重试无意义",那就该是一个码 + 一句人可读的
detail(10.2 节)。 - 超时之后必须回答三个问题:谁清理表项、迟到响应怎么处理、请求 id 能不能复用。答不上来,这段代码就一定会出偶发故障(8.4、8.5 节)。
- 超时路径要显式关闭共享状态(投递一个异常),不要靠析构关闭。 前者给等待方一句有意义的
timed out after 120 ms,后者只给一句Broken promise(8.4、11.3 节)。 - 让"忘记清理"在结构上不可能发生,而不是靠 review 保证。 表项带 deadline + 后台扫描兜底,并且把
pendingCount/lateResponseCount/sweptCount暴露成监控指标------泄漏要能被看见(8.5、9.1 节)。 - 任务内部的异常要自己落日志,别指望有人
get()。 没人消费的 future 会把异常安静地吃掉,程序不崩、日志也没有(5.6、11.7 节)。 - 别用
future/promise传高频数据。 每秒上千次传递的场景(音频帧、传感器采样)应该用环形缓冲 + 条件变量,做到零分配(12.4 节)。 - 选型依据是异常语义、超时能力、组合能力,不是性能。 12.2 节的实测结论:跨线程传递时
promise/future和裸condition_variable的差异在噪声范围内,为了"性能"手写裸条件变量是白付出。 - 新代码先看 C++20 有没有更合适的工具 :要真取消用
std::jthread+stop_token,只要完成信号用std::latch/call_once,复杂组合考虑协程或std::execution(13.5 节的选型表)。
14.6 重构清单:手上有一段这样的代码,按什么顺序改
如果你在维护一段已经在跑的 future 代码,建议按这个顺序推进------从"能发现问题的"开始,因为看不见的问题最难修。
第一步:让问题可见
- 把
pendingCount()/lateResponseCount()/sweptCount()之类的计数暴露成监控指标,先跑一周看看真实数字。 - 给所有会出现 pending 状态的地方加日志,记录"登记时刻 / 完成时刻 / 结果类型(值/异常/超时)"。
第二步:排查三个高危写法
bash
# 1) async 的返回值有没有被接住(漏接 = 同步执行)
grep -rn "std::async" --include=*.cpp

# 2) 有没有裸 wait_for ------ 它不取消任何东西
grep -rn "wait_for\|wait_until" --include=*.cpp

# 3) 有没有 detach 出去的线程捕获了 this(use-after-free 的经典来源)
grep -rn "detach()" --include=*.cpp
逐条确认:每个 std::async 的返回值都被消费了吗?每个 wait_for 超时之后都有清理路径吗?每个 detach 都有明确的生命周期保证吗?
第三步:收拢职责
- 把散落在调用点的
wait_for+try/catch+ 错误码映射,收进一个统一的调用封装(第 9 章的call()就是这个东西)。 - 把错误码按"调用方能做什么"重新分类。
- 把硬编码的超时值搬到配置里,并按 14.5 第 1 条分层。
第四步:堵住泄漏
- 每个表项加 deadline。
- 加一个后台扫描线程兜底(第 9 章的
sweeperLoop)。 - 检查四条关闭路径是否都有明确执行流:正常完成 / 超时 / 主动取消 / 持有者析构。
第五步:把行为钉住
- 按 9.2 节的四个场景写测试:正常路径、超时 + 迟到响应、并发多请求、放弃等待。并发场景一定要真的开线程------9.3 节末尾那个坑说明,串行写法会人为制造出错误的时序,测不到你想测的东西。
14.7 结论的验证环境与可移植性
本文的行为断言都在下面这个环境里实测过,代码全部编译运行通过:
text
编译器 : g++ (Ubuntu 13.3.0-6ubuntu2~24.04) 13.3.0
标准库 : libstdc++
平台   : x86-64 Linux(单核容器,负载较高)
编译 : -std=c++17 / -std=c++20,-O0(行为验证)/ -O2(性能测试)但并非所有结论都同等可靠,用之前值得区分一下:
| 断言 | 性质 | 说明 |
|---|---|---|
get() 只能调用一次,取走即失效 |
标准保证 | 跨编译器一致 |
一个 promise 只能设置一次结果 |
标准保证 | 跨编译器一致 |
写端未设结果就析构 → broken_promise |
标准保证 | 跨编译器一致 |
wait_for 超时不会取消任务 |
标准保证 | 标准里根本没有"取消"这个 API |
launch::async 的 future 析构会阻塞 |
标准要求 | 本平台实测符合 |
std::async 默认 policy 允许 deferred |
标准保证 | 实现可以选择 |
未 get() 的 future 会丢掉异常 |
标准保证 | 异常存在共享状态里,没人取就没人处理 |
e.what() 的文本 |
实现相关 | libstdc++ 是 std::future_error: ...,别用它做判断 |
e.code().value() 是 1/2/3/4 |
实现相关 | 本平台实测值,别硬编码 |
e.code().category().name() 是 "future" |
实现相关 | 同上 |
| 线程 ID 被复用 | 实现/系统相关 | 与线程池和调度策略有关 |
| 12 章的所有性能数字 | 环境相关 | 1 核繁忙容器,绝对值参考价值有限 |
所以判断错误类型时,请这样写(实测三种写法在本平台都成立,但只有前两种是可移植的):
cpp
catch (const std::future_error& e) {
    // 推荐:直接和枚举比(简洁、可移植)
    if (e.code() == std::future_errc::broken_promise) {
        // 写端没设结果就消失了
    }

    // 等价写法:显式构造 error_condition
    if (e.code() == std::make_error_condition(std::future_errc::no_state)) {
        // 无共享状态
    }

    // 不要依赖数字:e.code().value() == 4 在不同标准库上未必成立
}
两个错误码实测结果(供对照,别照抄):
text
future_already_retrieved : value=1  category=future  what="std::future_error: Future already retrieved"
promise_already_satisfied: value=2  category=future  what="std::future_error: Promise already satisfied"
no_state                 : value=3  category=future  what="std::future_error: No associated state"
broken_promise : value=4 category=future what="std::future_error: Broken promise"另外注意一个容易忽略的点:取过一次的 future 再 get(),抛出的是 no_state(值 3),不是 broken_promise ------因为结果被取走后,这个 future 已经没有共享状态了。这两件事都表现为 future_error,但原因完全不同。
最后,性能数字请在自己的目标平台上复验:12.5 节的脚本可以直接拿走,改一下迭代次数和线程数即可。
14.8 最后
回过头看,这份笔记从"一段能用但不够好的 axis_init 调用代码"出发,走过了四个层次:
- 机制 (1~4 章):
future/promise是同一个共享状态的两个把手,写端一次、读端一次。所有"只能一次"的规则都是从这一句话推出来的。 - 陷阱 (5~7 章):
std::async的默认策略、析构阻塞、异常静默丢弃,以及三种生产者各自适合什么场景。 - 工程 (8~10 章):超时、取消、迟到响应、请求表------真正让这套机制在生产环境里活下来的部分。第 9 章那个 RPC 客户端是这一层的完整答案。
- 演进(11~13 章):错误清单、性能边界,以及 C++20/26 提供的替代方案。
那段的 axis_init 代码,问题不在于某一行写错了,而在于它把 RPC 客户端的内部责任(请求登记、超时清理、迟到响应、取消)泄露到了每一个调用点上 。六个错误码、一个 10 分钟的 wait_for、一句被注释掉的 cancel,共同构成了后面所有偶发故障的土壤。
所以最终的落点不是"记住这些 API",而是两条设计原则:
- 把必须做对的事情收进一个所有调用者都会自动做对的地方。 第 9 章的
RpcClient::call()就是这个"地方"------业务代码里不再出现wait_for,不再出现try/catch,也不再需要记得调cancel。 - 让"忘记清理"这类错误在结构上不可能发生,而不是靠 code review 保证。 表项带 deadline + 后台扫描兜底,就是这个思路的体现:即使有人忘了,系统也不会泄漏。
如果只能带走一句话,那就是:
std::future本身很简单,难的是围绕它的那套"谁登记、谁清理、谁负责关闭"的纪律。把这份纪律收进一个封装里,比记住任何一个 API 都重要。
这两条原则跟 std::future 没有关系,但它们是让 std::future 在一个长期维护的系统里真正好用的前提。