开篇:手搓一个 Agent 的三个死穴
2026 年 7 月,我这套东西还叫"手搓态"。
手搓态的死穴很具体:ReAct 循环、function-call 协议、工具派发,全部自己写。 结果就是三个问题同时出现:
- 加能力要改内核。 想让 Agent 会看屏幕,就往循环里塞视觉逻辑;想让它会点鼠标,再塞一段。每加一个能力,内核就被污染一次。
- 换模型要改代码。 工具列表、调用格式、prompt 全都和模型绑死。
- 知识是一次性的。 这次跑通了,下次从零开始------同一个坑可以踩十遍。
后来我把它整体重写成"框架态"。这篇记录下来的是三件事:
- 通用内核到底强在哪------四种复利,这是整篇最想讲清楚的部分;
- 架构全景------两层循环、一条旁路;
- 14 个设计决策 + 5 个被推翻的决策------每条都写代价。
不写代价的决策记录,等于没写。
第一部分 · 通用内核的四种复利
先说结论:「通用」不是为了显得高级,是因为它会让四件事产生复利。 每一次加能力、换模型、跑任务,都在给下一次省钱。
复利 1 · 插件化:能力 == 插件(红线)
这是整个内核最核心的一条约束:
加能力 = 加一个外层插件,绝不改内核。
具体到实现,能力来自外层插件层,而且是两类插件完全平级:
| 插件类型 | 承载什么 | 接入方式 |
|---|---|---|
| 自研 tool | 基础能力:屏幕观测 / 鼠标键盘 / 视觉 / 文件 IO | 用框架原生 function_tool 包装 |
| 外部 MCP | 外部系统:开源服务、第三方工具 | 纯配置接入,框架原生加载 |
自研 tool 和开源 MCP 是平级的,都由 LLM 直接调用。 内核不认识它们中的任何一个,只认识"有一批工具可用"这件事。
这跟 MCP 的设计哲学是同一个:build once as MCP server, any host 可用------一次写好,任何宿主都能用。反过来看内核,就是"core 不认识 X"。
复利在哪 :能力数量线性增长,内核复杂度零增长。加第 100 个能力和加第 1 个能力的成本一样,都是写一个插件。手搓态下这是指数增长的------第 100 个能力要在已经缠满分支的循环里找位置。
复利 2 · 模型无关:内核认识「能力声明」,不认识模型
手搓态下换模型是灾难:工具列表要跟着模型改,prompt 要跟着模型改。
框架态的做法是把模型能力抽成元数据,动态注入提示词。系统提示是一个动态模板,运行时按两件事自动填充:
{capabilities_block}   ← 模型原生能力:text_only / text_vision
{tool_catalog_block} ← 当前可用工具:自动读 schema,提取描述首句生成清单于是换一个模型、加一个工具,提示词代码一行都不用改 。text_only 的模型被告知"图像和屏幕观测需要依赖工具",text_vision 的模型被告知"可以直接解析图像,也支持工具二次核验"------同一条纪律,两种说法,自动适配。
说实话,这比主流的"静态写死一份工具列表"要严谨一些。而且这套抽象还顺手解决了一个更大的问题:换执行模型(本地 GGUF ↔ 云端 API)也是零代码改动,只改配置。
复利 3 · 知识进化:自升级 Meta-loop(护城河)
这一条是整套设计里唯一称得上"护城河"的部分。
设计上有个关键判断:skill 和训练数据集源自同一批轨迹。 也就是同一条执行轨迹,能同时长出两样东西------
ini
执行轨迹 ──┬─→ 蒸馏成 rollout(facts / lessons / 用户修正)→ 合并进全局记忆
           └─→ 提炼成 skill 候选 → 连续成功 N=3 → 晋升为可信技能
为什么要有 N=3 这道门 :不设门槛的话,一次偶然成功就会被固化成"技能",之后每次都往上下文里注入噪声。所以要求跨任务连续成功 3 次------注意是跨任务,同一个任务里重复成功不算,那等于自己给自己发奖状。中途失败,计数归零。
为什么 Curator 是"非决策者" :负责维护的后台进程只做四件事------清理过期轨迹、精炼世界模型、复核技能候选、标记低质量样本。它不介入任务执行,只在任务完成后跑一次(触发式,不挂周期性定时器)。
这里的诚实边界必须写清楚:
自学习只长「知识 / 策略」,不长「硬件 / 工具精度」。
多跑几轮不会让某个工具适配得更准。而且当前自动生成 skill 仍不可靠------弱模型产出的 skill 会把错误放大。"人审核接入"是正确保守姿态,不是妥协。
复利 4 · 长任务连续性:把「工作上下文」和「会话连续性」分开
这一条是被任务时长逼出来的。
常见 Agent 的假设是"一次会话 = 一个任务",跑完就 /clear 开下一个。但挂机跑几小时甚至跨天的任务里,这个假设不成立,会撞上三堵墙:
- 不能靠
/clear续命------目标全丢; - 反复压缩会磨掉初心(JPEG 效应)------一代代压下去,最早那段"我们为什么要做这个"最先没;
- lost-in-the-middle 更严重------t=0 的全局目标必须活到 t=3h。
解法是把两个概念拆开:
| 概念 | 性质 | 落在哪 |
|---|---|---|
| 工作上下文 | 有界、可压 | LLM 窗口,token 占比 0.65 触发压缩 |
| 会话连续性 | 外部、持久 | 世界模型落盘 + 子目标检查点,不进窗口 |
核心手段是"让大部分状态根本不进窗口" :无状态大脑每次调用只收「世界模型快照 + 当前子目标」,天然不累积历史。压缩的时候不只产窗口内摘要,更要把关键进展写回持久世界模型------窗口里只留指针。外部记忆才是连续性的真靠山,压缩是有损的。
配合子目标分解,把"刷 2 小时副本"拆成"清房间 1 / 清房间 2...",每个子目标给执行单元一个干净的小上下文,只有高层进度回传大脑。单上下文永远小,总任务才能无限长。
这四种复利合起来,才是"通用"
支撑它们的是三层结构:
L3  框架驱动循环       ← LangGraph + Agents SDK(循环、协议、工具路由,交给框架)
L2  护城河外挂钩子     ← WorldModel / Curator / Trajectory / Skill(生命周期钩子)
L1  外层插件(平级)   ← 自研 tool  +  外部 MCP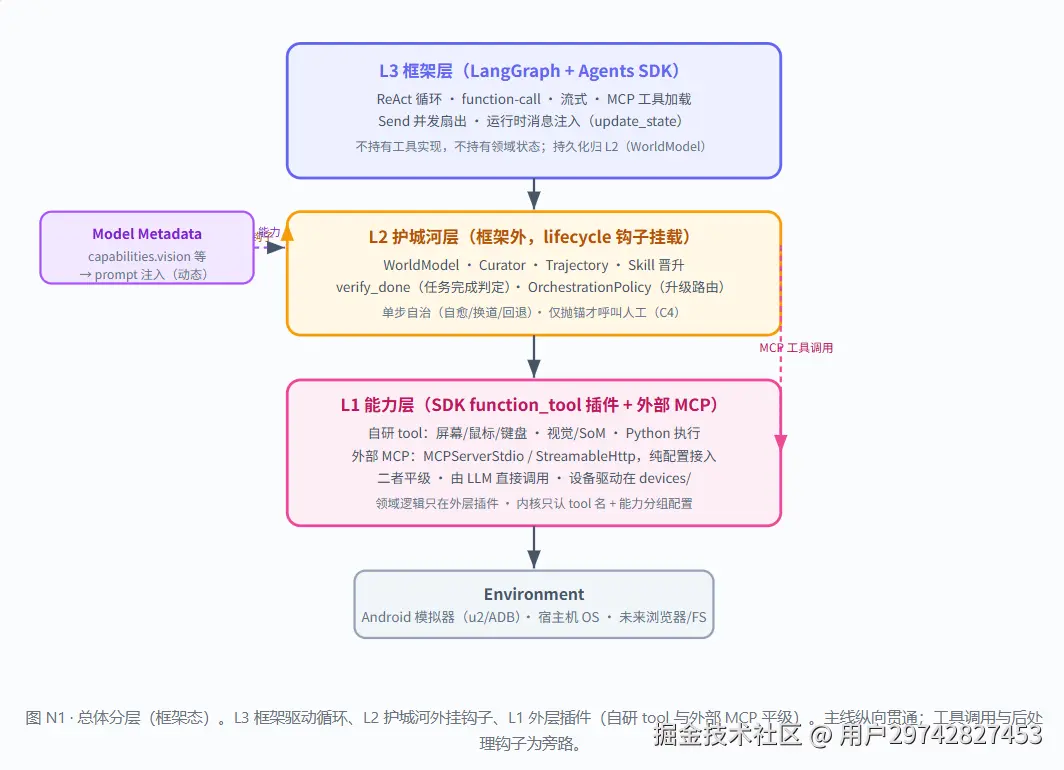
L3 用开源框架,L2 自己写,L1 完全开放。 内核退化成"配置 + 钩子注册中心"------这是框架态和手搓态最根本的区别,也是四种复利能成立的前提。
顺带说一句行业对标,这四种复利不是我凭空想的:
| 参照 | 印证了什么 |
|---|---|
| MCP(Anthropic 提出,2025-12 捐 Linux Foundation AAIF) | "能力 == 工具、core 不认识 X"的哲学同源 |
| Agent Skills(Anthropic 开放标准) | SKILL.md 文件夹、像装 App 一样加载技能 = 我们的知识库形态 |
| Hermes(NousResearch, MIT) | 自进化技能系统 + Background Curator + 三层本地 markdown 记忆,直接印证「world-model + skill 自学」范式 |
| UI-TARS(ByteDance) | 印证"反思 + 从失败轨迹学"必须内建 |
| MGA(Memory-Driven GUI Agent 论文) | 本地快 VLM 感知 + 远程强模型规划 ≈ 分层派发的论文版 |
| OSWorld 基准 | 顶级 agent 75--94% wall time 花在规划/反思的 LLM 调用 → 印证"强模型低频、本地快执行" |
第二部分 · 架构全景
两层循环,职责完全不同
scss
用户输入
   │
   ▼
POST /chat ───── 创建 / 复用 task,持久化用户消息
   │
   ▼
ToolLoop(L2 内核:编排注入 + 门控)
   │
   ▼
LangGraph 编排图
   entry → main ──(有 plan)── Send("sub") × N ──→ sub ──→ main(下一轮)
              │
              └─(done / 无 plan / round > max_rounds / 预算耗尽) → finalize → END
   │
   ▼
Agents SDK Runner 块循环(LLM 调用 + 工具派发)
   │
   ▼
执行后端(devices/:HostBackend · EmulatorBackend)
   │
   ▼
Environment| 循环 | 载体 | 管什么 |
|---|---|---|
| 外层:编排图 | LangGraph | 该不该派发、派给谁、什么时候收尾 |
| 内层:块循环 | Agents SDK Runner |
一次 run 内:推理 → 调工具 → 看结果 → 再推理 |
内层是常规 Agent 循环;外层是自己的东西------主 agent 决定派不派、派给哪个执行单元槽位,框架负责扇出和 join。
一条旁路:知识回流
ini
任务完成 → 轨迹落盘 → Curator 蒸馏 → 记忆合并(MEMORY.md)
└────→ skill 候选 → N=3 晋升 → 下次任务弱注入它不参与当前任务,只在任务结束后工作。目的只有一个:同一个坑不要踩第二次。
五层职责与代码位置
| 层 | 文件 | 职责 |
|---|---|---|
| L2 内核 | omni_core/local/tool_loop.py |
编排注入 + 门控 + 收尾 |
| 编排图 | omni_core/orchestration/graph.py |
LangGraph 拓扑、扇出、聚合 |
| 块循环 | omni_core/brain/sdk_loop.py |
SDK Runner 分块执行 |
| 提示词 | omni_core/brain/prompt.py |
动态模板组装 |
| 执行后端 | devices/ |
HostBackend(pyautogui)· EmulatorBackend(u2/ADB) |
| 前端 | web/src/store/taskStore.tsx |
状态 + SSE |
| 红线守护 | scripts/review_lint.py |
内核零场景硬编码检查 |
第三部分 · 14 个设计决策
A. 执行与感知
D1 · 设备控制:uiautomator2/ADB 优先,不是纯视觉
背景:控制 Android 设备,最直觉的方案是"截图 → 视觉模型出坐标 → 点击"。
选择:以 uiautomator2 + ADB 为主,视觉作补充。
理由两点都很硬:
- IME 无关的文本输入 。
set_fastinput_ime(True)+send_keys()绕开本机输入法状态------纯截图方案在输入框上会一直踩输入法的坑。 - 结构化 UI 层级树 。
dump_hierarchy()给出元素的 bounds / text / resource-id / class,是结构化观测数据,可直接喂世界模型和 SoM 编号;截图是像素,模型得自己猜。
代价:绑定 Android 生态,桌面端和真机得另写后端实现。
这个代价直接催生了 L1 层的目录结构------正因为设备实现不通用,执行后端才必须待在内核之外。
D2 · 感知工具三角:三件并列,无程序化优先级
背景:三种感知手段各有优劣------UI 层级树(结构准,但有些界面拿不到)、OCR(文字可靠,拿不到语义)、本地 VLM(懂语义,坐标会认错)。
常见做法是降级链:先试 A,失败降级 B,再不行 C。
选择 :三件并列成工具 observe / ocr_screenshot / vision_describe,由模型自主选择,无程序化优先级。
理由:降级链本质上是把"什么时候该用哪个"写成了程序判断------那就是场景知识,属于内核污染。而且降级链写死之后,模型看到的是"被选好的"观测结果,它没机会表达"这个层级树在骗我,我要看截图"。
代价:每次判断都要花 token 让模型思考,比固定流水线慢一点、贵一点。
D3 · 视觉通道:默认关闭,本地 VLM 转文本
背景:截图直接回传强模型,效果确实更好,但很贵。
选择 :默认 vision=False------截图先给本地 VLM 理解,只把文本摘要 回传大脑;保留 vision=True 升级通道,本地连续搞不定的界面才直传截图。
理由:成本决策。截图的 token 成本远高于文本摘要,而绝大多数步骤不需要大脑看原图。"本地看懂 → 转述"是个划算的压缩。
代价:本地 VLM 转述会丢信息。所以升级通道必须留着。
B. 编排与调度
D4 · 升级判定:大脑不做模型路由,交给可量化条件
背景:什么时候该从本地小模型升级到强模型?直觉方案是"让大脑自己判断"。
选择 :不做。升级回流完全靠量化条件触发:
verify 连续失败 3 次 / 内层循环超 8 步 / subtask 墙钟超 120s
无置信(no_confidence)硬触发 / 显式 escalate / 上下文溢出理由:让大脑判断"我该升级了",本身就是一次 LLM 调用,判断质量还不稳定。改成量化条件后,这套逻辑可测试、可复现、可调参------出问题能定位到是哪个阈值不对。
代价:阈值是刚性的。"一步都没超但明显跑偏"的情况,量化条件抓不到。所以全部阈值放 config,默认值先跑通再实测反推。
D5 · 派发可选:分层与否由配置决定
背景:多 agent 派发是核心能力,很容易做成"默认开启多层"。
选择 :派发默认开启,但单模型也能跑 (主 agent 自派发,并发与上下文隔离本身就有价值)。要分层需两步显式配置:先在 models.json 声明槽位,再在 runtime.dispatch.agents 显式列出参与派发的槽。
理由 :不让人在还不知道需不需要分层的时候先背上分层的复杂度。能力默认关、需显式开启------这条对自动化系统尤其重要。
代价:新用户得多读两段文档才能用上分层的价值。
D6 · 编排兜底:max_rounds + max_parallel 双硬边界
背景:派发机制一旦跑起来,最典型的故障是"派发 → 回收 → 再派发"的无限循环;其次是一次扇出太多子任务打满资源。
选择 :max_rounds(默认 3 轮)+ max_parallel(默认 4 个)双兜底,超长计划自动截断。
理由 :这是被真实故障教的------任何带循环的编排机制,都必须有一个跟模型无关的硬边界。不能靠"模型应该不会这么做"来保证收敛。
代价:正常长任务可能被截断,需要手动调高。宁可截断后手动放行,也不要无限循环。
C. 上下文与记忆
这一组是整份设计文档里我花时间最多的部分。
D7 · 1M 上下文 ≠ 不需要压缩
背景:窗口越来越大,很自然的推论是"那就全塞进去"。
选择 :照样压,且以 token 占比为主触发,不按轮数:
| 阈值 | 值 | 作用 |
|---|---|---|
compress_threshold |
0.65 | 用到窗口 65% 就压,抢在退化前 |
hard_ceiling |
0.85 | 到 85% 无条件压(兜底) |
max_turns |
16 | 次级兜底,多小轮也压 |
理由 :这个反直觉的结论有公开实证------Anthropic 官方把它叫 context rot ;Chroma 2025 年对 18 个前沿模型的实测显示,200K 窗口的模型从 50K token 起性能就明显退化(lost-in-the-middle)。大窗口给的是"跑大任务的余量",不是"不用压的理由"。
而且纯按轮数触发是错的:worker 吐几十 K 终端日志时,还没到第 N 轮就已经爆窗。主触发必须是 token 占比。
代价:阈值依赖大脑真实窗口。换模型后窗口变了,阈值得跟着改------这是配置维护成本。
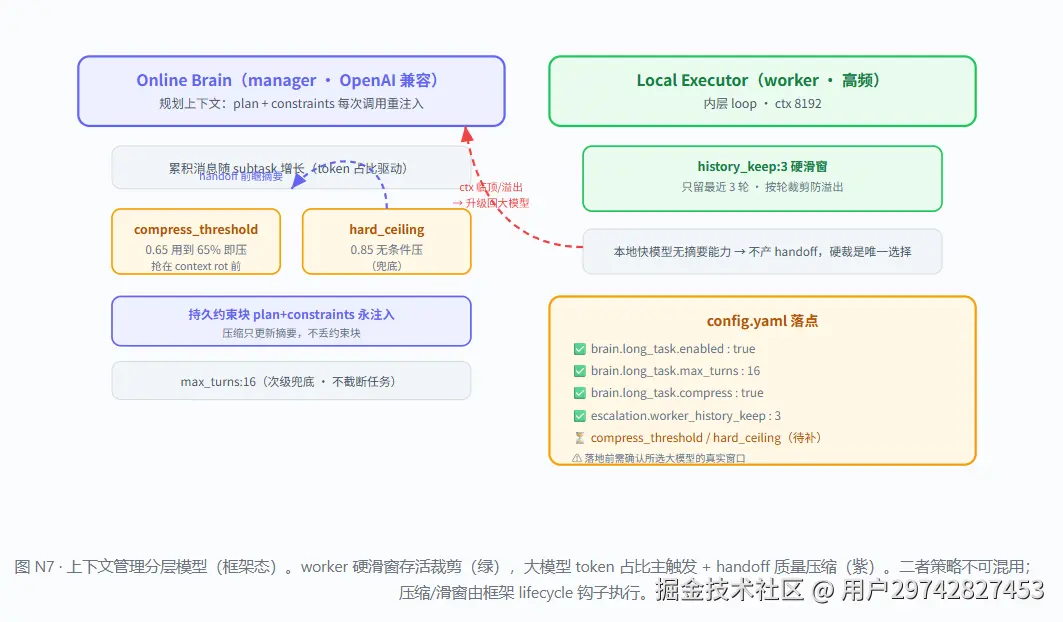
D8 · 上下文分层:worker 硬滑窗 vs 大脑质量压缩,不可混用
背景:上下文管理看起来是一个功能,其实要处理两个完全不同的场景。
选择:刻意不让它们共用机制:
| 层 | 策略 | 原因 |
|---|---|---|
| 子 agent(worker 槽) | 硬滑动窗口 history_keep: 3,不做摘要 |
本地小模型没有摘要能力,ctx 8192 也塞不下 |
| 主 agent(brain) | 质量压缩 + token 占比触发 + 硬上限兜底 | 绝不 3 轮硬截断------全局目标和约束会被切掉 |
理由 :混用是很典型的错误。给 worker 上摘要,是小模型做不了的事;给大脑上硬截断,等于每隔几轮失忆一次。worker = 存活裁剪,大脑 = 质量压缩,这是两条红线。
代价:两套机制要分别维护调参,比一套统一复杂。
D9 · 摘要形态:必须是 handoff(前瞻),不是 backward summary
背景:压缩时写摘要,最自然的写法是"回顾刚才发生了什么"。
选择 :摘要按前向交接写,必须含四块:
- 已完成进展 / 关键决策
- 约束与用户偏好
- 剩余待办
- 续做所需的关键数据
理由:Agent 要的是"接着做",不是"知道刚才干了啥"。而且用户消息原文和目标的原文不参与压缩------压缩只动中间过程。
代价:写 handoff 摘要对模型能力有要求,弱模型写出来的交接质量堪忧------又回到 D8 的结论:这活儿只能交给大脑。
D10 · 长任务连续性:无状态大脑 + 持久世界模型 + 子目标检查点
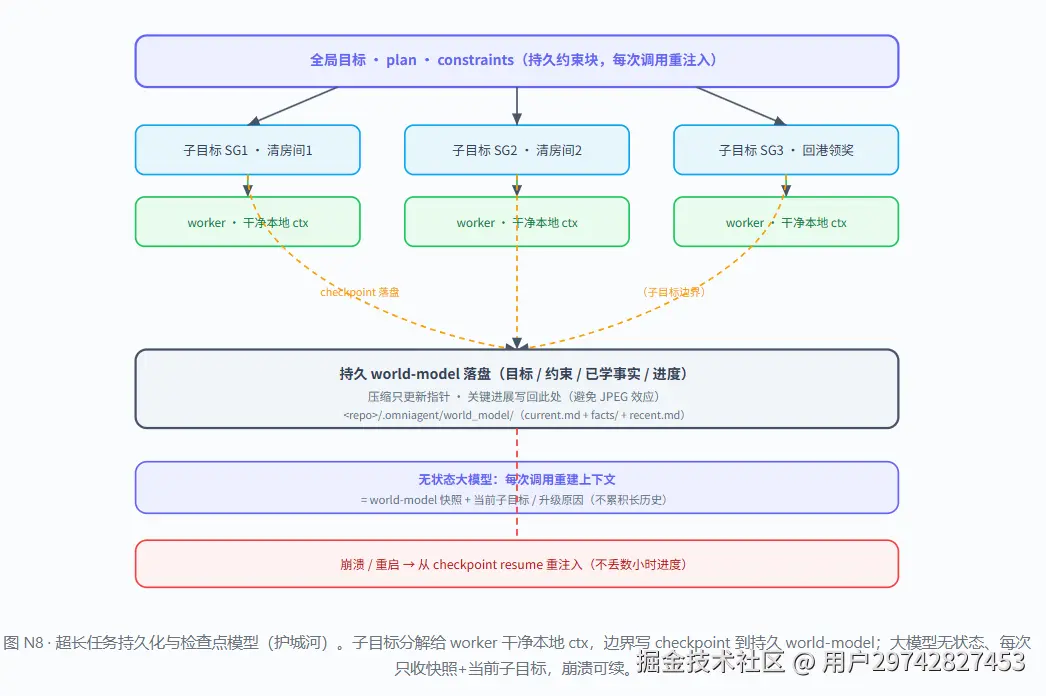
背景:任务可能连续跑几小时甚至跨天,撞上开篇说的那三堵墙(不能 /clear、JPEG 效应、lost-in-the-middle)。
选择 :把大部分状态根本不放回窗口。 三层机制:
| 机制 | 作用 | 是否进 LLM 窗口 |
|---|---|---|
| 无状态大脑(每次调用重建上下文) | 只收世界模型快照 + 当前子目标 | 极小 |
| 持久外部记忆(world-model 落盘) | 目标 / 约束 / 已学事实 / 进度,每次重注入 | 仅摘要指针 |
| 子目标检查点(checkpoint 落盘) | 崩溃重启从检查点续 | 不进 |
理由 :外部记忆才是长任务连续性的靠山。压缩时不只产窗口内摘要,更要把关键进展写回世界模型落盘,窗口里只留指针。
代价:世界模型的读写、合并、去重成了关键路径上的一环,写坏了比不写更糟------所以这块一直有 Curator 在做去重和精炼。
D11 · 记忆检索:不做 RAG,先全量注入
背景:记忆系统上了规模,标准答案似乎就是上向量检索。
选择 :不做 RAG,全量注入。 检索只在记忆超 20K token 预算、或进入多角色场景时才触发。
理由 :当前记忆量根本不大,全量注入比检索更可靠------检索会漏,漏掉的那条可能正好是约束。为了一个还不存在的问题(记忆爆炸)引入一层可能出错的机制(召回不准),不划算。
代价:记忆长的用户会撞到 20K 预算。所以扩容路径预留好了:0(单角色全局单份,当前)→ 1(per-role 隔离)→ 2(轻量检索)→ 3(真多 agent)。
D. 知识与工程
D12 · 技能晋升:N=3 门,跨任务连续成功
背景:自动提炼技能,不设门槛的话,一次偶然成功就被固化。
选择 :跨任务连续成功 3 次才晋升为可信技能,中途失败计数归零;同名技能合并累计成功次数。
理由:过滤"运气好"。而且必须是跨任务------同任务内重复成功不算。
代价:晋升慢。有些确实有用但依赖特定环境的技能,会一直卡在门槛外。
D13 · 维护进程:触发式,不挂周期性定时器
背景:后台维护(清理轨迹、精炼世界模型、复核技能候选)天然适合做成定时任务。
选择 :触发式------每次顶层任务完成后跑一次,Phase 1 不挂周期性后台定时器。
理由:定时器会带来并发写 world-model / skill 的锁复杂度。为了"及时维护"引入一整套并发控制,在单用户桌面场景里性价比很低。
代价:任务不密集时维护滞后。这可以接受------知识沉淀本来就不需要实时。
D14 · CI 策略:只跑红线 lint,不跑测试
背景 :scripts/review_lint.py 守着"内核零场景硬编码",实际检查三条:
| 规则 | 检测内容 |
|---|---|
| R1 屏幕字段泄露 | 内核文件里直接访问 ocr_text / ui_tree / active_window 等感知字段 |
| R2 具体工具名分支 | 内核文件里对具体设备工具名做 if 分支 |
| R3 抽象缺失 | devices/base.py 里 text_of / verify_done 仍有默认实现体(出现 @abstractmethod 即合规) |
选择 :CI 每次 push / PR 跑 review_lint.py --strict,但刻意不跑 pytest。
还有个刻意的分层:omni_core/**/*.py 强制 R1+R2,而 L1 能力层(omni_core/tools/**)与设备层(devices/**)豁免 R1/R2------它们本来就是具体实现,红线只该管内核。设备层额外强制 R3。
理由:测试依赖 torch / opencv / pyautogui 这些原生包,在 CI 里装齐会把反馈从秒级拖到分钟级;而红线 lint 是纯标准库、秒级返回。
把最需要高频执行的检查做得足够轻,它才会真的被执行 ------一个每次要等五分钟的检查,最后一定会被人用 --no-verify 绕过去。
代价:CI 抓不到功能回归,只能靠本地跑重型测试。
第四部分 · 我推翻过的 5 个决策
被推翻的决策比被采纳的更有信息量。
❌ 推翻 1:首条消息的闲聊 probe
曾用轻量判断识别第一条消息是"闲聊"还是"任务",闲聊走轻链路。
为什么推翻 :probe 是程序化预判,判错要么白跑重链路,要么把任务当闲聊敷衍掉。2026-09-17 整体移除,所有消息走同一条链路,由模型决定直接文本作答还是调工具。
这和 D2 是同一个思想:能交给模型判断的语义问题,不要用程序化启发式去猜。
❌ 推翻 2:LLM-as-judge 外部评审
曾用一个独立 LLM 调用做任务质量评审。
为什么推翻 :外部评审会失真------它没有真实执行上下文,评的是"看起来对不对"。改为四层原生校验:提示纪律约束、verify 工具主动校验、done_when 字面条件匹配、收尾校验。
❌ 推翻 3:orchestration/policy.py
曾用一个独立策略模块决定派发规则。
为什么推翻 :策略表会膨胀,而且它和"控制流归大脑"直接冲突。删掉后改成:子 agent 自报状态 + 主 agent 决断。
❌ 推翻 4:K4 动态纠偏采集
曾用关键字匹配自动从会话里捞用户的"纠正"话术,蒸馏成经验。
为什么推翻 :关键字识别不可靠------子串误伤是硬伤,一句普通指令里只要含"别"字就可能被当成纠正。而且任务级纠偏本就该止于当前任务,不该沉淀成全局记忆。
教训:看起来聪明的隐式自动化,不如显式声明可靠。现在画像走显式声明 + 人工确认,记忆靠 facts / lessons 两类结构化条目。
❌ 推翻 5:workspace / app 分区模型
曾按 workspace、app 两级分区存放资产。
为什么推翻 :这两个概念都没有真实语义支撑,结果路径逻辑到处是分支和兜底。改成 project(路径 slug,只装会话历史)+ task(一等实体,自带全部资产) 之后,所有 app 分区逻辑被彻底删除。
教训:如果一个概念需要写一堆兜底分支才能自洽,那不是实现问题,是这个概念本身不该存在。
写在最后
回头看这 14 个决策,它们指向同一个判断:
能交给模型的语义判断,交给模型;不能交给模型的,用可量化、可测试的机制兜住。
- 感知用什么、要不要派发、这是闲聊还是任务 → 模型判断(D2、D5,推翻 1)
- 什么时候升级、什么时候压缩、什么时候算完成 → 量化条件(D4、D7、D12)
以及一条更朴素的:
机制要诚实。 硬边界(
max_rounds)、显式开关(能力默认关)、可测量的门槛(N=3)------这些东西不聪明,但它们不会骗你。
而"通用"的价值,就体现在那四种复利上:能力变成插件,模型变成配置,知识变成资产,任务长度不再有上限。 内核只做一件事------当好"配置 + 钩子注册中心"。
项目地址:github.com/momo-null/O...
也想听听别人的答案:你在自己的 Agent 项目里,有没有一个"看起来很合理、后来被推翻"的决策?
文中设计与阈值均来自项目 master-spec、产品设计与架构设计文档;引用的公开数据(Anthropic context rot、Chroma 2025 长上下文实测、OSWorld 基准)为设计文档中的来源记录,未做效果承诺。