为什么会有 Pushgateway 这个组件
Prometheus 的核心采集模型是 pull:它按 scrape_interval 周期性地去各个 target 的 /metrics 拉数据。这个模型对长期运行的服务很合适,但对另一类任务就不太友好------那些跑几秒、几十秒就结束的进程。
比如:
- 每天凌晨跑一次的数据库备份脚本,成功与否、耗时多少,你希望有监控;
- 一个 CI 流水线里执行的数据同步任务,处理了多少条记录;
- 临时拉起的离线推理任务,跑完就退出。
这些进程在 Prometheus 下一次抓取之前就已经结束了,pull 模型根本抓不到。Pushgateway 就是为这种场景设计的:任务主动把指标 push 给 Pushgateway,Pushgateway 把这些指标缓存起来并长期暴露在 /metrics 上,Prometheus 只需要照常抓取 Pushgateway 一个 target,就能拿到所有短生命周期任务上报的数据。
这里有个关键点要先说清楚,也是很多人第一次用会误解的地方:
【关键结论】Pushgateway 不是"指标中转的时序数据库",它是一个指标的暂存与聚合点。它不会自动过期删除你推送的数据,同一条指标会一直保留到你主动删除或覆盖。这一点和 Prometheus 主库的 retention 机制完全不同,后面会专门讲怎么处理。
部署方式一:二进制直接跑
Pushgateway 是 Go 写的单文件程序,官方在 GitHub Releases 提供各平台二进制。截至我写这篇文章时,较新的稳定版本是 1.x 系列(例如 v1.9.x / v1.11.x 这类版本号,具体以你下载时 Releases 页面显示的为准,这一点我没有逐一验证每个小版本)。下载对应平台的压缩包后:
bash
# 以 linux-amd64 为例,版本号请替换成 Releases 页面上实际的最新版
wget https://github.com/prometheus/pushgateway/releases/download/v1.11.1/pushgateway-1.11.1.linux-amd64.tar.gz
tar xvf pushgateway-1.11.1.linux-amd64.tar.gz
cd pushgateway-1.11.1.linux-amd64
./pushgateway --version
默认它监听 :9091,直接启动:
bash
./pushgateway几个在真实环境里会用到的参数:
--web.listen-address=:9091:监听地址,默认就是 9091;--persistence.file=/var/lib/pushgateway/data:把指标持久化到磁盘。这个参数很重要,默认情况下 Pushgateway 的数据只在内存里,进程重启后所有 pushed 指标全丢。加上它之后,Pushgateway 会定期把状态写入文件,重启后恢复;--persistence.interval=5m:持久化写入间隔,默认 5 分钟。
生产环境建议至少加上 --persistence.file。否则一次重启,你所有定时任务的历史指标就没了,而 Pushgateway 本身又不像 Prometheus 那样有 WAL 和远程存储兜底。
想开机自启的话,用 systemd 写个 unit 就行,这部分是标准操作,不展开。
部署方式二:Docker
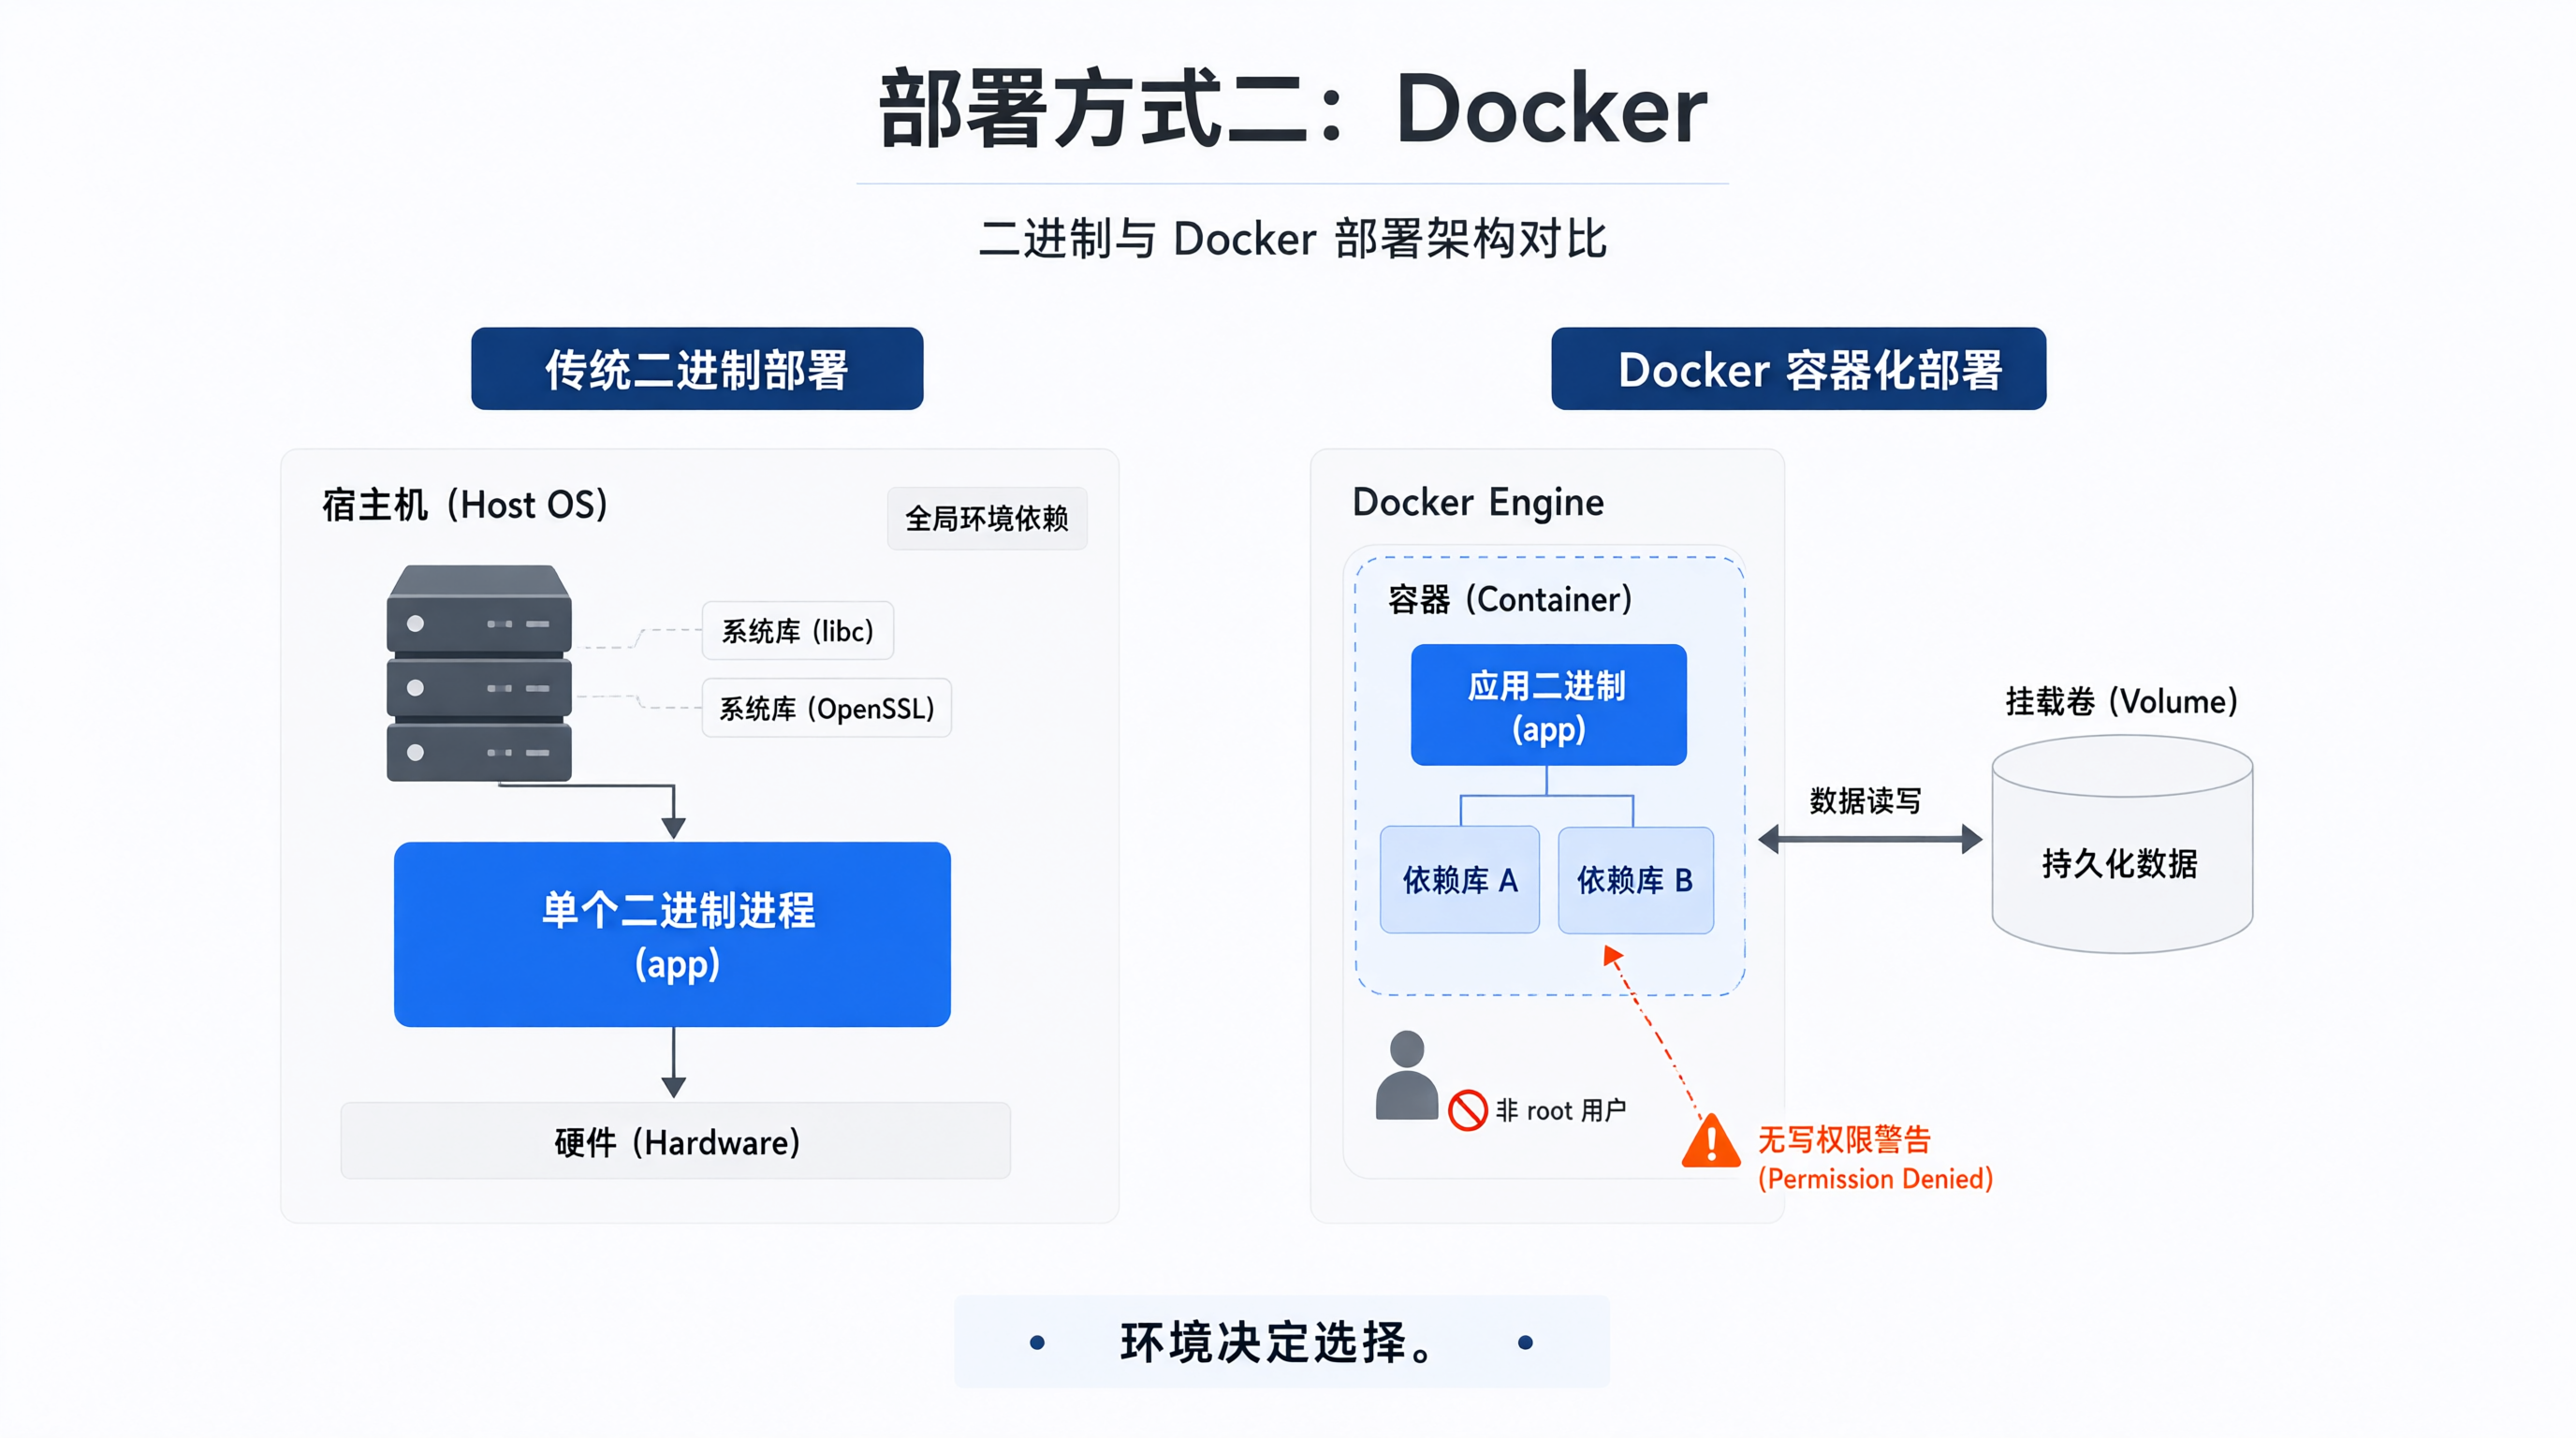
如果是容器化环境,直接用官方镜像 prom/pushgateway:
bash
docker run -d \
  --name pushgateway \
  -p 9091:9091 \
  -v /data/pushgateway:/pushgateway \
  prom/pushgateway:v1.11.1 \
  --persistence.file=/pushgateway/data
注意两点:
- 镜像 tag 不要用
latest。我见过因为latest被更新、行为有变化导致排查困难的案例,生产上固定版本 tag 更稳妥。 - 挂载卷的目录权限要对。官方镜像默认以非 root 用户运行(
nobody或类似),如果宿主机目录属主不对,持久化文件会写失败。可以先chown一下,或者先用不挂载的方式跑通再处理权限。
两种方式怎么选,我列个对比:
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 二进制 | 无依赖,启动快,资源占用低;systemd 集成简单 | 需要自己管升级、管进程 | 单机部署、已有 systemd 体系、边缘节点 |
| Docker | 环境隔离,升级换 tag 即可;和容器编排天然契合 | 多一层运行时;卷权限、网络要额外配置 | K8s / Docker Compose 环境,团队统一用容器 |
我自己的习惯是:如果整个监控栈(Prometheus、Grafana、Alertmanager)都在容器里跑,那 Pushgateway 也放容器里,用同一个 compose 文件管理最省心;如果是裸机部署的 Prometheus,那 Pushgateway 用二进制 + systemd 反而更少出问题。
验证服务是否起来
不管哪种方式,起来之后先确认:
bash
curl -s http://localhost:9091/-/healthy
# 正常会返回 Pushgateway is Healthy.
访问 http://localhost:9091/ 能看到一个简单的 Web UI,初始状态下没有任务,页面是空的。push 之后这里会列出所有 job 和对应的指标。
用 Python 推送指标
Pushgateway 的 push 接口是 HTTP 的,理论上你用 requests 手拼也行,但官方维护了 prometheus_client 这个库,封装了 push 逻辑,用起来更规范。安装:
bash
pip install prometheus_client我这边用的是 prometheus_client 0.20.x 系列,下面代码基于这个版本的 API。
最基础的推送长这样:
python
from prometheus_client import CollectorRegistry, Gauge, push_to_gateway

# 1. 用独立 registry,避免和进程内默认 registry 混在一起
registry = CollectorRegistry()

# 2. 定义指标
g = Gauge(
    'backup_duration_seconds',
    'Duration of the nightly backup job',
    registry=registry
)
g.set(42.5)

# 3. 推送
push_to_gateway(
    'localhost:9091',
    job='nightly_backup',
    registry=registry
)
几点解释:
为什么要单独建 CollectorRegistry? 默认的 registry 是全局的,如果这个进程里还跑着 HTTP server 之类的、暴露了别的指标,用默认 registry 会把不相关的一堆指标一起推上去。用独立 registry 只推你想推的,干净。
job 参数是什么? 它是 Pushgateway 里分组用的标签。同一个 job 下的指标会归到一组。后面 Prometheus 抓取时,这个 job 会体现在 job 标签上(注意:如果 Prometheus 的 scrape_config 里也定义了 job,会按规则处理,这里容易混淆,见下一节)。
推送的位置 :push_to_gateway 默认走的是 POST /metrics/job/<job> 这个路径。这个路径语义是"替换 该 job 下的所有指标"------每次 push 会覆盖掉这个 job 之前的内容。如果你希望按实例区分,用 grouping_key:
python
push_to_gateway(
    'localhost:9091',
    job='nightly_backup',
    registry=registry,
    grouping_key={'instance': 'db-primary-01'}
)
这样路径会变成 /metrics/job/nightly_backup/instance/db-primary-01,不同实例的数据互不覆盖。
push 完,去 Pushgateway 的 Web UI 或 curl http://localhost:9091/metrics 就能看到你推的指标了,格式和 Prometheus 的 exposition format 一致。
一个容易踩的语义坑
push_to_gateway(也就是默认的 POST 到 /metrics/job/...)是全量替换。这意味着:
如果你分两次推送,第一次推了指标 A,第二次只推了指标 B,那 A 会被删掉。因为 POST 的语义是"这个 job 下的指标现在就是这些"。
如果你想要"追加/只更新某一条"的语义,应该用 pushadd_to_gateway,它对应 PUT 方法,只更新你推送的指标,不动其他。这个区别很多人第一次用会踩。
python
from prometheus_client import pushadd_to_gateway

# 只更新这一条,不影响该 job 下其他已有指标
pushadd_to_gateway(
    'localhost:9091',
    job='nightly_backup',
    registry=registry
)
配置 Prometheus 抓取 Pushgateway
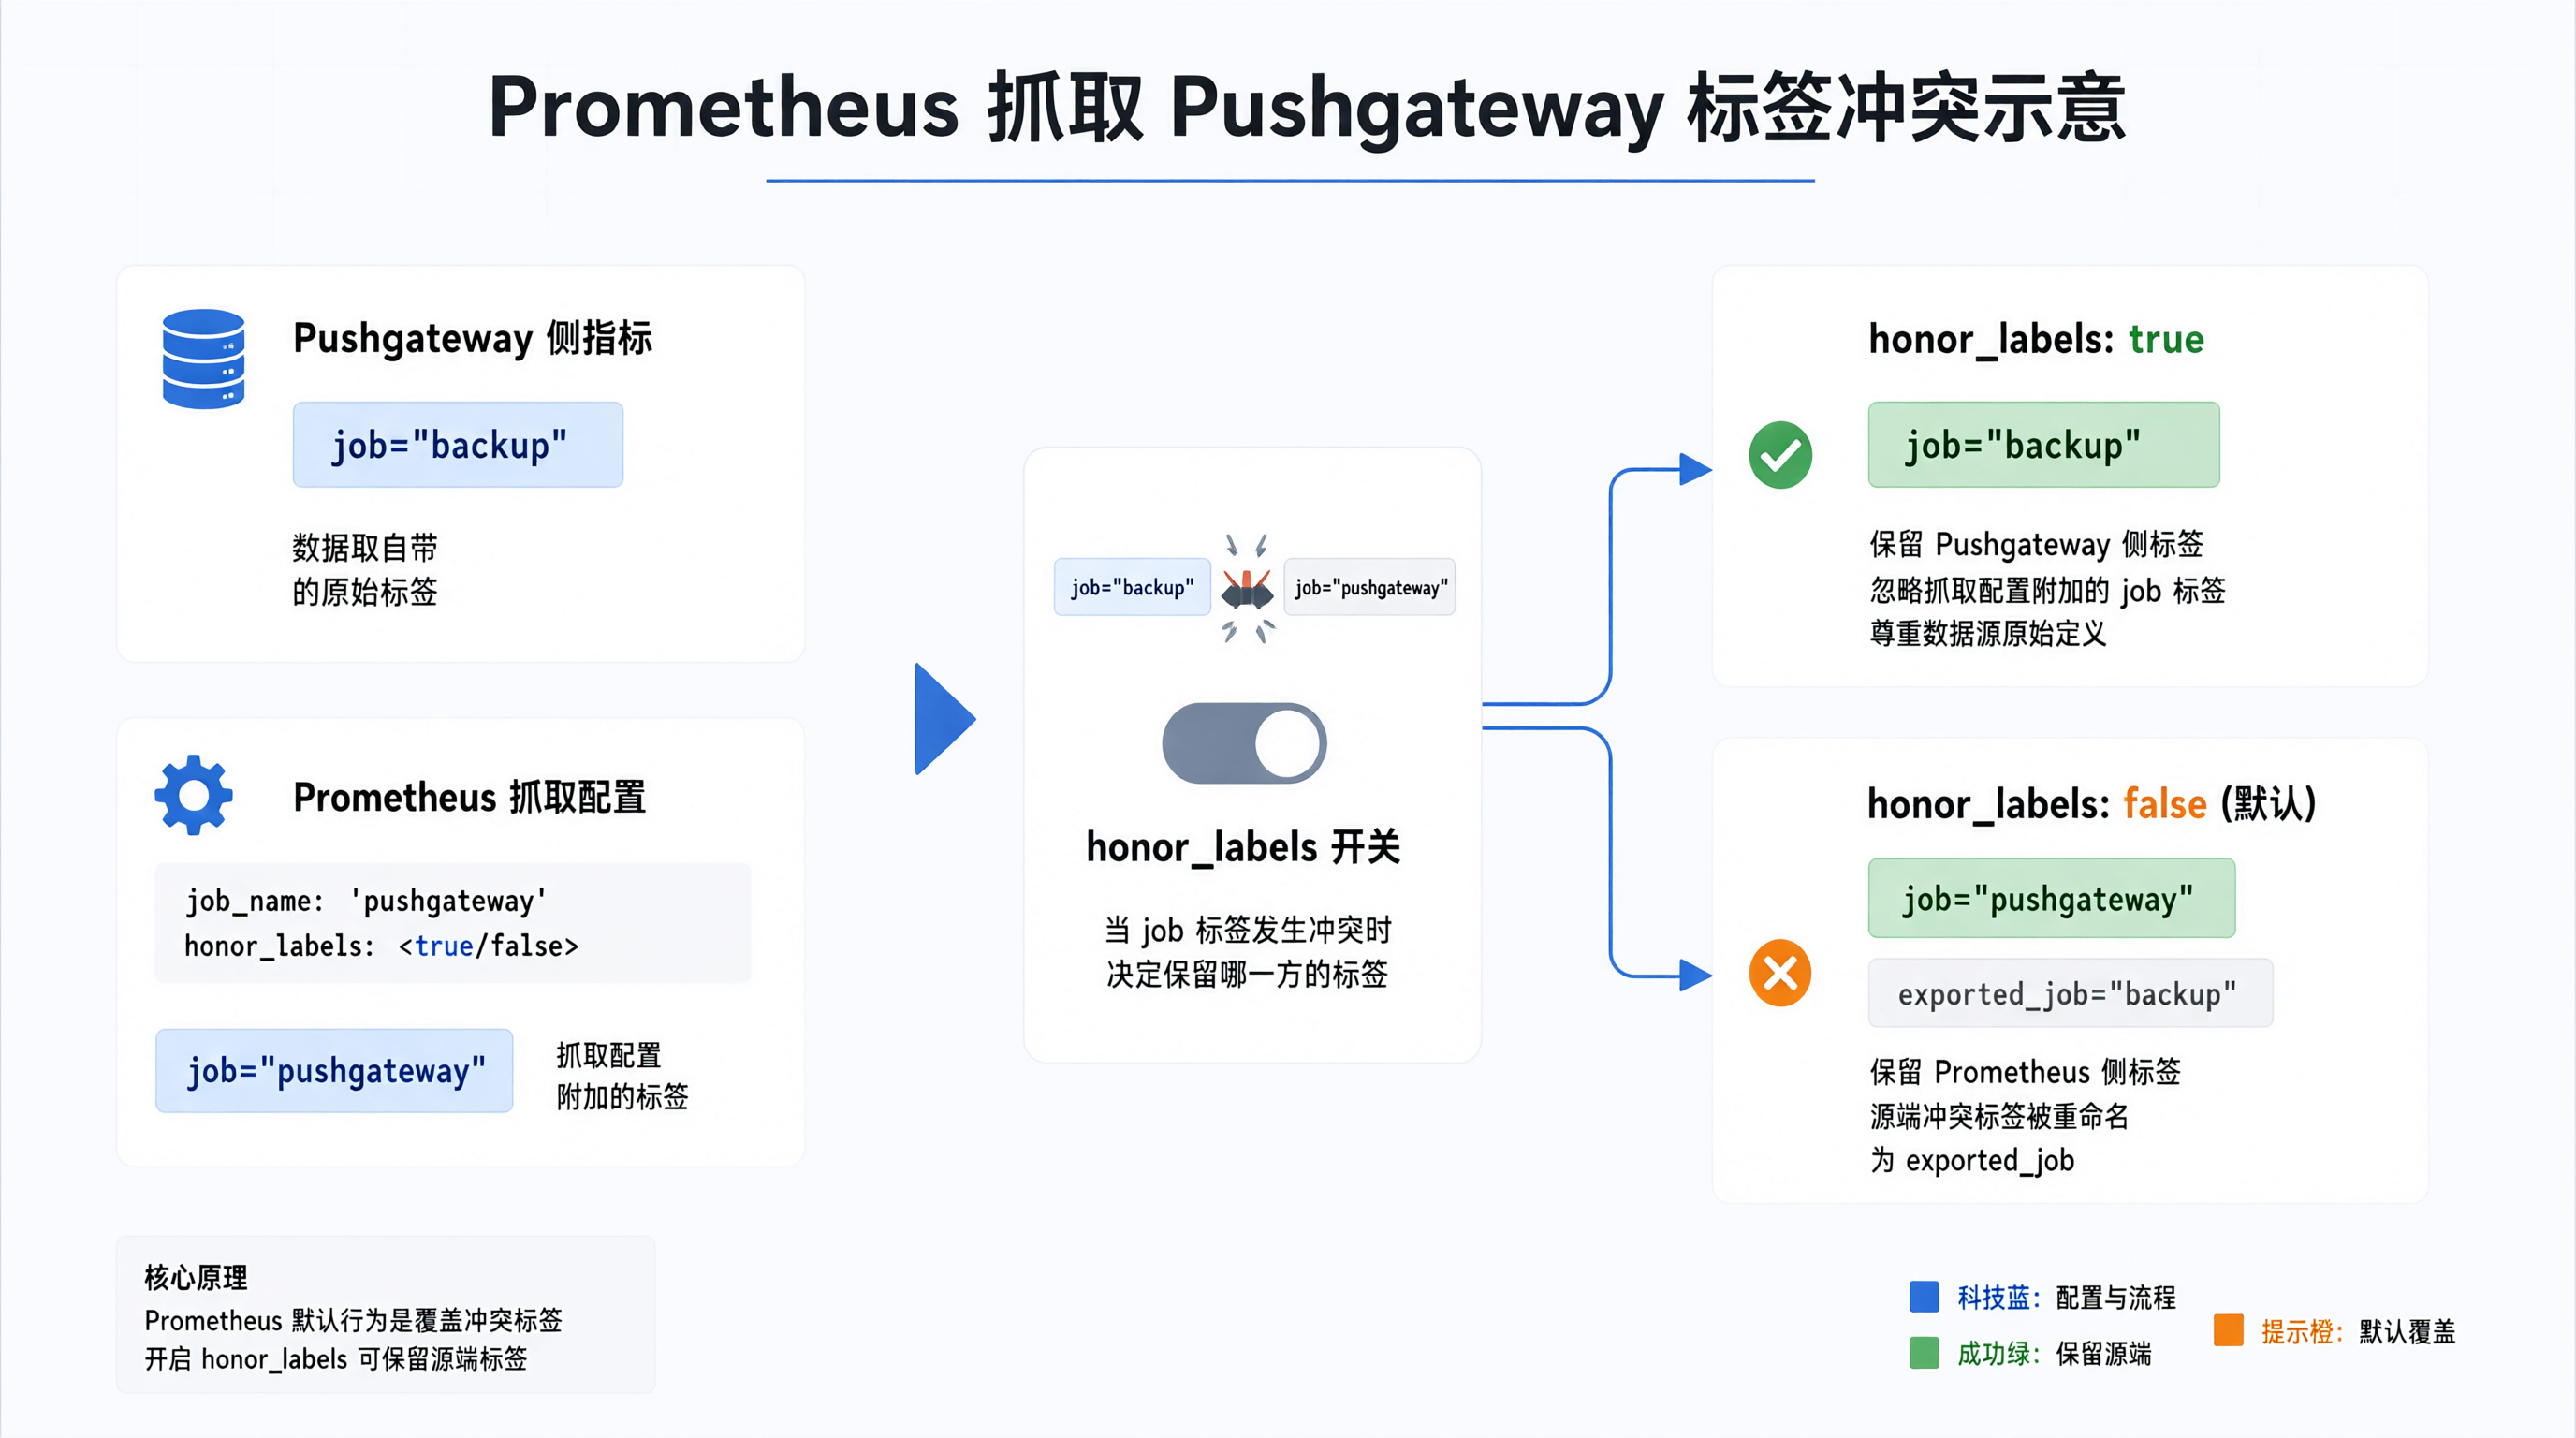
Pushgateway 本身就是一个普通的 Prometheus target,在 prometheus.yml 里加一段:
yaml
scrape_configs:
  - job_name: 'pushgateway'
    honor_labels: true
    static_configs:
      - targets: ['localhost:9091']
这里重点说 honor_labels。
默认情况下 ,Prometheus 抓取时会给它抓到的所有指标加上 job 和 instance 标签,值来自 scrape_config。但 Pushgateway 上暴露的指标里,本身就带了 push 时指定的 job 标签(还有 instance 等 grouping key)。两边的 job 会冲突。
- 如果
honor_labels: false(默认),Prometheus 会把 Pushgateway 暴露的job标签重命名成exported_job,然后用自己的job="pushgateway"覆盖。结果就是你在 Grafana 里查job="nightly_backup"查不到,得查exported_job。 - 如果
honor_labels: true,Prometheus 保留指标自带的job,不覆盖。这样你在 Pushgateway 里推的job="nightly_backup"在 Prometheus 里就是原样的。
大多数用 Pushgateway 的场景,你都是希望保留 push 时指定的 job 的,所以 honor_labels: true 基本是必配项。
【踩坑提醒】如果你的 Pushgateway 上不同 job 推了同名指标、但标签不同,加上 honor_labels: true 后要确认这些标签组合不会互相冲突,否则会出现 duplicate metric 的抓取错误。
指标清理:Pushgateway 不会自动删
前面提过,Pushgateway 不会自动清理你 push 的数据。一个每天跑一次的备份任务,如果某天不再运行了,它的 backup_duration_seconds 会永远留在那里,Prometheus 也会一直抓到它,告警规则可能因此误判。
所以推送方要负起清理责任。常见做法有两个:
做法一:任务结束前主动删除自己的指标。 prometheus_client 提供了 delete_from_gateway:
python
from prometheus_client import delete_from_gateway

delete_from_gateway(
    'localhost:9091',
    job='nightly_backup',
    grouping_key={'instance': 'db-primary-01'}
)
适合"任务跑完就不需要这个指标了"的场景。但注意,如果任务异常退出(比如被 kill),这段清理代码不会执行,指标还是会残留。
做法二:用 Pushgateway 的 API 手动/脚本清理。 比如:
bash
# 删除某个 job 下的全部指标
curl -X DELETE http://localhost:9091/metrics/job/nightly_backup

# 删除某个 job 某个 instance 的指标
curl -X DELETE http://localhost:9091/metrics/job/nightly_backup/instance/db-primary-01
可以配合一个定时清理脚本,定期删掉长时间没更新的 job。判断"长时间没更新",可以看 Pushgateway 自动加的一个指标 push_time_seconds,它记录了每条 push 的时间戳。
bash
# 该指标能反映每个 job 最后一次 push 的时间
curl -s http://localhost:9091/metrics | grep push_time_seconds
【关键结论】Pushgateway 只适合"状态型"的短任务指标。不要把它当成通用指标通道,更不要用它来做高频率、多实例的常规服务监控------那样会把 push 语义的坑放大,而且所有数据都挤在一个 target 上,抓取压力也集中。
关于远程上报的一点取舍
标题里提到"远程上报",这里想澄清一个容易混淆的概念。
Pushgateway 和 Prometheus 的 remote write(远程写入)是两回事,经常被混为一谈:
- Pushgateway:面向被监控的短任务,任务是主动方,push 给 Pushgateway,Prometheus 再 pull Pushgateway。它解决的是"pull 抓不到短任务"的问题。
- remote write :是 Prometheus 自身把采集到的数据转发 到远端存储(比如 Thanos、VictoriaMetrics、Mimir 或云厂商的托管服务)的机制,配置在 Prometheus 的
remote_write段。它解决的是"本地存储容量有限、需要长期/跨集群存储"的问题。
如果你是"任务在 A 网络,Prometheus 在 B 网络,任务无法直接被 B 的 Prometheus 抓到"这种场景,做法是:任务 push 到本网络内的 Pushgateway,然后让 B 网络的 Prometheus 跨网抓这个 Pushgateway,或者用 Prometheus 的 remote write 把 B 采集的数据转发出去。选择取决于你的网络拓扑和存储需求,不是简单二选一。
yaml
# remote_write 的配置形态(示意,具体 endpoint 和认证按你的远端存储文档来)
remote_write:
  - url: "https://your-remote-storage/api/v1/write"
    basic_auth:
      username: "xxx"
password: "yyy"这里我要明确一点:remote write 的具体认证方式、endpoint 路径、是否支持某些高级参数,取决于你所用的远端存储后端,各家实现不完全一致。这一点我没法给一个通用答案,请以对应后端的官方文档为准,我不在这里编造。
一个完整的推送示例
把前面的点串起来,写一个"任务开始记录时间 + 结束推送耗时 + 记录处理条数"的脚本:
python
import time
from prometheus_client import CollectorRegistry, Gauge, push_to_gateway, delete_from_gateway

GATEWAY = 'localhost:9091'
JOB = 'data_sync'
GROUPING = {'instance': 'sync-worker-01'}

def run_task():
    # 模拟实际业务
    time.sleep(2)
    return 1234  # 处理条数

def main():
    registry = CollectorRegistry()

    duration = Gauge(
        'data_sync_duration_seconds',
        'Duration of the data sync job',
        registry=registry
    )
    processed = Gauge(
        'data_sync_processed_records',
        'Number of records processed',
        registry=registry
    )
    last_success = Gauge(
        'data_sync_last_success_timestamp',
        'Unix timestamp of last successful run',
        registry=registry
    )

    start = time.time()
    try:
        count = run_task()
    except Exception:
        # 失败也推一次,但 success 时间戳不更新,方便告警
        duration.set(time.time() - start)
        push_to_gateway(GATEWAY, job=JOB, registry=registry, grouping_key=GROUPING)
        raise

    duration.set(time.time() - start)
    processed.set(count)
    last_success.set(time.time())

    push_to_gateway(GATEWAY, job=JOB, registry=registry, grouping_key=GROUPING)

if __name__ == '__main__':
    main()
这个脚本的要点:
- 失败时也 push,但
last_success不更新。这样你可以基于time() - data_sync_last_success_timestamp做"多久没成功"的告警,比单纯看失败次数更直观。 - 用
grouping_key区分实例,避免多 worker 互相覆盖。 - 每次 push 都是全量替换该 job+instance 下的指标,所以三个指标必须一起推,不能只推一部分。
跑完之后,去 Prometheus 里查询 data_sync_duration_seconds,应该能看到数据。如果没有,按这个顺序排查:
curl http://localhost:9091/metrics确认 Pushgateway 上确实有这条指标;- 确认 Prometheus 的
scrape_configs里 target 是 Pushgateway 的地址,且 Prometheus 的 Targets 页面显示这个 target 是 UP; - 确认
honor_labels配置符合预期,查询时用对标签名。
结尾
Pushgateway 解决的问题很具体------pull 模型抓不到短生命周期任务。它的部署不复杂,二进制和 Docker 两种方式按你的环境选即可。真正需要花心思的是语义 :push 是全量替换还是追加、指标谁来清理、honor_labels 怎么配、别把它当成常规服务监控的通道。
如果你只是想让一个定时脚本的结果能被 Prometheus 看到,上面这套流程足够用了。再往上,如果涉及多集群、长期存储、跨网络,那就是 remote write 和远端存储的领域,Pushgateway 只负责它该负责的那一段。
文中涉及具体版本号的地方(如 Pushgateway 的 1.x 小版本、prometheus_client 的 0.20.x),请以你实际下载和安装时看到的版本为准,我在文中没有逐一验证每个小版本的行为差异。