做商品评论分析的工具,最烦的其实不是模型效果,而是模型名字。
我手头这个需求很典型:给一批电商评论做三件事------判断情感倾向、抽取商品属性标签、对差评生成一句简短摘要。一开始我图省事,三个任务全写死同一个模型:
python
MODEL = "some-chat-model"跑起来没问题,但很快就不对劲了。情感判断这种二分类任务,用小模型又快又便宜;摘要生成需要点语言组织能力,小模型出来的东西经常是"质量不好,不满意"这种评论原文的复读;标签抽取又对结构化输出要求高。三个任务塞进一个模型,要么贵,要么差。
于是我改成一个任务一个模型,在代码里维护一张映射表:
python
TASK_MODEL_MAP = {
    "sentiment": "model-a",
    "tags": "model-b",
    "summary": "model-c",
}
这张表就是新的麻烦。模型会下线、会涨价、会有新版本,每次变动都得改代码、重新发版。更尴尬的是,这张表是我根据当时的测试拍的,过两周自己都记不清为什么 tags 用了 model-b。
这次我换了个思路:代码里只写任务名,实际用哪个模型交给平台的智能路由去决定。下面把整个过程拆开讲,包括我实际验证过的部分和没验证的部分。
先想清楚"交给平台"到底交出去什么
"智能路由"这个词听起来很玄,但落到工程上,它要解决的其实就是一件事:调用方表达意图,平台决定实现。
调用方说"我要做情感判断",平台根据任务类型、当前可用模型、成本策略、甚至是负载情况,选一个模型执行。调用方不需要知道最后是谁干的。
这里有个前提必须说清楚:路由规则本身是平台侧的能力,不是我能完全控制的。我能控制的是怎么把"任务意图"表达清楚,以及在拿到结果后怎么处理。
所以我的设计重点放在两件事上:
- 代码里彻底不出现具体模型名,只出现任务标识。
- 对返回结果做防御性解析,因为不同模型的实际输出格式可能有差异------这一点后面会展开。
【注意】蓝耘平台智能路由的具体配置入口、规则优先级、以及是否支持按任务名自定义路由,本文不做断言。我下面写的调用层是围绕"任务名 → 平台路由 → 模型返回"这个抽象来设计的,具体参数请以你所用平台的当前文档为准。我没验证过的部分会明确标出来。
把调用层抽象成一个函数
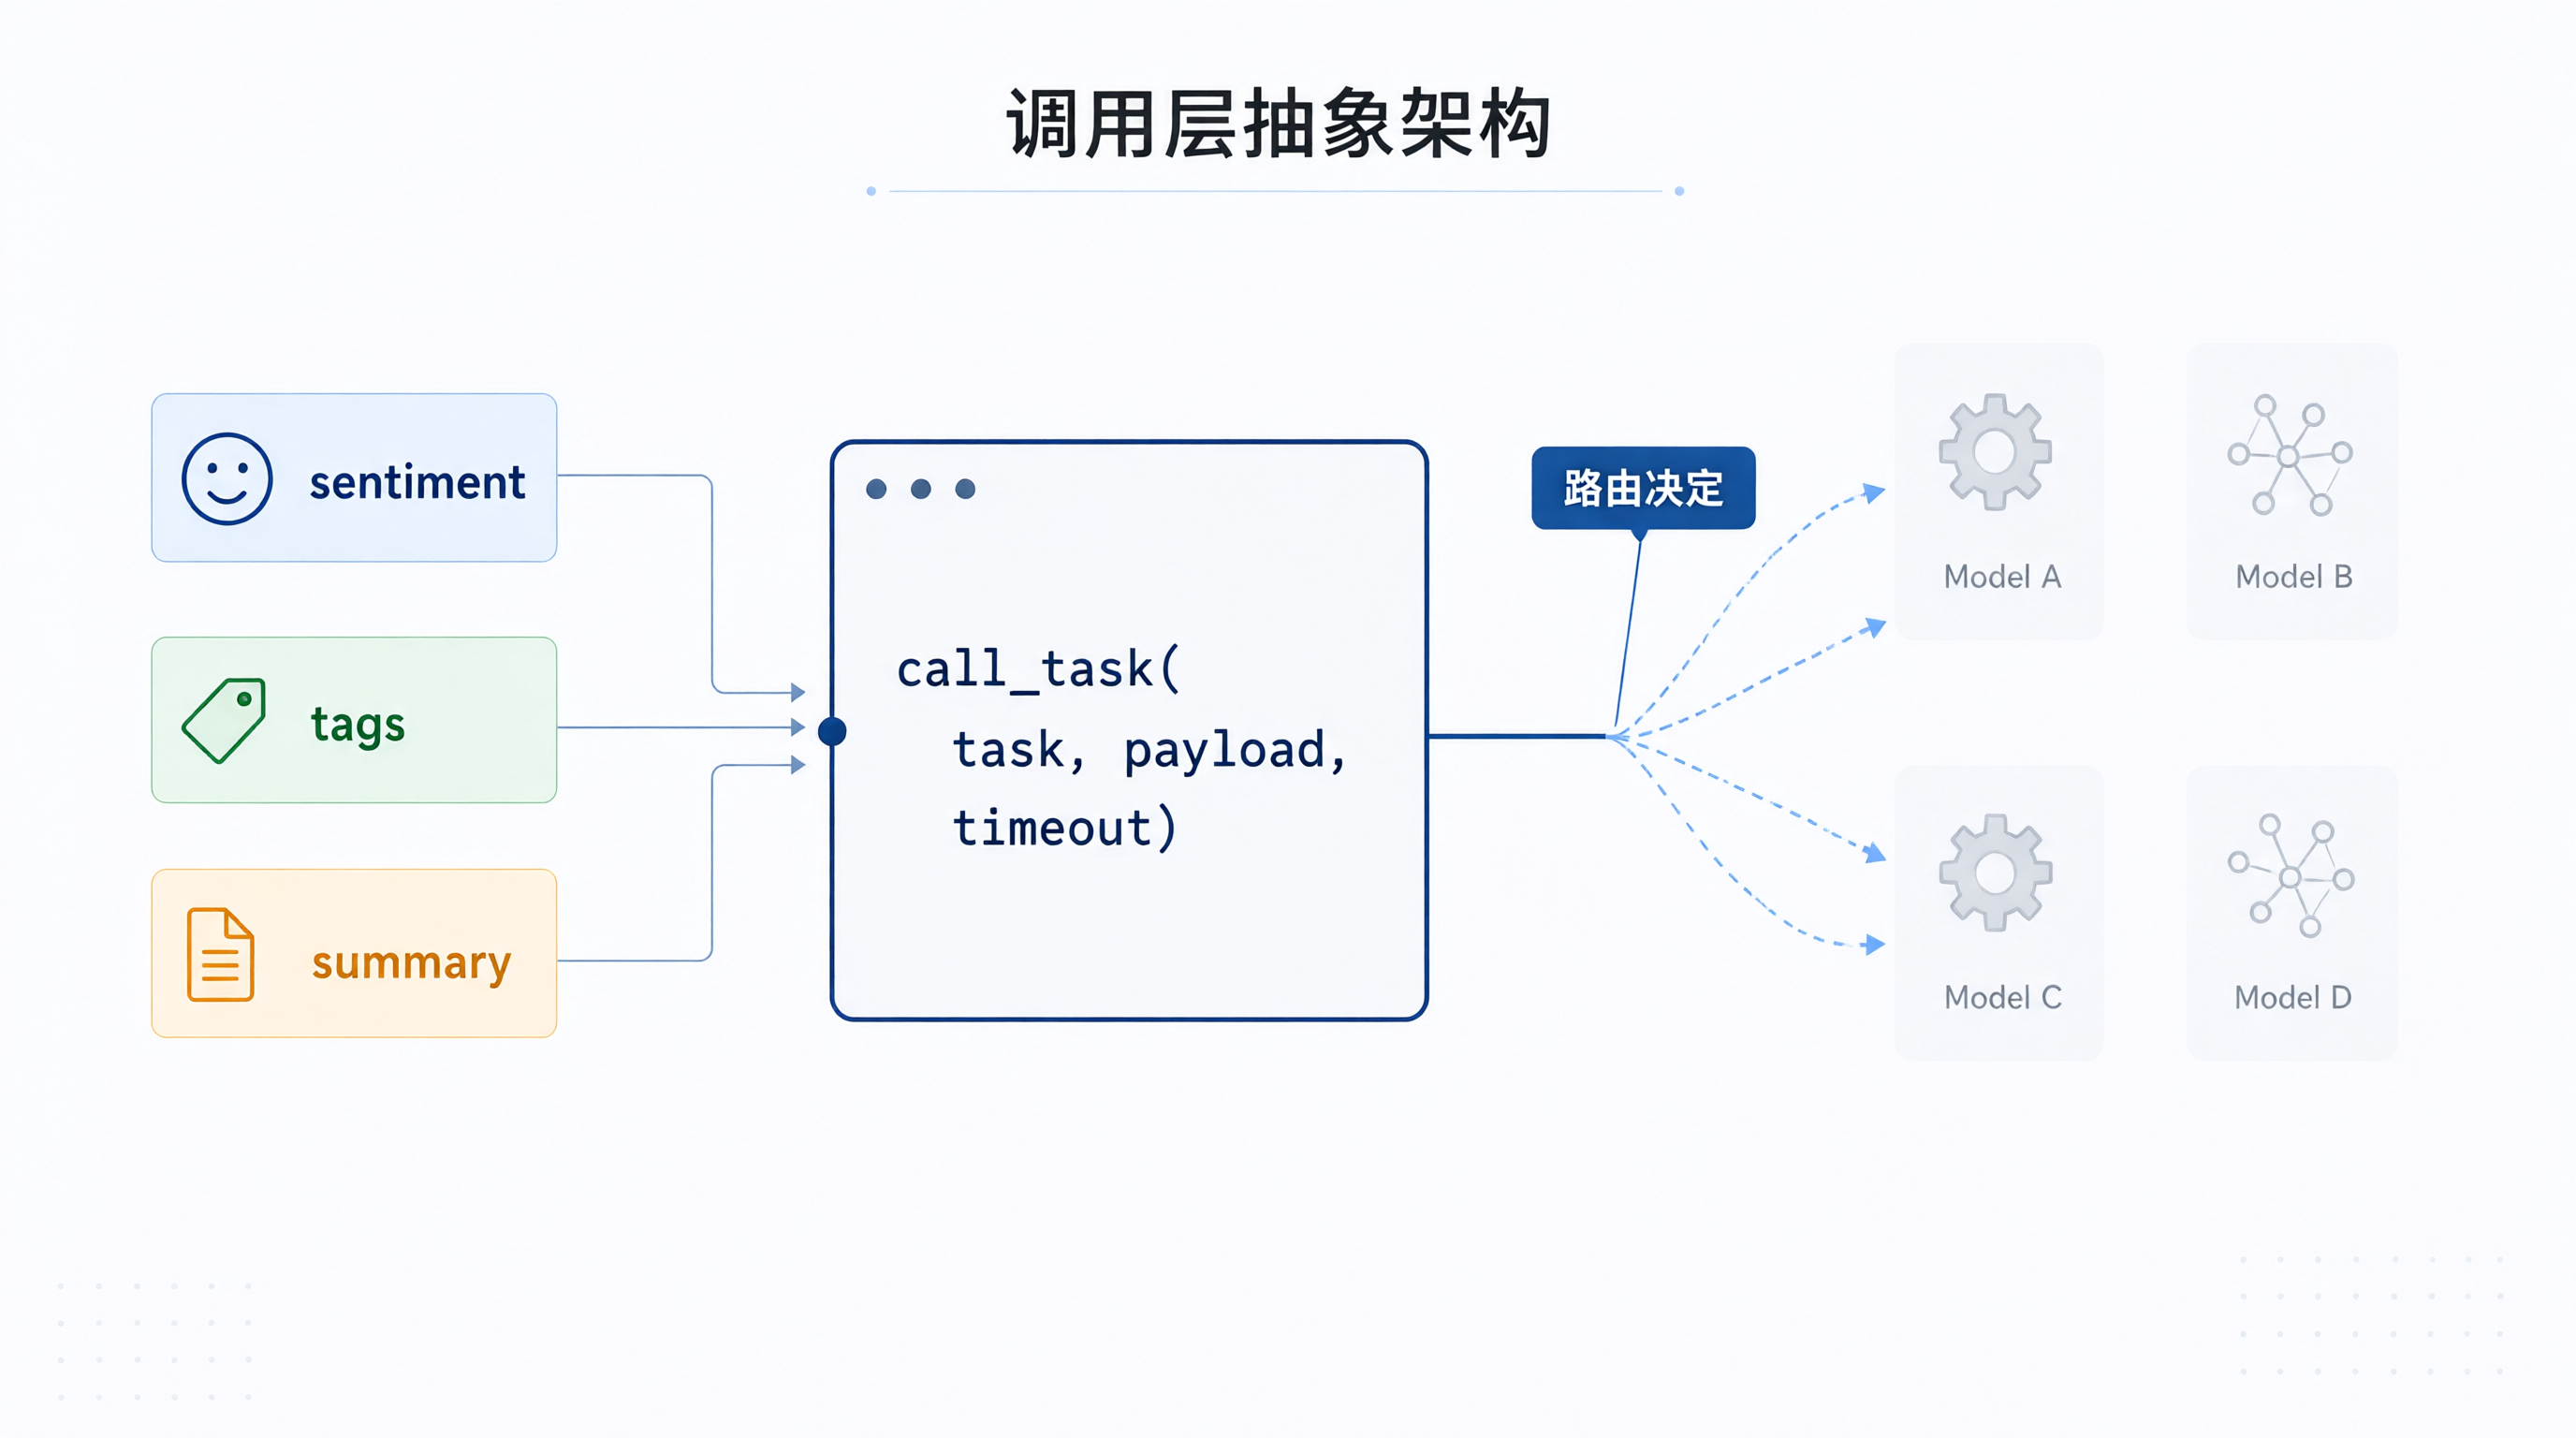
核心思路是:不管什么任务,对外只暴露一个函数。
python
# router_client.py
# Python 3.10+
# 说明:这里用 requests 直连,实际 SDK 名称和参数请以平台文档为准

import os
import json
import requests

BASE_URL = os.environ.get("LANYUN_BASE_URL", "")   # 平台提供的接口地址
API_KEY = os.environ.get("LANYUN_API_KEY", "")

def call_task(task_name: str, payload: dict, timeout: int = 30) -> dict:
    """
    task_name: 任务标识,比如 sentiment / tags / summary
    payload:   任务输入,交给平台路由去选择模型
    """
    if not BASE_URL or not API_KEY:
        raise RuntimeError("缺少 LANYUN_BASE_URL 或 LANYUN_API_KEY")

    headers = {
        "Authorization": f"Bearer {API_KEY}",
        "Content-Type": "application/json",
    }
    body = {
        "task": task_name,      # 关键:传任务名,不传模型名
        "input": payload,
    }
    resp = requests.post(
        f"{BASE_URL}/route",
        headers=headers,
        data=json.dumps(body),
        timeout=timeout,
    )
    resp.raise_for_status()
    return resp.json()
为什么这么写,有几个考虑:
第一,task 是唯一的路由依据。 我刻意不提供 model 参数。一旦留了口子,早晚有人会绕过路由直接指定模型,那张隐藏的耦合表就又回来了。
第二,超时是必须的。 批量评论分析动辄几百上千条,单条卡住会拖垮整批。我给了 30 秒默认值,实际批量场景会调小。
第三,payload 保持简单。 我只传原始文本和必要的指令,不在客户端拼接复杂的 prompt 模板------因为路由可能落到不同模型,而不同模型对 prompt 格式的偏好不一样,把模板放在路由后面更合理。
【踩坑提醒】/route 这个路径和 task / input 这两个字段名是我为了说明抽象层写的示例。蓝耘实际的接口路径和参数命名我没有验证过,接入时一定要对照官方文档改。我在这里强调的是参数语义------传任务不传模型------而不是具体的字段拼写。
三个任务,三套 prompt 意图
调用层统一了,接下来是任务本身。我把每个任务的指令写成一个独立的构造函数,让"意图"和"数据"分开。
python
# tasks.py

def build_sentiment(text: str) -> dict:
    return {
        "instruction": "判断下面这条商品评论的情感倾向,只回答 positive / negative / neutral 三个词之一。",
        "text": text,
    }

def build_tags(text: str) -> dict:
    return {
        "instruction": (
            "从下面这条评论中抽取商品属性标签,"
            "以 JSON 数组返回,例如 [\"物流\", \"做工\"],不要输出其他内容。"
        ),
        "text": text,
    }

def build_summary(text: str) -> dict:
    return {
        "instruction": "用不超过 20 个字概括这条差评的核心问题,直接输出概括,不要解释。",
        "text": text,
}这里有个我一开始没想明白的点:指令里强调"只回答某个词""只输出 JSON"这类约束,实际效果取决于落到哪个模型。有的模型很听话,有的会加一句"好的,这条评论的情感是 positive"。所以我后面加了结果解析层来兜底,而不是指望 prompt 一定能约束住。
结果解析:不要假设模型输出是干净的
这是整个工具里最容易出问题的地方,也是我认为最值得单独讲的部分。
情感判断任务,我期望拿到的是 positive。但实际返回可能是:
positivePositivepositive。这条评论的情感倾向是 positive。
标签抽取更麻烦,期望是 ["物流", "做工"],实际可能是:
- 纯 JSON 数组
- 被 ```json 代码块包起来的 JSON
- 前面带一句"抽取结果如下:"再跟 JSON
所以我写了一个解析层,把"拿到原始文本"和"解析成结构化数据"分开:
python
# parser.py
import re
import json

VALID_SENTIMENTS = {"positive", "negative", "neutral"}

def parse_sentiment(raw: str) -> str:
    text = raw.strip().lower()
    for label in VALID_SENTIMENTS:
        if label in text:
            return label
    return "unknown"   # 解析不出来就显式标记,不要瞎猜

def parse_tags(raw: str) -> list[str]:
    text = raw.strip()
    # 去掉可能的 markdown 代码块包裹
    text = re.sub(r"^```(?:json)?|```$", "", text, flags=re.MULTILINE).strip()
    # 尝试直接解析
    try:
        data = json.loads(text)
        if isinstance(data, list):
            return [str(x) for x in data]
    except json.JSONDecodeError:
        pass
    # 退一步:从文本里抓第一个 JSON 数组
    match = re.search(r"\[.*?\]", text, re.DOTALL)
    if match:
        try:
            data = json.loads(match.group())
            if isinstance(data, list):
                return [str(x) for x in data]
        except json.JSONDecodeError:
            pass
    return []   # 抽不到就返回空列表,交给上层决定怎么处理

def parse_summary(raw: str) -> str:
    # 摘要任务最简单:去掉首尾空白和可能的引号
return raw.strip().strip("""\"'")为什么要这么啰嗦?因为路由把模型选择权交出去了,就意味着输出格式的不确定性也一起交出去了。如果我还在客户端假设输出一定是干净的 JSON,那路由反而变成了风险来源。
parse_sentiment 里我特意用"包含"而不是"相等"来判断。因为 positive 是 positive 的子串,但 negative 里也含 negative 这个词,不会误判。不过这里有个细节:如果模型输出 not positive,我的逻辑会判成 positive,这是错的。这种情况我目前靠 prompt 约束 + 人工抽查发现,没有做更复杂的否定检测。这一点我没有做完整的验证,只是知道存在这个边界情况。
【关键结论】解析层要假设"输出可能不干净",并且解析失败时返回明确的标记值(unknown / 空列表),而不是抛异常或返回默认的正常值。前者会让脏数据静默通过,后者会让整批任务中断。
批量处理:并发、限流和失败重试
单条调通之后,真正的场景是批量。几百条评论,串行跑太慢,全并发又容易触发限流。
我用 concurrent.futures 做一个受控的并发池:
python
# batch.py
from concurrent.futures import ThreadPoolExecutor, as_completed
from router_client import call_task
from tasks import build_sentiment, build_tags, build_summary
from parser import parse_sentiment, parse_tags, parse_summary

MAX_WORKERS = 5   # 保守值,避免触发平台限流

def analyze_one(text: str) -> dict:
    result = {"text": text}

    try:
        raw = call_task("sentiment", build_sentiment(text))
        result["sentiment"] = parse_sentiment(raw.get("output", ""))
    except Exception as e:
        result["sentiment"] = "error"
        result["sentiment_error"] = str(e)

    try:
        raw = call_task("tags", build_tags(text))
        result["tags"] = parse_tags(raw.get("output", ""))
    except Exception as e:
        result["tags"] = []
        result["tags_error"] = str(e)

    return result

def analyze_batch(texts: list[str]) -> list[dict]:
    results = []
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = {pool.submit(analyze_one, t): t for t in texts}
        for fut in as_completed(futures):
            results.append(fut.result())
    return results
几个设计取舍:
并发数我压得很低(5)。 因为路由背后到底落到哪个模型、那个模型的限流阈值是多少,我在客户端是不知道的。宁可慢一点,也不要因为 429 让整批失败。
每个任务单独 try。 情感判断失败了,不应该连累标签抽取。所以我把它们分开捕获,失败的那个字段标记出来,其他字段照常写入。
没有做自动重试。 这是我故意的------重试策略和限流策略耦合,而限流是平台侧的行为。如果盲目重试,可能在平台已经限流的情况下火上浇油。目前我的做法是记录失败项,人工决定是否重跑。更完善的重试机制我没有实现,也没有验证过退避策略在这个场景下的效果。
差评摘要只在需要时触发,避免对每条评论都调用:
python
def summarize_negatives(results: list[dict]) -> list[dict]:
    for r in results:
        if r.get("sentiment") == "negative":
            try:
                raw = call_task("summary", build_summary(r["text"]))
                r["summary"] = parse_summary(raw.get("output", ""))
            except Exception as e:
                r["summary"] = ""
                r["summary_error"] = str(e)
    return results
路由带来的一个实际好处和两个代价
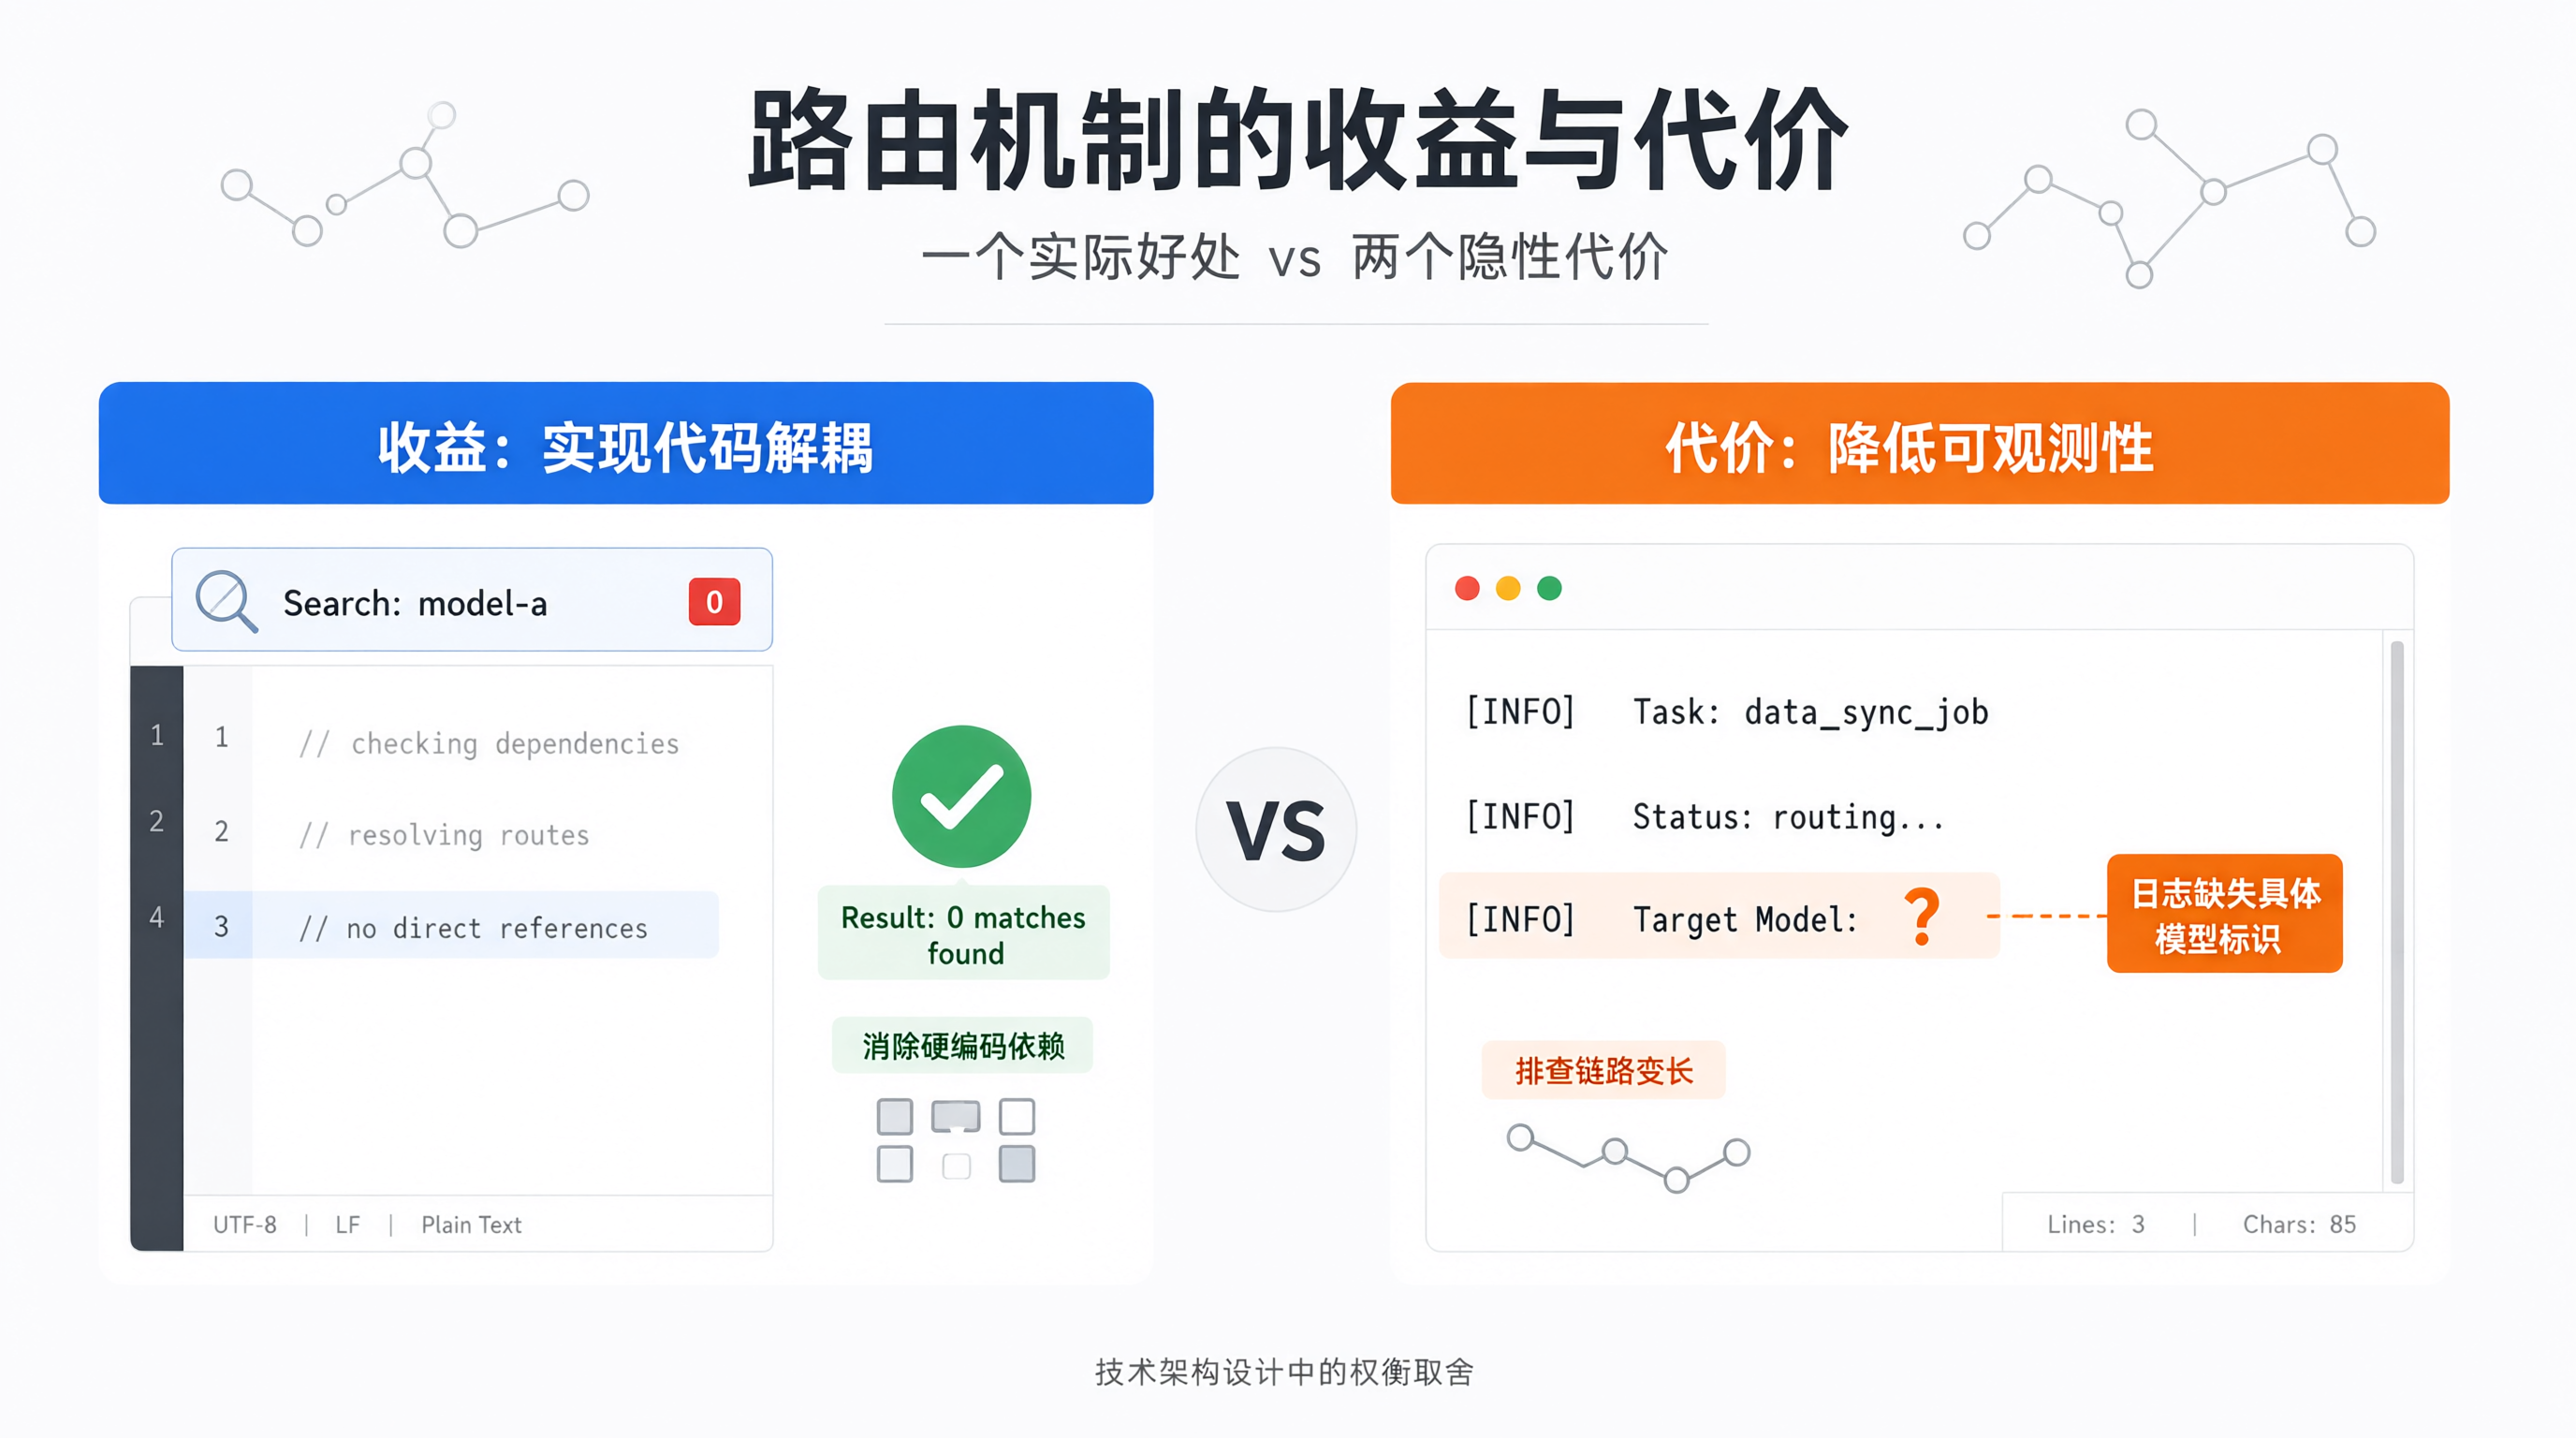
用下来,好处很直接:代码里再也没有模型名 。搜索整个项目,找不到任何 model-a、model-b 这样的字符串。模型换代、调整策略,我这边不用动代码。
但代价也是真实的,得说清楚。
代价一:可观测性变差。 以前我知道每条请求用了哪个模型,出了问题能直接定位。现在不知道了。如果平台返回里带了实际使用的模型标识,一定要记下来;如果没带,那排查问题会麻烦很多。我目前的做法是在日志里把整个响应存下来,但蓝耘的响应里是否包含实际模型信息,我没有验证过。
代价二:调试变难。 以前可以固定一个模型反复调 prompt,现在每次可能落到不同模型,prompt 效果不稳定。我的应对是把 prompt 写得尽量"无脑"------约束明确、格式简单,减少对特定模型风格的依赖。
下面这张表是我对两种方案的实际感受对比:
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 代码里硬编码模型 | 可观测性好,调试可控,行为确定 | 模型变更需改代码发版,多任务难兼顾性价比 | 任务单一、模型稳定、对确定性要求高的场景 |
| 交给平台智能路由 | 代码与模型解耦,多任务自动择优 | 可观测性下降,调试不确定,依赖平台能力 | 任务多样、模型更新频繁、想省运维成本 |
我的判断是:任务类型多、模型更新频繁的场景适合路由;单一任务、追求极致可控的场景,硬编码反而更省心。 这不是"路由一定更好",而是取舍。
一个我没绕过去的边界
有个问题我一直没解决好:结构化输出任务(比如标签抽取)对模型能力有硬要求。
如果路由为了省钱,把一个要求输出 JSON 的任务落到了不擅长结构化输出的小模型上,返回的就是一堆自然语言,我的解析层只能返回空列表。这时候我无法区分"这条评论确实没有可抽取的标签"和"模型没按要求输出"。
我目前的处理是:解析失败返回空列表,同时在结果里加一个标记。但更根本的解法应该是让路由知道"这个任务需要结构化输出能力"。蓝耘的智能路由是否支持按输出格式或能力要求来筛选模型,这一点我没有验证,无法给出确定答案。 如果你的场景里结构化任务占比高,接入前建议先确认这一点。
最后
这套工具现在的形态是:三个任务意图(sentiment / tags / summary),一个统一的 call_task 入口,一个防御性的解析层,一个受控并发的批处理。代码里没有任何模型名。
它不算完美。可观测性、结构化输出的能力匹配、失败重试,都还有没做透的地方。但至少解决了我最初的那个痛点------不用再维护一张自己都记不清来由的模型映射表了。
如果你也在做类似的评论分析或者文本批处理,我建议先把"任务意图"和"模型实现"这两层拆开。不管最后用不用平台路由,这个拆分本身就能让代码干净不少。至于路由规则怎么配、能力怎么筛,那部分得结合你实际用的平台文档来定,我文中标了"没验证"的地方,请务必自己确认一遍再上生产。