K8S (Kubernetes) 完整知识点总结
适合面试复习、系统梳理;从基础概念→组件→资源对象→网络→存储→调度→安全→运维→进阶。
一、K8S 基础概念
1. 什么是 K8S
Kubernetes 是 Google 基于 Borg 开源的容器编排平台,用于自动化容器部署、扩缩容、故障自愈、服务管理。
- 作用:管理大量 Docker 容器,不用手动一个个启停容器
- 定位:不负责构建镜像,只负责运行、调度镜像;镜像由 Docker/Containerd 构建
- 底层容器运行时:containerd(现在主流)、docker(已废弃 dockershim)、cri‑o
- CRI:Container Runtime Interface,容器运行时接口,K8S 通过 CRI 对接底层容器引擎
2. K8S 集群角色划分
集群分为 Master(控制平面 Control Plane)节点 和 Worker(工作)节点表格
| 角色 | 作用 |
|---|---|
| Control Plane (控制平面) | 整个集群大脑,做调度、决策,不跑业务 Pod(默认) |
| Worker Node (工作节点) | 真正运行业务 Pod 的机器 |
高可用集群:部署 3 个控制平面节点;单 master 为测试环境使用。
二、控制平面(Master)五大核心组件
1. kube‑apiserver
✅ 集群唯一入口,所有请求必经它
- REST API 接口,所有 kubectl、各组件全部访问 apiserver
- 身份认证、鉴权、准入控制
- 唯一读写 etcd 的组件;其他组件不能直接访问 etcd
2. etcd
✅ 集群数据库,保存集群全部状态数据
- key‑value 数据库;保存全部资源对象(Pod、Deployment、Service 等)
- 必须做备份;集群所有状态存在 etcd;丢失 etcd 数据集群直接报废
生产 etcd 独立部署或者跟 master 节点一起,一定要高可用
3. kube‑scheduler(调度器)
✅ 负责Pod 调度:新建 Pod 后,筛选合适的 worker 节点运行 Pod
- 筛选流程:过滤(Predicate 预选) → 打分(Priority 优选)
- 可自定义调度策略;支持自定义调度器
4. kube‑controller‑manager(控制器管理器)
运行各类控制器 Controller,持续调谐(Reconcile),维持集群期望状态 常见内置控制器:
- NodeController:监控节点宕机
- ReplicationController:副本控制器(老版本)
- DeploymentController、StatefulSetController、JobController 等
核心思想:期望状态 vs 当前状态,不断循环调谐,让现状追平期望
5. cloud‑controller‑manager(CCM 云控制器管理器)
对接公有云 API;自建裸金属集群一般不用;云厂商实现负载均衡、节点生命周期管理。
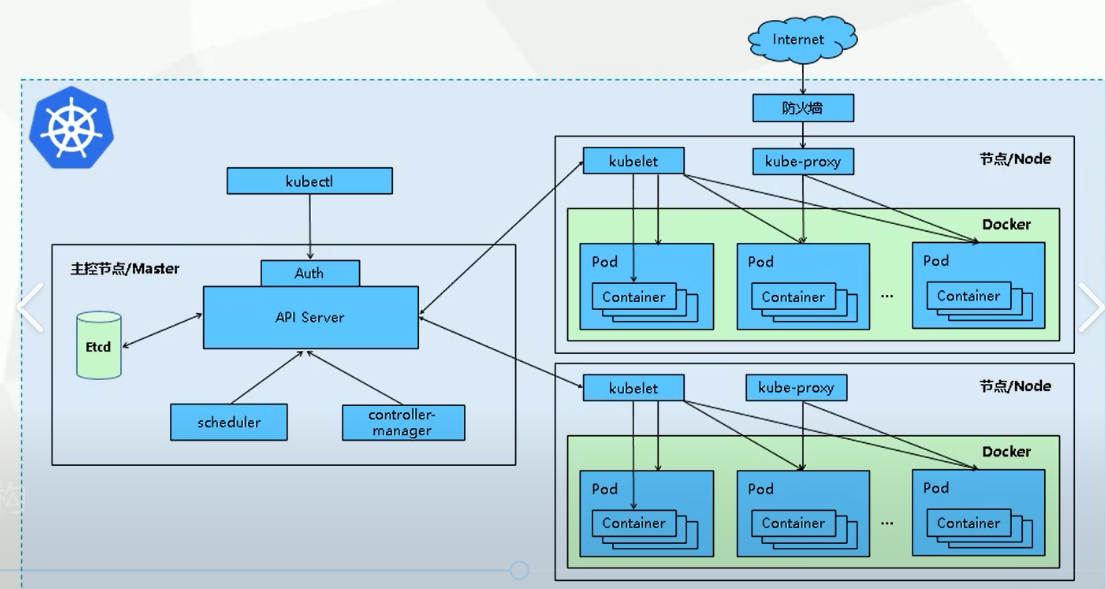
Pod 创建启动分步流程(面试背诵版)
- 步骤 1:用户提交创建请求 用户执行
kubectl create/apply -f xxx.yaml,通过kubectl 发送创建 Pod(一般是 Deployment)的请求,请求先经过 Auth(认证鉴权),发送给 API‑Server。 - 步骤 2:APIServer 写入 etcd 持久化存储 APIServer 完成认证、鉴权、准入校验后,把 Pod 资源信息写入etcd 数据库保存集群期望状态;此时 Pod 状态为 Pending。
💡注意:其它组件不会直接访问 etcd,全部走 APIServer。
- 步骤 3:Controller‑manager 监听到资源变化 controller‑manager 通过监听 APIServer,发现有新建 Deployment,生成对应的 Pod 对象,再更新信息写入 apiserver→etcd。 (如果直接创建裸 Pod,则跳过这一步;实际业务一般用 Deployment 控制器生成 Pod)
- 步骤 4:Scheduler 调度器进行节点调度 scheduler 持续监听 apiserver,发现存在还没有绑定节点的 Pending 状态 Pod;
- 执行预选 Predicate过滤不符合条件的节点;
- 执行优选 Priority给剩下节点打分; 选出最合适的 Worker 节点; 调度结果(Pod 绑定到某一个 node)提交给 APIServer,保存到 etcd。
- 步骤 5:目标 Node 上 kubelet 接收任务,拉起 Pod 容器 被选定工作节点上的kubelet(本机节点代理)通过监听 APIServer,发现有分配给自己的 Pod; kubelet 调用本机底层容器运行时(图里是 Docker,新版是 containerd),拉取镜像、创建并启动 Pod 内部的 Container 容器。
- 步骤 6:kubelet 上报 Pod 状态回 APIServer 容器启动之后 kubelet 收集 Pod、容器的运行状态,回传给 APIServer;APIServer 把最新状态更新存入 etcd;集群就可以看到 Pod 变为 Running。
- 步骤 7:kube‑proxy 维护 Service 网络规则(网络负载均衡) 每个节点上的 kube‑proxy 监听 apiserver 中 Service、Endpoints 变化,在本机生成 iptables/ipvs 转发规则,实现 Service 对后端 Pod 的访问负载均衡。
三、Worker Node 工作节点组件
1. kubelet(节点代理,每个 worker 必跑)
✅ 节点上的代理程序,跟 apiserver 通信,管理本机 Pod
- 接收 apiserver 下发 Pod 定义;调用 CRI 创建 / 停止容器
- 上报节点、Pod 状态回 apiserver;定期心跳汇报节点存活
kubelet 只接受 apiserver 下发指令,不能别人直接操控
2. kube‑proxy(网络代理,每个 worker 必跑)
✅ Service 网络组件;维护节点上 iptables/ipvs 规则,实现 Service 负载均衡 三种模式:
- userspace(废弃,性能差)
- iptables(默认早期)
- ipvs(高性能,推荐生产,支持更多调度算法:rr/wrr/lc 等)
3. 容器运行时 containerd
拉镜像、启停容器;CRI 接口对接 kubelet。
四、K8S 最小调度单元:Pod
❗重点:Pod 是 K8S 最小调度单元,不是容器!一个 Pod 可以封装 1‑N 个容器
Pod 特点
- 同一个 Pod 内部所有容器共享网络命名空间(同一个 IP),共享 Volume 存储;本地回环 lo 互通
- Pod IP 是集群内部 IP,集群内可见,外部不能直接访问;Pod 销毁重建 IP 会变(无固定 IP)
- Pod 不建议直接创建,不要裸写 Pod 资源;上层控制器管理 Pod(Deployment/StatefulSet)
Pod 内部容器分类
- 业务主容器:业务程序
- sidecar 边车容器:和主容器一起跑,日志采集、代理(istio envoy)
- init 容器:初始化容器,先执行完成退出之后,主容器才启动
Pod 生命周期与状态
Pod 的 Phase 阶段(status.phase)
- Pending:apiserver 已经创建 pod,还没调度或者镜像拉取中
- Running:Pod 已经调度,容器正在运行
- Succeeded:全部容器正常执行完毕退出(一次性任务 Job)
- Failed:至少一个容器异常退出
- Unknown:apiserver 收不到 kubelet 上报,节点失联
Pod 重启策略 restartPolicy
只针对容器崩溃;Pod 本身不会重启,是容器重启
- Always:容器退出总是重启(默认,适合常驻业务)
- OnFailure:异常退出才重启(Job 任务)
- Never:绝不重启(一次性脚本)
Pod 探针(健康检查 liveness/readiness/startupProbe)
面试高频!三种探针
- livenessProbe 存活探针 :判断容器是否活着;失败就重启容器
- readinessProbe 就绪探针 :判断容器是否就绪可以接收流量;失败把 Pod 从 Service 后端端点移除,不会重启 Pod
- startupProbe 启动探针:应对程序启动慢;启动探针成功之后才开始执行存活 / 就绪探针;防止程序没启动完就被 liveness 误杀
探针检查方式三种:
- exec:执行容器内部命令,返回码判断
- httpGet:访问容器内 http 接口
- tcpSocket:tcp 端口连通探测
五、工作负载控制器(Workload,管理 Pod)
Pod 本身不会自愈扩缩容;靠上层控制器维护副本
1. Deployment(无状态服务,最常用)✅
- 管理 ReplicaSet(副本集);ReplicaSet 真正维护 Pod 副本数量,Deployment 管控 RS 版本
- 支持滚动更新、回滚、版本记录、扩缩容 适合 web、nginx 这类无状态应用;无状态:Pod 之间无差异,任意销毁重建不影响业务
- 更新策略 strategy:
- RollingUpdate 滚动更新(默认:maxSurge 最大超量,maxUnavailable 最大不可用)
- Recreate 重建更新:全部删掉旧 Pod 再新建(停机更新)
2. StatefulSet(有状态服务)✅
用于有状态应用:mysql、etcd、zookeeper;特点:
- Pod 有序命名:web‑0,web‑1,web‑2;稳定网络标识
- 稳定持久化存储,每个 Pod 绑定独立 PVC;删除 Pod 不会自动删 pv
- 有序部署、有序删除;启动顺序 0→1→2;删除 2→1→0
StatefulSet 本身不做数据主从选举;业务自己内部处理
3. DaemonSet
每个符合条件的 Node 上运行恰好一个 Pod;新增节点自动部署 Pod;节点删除自动销毁 典型用途:节点日志采集(filebeat)、监控 agent、网络插件 calico/flannel;适合节点级代理程序。
4. Job & CronJob(批处理任务)
- Job:一次性任务;执行到完成;保证任务执行结束;restartPolicy 只能 OnFailure/Never
- CronJob:定时 Job;类似 linux crontab;cron 表达式定时创建 Job 执行任务
小结控制器选型速查表
| 控制器 | 适用场景 |
|---|---|
| Deployment | 无状态 web 业务;绝大多数业务 |
| StatefulSet | 有状态数据库、中间件集群 |
| DaemonSet | 节点守护进程,每个节点跑一个 agent |
| Job | 一次性批处理任务 |
| CronJob | 定时周期性任务 |
六、Service 服务(访问 Pod)
Pod IP 飘忽不定;Service 提供稳定访问入口,后端对接一组 Pod,提供负载均衡。 Service 的本质:kube‑proxy 维护节点上 iptables/ipvs 转发规则。
Service 四种类型
- ClusterIP(默认) :集群内部虚拟 IP;只能集群内部访问;外部访问不到
- NodePort :宿主机开放端口;
30000‑32767端口范围;访问任意节点 IP:NodePort 即可转发后端 Pod;集群内外都可访问。 - LoadBalancer:依赖外部云厂商 LB;云环境;外部云负载均衡指向集群 NodePort
- ExternalName:CNAME 别名;把 service 映射到外部域名,集群内访问别名直接转发外部域名;无代理
Service Endpoints
Endpoints 资源保存 Service 后端 Pod 实际 IP 列表;控制器通过 Pod 标签 selector 匹配 Pod 生成 endpoints。
如果 endpoints 为空:检查 service 的 selector 标签是否和 pod 标签完全匹配!
Headless Service(无头 Service,ClusterIP: None)
不给分配 clusterIP;DNS 直接解析返回后端全部 Pod 的 IP;专门给 StatefulSet 有状态应用使用,用于 Pod 之间互相发现。
Ingress(七层反向代理)
Service 是四层;Ingress 实现 http/https 七层域名、路径路由。 Ingress 资源只是规则;必须部署 Ingress‑Controller(nginx‑ingress)真正执行反向代理。
- 配置域名、路径、证书 https;对外暴露 web 业务。
七、K8S 存储体系 Volume & PV/PVC
Pod 容器本地存储 emptyDir 随 Pod 删除丢失;需要持久化存储。
1. 基础 Volume
- emptyDir:Pod 启动创建临时空目录;Pod 删除数据丢失;pod 内多容器共享目录
- hostPath:直接挂载宿主机本地目录;数据落在 node 本机;Pod 漂移到别的节点就看不到旧数据;适合 kubelet 日志这类节点本地场景
2. PV & PVC(持久化存储抽象)
PV (PersistentVolume):后端存储资源;管理员预先创建;代表一块存储(nfs/ceph/local‑pv) PVC (PersistentVolumeClaim):用户存储申请;在 yaml 里面声明我需要多大空间;PVC 绑定 PV。
解耦:业务 Pod 只写 PVC,不用关心底层是什么存储;管理员维护 PV。
PV 访问模式 accessModes
- ReadWriteOnce (RWO):只能单节点读写(大部分本地盘)
- ReadOnlyMany (ROX):多节点只读
- ReadWriteMany (RWX):多节点同时读写(nfs、cephfs)
PV 回收策略 persistentVolumeReclaimPolicy
- Retain:PVC 删除,PV 保留,数据保留,手动清理(默认)
- Delete:删 PVC 自动删除后端存储(云盘)
- Recycle(废弃)
StorageClass 存储类(动态供给)
不用管理员手动预先创建一堆 PV;用户创建 PVC,StorageClass 自动动态生成 PV。
生产优先 StorageClass 动态供给。
八、Namespace 命名空间
逻辑隔离集群资源;不是网络隔离!ns 只是逻辑分组,同一个集群不同 ns 之间默认网络互通
- 默认命名空间:
default、kube‑system(系统组件)、kube‑public - 资源是否隔离:大部分资源隔离 (Pod,Deployment,Service);Node、PV 是集群级别,不属于 namespace,全局资源
kubectl -n xxx 指定命名空间;--all‑namespaces 查看全部 ns 资源。
Label 标签 & Selector 选择器 & Annotation 注解
- Label:key=value 标签;给资源打标记;用于 selector 筛选(service 匹配 pod,控制器匹配 pod)
- Annotation 注解:附加描述信息;不能用于筛选;存额外元数据
九、K8S 调度机制
调度流程
- 用户提交 Pod 到 apiserver;写入 etcd
- scheduler 观察到未绑定 node 的 Pod
- 预选 Predicate:过滤掉不满足条件节点(资源不够、nodeSelector/nodeAffinity 污点)
- 优选 Priority:对剩余节点打分,选出分数最高节点
- scheduler 绑定 Pod 到目标 Node;写入 etcd
- 对应节点 kubelet 拿到 Pod 定义,调用 CRI 创建容器
调度约束:4 种
- nodeSelector:简单节点标签匹配;硬约束,Pod 只能跑带指定标签 node
- NodeAffinity 节点亲和性:更丰富节点亲和;硬要求 (requiredDuringSchedulingIgnoredDuringExecution)、软偏好 (preferredDuringSchedulingIgnoredDuringExecution)
- PodAffinity Pod 亲和:希望 Pod 和其他 Pod 调度到同一拓扑域(同一个节点 / 机房);业务尽量放一起
- PodAntiAffinity Pod 反亲和:希望同类 Pod 分散开,不要部署同一节点(高可用,副本打散不同 node)
Taint (污点) & Tolerations (容忍) ✨面试重点
Taint 打在Node 节点上;排斥 Pod;不让 Pod 随便调度上来;Toleration 写在 Pod 上,代表 Pod 可以容忍污点。
- effect 污点策略:
- NoSchedule:不能调度上来;已经在节点上的 Pod 不受影响
- PreferNoSchedule:尽量不要调度,软约束
- NoExecute:不仅不能调度;已经运行在此节点上不能容忍污点的 Pod 直接驱逐赶走!
典型场景:master 节点默认打污点,业务 Pod 默认不会调度到 master;特殊 Pod 加上容忍就可以跑 master。
区分记忆:亲和性是 Pod 选 Node;污点是 Node 拒绝 Pod。
十、K8S 网络模型(CNI)
K8S 网络四大假设(K8S 网络模型)
- 所有 Pod 之间不使用 NAT,可以直接互通
- 所有 Node 和所有 Pod 之间互通
- Pod 看到自己的 IP 就是其他 Pod 看到的 PodIP;无 NAT
- Service 的 IP 只有集群内部可访问
CNI Container Network Interface
CNI 是网络插件标准;集群必须部署 CNI 网络插件,Pod 才有网络。 主流插件:Calico(支持 NetworkPolicy 网络策略,bgp;生产首选)、Flannel(简单 overlay,性能弱一点,无网络策略)。
NetworkPolicy 网络策略
Pod 层面防火墙;控制 Pod 之间访问权限;需要 CNI 插件支持(Calico),flannel 不支持 NetworkPolicy;基于 Pod 标签、ns 标签管控 ingress/egress 进出流量。
注意:NetworkPolicy 是 Pod 防火墙,不是 Node 防火墙。
十一、K8S 安全
1. 认证、鉴权、准入控制(apiserver 三道关卡)
访问 apiserver 请求三层校验顺序:
- Authentication 认证:你是谁?账号密码、token、证书;serviceAccount
- Authorization 鉴权:你能干什么?RBAC 权限判断
- Admission Controller 准入控制:资源写入前拦截修改 / 校验(比如默认 storageclass、podsecurity)
RBAC 基于角色访问控制 ✨高频面试
核心资源:
- Role:命名空间内角色;权限是一组 api 操作
- ClusterRole:集群全局角色,跨 namespace(node/pv 全局资源)
- RoleBinding:把 Role 绑定给用户 /serviceAccount(本 ns 内)
- ClusterRoleBinding:ClusterRole 全局绑定用户
ServiceAccount (SA):Pod 内部访问 apiserver 使用的账号;每个 ns 自带 default sa;Pod 自动挂载 sa token 到容器内。
PodSecurityPolicy (废弃) → Pod Security Admission (PSA)
Pod 安全准入;限制 Pod 权限;禁止特权容器、禁止 hostPath 挂载、禁止以 root 运行容器。
Secret & ConfigMap 配置管理
- ConfigMap:存普通明文配置;环境变量或者挂载文件进 Pod;非敏感配置(nginx.conf,配置参数)
- Secret:存敏感数据(密码、token、证书);base64 编码⚠️不是加密!只是简单编码,需要 etcd 加密存储才安全 Secret 三种类型:Opaque 自定义;kubernetes.io/tls 证书;service‑account‑token。
两者更新之后:挂载文件形式 Pod 内自动刷新;环境变量形式 Pod不会自动刷新,必须重启 Pod
十二、K8S 运维与命令(kubectl 常用)
kubectl 原理
kubectl 是客户端工具;读取 kubeconfig 配置文件,拿到 apiserver 地址、证书访问集群。~/.kube/config
基础命令分类
#查看资源
kubectl get pods/deploy/svc/node -o wide
kubectl describe pod xxx #详细事件,排错最重要!
kubectl logs pod‑xxx [-c containerName] #查看容器日志
kubectl exec -it pod‑xxx -- /bin/sh #进入pod

#创建更新
kubectl apply -f xxx.yaml #声明式推荐
kubectl create -f xxx.yaml #命令式
kubectl edit deploy xxx #在线编辑资源yaml
kubectl rollout history deployment xxx #版本历史
kubectl rollout undo deployment xxx --to‑revision=2 #回滚版本
kubectl scale deployment nginx --replicas=5 #扩缩容

#污点标签
kubectl taint nodes node‑1 key=val:NoSchedule
kubectl label nodes node‑1 disk=ssd
声明式 apply vs 命令式 create/replace;生产优先 apply
排错通用思路
kubectl describe pod xxx看 Events 事件(优先!)kubectl logs pod‑name看业务日志- 确认镜像是否正确、拉取镜像是否报错(镜像私有仓库 secret)
- 探针配置是否错误;资源 Limit/Request 是否 OOM 被杀死
- node 资源是否充足;污点亲和调度问题
资源配额 ResourceQuota & LimitRange
- ResourceQuota:namespace 总资源配额;限制整个 ns 所有 Pod 总 CPU 内存数量
- LimitRange:设置 ns 内 Pod / 容器默认 request、limit;防止容器不写资源限制吃光节点资源
QoS 服务质量(Pod 的 QOS 等级)由 request 和 limit 决定
- Guaranteed:request=limit;最高优先级;节点内存压力最后被驱逐
- Burstable:request<limit;中间级别
- BestEffort:没有设置任何 request limit;最低优先级;内存压力最先被驱逐!
生产业务建议尽量设置 request+limit,拿到 Guaranteed 或者 Burstable;不要 BestEffort。
十三、K8S 进阶内容(面试拔高)
- HPA 水平 Pod 自动扩缩容 HorizontalPodAutoscaler 根据 CPU / 内存或者自定义 metrics 指标,自动增减 Deployment 副本数量;
注意:HPA 只水平扩 Pod 数量;不能垂直改变 Pod 本身 CPU 内存;VPA 垂直扩缩改 Pod 资源;需要 metrics‑server 采集指标。
-
Metrics‑server:集群指标采集组件;替代 heapster;提供 node/pod cpu 内存指标,给 HPA、kubectl top 使用。
kubectl top nodes
kubectl top pods -
K8S 版本升级:kubeadm upgrade;滚动升级控制平面再升级 node;先升级 kubelet。
-
etcd 备份还原:
etcdctl snapshot save定期快照备份,灾难恢复核心。 -
kubeadm 集群部署流程: 初始化 control‑plane
kubeadm init;输出 join 命令;worker 节点kubeadm join加入集群;之后手动部署 CNI 网络插件。
十四、常见面试坑点总结(易混淆)
- ❌Pod 可以直接调度;✅业务 Pod 尽量使用上层控制器管理
- ❌Namespace 做网络隔离;✅Namespace 只是逻辑隔离;网络隔离靠 NetworkPolicy
- ❌Secret 是加密;✅Secret 只是 base64 编码;etcd 开启加密才是真正加密
- ❌Service 会直接管理 Pod;✅Service 靠 selector 匹配,通过 Endpoints 关联 Pod
- ❌Ingress 本身可以代理;✅Ingress 只是规则,必须 ingress‑controller 实现七层代理
- ❌污点是打在 Pod;✅污点 Taint 在 Node;容忍 Tolerations 写 Pod
- ❌readiness 探针重启 Pod;✅readiness 只摘除后端端点;liveness 才重启容器
- ❌K8S 构建镜像;✅K8S 只运行镜像;镜像由 docker 构建