文章目录
- [AI infra 学习笔记(三):预处理·第一步------QKV 投影到底算了多少](#AI infra 学习笔记(三):预处理·第一步——QKV 投影到底算了多少)
-
- [0. 从注意力公式倒推回去](#0. 从注意力公式倒推回去)
- [1. 题目](#1. 题目)
- [2. 这些数字是哪来的?翻 `config.json`](#2. 这些数字是哪来的?翻
config.json) - [3. 投影到底怎么算](#3. 投影到底怎么算)
- [4. 交叉验证:去 `safetensors` 里看真实形状](#4. 交叉验证:去
safetensors里看真实形状) - [5. 动手算:参数量](#5. 动手算:参数量)
-
- [5.1 单层明细](#5.1 单层明细)
- [5.2 全模型](#5.2 全模型)
- [6. 顺手把计算量也算出来](#6. 顺手把计算量也算出来)
- [7. 几个值得记住的结论](#7. 几个值得记住的结论)
- 参考
AI infra 学习笔记(三):预处理·第一步------QKV 投影到底算了多少
0. 从注意力公式倒推回去
注意力的公式大家都背得出来:
Attention ( Q , K , V ) = softmax ( Q K T d k ) V \text{Attention}(Q,K,V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V Attention(Q,K,V)=softmax(dk QKT)V
但这里有个前置问题常被跳过:Q、K、V 本身是从哪来的?
答案很简单------它们都是同一个输入 Token 乘上三个不同的权重矩阵得到的 。这一步叫投影(Projection),是每个 Transformer 层里最先吃掉算力的地方。
先上一道题,一起实际看看!
1. 题目
在 Qwen3-8B 中,一个被输入进来的 Token 假设是
[1, 4096];其中查询(Q)和输出(O)投影的宽度是 4096 ,键(K)和值(V)的宽度是 1024 ,FFN 中间维度是 12288。求四个注意力投影 + 三个 FFN 矩阵的参数量。
2. 这些数字是哪来的?翻 config.json
上面的 4096 / 1024 / 12288 是在 config.json 里实际写到的。
json
{
  "hidden_size": 4096,
  "head_dim": 128,
  "num_attention_heads": 32,
  "num_key_value_heads": 8,
  "intermediate_size": 12288,
  "num_hidden_layers": 36,
  "vocab_size": 151936,
  "torch_dtype": "bfloat16",
  "tie_word_embeddings": false
}
其中一些字段的意义是:
| config.json 字段 | 值 | 对应概念 |
|---|---|---|
hidden_size |
4096 | 隐状态维度:所有投影的输入 宽度,也是 Q、O 投影的输出宽度 |
num_attention_heads |
32 | Q 的头数 |
num_key_value_heads |
8 | K、V 的头数(GQA 分组查询,所以 K/V 比 Q 窄) |
head_dim |
128 | 每个注意力头的维度 |
intermediate_size |
12288 | FFN 中间维度(gate / up 的输出宽度) |
num_hidden_layers |
36 | 层数 |
于是可以直接推出三个关键宽度:
| 宽度 | 计算 | 结果 |
|---|---|---|
| Q 的宽度 | num_attention_heads × head_dim = 32 × 128 |
4096 |
| K、V 的宽度 | num_key_value_heads × head_dim = 8 × 128 |
1024 |
| Token 的维度 | hidden_size |
4096 |
⚠️ 关于 GQA :因为
num_key_value_heads (8) < num_attention_heads (32),每 4 个 Q 头共享 1 组 K/V 头。这就是 K、V 投影比 Q 窄 4 倍的原因,也是显存能省下来的关键。如果 K/V 头数等于 32(标准 MHA),K、V 宽度就会是 4096 而不是 1024。
3. 投影到底怎么算
输入 Token 记作 x x x([1, 4096],1 个 token、4096 维),它分别和三个权重矩阵相乘:
Q = x W q , K = x W k , V = x W v Q = xW_q,\quad K = xW_k,\quad V = xW_v Q=xWq,K=xWk,V=xWv
由矩阵乘法的维度规则([1, in] × [in, out] = [1, out])可以反推每个权重矩阵的形状:
| 矩阵 | 形状 [in, out] |
输出维度 | 推导 |
|---|---|---|---|
| W q W_q Wq | [4096, 4096] |
Q = [1, 4096] |
[1,4096] × [4096,4096] = [1,4096] |
| W k W_k Wk | [4096, 1024] |
K = [1, 1024] |
[1,4096] × [4096,1024] = [1,1024] |
| W v W_v Wv | [4096, 1024] |
V = [1, 1024] |
[1,4096] × [4096,1024] = [1,1024] |
注意力算完之后,多头输出拼回 4096 维,还要再过一个输出投影 W o W_o Wo 才能回到残差流:
| 矩阵 | 形状 [in, out] |
说明 |
|---|---|---|
| W o W_o Wo | [4096, 4096] |
把拼接后的多头输出投回 hidden_size |
FFN 部分(Qwen3 用的是 SwiGLU 结构)有三个矩阵:
| 矩阵 | 形状 [in, out] |
作用 |
|---|---|---|
gate_proj |
[4096, 12288] |
门控分支,过 SiLU 激活 |
up_proj |
[4096, 12288] |
升维分支 |
down_proj |
[12288, 4096] |
降维回 hidden_size |
SwiGLU 的计算是 down ( SiLU ( x W g a t e ) ⊙ x W u p ) \text{down}\big(\text{SiLU}(xW_{gate}) \odot xW_{up}\big) down(SiLU(xWgate)⊙xWup),所以是"两升一降"三个矩阵,而不是经典 FFN 的两个。
4. 交叉验证:去 safetensors 里看真实形状
光靠 config 推导还不够放心,可以直接去权重文件里核对。
模型仓库里有一份 model.safetensors.index.json,它记录了每一层的每一个权重存在哪个分片文件里:
https://www.modelscope.cn/models/Qwen/Qwen3-8B/file/view/master/model.safetensors.index.json
内容大致长这样:
json
"model.layers.13.input_layernorm.weight": "model-00002-of-00005.safetensors",
"model.layers.13.mlp.down_proj.weight": "model-00002-of-00005.safetensors",
"model.layers.13.mlp.gate_proj.weight": "model-00002-of-00005.safetensors",
"model.layers.13.mlp.up_proj.weight": "model-00002-of-00005.safetensors",
"model.layers.13.post_attention_layernorm.weight": "model-00002-of-00005.safetensors",
"model.layers.13.self_attn.k_norm.weight": "model-00002-of-00005.safetensors",
"model.layers.13.self_attn.k_proj.weight": "model-00002-of-00005.safetensors",
"model.layers.13.self_attn.o_proj.weight": "model-00002-of-00005.safetensors",
"model.layers.13.self_attn.q_norm.weight": "model-00002-of-00005.safetensors",
"model.layers.13.self_attn.q_proj.weight": "model-00002-of-00005.safetensors",
"model.layers.13.self_attn.v_proj.weight": "model-00002-of-00005.safetensors",
"model.layers.14.input_layernorm.weight": "model-00002-of-00005.safetensors"
每一层的 k_proj / v_proj / q_proj / o_proj 以及 FFN 的三个矩阵,都能查到归属。想看第 13 层的 Q 权重具体维度,直接点开 model-00002-of-00005.safetensors:
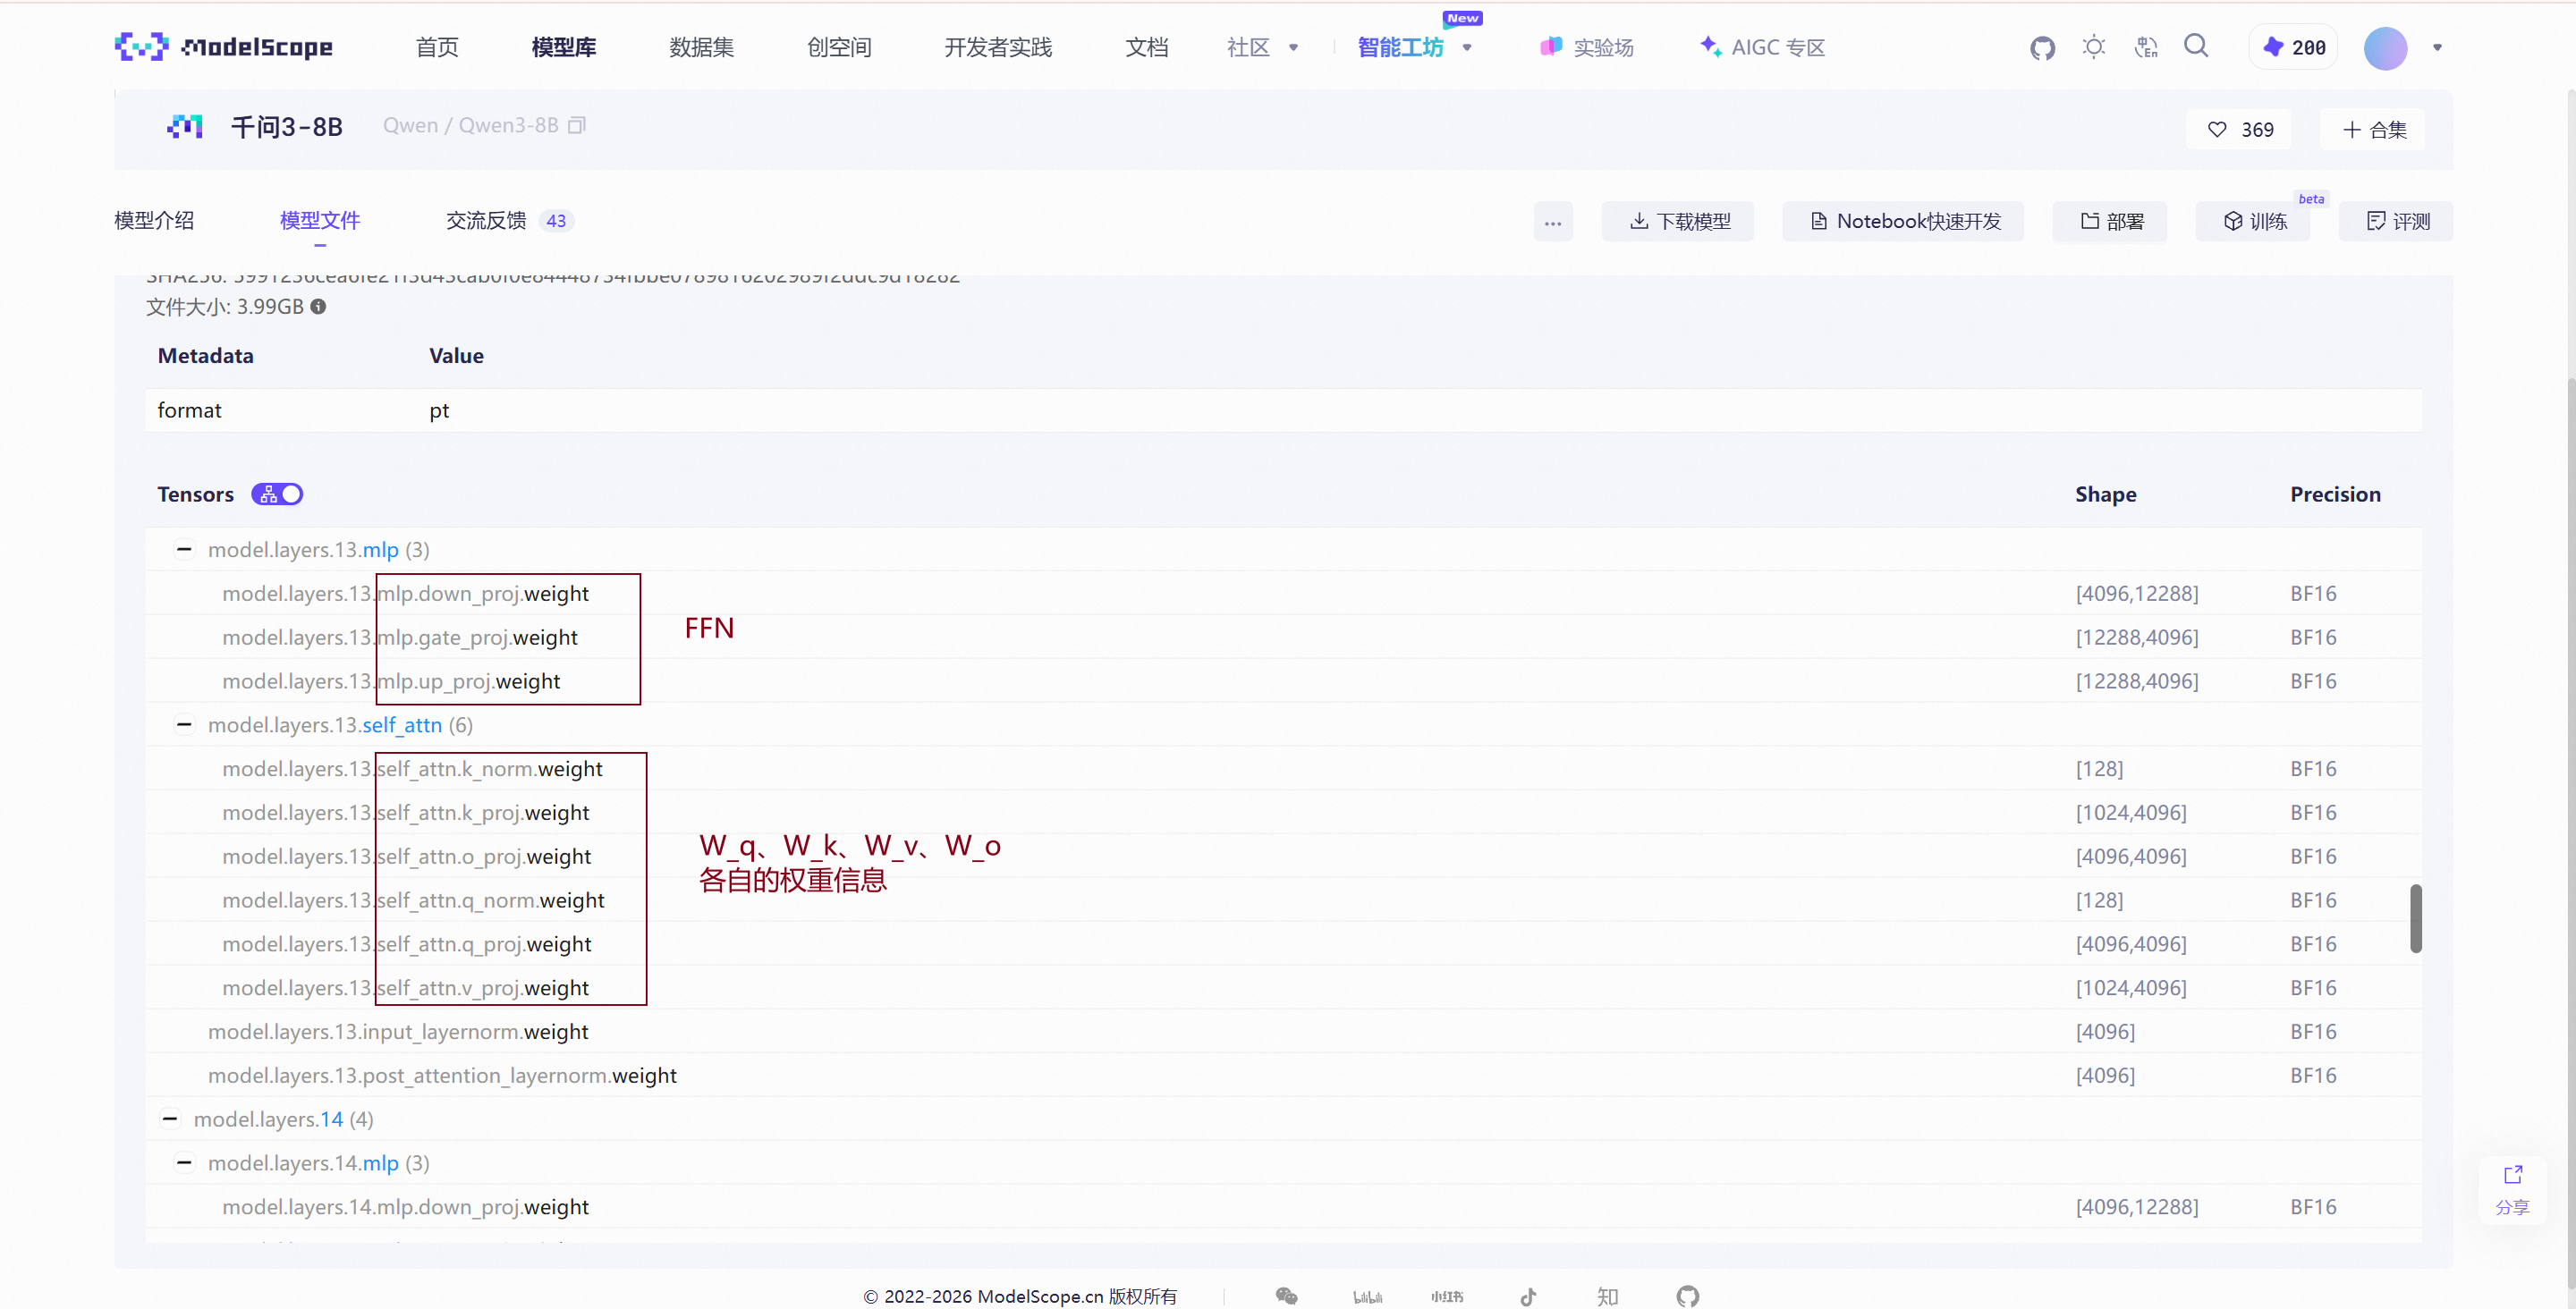
💡 一个容易踩的坑 :HuggingFace / safetensors 里存储的
nn.Linear权重形状是[out_features, in_features],也就是上面表格的转置。所以你在文件里看到的是:
权重 文件中的形状 与本文记法 q_proj.weight[4096, 4096]对称,一致 k_proj.weight[1024, 4096]W k T W_k^T WkT v_proj.weight[1024, 4096]W v T W_v^T WvT o_proj.weight[4096, 4096]对称,一致 gate_proj.weight[12288, 4096]W g a t e T W_{gate}^T WgateT up_proj.weight[12288, 4096]W u p T W_{up}^T WupT down_proj.weight[4096, 12288]W d o w n T W_{down}^T WdownT 参数量是完全一样的(转置不改变元素个数),只是行、列含义对调了。看形状时别被绕晕。
5. 动手算:参数量
关键前提:向量与矩阵的点积,每个元素是"一次乘 + 一次加",即 2 次浮点运算(FLOPs)。
先算参数量。一个 [in, out] 的权重矩阵,参数量就是 in × out。
5.1 单层明细
| 模块 | 矩阵 | 形状 | 参数量 |
|---|---|---|---|
| Attention | q_proj |
4096 × 4096 | 16,777,216 |
| Attention | k_proj |
4096 × 1024 | 4,194,304 |
| Attention | v_proj |
4096 × 1024 | 4,194,304 |
| Attention | o_proj |
4096 × 4096 | 16,777,216 |
| 注意力小计 | 41,943,040 | ||
| FFN | gate_proj |
4096 × 12288 | 50,331,648 |
| FFN | up_proj |
4096 × 12288 | 50,331,648 |
| FFN | down_proj |
12288 × 4096 | 50,331,648 |
| FFN 小计 | 150,994,944 | ||
| 单层合计 | 192,937,984 |
即 单层约 1.93 × 10⁸ ≈ 193 M 参数。
5.2 全模型
Qwen3-8B 共 36 层:
192,937,984 × 36 = 6,945,767,424 ≈ 6.95 × 10 9 192{,}937{,}984 \times 36 = 6{,}945{,}767{,}424 \approx 6.95 \times 10^9 192,937,984×36=6,945,767,424≈6.95×10⁹
这 7 个矩阵合计约 6.95 B 参数,占了模型的绝大部分。再算上词嵌入矩阵:
151,936 × 4,096 = 622,329,856 ≈ 0.62 B 151{,}936 \times 4{,}096 = 622{,}329{,}856 \approx 0.62\text{ B} 151,936×4,096=622,329,856≈0.62 B
加上各层 RMSNorm 的小参数,总量落在 7.6 B 左右,与"8B"这个名义规模吻合。
6. 顺手把计算量也算出来
FLOPs = 2 × 参数量 \text{FLOPs} = 2 \times \text{参数量} FLOPs=2×参数量
因为每个权重元素都要参与一次乘加。
单 token、单层:
2 × 192,937,984 = 385,875,968 ≈ 3.86 × 10 8 FLOPs 2 \times 192{,}937{,}984 = 385{,}875{,}968 \approx 3.86 \times 10^8 \text{ FLOPs} 2×192,937,984=385,875,968≈3.86×10⁸ FLOPs
单 token、全模型(36 层)投影部分:
2 × 6,945,767,424 = 13,891,534,848 ≈ 13.9 GFLOPs 2 \times 6{,}945{,}767{,}424 = 13{,}891{,}534{,}848 \approx 13.9 \text{ GFLOPs} 2×6,945,767,424=13,891,534,848≈13.9 GFLOPs
写成原始式子就是:
2 \\times \\underbrace{(4096{\\times}4096 + 4096{\\times}1024 + 4096{\\times}1024 + 4096{\\times}4096)}_{\\text{QKV + O 投影}} * 2 \\times \\underbrace{3 \\times (4096{\\times}12288)}_{\\text{FFN 三个矩阵}}
Prefill 场景 :如果一次喂进 S S S 个 token,投影部分的计算量是 13.9 × S 13.9 \times S 13.9×S GFLOPs(矩阵乘可以批量做,近似线性放大)。
7. 几个值得记住的结论
-
FFN 比注意力贵得多 。单层里 FFN 占 150.99 M,注意力占 41.94 M ------ FFN 是注意力的 3.6 倍。很多人以为 Transformer 的算力都在注意力上,其实在中小序列长度下,投影 + FFN 才是大头。
-
GQA 省的是 K/V 投影 。如果换成 MHA(
num_key_value_heads = 32),K、V 宽度会从 1024 涨到 4096,注意力部分参数会从 41.94 M 涨到 100.66 M。这还没算 KV Cache 的显存节省------那才是 GQA 真正的大头。 -
2 × 参数量这个经验法则很好用。推理时估算算力,直接把参数量乘 2 就是每 token 的 FLOPs(不含注意力分数部分)。 -
注意力的分数计算被省略了 。本文只算投影和 FFN。加上 Q K T QK^T QKT 和 A V AV AV 后,每个 token 每层还要额外约 4 × 4096 × L 4 \times 4096 \times L 4×4096×L 次浮点运算( L L L 是序列长度)。在 L = 4096 L=4096 L=4096 时约 67 M,仍小于投影部分的 386 M------但序列一长,这一项就会反超。这也是长上下文推理变慢的根源。
参考
- Qwen3-8B 模型文件:https://www.modelscope.cn/models/Qwen/Qwen3-8B/files
- 权重索引文件:
model.safetensors.index.json - 模型配置:
config.json