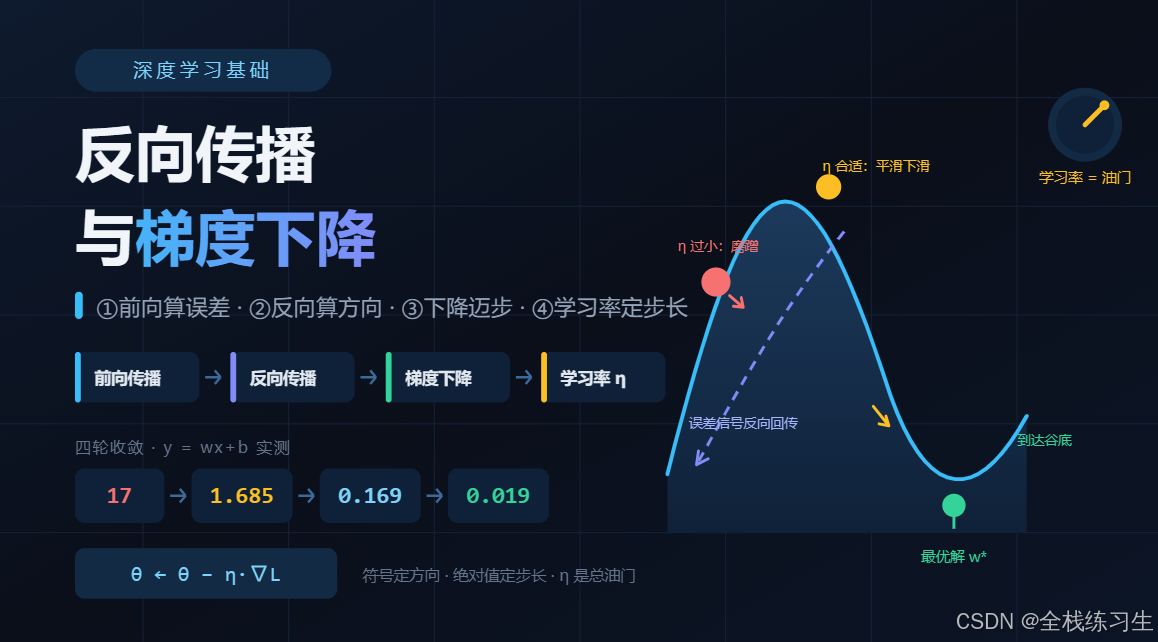
摘要
神经网络训练是一条"四步一循环"的流水线:前向传播算出预测与损失,反向传播用链式法则算清每个参数的梯度,梯度下降沿负梯度方向更新参数,学习率作为唯一人工旋钮缩放每步步长。本文严格按这条流水线组织:先给出总览与各环节职责边界,再逐步展开原理与数值推演------以最小模型 y=wx+b 完整走完损失 17 → 1.685 → 0.169 → 0.019 的四轮收敛;随后系统讨论学习率设置:症状诊断、LR Range Test 初值定位、Warmup+余弦退火调度、与优化器和批次大小的联动,并基于 L(w)=w² 的解析解给出 η 过小、合适、偏大、临界、过大五种行为的数学刻画,以及梯度裁剪、Warmup 两道工程防线;最后澄清概念与调参误区。Rumelhart 等的反向传播奠基工作与 Goyal 等的线性缩放规则验证了核心结论。
关键词:前向传播;反向传播;梯度下降;学习率;链式法则;学习率调度
一、问题背景
1.1 训练神经网络的两个问题
训练神经网络要回答两个问题:
- 方向怎么算:网络有上亿个参数,每个参数对最终误差的"责任"如何高效计算?
- 参数怎么更新:知道了方向,往哪迈、迈多大步?
前者的答案是反向传播,后者的答案是梯度下降;再配上"从哪出发算误差"的前向传播和"步子多大"的学习率,就构成一条完整流水线。本章先给对比与直觉,第二章给出流水线总览,第三至六章逐步拆解每一步。
1.2 分工对比
| 维度 | 梯度下降 | 反向传播 |
|---|---|---|
| 本质 | 参数更新的优化算法 | 高效计算梯度的方法 |
| 解决的问题 | 知道了方向,往哪迈、迈多大 | 方向怎么算出来 |
| 核心思想 | 沿损失下降最快的方向(负梯度)走一小步 | 利用链式法则,从输出层反向逐层推导每个参数的梯度 |
| 数学基础 | 多元函数沿负梯度方向下降最快 | 微积分链式法则 |
| 关键公式 | θ ← θ − η ⋅ ∇ θ L \theta \leftarrow \theta - \eta \cdot \nabla_\theta L θ←θ−η⋅∇θL | 每层梯度 = 后一层梯度 × 当前层局部导数,逐层递推 |
1.3 两个比喻
- 下山:蒙眼下山走到谷底(损失最小)。梯度下降回答"怎么走"------感受最陡下坡方向迈一小步;步子太大(η 过高)跨过谷底来回震荡,太小(η 过低)半天挪不动。反向传播回答"坡度怎么算"------上万维地形中每条边坡度都不同,从山顶(损失)出发借链式法则把误差信号一层层往回传,算出每个参数对错误的"责任"。
- 做题:学生做完题猜答案(前向传播),老师批改指出差距(计算损失),老师追问"错在审题还是计算"(反向传播分配责任),学生按追责结果调整认知(梯度下降更新参数)。
二、完整流水线总览
2.1 四步一循环
一次参数训练由三个执行环节加一个人工旋钮构成,循环直到损失收敛:
#mermaid-svg-YQ8QX8SO2j8qzG1D{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-YQ8QX8SO2j8qzG1D .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-YQ8QX8SO2j8qzG1D .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-YQ8QX8SO2j8qzG1D .error-icon{fill:#552222;}#mermaid-svg-YQ8QX8SO2j8qzG1D .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-YQ8QX8SO2j8qzG1D .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-YQ8QX8SO2j8qzG1D .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-YQ8QX8SO2j8qzG1D .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-YQ8QX8SO2j8qzG1D .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-YQ8QX8SO2j8qzG1D .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-YQ8QX8SO2j8qzG1D .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-YQ8QX8SO2j8qzG1D .marker{fill:#333333;stroke:#333333;}#mermaid-svg-YQ8QX8SO2j8qzG1D .marker.cross{stroke:#333333;}#mermaid-svg-YQ8QX8SO2j8qzG1D svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-YQ8QX8SO2j8qzG1D p{margin:0;}#mermaid-svg-YQ8QX8SO2j8qzG1D .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-YQ8QX8SO2j8qzG1D .cluster-label text{fill:#333;}#mermaid-svg-YQ8QX8SO2j8qzG1D .cluster-label span{color:#333;}#mermaid-svg-YQ8QX8SO2j8qzG1D .cluster-label span p{background-color:transparent;}#mermaid-svg-YQ8QX8SO2j8qzG1D .label text,#mermaid-svg-YQ8QX8SO2j8qzG1D span{fill:#333;color:#333;}#mermaid-svg-YQ8QX8SO2j8qzG1D .node rect,#mermaid-svg-YQ8QX8SO2j8qzG1D .node circle,#mermaid-svg-YQ8QX8SO2j8qzG1D .node ellipse,#mermaid-svg-YQ8QX8SO2j8qzG1D .node polygon,#mermaid-svg-YQ8QX8SO2j8qzG1D .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-YQ8QX8SO2j8qzG1D .rough-node .label text,#mermaid-svg-YQ8QX8SO2j8qzG1D .node .label text,#mermaid-svg-YQ8QX8SO2j8qzG1D .image-shape .label,#mermaid-svg-YQ8QX8SO2j8qzG1D .icon-shape .label{text-anchor:middle;}#mermaid-svg-YQ8QX8SO2j8qzG1D .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-YQ8QX8SO2j8qzG1D .rough-node .label,#mermaid-svg-YQ8QX8SO2j8qzG1D .node .label,#mermaid-svg-YQ8QX8SO2j8qzG1D .image-shape .label,#mermaid-svg-YQ8QX8SO2j8qzG1D .icon-shape .label{text-align:center;}#mermaid-svg-YQ8QX8SO2j8qzG1D .node.clickable{cursor:pointer;}#mermaid-svg-YQ8QX8SO2j8qzG1D .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-YQ8QX8SO2j8qzG1D .arrowheadPath{fill:#333333;}#mermaid-svg-YQ8QX8SO2j8qzG1D .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-YQ8QX8SO2j8qzG1D .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-YQ8QX8SO2j8qzG1D .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-YQ8QX8SO2j8qzG1D .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-YQ8QX8SO2j8qzG1D .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-YQ8QX8SO2j8qzG1D .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-YQ8QX8SO2j8qzG1D .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-YQ8QX8SO2j8qzG1D .cluster text{fill:#333;}#mermaid-svg-YQ8QX8SO2j8qzG1D .cluster span{color:#333;}#mermaid-svg-YQ8QX8SO2j8qzG1D div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-YQ8QX8SO2j8qzG1D .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-YQ8QX8SO2j8qzG1D rect.text{fill:none;stroke-width:0;}#mermaid-svg-YQ8QX8SO2j8qzG1D .icon-shape,#mermaid-svg-YQ8QX8SO2j8qzG1D .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-YQ8QX8SO2j8qzG1D .icon-shape p,#mermaid-svg-YQ8QX8SO2j8qzG1D .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-YQ8QX8SO2j8qzG1D .icon-shape .label rect,#mermaid-svg-YQ8QX8SO2j8qzG1D .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-YQ8QX8SO2j8qzG1D .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-YQ8QX8SO2j8qzG1D .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-YQ8QX8SO2j8qzG1D :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 未收敛,回到下一轮
步长缩放
损失收敛
① 前向传播
输入→预测→损失 L
职责:算误差
② 反向传播
链式法则倒推
职责:算每个参数的梯度
③ 梯度下降
θ ← θ − η·∇L
职责:更新参数
学习率 η
人工旋钮:总油门
训练完成
图 1 前向传播→反向传播→梯度下降的训练闭环与学习率的角色
各环节的职责边界:
| 环节 | 职责 | 产出 | 不负责 |
|---|---|---|---|
| ① 前向传播 | 算误差 | 一个数:损失 L L L("有多错") | 不知道错在谁身上 |
| ② 反向传播 | 算清每个参数的责任 | 梯度 ∇ L \nabla L ∇L:方向 + 陡峭度("错在谁、往哪调") | 只算不改,不更新任何参数 |
| ③ 梯度下降 | 执行更新,减号消费梯度符号 | 新的一组参数 | 自己不会算导数 |
| η 学习率 | 缩放每步步长 | 人工定的总油门 | 不改变方向 |
一句话分工:①算误差 ②算方向 ③迈步 ④η 定步长。四步串起来的数值效果(第三至五章逐步推演):损失 17 → 1.685 → 0.169 → 0.019,4 轮即逼近真实解。
2.2 术语与收敛判据
图 1 的闭环每完整跑一遍训练集称为一个 epoch。相关术语约定:
| 术语 | 含义 |
|---|---|
| iteration(step) | 一次前向 + 反向 + 更新 |
| epoch | 完整过一遍全部训练数据 |
| batch | 一次更新所用的样本数(决定梯度是全量还是小批量估计) |
停止条件通常是:验证集指标连续多轮不再下降(早停),或达到预设 epoch 数。这条流水线只有两个决策点需要人工干预------"何时降速"由学习率调度器回答(6.3 节),"何时停车"由早停回答;其余全部自动执行。
三、第一步:前向传播------算误差
3.1 从输入到预测
前向传播指数据从输入流向输出的计算过程:每一层对输入做加权求和并通过非线性激活函数变换,逐层传递,直到产出预测值 y ^ \hat{y} y^。单层模型 y ^ = w x + b \hat{y} = wx + b y^=wx+b 只有一段计算;深度网络只是把这条链拉长------每多一层就多一次"加权 + 激活"。前向过程不涉及任何参数更新,它的唯一使命是把误差量化。
3.2 损失函数:把误差变成一个数
预测值与真实标签代入损失函数得到标量 L L L。回归常用均方误差,分类常用交叉熵。本文统一用均方误差:
L = 1 n ∑ i = 1 n ( y ^ i − y i ) 2 L = \frac{1}{n}\sum_{i=1}^{n}(\hat{y}_i - y_i)^2 L=n1i=1∑n(y^i−yi)2
损失只回答"现在有多错",不回答"错在谁身上"------后者是下一步反向传播的任务。
3.3 y=wx+b:算出 L = 17
设定:数据 ( x 1 = 1 , y 1 = 3 ) (x_1{=}1, y_1{=}3) (x1=1,y1=3)、 ( x 2 = 2 , y 2 = 5 ) (x_2{=}2, y_2{=}5) (x2=2,y2=5),真实规律 y = 2 x + 1 y = 2x + 1 y=2x+1(最优解 w ∗ = 2 , b ∗ = 1 w^*=2, b^*=1 w∗=2,b∗=1,模型不知道);初始 w = 0 , b = 0 w = 0, b = 0 w=0,b=0, n = 2 n=2 n=2。代入计算:
ŷ₁ = 0×1 + 0 = 0      误差 e₁ = 0 − 3 = −3
ŷ₂ = 0×2 + 0 = 0      误差 e₂ = 0 − 5 = −5
L = (e₁² + e₂²)/2 = (9 + 25)/2 = 17
前向传播完成:一个数 17 概括了当前的全部错误。
四、第二步:反向传播------算方向
4.1 链式法则
对上亿个参数暴力求导计算量会爆炸。反向传播的妙处在于复用中间结果:利用链式法则
d y d x = d y d z ⋅ d z d x \frac{dy}{dx} = \frac{dy}{dz} \cdot \frac{dz}{dx} dxdy=dzdy⋅dxdz
从输出层的损失开始,把梯度信号一层层往回传,每层梯度都由"后一层的梯度 × 当前层的局部导数"递推得到,每层只需做一次局部计算,不必从零求导。
4.2 两层网络示例
输入 x x x 经过 W 1 W_1 W1、 b 1 b_1 b1 和激活函数得到隐藏层 h h h,再经过 W 2 W_2 W2、 b 2 b_2 b2 得到预测 y ^ \hat{y} y^。反向传播时,先算损失对输出层参数 W 2 W_2 W2 的梯度,再把这个梯度传回去乘上中间量,算出 W 1 W_1 W1 的梯度。
反向传播最早由 Rumelhart、Hinton 和 Williams 系统提出 1,是深度学习得以实用的奠基算法。
4.3 "反向"的含义
数据从输入流向输出叫前向传播 ;误差信号从输出流回输入叫反向传播------"反向"指的就是梯度传播方向与数据流方向相反。深度网络只是把这条链拉长,每个参数的更新公式一模一样:
θ ← θ − η ⋅ ∂ L ∂ θ \theta \leftarrow \theta - \eta \cdot \frac{\partial L}{\partial \theta} θ←θ−η⋅∂θ∂L
4.4 y=wx+b:算出梯度 −13 / −8
L L L 到 w w w 之间隔着一层 y ^ \hat{y} y^,需拆成两段相乘:
#mermaid-svg-w7Cu78VeuCFLMq84{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-w7Cu78VeuCFLMq84 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-w7Cu78VeuCFLMq84 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-w7Cu78VeuCFLMq84 .error-icon{fill:#552222;}#mermaid-svg-w7Cu78VeuCFLMq84 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-w7Cu78VeuCFLMq84 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-w7Cu78VeuCFLMq84 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-w7Cu78VeuCFLMq84 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-w7Cu78VeuCFLMq84 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-w7Cu78VeuCFLMq84 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-w7Cu78VeuCFLMq84 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-w7Cu78VeuCFLMq84 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-w7Cu78VeuCFLMq84 .marker.cross{stroke:#333333;}#mermaid-svg-w7Cu78VeuCFLMq84 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-w7Cu78VeuCFLMq84 p{margin:0;}#mermaid-svg-w7Cu78VeuCFLMq84 .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-w7Cu78VeuCFLMq84 .cluster-label text{fill:#333;}#mermaid-svg-w7Cu78VeuCFLMq84 .cluster-label span{color:#333;}#mermaid-svg-w7Cu78VeuCFLMq84 .cluster-label span p{background-color:transparent;}#mermaid-svg-w7Cu78VeuCFLMq84 .label text,#mermaid-svg-w7Cu78VeuCFLMq84 span{fill:#333;color:#333;}#mermaid-svg-w7Cu78VeuCFLMq84 .node rect,#mermaid-svg-w7Cu78VeuCFLMq84 .node circle,#mermaid-svg-w7Cu78VeuCFLMq84 .node ellipse,#mermaid-svg-w7Cu78VeuCFLMq84 .node polygon,#mermaid-svg-w7Cu78VeuCFLMq84 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-w7Cu78VeuCFLMq84 .rough-node .label text,#mermaid-svg-w7Cu78VeuCFLMq84 .node .label text,#mermaid-svg-w7Cu78VeuCFLMq84 .image-shape .label,#mermaid-svg-w7Cu78VeuCFLMq84 .icon-shape .label{text-anchor:middle;}#mermaid-svg-w7Cu78VeuCFLMq84 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-w7Cu78VeuCFLMq84 .rough-node .label,#mermaid-svg-w7Cu78VeuCFLMq84 .node .label,#mermaid-svg-w7Cu78VeuCFLMq84 .image-shape .label,#mermaid-svg-w7Cu78VeuCFLMq84 .icon-shape .label{text-align:center;}#mermaid-svg-w7Cu78VeuCFLMq84 .node.clickable{cursor:pointer;}#mermaid-svg-w7Cu78VeuCFLMq84 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-w7Cu78VeuCFLMq84 .arrowheadPath{fill:#333333;}#mermaid-svg-w7Cu78VeuCFLMq84 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-w7Cu78VeuCFLMq84 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-w7Cu78VeuCFLMq84 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-w7Cu78VeuCFLMq84 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-w7Cu78VeuCFLMq84 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-w7Cu78VeuCFLMq84 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-w7Cu78VeuCFLMq84 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-w7Cu78VeuCFLMq84 .cluster text{fill:#333;}#mermaid-svg-w7Cu78VeuCFLMq84 .cluster span{color:#333;}#mermaid-svg-w7Cu78VeuCFLMq84 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-w7Cu78VeuCFLMq84 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-w7Cu78VeuCFLMq84 rect.text{fill:none;stroke-width:0;}#mermaid-svg-w7Cu78VeuCFLMq84 .icon-shape,#mermaid-svg-w7Cu78VeuCFLMq84 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-w7Cu78VeuCFLMq84 .icon-shape p,#mermaid-svg-w7Cu78VeuCFLMq84 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-w7Cu78VeuCFLMq84 .icon-shape .label rect,#mermaid-svg-w7Cu78VeuCFLMq84 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-w7Cu78VeuCFLMq84 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-w7Cu78VeuCFLMq84 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-w7Cu78VeuCFLMq84 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 反向
局部导数 2e/n
局部导数 x 或 1
1
x
×
w
+
b
²
损失 L
图 2 y=wx+b 的链式求导路径
- 外层导数 : ∂ L ∂ y ^ = 2 ( y ^ − y ) n \frac{\partial L}{\partial \hat{y}} = \frac{2(\hat{y}-y)}{n} ∂y^∂L=n2(y^−y)------误差贡献了多少损失
- 内层导数 : ∂ y ^ ∂ w = x \frac{\partial \hat{y}}{\partial w} = x ∂w∂y^=x------这条边对 w w w 多敏感(对 b b b 求导为 1)
多样本求平均得通用公式:
∂L/∂w = (2/n)·Σ eᵢ·xᵢ = (−3)(1) + (−5)(2) = −13
∂L/∂b = (2/n)·Σ eᵢ     = (−3) + (−5)      = −8
直觉验证 :误差为负(预测太低),梯度也为负------说明 w w w、 b b b 偏小,应该调大。
五、第三步:梯度下降------迈步
5.1 更新公式与减号的意义
损失函数 L ( θ ) L(\theta) L(θ) 是关于所有参数的多元函数,梯度 ∇ θ L \nabla_\theta L ∇θL 由各偏导数组成,指向损失上升最快的方向。想降低损失,就往梯度的反方向走:
θ t + 1 = θ t − η ⋅ ∇ θ L ( θ t ) \theta_{t+1} = \theta_t - \eta \cdot \nabla_\theta L(\theta_t) θt+1=θt−η⋅∇θL(θt)
减号的意义:梯度指向损失上升最快的方向(上坡),减去它就等于走下降最快的方向(下坡)。这半句就是"该往哪走"的全部答案。
最简单的例子:损失 L = w 2 L = w^2 L=w2,梯度 d L d w = 2 w \frac{dL}{dw} = 2w dwdL=2w,取 η = 0.1 \eta = 0.1 η=0.1,初始 w = 3 w = 3 w=3,梯度为 6,更新后 w = 3 − 0.1 × 6 = 2.4 w = 3 - 0.1 \times 6 = 2.4 w=3−0.1×6=2.4,损失变小;反复迭代, w w w 逐渐逼近最优值 0。
回到 y=wx+b,把 4.4 的梯度代入更新:
w_new = w_old − η·(∂L/∂w) = 0 − 0.1×(−13) = 1.3
b_new = b_old − η·(∂L/∂b) = 0 − 0.1×(−8)  = 0.8
5.2 方向与步长的两个机制
| 问题 | 答案 | 由谁决定 |
|---|---|---|
| 往哪走 | 负梯度方向 (13, 8),即同时增大 w w w 和 b b b | 梯度符号,公式自动消费 |
| 走多大 | 步长 = η × \eta \times η× 梯度大小 | η \eta η 手动定,梯度大小自动变 |
在数轴上看方向(以 L = w 2 L=w^2 L=w2 为例,谷底在 w ∗ = 0 w^*=0 w∗=0):
- 梯度为正 (右侧是上坡)→ 减去正数 → w w w 变小 → 向左走下坡 ✓
- 梯度为负 (右侧是下坡)→ 减去负数 → w w w 变大 → 向右走下坡 ✓
正负号定方向,绝对值定步长:减号自动消费了符号,公式写好后方向无需人工判断;但方向确实由符号决定,两者缺一不可。
5.3 迭代收敛与最小实现
每轮都完整重复"①前向 → ②反向 → ③更新":
| 轮次 | w | b | 误差 e₁, e₂ | 损失 L | 梯度 (∂L/∂w, ∂L/∂b) |
|---|---|---|---|---|---|
| 初始 | 0 | 0 | −3, −5 | 17 | (−13, −8) |
| 1 | 1.30 | 0.80 | −0.9, −1.6 | 1.685 | (−4.1, −2.5) |
| 2 | 1.71 | 1.05 | −0.24, −0.53 | 0.169 | (−1.3, −0.77) |
| 3 | 1.84 | 1.13 | −0.03, −0.19 | 0.019 | (−0.42, −0.23) |
三个现象值得注意:
- 损失指数下降:17 → 1.69 → 0.17 → 0.019,每轮约降一个数量级;
- 步子自动变小 :梯度绝对值 13 → 4.1 → 1.3 → 0.42。误差 e i e_i ei 越接近 0,梯度 ∝ e i \propto e_i ∝ei 也随之缩小------越接近答案走得越谨慎,这是天然刹车,无需手动减速;
- 方向始终正确 :预测一直偏低,参数就一路增大,最终逼近真实值 ( 2 , 1 ) (2, 1) (2,1)。
最小实现示例如下:
python
import numpy as np

X = np.array([1.0, 2.0])
y = np.array([3.0, 5.0])
w, b, lr = 0.0, 0.0, 0.1

for step in range(4):
    y_hat = w * X + b                      # 前向传播:算预测
    loss = np.mean((y_hat - y) ** 2)       # 计算损失
    e = y_hat - y
    dw = np.mean(2 * e * X)                # 反向传播:链式求导
    db = np.mean(2 * e)
    w -= lr * dw                           # 梯度下降:减法更新
    b -= lr * db
    print(f"step {step}: loss={loss:.3f}, dw={dw:.2f}, db={db:.2f}")
# step 0: loss=17.000, dw=-13.00, db=-8.00
# step 1: loss=1.685,  dw=-4.10,  db=-2.50
# step 2: loss=0.169,  dw=-1.30,  db=-0.77
# step 3: loss=0.019,  dw=-0.42,  db=-0.23
5.4 三种变体
| 变体 | 每次更新使用的数据 | 特点 |
|---|---|---|
| 批量梯度下降(BGD) | 全部数据 | 稳定但慢,内存开销大 |
| 随机梯度下降(SGD) | 单条样本 | 快但噪声大,震荡剧烈 |
| 小批量梯度下降(Mini-Batch) | 小批量(常用 32/64/128) | 速度与稳定性平衡,深度学习工业标准 |
六、第四步:设置学习率
前三步全自动执行,流水线上唯一需要人工设定的量就是学习率 η \eta η。它不改变方向,只缩放每步的大小:太小磨蹭,太大爆炸。本章回答三件事------怎么找初值 、怎么动态管全程 、极端值为什么危险。
6.1 症状诊断与起点值
| 现象 | 学习率过大 | 学习率过小 |
|---|---|---|
| 损失曲线 | 剧烈震荡、忽高忽低,甚至 NaN/发散 | 下降极慢,几乎一条平线 |
| 训练表现 | 无法收敛,损失可能突然爆炸 | 训练久但收益递减,可能卡在次优解 |
| 直观比喻 | 下山步子太大,跨过谷底来回蹦 | 步子太碎,走到天黑还在半山腰 |
经验起点值:
- SGD:0.01~0.1
- Adam / AdamW:1e-3(3e-4 也是稳妥起点)
- 微调预训练大模型:1e-5~5e-5(BERT 类常用 2e-5)
这些只是起点,实际要靠实验定位。
6.2 LR Range Test:找初值
由 Leslie Smith 提出,也是 fastai 等框架的标配功能 2,核心思想是用实验代替猜测:
- 从极小学习率(如 1e-7)开始训练;
- 每个批次后按指数级增大学习率(如 ×1.5~×2);
- 记录"学习率 vs 损失"曲线;
- 选择损失下降最陡峭处对应的学习率作为起点------此处下降快且尚未失稳。
#mermaid-svg-4Rr5KYIheRNFuiJW{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-4Rr5KYIheRNFuiJW .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-4Rr5KYIheRNFuiJW .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-4Rr5KYIheRNFuiJW .error-icon{fill:#552222;}#mermaid-svg-4Rr5KYIheRNFuiJW .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-4Rr5KYIheRNFuiJW .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-4Rr5KYIheRNFuiJW .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-4Rr5KYIheRNFuiJW .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-4Rr5KYIheRNFuiJW .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-4Rr5KYIheRNFuiJW .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-4Rr5KYIheRNFuiJW .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-4Rr5KYIheRNFuiJW .marker{fill:#333333;stroke:#333333;}#mermaid-svg-4Rr5KYIheRNFuiJW .marker.cross{stroke:#333333;}#mermaid-svg-4Rr5KYIheRNFuiJW svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-4Rr5KYIheRNFuiJW p{margin:0;}#mermaid-svg-4Rr5KYIheRNFuiJW .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-4Rr5KYIheRNFuiJW .cluster-label text{fill:#333;}#mermaid-svg-4Rr5KYIheRNFuiJW .cluster-label span{color:#333;}#mermaid-svg-4Rr5KYIheRNFuiJW .cluster-label span p{background-color:transparent;}#mermaid-svg-4Rr5KYIheRNFuiJW .label text,#mermaid-svg-4Rr5KYIheRNFuiJW span{fill:#333;color:#333;}#mermaid-svg-4Rr5KYIheRNFuiJW .node rect,#mermaid-svg-4Rr5KYIheRNFuiJW .node circle,#mermaid-svg-4Rr5KYIheRNFuiJW .node ellipse,#mermaid-svg-4Rr5KYIheRNFuiJW .node polygon,#mermaid-svg-4Rr5KYIheRNFuiJW .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-4Rr5KYIheRNFuiJW .rough-node .label text,#mermaid-svg-4Rr5KYIheRNFuiJW .node .label text,#mermaid-svg-4Rr5KYIheRNFuiJW .image-shape .label,#mermaid-svg-4Rr5KYIheRNFuiJW .icon-shape .label{text-anchor:middle;}#mermaid-svg-4Rr5KYIheRNFuiJW .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-4Rr5KYIheRNFuiJW .rough-node .label,#mermaid-svg-4Rr5KYIheRNFuiJW .node .label,#mermaid-svg-4Rr5KYIheRNFuiJW .image-shape .label,#mermaid-svg-4Rr5KYIheRNFuiJW .icon-shape .label{text-align:center;}#mermaid-svg-4Rr5KYIheRNFuiJW .node.clickable{cursor:pointer;}#mermaid-svg-4Rr5KYIheRNFuiJW .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-4Rr5KYIheRNFuiJW .arrowheadPath{fill:#333333;}#mermaid-svg-4Rr5KYIheRNFuiJW .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-4Rr5KYIheRNFuiJW .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-4Rr5KYIheRNFuiJW .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-4Rr5KYIheRNFuiJW .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-4Rr5KYIheRNFuiJW .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-4Rr5KYIheRNFuiJW .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-4Rr5KYIheRNFuiJW .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-4Rr5KYIheRNFuiJW .cluster text{fill:#333;}#mermaid-svg-4Rr5KYIheRNFuiJW .cluster span{color:#333;}#mermaid-svg-4Rr5KYIheRNFuiJW div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-4Rr5KYIheRNFuiJW .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-4Rr5KYIheRNFuiJW rect.text{fill:none;stroke-width:0;}#mermaid-svg-4Rr5KYIheRNFuiJW .icon-shape,#mermaid-svg-4Rr5KYIheRNFuiJW .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-4Rr5KYIheRNFuiJW .icon-shape p,#mermaid-svg-4Rr5KYIheRNFuiJW .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-4Rr5KYIheRNFuiJW .icon-shape .label rect,#mermaid-svg-4Rr5KYIheRNFuiJW .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-4Rr5KYIheRNFuiJW .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-4Rr5KYIheRNFuiJW .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-4Rr5KYIheRNFuiJW :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} LR 从 1e-7 起步
每步增大 LR 并记录损失
观察损失曲线
损失骤降区
选此区间偏左的值
损失开始反弹/震荡
说明过大,越过上限
图 3 LR Range Test 流程
工程上 PyTorch Lightning 一行 Trainer(auto_lr_find=True)、fastai 的 learn.lr_find() 即可运行。
6.3 学习率调度:训练全程动态调整
找到初值只是第一步,全程固定学习率往往不是最优。主流调度策略:
| 策略 | 做法 | 适用场景 |
|---|---|---|
| Step Decay | 每 N 个 epoch 把 LR 乘以 0.1 | 通用基线 |
| 余弦退火 | LR 沿余弦曲线平滑降至接近 0 | CV 任务最常用之一,收敛平滑 [4](#策略 做法 适用场景 Step Decay 每 N 个 epoch 把 LR 乘以 0.1 通用基线 余弦退火 LR 沿余弦曲线平滑降至接近 0 CV 任务最常用之一,收敛平滑 [4] Warmup(预热) 训练最初几百步从极小值线性升到目标 LR Transformer/大模型必备,防初期发散 [3] One-Cycle 先升后降,一个周期内完成 配合 LR Range Test,收敛快且泛化好 ReduceLROnPlateau 验证指标停滞时自动降 LR 不想手动设定节奏时的省心选择) |
| Warmup(预热) | 训练最初几百步从极小值线性升到目标 LR | Transformer/大模型必备,防初期发散 [3](#策略 做法 适用场景 Step Decay 每 N 个 epoch 把 LR 乘以 0.1 通用基线 余弦退火 LR 沿余弦曲线平滑降至接近 0 CV 任务最常用之一,收敛平滑 [4] Warmup(预热) 训练最初几百步从极小值线性升到目标 LR Transformer/大模型必备,防初期发散 [3] One-Cycle 先升后降,一个周期内完成 配合 LR Range Test,收敛快且泛化好 ReduceLROnPlateau 验证指标停滞时自动降 LR 不想手动设定节奏时的省心选择) |
| One-Cycle | 先升后降,一个周期内完成 | 配合 LR Range Test,收敛快且泛化好 |
| ReduceLROnPlateau | 验证指标停滞时自动降 LR | 不想手动设定节奏时的省心选择 |
现代训练(尤其 NLP/大模型)普遍采用 Warmup + 余弦退火 组合:先热身避免冷启动发散,再平滑退火精修。
6.4 与优化器和批次大小联动
- 优化器类型 :Adam 系内部有自适应缩放,对学习率更宽容,通常 1e-3 就能工作 5;SGD 对学习率和动量更敏感,需配合调度器精调,但调好后泛化上限可能更高。
- 批次大小 :线性缩放规则 ------批次扩大 k k k 倍,学习率也相应扩大 k k k 倍,大批次训练需配合 Warmup 3。换批次大小后原学习率需重新校准。
- 模型规模与任务:模型越深、微调预训练模型,学习率应越小;从头训练小模型可以更大胆。
6.5 实操流程
- 跑一次 LR Range Test,锁定"损失下降最陡"的量级;
- 取该值附近 2~3 个候选(如 1e-3、3e-4、1e-4)各训几个 epoch,对比下降速度和稳定性;
- 选定后配上调度器(Warmup + 余弦退火是安全牌),跑完整训练;
- 盯损失曲线微调:震荡 → 降 LR;前期太慢 → 升 LR 或延长 warmup;
- Transformer 训练务必加 warmup,否则初期极易 NaN。
6.6 数学分析:η 的五种命运
极端值的行为可以精确预测。以 5.1 的 L ( w ) = w 2 L(w) = w^2 L(w)=w2(梯度 g = 2 w g = 2w g=2w,起点 w 0 = 3 w_0 = 3 w0=3,最优解 w ∗ = 0 w^* = 0 w∗=0)为例:
w t + 1 = w t − η ⋅ 2 w t = ( 1 − 2 η ) w t w_{t+1} = w_t - \eta \cdot 2w_t = (1-2\eta)\,w_t wt+1=wt−η⋅2wt=(1−2η)wt
收敛条件 : ∣ 1 − 2 η ∣ < 1 |1-2\eta| < 1 ∣1−2η∣<1,即 0 < η < 1 0 < \eta < 1 0<η<1。每步只乘一个常数,五种命运全由 η \eta η 决定:
| η 取值 | 每步乘数 (1−2η) | 行为 | 代表轨迹 |
|---|---|---|---|
| 0.001(过小) | ≈ +0.998 | 几乎不动,收敛极慢 | L L L: 9 → 6(约 100 轮)→ 1(约 550 轮) |
| 0.1(合适) | +0.8 | 单调平滑滑向谷底 | L L L: 9 → 5.76 → 3.69 → ...,10 轮降至 0.1 |
| 0.9(偏大) | −0.8 | 冲过谷底,来回横跳但幅度递减 | w w w: 3 → −2.4 → 1.9 → −1.5 → 1.2 → ... |
| 1.0(临界) | −1 | 永久等幅震荡,一步都没接近答案 | w w w: 3 → −3 → 3 → −3, L L L 恒为 9 |
| 1.1(过大) | < −1 | 发散爆炸,最终 NaN/Inf | w w w: 3 → −3.6 → 4.3 → −5.2 → 6.2 → ... |
对 L = w 2 L=w^2 L=w2,η=0.1 时损失曲线与 η=0.9 时看似相同(每步损失都乘 0.64),但这是对称碗形的巧合------在真实高维损失面上,来回横跳的代价大得多,也更容易撞上不稳定。
6.7 为什么会炸:正反馈与两道防线
"梯度大 = 离答案远 = 大步向前"的直觉在凸碗上成立,但跨过谷底后就失效:
梯度大 → 步子大 → 冲过谷底、落到对岸更陡处 → 梯度更大 → 步子更大 → ..."坡陡"本该意味着离得远,但跨过谷底之后,坡陡意味着冲过头了 ------此时大梯度反而把参数踹得更远。刹车失灵的条件是 η × \eta \times η× 曲率超过了 1(上例曲率为 2,故 η < 1 \eta < 1 η<1 才安全)。
用 3.3--5.3 的 y=wx+b 实测 η = 0.5 \eta = 0.5 η=0.5:首轮更新后 w = 6.5 , b = 4 w=6.5, b=4 w=6.5,b=4,损失从 17 直接冲到约 100------从"低估 5"变成"高估 12";下一轮被巨大的梯度踹回负方向,损失震荡至约 590,幅度越来越大。这就是"跨过谷底来回蹦"的数值版。
真实深度网络的损失面比碗形复杂得多,两道工程防线:
- 梯度裁剪 :真实损失面有近乎垂直的崖壁,梯度爆表不一定代表离最优远。LLM 训练普遍加梯度裁剪(如 clip norm = 1.0),给步长强制装天花板 6。
- Warmup :训练初期参数随机、方向不可信,先用小学习率热身几百步再升到目标值,防止第一步就踩进悬崖 3。
6.8 症状到处方速查
| 训练中看到 | 处方 |
|---|---|
| 损失平、降得慢 | 调大 LR(×3~×10),或重跑 LR Range Test |
| 损失震荡不降 | 调小 LR(×0.3~×0.1) |
| 损失 NaN/爆炸 | LR 大幅调小 + 加 warmup + 确认开启梯度裁剪 |
| 前几步就炸 | 优先加 warmup,其次降 LR |
七、常见误区
7.1 概念误区
- "反向传播就是优化器":反向传播只是链式求导的计算框架,本身不更新任何参数;参数更新由梯度下降(或其变种)完成。
- "梯度下降是求导方法":梯度下降是参数更新策略,必须依赖梯度才能运行,它自己不会算导数。
- "反向传播 = 反向梯度下降":二者是"探路"与"迈步"的分工------反向传播算出方向,梯度下降据此移动。
- 优化器与反向传播的关系 :SGD、Momentum、RMSprop、Adam、AdamW 全都依赖反向传播求梯度,区别只在于拿到梯度后如何更聪明地更新参数(Momentum 累积历史惯性、Adam 自适应调整每个参数的学习率 5)。
7.2 调参误区
- 迷信单一"最佳值":学习率最优值与批次大小、优化器、模型深度强耦合,他人论文里的值未必适合自己的设置。
- 只调学习率不看损失曲线:损失曲线是最直接的诊断工具,震荡还是平缓一目了然。
- 大模型直接用 1e-3:这是 Adam 训练小模型的经验值,微调 BERT/GPT 类模型会立刻训崩,务必降到 1e-5 量级。
- 忽略学习率与批次大小的联动:改了批次大小却沿用旧学习率,是最常见的手动调参失败原因。
八、结论
一条流水线串起全部四个环节:前向算误差,反向用链式法则追责任,梯度下降拿着负号迈步,学习率当总油门。反向传播负责"算清责任",梯度下降负责"承担责任并做出改变"------前者是导航系统,后者是油门和方向盘;四个环节在 y=wx+b 和 GPT 里没有任何本质区别,深度网络只是把反向传播的链拉长了。学习率选择是实验驱动的过程:先用 LR Range Test 定位量级,再用 Warmup + 调度器动态管理全程,最后盯着损失曲线迭代微调。符号定方向、绝对值定步长、η 是总油门------η 太小磨蹭,合适平滑下滑,太大先横跳、再卡死、最后爆炸,全部行为都能被 ( 1 − 2 η ) (1-2\eta) (1−2η) 这一个乘数预测。
参考文献
1 D. E. Rumelhart, G. E. Hinton, R. J. Williams. "Learning representations by back-propagating errors." Nature, 1986.
2 L. N. Smith. "Cyclical Learning Rates for Training Neural Networks." IEEE WACV, 2017.
3 P. Goyal et al. "Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour." arXiv, 2017.
4 I. Loshchilov, F. Hutter. "SGDR: Stochastic Gradient Descent with Warm Restarts." ICLR, 2017.
5 D. P. Kingma, J. Ba. "Adam: A Method for Stochastic Optimization." ICLR, 2015.
6 R. Pascanu, T. Mikolov, Y. Bengio. "On the difficulty of training recurrent neural networks." ICML, 2013.