📚 本文收录于「流浪」的系列专栏
| 🐧 Linux系统 | ⚙️ C++ |
| 📊 数据结构与算法 | 🐍 Python |
| 🔗 LangChain & LangGraph | 🗄️ MySQL 数据库 |
| 🌿 Git 工具 | 🌐 计算机网络 |
| 🤖 AI | 💯 大厂面试、八股 |
| 📚 学习筑基专栏 |
🏠 博客主页:流浪 | 📝 原创首发于 CSDN
前言: 线程(六)讲完退出和隔离,线程控制的面儿全了。但还有个更底层的问题没拆开------
pthread 库到底是怎么把一个线程从无到有管起来的。本篇拆这条工作流:库怎么描述线程,内核怎么造执行流,两者怎么联动,join 怎么收割。
一、Linux 没有真正的线程,线程库是用户层的封装
1.1 内核眼里只有轻量级进程
篇36 讲过一个底层事实:Linux 没有真正的线程,只是用轻量级进程(LWP)来模拟的。内核里只有 task_struct 这一种执行流描述符,线程和进程在内核眼里是同一种东西,区别只在共享了哪些资源。
由此推出一个关键结论:OS 不提供线程接口 。既然内核不认识「线程」这个概念,自然不会有 create_thread() 这样的系统调用给你用。
1.2 用户层自己封装,造出原生线程库
内核不提供,应用又需要,这个缺口只能由用户层来补------在用户层封装轻量级进程,形成原生线程库。
Linux 下这就是 NPTL(Native POSIX Threads Library,原生 POSIX 线程库) ,从 glibc 2.3.2 起成为标准实现。按照 man 手册 pthreads(7) 的说法,它是 1:1 实现------你每创建一个用户线程,库就在内核里造一个对应的调度实体,一个对一个。
1:1 意味着每个线程在内核眼里都是一个独立可调度的任务,多核机器上可以真正并行着跑,ps -eLf里能看到每个线程自己的 LWP 号。更早的实现 LinuxThreads 还要在进程里塞一个 manager 线程替库打杂,NPTL 把它干掉了,线程就是普通任务,没有中间商。
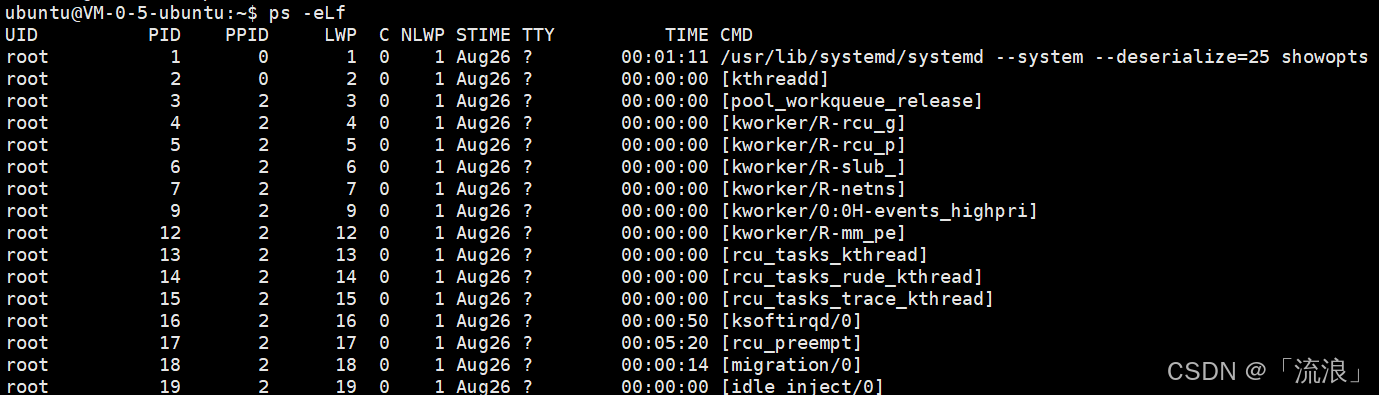
我们前面所有篇章用的 pthread_create、pthread_join,全是这个库提供的函数。
1.3 这个库是动态库,映射进进程地址空间
pthread 库本身是个动态库。动态库和你的可执行程序是同一种 ELF 格式,只是文件类型字段标的是共享对象(ET_DYN),而不是可执行(ET_EXEC)------这是 ELF 规范里 e_type 字段的两种取值,本质是一家人。
程序启动时会发生什么?可执行程序被加载,形成进程,经过动态链接和动态地址重定向,动态库也被加载到内存,映射到当前进程的地址空间。
这一步是后面一切的前提:库被映射进了进程地址空间,进程自己的代码才可以访问 pthread 库内部的相关数据。管理线程用的数据结构、栈、属性,全都放在这块映射出来的区域里,跟你的全局变量、堆栈处在同一个地址空间中,互相看得见。
二、库要管理线程,先描述再组织
线程的概念是在库中维护的。库内部一定会存在多个被创建好的线程,那库要不要管理它们?要 。管理的套路还是那句老话------先描述,再组织。
2.1 先描述,管理块里记什么
描述线程,就是给每个线程建一个结构体。线程控制块(TCB)是这类结构的通用叫法,glibc 源码里的实名是 struct pthread ,定义在 nptl/descr.h 中。本篇后面统一用管理块称呼它。
核心字段长这样(简化自 glibc nptl/descr.h):
c
struct pthread
{
    pid_t tid;              // 内核侧的轻量级进程 ID
    void *result;           // 线程的返回值
    void *(*start_routine)(void *);  // 线程要执行的函数
    void *arg;              // 传给函数的参数
    // 线程状态、独立栈结构、栈大小、取消状态...
};线程从创建到组织起来要记的参数,就落在这几个字段上:内核 ID、返回值、执行方法和参数、栈信息、状态标志。前两篇埋的伏笔在这里收口------篇40 拆过 pthread_t 的本质是地址,那个地址指向的就是这个管理块;篇39 讲过 create 的第三参数是返回值通道,函数指针和参数先存进管理块,就是为执行那天做准备。
2.2 调度属性不归库管,归内核
有一批属性在描述时被刻意排除了:优先级、时间片、上下文 。这三样不进管理块,它们走另一条路------LWP → PCB,在内核中维护。
道理很简单,这三样都是调度概念,而调度是内核的活。库在用户态,管不着 CPU 给谁时间片。于是线程的相关概念被劈成了两半:
| 对比项 | 用户层(pthread 库) | 内核(LWP → PCB) |
|---|---|---|
| 管理块 | struct pthread | task_struct |
| 记什么 | 线程状态、线程 id、独立栈、栈大小、返回值、函数指针 | 优先级、时间片、上下文 |
| 谁在用 | pthread 系列库函数 | 内核调度器 |
线程的相关概念,一部分在用户层,一部分在内核维护。 这张表就是本篇的中心结论,后面三章全是围绕它展开的工作流。
2.3 再组织,管理块挂在链表上
光描述不够,多个管理块得串起来。glibc 的做法是把每个 struct pthread 用 list 字段挂进库维护的全局链表(源码注释写明挂在 dl_stack_used 或 dl_stack_user 链上)。库想遍历所有线程、找一个线程、回收一个线程,顺着链表走就行。
内核侧同样是组织好的------所有 task_struct 挂在内核自己的调度数据结构里,等着调度器挑。用户态一条链,内核态一条链,两边的组织各管各的,靠管理块里的 tid 字段把同一个线程在两边对上号。
先描述、再组织,进程管理那套方法论在线程库身上原样重演了一遍。
三、pthread_create 背后,创建线程的完整工作流
铺垫到位,看主戏。用户线程和 LWP 是如何关联的?先看一个前提:每个线程都有自己独立的栈空间------主线程用地址空间里的栈区,新线程用库 mmap 出来的线程栈,这点篇38 已经拆过,不重讲。
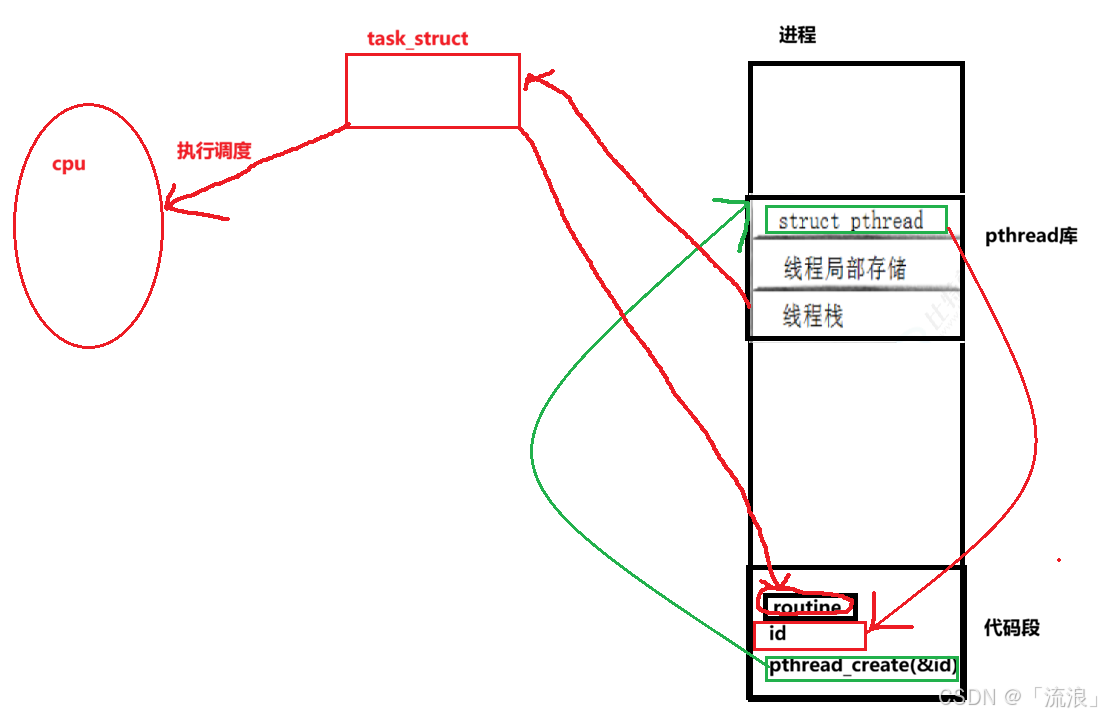
带着这个前提,看一个线程是怎么被创建的。代码区里就一行:
c
pthread_create(&id, ..., routine, arg);这一行背后是两个步骤。
1. 库里先建管理块,起始地址写进 id
调用 create 时,pthread 库会先在库中创建一个 struct pthread 管理块,把 routine、arg、栈信息、状态这些字段填好,再将管理块的起始地址写入 id 中。
这就是篇40 那个结论的诞生现场------pthread_t 为什么是个地址?因为 create 压根没给你什么编号,它直接把库内部数据结构的地址交了出来。之后你调 pthread_join、pthread_detach,库拿着这个地址一步到位找到管理块,中间不需要任何映射表。
2. clone 系统调用,在内核里建 LWP
create 还要在内核中创建轻量级进程。这一步走的是系统调用 clone------既然线程在内核眼里就是 LWP,那创建线程就是让内核建一个 task_struct。
man 手册里 clone 的 wrapper 原型长这样:
c
int clone(int (*fn)(void *), void *child_stack,
int flags, void *arg, ...);注意前两个参数:fn,执行方法;child_stack,栈在哪里。内核要造执行流,必须知道两件事------这个执行流从哪个函数开始跑、用什么栈跑。栈由库提前 mmap 好,把栈顶地址递过去;fn 传的是库自己的启动函数,用户的方法存在管理块里,由它中转。
flags 则告诉内核共享什么:CLONE_VM 共享地址空间、CLONE_FILES 共享文件描述符表、CLONE_THREAD 归入同一线程组......共享得越多,新 task 越像线程,这正是篇36 讲过的「用进程模拟线程」在系统调用层面的落地。
四、内核和用户层就这样联动起来
clone 返回,LWP 造好了,接下来轮到 CPU。
4.1 新线程怎么跑起来
CPU 在进行调度时会自动执行对应的方法 ------调度器选中这个新 LWP,执行流从库的启动函数进入,启动函数从管理块里取出 start_routine 和 arg,去执行自己定义的方法,再把线程私有的栈结构地址交给它。
「把栈地址交给它」落到硬件层面,就是把栈寄存器指向那块 mmap 出来的空间。此后函数运行形成的临时数据,会自动压进线程栈------局部变量、函数调用帧,全落在线程自己的私有地盘上,谁也踩不着谁。
4.2 用户线程和 LWP 的关联闭环
到这里,整条链路闭环了,内核和用户层在一定程度联动起来:
- 用户层的库出数据结构(管理块)和栈;
- 内核出执行流(LWP/task_struct)和调度;
- 管理块的 tid 字段记着内核给的 LWP ID,库借它跟内核对话;pthread_t 指向管理块,LWP 在内核调度------一个用户线程就这样和 LWP 一对一关联。
你写的 routine 函数跑在库准备的栈上、被内核当成 LWP 调度、被库的数据结构记录------三方合资,才凑出一个「线程」。
五、线程的回收,join 从管理块里拿返回值
创建讲完讲回收。站在 struct_pthread 和线程返回值的角度,回收过程值得单独拆一章。
5.1 返回值写进管理块
线程结束后,返回值被写进 struct_pthread 的 result 字段。篇39 讲过 return 的值通过 void* 通道传出来、join 用二级指针接住------那个值最终落在哪?就落在管理块里。
5.2 线程被销毁,管理块没销毁
关键一句:线程被销毁,但是 struct_pthread 没有被销毁,通过 struct_pthread 进行 join。
「线程被销毁」销的是内核侧的执行流------LWP 不复存在,调度队列里没有它了。「没被销毁」的是用户侧的数据------管理块还挂在库的链表上,result 字段原封不动地存着退出信息。它处没有,想拿线程的返回值,只能通过这个管理块。
两层销毁时机不同,恰好对应 2.2 那张表的左右两半:内核的跟着调度实体走,说没就没;用户层的跟着数据走,等人来收。
5.3 join 的收割动作
站在管理块和返回值的角度,join 的回收过程三步走:先等 ------通过 futex 阻塞在目标线程的结束事件上;再取 ------目标线程结束后,从它的管理块里把 result 读出来,交给 join 的第二个参数;后释放------返回值拿走了,管理块连同 mmap 出来的线程栈才真正被库回收。
回收下来的栈也不会马上还给系统。篇38 讲过 glibc 有栈缓存------回收的栈先进缓存池,等下一个 pthread_create 来了直接复用,省去又一次 mmap。所以「释放」释放的是库的占用,不是内存的消失。
线程(六)讲过 detach------分离的线程没人 join,库就在它结束时自己走完取值和释放这套动作,管理块直接回收。所以分离线程的返回值你拿不到,不是库小气,是收割流程压根没给你留入口。
六、线程的局部存储,__thread 让全局变量每线程一份
工作流讲完,补一个库挂在线程身上的私有能力。篇38 拆 errno 时点过一句------错误码能线程私有,靠的就是线程局部存储(TLS,Thread-Local Storage)。
6.1 变量前加 __thread,一个变量各线程一份
用法就一个动作,全局或静态变量前面加 __thread:
cpp
__thread int g_val = 10; // 加 __thread,全局变量按线程私有一份- 变量前的
__thread 起到引导编译器的作用。没有它,g_val 全进程一份,定义在已初始化数据段共享;加上它,编译器不再按全局共享的方式安置这个变量,而是给每个线程准备一份私有副本,放进各自线程的局部存储空间------大家的变量名相同,底层虚拟地址不同。
demo
cpp
int a=10;
std::string Addr(int &num)
{
    char a[64];
    snprintf(a,sizeof(a),"%p",&num);
    return a;
}

void *routine1(void *mes)
{
    while(true)
    {
        std::cout<<"我是线程1,a的值为:"<<a++<<" "<<"a的地址:"<<Addr(a)<<std::endl;
        sleep(1);
    }
    return nullptr;
}

void *routine2(void *mes)
{
    while(true)
    {
        std::cout<<"我是线程2,a的值为:"<<a  <<" "<<"a的地址:"<<Addr(a)<<std::endl;
        sleep(1);
    }
    return nullptr;
}

int main()
{
    pthread_t tid1,tid2;
    pthread_create(&tid1,nullptr,routine1,nullptr);
    pthread_create(&tid2,nullptr,routine2,nullptr);

    pthread_join(tid1,nullptr);
    pthread_join(tid2,nullptr);
    return 0;
}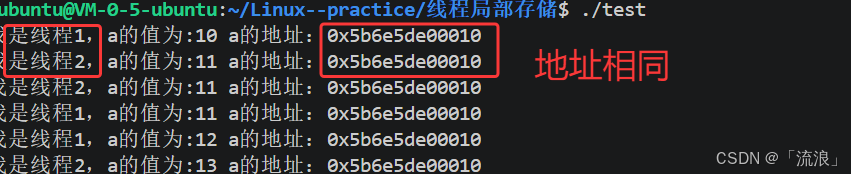
加上__thread之后:
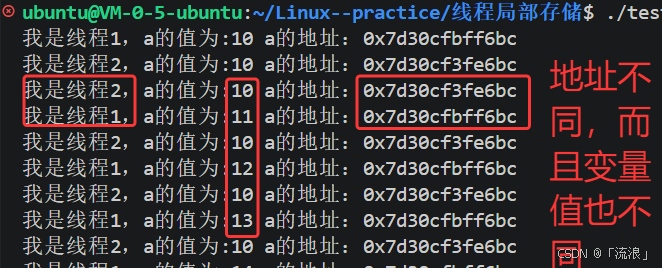
- 容易联想到父子进程的写时拷贝,像,但机制不一样:写时拷贝先共享一份、写到才复制;局部存储是线程的存储空间里本来就备好独立一份,没有「触发拷贝」这个动作。共性只有一个------各有一份,互不干扰。
6.2 它解决什么问题
有一个全局变量,但又不想让这个全局变量被其他线程看到。 全局的写法省事,共享的副作用全不想要------局部存储就是为这种情况准备的,访问零成本,副作用隔离在各自线程里。
errno 是现成的招牌:出错码放全局,一个线程刚查完就被另一个覆盖,错误码全乱套。篇38 那句「每线程一份」到这里才算把用法补全。
6.3 两个边界,外加名字存哪的甄别
1. 类型受限,只能存内置类型和部分指针
局部存储装不下复杂对象。 GCC 手册要求 C++ 的初始化必须是常量表达式------带自定义构造、析构的类对象放不进来。 日常用法就剩整型、指针这类,「内置类型和部分指针」说的就是这条边界。
2. setname_np 设置的名字,每线程一份但不放局部存储
pthread_setname_np / pthread_getname_np 给线程起名字,名字限 16 字节(含结尾 '\0'),超了报 ERANGE。名字每线程一份,各写各的,不存在互相覆盖的并发问题。
但 man 手册注记写明 setname_np 内部写的是 /proc/self/task/tid/comm------名字落在内核 task_struct 的 comm 字段,不在用户层的局部存储里。「无并发问题」取的是每线程一份的私有语义,位置上面试别说错。
七、全篇总结
- Linux 没有真正的线程,内核用 LWP 模拟,OS 不提供线程接口,用户层封装出原生线程库 NPTL,1:1 映射。
- 库是动态库,ELF 格式,映射进进程地址空间,进程代码才能访问库内部数据。
- 先描述再组织------描述是 struct pthread 管理块(记 tid、result、start_routine、栈信息),组织是挂在库的全局链表上;优先级、时间片、上下文归内核,走 LWP → PCB。
- 创建两步走------库里建管理块、起始地址写进 id;clone 在内核建 LWP,前两个参数是执行方法和栈位置。
- 执行靠联动------CPU 调度 LWP,从库的启动函数进入,转去执行用户方法,临时数据自动入线程栈。
- 回收看两层------线程销毁的是 LWP,管理块留着,join 从 result 取值后才释放管理块和栈。
- 线程局部存储------全局变量加 __thread 每线程一份,变量名相同地址不同;只能放内置类型和部分指针,errno 是招牌应用。
八、源码框架--线程创建到销毁全链路骨架
cpp
/*
 * LWP-Life 框架 ------ 线程从创建到销毁的全链路骨架(glibc nptl)
 * 闭环:申请空间 -> 克隆 -> 运行 -> 退出 -> 等待/回收 -> 归还缓存 -> 再被申请
 */

/* 一、线程描述符 TCB:struct pthread 关键成员 */
struct pthread
{
    pid_t tid;   // 线程 ID,兼作"该描述符(栈)是否在被使用"的标志
                 // >=0 在用;==0 内核已把它清零(线程真走了);<0 已被自行 detach/join
    pid_t pid;   // 进程 ID,内核里叫线程组 ID(tgid)

    bool user_stack; // 栈是否由用户提供(否则由库 mmap 而来,才可进缓存复用)

    void *result;    // 线程函数的返回值 void* 放在这里
                     // pthread_join 拿退出信息,读的就是它
                     // 也解释了"执行流可以退出,TCB 可以暂时保留"

    struct sched_param schedparam;    // 调度参数
    int schedpolicy;                  // 调度策略

    void *(*start_routine) (void *);  // 用户指定的线程函数
    void *arg;                        // 用户指定的参数

    void *stackblock;       // 线程整块空间的起始地址
    size_t stackblock_size; // 整块空间的大小
};

/* 二、pthread_create:用户层入口,创建链路起点 */
int
__pthread_create_2_1 (pthread_t *newthread, const pthread_attr_t *attr,
                      void *(*start_routine) (void *), void *arg)
{
    // 线程属性:没传就退回默认属性
    const struct pthread_attr *iattr = (struct pthread_attr *) attr;
    if (iattr == NULL)
        iattr = &default_attr;

    struct pthread *pd = NULL;   // 待填充的线程描述符

    // 申请一大块线程私有空间,struct pthread 落在空间开头(见第三阶段)
    int err = ALLOCATE_STACK (iattr, &pd);

    // 把要执行的函数和参数登记进 TCB(稍后由新线程自己取出来跑)
    pd->start_routine = start_routine;
    pd->arg = arg;

    // 把 TCB 地址作为线程 ID 交给上层 ------ pthread_t 本质是一个虚拟地址
    *newthread = (pthread_t) pd;

    bool is_detached = IS_DETACHED (pd);           // 是否分离:决定退出时谁释放资源

    err = create_thread (pd, iattr, STACK_VARIABLES_ARGS);   // 真正创建(第四阶段)
    if (err != 0)
        __deallocate_stack (pd);                   // 创建失败:空间直接还回去
    return err;
}

/* 三、allocate_stack:安家 ------ 申请空间并确定 TCB 位置 */
static int
allocate_stack (const struct pthread_attr *attr, struct pthread **pdp,
                ALLOCATE_STACK_PARMS)
{
    // 栈大小:用户设置了就用用户的,否则用默认值
    size = attr->stacksize ?: __default_stacksize;

    // 先尝试从栈缓存申请:缓存里挂的是已退出线程的旧栈
    // 判定能否复用的条件是 FREE_P(curr) == (curr->tid <= 0)
    // ------ 内核只有在线程真正退出后才会把 tid 清零,这就是闭环的连接点
    pd = get_cached_stack (&size, &mem);
    if (pd == NULL)
        // 缓存没有合适的 -> mmap 申请私有匿名内存,作用类似 malloc
        ;

    // 在申请到的空间中确定 TCB 地址:放在这块空间的末尾
    pd = (struct pthread *) ((char *) mem + size - coloring) - 1;

    // 记录整块空间的地址和大小,回收时按它归还/复用
    pd->stackblock = mem;
    pd->stackblock_size = size;

    // 线程即轻量级进程,记录所属进程的 pid
    pd->pid = THREAD_GETMEM (THREAD_SELF, pid);
    return 0;
}

/* 四、create_thread:向内核下创建订单,成功后放行新线程 */
static int
create_thread (struct pthread *pd, const struct pthread_attr *attr,
               STACK_VARIABLES_DECL)
{
    // 最后一个参数控制新线程是否先挂起,等父线程登记完信息再放行
    int res = do_clone (pd, attr, clone_flags, start_thread,
                        STACK_VARIABLES_ARGS, stopped);

    if (res == 0)
    {
        // 登记 TD_CREATE 调试事件,挂进事件链表并通知调试器
        pd->eventbuf.eventnum = TD_CREATE;
        pd->eventbuf.eventdata = pd;
        // ... CAS 挂链表 + __nptl_create_event() ...

        lll_unlock (pd->lock);      // 解锁放行:新线程这才开始真正跑
    }
    return res;
}

/* 4.1 do_clone 内部:打包参数,真正陷入内核 */
// ARCH_CLONE 把入口函数 fct、参数 pd、TLS、tid 地址打包交给内核,返回 -1 即失败
if (ARCH_CLONE (fct, STACK_VARIABLES_ARGS, clone_flags,
                pd, &pd->tid, TLS_VALUE, &pd->tid) == -1)
    /* 失败:释放栈,返回错误码 */;

movl $SYS_ify(clone), %eax   /* 系统调用号进 eax */
syscall                      /* 陷入内核(x86_32 是 int 80),要求内核创建轻量级进程 */
/* 内核从此担起一个约定:clone 带了 CLONE_CHILD_CLEARTID,
   线程死时会把 *(&pd->tid) 清零并 futex 唤醒等待者 ------ 后面 join 全靠它 */

/* 五、start_thread:新线程的起点,也是退出的起点 */
static int
start_thread (void *arg)
{
    struct pthread *pd = arg;

    // 若被要求挂起启动:抢到 pd->lock 才算拿到 TCB 所有权,随即释放
    // 这一步和上面 create_thread 的解锁正好对上,保证父子交接完成
    if (pd->stopped_start)
    {
        lll_lock (pd->lock, LLL_PRIVATE);
        lll_unlock (pd->lock, LLL_PRIVATE);
    }

    // setjmp 埋点:pthread_exit / 取消时的清理回滚就落在 unwind_buf 上
    int not_first_call = setjmp (unwind_buf.cancel_jmp_buf);

    if (__glibc_likely (! not_first_call))
    {
        THREAD_SETMEM (pd, cleanup_jmp_buf, &unwind_buf);

        void *ret = pd->start_routine (pd->arg);   // 跑用户的线程函数
        THREAD_SETMEM (pd, result, ret);           // 返回值落进 TCB
    }

    call_function_static_weak (__call_tls_dtors);  // 析构 thread_local 变量
    __nptl_deallocate_tsd ();                      // 清理线程局部数据
    __libc_thread_freeres ();                      // 清理 libc 的线程状态

    atomic_fetch_or_relaxed (&pd->cancelhandling, EXITING_BITMASK);  // 标记正在退出

    // 已经没人能 join(分离线程)?自己把资源清干净
    if (IS_DETACHED (pd))
        __free_tcb (pd);

    // 不能 _exit(会杀整个进程):只退出当前执行流
    // 内核按 CLONE_CHILD_CLEARTID 的约定把 pd->tid 清零,并 futex 唤醒 join 者
    // tid 归零后,这块栈才可能被 get_cached_stack 挑走复用
    while (1)
        INTERNAL_SYSCALL_CALL (exit, 0);
}

/* 六、pthread_join:等待线程死亡并取回结果(非分离线程由这里收尾) */
int
__pthread_join (pthread_t threadid, void **thread_return)
{
    struct pthread *pd = (struct pthread *) threadid;   // pthread_t 就是 TCB 地址

    if (INVALID_NOT_TERMINATED_TD_P (pd)) return ESRCH; // 句柄已失效
    if (IS_DETACHED (pd))                return EINVAL; // 分离线程不可 join
    if (pd == THREAD_SELF)               return EDEADLK;// 自己 join 自己:死锁

    atomic_exchange (&pd->joinid, self);   // 抢占 join 权,只能有一个等待者

    // 在 pd->tid 上 futex 阻塞:非 0 就睡,内核清零时自动唤醒
    lll_wait_tid (pd->tid);

    pd->tid = -1;                          // 标记:线程已终止且已被 join
    if (thread_return != NULL)
        *thread_return = pd->result;       // 取回返回值
    __free_tcb (pd);                       // 未分离线程的资源,由 join 者释放
    return 0;
}

/* 七、__free_tcb -> __deallocate_stack:资源归还,闭环回到第三阶段 */
void
__free_tcb (struct pthread *pd)
{
    // 首次置上 TERMINATED 位的那个线程负责回收(分离线程是自己,join 情形是调用者)
    if (__builtin_expect (atomic_bit_test_set (&pd->cancelhandling,
                                               TERMINATED_BIT) == 0, 1))
        __deallocate_stack (pd);
}

void
__deallocate_stack (struct pthread *pd)
{
    lll_lock (stack_cache_lock, LLL_PRIVATE);
    stack_list_del (&pd->list);            // 先移出在用链表

    if (__glibc_likely (! pd->user_stack))
        queue_stack (pd);                  // 库申请的栈:进缓存,留给下一个线程复用
    else
        _dl_deallocate_tls (TLS_TPADJ (pd), false); // 用户自己的栈不能动,只释放 TLS
    lll_unlock (stack_cache_lock, LLL_PRIVATE);
}

static inline void
queue_stack (struct pthread *stack)
{
    // 无条件挂进缓存:这块内存的 tid 还没被内核清零前不会被选中复用
    stack_list_add (&stack->list, &stack_cache);
    stack_cache_actsize += stack->stackblock_size;
    if (__glibc_unlikely (stack_cache_actsize > stack_cache_maxsize))
        __free_stacks (stack_cache_maxsize);  // 缓存超限:挑旧的真正 munmap 归还
}
九、文末面试题
9.1 推导题
1. 为什么内核不提供线程接口,线程还能被使用?
答(推导):内核虽然不认识「线程」,但提供了 clone 这个可控共享的系统调用。用户层库把 clone 封装起来,配上自己的数据结构(管理块、线程栈),在用户态拼出了线程的完整语义。OS 不提供的是「线程」这个名字和接口,不提供不了的是共享执行流的能力。
2. clone 的 fn 参数和用户传给 pthread_create 的 start_routine 是同一个函数吗?
答(推导):不是。clone 的 fn 传的是库内部的启动函数,用户的方法 start_routine 和参数 arg 先存进管理块。新 LWP 被调度时先执行库的启动函数,再由它从管理块取出 start_routine 转调。多做这一层中转,库才能在执行前后插手------填 tid、收返回值、标记状态,全靠这个中转站。
3. 线程结束后,内核的 task_struct 和库里的管理块谁先消失?
答(推导):task_struct 先消失。线程退出即执行流终结,内核侧的 LWP 不复存在;管理块是库的数据结构,要等 join(或 detach 的自动回收)取走 result 后才释放。所以「线程死了但返回值还在」,拿返回值靠的是管理块。
4. 为什么 create 直接把管理块地址当线程 ID 返回给用户?
答(推导):后续所有库函数(join、detach、cancel)都需要找到目标线程的管理块。直接把地址当 ID,库函数拿到参数就能访问数据,省去一次 ID 到内存块的映射查找;地址在进程地址空间内天然唯一,也不会和别的线程混淆。代价是它只在进程内有意义,内核不认这个值。
5. 主线程有没有管理块和线程栈?
答(推导):主线程同样被库管理,pthread_self 在 main 里一样能拿到 ID。区别在栈------主线程用的是进程地址空间里的栈区,随进程创建就有;新线程的栈才是库 mmap 出来的。所以主线程和子线程在库眼里都是线程,差异只在栈的来源。
6. 库把线程概念劈成用户层一半、内核一半,为什么不干脆全放一边?
答(推导):全放内核,就得给内核加线程接口,改动内核且违背 Linux「一切皆进程」的简化设计;全放用户层,调度属性(优先级、时间片、上下文)没人管------调度是内核的职权,用户态碰不到 CPU 分配。两半的划分不是设计者的偏好,是职权边界:数据归看得见它的库,调度归管得了 CPU 的内核。
9.2 真题
1. 在 Linux 中有一个线程被创建出来,会发生什么?
【真题·转述自掘金面经复盘帖《面试复盘:谈谈 Linux 在创建线程时做了什么工作》】
答(推导 · 已对照面经,转述):按本篇工作流作答------库先在用户态建管理块、mmap 线程栈,把 pthread_t(管理块地址)交给调用者;再走 clone 系统调用,内核创建 task_struct(LWP),按 flags 共享地址空间和文件表,得到自己的 TID;新执行流进调度队列,被调度后从库的启动函数进入,转去执行用户方法,临时数据压线程栈。面经里面试官还期待你能点出 CLONE_VM 这类 flags 的作用,本篇第三章正好补齐。
2. pthread_create 是系统调用吗?它和 clone 是什么关系?
【真题·转述自 CSDN 技术博客《Linux 线程机制》面试高频总结,iies.in 面试题汇编同题互证】
答(推导 · 已对照面经,转述):不是。pthread_create 是用户态库函数,clone 才是系统调用。前者封装后者:建管理块、备栈,然后带上一串 CLONE_ 标志调 clone 造出 LWP。内核从头到尾不知道「线程」的存在,它只是照要求建了一个共享资源的 task_struct。
💬 结语: 到这里,线程系列从概念、控制、退出一路拆到了库和内核的交界处。一个 pthread_create 背后站着两个世界,看懂这条工作流,前面几篇的所有结论(pthread_t 是地址、返回值通道、栈私有)就全部串成了一张网。哪一步最出乎你的意料,评论区聊聊。如果这篇对你有帮助,点个赞再走,关注流浪,Linux 系统篇持续更新。