一、编译
StateGraph 只是一张"蓝图",compile() 会把它变成一个可执行的 Runnable。
builder = StateGraph(MyState)
# ... 添加节点和边 ...
graph = builder.compile()   # 编译
编译时 LangGraph 会做几件事:
| 编译时做的事 | 说明 |
|---|---|
| 校验图结构 | 检查是否有孤立节点、是否有入口 |
| 绑定持久化 | 如果传了 checkpointer,会绑定到图上 |
| 生成执行计划 | 把节点和边转换成可调度的执行流程 |
| 返回 Runnable | 编译后的图支持 invoke、stream、batch 等方法 |
2. 编译参数
graph = builder.compile(
    checkpointer=memory,      # 持久化
    store=store,              # 长期记忆
    interrupt_before=["node_a"],  # 在某节点前中断
    interrupt_after=["node_b"],   # 在某节点后中断
)
二、执行:四种调用方式
编译后的图是一个 Runnable,支持标准调用方法。
| 方法 | 用途 | 是否阻塞 |
|---|---|---|
invoke |
执行一次,返回最终 State | 阻塞 |
stream |
流式执行,逐个输出 | 非阻塞迭代 |
batch |
批量执行多个输入 | 阻塞 |
ainvoke / astream |
异步版本 | 异步 |
1. invoke:最简单的执行
result = graph.invoke({"messages": [], "count": 0})
print(result)
2. stream:流式执行(推荐)
stream 可以实时看到每个节点的输出,而不是等全部跑完。
for chunk in graph.stream({"messages": []}):
    print(chunk)
stream_mode 决定了输出的粒度:
| stream_mode | 输出内容 |
|---|---|
"values" |
每个节点执行后的完整 State |
"updates" |
每个节点返回的更新字典 |
"messages" |
LLM 生成的 token 流 |
"custom" |
节点内通过 writer 自定义的输出 |
# 只看每个节点的更新
for chunk in graph.stream(input, stream_mode="updates"):
    print(chunk)
    # 输出:{'node_a': {'count': 1}}
3. batch:批量执行
results = graph.batch([
    {"messages": [], "count": 0},
    {"messages": [], "count": 100}
])
4. 执行时的 config
config = {
    "configurable": {
        "thread_id": "user_123"   # 会话 ID
    },
    "recursion_limit": 25          # 最大迭代次数
}
result = graph.invoke(input, config)
三、持久化:Checkpointer
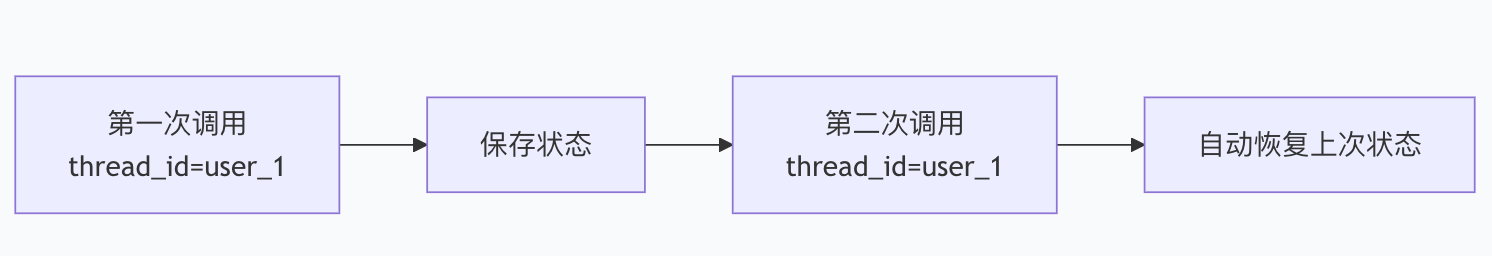
没有持久化时,每次调用都是独立 的,图不记得上次说了什么。Checkpointer 让图能记住历史,实现多轮对话。
使用方式
from langgraph.checkpoint.memory import MemorySaver

memory = MemorySaver()
graph = builder.compile(checkpointer=memory)

# 第一次调用
config = {"configurable": {"thread_id": "user_1"}}
graph.invoke({"messages": ["你好"]}, config)

# 第二次调用(自动恢复上下文)
graph.invoke({"messages": ["继续"]}, config)
常用 Checkpointer
| Checkpointer | 存储位置 | 适用场景 |
|---|---|---|
MemorySaver |
内存 | 开发测试 |
SqliteSaver |
SQLite 文件 | 本地生产 |
PostgresSaver |
PostgreSQL | 生产环境 |
RedisSaver |
Redis | 高并发 |
查看历史状态
# 获取当前状态
state = graph.get_state(config)

# 获取历史状态列表
history = list(graph.get_state_history(config))
四、长期记忆:Store
1. Checkpointer vs Store
| 特性 | Checkpointer | Store |
|---|---|---|
| 作用范围 | 单个会话(thread_id) | 跨会话 |
| 存储内容 | 图的完整状态 | 键值对数据 |
| 典型用途 | 多轮对话 | 用户偏好、长期知识 |
2. 使用方式
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()
graph = builder.compile(store=store)

# 在节点中访问 store
def my_node(state, runtime: Runtime):
    # 写入
    runtime.store.put(("users", "user_1"), "preference", {"theme": "dark"})
    # 读取
    pref = runtime.store.get(("users", "user_1"), "preference")
    return {"result": pref}
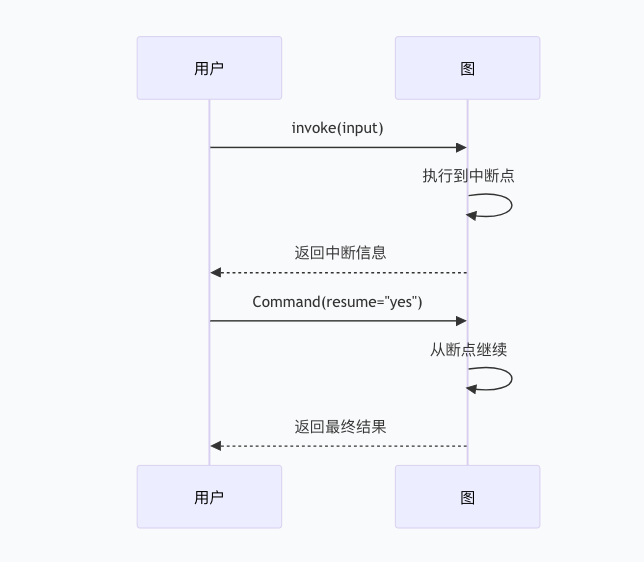
五、中断与恢复(人机协同)
1. 中断的两种方式
# 方式一:编译时指定
graph = builder.compile(
    interrupt_before=["approve_node"],  # 在节点前中断
    interrupt_after=["review_node"]     # 在节点后中断
)

# 方式二:节点内调用 interrupt
from langgraph.types import interrupt

def approve_node(state):
    user_input = interrupt("是否批准?")
    return {"approved": user_input == "yes"}
2. 恢复执行
from langgraph.types import Command

# 用 Command 恢复
graph.invoke(Command(resume="yes"), config)
3. 中断流程图
六、示例
from typing import TypedDict, Annotated
from operator import add
from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.memory import MemorySaver

class ChatState(TypedDict):
    messages: Annotated[list, add]

def chatbot(state: ChatState) -> dict:
    # 模拟 LLM 回复
    user_msg = state["messages"][-1]
    return {"messages": [f"回复:{user_msg}"]}

builder = StateGraph(ChatState)
builder.add_node("chatbot", chatbot)
builder.add_edge(START, "chatbot")
builder.add_edge("chatbot", END)

# 编译时绑定 checkpointer
memory = MemorySaver()
graph = builder.compile(checkpointer=memory)

# 多轮对话
config = {"configurable": {"thread_id": "user_1"}}

graph.invoke({"messages": ["你好"]}, config)
graph.invoke({"messages": ["再见"]}, config)

# 查看完整历史
state = graph.get_state(config)
print(state.values["messages"])
# ['你好', '回复:你好', '再见', '回复:再见']