1. 项目背景
在使用 CodeBuddy(VSCode 扩展 tencent-cloud.coding-copilot)的过程中,很多开发者会关心一个问题:每天到底烧了多少 Token、花了多少积分、哪个项目在烧、用的哪个模型、缓存命中多少。官方没有提供本地化的用量统计工具,而数据其实都写在本机磁盘上。
本项目就是为解决这个问题而生:把本地 CodeBuddy 的会话与 Token 消耗数据解析出来,用一个本地看板直观展示。数据全部来自本机磁盘,不联网、不上传、不依赖任何官方接口。
项目开源地址
该项目的开源代码托管于 GitHub,可通过以下链接访问:
该仓库提供了 CodeBuddy 使用情况仪表盘的完整实现,包含前端可视化界面、数据采集逻辑及部署配置说明,支持开发者快速搭建与定制化使用。
2. 功能特性
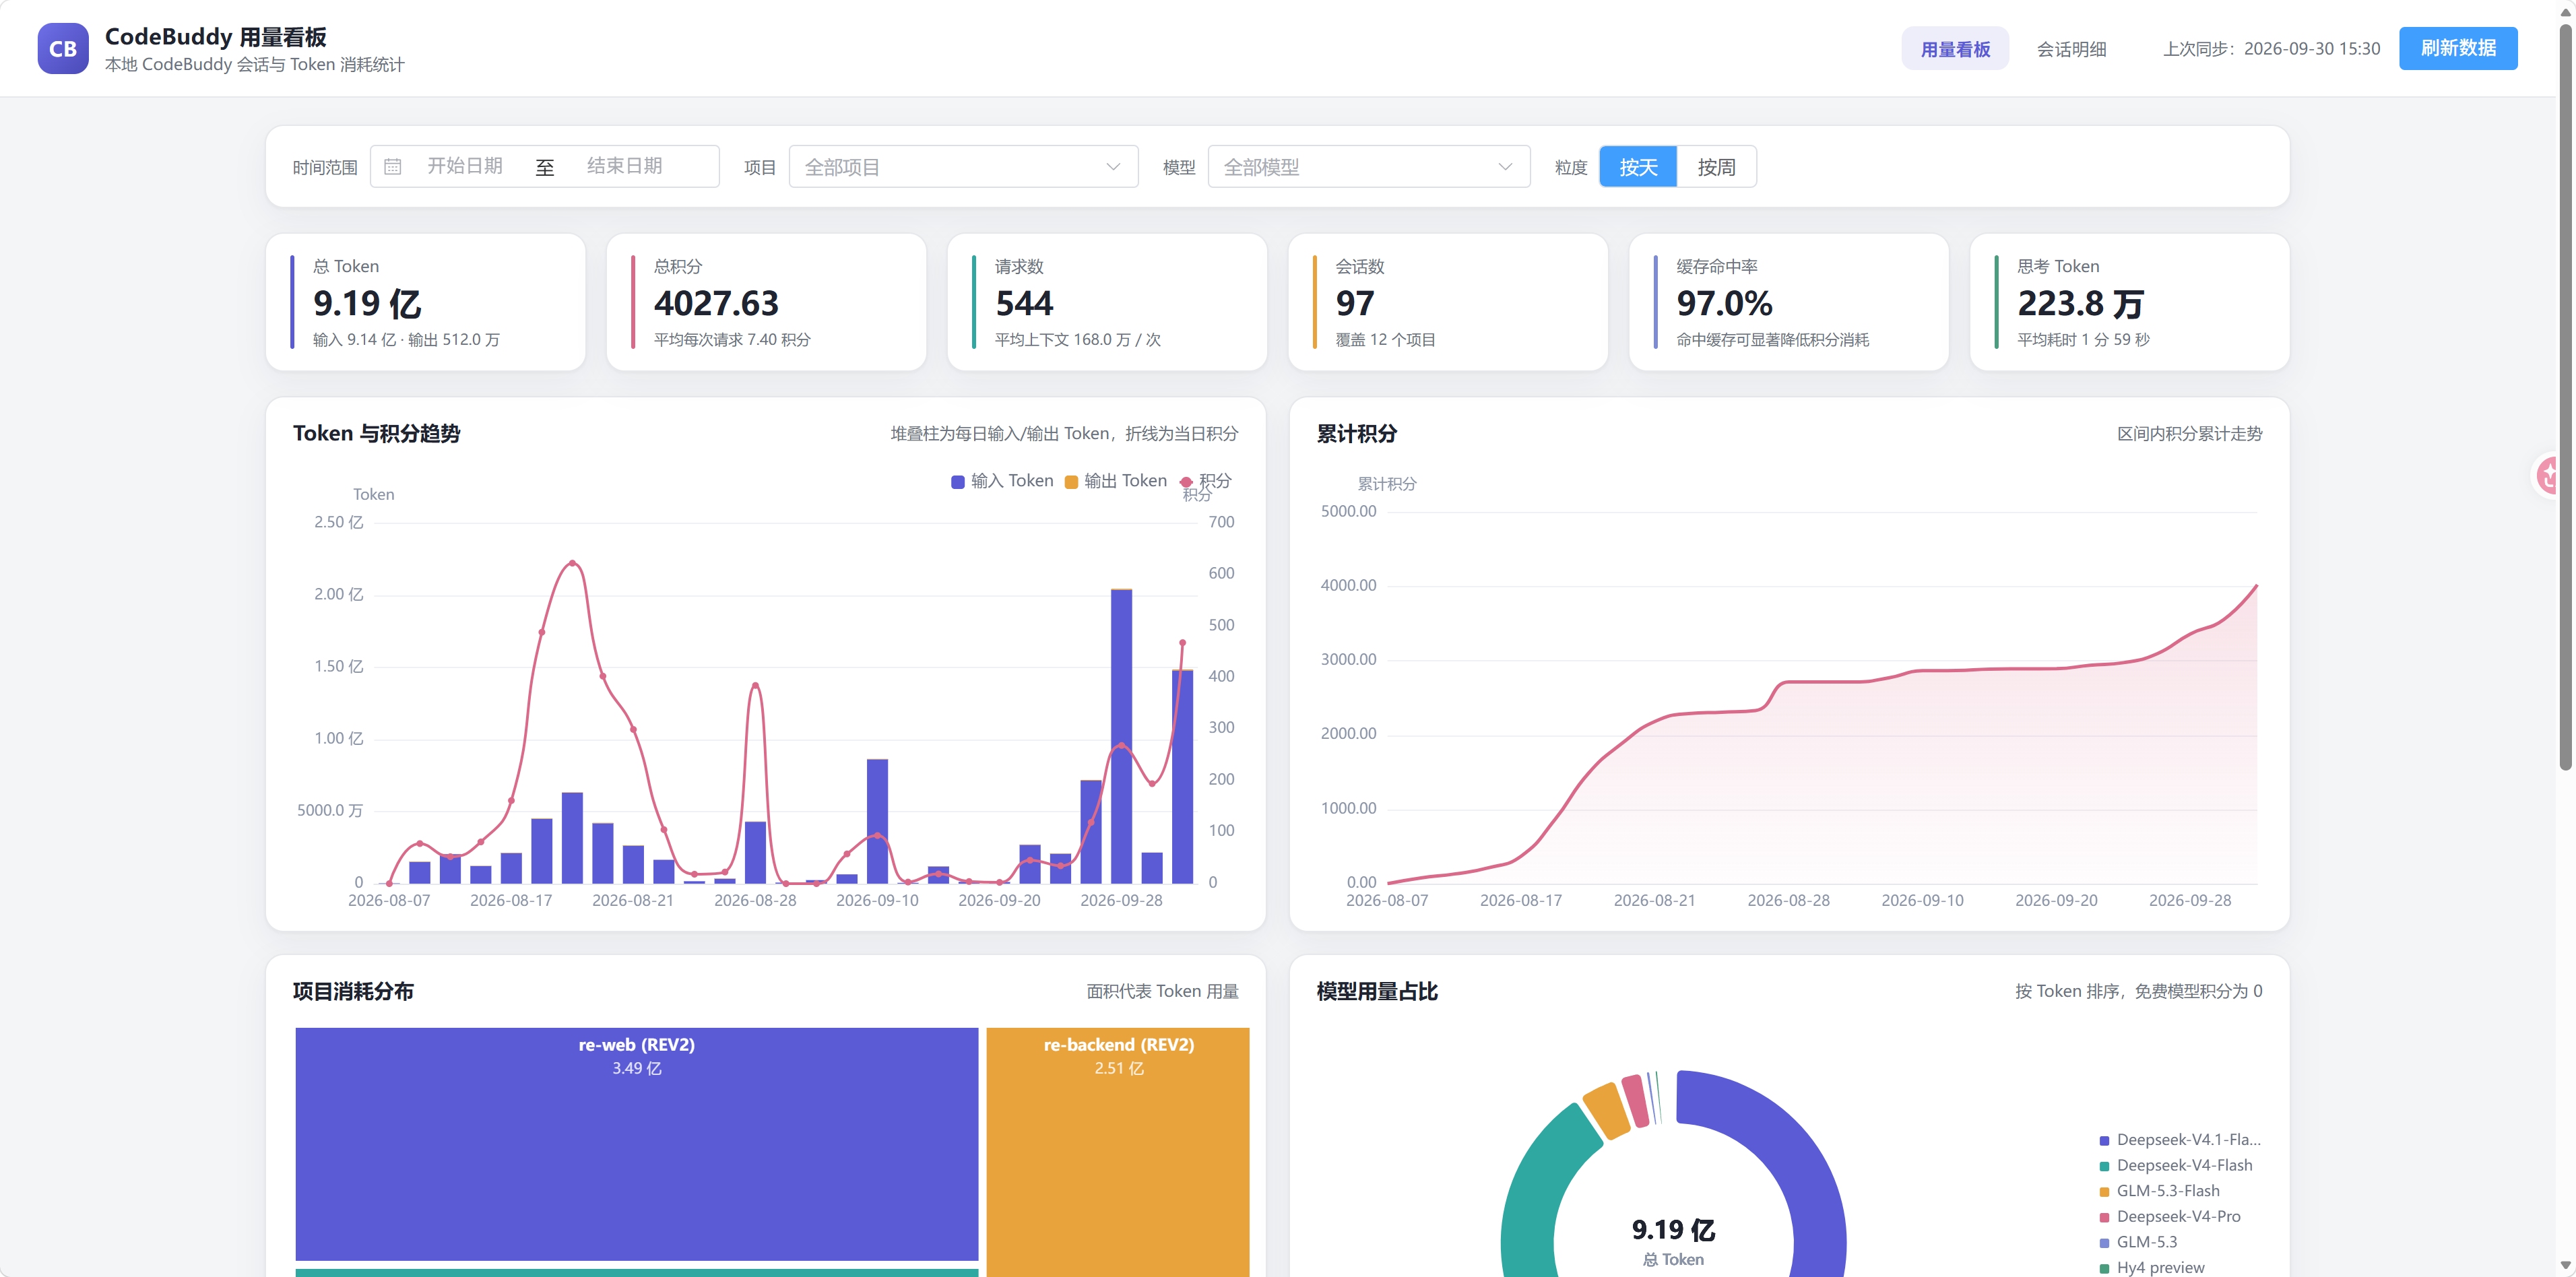
- 总览 KPI:总 Token、总积分、请求数、会话数、缓存命中率、思考 Token。
- 趋势:每日输入/输出 Token 堆叠柱 + 当日积分折线,以及区间累计积分曲线。
- 分布:项目消耗树图(面积 = Token)、模型用量环形图(含免费模型的 0 积分)。
- 热力:日历热力图按天展示积分消耗强度。
- 会话明细:分页列表 + 中文标题搜索,点开抽屉看逐请求明细(模型、缓存命中率、峰值上下文、思考 Token、耗时)。
- 筛选:时间范围、项目、模型任意组合,粒度可按天/按周切换。
3. 快速开始
后端环境要求 Python 3.12,前端使用 pnpm 构建。启动步骤如下:
bash
# 1. 后端环境(Python 3.12)
cd backend
python -m venv .venv
uv pip install --python .venv/Scripts/python.exe -e .
2. 前端依赖与构建
cd ../frontend
pnpm install
pnpm build
3. 启动(在项目根目录)
python run.py            # → http://127.0.0.1:9000
Windows 下也可以直接双击 start.bat(会自动检查前端产物、必要时构建)。首次启动会自动全量解析本地数据(约 1 秒)并写入 data/codebuddy_cache.db,之后每次启动只做增量检查(约 100ms)。
3.1 开发模式
bash
# 终端 1
cd backend && .venv/Scripts/python.exe -m uvicorn app.main:app --reload --port 9000
终端 2
cd frontend && pnpm dev        # → http://localhost:5173,/api 已配置代理到 9000
注意:
uv venv生成的python.exe在部分 Windows 策略下会被应用程序控制策略拦截,因此后端环境固定用python -m venv创建,uv只用来装包。
4. 数据来源
CodeBuddy 把数据写在 %LOCALAPPDATA%\CodeBuddyExtension\(不在 VSCode 的 globalStorage 里)。各路径与内容对应关系如下:
| 路径 | 内容 |
|---|---|
Data/<账号>/VSCode/<账号>/history/<workspaceHash>/<会话ID>/index.json |
会话与请求元数据,requests[].usage 是每请求的权威用量 |
Data/.../messages/<消息ID>.json |
单条消息,模型名与 statsSnapshot(思考 Token、耗时)在这里 |
Logs/VSCode/<日期>/*.log |
每步 usage: 明细,只滚动保留约 10 天(本工具未使用) |
4.1 关键口径
usage.inputTokens是各 step 累计上下文之和(每步都会重发完整历史),因此它就是真实计费量,不是重复计数。credit是 CodeBuddy 计费积分。免费预览模型(hy3、hy4-preview)的credit为 0 是真实值,不是缺失。- 模型名只存在于消息文件里,通过
extra.requestId == requests[].id关联(实测 100% 命中)。 - 会话所在目录名
workspaceHash可由工作区路径反推:md5(路径.replace('/', '\\') 且盘符小写、去前导反斜杠);无工作区窗口为md5("\\")。权威反查源是%APPDATA%\Code\User\workspaceStorage\*/workspace.json。
4.2 解析策略
不读全部消息文件。每个会话只读:最早一条 user 消息(抽标题)+ 每个已完成请求内最后一个 assistant 消息(取模型与快照),合计约 1090 / 12692 个文件(8.6%),冷启动不到 1 秒。为规避 VSCode 运行中原地重写文件、以及 file-tree/ 里的超长路径(Windows MAX_PATH),扫描只做两级 glob + 定点读取,并对每个文件做重试与容错跳过。
5. 项目结构
text
codebuddy_token/
├─ run.py                      # 启动入口
├─ start.bat                   # Windows 双击启动
├─ PLAN.md                     # 设计与数据契约
├─ data/codebuddy_cache.db     # SQLite 缓存(可随时删除重建)
├─ backend/
│  ├─ pyproject.toml
│  ├─ scripts/verify.py        # 对账脚本
│  └─ app/
│     ├─ main.py               # FastAPI 实例、CORS、SPA 托管
│     ├─ config.py             # 路径配置(支持环境变量覆盖)
│     ├─ db.py / schema.sql    # 连接与建表
│     ├─ refresh.py            # 增量刷新编排
│     ├─ ingest/               # 扫描 / 解析 / 入库 / 工作区解析
│     └─ api/                  # 路由 / 响应模型 / 聚合 SQL
└─ frontend/                   # Vue 3 + TS + Vite + Element Plus + ECharts
   └─ src/{api,stores,components,views}
数据库共 6 张表:workspace、conversation、request、message_stat、scan_file(增量指纹账本)、sync_meta。增量以会话为失效单元:(mtime_ns, size) 指纹变化 → 级联删除并重新解析;磁盘上消失 → 一并删除。整个写入过程在单个事务内完成。
6. 接口设计
所有接口支持共享筛选参数:start_date、end_date(本地时区,闭区间)、workspace(可重复)、model(可重复)。
| 方法 | 路径 | 说明 |
|---|---|---|
| GET | /api/overview |
KPI 汇总:Token、积分、请求/会话/项目数、缓存命中率、思考 Token、平均耗时 |
| GET | `/api/timeseries?granularity=day | week` |
| GET | /api/projects |
按项目汇总 |
| GET | /api/models |
按模型汇总(含缓存命中率) |
| GET | /api/conversations?page=&size=&q=&sort=&order= |
会话列表(分页、标题搜索、排序) |
| GET | /api/conversations/{id} |
会话详情:逐请求明细 |
| POST | /api/refresh |
触发增量刷新,返回 added/updated/deleted/errors/duration_ms |
| GET | /api/meta |
上次同步时间、库路径、项目/会话总数 |
接口文档:http://127.0.0.1:9000/docs
6.1 环境变量
| 变量 | 默认值 | 用途 |
|---|---|---|
CODEBUDDY_DATA_ROOT |
%LOCALAPPDATA%\CodeBuddyExtension\Data |
数据根目录 |
CODEBUDDY_WORKSPACE_STORAGE |
%APPDATA%\Code\User\workspaceStorage |
工作区映射来源 |
CODEBUDDY_DB |
./data/codebuddy_cache.db |
缓存库路径 |
CODEBUDDY_DIST |
./frontend/dist |
前端产物路径 |
7. 验证与对账
bash
backend/.venv/Scripts/python.exe backend/scripts/verify.py脚本会做四件事,退出码非 0 表示失败:
- 对照实测基准值 断言库内聚合:input
913,734,087、output5,119,598、credit4027.63、544 次请求、97 个会话、542 条快照、9 个模型的分布逐一比对。 - 独立重走一遍 JSON(不复用应用代码)交叉核对总量与按项目小计。
- 恒等式检查 :
total = input + output、input = cache + miss违例数必须为 0。 - 增量幂等 :连续刷新两次,第二次必须
updated = deleted = errors = 0。
基准值对应 2026-09-30 的本地快照。随着继续使用 CodeBuddy,数值会增长,此时应更新
verify.py里的EXPECTED常量(独立遍历与恒等式检查仍然有效)。
8. 已知限制
- 不做
Logs/的单请求 step 级钻取,因此看不到一次请求内 Token 随 step 的增长曲线(日志只有约 10 天)。 - 会话标题取自
<user_query>块;少数以引用/命令开头的会话会显示成路径片段,6 个空会话无标题。 - 项目名相同时会附加父目录消歧(如
re-web (Desktop)与re-web (D:)),所有图表以 hash 为 key、显示名仅作标签。 - 前端产物约 1.7MB(Element Plus 全量引入);本地工具未做按需引入优化。
- 页面按容器宽度自适应(
auto-fit栅格),窄窗口下会自动折叠为单列。
9. 总结
CodeBuddy 用量看板是一个完全本地化的数据解析与可视化工具。它不依赖任何官方接口,也不会上传任何数据,所有统计都基于本机磁盘上的会话与消息文件。通过增量指纹与单事务写入,冷启动与日常刷新都非常轻量。对于希望精确掌握自己 Token 与积分消耗的开发者来说,这是一个实用且透明的本地解决方案。