【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
239、【AI】【模型部署】基座模型研究:反向传播的已知、所求与场景
背景
上篇 blog
把前向单独讲清了:前向就是"把模型跑一遍"------输入经嵌入、N 个 Block、归一化、输出头得到 logits,再经 softmax 变成概率、由交叉熵汇总出一个标量损失 L L L ;它全程只算数值、不涉及求导,已知输入与参数,产出损失与中间激活缓存,并且训练与推理都要做前向。
前向交付了那个标量 L L L------"这一步错了多少"。但训练要改的是成千上万个参数 ,一个笼统的 L L L 显然不够用。于是自然引出本篇的三个问题:反向传播已知什么、算什么,又用在哪? 上篇留下的"中间激活缓存"到这里终于派上用场。
模型部署
第 237 篇讲过反向传播的数学内核(链式法则与计算图)。这篇换个工程问答 的视角,把最常卡住的几件事一次说清:反向的输入输出是什么、它凭什么一次算出全部梯度、 p − y p-y p−y 这个漂亮结果从哪来、以及它到底只在训练里出现还是推理也要。
🧩 反向传播在回答一个问题
一句话:把"错了多少"按贡献摊到每个参数上,得到"每个参数该往哪改、改多少"。
前向从输入走到损失,是把信息"汇拢"成一个数;反向则从这一个数出发,把影响"分摊"回每一个参数。前者是"由因到果",后者是"由果溯因"。
📊 已知什么:前向的产物
反向量不是凭空启动的,它的输入正是前向的输出:
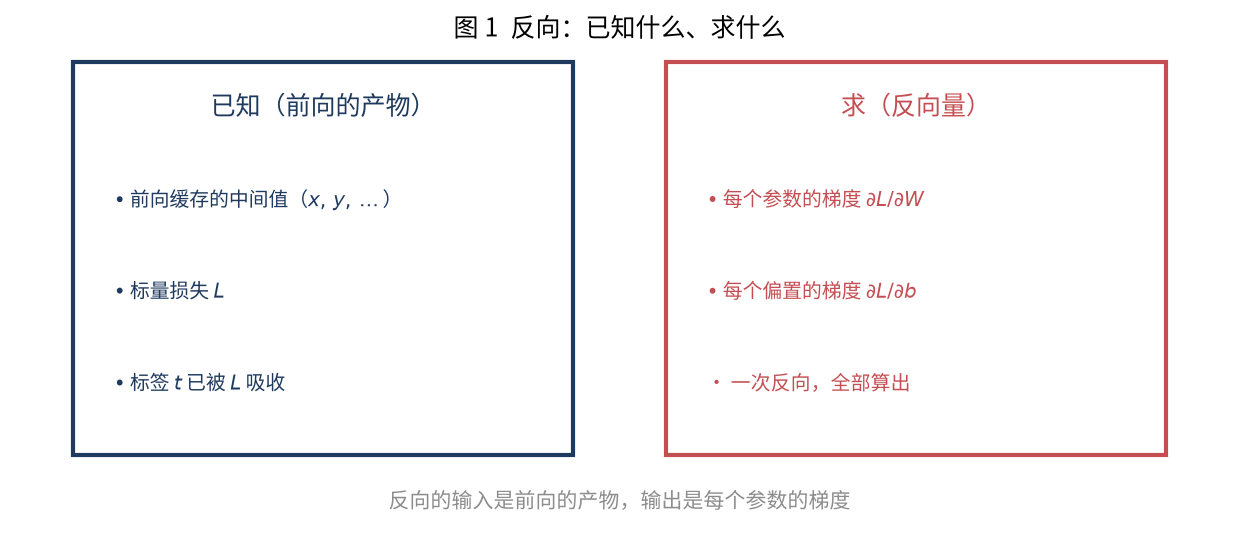
图 1 列清了两侧。已知的是:
- 前向缓存下来的中间值 (如各层的激活、以及链式法则里要用到的 x x x、 y y y);
- 标量损失 L L L,它是反向的起点。
注意一点:标签 t t t 不需要再单独传入 ------它在算损失时已经被吸收进 L L L 了。反向要做的是"从 L L L 出发",而不是"从标签出发"。
🧩 求什么:每个参数的梯度
要算的是 L L L 对每个参数 的偏导数 ∂ L / ∂ W \partial L/\partial W ∂L/∂W。它回答"把 W W W 调大一点点, L L L 会变大还是变小、变多少":符号给方向,绝对值给幅度。
关键在于规模 :真实模型有几十亿个参数,若逐个去问"它变了损失会怎样",代价无法承受。反向传播的价值就在于------一次反向,把所有参数的梯度一起算出来 ,代价只比一次前向多一个常数倍(约 2~3 倍)。这就是反向模式自动微分(reverse-mode automatic differentiation) ,也是各框架 autograd 的实现方式。
🧩 怎么算:从损失往回走
算法本身在第 237 篇讲透了,这里只留结论:把每一步运算看成计算图上的节点,反向就是沿同一条图逆序走回去,每到一个节点,用
上游传来的梯度 × 本节点的局部导数 \text{上游传来的梯度}\ \times\ \text{本节点的局部导数} 上游传来的梯度 × 本节点的局部导数
算出对流经变量的梯度,再继续往上游传:
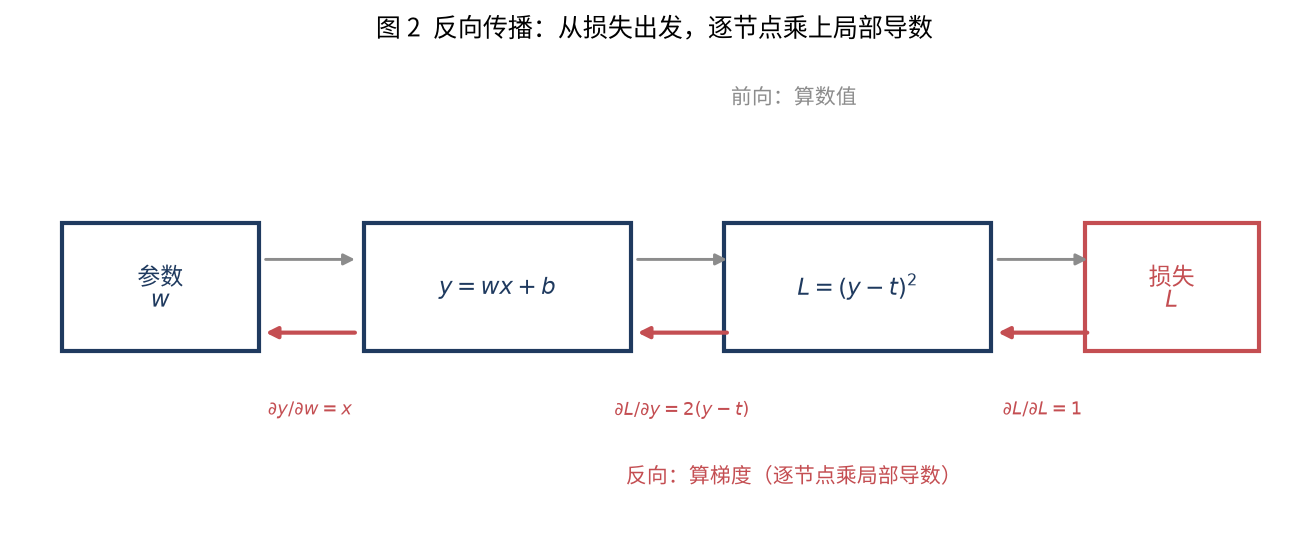
图 2 里,灰色箭头是前向,红色箭头是反向。以最简单的 y = w x + b , L = ( y − t ) 2 y=wx+b,\ L=(y-t)^2 y=wx+b, L=(y−t)2 为例,往回乘两段局部导数,就得到 ∂ L / ∂ w = 2 ( y − t ) ⋅ x \partial L/\partial w=2(y-t)\cdot x ∂L/∂w=2(y−t)⋅x------其中 y y y 和 x x x 正是前向缓存下来的值。
用一个具体数验证一遍( x = 1 , b = 0 , t = 1 , w = 0.5 x=1,\ b=0,\ t=1,\ w=0.5 x=1, b=0, t=1, w=0.5):前向已算出 y = 0.5 y=0.5 y=0.5、 L = 0.25 L=0.25 L=0.25,反向从 L L L 出发逐段往回乘:
| 求导对象 | 计算 | 结果 |
|---|---|---|
| ∂ L / ∂ y \partial L/\partial y ∂L/∂y | 2 ( y − t ) 2(y-t) 2(y−t) | − 1 -1 −1 |
| ∂ y / ∂ w \partial y/\partial w ∂y/∂w | x x x | 1 1 1 |
| ∂ L / ∂ w \partial L/\partial w ∂L/∂w | ∂ L / ∂ y ⋅ ∂ y / ∂ w \partial L/\partial y\cdot\partial y/\partial w ∂L/∂y⋅∂y/∂w | − 1 -1 −1 |
| ∂ L / ∂ b \partial L/\partial b ∂L/∂b | ∂ L / ∂ y ⋅ 1 \partial L/\partial y\cdot 1 ∂L/∂y⋅1 | − 1 -1 −1 |
梯度为负,说明把 w w w、 b b b 调大 会让损失变小;于是更新 w ← w − η ( − 1 ) = 0.5 + η w\leftarrow w-\eta(-1)=0.5+\eta w←w−η(−1)=0.5+η, y y y 向目标 1 1 1 靠近。整个过程没有一处新的前向,全部靠缓存与乘法完成。
🧩 为什么不用数值求导
一个朴素想法是"把某个参数扰动一下、看损失变化多少",也就是数值微分。它有两个硬伤:
- 代价太高 :每动一个参数都要重跑一次前向, N N N 个参数就是 N N N 次前向,千亿参数直接不可行;
- 精度太差:有限差分会引入截断误差,还容易被浮点误差淹没。
反向传播只做"一次前向 + 一次反向"就把全部梯度算出来,代价与前向同阶------这才是它能训练大模型的根本原因(第 237 篇展开过)。
🧩 重点:为什么 softmax + 交叉熵的梯度恰好是 p − y p-y p−y
第 237 篇直接给出了这个结论,却没有说明它从哪来。这里把它补全------它并不是巧合,而是两类导数相乘后恰好相消的结果。 记 softmax 后的概率为 p j p_j pj、logits 为 z i z_i zi,交叉熵(one-hot 标签)为
L = − ∑ j y j log p j L = -\sum_j y_j \log p_j L=−j∑yjlogpj
第一步:损失对概率求导。 只有真实项 j = y j=y j=y 的 y j y_j yj 为 1,其余为 0,于是
∂ L ∂ p j = − y j p j \frac{\partial L}{\partial p_j} = -\frac{y_j}{p_j} ∂pj∂L=−pjyj
第二步:概率对 logits 求导。 softmax 的导数有两类情况( i i i 是要求梯度的那个 logit):
∂ p j ∂ z i = p j ( δ i j − p i ) \frac{\partial p_j}{\partial z_i} = p_j\,(\delta_{ij} - p_i) ∂zi∂pj=pj(δij−pi)
其中 δ i j \delta_{ij} δij 在对角( i = j i=j i=j)为 1、其余为 0:某个 logit 变大,会抬高自己的概率、同时压低所有别的概率。
第三步:链式法则把两者相乘、再对 j j j 求和。
∂ L ∂ z i = ∑ j ∂ L ∂ p j ⋅ ∂ p j ∂ z i = ∑ j ( − y j p j ) ⋅ p j ( δ i j − p i ) = ∑ j ( − y j ) ( δ i j − p i ) \frac{\partial L}{\partial z_i}=\sum_j \frac{\partial L}{\partial p_j}\cdot\frac{\partial p_j}{\partial z_i} =\sum_j\left(-\frac{y_j}{p_j}\right)\cdot p_j\,(\delta_{ij}-p_i) =\sum_j(-y_j)(\delta_{ij}-p_i) ∂zi∂L=j∑∂pj∂L⋅∂zi∂pj=j∑(−pjyj)⋅pj(δij−pi)=j∑(−yj)(δij−pi)
拆开求和,第一项 − ∑ j y j δ i j = − y i -\sum_j y_j\delta_{ij}=-y_i −∑jyjδij=−yi,第二项 + p i ∑ j y j = p i +p_i\sum_j y_j=p_i +pi∑jyj=pi(因为标签求和为 1)。两式相加,中间那坨复杂的 softmax 导数恰好消掉,只剩:
∂ L ∂ z i = p i − y i \frac{\partial L}{\partial z_i} = p_i - y_i ∂zi∂L=pi−yi
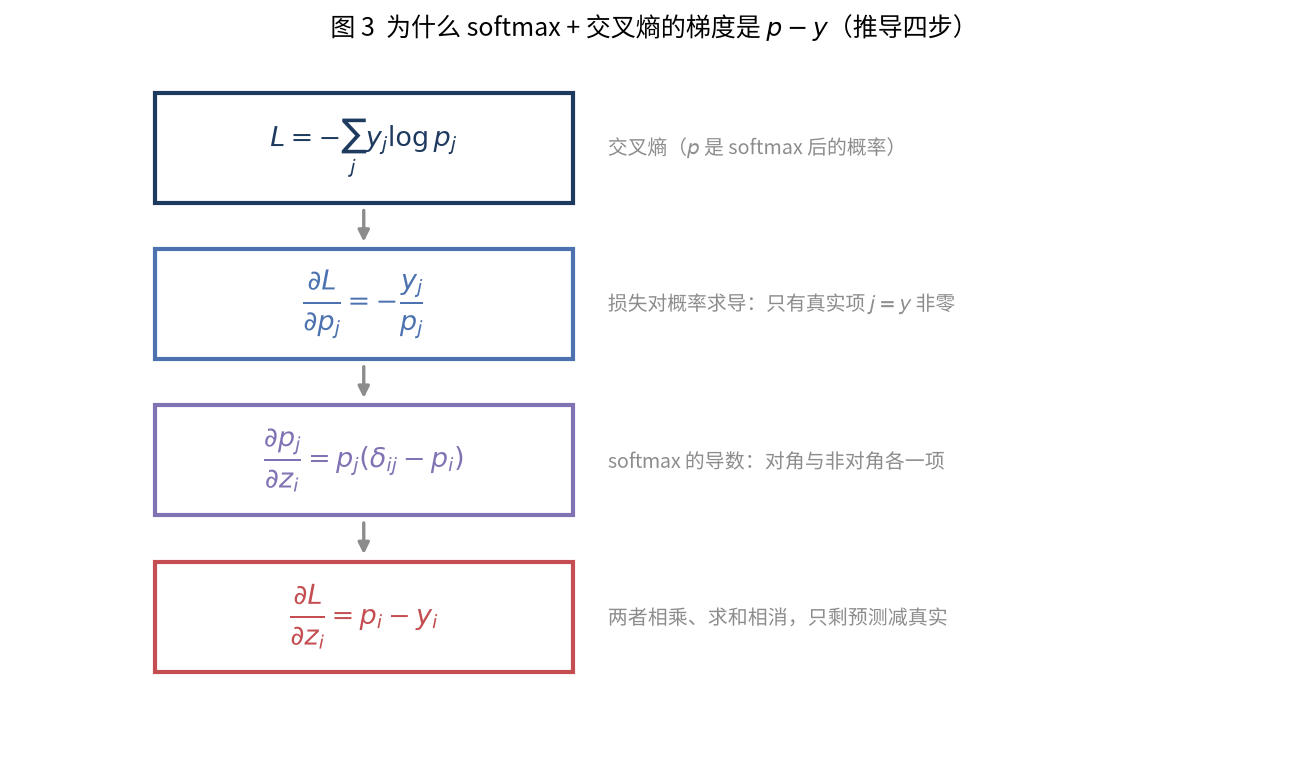
图 3 把推导拆成四步。结果的直觉很直白:p i − y i p_i-y_i pi−yi 就是把"预测多给的分"扣回去、把"少给的分"补回来------预测概率高于真实标签,梯度为正(该下调);低于真实标签,梯度为负(该上调)。这也解释了交叉熵为什么"好训练":梯度天然带着方向,不需要额外缩放。
这一结果只发生在softmax 与交叉熵的组合上(例如语言模型的输出层);换成别的损失与激活组合,梯度形式就不会这么干净。
🧩 算完之后:梯度去哪了
反向算出的是每个参数的 .grad,它自己不会改参数,还要交给优化器:
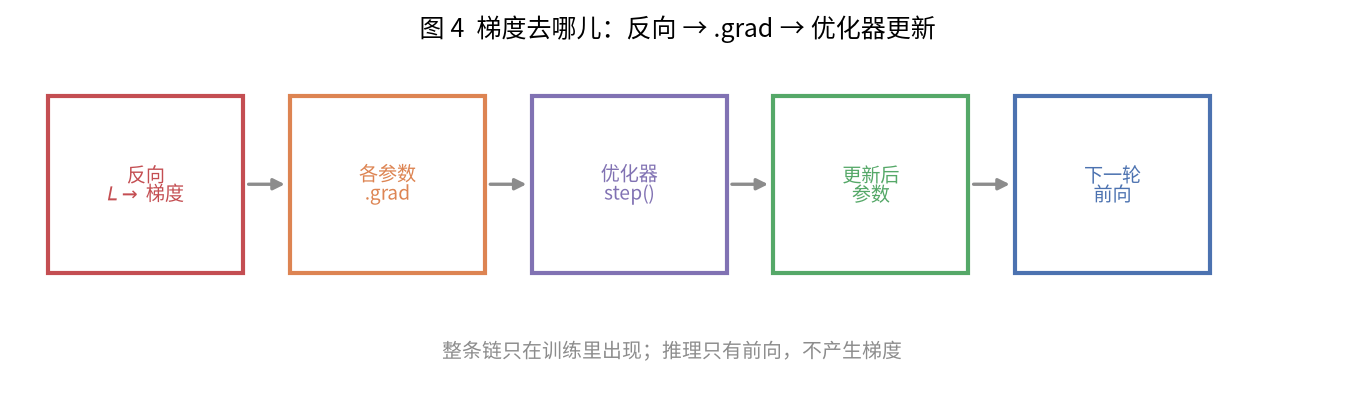
图 4 是这条链:反向 → 各参数 .grad → 优化器 step() → 更新后的参数 → 下一轮前向。对应的三行代码(第 237 篇提过):opt.zero_grad() 清空上一轮梯度、loss.backward() 填好 .grad、opt.step() 用梯度更新。更新规则最朴素的形式是随机梯度下降(Stochastic Gradient Descent,SGD): W ← W − η ∂ L / ∂ W W \leftarrow W - \eta\,\partial L/\partial W W←W−η∂L/∂W;实践中常用 AdamW。
📊 用在哪:只在训练,不在推理
这是最常被问的一点:反向传播只出现在训练里。 原因也很直接------反向的产物是"梯度",而梯度的唯一用途是改参数;推理阶段参数是固定的,根本不需要改,自然不需要反向。
| 场景 | 前向 | 反向 | 更新 | 说明 |
|---|---|---|---|---|
| 训练 | 要 | 要 | 要 | 每步:前向 → 损失 → 反向 → 更新 |
| 推理 | 要 | 不要 | 不要 | 只要预测,参数不动 |
换句话说:"要不要反向"取决于"要不要改参数"。 这也正是训练比推理更贵、更吃显存的原因之一------推理不必保存激活缓存、更不必做反向。
🧩 两个常见误区
- "反向传播就是一个求导公式" :不准确。它真正的价值是计算图上的组织方式------沿图逆序、逐节点复用中间值与局部导数,让"求全部梯度"的代价与前向同阶;
- "推理也要反向才能生成":不成立。生成只用前向得到的概率分布采样,梯度只服务于"改参数"这一件事。
分清这两点,就不会把"反向传播"与"推理流程"混在一起了。
📌 一句话记忆
反向传播已知的是前向的产物(缓存中间值与标量损失 L L L),求的是每个参数的梯度 ∂ L / ∂ W \partial L/\partial W ∂L/∂W,靠链式法则在计算图上逆序、逐节点乘局部导数,一次就能算出全部梯度;softmax 与交叉熵组合时,损失导数与 softmax 导数相乘后相消,恰好得到 p − y p-y p−y;梯度写进
.grad交给优化器改参数,因此反向只在训练用、推理不用。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!!更多内容见下篇 blog