上一篇我们说,Agent 会在对话后提炼出"用户偏好靠窗"这类事实,存进长期记忆。可"存"这个动作,其实大有讲究:同一句"用户在 TechCorp 工作、是高级工程师、负责推荐系统",可以存成三条孤立的便签,也可以存成一张带身份和情境的卡片。粒度不同,AI 用起来的效果天差地别。
下面就从"怎么存"和"存什么"说起:四种记忆格式,一个把记忆写成代码的新思路,以及背后那套从人脑借来的分类法;最后,再看看开源社区里两个真实框架是怎么取舍的。
一、四种记忆格式:从"便签"到"档案卡"
同一条信息,可以用不同的粒度和结构来表示。书里给了四种渐进式格式,正好对应从"省事"到"好用"的连续光谱。
Simple Notes(极简便签) :每条记忆是一个不可再分的最小事实,比如"用户邮箱:john@example.com"。好处是开销极低、操作极快;坏处是完全丢掉了信息之间的关联------"在 TechCorp 工作""是高级工程师""负责推荐系统"被拆成三条,同一份工作的内在联系没了。要回答综合性的问题,系统得重新拼碎片。
Enhanced Notes(完整段落):用整体视角,把记忆存成一段带上下文的话:"用户在 TechCorp 担任高级软件工程师,专注机器学习三年,目前领导一个 5 人推荐系统项目。"语义完整、读起来像人话,代价是冗余(同一信息在多段里重复)和更新麻烦(一个属性变,得改好几段)。
JSON Cards(结构化卡片):用三层嵌套结构(类别→子类别→键值对,如 work.position.title),模拟人对信息的分类。它能局部更新(改职位不影响公司名),可预测、可扩展;但刚性分类有个假设------信息能被清晰归类。可"周末用 Python 写个人项目"同时涉及时间偏好、技术偏好、活动类型,硬塞进一个格子就丢了维度。
Advanced JSON Cards(情境化卡片):它标志着记忆从"信息存储"迈向"知识管理"。每张卡不只记事实,还附上信息来源的叙事背景(backstory)、主体身份(person)、与用户的关系(relationship)和时间戳。为什么需要这些?因为同一句话在不同情境下含义完全不同:"张医生"可能是你自己的牙医,也可能是你父亲的心脏科医生------脱离情境就没法正确理解。
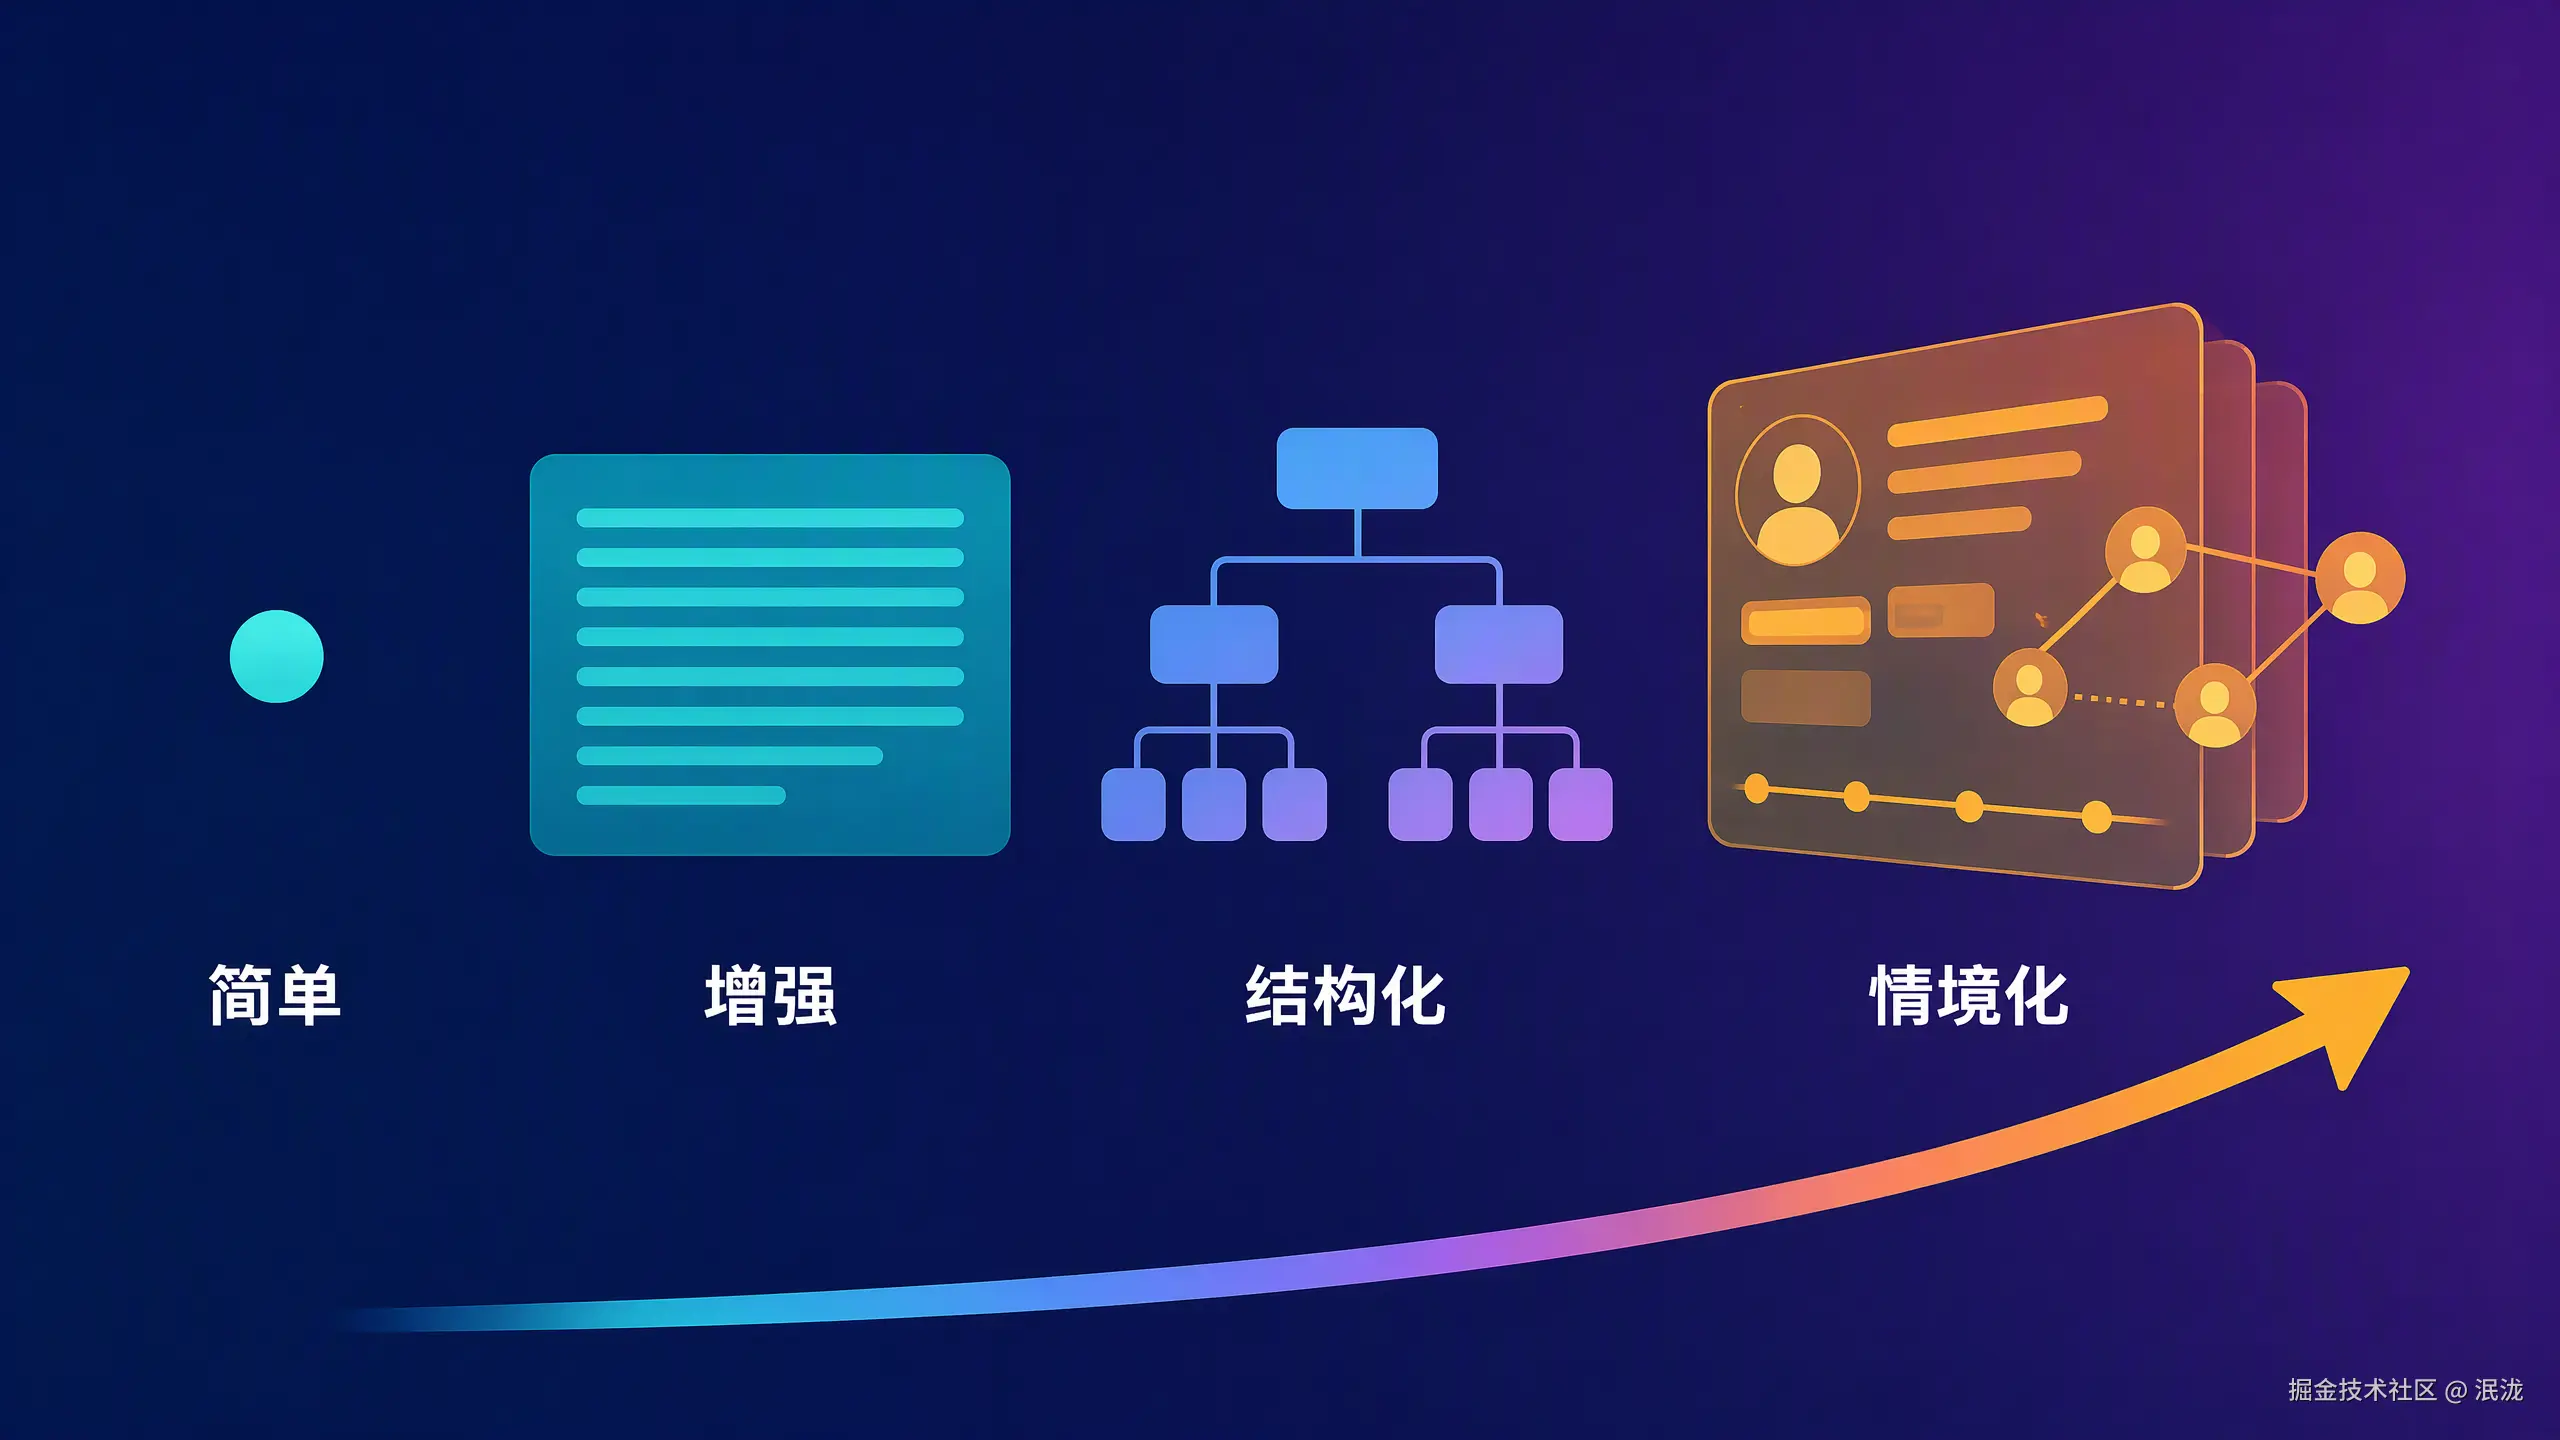
实践中的选择标准很务实:关键且少量 的信息(用户偏好、关键人物关系)用 Advanced JSON Cards 保检索质量;大量且非关键的对话事实用 Simple Notes 压成本。多数生产系统走混合路线------同一 Agent 内,不同类别的信息走不同通道。
二、更激进的一步:把记忆写成"可执行代码"
上面四种本质上都还是文本。文本擅长召回单条事实,可一旦要做聚合、查冲突、执行规则,就得靠大模型"读一遍再心算",既慢又容易错。
有个新思路叫 User as Code :把用户状态改成带类型的可执行对象,把规则写成普通函数。它借用数据库里的"预写日志 + 检查点":对话结束后先把事实追加到只增日志,再定期从完整日志重建出带类型的状态。这样既有原始证据,又得到一份可查询、可执行的档案。于是"统计今年有几次国际旅行""检查当前用药和过敏史是否冲突""护照快过期就自动预警"这类事,交给确定性函数即可,不必让模型心算。
三、从人脑借来的分类:存什么
设计格式之外,还有一个维度来自认知科学------记忆内容的类型。
认知科学把记忆分为工作记忆和长期记忆。工作记忆对应 Agent 的上下文窗口,是处理当前任务的临时空间(轨迹就是其中最核心的部分)。长期记忆又细分为三种,都能在 Agent 里找到对应:
-
情景记忆:具体的事件经历。人:"上周三和同事在一家意大利餐厅吃了顿好饭。" Agent:"用户订了下周五去东京的 ANA 航班。"
-
语义记忆:从事件里抽出来的一般知识。人:"意大利首都是罗马。" Agent:"用户是素食者""偏好靠窗座位。"
-
程序记忆:行为流程。人:骑自行车的能力。Agent:"先搜直飞→确认座位偏好→用常旅客号→订餐。"
聊到这里,其实已经牵扯出三套分类体系,容易混淆。一张表厘清它们的关系------它们是正交的三个维度,可以自由组合:
| 分类体系 | 回答的问题 | 具体类别 |
|---|---|---|
| 记忆层次 | 存在哪里? | 轨迹、用户长期记忆、业务状态 |
| 存储格式 | 怎么存? | Simple / Enhanced / JSON / Advanced JSON Cards |
| 认知类型 | 存什么? | 情景记忆、语义记忆、程序记忆 |
所以,"用户偏好靠窗"这条语义记忆 ,可以用 Simple Notes 存在用户长期记忆 里;而"先搜直飞→确认座位"这段程序记忆 ,可以用 Advanced JSON Cards 存。选哪种格式看工程取舍,存什么类型看业务场景。
四、看看真实框架怎么选:Mem0 与 Memobase
理论说完,落到工程。开源社区已有专门的记忆框架,这里看两个设计理念截然不同的代表。
Mem0 的演进很有意思。 在 2025 年的论文(arXiv:2504.19413)和 v2 里,它把"冲突处理"放在写入阶段 :对话结束后,大模型先抽取候选事实,再用向量检索找到相近的旧记忆,由模型在 ADD / UPDATE / DELETE / NOOP 里做决定。用户先"住北京"、后"搬上海",系统就把旧记忆 UPDATE 掉。好处是记忆库始终干净;风险是一次错误的更新或删除会不可逆地丢历史,而且每条候选都要跑一次检索加一次模型判断。
到了 2026 年的 v3,思路翻转成只追加写入 + 检索时推理:一次模型调用抽取事实,只做 ADD,"住北京"和"搬到上海"作为两条带时间的事实并存;查询时融合语义相似度、BM25 关键词和实体匹配,再结合时间排序。这样既不丢历史,又省模型调用,还能靠时间排序找出"当前事实"。Mem0 报告说,这套改动让 LoCoMo 从 71.4 提升到 92.5。
Memobase 走的是另一条路。 它不追求通用流水线,而是聚焦"用户画像"这一形态:用户画像(Profile) 是一组开发者可配置的槽位(如 basic_info→姓名、interest→兴趣、work→职位),存放从对话里提取的稳定属性;事件记忆(Event Memory) 则按时间线记录用户经历,用来回答"我们上次聊预算是啥时候"这类问题。工程上它用缓冲批处理------对话先在缓冲区攒着,到量或到点再统一提取,摊薄模型调用成本。
把两个框架对照着看会发现:Mem0 的事实条目更像语义记忆,Memobase 的画像近似语义记忆、事件记忆近似情景记忆。它们各自只覆盖了记忆设计空间的一部分------按需取舍,往往比追求"大而全"更现实。
五、两个绕不开的现实问题:遗忘与隐私
记忆会越攒越多,于是必须解决"怎么省"和"怎么安全"。
记忆压缩分三层:先用重要性评分筛选(综合访问频率、时间衰减、情感强度、信息独特性),低于阈值的压缩或删除;再把相似记忆聚类、每组生成一条代表性摘要,原始细节归档到二级存储;最后做抽象泛化,从具体事件里抽出一般规律,转化为语义或程序记忆。
日志脱敏 则关乎隐私。核心矛盾是:既要让 Agent 用你的信息提供个性化服务,又不能把敏感数据暴露在模型上下文和系统日志里。一个巧妙做法是用本地小模型做 PII(个人身份信息)识别与脱敏------比如通过 Ollama 跑一个 Qwen3 0.6B,在 CPU 上就能跑,因为"把日志发到云端去脱敏"本身就已经违背了隐私的初衷。相比传统正则,基于大模型的脱敏召回率能到 95% 以上。
小结
"怎么存"和"存什么",到这篇基本讲透了:四种存储格式是一条从省事到好用的光谱,认知科学又给了情景/语义/程序三种内容类型,两者正交组合;真实框架 Mem0、Memobase 各自押注了设计空间的一部分;最后还有压缩与脱敏两道工程关口。
存好了记忆,还有一个绕不开的问题:当记忆成千上万条时,怎么在需要的那一刻,快速找到相关的那几条? 这就要请出下一篇的主角------RAG(检索增强生成)。
延伸阅读(开源项目) :记忆框架可以看 Mem0 (github.com/mem0ai/mem0)和 Memobase (github.com/memodb-io/memobase);想理解"记忆即代码"可搜 User as Code ;本地脱敏用 Ollama 跑 Qwen3 小模型即可复现。