本文摘要:500 万行表加二级索引后计划显示走了索引,查询仍然明显偏慢。覆盖索引配合 VACUUM 更新可见性映射,可把回表的随机读降下来。低选择性时顺序扫描更快,写密集表与小表不适用此路线。
一、问题与结论
线上业务库为 PostgreSQL 14.x,orders 表约 500 万行,payload 列用 repeat('x', 200) 把单行撑到约 240 字节。给 status 建 idx_orders_status 后,EXPLAIN 输出 Index Scan on orders,接口延迟没有回落。
结论先给:Index Scan 只说明索引参与了行定位,取 amount 仍要按 TID 读堆表页(回表);命中行占比越高随机读越贵,低选择性时 Seq Scan 反而更快;Index Only Scan 只是"可能"跳过堆页,必须看 Heap Fetches 是否为 0。下文的行数与耗时均标注为预期输出,未在读者环境实测。
二、排查与选择依据
诊断顺序:EXPLAIN (ANALYZE, BUFFERS) → 对比 rows= 与 actual rows → 看 shared read 与 Heap Fetches → 检查 pg_stats 是否过时。只跑 EXPLAIN 看到的是规划器预估,无法判断真实开销。
三个观察点:
- 回表量:
Index Scan拿到 TID 后要读堆页取amount,命中 400 万行等于数百万次堆页访问。 - 选择性:
status = 'active'覆盖约 80% 行,索引没有减少多少数据,只是把顺序读换成随机读。 - 统计过时:批量
UPDATE200 万行后不执行ANALYZE,规划器按旧直方图估 100 万行并选Index Scan,实际命中 350 万行,耗时高于Seq Scan;执行ANALYZE orders后重新估算,可能改选顺序扫描。
替代方案与取舍
| 做法 | 适用条件 | 代价 | 边界 |
|---|---|---|---|
INCLUDE 覆盖索引 |
查询列固定、PostgreSQL 11+ | 索引变大,写入多维护一份 | SELECT * 或列频繁变化 |
定期 VACUUM (ANALYZE) |
全场景基线 | 与业务 I/O 竞争 | 不减少回表行数 |
CLUSTER 重排表 |
索引列与查询排序相关 | 锁表耗时,写入后退化 | 写密集表需反复重排 |
| 物化视图 | 聚合报表查询 | 刷新延迟、额外存储 | 需要实时数据 |
强制 Seq Scan |
命中占比极高 | 放弃其他查询的索引收益 | 只做对照验证 |
不该用"覆盖索引 + VACUUM"路线的情况:SELECT * 或返回列不固定;高频 UPDATE/DELETE 的写密集表,索引写放大与膨胀会吃掉收益;几千行以内的小表顺序扫描更快,二级索引只有维护开销。
三、关键原理
B-tree 索引只保存键值与 TID,amount 等非键列仍在堆表;INCLUDE (id, amount) 把附加列写进叶页(PostgreSQL 11+),才有机会走 Index Only Scan。是否真的跳过堆页由可见性映射决定:某页元组对所有事务均可见时 VACUUM 才置 VM 位,否则 Heap Fetches > 0,仍会回表。autovacuum 按 dead tuple 阈值触发,刚插入的活元组不会让它立即置位,所以批量导入后常见"看着是 Index Only Scan,实际还在读堆页"。
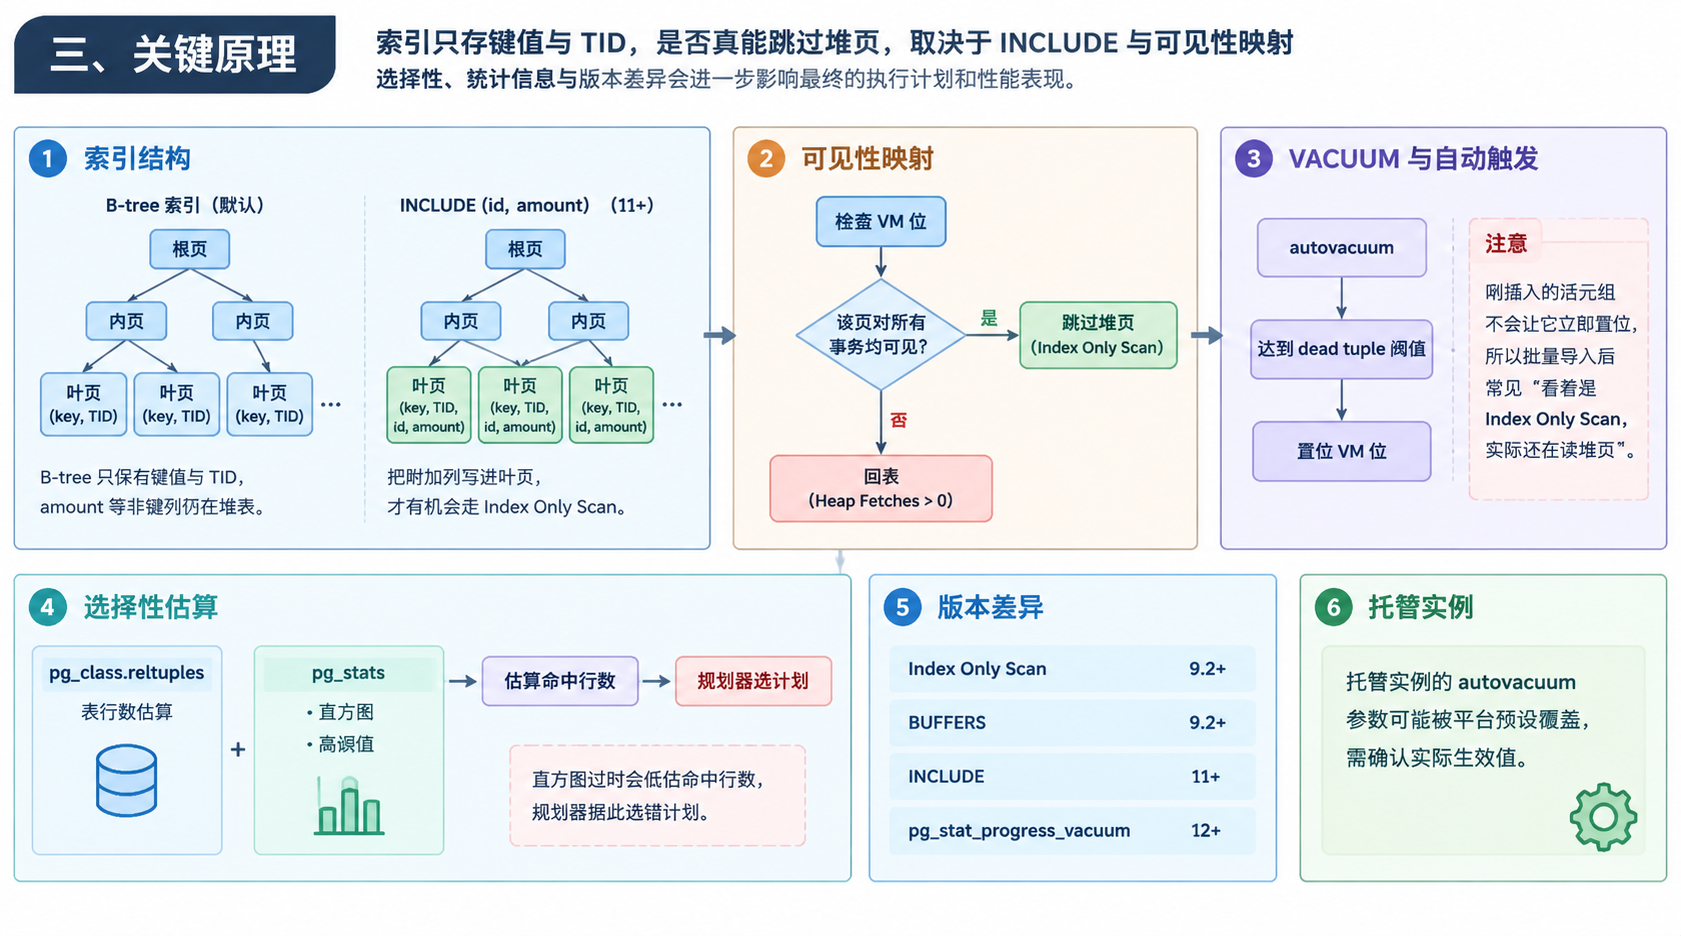
选择性估算来自 pg_class.reltuples 与 pg_stats 的直方图、高频值;直方图过时会低估命中行数,规划器据此选错计划。版本差异:Index Only Scan 与 BUFFERS 自 9.2 起可用,INCLUDE 需 11+,pg_stat_progress_vacuum 需 12+;托管实例的 autovacuum 参数可能被平台预设覆盖,需确认实际生效值。
四、可运行示例
环境与输入:PostgreSQL 12+(脚本按 14.x 编写),可自由建表的测试库,SSD 磁盘,shared_buffers 与 random_page_cost 未调优;输入 500 万行,status='active' 约占 80%。
sql
DROP TABLE IF EXISTS orders;
CREATE TABLE orders (
    id      BIGSERIAL PRIMARY KEY,
    status  TEXT NOT NULL,
    amount  NUMERIC(10,2) NOT NULL,
    payload TEXT NOT NULL DEFAULT repeat('x', 200)
);
INSERT INTO orders (status, amount)
SELECT CASE WHEN random() < 0.8 THEN 'active' ELSE 'inactive' END,
       round((random() * 10000)::numeric, 2)
FROM generate_series(1, 5000000);
CREATE INDEX idx_orders_status ON orders (status);
ANALYZE orders;

EXPLAIN (ANALYZE, BUFFERS) SELECT id, amount FROM orders WHERE status = 'active';

CREATE INDEX idx_orders_status_covering ON orders (status) INCLUDE (id, amount);
VACUUM (ANALYZE) orders;
EXPLAIN (ANALYZE, BUFFERS) SELECT id, amount FROM orders WHERE status = 'inactive';

SET enable_indexscan = off;
SET enable_indexonlyscan = off;
SET enable_bitmapscan = off;
EXPLAIN (ANALYZE, BUFFERS) SELECT id, amount FROM orders WHERE status = 'active';
RESET enable_indexscan;
RESET enable_indexonlyscan;
RESET enable_bitmapscan;

DROP TABLE orders;
预期输出:第一条查询的计划节点可能是 Index Scan on orders(若统计准确,规划器也可能直接选 Seq Scan,这正说明选择性判断生效),actual rows 约 400 万;INCLUDE 索引加 VACUUM (ANALYZE) 之后应出现 Index Only Scan using idx_orders_status_covering,且 Heap Fetches 为 0 或接近 0;最后一条 Seq Scan on orders 的 Execution Time 应低于第一条。以上为预期输出,数值随硬件、缓存与并发变化。
实际输出:以本库的 EXPLAIN (ANALYZE, BUFFERS) 为准,记录三次执行的 Execution Time 与 Heap Fetches。验证成立的条件是第三条快于第一条,且 Index Only Scan 的 Heap Fetches 归零;若 Heap Fetches 仍是六位数,说明可见性映射未覆盖。
常见失败:批量导入 500 万行后建 INCLUDE 索引并立即查询,计划显示 Index Only Scan,Heap Fetches: 350000+,耗时没有改善。原因是 autovacuum 不为刚插入的活元组置 VM 位,修复是显式执行 VACUUM (ANALYZE) orders; 后重试,大表可用 pg_stat_progress_vacuum 观察进度。另一个失败是统计过时:UPDATE 后未 ANALYZE 导致规划器选 Index Scan,可临时 ALTER TABLE orders SET (autovacuum_enabled = off); 复现,再 ANALYZE orders 对比计划。
五、验证结果与边界
预期对比:低选择性查询在 Index Scan 与 Seq Scan 之间可差一个数量级,标题中的 10 倍即这一量级的参考值;Heap Fetches 归零后,覆盖索引的耗时低于普通索引扫描数倍。以上均为预期,未在生产库实测。
代价有三点。存储与写放大:两个索引同时维护,插入与更新各多写一份,索引膨胀后 VACUUM 不回收索引页,需要 REINDEX CONCURRENTLY。维护负担:VACUUM 频率提高会与业务 I/O 竞争,调 autovacuum_vacuum_scale_factor 等参数前先在测试环境验证。计划波动:统计更新后计划可能切换,接口应能接受两种计划的延迟差异。
适用边界:写密集表(高频改 status)会让索引快速膨胀,通常不值得加覆盖索引;小表直接顺序扫描;SELECT * 无法被覆盖索引覆盖;聚合报表更适合物化视图。上线后可用 pg_stat_user_indexes.idx_scan 与 pg_class.relpages 观察索引使用率与体积变化。