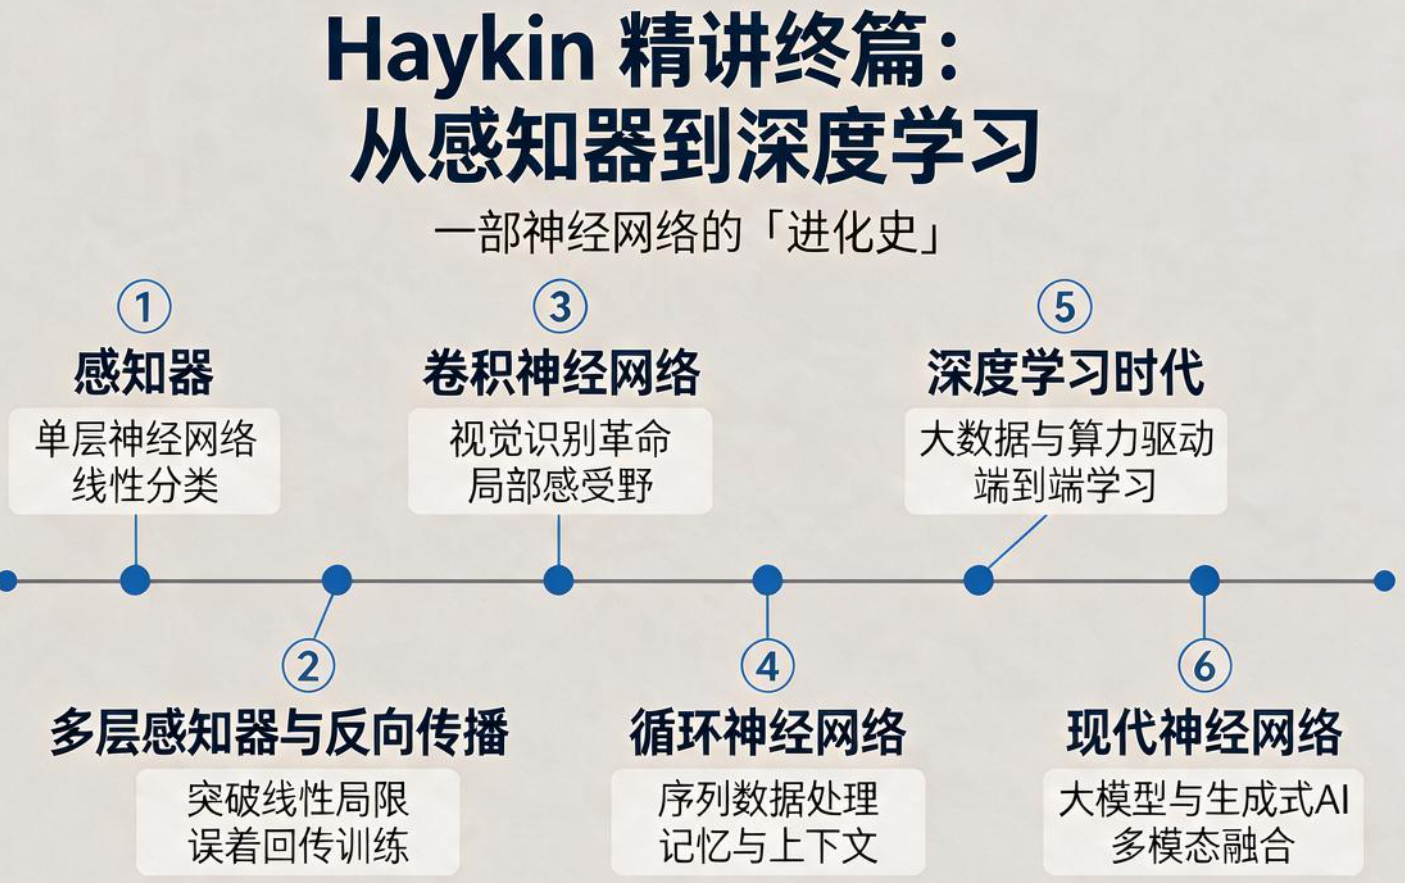
15 个核心算法的全景回顾,以及它们在工业中的应用
开头:15 篇读完了,但知识是零散的
上一篇我们学习了卡尔曼滤波,完成了序列学习主线。
今天我们做全景回顾------把 15 个算法串起来,形成完整的知识图谱。
15 篇文章,15 个核心算法
    → 但它们之间有什么关系?
    → 怎么在实际项目中应用?
    → 下一步该学什么?

这篇就是答案
一、知识图谱:15 个算法的关系
1.1 监督学习主线(7 篇)
监督学习主线
═══════════════════════════════════════════════════════════════════

感知器 (1958) → LMS (1960) → 反向传播 (1986)
    ↓              ↓              ↓
  线性分类      梯度下降        多层网络

核方法 (1990s) → SVM (1990s) → 正则化 (贯穿始终)
    ↓              ↓              ↓
  非线性映射    小数据学习      防止过拟合

核心思想进化:
    规则驱动 → 梯度驱动 → 数据驱动
1.2 无监督学习主线(4 篇)
无监督学习主线
═══════════════════════════════════════════════════════════════════

PCA → SOM → 信息论(ICA) → 玻尔兹曼机
↓       ↓         ↓            ↓
降维    聚类    特征分离      生成模型

核心思想进化:
    降维 → 聚类 → 特征学习 → 生成模型
1.3 序列学习主线(4 篇)
序列学习主线
═══════════════════════════════════════════════════════════════════

动态规划 → Hopfield → 卡尔曼滤波
    ↓          ↓           ↓
  决策优化   联想记忆    状态估计

核心思想进化:
    决策 → 记忆 → 预测
二、深度学习的「进化史」
2.1 时间线
1943  M-P 神经元 → 第一个神经元数学模型
1958  感知器 → 第一个可以学习的神经网络
1960  LMS → 梯度下降的雏形
1969  感知器局限性 → AI 寒冬开始
1986  反向传播 → 多层网络可以训练 → AI 寒冬结束
1990s SVM/核方法 → 统计学习理论的巅峰
2006  深度信念网络 → 深度学习复兴
2012  AlexNet → 深度学习爆发
2014  GAN → 生成模型革命
2017  Transformer → 注意力机制统治 NLP
2.2 三次浪潮
第一次浪潮(1950s-1960s):
    感知器 → 「改变世界」的发明
    → Minsky 指出局限 → AI 寒冬

第二次浪潮(1980s-1990s):
    反向传播 → 多层网络
    → SVM 崛起 → 深度学习被遗忘

第三次浪潮(2010s-至今):
    深度学习 → GPU 加速 → 大数据
    → 统治 AI 领域
三、算法对比
3.1 监督学习算法对比
| 算法 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 感知器 | 简单、快速 | 只能线性分类 | 简单分类 |
| LMS | 梯度下降基础 | 单层 | 线性回归 |
| MLP | 非线性、万能逼近 | 需要大量数据 | 通用 |
| SVM | 小数据强、理论优雅 | 训练慢 | 小样本分类 |
| RBF | 训练快、可解释 | 容量有限 | 函数逼近 |
3.2 无监督学习算法对比
| 算法 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| PCA | 简单、快速 | 只能线性降维 | 降维、去噪 |
| SOM | 拓扑保持、可视化 | 计算慢 | 聚类可视化 |
| ICA | 信号分离 | 需要非高斯 | 盲源分离 |
| RBM | 生成模型 | 训练复杂 | 特征学习 |
3.3 序列学习算法对比
| 算法 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 动态规划 | 最优解 | 状态空间爆炸 | 网格世界 |
| Hopfield | 联想记忆 | 容量有限 | 图像识别 |
| 卡尔曼滤波 | 最优线性估计 | 只能线性高斯 | 目标跟踪 |
四、工业应用全景
4.1 AOI 项目中的算法
AOI 项目中的算法应用
═══════════════════════════════════════════════════════════════════

YOLO 训练:
    - 反向传播(BP):梯度计算
    - 正则化(Weight Decay):防止过拟合
    - 数据增强:增加训练数据

模型导出:
    - ONNX:跨平台部署
    - FP16:量化加速

产线部署:
    - C++ ONNX Runtime:推理引擎
    - 预处理对齐:Python ↔ C++
4.2 更广泛的工业应用
计算机视觉:图像分类、目标检测、图像分割
自然语言处理:文本分类、机器翻译、对话系统
推荐系统:协同过滤、深度推荐
自动驾驶:目标跟踪、路径规划、感知融合
五、从理论到实践的桥梁
5.1 理论指导实践
正则化理论 → Dropout、Weight Decay
核方法 → SVM、RBF 网络
统计力学 → 玻尔兹曼机、DBM
贝叶斯推断 → 卡尔曼滤波、粒子滤波
5.2 实践反哺理论
深度学习实践 → 新理论
    - 为什么深层网络比浅层好?
    - 为什么 SGD 能收敛到好的解?
    - 为什么过参数化不导致过拟合?

大模型实践 → 涌现能力
    - 小模型没有的能力,大模型突然出现
六、下一步学习路径
6.1 推荐学习路线
第一阶段:框架学习
    - PyTorch:动态图,研究首选
    - TensorFlow:静态图,生产首选

第二阶段:计算机视觉
    - CNN:ResNet、EfficientNet
    - 目标检测:YOLO 系列
    - 图像分割:U-Net

第三阶段:自然语言处理
    - Transformer:自注意力机制
    - BERT:预训练语言模型
    - GPT:生成式模型

第四阶段:生成模型
    - GAN:生成对抗网络
    - VAE:变分自编码器
    - Diffusion:扩散模型
6.2 推荐资源
经典论文:
    - AlexNet:ImageNet Classification with Deep CNNs
    - ResNet:Deep Residual Learning
    - Transformer:Attention Is All You Need
    - GAN:Generative Adversarial Networks

开源项目:
    - PyTorch:github.com/pytorch/pytorch
    - Hugging Face:huggingface.co
    - Ultralytics:github.com/ultralytics/ultralytics
七、系列总结
7.1 我们学到了什么?
15 篇文章,15 个核心算法:

感知器 → LMS → 反向传播 → 核方法 → SVM → 正则化
PCA → SOM → 信息论 → 玻尔兹曼机
动态规划 → Hopfield → 卡尔曼滤波

每一篇都有:
    - 原理讲解(50%)
    - Python 实现(30%)
    - 避坑指南(20%)
7.2 核心收获
- 理论基础:理解了神经网络的数学本质
- 代码能力:能用 NumPy 手写核心算法
- 工程思维:知道理论和实践的差距
- 学习路径:知道下一步该学什么
八、致谢
感谢你陪我走完这 15 篇文章。
从 1943 年的 M-P 神经元,到 2020 年的深度学习,神经网络经历了 80 年的发展。
理论是基础,实践是目的。
希望这个系列能帮你:
- 看懂论文不再头疼
- 手写算法不再迷茫
- 工程落地不再踩坑
系列目录
| 篇 | 标题 | 状态 |
|---|---|---|
| 01 | Haykin 精讲开篇:从「只会调参」到「理解神经网络的灵魂」 | ✅ |
| 02 | 感知器:神经网络的「鼻祖」 | ✅ |
| 03 | LMS 算法:从最小二乘到随机梯度下降 | ✅ |
| 04 | 反向传播:神经网络为什么能「学习」 | ✅ |
| 05 | 核方法:为什么 SVM 能处理非线性问题 | ✅ |
| 06 | 支持向量机:最大间隔的「艺术」 | ✅ |
| 07 | 正则化:防止过拟合的「数学武器」 | ✅ |
| 08 | PCA:降维的「艺术」 | ✅ |
| 09 | SOM:无监督学习的「聚类之王」 | ✅ |
| 10 | 信息论:从 Shannon 到 ICA | ✅ |
| 11 | 玻尔兹曼机:深度学习的「前世」 | ✅ |
| 12 | 动态规划:强化学习的「数学基础」 | ✅ |
| 13 | Hopfield 网络:联想记忆的「鼻祖」 | ✅ |
| 14 | 卡尔曼滤波:从贝叶斯推断到粒子滤波 | ✅ |
| 15 | Haykin 精讲终篇:从感知器到深度学习 | ✅ |
感谢阅读,点赞收藏转发!