同一条分组 SQL,把聚合条件写进 WHERE 直接报错,挪到 HAVING 立刻出结果------不是数据库为难你,是它俩根本不在同一个时间点干活。
这篇我带你顺着执行顺序走一遍,以后拿到任何条件,你都能自己判断它该写在哪个子句里。
一、场景:一张报表里的分组需求
业务侧甩来的统计需求,基本都是同一个模子:
- 统计每个部门的平均工资;
- 计算每个商品类别的销售总额;
- 找出订单数超过 100 的客户;
- 生成按月汇总的财务报表。
它们的共同点是:统计对象不再是某一行,而是某一类数据。SQL 用分组(GROUP BY)把行切成组,再用聚合函数(Aggregate Function)把每组压成一行;对分组结果的过滤,交给分组过滤(HAVING)。
我第一次写这类报表,需求没多难,却连续踩了三个坑。
二、问题点:三个看似无关的报错
我把当年卡过的写法整理成下表,你可以对照看看自己中过几个。
| 序号 | 我写的写法 | 数据库的反应 | 我当时的疑惑 |
|---|---|---|---|
| 1 | WHERE AVG(salary) > 10000 |
直接报错 | 聚合函数也是函数,为什么不能放 WHERE |
| 2 | SELECT dept_id, job ... GROUP BY dept_id |
直接报错 | job 明明是表里的列,为什么不让选 |
| 3 | 普通条件全塞进 HAVING | 能出结果,但很慢 | 结果明明对,为什么要跑半天 |
三个现象,一个报错语法、一个报错列、一个拖慢速度,看着毫无关联。
记住:它们的根因只有一个------一条 SQL 不是按你书写的顺序执行的。
三、原理:一条 SQL 的真实执行顺序
那它到底按什么顺序执行?
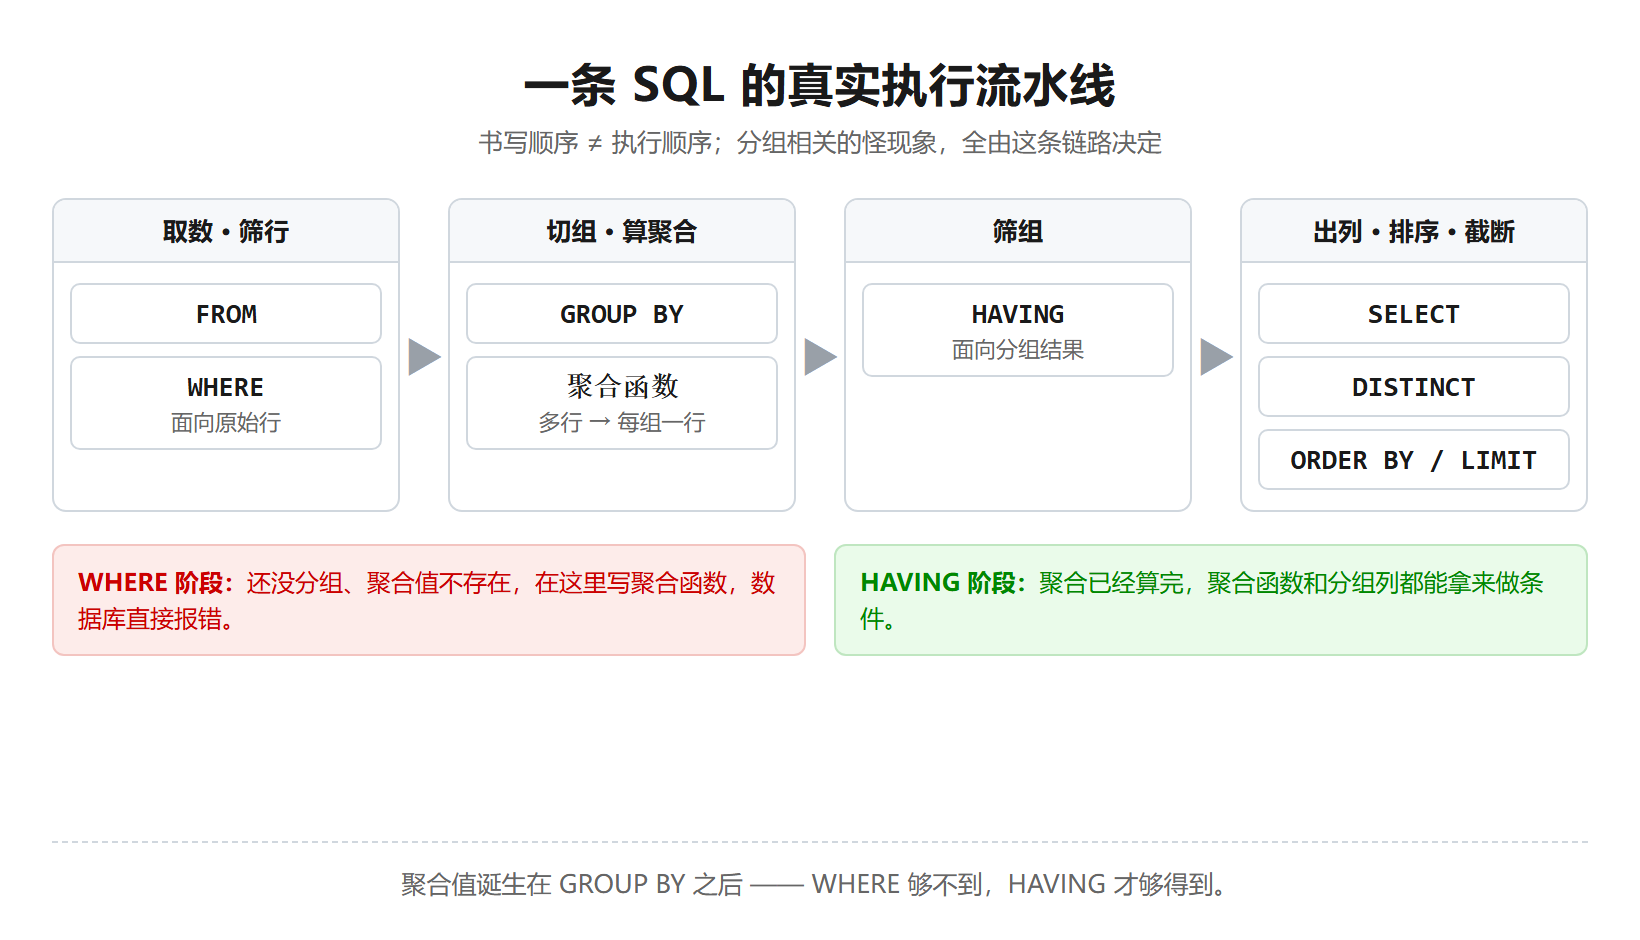
逻辑执行顺序(Logical Execution Order)如下,注意它是逻辑顺序,不等于书写顺序,也不完全等同于数据库内部的物理执行顺序:
latex
FROM -> WHERE -> GROUP BY -> 聚合计算 -> HAVING -> SELECT -> DISTINCT -> ORDER BY -> LIMIT每一步的动作和数据形态,列成下表:
| 步骤 | 干什么 | 此刻的数据形态 |
|---|---|---|
| FROM | 加载表、做连接 / 笛卡尔积(Cartesian Product) | 原始行集合 |
| WHERE | 逐行过滤,不满足的丢弃 | 幸存的原始行 |
| GROUP BY | 按分组列把行切成组 | 多个组,每组多行 |
| 聚合计算 | 对每组算 COUNT/SUM/AVG/MAX/MIN | 每组一行 |
| HAVING | 淘汰不满足条件的组 | 剩下的分组 |
| SELECT / DISTINCT | 选出列、起别名、去重 | 结果行 |
| ORDER BY / LIMIT | 排序、截取 | 最终结果 |
按这条链路,先解释第一个报错。WHERE 是第 2 步,聚合是第 4 步,WHERE 执行时组都还没切,聚合值根本不存在,数据库无从判断。
错误写法(聚合值此刻不存在,直接报错):
sql
SELECT dept_id, AVG(salary)
FROM employee
WHERE AVG(salary) > 10000
GROUP BY dept_id;
正确写法(把条件挪到聚合之后的 HAVING):
sql
SELECT dept_id, AVG(salary)
FROM employee
GROUP BY dept_id
HAVING AVG(salary) > 10000;
第二个报错同理。分组之后每组只剩一行,可组内的非分组列可能有多个值,数据库不知道该显示哪一个,标准 SQL 直接禁止。
sql
SELECT dept_id, job, COUNT(*)
FROM employee
GROUP BY dept_id; -- job 不在 GROUP BY,也不是聚合,报错记住:聚合值诞生在 GROUP BY 之后,WHERE 永远够不到它。
四、方案:让每个条件各归其位
拿到一个具体条件,怎么判断它该写哪儿?判断标准就一句话:过滤原始行用 WHERE,过滤分组用 HAVING。
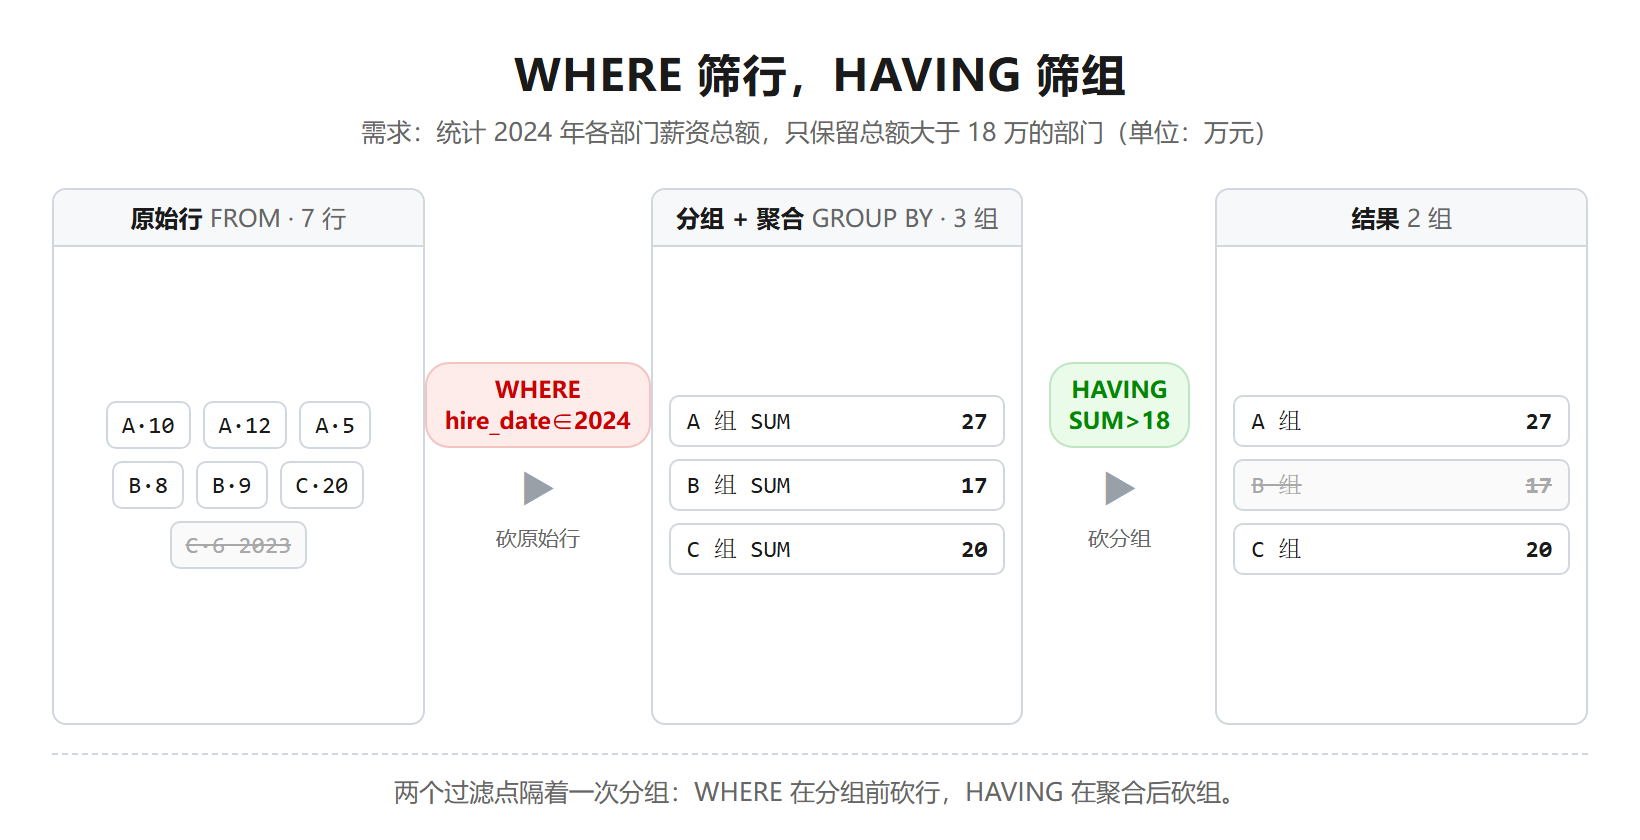
两者的完整差异,列成下表:
| 维度 | WHERE | HAVING |
|---|---|---|
| 执行时机 | 分组前 | 聚合后 |
| 作用对象 | 原始行 | 分组结果 |
| 能否用聚合函数 | 不能 | 能 |
| 能否用分组列 | 能 | 能 |
| 性能 | 提前砍行,开销小 | 分组后才过滤,开销大 |
| 是否必须配合 GROUP BY | 否 | 通常配合 |
落地原则:能在 WHERE 表达的条件,绝不放到 HAVING。提前砍行,参与分组的行数更少,算得更快。
以"统计 2024 年各部门薪资总额,只保留总额大于 50 万的部门"为例:
sql
SELECT dept_id, SUM(salary)
FROM employee
WHERE hire_date >= '2024-01-01' AND hire_date < '2025-01-01'
GROUP BY dept_id
HAVING SUM(salary) > 500000;
年份条件放 WHERE,因为它针对原始行;总额条件放 HAVING,因为它是聚合结果。
分组的几个语义细节,我列成下表,写报表时高频用到:
| 细节 | 行为 |
|---|---|
| 多列分组 | GROUP BY dept_id, job 按部门 + 岗位组合键切组 |
| NULL 分组 | 多个 NULL 会被并成同一组 |
| COUNT(*) | 统计所有行,包含 NULL |
| COUNT(列) | 只统计该列非 NULL 的行 |
| SUM/AVG/MAX/MIN | 忽略 NULL;整组为 NULL 时 SUM 得 NULL,COUNT 得 0 |
记住:条件能往前放就别往后拖,行过滤用 WHERE、组过滤用 HAVING。
五、验证:报表写法实测
下面的报表我都在 MySQL 8.0 上实际跑过,你可以照着复现。
客户订单 Top 10:先用 WHERE 限定已支付,再用 HAVING 卡总额。
sql
SELECT customer_id, COUNT(*) AS order_cnt, SUM(amount) AS total
FROM orders
WHERE status = 'PAID'
GROUP BY customer_id
HAVING SUM(amount) > 1000
ORDER BY total DESC
LIMIT 10;
条件统计:用 CASE WHEN 做行转列,统计每个部门的高薪、低薪人数。
sql
SELECT dept_id,
  SUM(CASE WHEN salary >= 10000 THEN 1 ELSE 0 END) AS high_cnt,
  SUM(CASE WHEN salary < 10000  THEN 1 ELSE 0 END) AS low_cnt
FROM employee
GROUP BY dept_id;
每组取前三名:分组查询会把多行压成一行,取每组 Top N 要靠窗口函数(Window Function)。
sql
SELECT dept_id, name, salary
FROM (
  SELECT dept_id, name, salary,
    ROW_NUMBER() OVER (PARTITION BY dept_id ORDER BY salary DESC) AS rn
  FROM employee
) t
WHERE rn <= 3;
PARTITION BY 语义上类似分组,但不会把多行压成一行,所以能保住明细。跑完你会看到类似结果:
latex
dept_id  name  salary
1        赵六  24000
1        钱七  18000
1        李四  15000
2 吴九 13000记住:报表四件套------行过滤 WHERE、组过滤 HAVING、条件统计 CASE WHEN、Top N 用窗口函数。
六、总结延伸:避坑与性能
我把踩过的坑和性能要点分成两张表,发布前扫一眼即可。
| 常见误区(写之前对照) |
|---|
| WHERE 写聚合函数;SELECT 非分组列;混淆 COUNT(*) 与 COUNT(列);漏看 NULL 被并组;该放 WHERE 的塞进 HAVING |
| 性能建议(数据量大必看) |
|---|
| GROUP BY 列建索引;WHERE 提前过滤;别在分组列上套函数(索引失效,可冗余日期列);HAVING 条件尽量简单;大表用预聚合(汇总表 / 物化视图) |
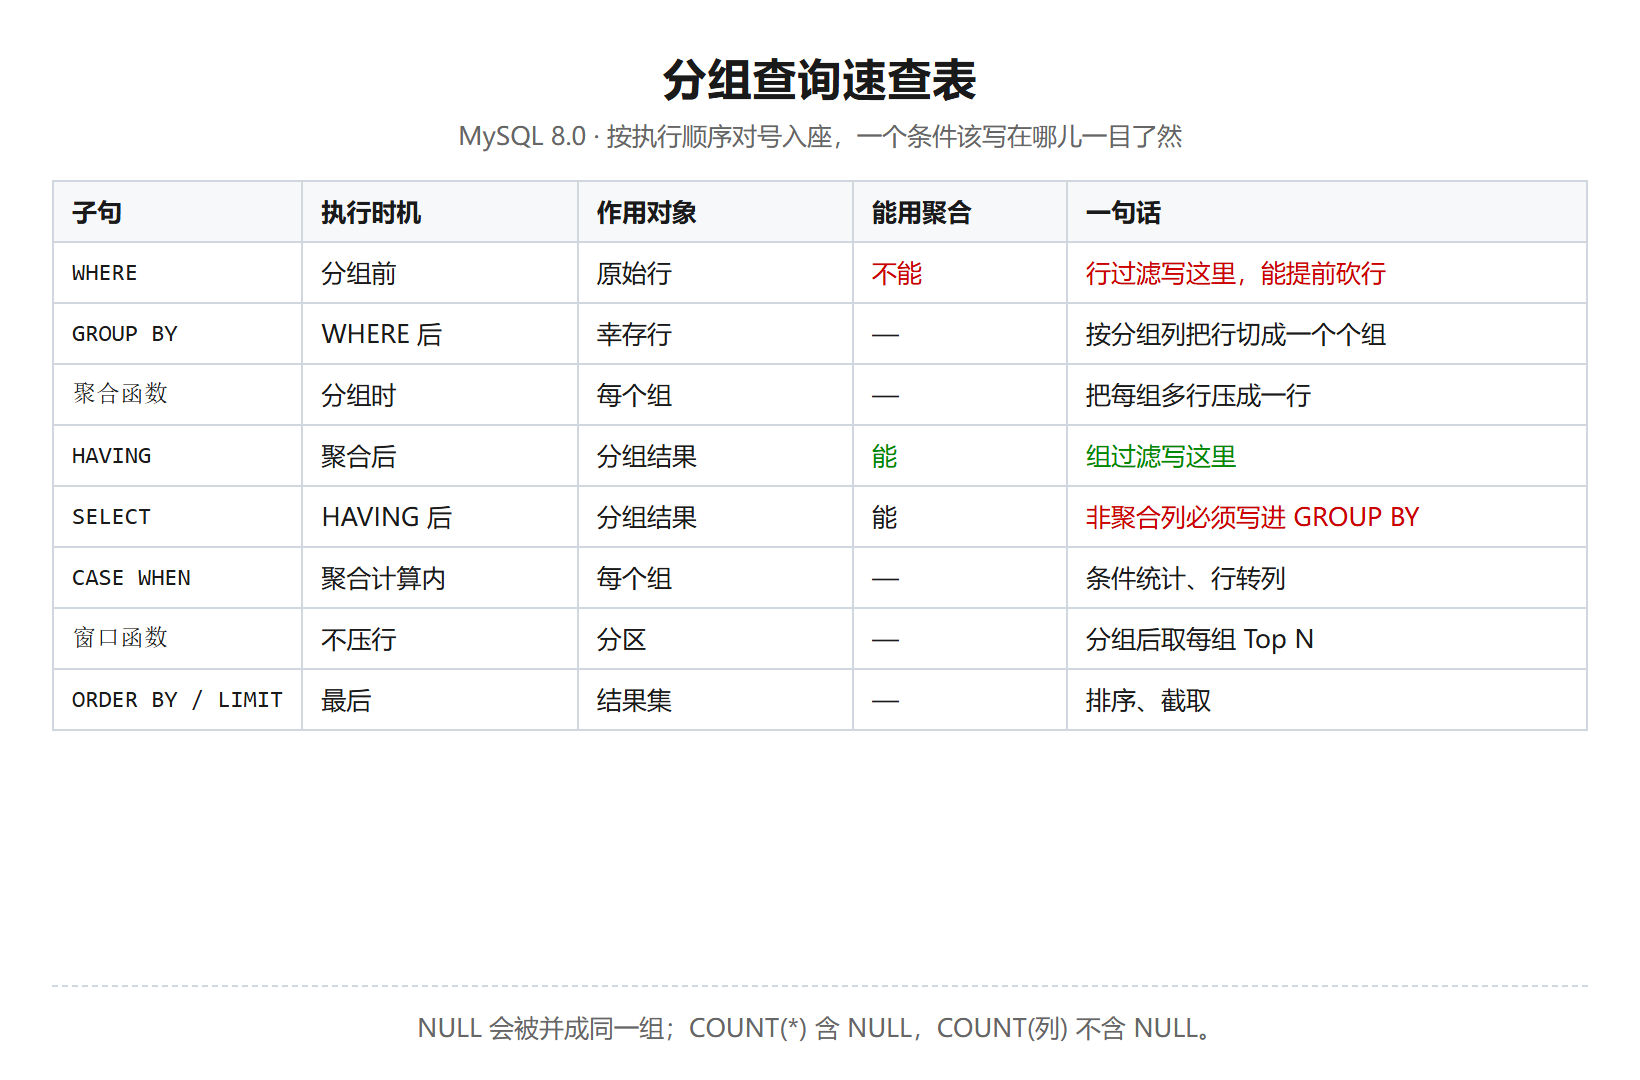
全文链路再收束一次:
先 FROM/WHERE 筛行,再 GROUP BY 切组,然后算聚合,HAVING 筛组,末段 SELECT 出列、ORDER BY 排序、LIMIT 截断。
记住:执行顺序是理解所有 SQL 行为的总钥匙,不用死记语法。
术语速查表
| 术语 | 英文 | 含义 |
|---|---|---|
| 分组 | GROUP BY | 按分组列把行切成一个个组 |
| 聚合函数 | Aggregate Function | COUNT/SUM/AVG/MAX/MIN,把每组多行压成一行 |
| 行过滤 | WHERE | 分组前对原始行过滤 |
| 分组过滤 | HAVING | 聚合后对分组结果过滤 |
| 逻辑执行顺序 | Logical Execution Order | 数据库处理各子句的先后逻辑 |
| 笛卡尔积 | Cartesian Product | 多表连接时行的组合 |
| 窗口函数 | Window Function | 按分区计算、不压缩行数 |