一、整体图景:AI 的 "七层高楼"
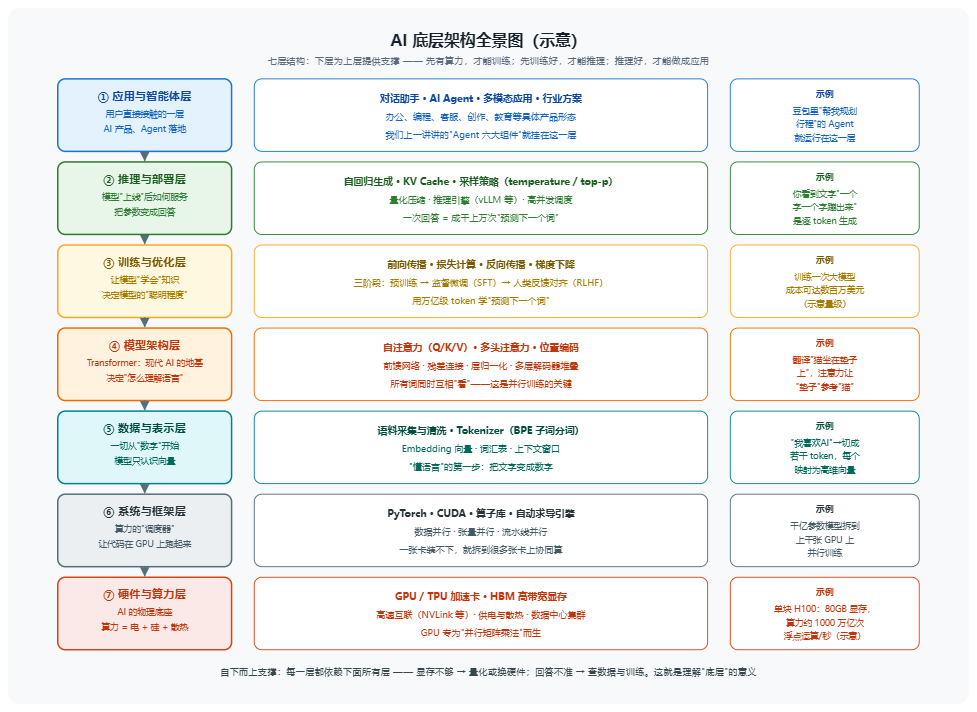
| 层级 | 一句话职责 | 你可以这样理解 |
|---|---|---|
| ⑦ 硬件层 | 提供算力与存储 | "电厂 + 机器" |
| ⑥ 系统框架层 | 调度 GPU 并行计算 | "包工头" |
| ⑤ 数据层 | 把文字 / 图像变成数字 | "翻译官" |
| ④ 模型架构层 | 定义 "怎么理解" | "大脑回路" |
| ③ 训练层 | 让模型学会知识 | "上学读书" |
| ② 推理部署层 | 上线后为用户生成答案 | "出诊看病" |
| ① 应用层 | 包装成产品 / Agent | "医生开的诊所" |
下面从最底层开始,逐层深入。
二、最小积木:神经元与前向传播
所有现代 AI(包括千亿参数的大模型)都由同一个积木堆出来:人工神经元。
一个神经元做的事极其简单:
z = w1·x1 + w2·x2 + b        (加权求和)
y = 激活函数(z)              (非线性变换,如 ReLU: y = max(0, z))
示例:判断一张照片是不是猫(极度简化)
假设我们只用两个 "特征":x1 = 耳朵有多尖,x2 = 胡须有多长。权重 w1、w2 表示这两个特征的 "重要程度",b 是偏置(类似门槛)。
- 前向传播:照片 A 算出 x1=0.9、x2=0.7,权重 w1=0.8、w2=0.5,b=-0.6,则 z = 0.8×0.9 + 0.5×0.7 - 0.6 = 0.67 > 0 → 输出 "是猫"。
- 如果算出来是负数,就输出 "不是猫"。
机制解释 :所谓 "模型学会了",本质就是把 w1、w2、b 调到了合适的数值 。训练时给它几千张标注好的照片,它不断试错、微调这几个数,直到判断准确。真实模型不过是把这个神经元做成几百上千层、每层几百万个,再塞进 GPU 里并行计算 ------ 道理完全一样。这就是为什么我们说 "AI 本质上是数学"。
三、学习机制:训练到底在干什么
AI 的 "学习" 不是像人一样理解概念,而是用数据反复调整参数,让预测误差越来越小。核心是四个动作:前向传播 → 计算损失 → 反向传播 → 梯度下降更新。
示例:用面积预测房价(2 个参数的微型模型)
- 前向传播 :模型先猜一个关系:
价格 = w × 面积 + b。假设 w=2、b=10(单位:万元),输入 80㎡ → 预测 170 万。 - 计算损失:真实成交价是 200 万,误差 = 200 − 170 = 30 万。损失函数(如均方误差)把这个误差变成一个 "惩罚分":L = (200−170)² = 900。分数越大 = 错得越离谱。
- 反向传播 :利用微积分的链式法则 ,从损失往回推导出 "每个参数该往哪个方向调、调多少"------ 数学上叫梯度。梯度告诉你:w 增加一点点,损失会变大还是变小。
- 梯度下降 :让参数沿着让损失变小的方向 迈一小步:
w = w − 学习率 × 梯度。学习率就是 "步长"------ 太大容易迈过头,太小学得慢。 - 迭代:重复上面 1--4 步成千上万次,w、b 逐渐收敛到 "能准确预测" 的值。
机制解释 :大模型和这个例子的区别只有规模 ------ 参数从 2 个变成几千亿个,数据从几十条变成万亿个 token,优化器从简单的梯度下降升级为 Adam 等,但 "预测 → 对比 → 调整" 的内核完全一样。"训练" 就是一场几千万轮的 "蒙眼猜数 + 公布答案 + 修正" 游戏。
补充一个新手常问的点:过拟合------ 模型把训练数据背得滚瓜烂熟,但见到新数据就抓瞎(就像学生只背住了原题,换个数就不会做)。所以训练时要留出一部分数据专门做 "考试"(验证集),并配合正则化等手段。
四、现代 AI 的地基:Transformer 架构
2017 年之前的主流是 RNN(循环神经网络),它像人读书一样逐字阅读 :必须先读完 "猫",才能处理 "坐"。缺点有二:不能并行 (GPU 的优势发挥不出来)和记不住太远的词("猫" 和后面 50 个字的 "它" 难以关联)。
Transformer 的革命性设计是:让一句话里的所有词同时互相 "看" ------ 一次前向计算里,每个词都能直接 "注意" 到句子中任意位置的词。它的核心是**自注意力(Self-Attention)**机制。
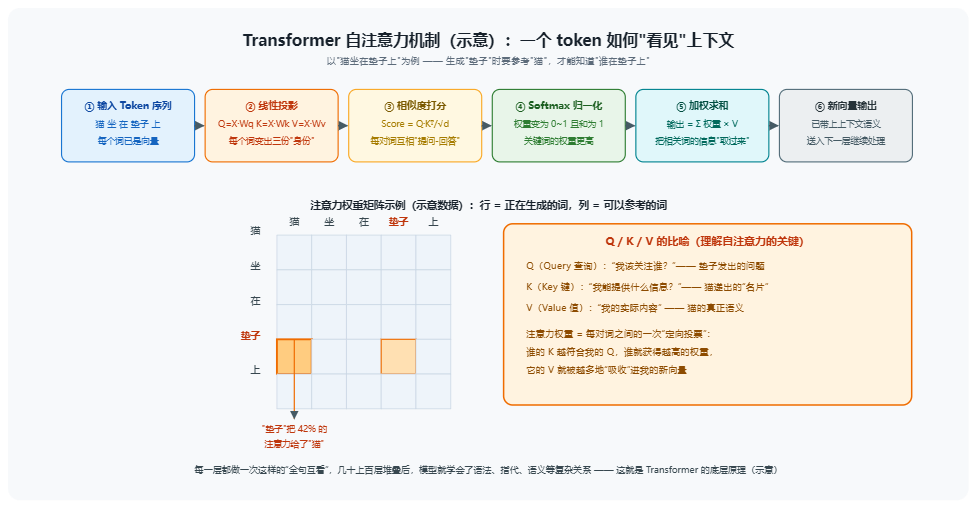
示例:翻译 "猫坐在垫子上",下面这张图演示了一次注意力计算的全部内部步骤:
机制逐条解释:
- Q/K/V 三个角色:每个词都通过乘以三个不同的权重矩阵(Wq/Wk/Wv),变出三份 "分身"------Q 代表 "我想了解什么",K 代表 "我能提供什么信息",V 代表 "我的实际内容"。这是注意力机制的精髓设计。
- 打分:用 Q 和所有词的 K 做点积(再除以 √d 防止数值过大),得到一个相似度分数 ------ 谁的 K 和我的 Q 越匹配,谁就越值得关注。
- Softmax:把分数压成 0~1 且总和为 1 的概率分布。图中 "垫子" 行里,"猫" 拿到了 0.42 的最高权重 ------ 模型 "发现" 了主谓关系(谁坐在垫子上)。
- 加权求和:用这些权重对所有词的 V 加权求和,得到新向量 ------"垫子" 的新向量里混入了 "猫" 的语义。这一步之后,"垫子" 这个词在模型内部就 "知道" 自己关联着 "猫"。
- 多头注意力:模型不会只做一场投票,而是同时开 8/16/32 场(不同头),各自学不同的关系 ------ 有的头抓语法、有的抓指代、有的抓语义。最后拼起来。
- 配套三件套 :
- 位置编码:注意力不分先后顺序,所以必须额外注入 "每个词在第几位" 的信息(正弦编码或 RoPE 旋转位置编码);
- 前馈网络(FFN):每个词独立做一次非线性变换,增加模型的表达能力;
- 残差连接 + 层归一化:把每层的输入 "搭桥" 直接加回输出,再归一化,让几百层深的网络也能稳定训练(梯度不会消失或爆炸)。
实际价值 :Transformer 让 "并行训练" 成为可能(所有词一次算完,而不是逐字),这是大模型能扩展到千亿参数、万亿 token 的根本原因。你今天用到的所有主流大模型,底层架构都是它。
五、数据与表示层:Token 与 Embedding
模型不识字,只认数字。这一层负责 "翻译"。
Tokenizer(分词器) :把文本切成模型词汇表里的最小单元 ------token。常用算法是 BPE(字节对编码),它把高频词整体保留、把生僻词拆成常见子词:
- 英文示例:
unbelievable→un+believable(或believ+able) - 中文示例:中文常用字 / 词或字节级切分,"我喜欢 AI" 可能切成
我、喜欢、AI三个 token
Embedding(词嵌入):每个 token 查表得到一个高维向量(如 768 维或更高)。这些向量的位置分布本身就有语义规律:
- 示例(词向量类比) :在训练好的向量空间里,
国王 − 男人 + 女人 ≈ 女王。因为 "国王" 和 "男人" 的向量差近似等于 "女王" 和 "女人" 的向量差 ------ 模型在数字上 "理解" 了性别关系。 - "相似词距离近":
猫和狗的向量比猫和汽车更接近。
上下文窗口:模型一次能 "看" 的 token 上限(如 8K/128K/1M)。超出窗口的旧内容会被截断或压缩 ------ 这正好对应上一讲里 Agent 的 "短期记忆" 是有物理上限的。
六、多模态的底层:图像和语音怎么进模型
大模型本质是 "文本模型",那图像、语音怎么进来?答案是先把它们也 "翻译" 成 token 一样的向量序列。
- 图像(ViT,Vision Transformer) :把图片切成 16×16 像素的小块(patch),每个小块线性投影成一个向量,加上位置信息后送入 Transformer 编码 ------图片被变成了 "一串视觉 token"。
- 图文对齐(CLIP) :用大量 "图片 - 文字描述" 对做对比学习------ 把配对的图和文在向量空间里拉近,把不配对的推远。训练后,"猫的照片的向量" 和 "猫这个词的向量" 落在相近位置。
- 图文问答的底层数据流 :图像 token 序列 + 问题文本 token 序列拼接在一起,送入同一个 Transformer,跨模态注意力让 "图里的猫" 和问题里的 "猫" 互相激活,最终解码出答案。上一讲的 "图像描述生成、图文问答" 在底层就是这样运转的。
- 语音 :ASR 把音频转成梅尔频谱图(频率 × 时间的二维图),用声学编码器编码成向量序列再转文字;TTS 反过来:文本 → 语言模型生成频谱 → 声码器(如 HiFi-GAN)把频谱 "唱" 成波形。所以语音本质上是 "声音的频谱图",和图像一样是二维信号,多模态架构天然复用。
七、从 "会背书" 到 "会聊天":训练的三个阶段
一个模型要变成好用的助手,要经过三个阶段,各解决不同问题:
| 阶段 | 学什么 | 数据 | 机制要点 |
|---|---|---|---|
| 预训练 | 语言本身 | 万亿级公开文本 | 自监督:给前文,预测下一个 token |
| SFT 监督微调 | 听指令 | 人工写的 "指令 - 正确回答" | 有监督:让模型学会问答格式 |
| RLHF 对齐 | 符合人类偏好 | 人类对多个回答的排序 | 训练奖励模型 + PPO/DPO 优化 |
- 预训练示例 :喂给模型 "青岛是山东的___",它学 "预测下一个词";在万亿个句子上反复做这件事,它就把语法、事实、推理能力 "压" 进了参数里。注意:模型这时只会 "续写",不会 "对话"。
- SFT 示例:给它 10 万条 "用户指令 → 理想回答"(如 "写一封请假邮件"→ 范文),它学会 "原来是让我回答,而不是续写"。
- RLHF 示例 :让人类给同一问题的多个回答打分排序(如 A 更安全、B 更详细),训练一个 "奖励模型" 模仿人类的偏好,再用强化学习(PPO)让大模型朝着高分方向调整参数。这就是模型 "懂得拒绝危险请求" 的底层原因 ------安全行为是训练出来的,不是天生自带的。
八、推理的底层:为什么字是一个个蹦出来的
你使用 AI 时看到的 "打字机效果",底层机制是自回归生成:
- 模型输入你的问题,输出下一个 token 的概率分布(比如 "青" 后面是 "岛" 的概率 95%、"海"3%......),按采样策略选一个;
- 把选中的 token 接到输入末尾,再预测下一个 ------ 如此循环,直到生成结束符。
三个关键优化 / 机制:
- KV Cache(键值缓存):生成第 100 个 token 时,前 99 个词的 Q 其实不需要重算,只需缓存它们的 K、V 直接复用 ------ 大幅提速,代价是占显存。这是推理引擎(如 vLLM)的核心优化点。
- 采样策略 :
temperature(温度)控制随机性 ------ 调低更确定(适合写代码),调高更有创意(适合写故事);top-p(核采样)只从累计概率达 p 的词里选,砍掉明显离谱的低概率词。 - 量化:把参数从 FP16(16 位浮点)压缩到 INT8/INT4。示例:一个 70B 参数的模型,权重在 FP16 下约需 140GB 显存(70B×2 字节),量化到 INT4 后降到约 35GB------ 这就是为什么 "笔记本能跑 70B 小模型" 主要靠量化。
九、算力底座:为什么大模型离不开 GPU
GPU 为什么适合 AI :AI 计算 90% 是矩阵乘法(成千上万个数字同时乘加),GPU 有数千个计算核心可同时算,而 CPU 只有几十个核心。GPU 加上 HBM 高带宽显存,喂数据的 "水管" 也特别粗 ------ 所以 "算得快" 的本质是并行 + 带宽。
显存算例(示意估算):
- 推理 70B 模型:权重 140GB(FP16)→ 一块 80GB 显存的 H100 装不下,需要 2 块卡,或量化到 35GB 用 1 块。
- 训练 70B 模型:除了权重,还要存梯度(又是 140GB)和优化器状态(Adam 需要额外两份 FP32 副本,约 280GB+)------训练比推理要多花几倍显存,单卡永远不可能,必须多卡并行。
三种并行方式(对应第⑥层):
- 数据并行:每张卡复制一份完整模型,各算不同批次数据,最后同步梯度("大家各做各的卷子,再对答案")。
- 张量并行:把一次矩阵乘法本身拆成几份,分到多张卡同时算("一道大题拆成几段同时算")。
- 流水线并行:把几十层模型按层切段,每张卡负责其中几层,数据像流水线一样流过("工厂流水线,每站只做一道工序")。
十、总结:把整栋楼串起来 + 新手学习路径
一句话全景 :AI 底层架构 = 硬件提供算力 → 框架调度 GPU → 数据把世界变成向量 → Transformer 负责理解 → 三阶段训练注入知识与对齐 → 推理引擎把参数变成回答 → 应用层包装成产品和 Agent。上一讲的 AI Agent 六大组件,恰好就搭在这栋楼的最上面一层。
给新手的建议路径:
- 搭积木:先手写一个 2 层小神经网络(PyTorch),用房价 / 手写数字识别练手,体会 "前向→损失→反向→更新" 循环 ------ 半天即可入门。
- 拆 Transformer:用在线可视化工具(如 BertViz、Attention 可视化 demo)看注意力权重矩阵,把 "Q/K/V" 从概念变成 "亲眼所见"。
- 跑一个开源小模型:在本地用 Ollama 跑 7B~14B 模型,观察 KV Cache、量化(q4/q8)对速度的影响。
- 进阶:读 Karpathy 的《Let's build GPT from scratch》或 nanoGPT 源码 ------ 从零实现一个迷你 GPT,你就真正 "打通" 了这几层的全链路。