文章目录
- [1 -> 引言](#1 -> 引言)
- [2 -> 岗位不会一次改变,任务会逐项迁移](#2 -> 岗位不会一次改变,任务会逐项迁移)
- [3 -> 委派之前,先写清楚任务契约](#3 -> 委派之前,先写清楚任务契约)
- [4 -> 一个完整例子:让 AI 归类客户反馈](#4 -> 一个完整例子:让 AI 归类客户反馈)
- [5 -> AI 输出越多,审核设计越重要](#5 -> AI 输出越多,审核设计越重要)
- [6 -> 评估一次改造,不能只看生成速度](#6 -> 评估一次改造,不能只看生成速度)
1 -> 引言
讨论 AI 对工作的影响时,人们经常从岗位名称出发:客服会不会被替代,运营是否还需要写报告,财务是否会减少重复对账。这样的讨论很容易走向两个极端,要么把 AI 描述成什么都能做,要么因为它会犯错而否定整个方向。
更有用的观察单位不是岗位,而是任务。一个岗位通常同时包含资料收集、规则处理、沟通协调、例外判断和责任承担。AI 可能已经能处理其中一部分,却未必能理解整条流程,更不能自动获得对外承诺、修改权限或删除数据的授权。
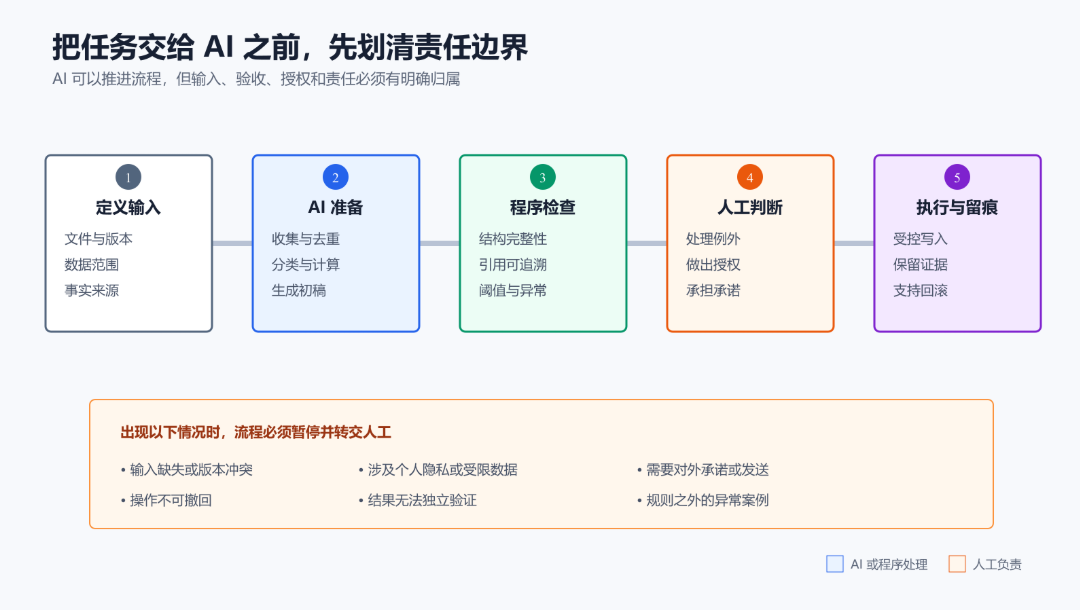
因此,真正需要重新设计的不是"哪些人要被 AI 替代",而是任务如何拆分、证据怎样保留、哪些节点必须由人判断。只有把这些问题说明白,AI 才可能减少重复劳动,而不是额外制造一批需要检查的输出。
2 -> 岗位不会一次改变,任务会逐项迁移
国际劳工组织在 2025 年更新的生成式 AI 职业暴露研究中,把分析落到了具体任务上。研究认为,多数职业更可能发生工作内容转变,而不是整个岗位被直接自动化。这里的"暴露"只表示某些任务可能受到 AI 影响,并不等于工作已经能够在真实环境中无人完成。
这种区分符合日常经验。以客户运营为例,同一个人可能同时做以下工作:
- 汇总多个渠道的客户反馈;
- 识别重复问题并统计频率;
- 判断某条反馈是否涉及合同、隐私或重大投诉;
- 与产品、销售和客户确认事实;
- 决定是否承诺解决时间;
- 跟踪问题是否真正关闭。
前两项具有较明确的输入和输出,适合让 AI 或程序先处理。中间两项需要业务背景和跨部门沟通。最后两项涉及承诺和责任,不能因为 AI 生成了一个看似完整的回复,就默认系统已经获得授权。
NBER 的生成式 AI 客服现场研究分析了 5,179 名客服人员。研究发现,引入 AI 助手后,每小时解决的问题数平均提高约 14%,新手和低技能员工的改善更明显,而经验丰富员工的变化较小。这个结果可以说明 AI 有机会传播已有经验,但它来自特定客服场景,不能直接外推成"所有知识工作都会提高 14%"。任务类型、数据质量和验收方式不同,结果也会不同。
3 -> 委派之前,先写清楚任务契约
很多 AI 任务失败,并不是模型完全没有能力,而是人只描述了目标,没有说明边界。例如"分析客户反馈"至少缺少以下信息:分析哪段时间、哪些文件算正式来源、允许使用哪些分类、结论需要什么证据、遇到个人信息怎么办、结果要写入系统还是仅供审阅。
把任务写成一份简短契约,可以显著降低这种模糊性:
text
任务:整理本月客户反馈,并找出重复出现的问题

输入:
- feedback.csv,版本日期为 2026-09-25
- 字段包括 id、channel、created_at、content

范围:
- 只分析本月记录
- 不推断记录中没有出现的客户意图
- 不把客户姓名、电话和邮箱写入结果

完成标准:
- 每个主题至少关联一条原始记录 ID
- 结论必须附带原文证据
- 无法判断的记录进入 needs_review,不强行分类

必须暂停:
- 输入文件版本冲突
- 出现未脱敏个人信息
- 需要向客户发送消息或做出承诺

交付:
- classified_feedback.jsonl
- summary.md
- needs_review.csv
任务契约的作用不是把提示词写得很长,而是让"完成"成为可以检查的状态。AI 做不到的部分也要被明确记录,而不是藏在一段流畅的总结里。
判断自动化程度时,可以使用两个简单维度:结果是否容易独立验证,错误造成的影响是否容易控制。
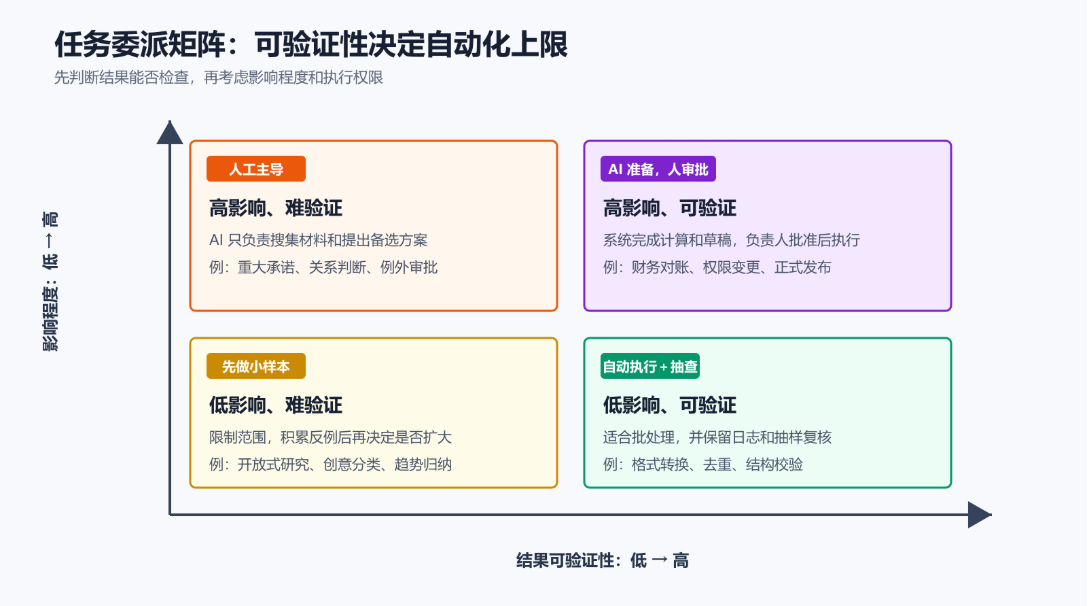
低影响、可验证的工作,例如格式转换、去重和字段完整性检查,可以自动执行并抽样复核。高影响但可验证的工作,例如财务对账和对外发布,可以由系统准备、人批准后执行。难以验证的开放式研究应先限制样本;既难验证又影响重大的任务,则应保持人工主导。
4 -> 一个完整例子:让 AI 归类客户反馈
假设团队每月收到 300 条客户反馈,需要输出高频问题和原文证据。直接让模型阅读全部内容并写总结,虽然省事,却会留下三个问题:无法确认是否漏掉记录,主题名称可能每次变化,摘要里的结论也不一定能追溯到原文。
更稳妥的流程可以拆成五步。
第一步,程序先检查输入。确认 ID 唯一、日期合法、正文非空,并在送入模型前删除不必要的个人信息。确定性工作应尽量由代码完成,不必消耗模型判断。
第二步,按固定批次让 AI 分类。输出使用 JSON Lines,每一行只对应一条输入记录:
json
{"id":"F-0182","theme":"delivery_delay","confidence":0.91,"evidence":"预计到货时间多次变化","needs_review":false}第三步,用程序检查输出结构。下面的脚本只依赖 Python 标准库,可以发现缺字段、非法主题、重复 ID、置信度越界和需要人工复核却没有证据的记录。
python
from __future__ import annotations

import json
from pathlib import Path

ALLOWED_THEMES = {
    "delivery_delay",
    "product_quality",
    "billing_question",
    "feature_request",
    "service_experience",
    "other",
}

REQUIRED_FIELDS = {
    "id",
    "theme",
    "confidence",
    "evidence",
    "needs_review",
}


def validate_record(record: dict, line_number: int) -> list[str]:
    errors: list[str] = []
    missing = REQUIRED_FIELDS - record.keys()
    if missing:
        errors.append(f"line {line_number}: missing {sorted(missing)}")
        return errors

    if record["theme"] not in ALLOWED_THEMES:
        errors.append(
            f"line {line_number}: unknown theme {record['theme']!r}"
        )

    confidence = record["confidence"]
    if not isinstance(confidence, (int, float)) or not 0 <= confidence <= 1:
        errors.append(f"line {line_number}: confidence must be 0..1")

    if not isinstance(record["needs_review"], bool):
        errors.append(f"line {line_number}: needs_review must be boolean")

    if not str(record["evidence"]).strip():
        errors.append(f"line {line_number}: evidence is empty")

    return errors


def main() -> None:
    path = Path("classified_feedback.jsonl")
    seen_ids: set[str] = set()
    errors: list[str] = []

    for line_number, line in enumerate(
        path.read_text(encoding="utf-8").splitlines(), start=1
    ):
        try:
            record = json.loads(line)
        except json.JSONDecodeError as exc:
            errors.append(f"line {line_number}: invalid JSON: {exc.msg}")
            continue

        errors.extend(validate_record(record, line_number))

        record_id = record.get("id")
        if record_id in seen_ids:
            errors.append(f"line {line_number}: duplicate id {record_id}")
        seen_ids.add(record_id)

    if errors:
        print("Validation failed:")
        for error in errors:
            print(f"- {error}")
        raise SystemExit(1)

    print(f"Validation passed: {len(seen_ids)} records")


if __name__ == "__main__":
main()第四步,把低置信度、other 类别以及规则冲突的记录交给人,而不是平均检查所有记录。第五步,再根据通过检查的数据聚合主题数量,生成总结,并抽查高频主题对应的原文证据。
这个流程并不能证明语义分类一定正确。结构校验只能发现格式错误,不能发现模型是否误解了一句话。因此仍然需要黄金样本、人工抽查和错误记录。它的价值在于把问题拆开:程序保证格式和数量,AI处理语义,人处理例外和责任。
5 -> AI 输出越多,审核设计越重要
当一个人可以同时启动多项任务,新的瓶颈往往从"没有时间做"变成"没有时间检查"。五份十页报告可能在几分钟内生成,但阅读和判断的成本并没有消失。
Microsoft Research 在生成式 AI 的自动化反讽研究中总结了几类可能造成效率损失的情况:人的角色从生产转向评估,原有工作流被不恰当地重组,系统产生更多中断,以及自动化让容易的工作更容易、困难的工作反而更难处理。
因此,审核不能只是任务末尾的一句"请人工确认"。一份便于审核的交付至少要包含:
- 使用了哪些输入和版本;
- 哪些检查已经由程序完成;
- 结果中的证据如何回到原始材料;
- 哪些部分置信度低或存在冲突;
- 现在需要人做什么决定;
- 执行后是否可以撤回。
对于低风险批处理,可以在结果阶段抽样。涉及资金、权限、隐私、数据删除和对外承诺时,人必须在执行前确认。若系统只能展示一个默认答案,还应主动提供反例和缺失证据,避免审核者长期变成只会点"同意"的橡皮图章。
6 -> 评估一次改造,不能只看生成速度
判断一条 AI 工作流是否有价值,至少要记录四类数据:从启动到可用结果的总周期,人工介入时间,返工次数,以及最终被采纳的结果比例。Token 用量、调用次数和生成字数可以帮助核算成本,却不能代替结果指标。
第一次实验不必选择复杂流程。可以选一项每周重复、输入相对稳定、失败容易撤回的任务,保留原人工流程作为对照。连续运行两到四周后,再比较总耗时、错误率和审核负担。若生成更快但返工更多,就不能简单称为效率提升。
Anthropic 对自有产品使用情况的经济指数分析也显示,不同职业和任务在协作增强与直接自动化之间差异明显。这类平台数据能帮助观察使用模式,但受到用户构成和产品特性的影响,不能替代团队自己的流程数据。
AI 进入非技术工作后,最值得学习的并不是某一套提示词,而是流程意识:知道输入来自哪里,知道完成标准是什么,知道哪些错误可以自动发现,也知道哪些决定必须由人理解并负责。
从一个任务开始,把它拆成确定性处理、语义判断、程序验证和人工决策四部分。能稳定通过验收的部分再逐步自动化,不能验证的部分则保留边界。这样的改造速度可能没有想象中那么快,却更容易形成长期可用的工作方法。
感谢各位大佬支持!!!
互三啦!!!