谷歌发布 Gemini 4 Argon,单次输出上限从 6.4 万 Token 拉到 100 万。
我判断,这条新闻的分量不在又发了个旗舰,在于它把一个被忽视的指标------输出上限------推到台前。而且谷歌做了 OpenAI 没做的选择:因为 Argon 漏洞发现能力太强,它分批发布,先给防御者不给攻击者。
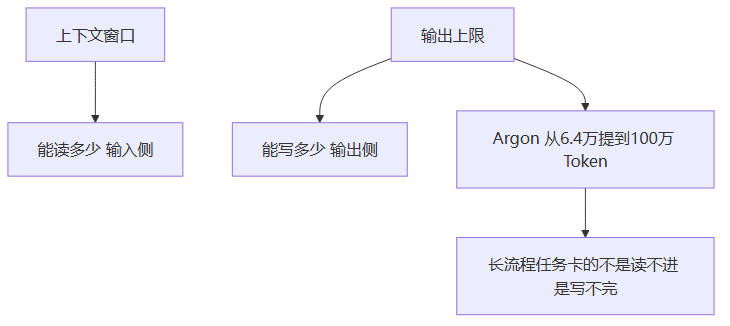
上图:100 万 Token 是输出上限不是上下文窗口,解决的是「一口气干长活」的问题。
100 万是输出,不是上下文
这里有个关键区分,很多报道混了。上下文窗口是模型能读多少,输入侧;输出上限是模型能写多少,输出侧。
Argon 突破的是后者,单次输出从 6.4 万 Token 提到 100 万。多数前沿模型输出上限约 12.8 万,Argon 是近 8 倍。
这个区分为什么重要:上下文窗口决定模型能看多长的资料,输出上限决定模型能一口气干多长的活。长流程任务------大型代码迁移、深度研究、多步企业流程------卡的不是读不进,是写不完。Argon 把写的天花板抬高了 15 倍,这才是它对长流程定位的底气。
不是刷榜,是实打实搬代码
Argon 的软件工程成绩,是这轮发布里最硬的部分。DeepSWE v1.1 得分 77.9%,超过 Claude Opus 5.5 的 74.2% 和 GPT-6 Astra 的 74.1%。它已在谷歌内部大规模使用,参与 C/C++ 到 Rust 的迁移,覆盖超过 80 万行 Fuchsia Zircon 内核代码。在 libgav1 项目里重写了约 3.2 万行 SIMD 代码,新版本速度是原版的 2.7 倍。
80 万行内核迁移、3.2 万行 SIMD 重写、2.7 倍提速,这三个数字比任何 benchmark 分数都更有说服力。因为它们不是测试集刷分,是生产代码库里干了真活。这和我之前写 Claude 九圈散射振幅是同一个母题:AI 的工程执行力,正在从能写对走向能搬完一整个代码库。
双用途风险:先给防御者
Argon 最值得注意的发布策略,是分批发布。因为漏洞发现能力太强,存在双用途风险,首批只通过 Fairwind Program 提供给受信任的网络安全防御者,之后再向付费客户、Google AI Ultra 用户开放,最后才到企业和普通消费者。
网络安全公司 Wiz 已经用 Argon 发现了影响全球医院医疗软件的严重漏洞,此前的前沿模型都没识别出来。
这个先防御者后大众的策略,和 OpenAI 之前取消 Astra 发布形成鲜明对比。OpenAI 发现不安全直接取消;谷歌发现太强就分批放行,先给好人。
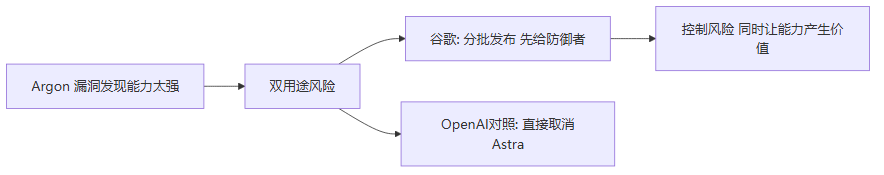
上图:分批、分层、分对象发布,是双用途风险治理的新答案。
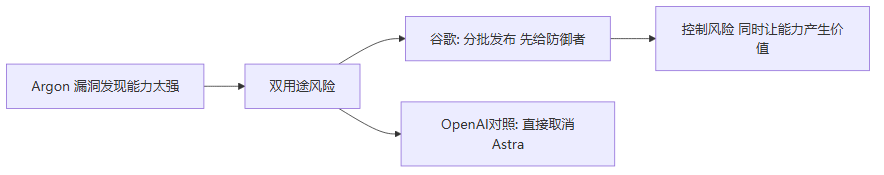
上图:同样是能力太强,谷歌分批放行,OpenAI 直接取消,两条安全策略的对比。
我的判断
100 万 Token 输出,是比任何 benchmark 都重要的信号。 我判断,智能体时代的竞争会从模型能答多准,转向模型能一口气干多长的活。长流程任务真正的瓶颈是输出上限。Argon 把指标抬到 100 万,等于给长流程智能体扫清了一个核心障碍。这个指标接下来会变成各家旗舰模型的标配军备。
80 万行内核迁移,比 77.9% 的 DeepSWE 分数更值得信。 我原以为这种参与生产代码库迁移的宣传会有水分,但 3.2 万行 SIMD 重写、2.7 倍提速、覆盖 Fuchsia Zircon 内核,这些是能在代码库里验证的事实。我判断谷歌这次是真在内部用 Argon 干重活,不是发布前刷个分。
分批发布是双用途风险的一个新答案。 这是我最看好的一点。OpenAI 面对能力太强选择取消,谷歌选择先给防御者。后者承认了能力的双用途,但没废掉它,而是用受信任对象来隔离风险。我判断,随着前沿模型越来越强,分批、分层、分对象发布会成为行业标准做法,这是 AI 安全治理的下一阶段。
一句话:Gemini 4 Argon 用 100 万 Token 输出,给智能体时代补上了「一口气干长活」的能力;而它先防御者后大众的分批发布,是比取消发布更务实的双用途风险解法。
每日更新。