**一句话讲清楚:**RAG、Agent记忆、推荐系统背后都靠向量数据库做语义检索。但Chroma、Qdrant、Milvus、Redis Vector、PgVector到底怎么选?这篇从原理到选型逻辑一次讲透。
01 什么是向量数据库,为什么不能用MySQL硬扛
向量数据库是专门存储、索引、检索高维向量的专用数据库。文本、图片、音频经过Embedding模型变成一串数字(比如1536维),向量数据库的核心活儿就是:给定一个查询向量,快速找出语义最接近的那些。
传统数据库只能做精准匹配(WHERE id=123)和模糊匹配(LIKE '%关键词%'),它不理解"手机"和"移动电话"语义相近。向量数据库通过距离算法(余弦、欧氏)计算语义相似度,这是RAG知识库、Agent记忆检索、推荐系统的底层基础设施。
为什么不能用MySQL存向量数组?
数据量小(几百条)暴力遍历确实能跑。但到了万级以上,每次查询都要把Query向量和所有向量逐个算距离,时间复杂度O(N),多人并发直接崩。向量数据库内置ANN(近似最近邻)索引,用极小的精度损失换百倍提速,还支持过滤、分片、持久化。
02 五大主流方案横向对比
直接上对比表,一目了然:
方案
技术栈
数据量级
运维成本
适配场景
ChromaPython 嵌入式
<10万
零运维
本地开发、Demo验证
QdrantRust
10万~千万
低
中小规模生产RAG
MilvusC++/Go 分布式
亿级以上
高(需K8s)
大型企业、海量数据
Redis VectorC(Redis Stack)
热点缓存级
低(已有Redis)
微秒级热点检索
PgVectorPG插件
<百万
极低(复用PG)
存量PG轻量改造
Chroma:纯Python嵌入式,零配置,import就能用。但不支持分布式、无SLA,只适合本地Demo,别上生产。
Qdrant:Rust写的,性能强、延迟稳、单节点扛百万级。Docker一条命令部署,中小团队生产首选,性价比最高。
Milvus:国内企业落地最多的分布式方案,支持亿级向量、IVF/HNSW/DiskANN/GPU多种索引。但依赖etcd、MinIO、K8s,运维门槛高,小团队用着浪费。
Redis Vector:Redis Stack内置,微秒级响应。适合已有Redis架构、做热点缓存和实时推荐,不适合存海量冷数据。
PgVector:PostgreSQL插件,SQL和向量检索混查最自然。性能远不如专用DB,但存量PG项目零改造升级AI能力,成本最低。
03 选型决策逻辑:一张图搞定
选型不看个人喜好,看四个硬指标:数据量级、并发要求、延迟指标、运维能力。
决策树:
· 数据量 < 10万、做Demo → Chroma
· 10万~千万级、中小团队生产 → Qdrant
· 亿级以上、需要集群高可用 → Milvus
· 已有Redis、做热点缓存 → Redis Vector
· 存量PG项目轻量改造 → PgVector
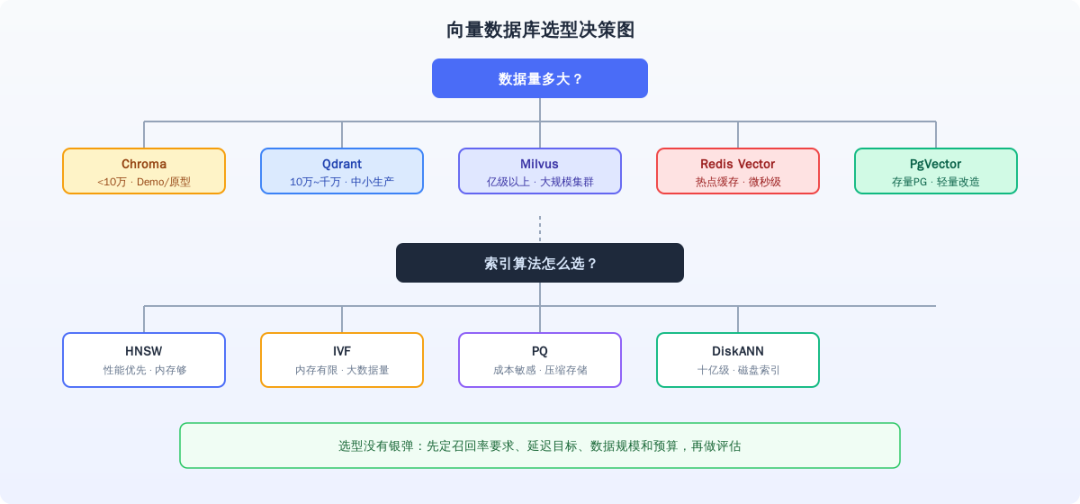
图:向量数据库选型决策图
04 核心索引算法:HNSW / IVF / PQ / DiskANN
向量数据库快不快,关键看索引算法。四种主流算法各有取舍:
HNSW(分层导航小世界图):查询最快,但索引常驻内存。内存够、追求低延迟就选它,Qdrant和Milvus默认推荐。
IVF(倒排文件,K-Means聚类):把向量分成N个桶,查询只搜邻近几个桶。内存比HNSW省,适合大数据量但内存有限。
PQ(乘积量化):把向量压缩成短编码,内存省几倍但召回率略降。存储成本敏感时用。
DiskANN:基于磁盘的索引,十亿级以上塞不进内存时的选择,Milvus支持。
面试追问:索引算法怎么选?
性能优先选HNSW,内存有限选IVF,成本敏感选PQ,超大规模选DiskANN。实际项目经常混用------热数据HNSW走内存,冷数据PQ压缩存磁盘。
05 高频面试题:怎么答才不像背的
Q1:为什么不用MySQL存向量?
关键看数据规模。几千条pgvector或FAISS能跑,但到了xx万条,每次查询暴力遍历,并发上去延迟直接崩。向量数据库的核心价值不是"存向量",而是ANN索引+过滤+分片+持久化这一整套工程能力,在可接受的召回损失下把延迟降下来。
Q2:Milvus和PgVector怎么选?
本质是定位不同。Milvus是专门的分布式向量数据库,Proxy/QueryNode/DataNode/IndexNode分工扩展,数据量大、并发高时撑得住。PgVector是PG插件,优势在于向量检索和业务SQL混查自然。选型:数据量大增长快选Milvus;数据中等、要和业务数据深度整合选PgVector。
Q3:选型核心考量有哪些?
四个维度:数据规模与增长预期、读写比例与延迟要求、查询复杂度(纯向量 vs 混合过滤)、运维能力与成本。没有绝对好坏,关键是能力和约束匹配------先定召回率要求、延迟目标、数据规模和预算,再做评估,别只看性能榜单。
**落地总结:**向量数据库选型没有银弹。Demo用Chroma快速验证,生产中小规模用Qdrant性价比最高,亿级以上上Milvus,已有Redis做热点缓存,存量PG做轻量改造。索引算法按"性能优先HNSW、内存有限IVF、成本敏感PQ、超大规模DiskANN"来选。
关注我们,一起把技术讲明白(寻码札记)。