布尔掩码、整数索引、条件选择与形状安全的数组工作流
适用读者:需要可靠数组过滤、索引、排序和条件赋值的 Python 开发者、数据分析师、工程师与学生。
1. 为什么选择操作重要
Selection(选择)是从 NumPy 数组中选取元素、行、列或子数组的操作。它把原始数值存储连接到 实际计算:掩码可以筛选有效测量值,整数索引可以重新排列观测,argmax 等归约操作可以定位最优值。本指南建立系统的选择模型,并介绍如何编写清晰、向量化、形状安全且高效的选择代码。
- 选择是向量化操作:一个表达式即可处理数百万个数值,而不必编写 Python 循环。
- 选择代码可以清楚区分条件、索引以及最终得到的数据。
- 选择会影响形状、广播、视图、复制、数据类型和内存布局。
- 高质量代码会明确处理缺失值、边界条件和维度假设。
2. 核心术语
|--------|---------------------------|----------------------|
| 概念 | 含义 | 典型表达式 |
| 布尔掩码 | 与数据对齐的 True/False 数组 | aa \> 0 |
| 整数索引 | 用于选择、排序或重复元素的位置 | a\[3, 0, 3] |
| 切片 | 由 start、stop、step 定义的规则区间 | a1:8:2 |
| 归约 | 返回更小结果或位置的操作 | np.argmax(a, axis=1) |
| 坐标 | 多维数组中的行、列或维度位置 | np.nonzero(a) |
import numpy as np
a = np.array(-3, 0, 4, 7, -1)
positive = aa \> 0
positions = np.flatnonzero(a > 0)
print(positive) # 4 7
print(positions) # 2 3
3. 布尔掩码
布尔掩码通常具有与源数组兼容的形状。对数组应用掩码后,只会返回掩码为 True 位置的值。在使用 &、| 或 ~ 组合比较条件时,应给每个比较表达式加括号,因为这些运算符与比较运算符的优先级不同。
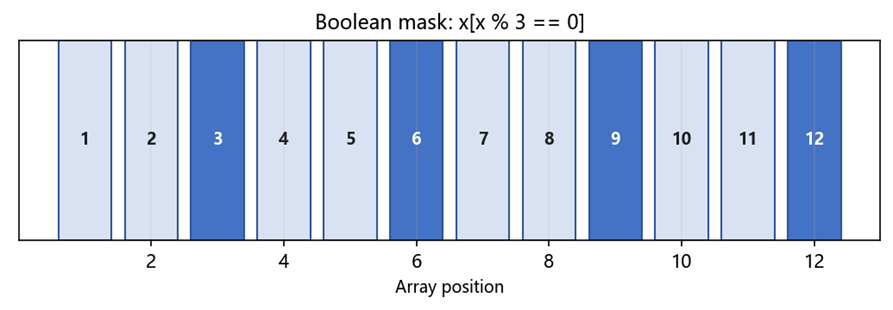
图 1 :掩码保留能够被 3 整除的元素。
x = np.arange(1, 13)
mask = (x % 3 == 0)
selected = xmask
selected -> array( 3, 6, 9, 12)
对每个元素组合条件
valid = (x >= 4) & (x <= 10)
subset = xvalid
使用 & 表示逐元素 AND,| 表示逐元素 OR,~ 表示逐元素 NOT。不要对 NumPy 数组使用 Python 的 and/or,因为它们需要一个真值,而数组包含多个真值。
4. 多维数组选择
对于二维数组,布尔掩码可以选择单个单元格;显式的行、列索引则能表达矩形选择或成对坐标选择。切片通常保留维度,而一维整数数组可能改变结果形状。
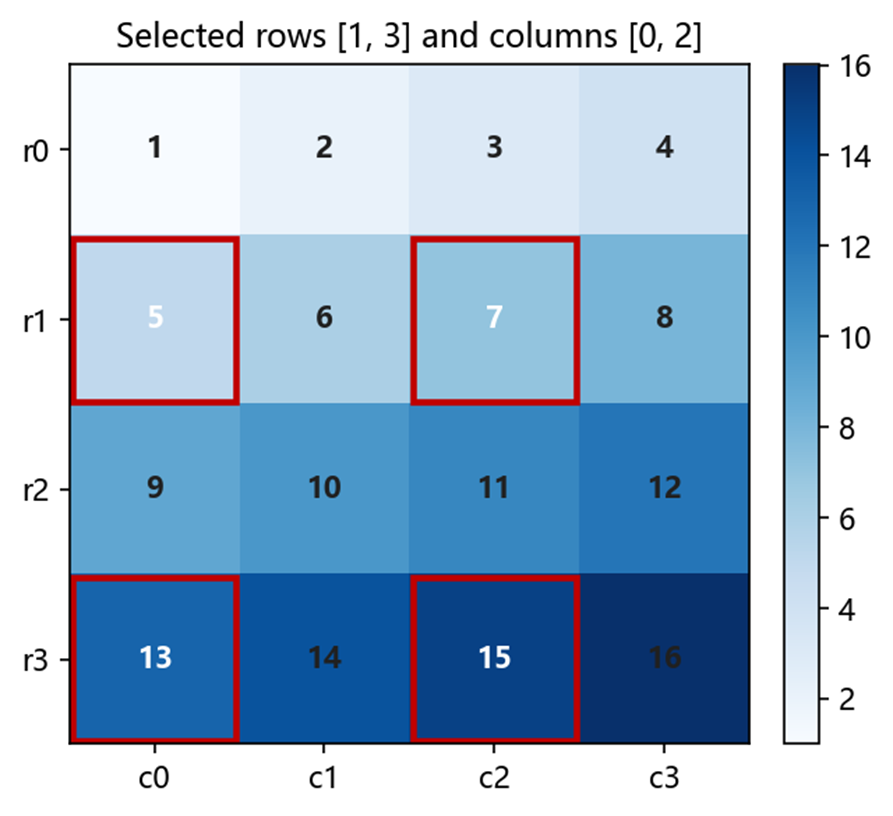
图 2 :高亮单元格来自指定的行与列。
a = np.arange(1, 17).reshape(4, 4)
rows = np.array(1, 3)
cols = np.array(0, 2)
rectangular = anp.ix_(rows, cols)
\[ 5 7
13 15]
row_slice = a1:4:2, : # 仍为二维结果
当需求是行与列的笛卡尔积时,`np.ix_` 很有用。相反,`arows, cols` 会将两个索引配对,返回 a1, 0 和 a3, 2 对应的一维结果。使用前必须明确需要矩形还是成对坐标。
5. 切片、视图与副本
|-----------------------|----------|----------|----------|
| 技术 | 形状行为 | 内存行为 | 适用场景 |
| astart:stop | 规则子区间 | 通常为视图 | 选择连续区域 |
| amask | 压缩为匹配值 | 通常为副本 | 按条件过滤 |
| aindex_array | 由索引形状决定 | 通常为副本 | 重排或重复 |
| a.take(indices, axis) | 沿显式轴选择 | 结果数组 | 强调轴意图 |
视图与源数组共享存储,因此赋值可能同时改变两者。布尔索引和高级整数索引通常会产生新数组。如果接口要求独立所有权,请显式调用 `.copy()` 并说明原因。
a = np.arange(6)
view = a1:4
view0 = 99
a 现在是 0, 99, 2, 3, 4, 5
filtered = aa \> 2.copy()
filtered: = 0 # 不会修改 a
6. 整数数组索引
整数数组索引可以用简洁方式收集任意顺序的元素。索引可以重复,而且索引数组的形状会成为结果形状。这对于排名、查找表、训练/测试划分和近邻结果都很有用。
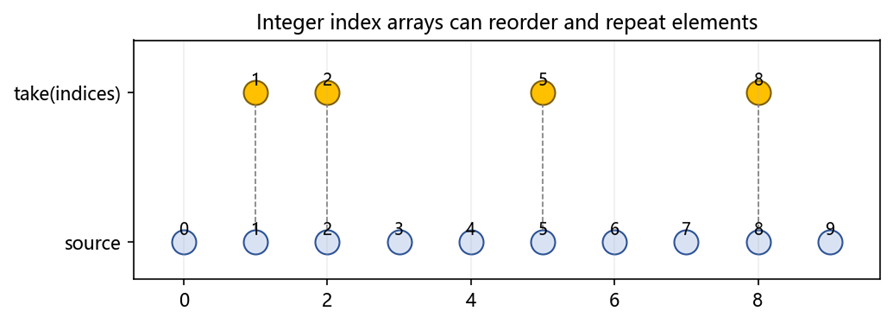
图 3 :整数索引数组可以重新排序并重复源位置。
scores = np.array(8, 3, 12, 5, 10, 2, 7, 11)
order = np.argsort(scores)::-1
ranked_scores = scoresorder
ranked_positions = order
lookup = np.array(100, 200, 300)
keys = np.array(2, 0, 2, 1)
print(lookupkeys) # 300 100 300 200
7. 使用 argmin、argmax 与 nonzero 查找位置
选择经常从"查找位置"开始。`np.argmax` 和 `np.argmin` 沿指定轴返回最大值或最小值的位置。`np.flatnonzero` 返回扁平位置,`np.nonzero` 则为每个维度返回一个坐标数组。
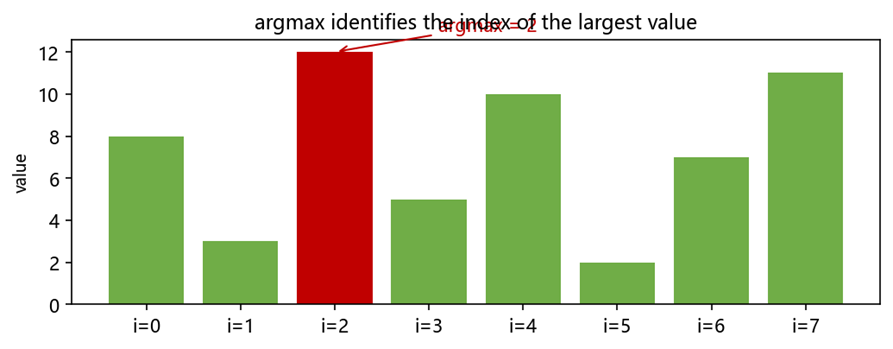
图 4 : argmax 返回最大值所在的索引。
scores = np.array(\[4, 9, 2, 8, 1, 7])
row_winners = np.argmax(scores, axis=1)
1 0
flat_positions = np.flatnonzero(scores >= 7)
coordinates = np.nonzero(scores >= 7)
coordinates0 -> 行坐标
coordinates1 -> 列坐标
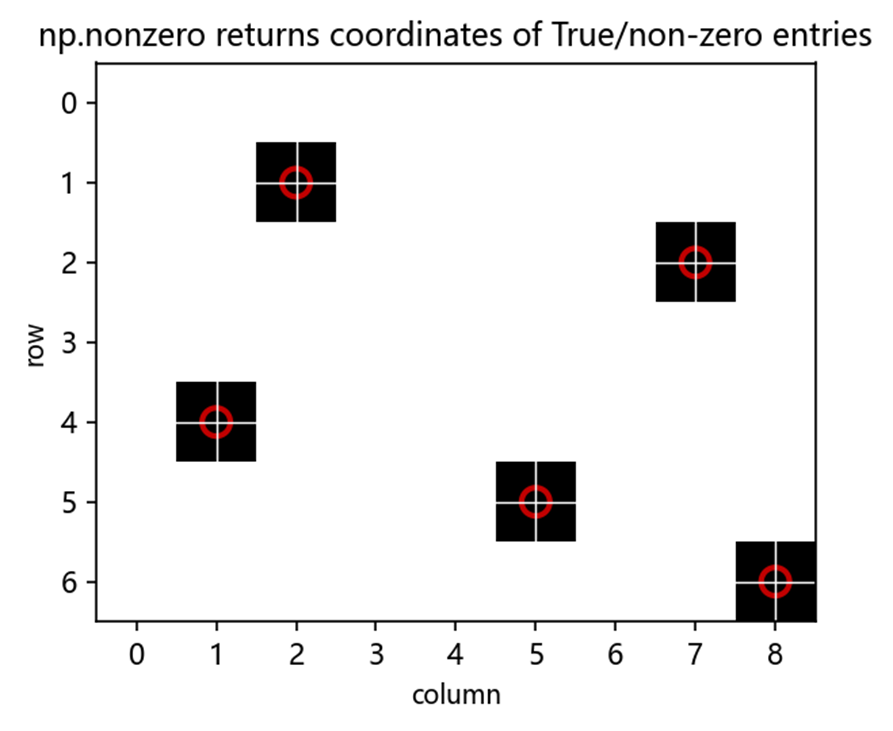
图 5 : nonzero 暴露非零单元格的坐标。
8. 使用 where 与 select 进行条件选择
`np.where(condition, x, y)` 在两个可广播值之间选择,适合二选一。`np.select` 处理多个有序条件,并且可以显式指定默认类别。条件会按顺序处理,因此重叠条件应从最具体到最一般排列。
temperature = np.array(-2, 5, 18, 31)
label = np.where(temperature >= 20, 'hot', 'not hot')
conditions = temperature \< 0, temperature \< 20
choices = 'freezing', 'mild'
labels = np.select(conditions, choices, default='hot')
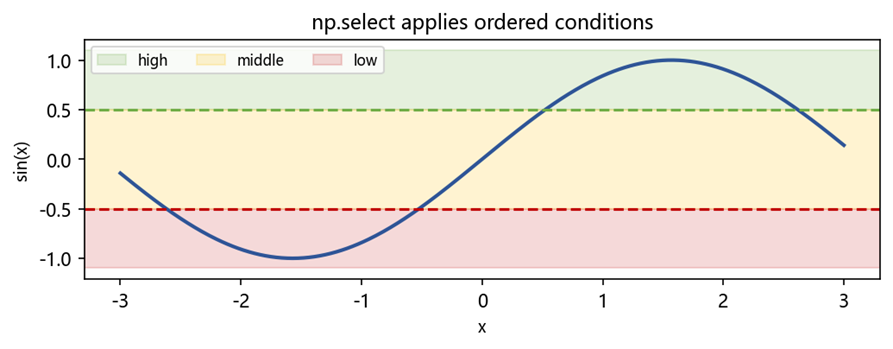
图 6 :有序条件把数值划分到不同类别。
|-----------|-----------------|----------|
| 函数 | 返回值 | 常见用途 |
| np.where | 来自 x 或 y 的值 | 二路条件替换 |
| np.select | 第一个匹配条件的 choice | 多路分类 |
| np.choose | 由索引选择的数组值 | 从多个数组选择 |
| np.take | 沿轴收集的值 | 明确的轴选择 |
9. 形状安全的选择模式
最常见的选择错误是形状错误。索引前应检查 `array.shape`、掩码形状和目标轴。掩码与数组形状一致时可以逐元素使用;把一维掩码应用到二维数组的第一个轴时,通常表示选择行。
data = np.arange(20).reshape(5, 4)
row_mask = np.array(True, False, True, False, True)
selected_rows = datarow_mask # shape (3, 4)
column_mask = np.array(True, False, True, False)
selected_columns = data:, column_mask # shape (5, 2)
cell_mask = data % 3 == 0
selected_cells = datacell_mask # shape (匹配数量,)
|-------------|----------------------------|------------------------|
| 问题 | 诊断方法 | 更安全的做法 |
| 筛选的是哪个轴? | 打印选择前后的 shape | 使用 `axis=` 或显式 `:` |
| 掩码是否对齐? | 比较 mask.shape 与 data.shape | 从同一个数组生成掩码 |
| 是否还需要坐标? | 判断仅有值是否足够 | 使用 nonzero/flatnonzero |
| 赋值是否会修改原数组? | 确认索引是否产生视图 | 需要所有权时调用 copy |
10. 通过选择进行赋值
选择结果可以出现在赋值语句左侧。右侧可以是标量,或者是能够广播到选中区域的数组。这种方式可以在没有循环的情况下完成清洗、截断、填补和标记。
data = np.array(2., -1., 5., np.nan, 8.)
替换负值
datadata \< 0 = 0
使用统计量替换缺失值
missing = np.isnan(data)
datamissing = np.nanmean(data)
截断异常大的观测
datadata \> 7 = 7
对于链式索引,最好使用一个完整的索引表达式。例如 `datamask0 = value` 中第二次操作可能作用于临时数组,而不是原数组。应使用明确坐标,或者直接通过 `datamask` 赋值。
11. 稳健过滤工作流
- 把有效性条件分别定义,并使用有意义的变量名。
- 用括号和逐元素运算符组合条件。
- 在昂贵操作前使用 `mask.sum()` 统计匹配数量。
- 过滤表格数据时保留原始行标识。
- 如果要独立编辑结果,使用 `copy()`。
- 测试空选择、全 True、全 False 以及包含 NaN 的情况。
12. 性能与内存考虑
布尔索引和高级索引表达力强,但会创建结果数组。对于超大数组,掩码本身需要内存,筛选结果也需要额外内存。切片描述规则区域,通常成本更低,并且常常是视图。最佳方案取决于你需要压缩后的结果,还是规则窗口。
|--------|-------------------------------------|-----------|
| 场景 | 推荐模式 | 原因 |
| 连续时间窗口 | astart:stop | 紧凑且通常为视图 |
| 满足规则的值 | amask | 直接向量化过滤 |
| 前 k 个值 | idx = np.argpartition(a, -k)-k: | 不需要完整排序 |
| 完整排名 | idx = np.argsort(a) | 得到完整顺序 |
| 稀疏坐标 | np.nonzero(mask) | 存储位置而非稠密值 |
a = np.array(8, 3, 12, 5, 10, 2, 7, 11)
k = 3
快速得到 top-k 候选位置,只对小候选集排序
candidate = np.argpartition(a, -k)-k:
ordered = candidatenp.argsort(a\[candidate)::-1]
print(ordered, aordered)
13. 常见错误与修复
|-----------------------------|--------------------|---------------------------|
| 错误 | 失败原因 | 修复 |
| 使用 and / or | 数组包含多个真值 | 使用带括号的 & / | |
| 忽略 axis | 归约了错误的维度 | 明确写出目标 axis |
| 混淆配对与矩形索引 | 两个索引数组会配对坐标 | 矩形选择使用 np.ix_ |
| 使用 amask... = value | 第二次操作可能针对临时结果 | 一次性完成赋值 |
| 忽略 NaN | 与 NaN 的比较结果为 False | 使用 np.isnan 或 np.isfinite |
14. 完整示例:质量筛选
下面的例子保留有限、位于允许范围内并且状态为 approved 的测量值,然后在保留结果中找出得分最高的原始位置。
measurements = np.array(12.5, np.nan, 8.1, 21.0, 15.4, 6.8)
status = np.array('ok', 'ok', 'hold', 'ok', 'ok', 'ok')
valid = (np.isfinite(measurements)
& (measurements >= 10)
& (measurements <= 20)
& (status == 'ok'))
kept_positions = np.flatnonzero(valid)
kept_values = measurementsvalid
best_position = kept_positionsnp.argmax(kept_values)
print(kept_positions, kept_values, best_position)
15. 快速参考
|--------|-----------------------------------------|----------|
| 目标 | 表达式 | 结果 |
| 过滤值 | aa \> threshold | 一维匹配值 |
| 过滤行 | arow_mask, : | 由掩码选择的行 |
| 选择列 | a:, column_mask | 由掩码选择的列 |
| 获得匹配位置 | np.flatnonzero(mask) | 扁平整数位置 |
| 获得坐标 | np.nonzero(mask) | 坐标数组元组 |
| 查找最大位置 | np.argmax(a, axis=axis) | 最大值索引 |
| 重新排序 | aorder | 按指定顺序排列 |
| 二选一 | np.where(cond, x, y) | 广播后的条件结果 |
| 多路选择 | np.select(conditions, choices, default) | 有序分类结果 |
| 沿轴收集 | np.take(a, indices, axis) | 明确轴的收集结果 |
16. 最终检查清单
- 条件是否使用了 NumPy 的逐元素运算符?
- 掩码是否与目标轴和形状一致?
- 你需要的是值、位置,还是两者都要?
- 空结果或 NaN 是否会改变后续逻辑?
- 结果是否要编辑,因而需要 `.copy()`?
- 切片、take、nonzero、argpartition 或 argsort 是否更能表达意图?
当这些问题都明确后,NumPy 选择就会变得可预测:构造条件或索引,检查形状,选择数据,并保留后续解释所需的坐标。
通信与计算Adv链路/系统/网络仿真05:SimPy 与移动网络:蜂窝系统的离散事件仿真-CSDN博客
通信与计算Adv链路/系统/网络仿真04:SimPy 与 IP 网络:分组系统的离散事件仿真-CSDN博客
通信与计算Adv链路/系统/网络仿真03:SimPy 实用指南-Python 离散事件仿真-CSDN博客