 @bit::Shadow
✧(≖ ◡ ≖✿
目录
[⚙️ 以 16KB 为单位进行的核心动作](#⚙️ 以 16KB 为单位进行的核心动作)
[聚簇索引 VS 非聚簇索引](#聚簇索引 VS 非聚簇索引)
[*索引覆盖 索引最左匹配原则 复合索引](#*索引覆盖 索引最左匹配原则 复合索引)
[🛠️ 创建与使用](#🛠️ 创建与使用)
[🎯 三种搜索模式](#🎯 三种搜索模式)
本文系统解析InnoDB引擎下B+树索引机制,重点阐述16KB数据页对I/O效率的优化作用。B+树"矮胖"结构极大减少磁盘读取次数,支持高效范围查询与稳定性能。对比B树,其仅在叶子节点存数据,且节点间双向链表连接,实现聚簇索引优势。通过主键、唯一、普通及复合索引构建,结合最左匹配原则与索引覆盖,显著提升查询效率。全文索引适用于大文本检索,需配合MATCH...AGAINST使用,支持自然语言、布尔及查询扩展三种模式。索引虽降低写操作开销,但显著提升读性能,是数据库优化核心手段。
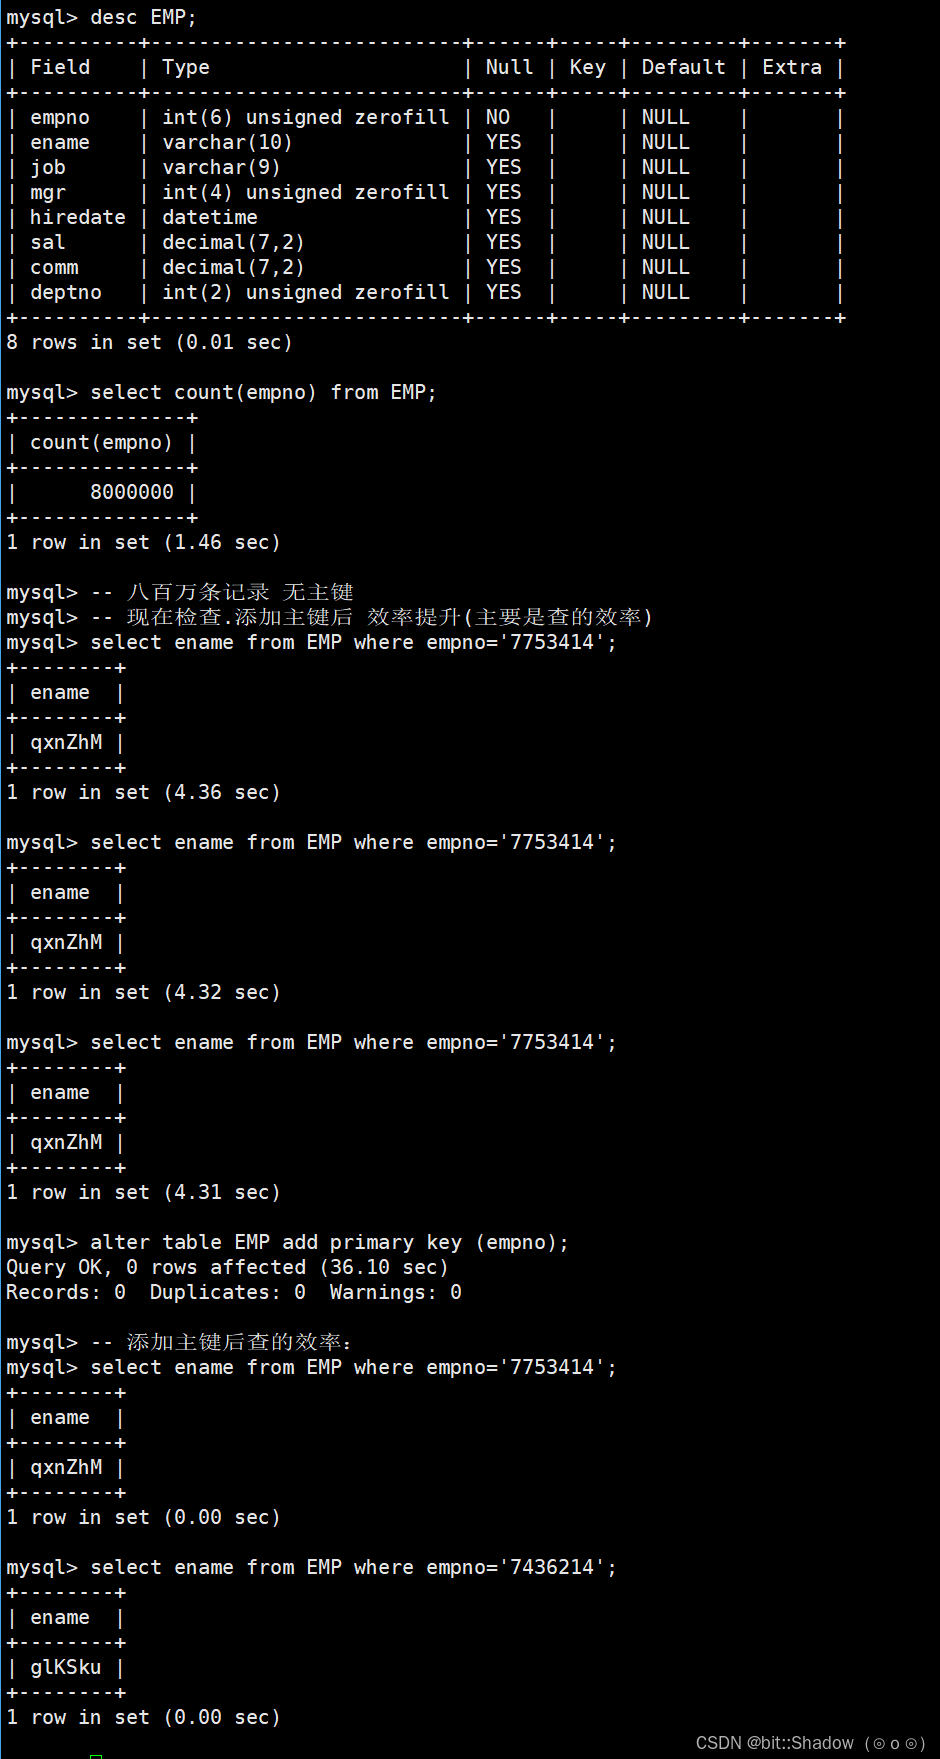
有无索引对效率的提示对比
有无索引的查找效率对比:
指数级效率提升
索引
索引:大大减少了'查'的消耗,适当增加了除'查'以外的消耗。
⚙️ 以 16KB 为单位进行的核心动作
16KB 是 InnoDB 存储引擎的默认数据页(Page)大小 。它不仅仅是存储单位,更是 InnoDB 管理磁盘与内存之间 I/O 交互的最小单位
1. 磁盘与内存的 I/O 交互
这是最基础的动作。InnoDB 从磁盘读取数据时,最少读取 16KB;将内存数据刷新回磁盘时,也最少 写入 16KB。这种设计是为了++避免频繁的小数据量 I/O,通过一次读取一整个页来提升效率。++
2. 构建 B+ 树索引节点
InnoDB 的索引结构 B+ 树,其每一个节点(无论叶子节点还是非叶子节点)都对应一个 16KB 的数据页 。B+ 树的"矮胖"特性正是基于 16KB 的页大小设计的。例如,一个 16KB 的非叶子节点,通常可以存放约 1000 个 主键指针,这意味着一个高度为 3 层的 B+ 树,大约可以支撑 10 亿级别 的数据量,而查询通常只需要 1~3 次磁盘 I/O。
B+树
B+树是MySQL中存储引擎(innodb等)主要使用的作为索引的CURD结构。(基于键构建索引)
结构如下
B+树的结构可以形象的比作"书籍目录+具体章节"的查询结构,不过为了存储大量数据不得不根据需要对目录做更上一层的"套娃",使用目录的目录来管理目录。(一级目录管理二级目录,二级目录管理具体章节)
注:通常情况下三层的B+树就可以管理10亿级别的数据。
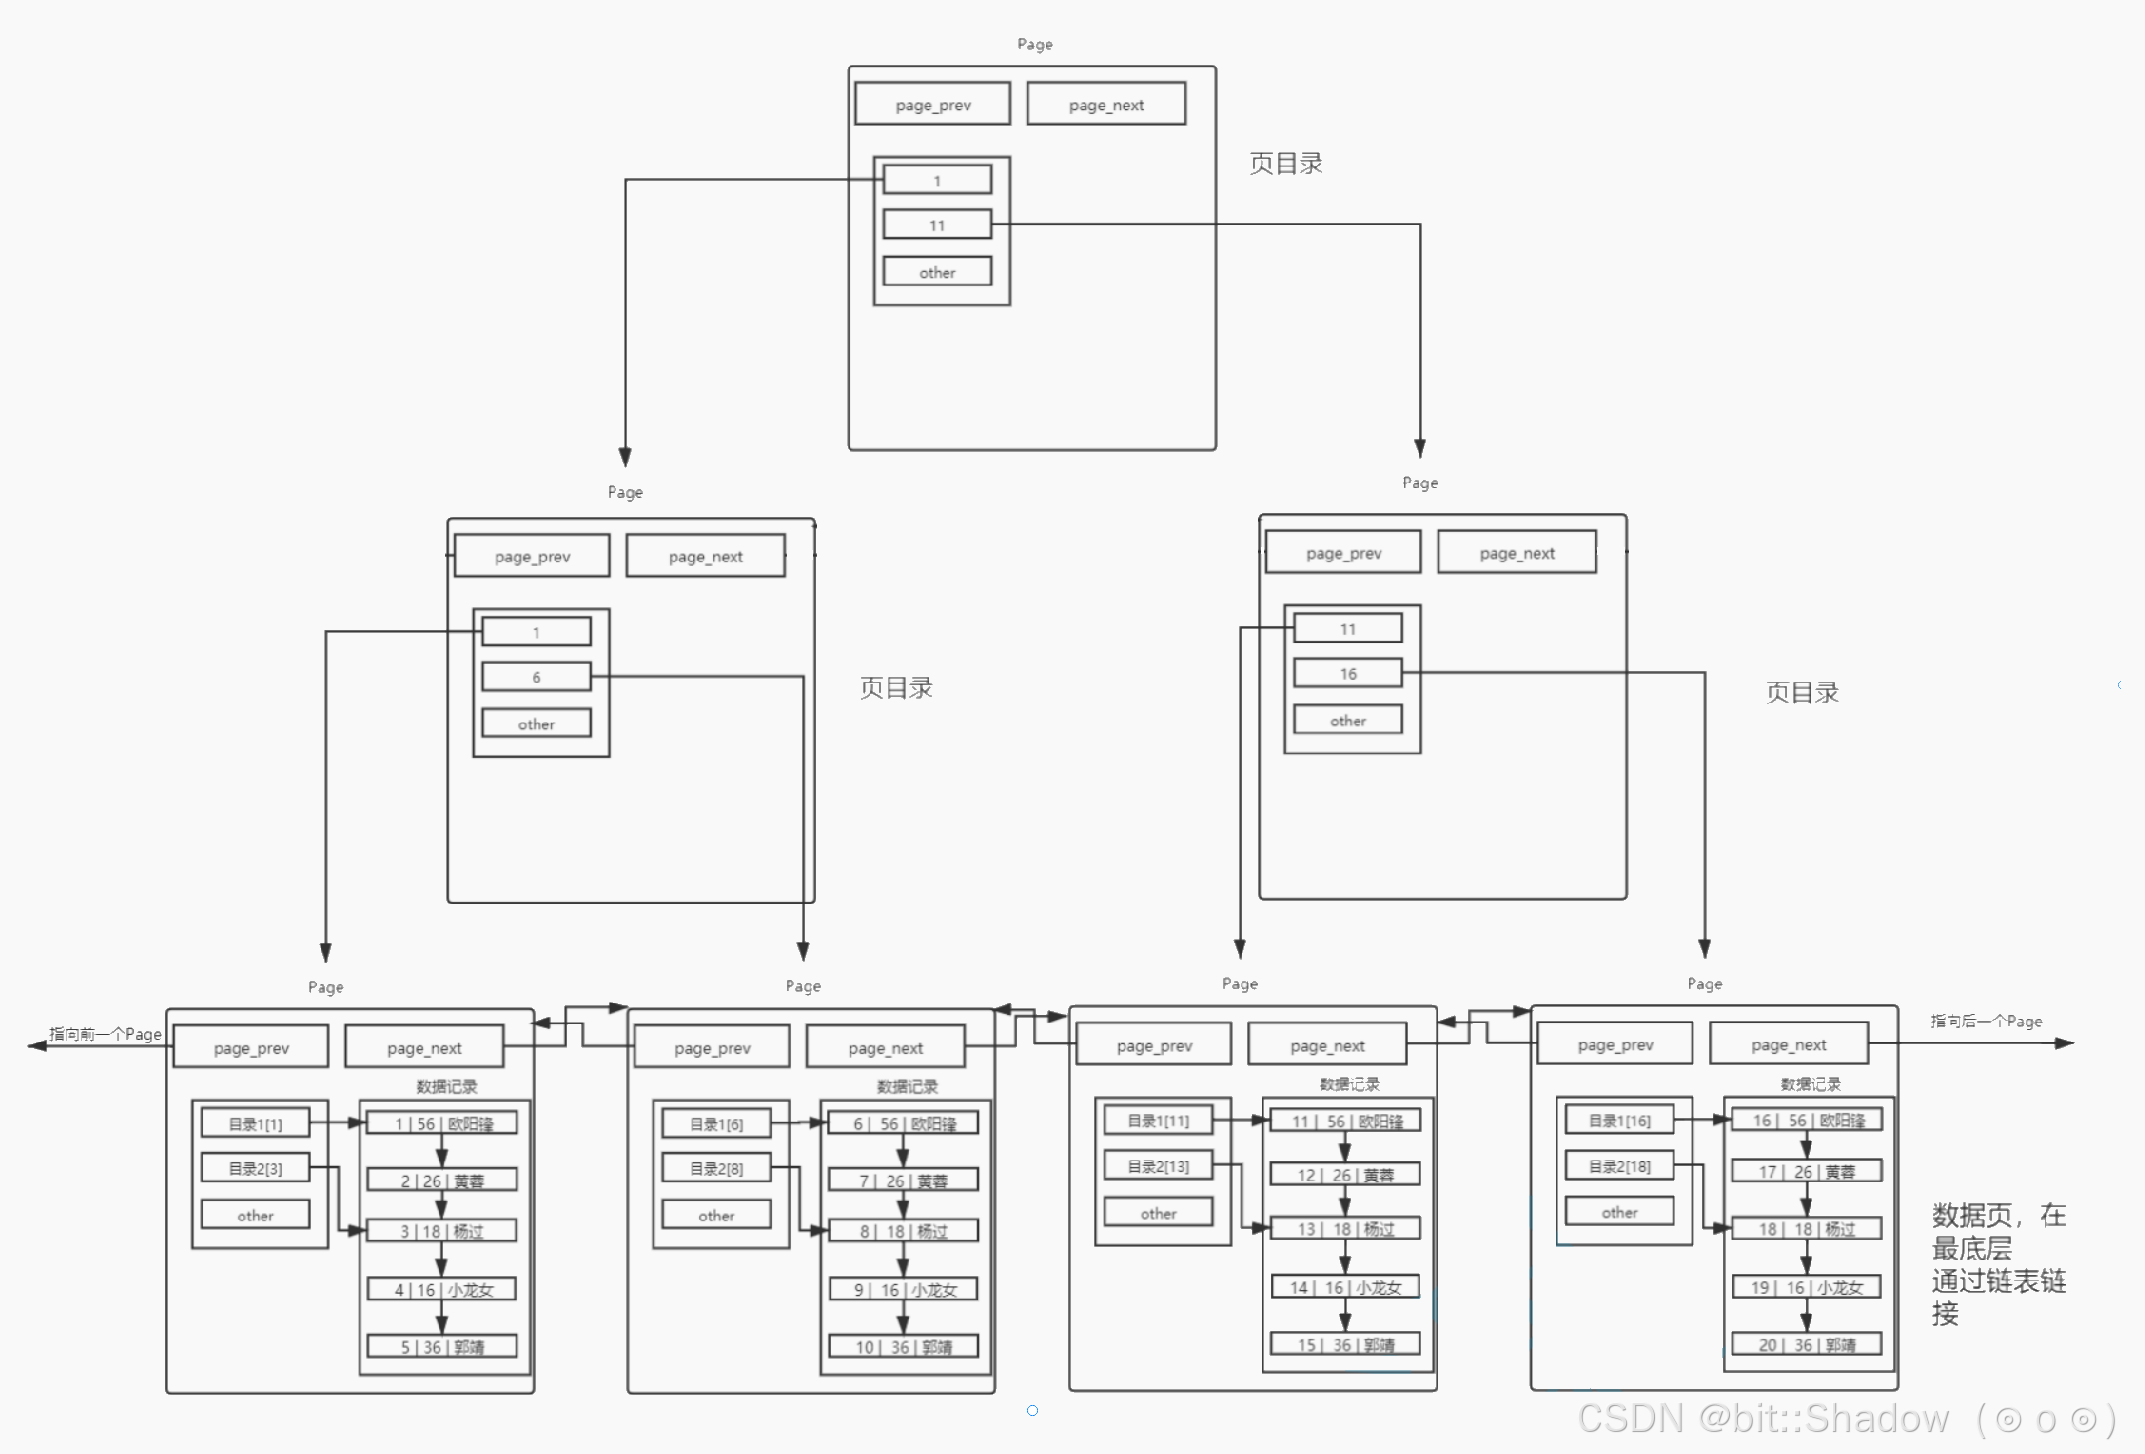
注意:
1.仅叶子节点间存在前后索引。
2.无主键MySQL++自动构建"隐藏主键"++。(来组织B+树结构)
B+树的特点:
1.非叶子节点++只存在键,不存在数据++。(只用于导航 所以空间十分富裕)
2.叶子节点间使用++双向链表++链接。
3.所有叶子节点在++同一层++,树是平衡的。
B+树作为索引依赖的核心优势:
1.极度"矮胖"的结构,大大压缩了以"读"为主的磁盘I/O消耗。
2.范围查询高效。
3.查询性能稳定。(因为全部节点都在同一层)
4.适合磁盘预读。
B树的结构:
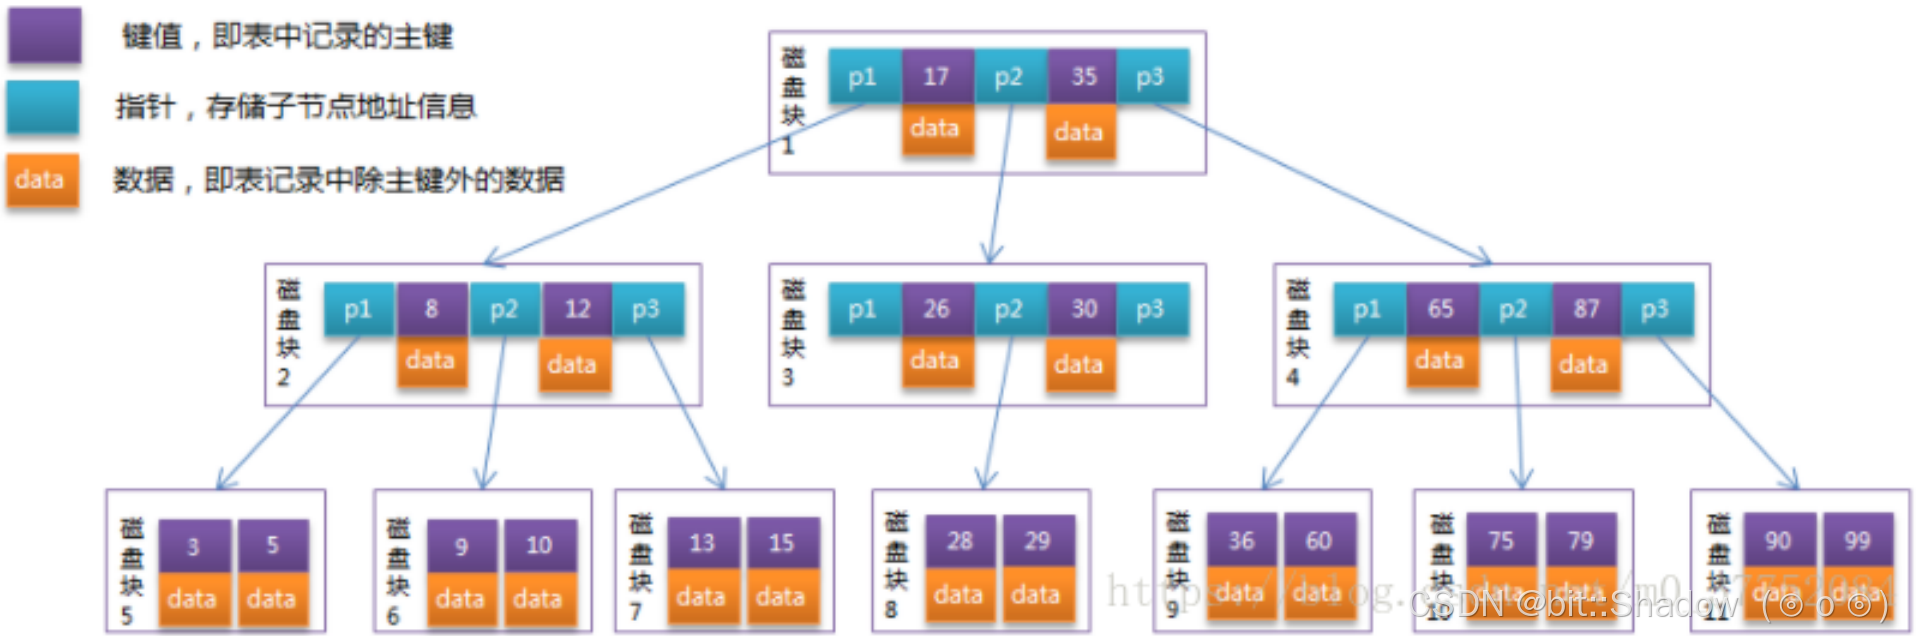
B树较于B+树不适合索引的搜索结构,因为在每层中都存在"data"数据。
聚簇索引 VS 非聚簇索引
MyISAM使用的非聚簇索引叶子节点的data区域存放的是数据的地址,而InnoDB使用的是聚簇索引将叶子节点的索引与数据是存放在一起的。
MyISAM使用非聚簇索引情况下直接存放的地址索引于另一个索引结构,因此需要再次查找(这就是MyISAM的回表查询)。
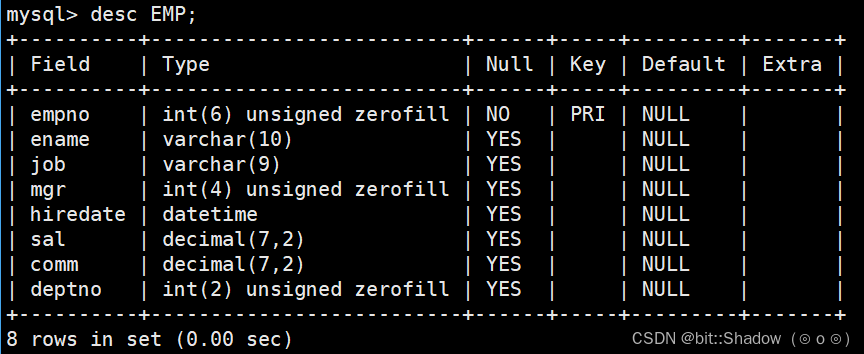
主键可以有多列构成--->复合主键 --->索引于复合主键--->复合索引
创建索引
创建主键索引:
sql
CREATE TABLE emp (
  empno INT ,
  ename VARCHAR(20),
  primary key(empno)
);
创建唯一键索引
sql
CREATE TABLE emp (
  empno INT ,
  ename VARCHAR(20),
  unique key unqk_name(empno) -- 唯一键索引名称'unqk_name'
);
创建普通键索引
sql
CREATE TABLE emp (
  empno INT PRIMARY KEY,
  ename VARCHAR(20),
  deptno INT,
  INDEX idx_name (deptno) -- 普通键索引名称
);
删除索引
删除主键索引
sql
ALTER TABLE 表名 DROP PRIMARY KEY;删除唯一键、普通键索引
sql
alter table 表名 drop index 唯一键/普通键索引名; 查看索引
sql
show index from 表名 \G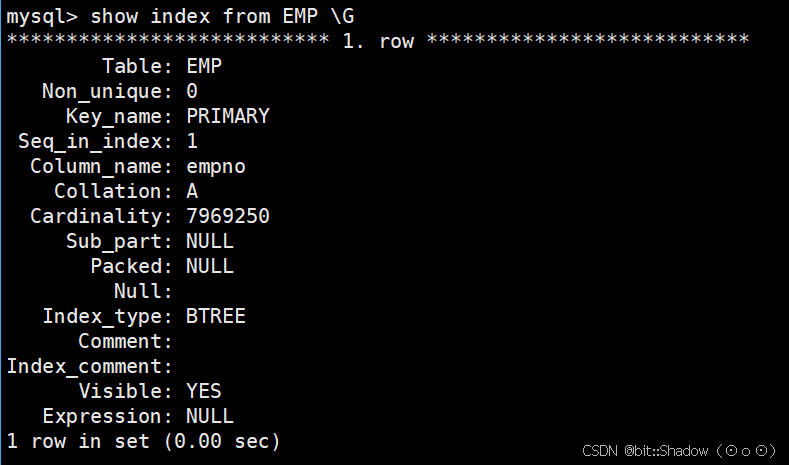
Key_name:PRIMARY 索引名(主键默认叫做PRIMARY)
Column_name:empno 索引列名
Index_type:BTREE(B+树) 索引类型 InnoDB常使用B+树
*索引覆盖 索引最左匹配原则 复合索引
需求:某两列/多列具备极强的唯一性且常需高频查找(低频修改)。
解决办法:构建复合索引(常是普通索引 两列/多列),当自B+树查找时,必然从左向右对比目标(最左匹配原则 ),一旦找到无需继续向下继续查找/回表查询。(索引覆盖)
**全文索引
当对文章字段或有大量文字的字段进行检索时,会使用到全文索引。MySQL 提供全文索引机制,但是有要求,要求表的存储引擎必须是 MyISAM,而且默认的全文索引支持英文,不支持中文。如果对中文进行全文检索,可以使用 sphinx 的中文版(coreseek)。
🛠️ 创建与使用
创建语法 (只能建在 CHAR、VARCHAR 或 TEXT 列上):
sql
create table articles (
  id int primary key,
  title varchar(200),
  body text, -- text: 大文本类型
  fulltext (title, body) -- 全文索引使用fulltext创建
) engine=innodb;
查询语法 (必须用 MATCH ... AGAINST,不能用 LIKE):
sql
select * from articles
    where match(title, body) against('数据库' in natural language mode);
🎯 三种搜索模式
-
自然语言模式(默认):把搜索词当成自然语言,按相关性排序返回结果。
-
布尔模式 :支持
+(必须包含)、-(必须排除)、*(通配)等运算符,控制更精确。 -
查询扩展模式:先搜一次,把结果里相关的词加入搜索串再搜一次,适合"模糊找相关"的场景
感谢支持,长期连载
欢迎关注