从一次文本分类的困境说起
几年前我做过一个情感分类的小任务,数据量不大,大概几千条中文评论。当时第一反应是用 Word2Vec 训练词向量,再套一个 LSTM 做分类。结果跑出来准确率一直卡在 80% 出头,怎么调都上不去。
问题出在哪?我盯着几个错例看了很久。有一条评论是"这家店的服务态度真是没得说",模型判成了负面。原因很简单:Word2Vec 给"没"和"得"这两个字分配的向量是固定的,跟上下文无关。而"没得说"整体是褒义,模型却只看单个字。
这就是静态词向量的死穴------同一个词,不管出现在什么句子里,向量永远一样。而自然语言里,词义高度依赖上下文。
BERT 要解决的,正是这个问题。它不是第一个预训练语言模型,但它把"双向"这件事做成了标配,从此 NLP 的玩法变了。
单向语言模型的天花板在哪里
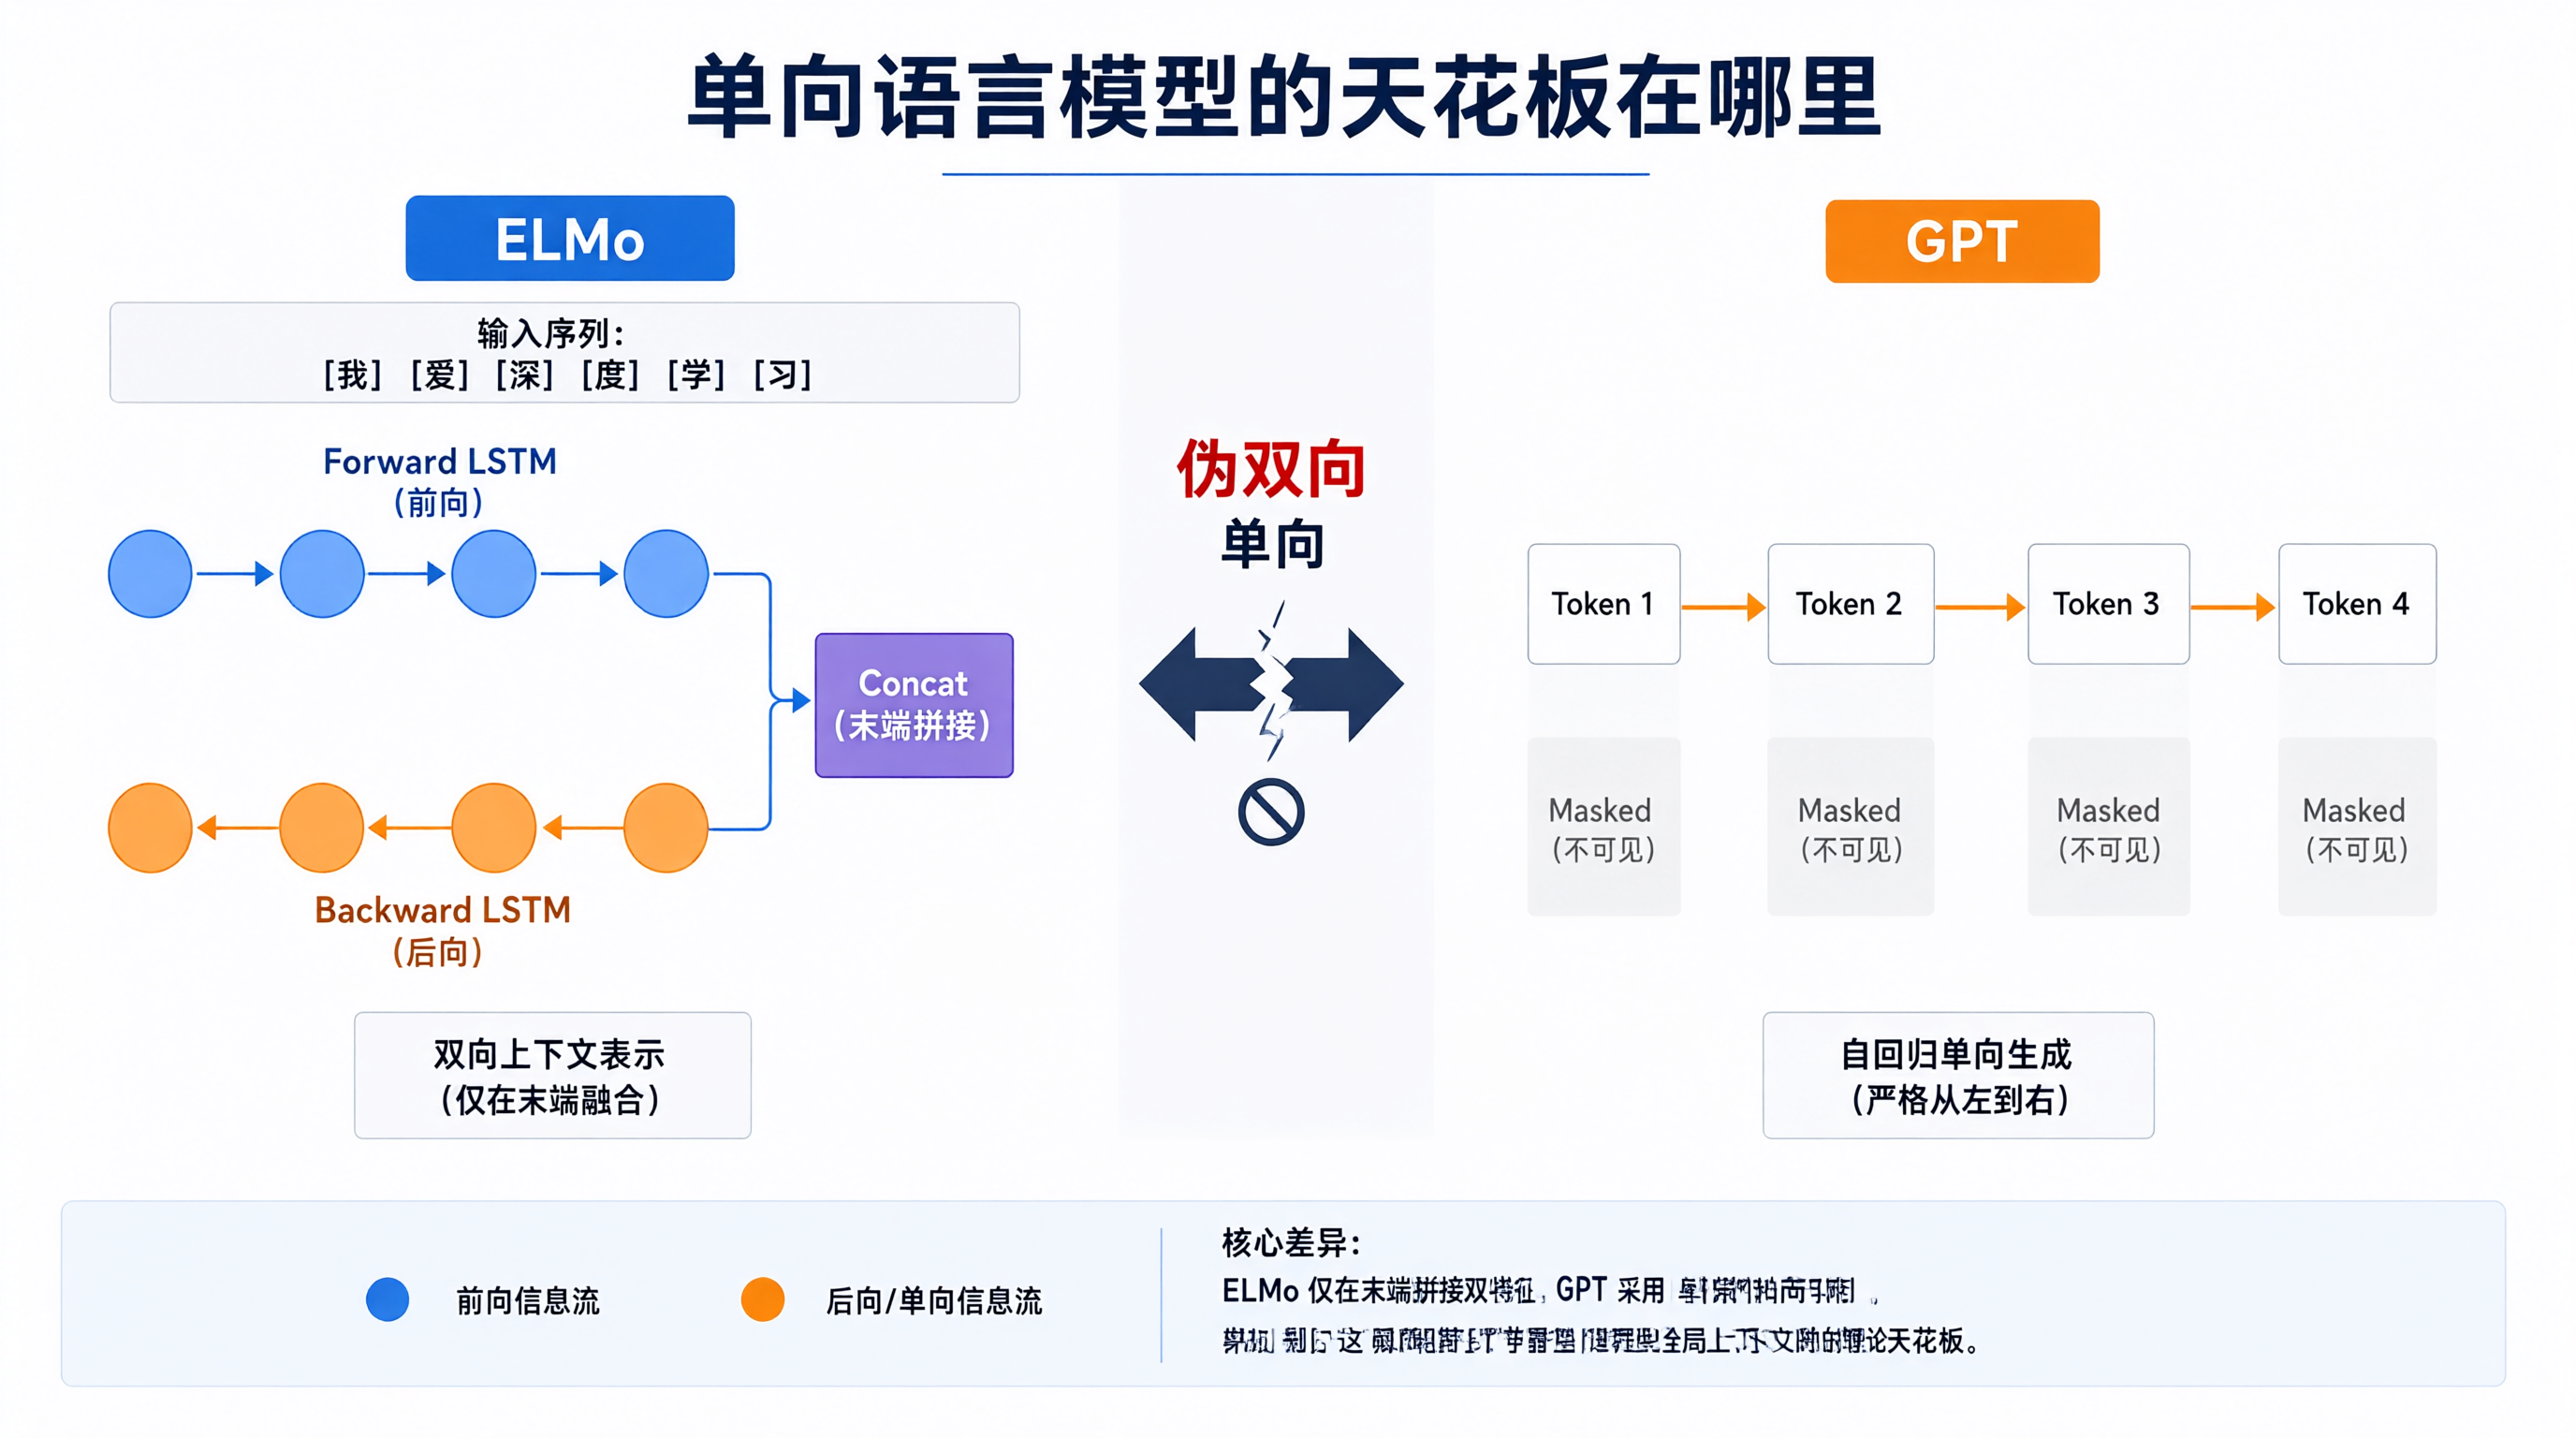
在 BERT 之前,比较有代表性的是 ELMo 和 GPT。
ELMo 的思路是用两个方向的 LSTM 分别读句子,一个从左往右,一个从右往左,然后把两边的隐状态拼起来。听起来像是"双向",但要注意,这两个方向是独立训练的,只是在最后拼接。模型在预测某个词的时候,左边那半并不知道右边看到了什么,右边那半也不知道左边看到了什么。这更像是"两个单向模型的拼盘",而不是真正的双向。
GPT 走的是另一条路:用 Transformer 的 Decoder,做标准的自回归语言模型,预测下一个词。这种结构天生是单向的,因为预测第 t 个词时,只能看到前 t-1 个词。
单向模型对生成类任务是合适的,写文章、续写句子,本来就只能从左往右。但对理解类任务,比如分类、问答、实体识别,句子是完整摆在面前的,凭什么只能看半边?
有人可能会想:那我把句子反过来再训一个模型,两个拼一起不就行了?ELMo 就是这么干的,效果确实比纯单向好,但前面说了,两个方向没有真正交互。
真正的问题在于:如果直接让模型同时看左右两边来预测中间词,会发生什么?
答案很简单------信息泄露。你要预测第 t 个词,如果模型能看到第 t 个词本身,那它什么都不用学,直接抄答案就行。这就是双向预训练最难绕过去的坎。
Masked LM:把答案藏起来再让人猜
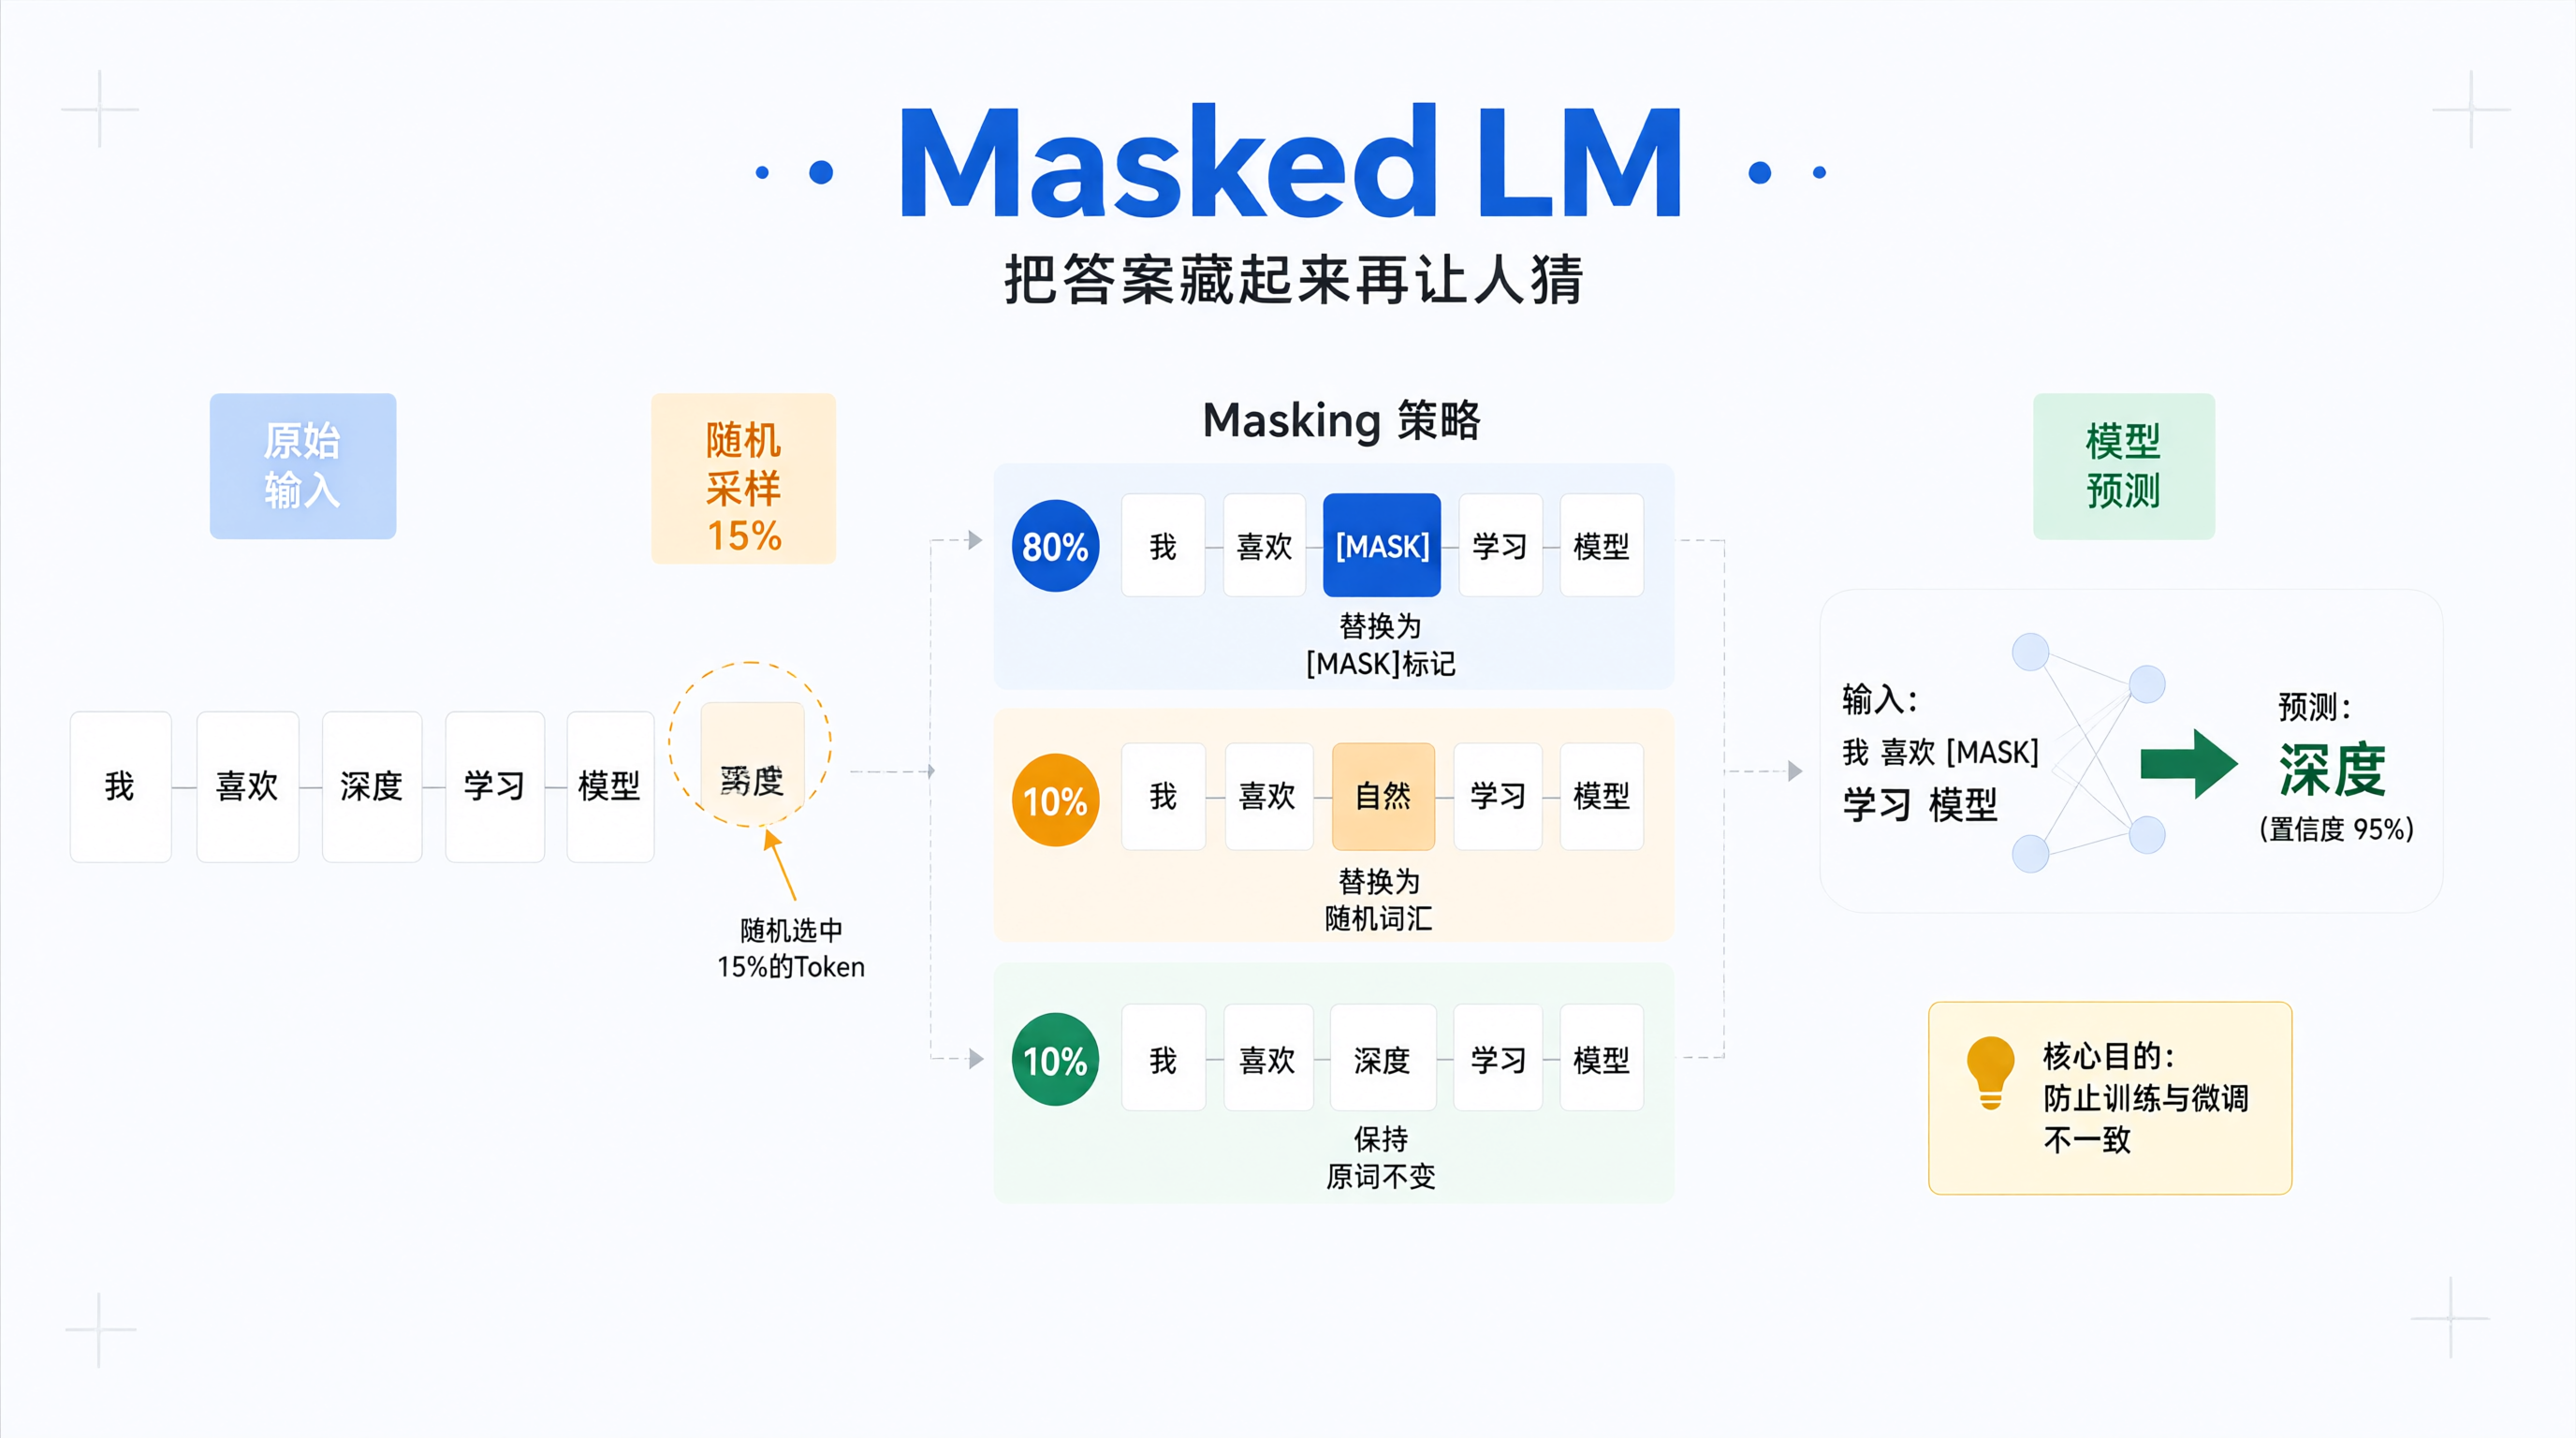
BERT 的解法非常直接:既然不能让你看到要预测的词,那我就把它遮住。
具体做法是,随机选句子中 15% 的 token,然后:
- 其中 80% 替换成
[MASK]标记; - 10% 替换成一个随机的其他词;
- 10% 保持不变。
然后让模型去预测这些位置原本是什么词。
我第一次看到这个设计时觉得有点奇怪:为什么不全部换成 [MASK],非要留 10% 随机词、10% 不变?
这里其实是工程上的权衡。如果训练时全是 [MASK],那模型只在看到 [MASK] 的时候才认真预测,而下游微调时根本没有 [MASK] 这个标记,训练和推理的输入分布就对不上了。掺入随机词和原词,是为了让模型对每个位置都保持一定的预测能力,缩小预训练和微调之间的差距。
【注意】这个 80/10/10 的比例是 BERT 原论文里的设定,后来有不少工作质疑过它的最优性,比如 RoBERTa 就试过其他方案。但作为理解 BERT 的入口,这个设计足够说明问题。
用 HuggingFace 的 transformers 库可以很直观地看到 Masked LM 的效果。下面这段代码用的是 bert-base-chinese,transformers 版本我测试时是 4.40 左右:
python
from transformers import pipeline

# 使用中文 BERT 做掩码填充
unmasker = pipeline(
    "fill-mask",
    model="bert-base-chinese",
    top_k=3
)

text = "这家店的 service 态度真是 [MASK] 得说"
results = unmasker(text)

for r in results:
    print(r["token_str"], round(r["score"], 4))
模型会给 [MASK] 位置填上概率最高的几个候选词。这里我想强调的是,BERT 在预测这个词的时候,是同时看了左边"这家店的服务态度真是"和右边"得说"的。左边告诉它这是评价场景,右边告诉它后面跟着"得说"这种固定搭配。两边的信息同时参与,这正是双向的价值。
注意力掩码:双向是怎么在代码里实现的
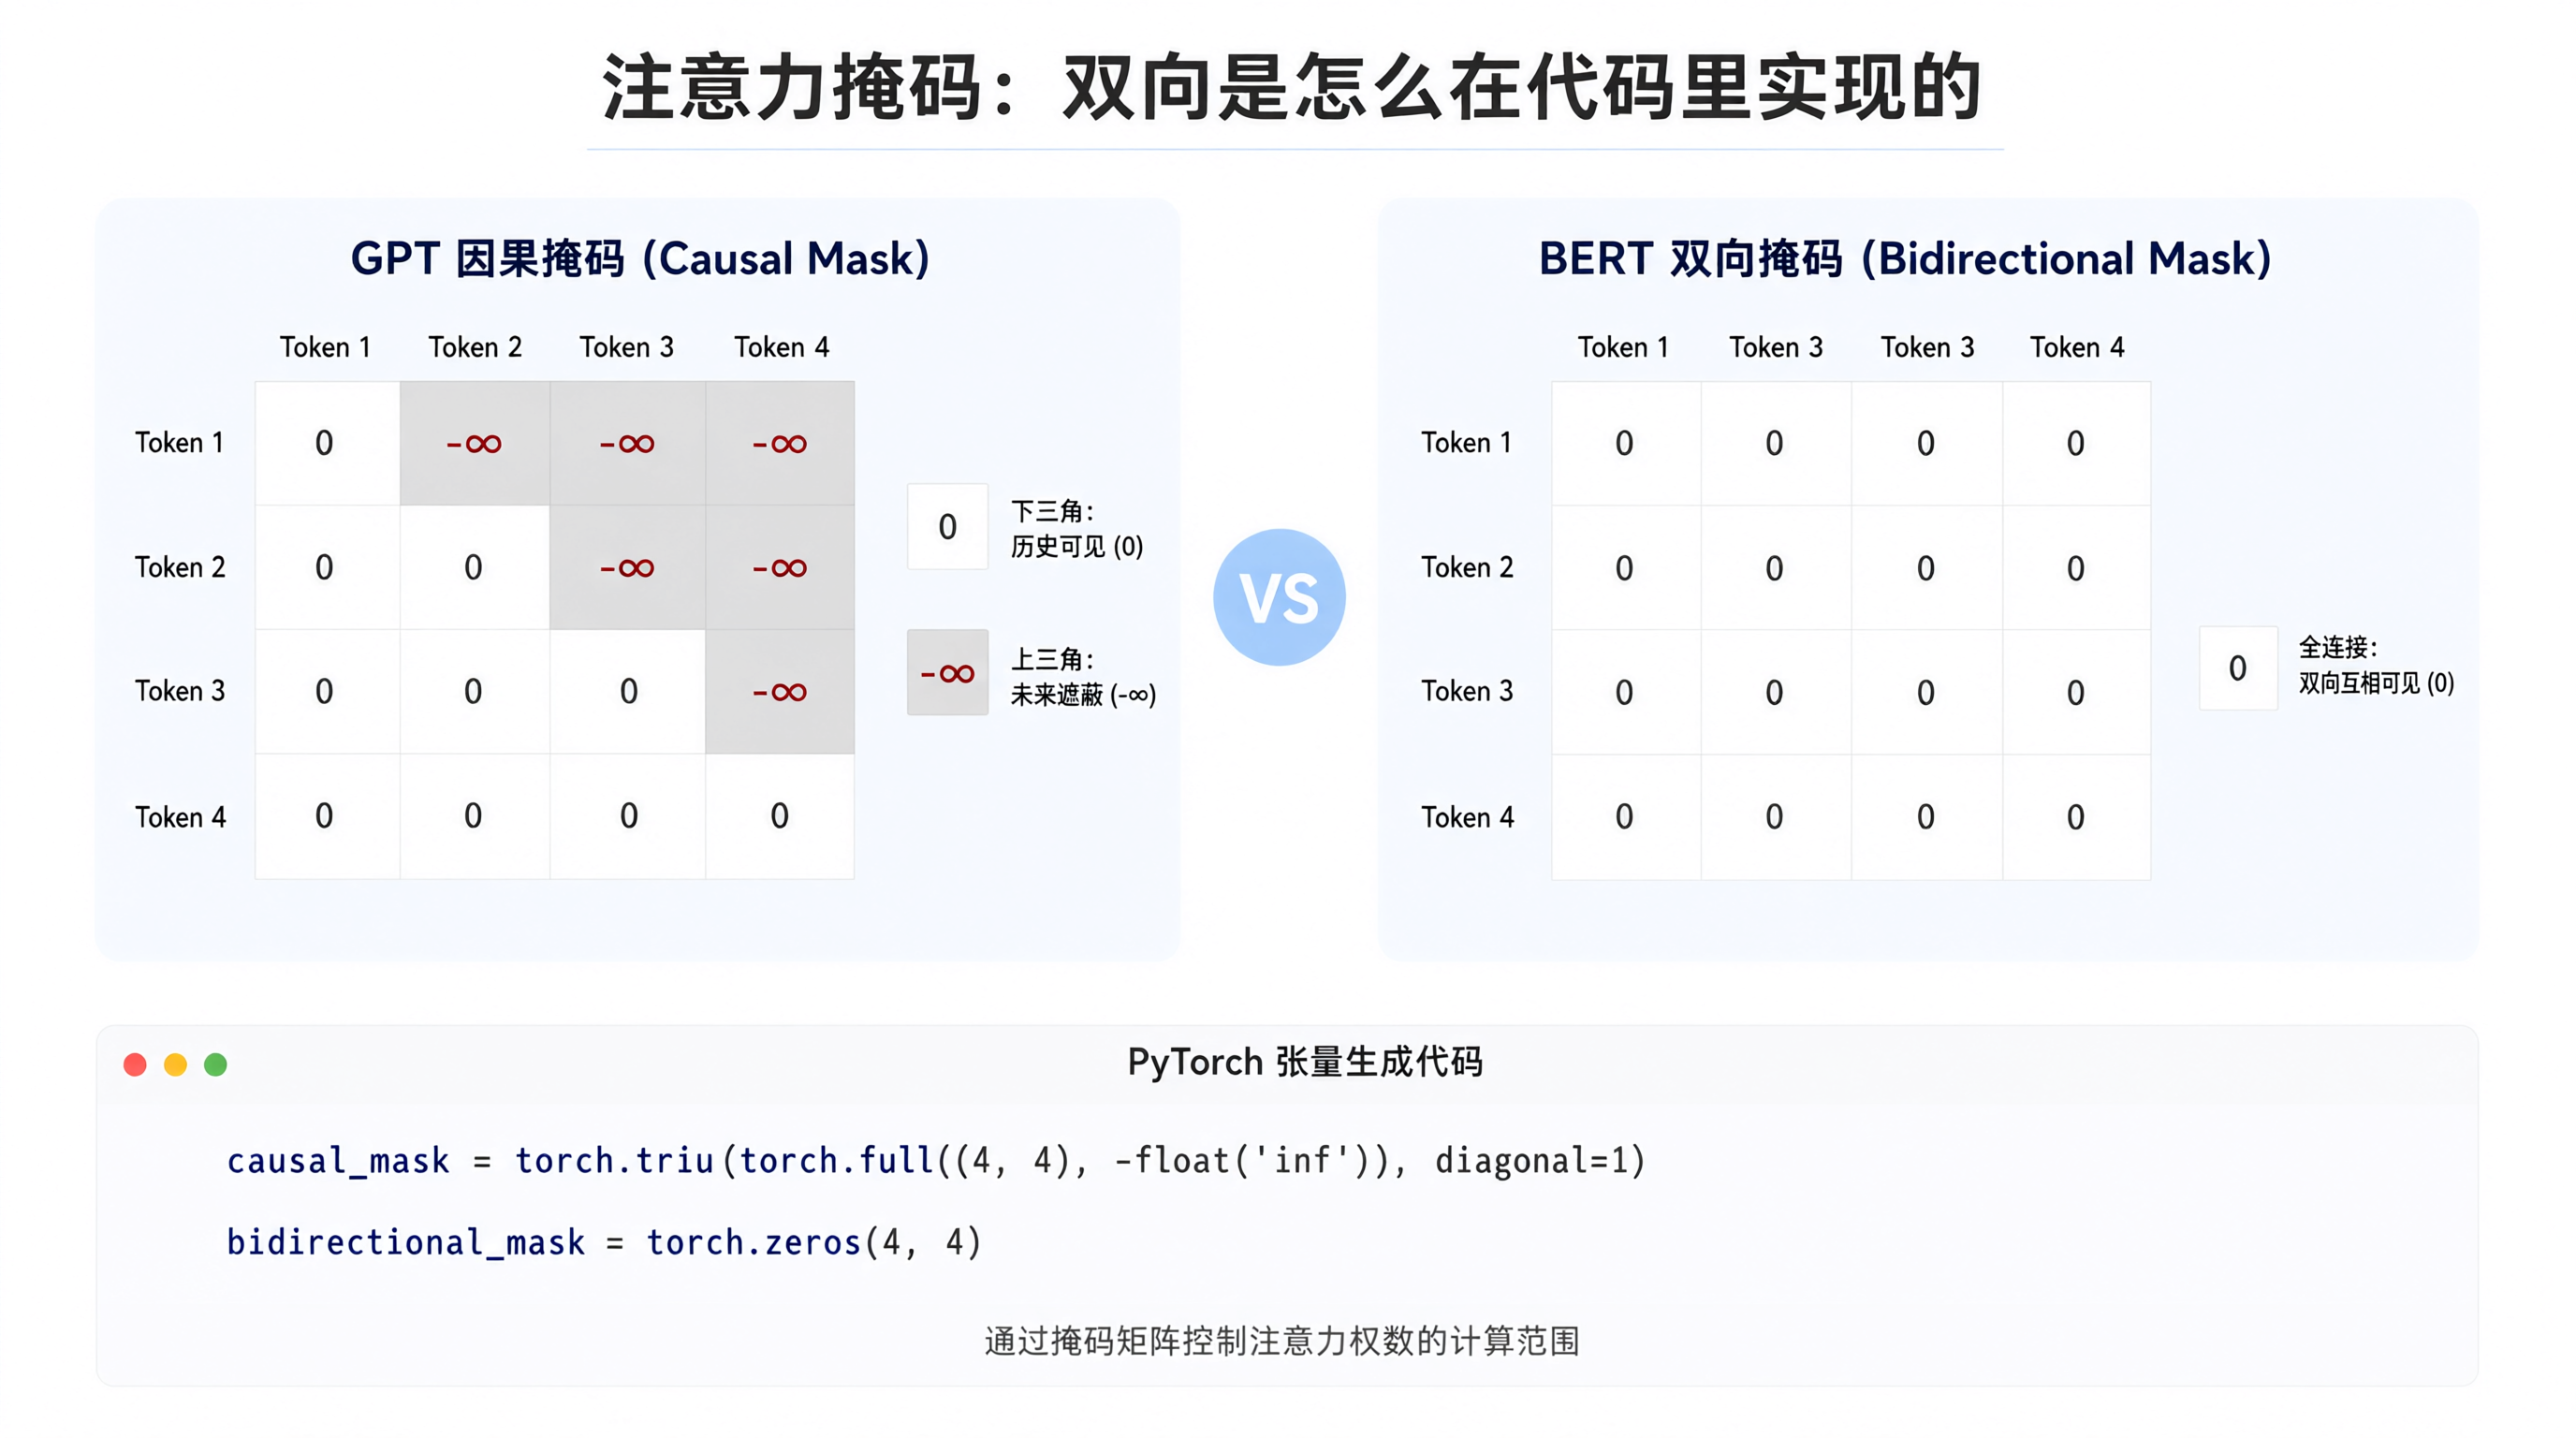
理解 BERT 的双向,绕不开注意力掩码(attention mask)。这也是很多人第一次读源码时容易懵的地方。
Transformer 的 Self-Attention 本质是每个 token 去"看"其他所有 token,然后加权求和。GPT 这类自回归模型需要一个上三角的掩码矩阵,把当前位置之后的位置全部屏蔽掉,保证只能看左边:
python
import torch

def causal_mask(seq_len):
    # 上三角为 1,表示需要屏蔽的位置
    mask = torch.triu(torch.ones(seq_len, seq_len), diagonal=1)
    # 转换成 attention 用的形式:被屏蔽处为 -inf
    mask = mask.masked_fill(mask == 1, float("-inf"))
    return mask

print(causal_mask(4))
输出是一个 4x4 的矩阵,右上角全是负无穷,意味着第 0 个 token 不能看第 1、2、3 个 token。
而 BERT 用的是 Transformer 的 Encoder,它根本不需要这个上三角掩码。每个 token 都能看到包括自己在内的所有 token。代码上就是不做任何屏蔽,注意力矩阵是完整的。
所以你去看 BERT 的源码,会发现它处理的是 padding mask(把补齐的短句部分屏蔽掉),而不是 causal mask。这个区别看着小,但决定了模型是单向还是双向。
【关键结论】BERT 的双向不是靠什么特殊结构实现的,而是靠"不做因果掩码"加上"Masked LM 训练目标"这两件事配合出来的。结构上放开双向,目标上防止作弊,缺一不可。
CLS 和 NSP:句子级别的表示从哪来
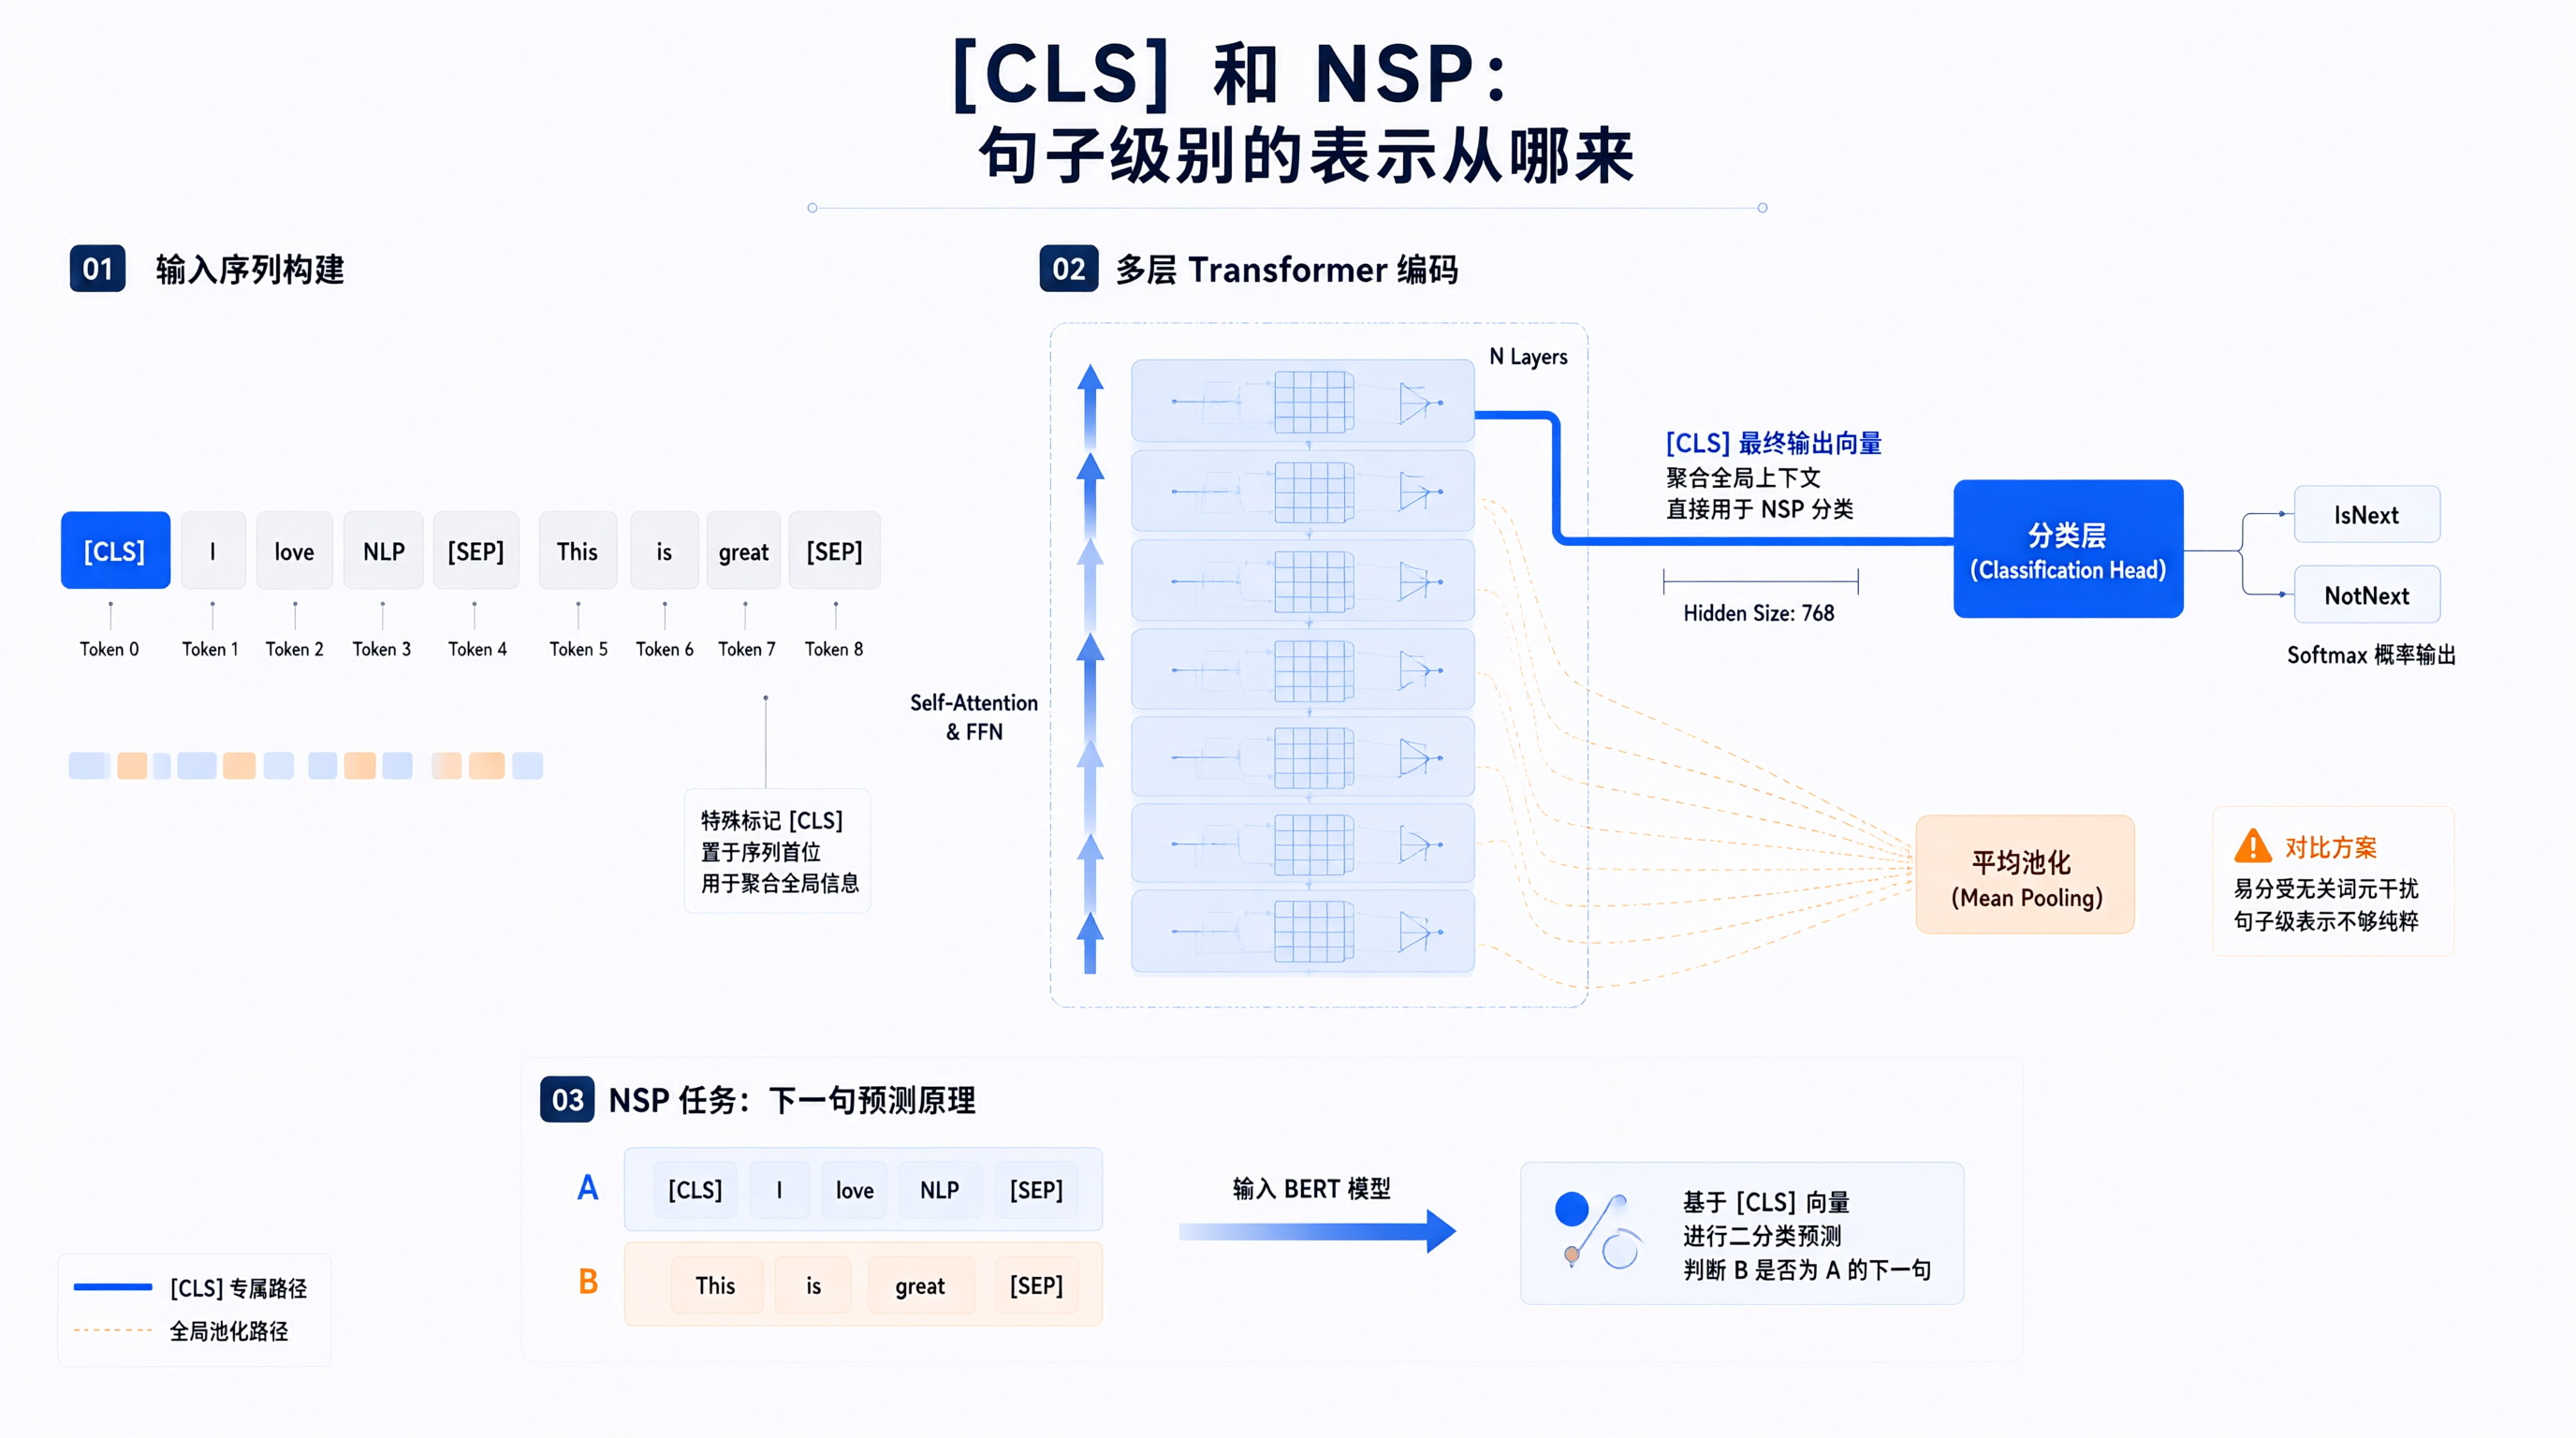
Masked LM 解决的是 token 级别的理解,但很多下游任务是句子级别的,比如判断两句话是不是承接关系、整段文本是什么情感。
BERT 的做法是在每个输入序列最前面加一个特殊的 [CLS] 标记。经过多层 Transformer 之后,这个位置的输出向量会被当作整个句子的聚合表示,接一个简单的分类层就能做句子级任务。
为什么是 [CLS] 而不是把所有 token 的向量平均一下?因为 [CLS] 没有具体的词义,它在训练中唯一的作用就是汇聚全局信息。经过预训练,模型会学着把句子级别的语义塞进这个位置。这也是一种"让模型自己学怎么聚合"的思路,比人工设计池化规则更灵活。
另一个预训练任务是 NSP(Next Sentence Prediction)。构造训练样本时,一半的样本 B 是 A 的真实下一句,另一半是从语料里随机抽的句子,让模型判断 B 是不是 A 的下一句。这个任务是为了让模型学到句子之间的关系。
不过 NSP 后来争议很大。RoBERTa 的实验显示,去掉 NSP 反而效果更好,或者换成更难的句子顺序预测(SOP)效果更佳。所以现在如果你要自己预训练,NSP 不是必须的。但理解 BERT 的原始设计,NSP 是绕不开的一环。
微调:为什么 BERT 用起来这么省事
BERT 真正让它流行的,不只是预训练本身,而是"预训练 + 微调"这套范式。
以前做 NLP 任务,每个任务都要从头设计网络结构、从头训练。有了 BERT 之后,流程变成:加载预训练权重,在最后接一个任务相关的小输出层,用少量标注数据微调几个 epoch。
下面是一个最小可运行的文本分类微调示例,用的是 transformers 的 Trainer:
python
from transformers import (
    BertTokenizer,
    BertForSequenceClassification,
    Trainer,
    TrainingArguments
)
from datasets import Dataset
import torch

model_name = "bert-base-chinese"
tokenizer = BertTokenizer.from_pretrained(model_name)
model = BertForSequenceClassification.from_pretrained(
    model_name,
    num_labels=2
)

# 假设已有文本和标签
texts = ["这家店服务很好", "东西太差了不会再买", "味道不错", "完全不推荐"]
labels = [1, 0, 1, 0]

def tokenize(batch):
    return tokenizer(
        batch["text"],
        padding="max_length",
        truncation=True,
        max_length=64
    )

dataset = Dataset.from_dict({"text": texts, "label": labels})
dataset = dataset.map(tokenize, batched=True)

args = TrainingArguments(
    output_dir="./bert_cls",
    num_train_epochs=3,
    per_device_train_batch_size=8,
    learning_rate=2e-5,
    logging_steps=10
)

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=dataset
)

trainer.train()
几个工程上的注意点:
学习率一定要小。BERT 微调常用的学习率是 2e-5 到 5e-5 这个量级,比从头训练小一两个数量级。因为预训练权重已经学到了很好的表示,学习率太大会把学到的知识冲掉。
epoch 不要多。通常 2 到 4 个 epoch 就够了。BERT 参数量大,在小数据集上很容易过拟合,跑十几个 epoch 反而掉点。
max_length 要按任务选。BERT 的输入上限是 512 个 token,但很多任务用不到那么长。短文本设 64 或 128 就够,能明显省显存和时间。
BERT 和它的同类,到底怎么选
到这一步,可以用一张表把几个常见方案的差异理清楚:
| 方案 | 核心思路 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| Word2Vec/GloVe | 静态词向量 | 轻量、快、可离线 | 词义与上下文无关 | 资源极受限、简单任务 |
| ELMo | 双向 LSTM 拼接 | 引入上下文相关表示 | 两方向独立、交互弱 | 早期 NLP 任务 |
| GPT | 自回归单向 | 生成能力强 | 理解类任务受限 | 文本生成、续写 |
| BERT | 双向 Encoder + MLM | 理解类任务强、微调方便 | 不擅长生成、输入长度受限 | 分类、问答、NER、句对任务 |
【关键结论】BERT 不是万能的,它的强项是"理解",弱项是"生成"。如果你的任务是写文案、续写、对话生成,单向的 GPT 系模型更合适。选型要看任务性质,不是看谁更新。
实际使用中容易忽略的几点
第一,中文要用中文预训练权重。bert-base-chinese 是在中文语料上训的,直接用英文版 bert-base-uncased 处理中文,tokenizer 会把汉字拆得乱七八糟,效果会差很多。
第二,BERT 的 tokenizer 是 WordPiece,会把罕见词拆成子词。这对处理未登录词有好处,但也意味着 token 数和你直觉上的"字数"不一样。做长度统计时要以 token 数为准。
第三,输入长度 512 是硬限制,超过就要截断或分段。长文本任务(比如长文档分类)需要额外设计,比如分段后聚合、或者换用 Longformer、BigBird 这类支持长序列的变体。
第四,[CLS] 向量直接拿来做相似度效果一般。原论文就提到过,句子相似度这类任务用 [CLS] 不如用句对输入效果好。后来 Sentence-BERT 专门针对这个问题做了改进,用孪生网络结构训练出更适合相似度计算的句向量。
写在最后
BERT 的价值不在于它有多复杂,恰恰相反,它的核心设计简洁得有点朴素:用 Transformer Encoder,放开双向,然后用 Masked LM 防止作弊。但就是这套组合,把预训练语言模型从"能用的工具"变成了"标配的基础设施"。
回头看,它真正改变的是工作方式。以前每个 NLP 任务都要单独设计模型,现在大多数任务的第一步都是"先加载一个预训练模型看看 baseline"。这种范式的转变,比任何单个技术点都重要。
如果你现在要上手,我的建议是先跑通一个微调例子,再回头读源码里的 attention mask 部分。搞清楚"为什么 BERT 不需要因果掩码",比记住多少参数有用得多。至于后续演进,RoBERTa、ALBERT、ELECTRA 都是在 BERT 基础上做的改进,理解 BERT 是理解它们的前提。