🔥铅笔小新z:个人主页
🎬博客专栏:stm32学习
💫滴水不绝,可穿石;步履不休,能至渊。
DMA 详解 ------ 让数据"自动搬家"的搬运工
面向初学者的通俗解读,配合逐行注释的代码,以及每个知识点后的"一句话总结"。
本文基于 STM32F103(Cortex-M3)+ DMA1 实战讲解,帮你彻底搞懂 DMA 的原理、通道、寄存器与中断。
目录
- [DMA 是什么](#DMA 是什么)
- [为什么需要 DMA](#为什么需要 DMA)
- [DMA 的核心目标与 CPU 的职责](#DMA 的核心目标与 CPU 的职责)
- [四方关系:DMA 到底在哪](#四方关系:DMA 到底在哪)
- [宏观理解 DMA 工作过程](#宏观理解 DMA 工作过程)
- [总线共享:CPU 和 DMA 会打架吗](#总线共享:CPU 和 DMA 会打架吗)
- [DMA 通道与仲裁](#DMA 通道与仲裁)
- [查文档:DMA 的寄存器与地址空间](#查文档:DMA 的寄存器与地址空间)
- 通道核心配置寄存器
- [DMA 中断:TC、HT、TE](#DMA 中断:TC、HT、TE)
- [区分中断类型:ISR 与 IFCR](#区分中断类型:ISR 与 IFCR)
- 配置案例
1. DMA 是什么
1.1 全称与定义
DMA(Direct Memory Access,直接存储器访问) ,用来提供外设和存储器之间 、或者存储器和存储器之间 的高速数据传输。无需 CPU 干预,数据就能通过 DMA 快速移动,从而节省 CPU 资源去做其他操作。
通俗地说,DMA 就是单片机内部的一个外设控制器 ,它拥有独立的地址总线和控制逻辑 。在 CPU 授权之后,它可以接管总线控制权,在不占用 CPU 资源的情况下,自动把数据从一个地址(源)搬到另一个地址(目的)。
1.2 一个搬运货物的比喻
为了快速理解 DMA,先看一个搬运货物的例子:
| 角色 | 对应 |
|---|---|
| CPU | 老板 |
| DMA | 专业搬运工 |
| 数据 | 需要搬运的货物 |
| 外设(串口、I2C、SPI、ADC 等) | 货物的来源或目的地之一 |
| 存储器(内存) | 货物的来源或目的地之一 |
老板(CPU)不用亲自搬货,他把"从哪搬、搬到哪、搬多少"交代给搬运工(DMA),搬运工自己完成,老板去做更重要的决策工作。
📌 本知识点一句话总结
DMA(直接存储器访问)是单片机内部的一个独立硬件控制器,拥有自己的地址总线和控制逻辑。它的作用是:在 CPU 授权后接管总线,不占用 CPU 就自动把数据从"源地址"搬到"目的地址",实现外设↔存储器、存储器↔存储器之间的高速传输。可以把 CPU 比作老板,DMA 比作专业搬运工------老板只下指令,搬运工干体力活,从而把宝贵的 CPU 资源留给逻辑运算等更重要的工作。
2. 为什么需要 DMA
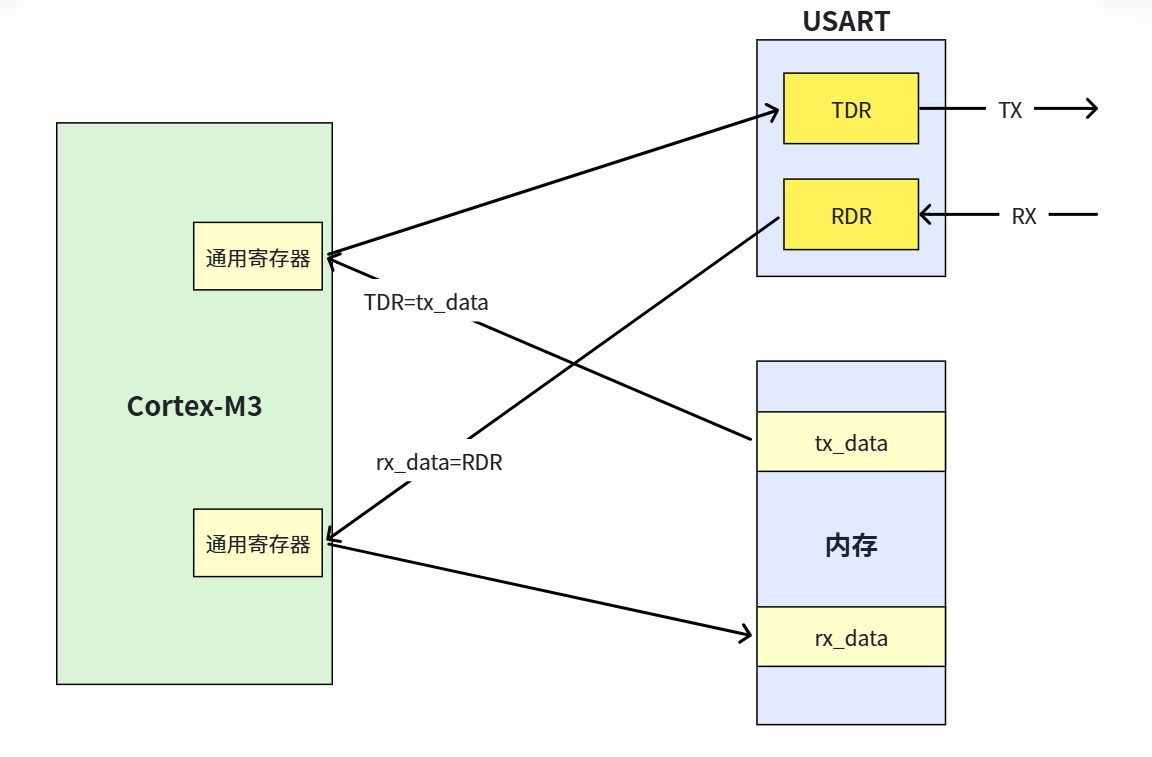
2.1 没有 DMA 时:CPU 亲自搬货
如果没有 DMA,把数据从外设搬到内存、从内存搬到外设,都是 CPU 自己做的:
外设 →(CPU 读取)→ CPU →(CPU 写入)→ 内存CPU 不仅要执行用户代码、响应中断,还要亲自干"数据搬迁"这种体力活。结果是:CPU 被拖慢,同时数据搬迁的响应速度也被拖慢。
2.2 引入 DMA 后:CPU 只发指令
引入 DMA 模块后,相当于请了搬运工(DMA)。CPU 只需要告诉 DMA 三件事:
- 搬多少(数据数量);
- 从哪搬(源地址);
- 搬到哪(目的地址)。
CPU 不需要亲自参与搬运过程,只需发布搬运命令,最后处理搬运完的货物即可。
2.3 为什么这么设计
CPU 资源非常宝贵,应该专注于逻辑运算、业务处理这类重要工作;而"大批量数据的重复搬运"这类简单、重复的工作,应该交给 DMA 完成。
没有 DMA:CPU 既当老板又当搬运工 → 累死且低效
有 DMA:   CPU 当老板,DMA 当搬运工 → 各司其职,高效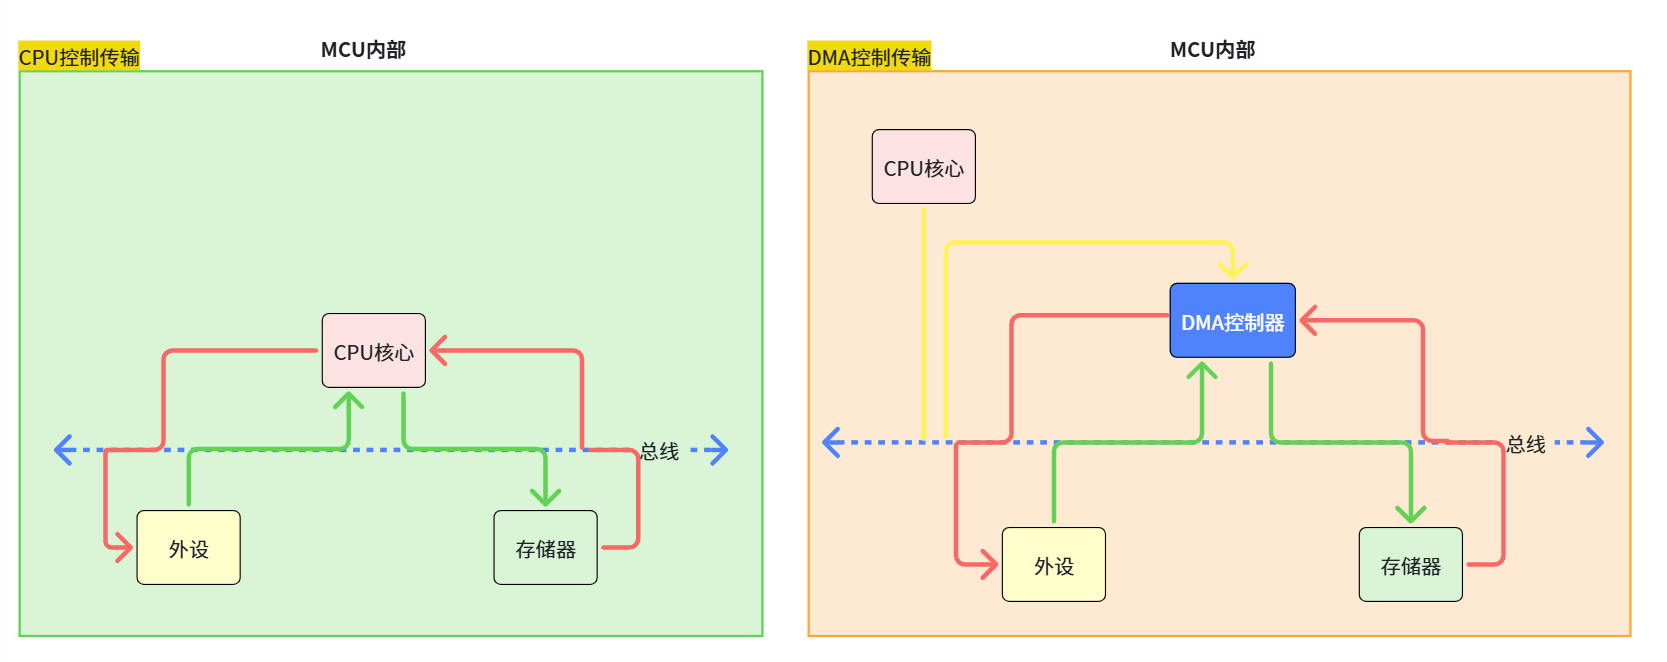
📌 本知识点一句话总结
引入 DMA 的根本原因是解放 CPU:没有 DMA 时,外设与内存之间的数据拷贝都要 CPU 亲自执行,既拖慢 CPU 又拖慢数据响应。引入 DMA 后,CPU 只需下发"源地址、目的地址、数据量"三个参数即可,搬运过程由 DMA 硬件完成。这样 CPU 专注于逻辑运算和业务处理,简单重复的搬运工作交给 DMA,实现"各司其职",整体效率大幅提升。
3. DMA 的核心目标与 CPU 的职责
3.1 核心目标
数据传输(搬运)过程需要一个主体来控制。在 CPU 不参与的情况下,就需要另一个主体来控制传输过程,这就是 DMA 控制器 。不同架构 CPU 的 DMA 控制器实现细节不同,但目标一致:代替 CPU 控制数据传输过程。
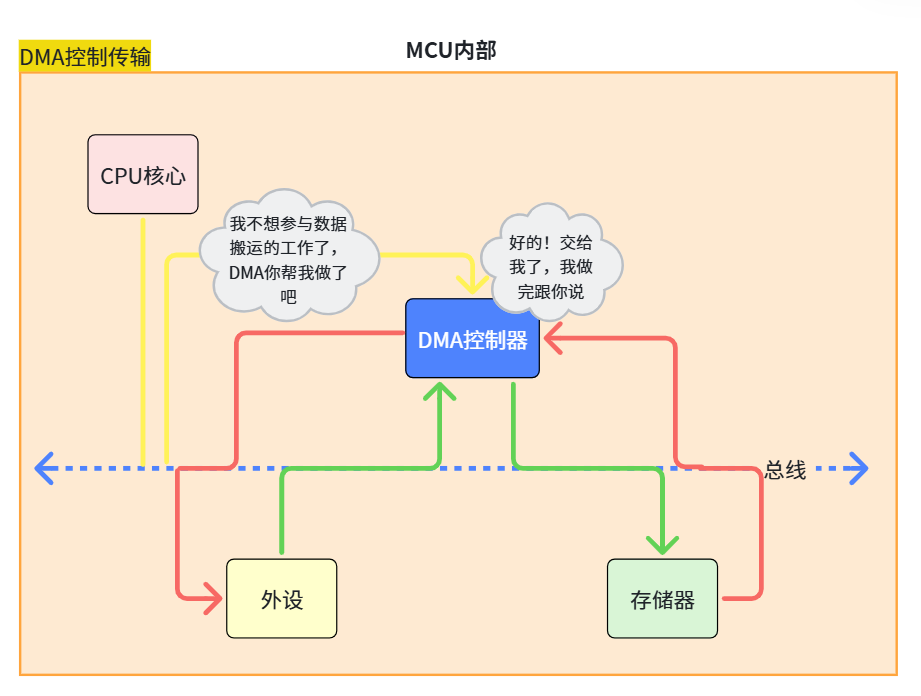
3.2 CPU 到底做什么
一个容易误解的点:说"DMA 不占用 CPU"不等于"CPU 什么都不用干"。CPU 需要做两件事:
- 启动 DMA 传输过程(初始化配置 + 使能);
- 在 DMA 传输结束时执行下一个业务逻辑(如启动新的传输、或处理已收到的数据,例如格式化打印)。
记住:CPU 不参与的是"搬运过程",而不是"启动"和"收尾"。 启动和收尾这两头,还得 CPU 亲自来。
📌 本知识点一句话总结
DMA 的核心目标是"代替 CPU 控制数据传输过程",但 CPU 并非完全不参与:它要负责两件事------① 在传输前配置并启动 DMA;② 在传输结束后(收到中断)执行后续业务逻辑(如启动下一次传输、处理数据)。所谓"不占用 CPU",仅指搬运过程本身由 DMA 硬件完成,CPU 不介入;但启动和收尾仍需 CPU 参与。
4. 四方关系:DMA 到底在哪
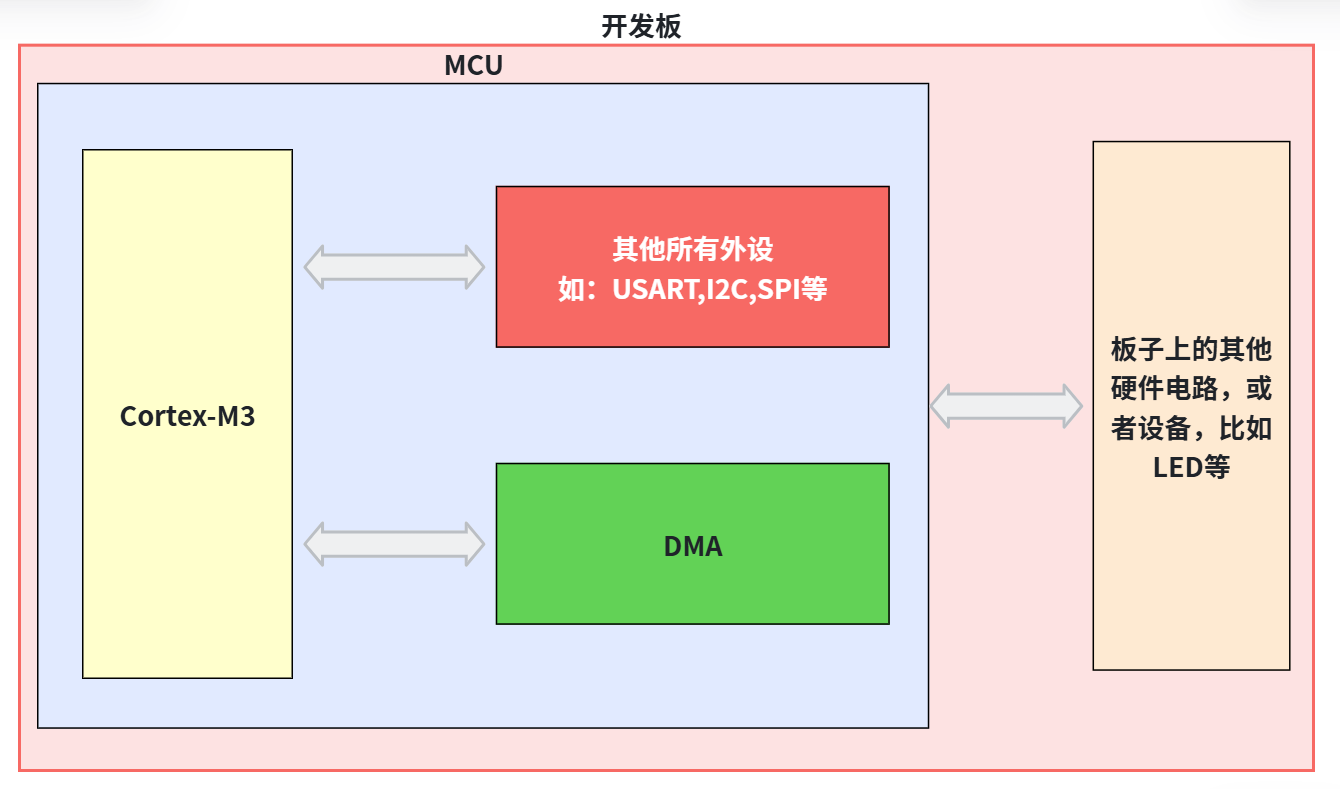
明确 DMA 的定位------它和 Cortex-M3(CPU)、MCU、开发板(灵犀板)之间的四方关系:
- DMA 在 MCU 内部,是 MCU 内部的一个独立硬件控制单元,属于一个独立的片上外设。
- 但从更本质的角度看,DMA 是一个总线主设备(Bus Master),这一点和普通片上外设(如串口,是被动的从设备)有区分度。
关键词:DMA 是"总线主设备"------它能主动发起总线操作(读/写),而普通外设只是被动响应。这是 DMA 能"自主搬数据"的根本原因。
在 STM32F103 系列芯片内部,一般包含两个 DMA 控制器模块:
- DMA1:有 7 个通道;
- DMA2:有 5 个通道(只有大容量和互联型产品才有)。
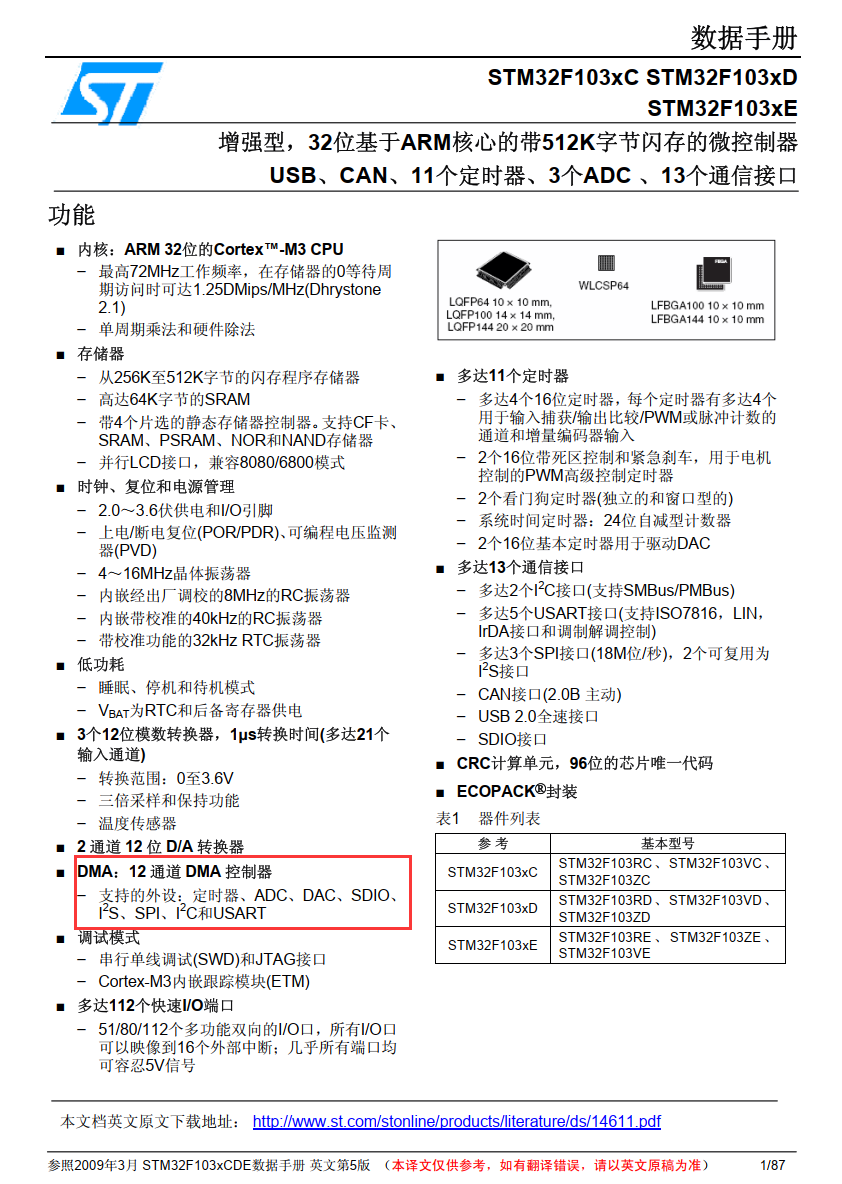
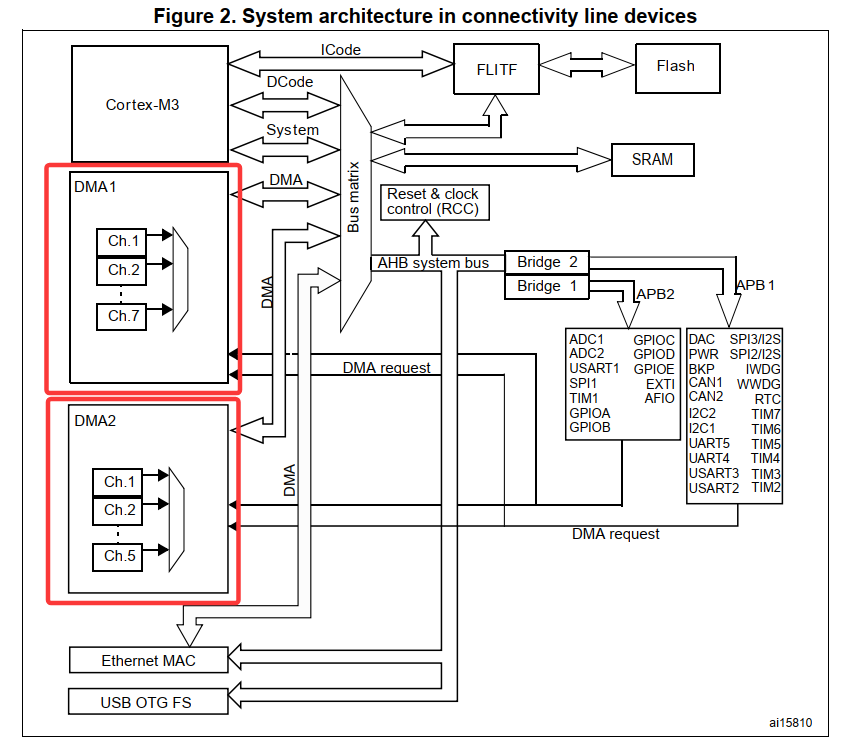
后续研究时,把注意力放在 DMA1 上即可(DMA2 原理完全一样)。
📌 本知识点一句话总结
DMA 位于 MCU 内部,是一个独立的硬件控制单元(片上外设),但本质上是总线主设备(Bus Master)------它能主动发起总线读写操作,这正是它能自主搬运数据的根本原因(普通外设只是被动的从设备)。STM32F103 有两个 DMA 控制器:DMA1(7 通道)和 DMA2(5 通道,仅大容量/互联型有),两者原理相同,学习时以 DMA1 为例即可。
5. 宏观理解 DMA 工作过程
DMA 传输主要发生在外设和内存之间(存储器到存储器虽然也支持,但应用很少)。一个 DMA 数据传输过程有 4 个核心参与主体:
- CPU(Cortex-M3 内核):负责启动 DMA 数据传输。
- 外设:负责向 DMA 控制器发起 DMA 请求。
- DMA 控制器:负责响应 DMA 请求并控制数据传输过程。
- 内存(SRAM):作为数据的源或目的缓冲区。
下面以串口(USART1)为例,分 4 步建立宏观认知:
5.1 第一步:CPU 启动 DMA
CPU 让 DMA 帮它搬迁数据,这个工作需要用户提前设置好(源地址、目的地址、数量等),并最终使能通道。
5.2 第二步:外设发起 DMA 请求
- 当外设收到数据时(如串口收到一个字节),USART1 会向 DMA 发起"DMA 数据搬迁请求"。
- 当外设要发数据时(如串口要往外发一个字节),USART1 也会向 DMA 发起请求。
5.3 关于 DMA 应答(硬件"握手")
外设在发生特定事件后,向 DMA 控制器发送一个请求信号 ;当 DMA 控制器开始访问该外设时,会先回一个应答信号。这个过程叫 DMA 的硬件"握手"。
- 从电气角度,握手就是电脉冲(或高低电平)。
- 这个握手过程不需要工程师配置,是 DMA 和对应片上外设自主完成的。
5.4 第三步:DMA 响应请求并控制传输
- 外设 → 内存:DMA 把外设数据寄存器里的数据搬到内存缓冲区。
- 内存 → 外设:DMA 把内存缓冲区的数据搬到外设数据寄存器。
5.5 第四步:通知 CPU,传输完成
数据全部搬完后,DMA 通过中断通知 CPU,CPU 收到后介入处理后续数据。
完整流程一句话:CPU 启动 → 外设请求 → DMA 握手并搬运 → DMA 中断通知 CPU 收尾。
📌 本知识点一句话总结
一个完整的 DMA 传输包含四个主体和四步流程:四个主体是 CPU、外设、DMA 控制器、内存。四步流程是:① CPU 配置并启动 DMA;② 外设因"收到数据/要发数据"向 DMA 发请求;③ DMA 与外设硬件握手后响应请求,把数据从外设寄存器搬到内存(或反向);④ 搬完产生中断通知 CPU 收尾。其中"握手"(请求/应答)是 DMA 与外设硬件自动完成的,无需软件配置。
6. 总线共享:CPU 和 DMA 会打架吗
6.1 提出问题
CPU 本来也要访问外设和内存(读 Flash 代码、访问 USART、写内存等),DMA 也要访问。两者都要通过 AHB 总线 和总线矩阵进行,那岂不是会冲突?
6.2 官方说明
意法官方文档(参考手册)给出的结论是:
DMA 控制器和 Cortex-M3 核心共享系统数据总线 。当 CPU 和 DMA 同时访问相同目标(RAM 或外设)时,DMA 请求会暂停 CPU 访问系统总线达若干个周期 ,以保证 CPU 至少可以得到一半的系统总线(存储器或外设)带宽。总线仲裁器执行循环调度。
6.3 结论
- 官方没有披露 DMA 和总线的详细内部细节,但对应用层来说足够了。
- 最终结论:逻辑上 CPU 和 DMA 互不影响。 总线仲裁器通过"循环调度",保证两边都能获得至少一半带宽,不会死锁或互相饿死。
📌 本知识点一句话总结
CPU 和 DMA 都通过 AHB 总线和总线矩阵访问外设/内存,存在潜在的资源竞争。解决方式是总线仲裁器的循环调度:当 CPU 和 DMA 同时访问相同目标时,DMA 请求会暂停 CPU 访问总线若干周期,从而保证 CPU 至少能获得一半总线带宽。因此逻辑上 CPU 和 DMA 互不影响,能安全地共享系统数据总线。
7. DMA 通道与仲裁
7.1 通道初识:为什么要多个通道
MCU 里的片上外设非常多(USART、SPI、I2C、ADC、TIM......)。如果 DMA 控制器只有一个通道,一次只能处理一个外设的请求,效率太低。
为了支持多个外设的数据搬迁"并发"进行,DMA 提供了多个通道,每个通道独立工作:
每一个通道,其实就是一个"子 DMA",主要负责进行数据搬迁。
7.2 一个疑问:总线不是共享的吗,怎么能并发?
多通道用的是同一套总线,所以严格说同一时刻只能有一个通道真正占有总线。但要注意:
- 外设数据"需要搬迁" ≠ "一直在搬迁"。多个外设往往在不同时刻才需要搬数据(空闲时总线就空着)。
- DMA 的"并发"本质是分时复用总线------多个通道交替使用总线空闲时间完成各自搬迁。
- 多通道的终极目标是"不让总线闲着",充分复用总线资源。
打个比方:一条单车道马路,不同的车(通道)轮流过,虽然同一时刻只能过一辆,但整体看起来是"并发"运行的。
7.3 仲裁器与通道优先级
既然同一时刻只能让一个通道拥有总线,那到底让谁先?这就需要优先级 和仲裁器。
关键认知(两个"细节"):
- 优先级高 ≠ 一直霸占总线:因为外设不一定满足搬迁条件(还没收到数据、还没发完等),高优先级通道暂时不工作时,低优先级通道照样能干活。
- 仲裁器:用来判断优先级、决定谁拥有总线资源的模块。
比喻:你是航空公司 VIP 乘客,优先级高,但你不是每天坐飞机、也不是时刻在排队。当你排队时,需要"工作人员"(仲裁器)确认你的 VIP 身份让你先走;你不排队时,普通乘客照常通行。
仲裁器根据通道请求的优先级来启动外设/存储器的访问,优先级管理分 2 个阶段:
阶段一:软件优先级(4 个等级)
在 DMA_CCRx 寄存器中设置:
c
DMA_PRIORITY_LOW        // 低
DMA_PRIORITY_MEDIUM     // 中
DMA_PRIORITY_HIGH       // 高
DMA_PRIORITY_VERY_HIGH  // 最高
阶段二:硬件优先级
如果两个请求的软件优先级相同,则编号较小的通道优先级更高。例如通道 2 优先于通道 4。
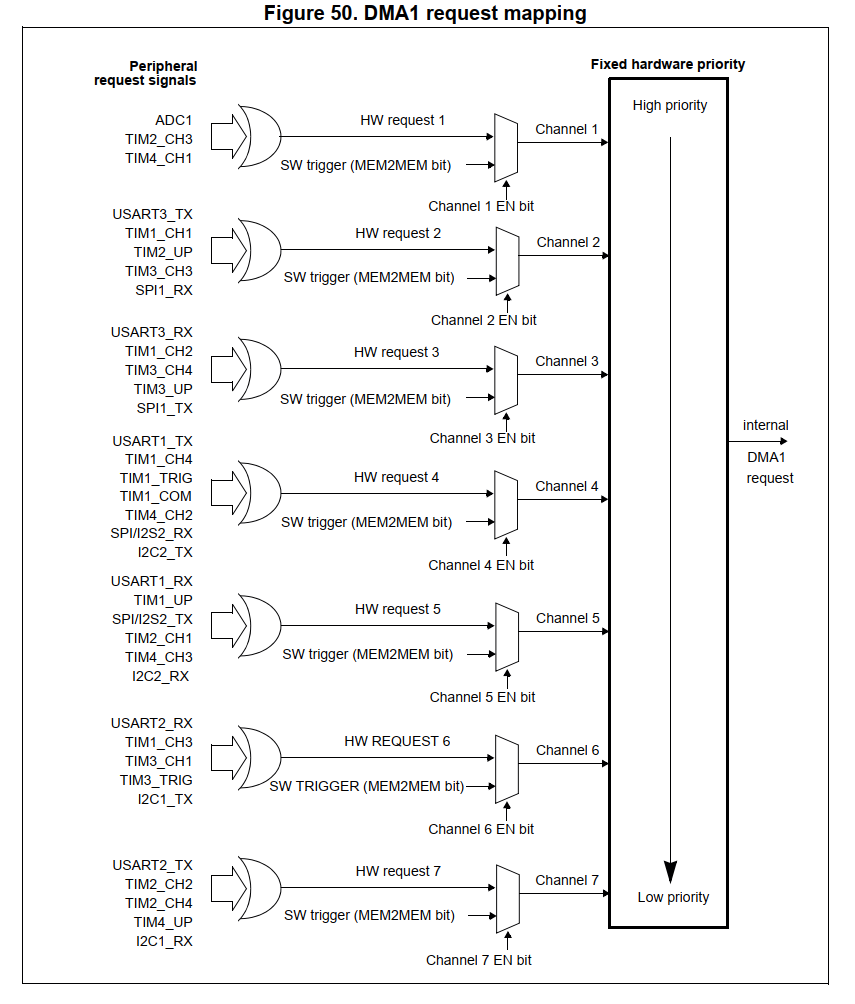
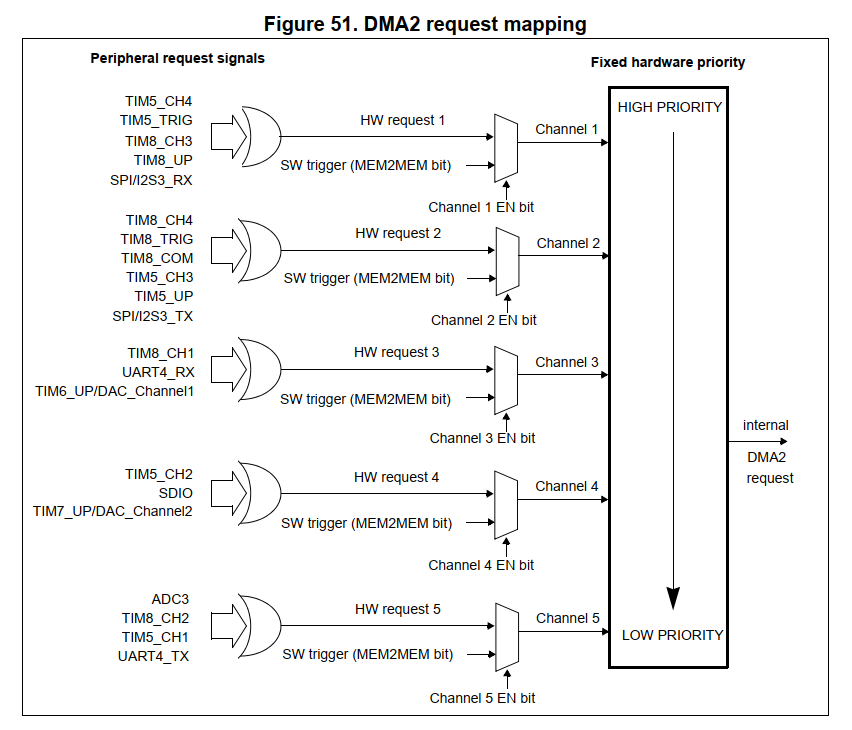
这个"硬件优先级"由芯片内部走线决定,通道编号固定,用户无需也无法设置。
7.4 细节 1:外设请求信号(硬映射)
哪种片上外设用哪个 DMA 通道,在芯片设计(走线)时就已经固定 了。这种"外设↔通道"的固定对应关系,叫硬映射(Hard Mapping)。
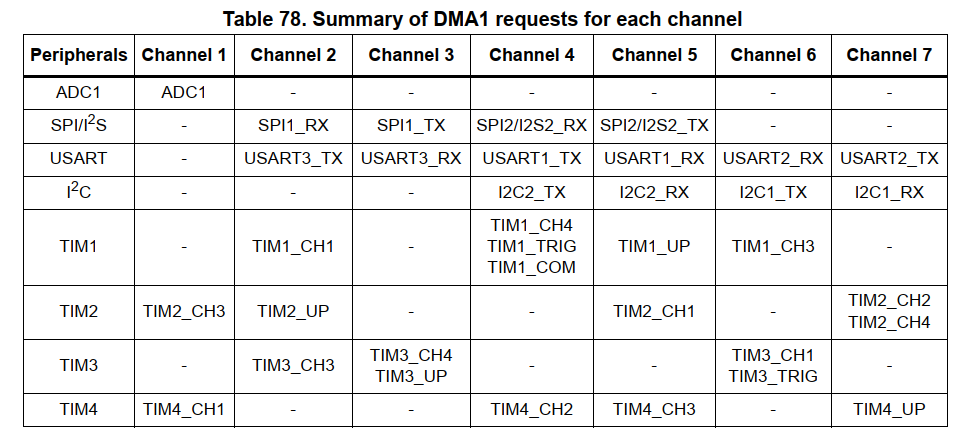
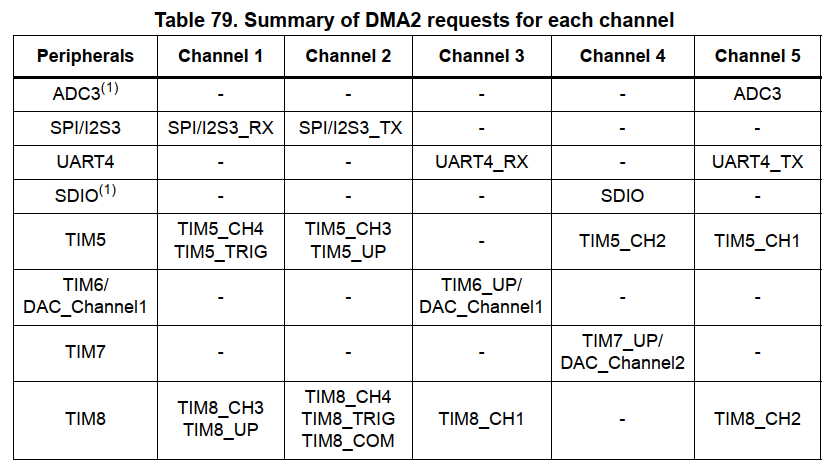
以 USART1 为例(DMA1):
- USART1_TX → 通道 4
- USART1_RX → 通道 5
收发映射到不同通道,是为了让收发"几乎同时"用 DMA 搬迁,从而在 DMA 场景下支持 USART1 的全双工。
同时,任意一个通道只能被一种外设使用 (排他性)。虽然一个通道理论上能接到多个外设的请求,但用户必须提前配置好让哪个外设用这个通道,不能同时让两个以上外设使用同一个通道。
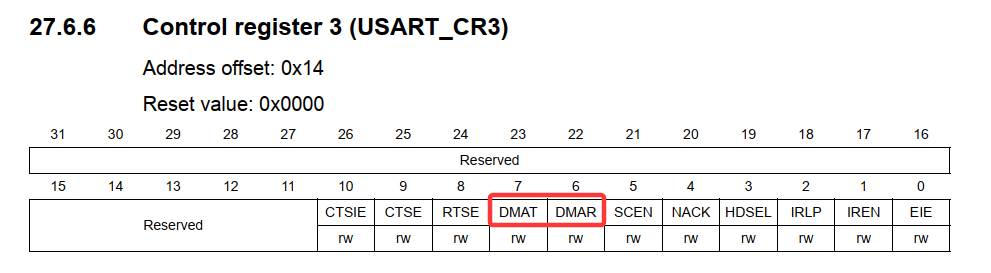
外设要使用 DMA,对应外设控制寄存器里必然有"开启 DMA"的配置位。以 USART1 为例,它的 CR3 寄存器 里的 DMAT (发送 DMA 使能)和 DMAR(接收 DMA 使能)就是开关。任何要用 DMA 的外设,都必然存在类似配置位。
7.5 细节 2:优先级聚合与仲裁过程
把"打开一个通道"想象成"选中一个开关"。多个通道的请求信号汇聚到仲裁器,仲裁器根据(软件优先级 → 硬件优先级)的顺序,选出当前应该占有总线的通道,执行该通道的数据搬迁。
7.6 核心结论:通道的内部构成
逻辑上,一个通道内部一定包含一套核心配置寄存器,n 个通道就包含 n 份核心寄存器。每个通道都要独立配置:优先级、传输方向、数据量、地址自增等,所以这些配置寄存器每个通道都有一份。
📌 本知识点一句话总结
DMA 通过"多通道"实现多外设的并发搬迁,每个通道是一个独立的"子 DMA"。多通道本质是分时复用总线 (同一时刻只有一个通道真正占有总线),终极目标是"不让总线闲着"。当多通道同时请求时,由仲裁器 决定谁先,优先级分两级:先看软件优先级(CCR 寄存器的 PL 位,4 级),相同再看硬件优先级(通道编号小的优先)。外设与通道的对应关系是芯片设计时固定好的硬映射(如 USART1_TX→通道4、RX→通道5),且一个通道具有"排他性"(同一时刻只能服务一个外设)。
8. 查文档:DMA 的寄存器与地址空间
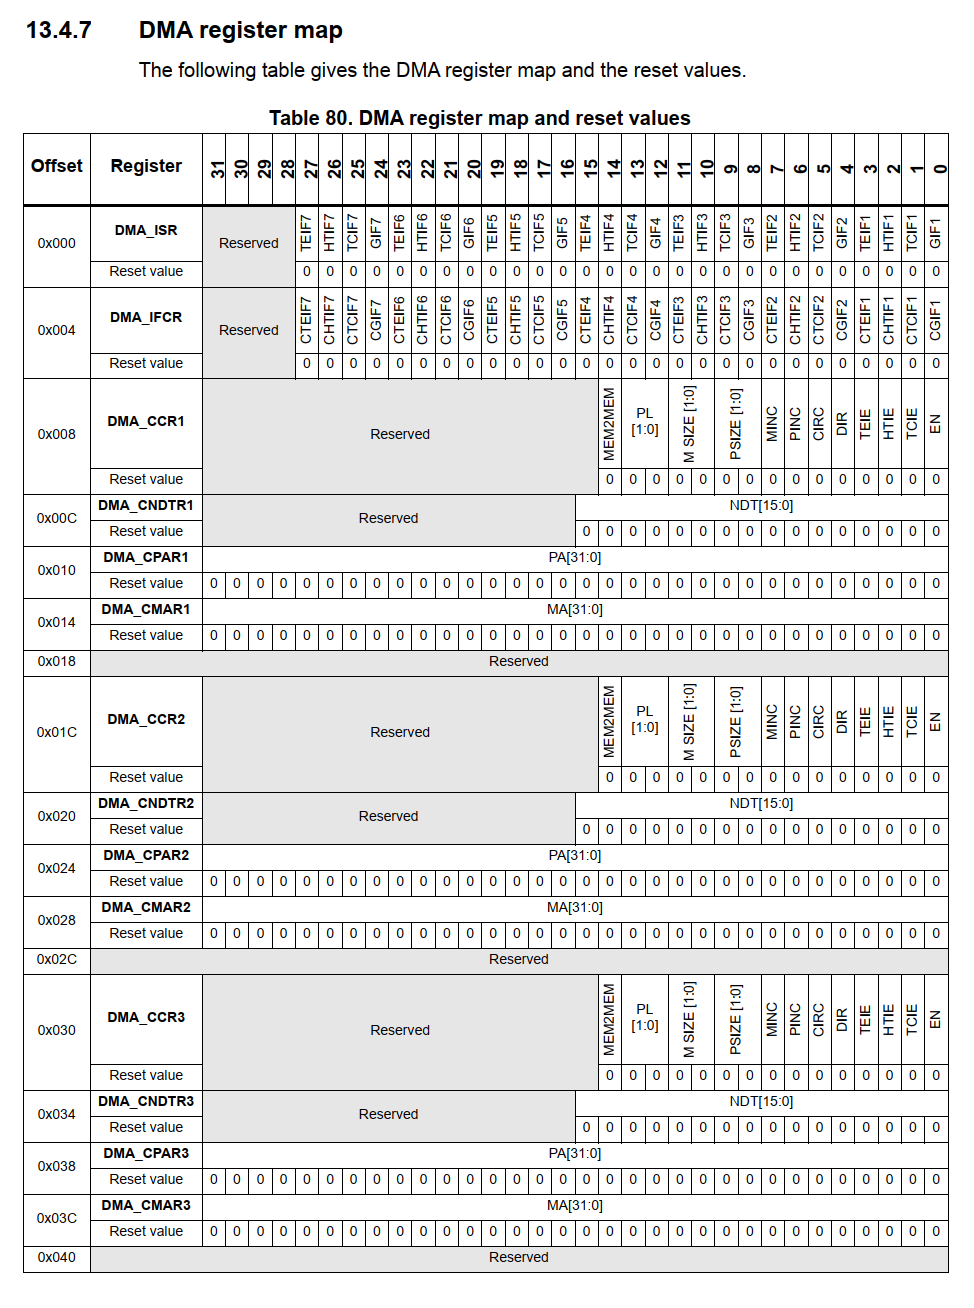
8.1 寄存器被映射到地址空间
STM32 的片上外设寄存器是统一编址、直接映射到 CPU 地址空间的,所以可以直接用 C 语言指针访问 DMA 模块。
8.2 DMA1 的地址范围
- DMA1 地址范围:
0x4002 0000~0x4002 03FF - 大小计算:
0x400203FF - 0x40020000 + 1 = 0x400 = 1024 字节 = 1KB - 注意:CPU 虽为 DMA1 分配了 1KB,但实际只用到开头很少一部分,后续地址是保留的,访问可能产生不可预知行为。
8.3 DMA1 的寄存器数量
DMA1 共有 2 + 4 × 7 = 30 个寄存器:
- "2":DMA1 整体关于通道中断管理的两个寄存器(即 ISR 和 IFCR,稍后讲)。
- "4":每个通道都有 4 个管理/配置类寄存器。
- "7":DMA1 有 7 个通道。
访问方式:0x40020000 + 寄存器偏移。
DMA2 结构几乎完全一样,只是:起始地址 0x40020400,只有 5 个通道,所以是 2 + 4 × 5 = 22 个寄存器。
核心结论:用 C 指针通过"基地址 + 偏移量"就能直接访问 DMA 内部寄存器,从而配置通道、控制 DMA 行为。
📌 本知识点一句话总结
STM32 的 DMA 寄存器是统一编址、可直接用 C 指针访问的。DMA1 基地址为
0x40020000,地址空间 1KB,共 30 个寄存器(= 2 个中断管理寄存器 + 每通道 4 个配置寄存器 × 7 个通道)。DMA2 基地址0x40020400,5 个通道,共 22 个寄存器。访问任意寄存器都是"基地址 + 偏移量",配置 DMA 的本质就是 CPU 写这些寄存器。
9. 通道核心配置寄存器
9.1 概览:每个通道 4 个寄存器
每个 DMA 通道有 4 个独立寄存器:
| 寄存器缩写 | 展开命名 | 英文全称 | 核心功能 |
|---|---|---|---|
DMA_CCRx |
DMA1_CCR1 ~ CCR7 | DMA Channel x Configuration Register | 配置与优先级:软件优先级、传输方向、模式、数据宽度、自增等 |
DMA_CNDTRx |
DMA1_CNDTR1 ~ CNDTR7 | DMA Channel x Number of Data to Transfer Register | 传输数量:设定并记录剩余待搬运数据总量 |
DMA_CPARx |
DMA1_CPAR1 ~ CPAR7 | DMA Channel x Peripheral Address Register | 外设地址:存储外设端起始物理地址 |
DMA_CMARx |
DMA1_CMAR1 ~ CMAR7 | DMA Channel x Memory Address Register | 存储器地址:存储内存端起始物理地址 |
每个通道都对应一套这 4 个寄存器,n 个通道就有 n 份。配置 DMA 的本质就是 CPU 设置这些寄存器。
9.2 CCR 寄存器详解
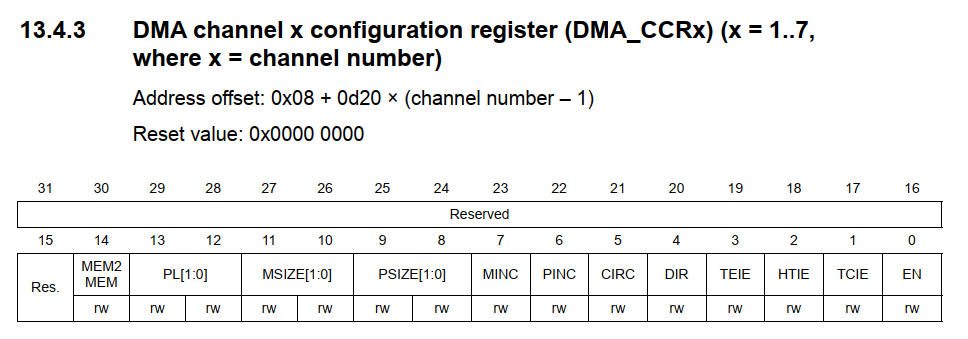
DMA_CCRx 是特定通道的核心寄存器。下面逐个解释其中的关键位。
9.2.1 通道使能 EN 与优先级 PL
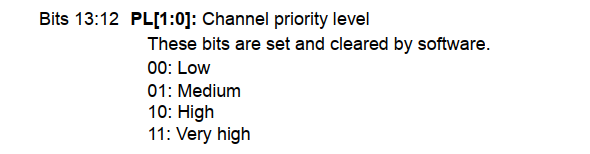
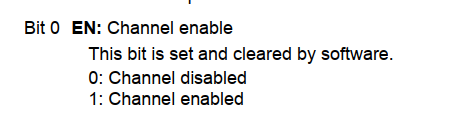
- EN(通道使能位) :决定是否开启对应通道。因为外设和通道是固定关联的,使能通道就允许对应外设使用该通道搬运数据。
- ⚠️ 细节:使能了 ≠ 仲裁成功。使能只表示"这个通道可以工作、可以参与申请仲裁",但当前是否真正搬运,取决于仲裁结果。
- PL(通道优先级):设置该通道的软件优先级(低/中/高/最高)。当多个通道同时申请时,仲裁器比较各通道 PL 值决定谁先。
9.2.2 传输方向 DIR
外设和存储器的 DMA 传输方向有两种:
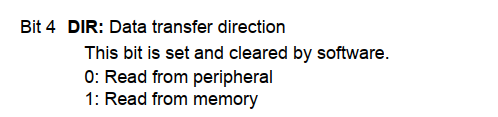
- DIR=0:外设 → 内存(从外设读)。例如从串口、I2C、SPI 接收数据。
- DIR=1:内存 → 外设(从内存读,即写外设)。例如向串口、I2C、SPI 发送数据。
记忆技巧:永远站在内存角度。
1像一支笔,用来写字,DIR=1 表示从内存"写"数据到外设。0像一张嘴,读书用嘴"读",DIR=0 表示把数据从外设"读"到内存。
9.2.3 数据宽度 PSIZE 和 MSIZE
数据宽度指定每次传输的数据大小,可配置 8/16/32 位。外设和内存是独立设备,可分别设置宽度。
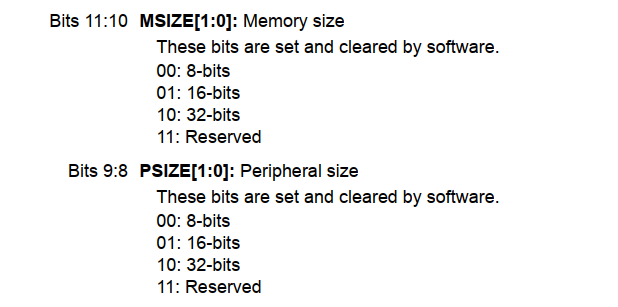
- 例如:外设 16 位、内存 16 位,则每次传输 2 字节。
⚠️ 注意:外设和内存宽度可以不同,但需匹配以避免数据错误:
- 源窄目的宽 → 数据扩展(类似
int b = a;里a是 char 会扩展);- 源宽目的窄 → 数据截断丢失(类似
char a = b;里b是 int 会截断)。多数情况把源端和目的端宽度配置相同即可避免截断错误。
9.2.4 地址自增 PINC 和 MINC
DMA 需要设置参与传输的双方是否会地址自增。
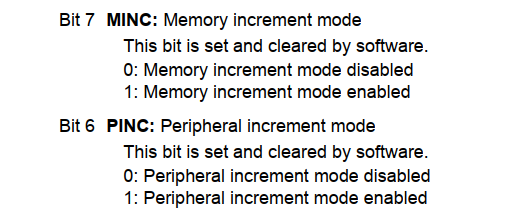
| 模式 | PINC/MINC | 步长逻辑 | 典型应用 | 说明 |
|---|---|---|---|---|
| 单增模式(常用) | PINC=0, MINC=1 | 外设固定,内存 +MSIZE | 串口收发 | 外设守着固定数据寄存器(如 USART_DR),内存按顺序存储 |
| 双增模式 | PINC=1, MINC=1 | 外设 +PSIZE,内存 +MSIZE | 数据拷贝 | 源地址和目的地址同步移动,整块迁移 |
| 双不增模式(不常用) | PINC=0, MINC=0 | 外设固定,内存固定 | 引脚镜像 | 两个地址原地踏步,硬件寄存器↔内存变量实时映射 |
地址自增时,按对应设备自己设置的数据宽度自增:
| 宽度设置 | 数据类型 | 物理步长 |
|---|---|---|
| 00(8 位) | uint8_t | +1 字节 |
| 01(16 位) | uint16_t | +2 字节 |
| 10(32 位) | uint32_t | +4 字节 |
9.2.5 循环模式 CIRC
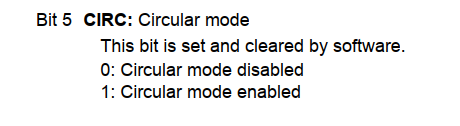
DMA 有时只需做一次,有时需要重复执行:
| 单次模式(Normal) | 循环模式(Circular) | |
|---|---|---|
| 核心逻辑 | 搬完预设数量即停止,进入空闲 | 搬完立即重头开始,无限循环 |
| CNDTR 归零后 | 保持为 0 | 自动重装为初始总数 |
| 地址指针 | 停留在末尾地址 | 自动跳回起始地址 |
| EN 使能位 | 硬件自动清零(通道关闭) | 始终保持 1(持续开启) |
| 再次触发 | 需软件重新配置并开启 EN | 只需启动一次,硬件自动触发 |
| 典型应用 | 串口发字符串、内存拷贝 | ADC 连续采样、音频播放、引脚镜像 |
| 数据覆盖风险 | 无(搬完即停) | 高(CPU 处理慢时第二圈覆盖第一圈) |
9.3 传输数量寄存器 CNDTR
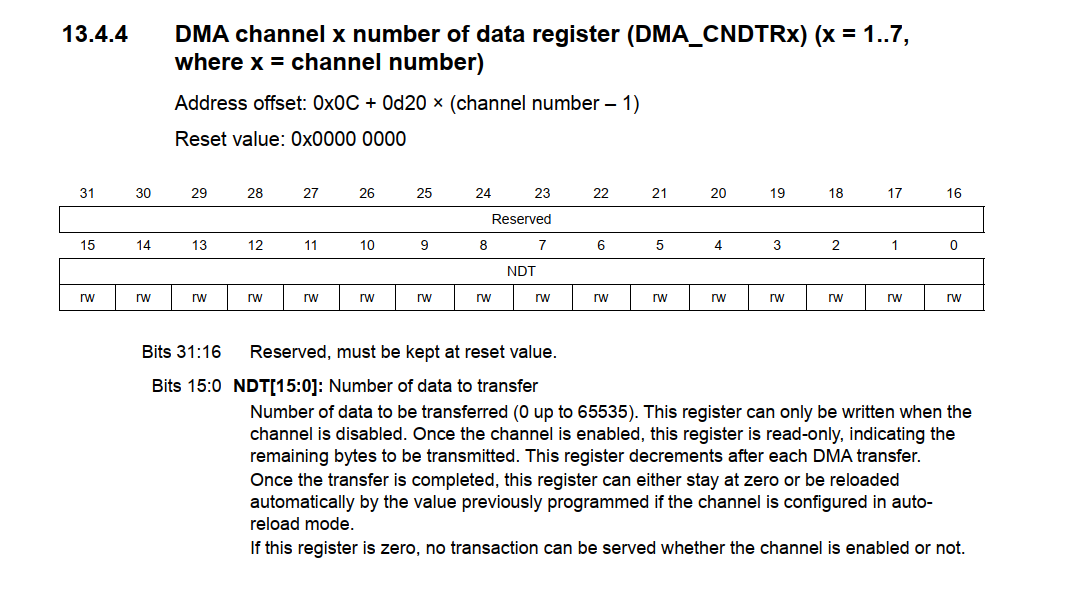
数据传输数量 NDT 表示"传输数据项的个数",最大可配置 65535。几点含义:
- NDT 不是字节数,实际总字节数 = NDT × 数据宽度。
- 示例:NDT=32,宽度 32bit(4 字节),总字节 = 32 × 4 = 128 字节。
- 数据宽度是"基本大小",传输数量是"多少个基本大小"。
- 从外设到内存:表示从外设读取的数据项个数;从内存到外设:表示向外设发送的数据项个数。
- NDT 决定了单次 DMA 传输何时结束(传输完成)。
9.4 外设地址 CPAR 与内存地址 CMAR
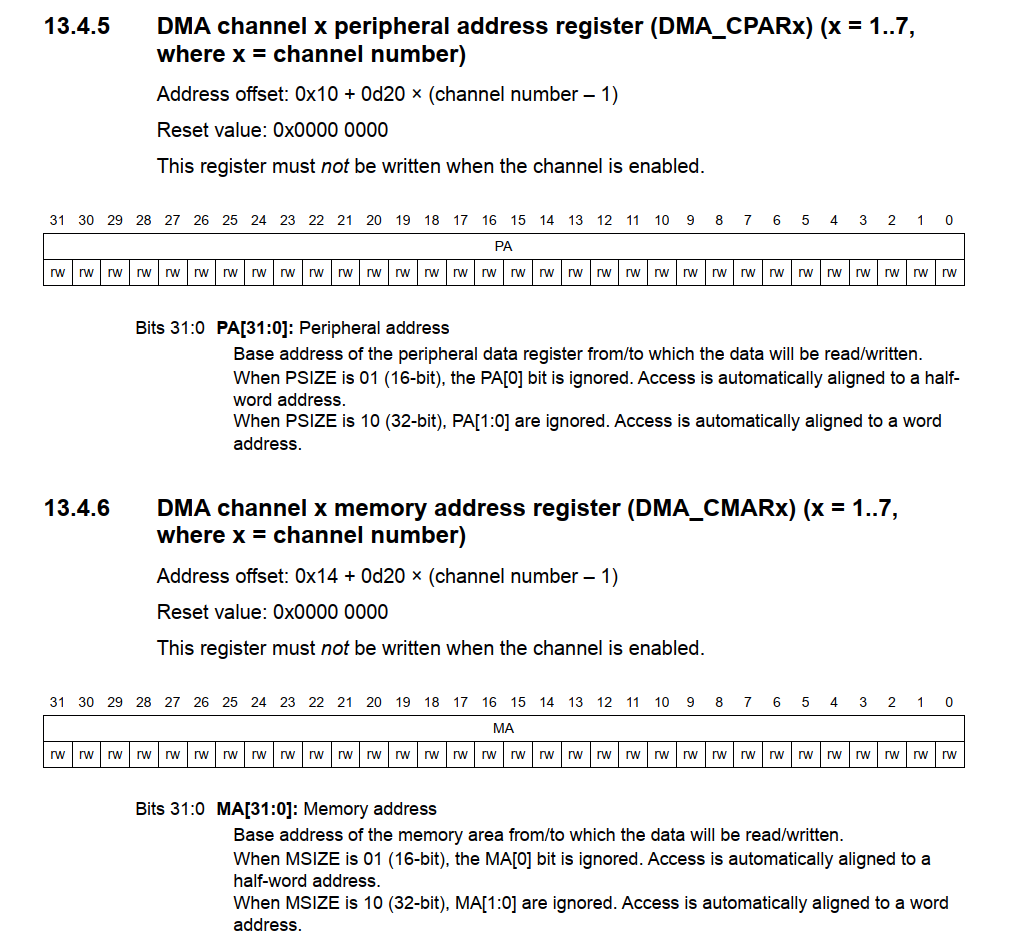
严格说,搬迁数据不是"从外设到内存",而是:
- 从外设数据寄存器(DR)到内存地址指向的空间,或
- 从内存地址指向的空间到外设数据寄存器。
所以通道配置里必然要有描述"源/目的"的寄存器:
DMA_CPARx:保存外设数据寄存器地址;DMA_CMARx:保存内存地址;- 再由
DMA_CCRx的 DIR 位表示传输方向。
对齐(了解即可):
- 半字对齐:地址能被 2 整除(bit0 = 0);
- 字对齐:地址能被 4 整除(bit0、bit1 = 0)。
- 现代 CPU 按"块"读内存(如一次 4/8 字节),若数据跨越两个读取周期则需读两次拼接,耗时翻倍。设置 2/4 字节读写单位时,DMA 会自动处理对齐。
9.5 通道配置小结
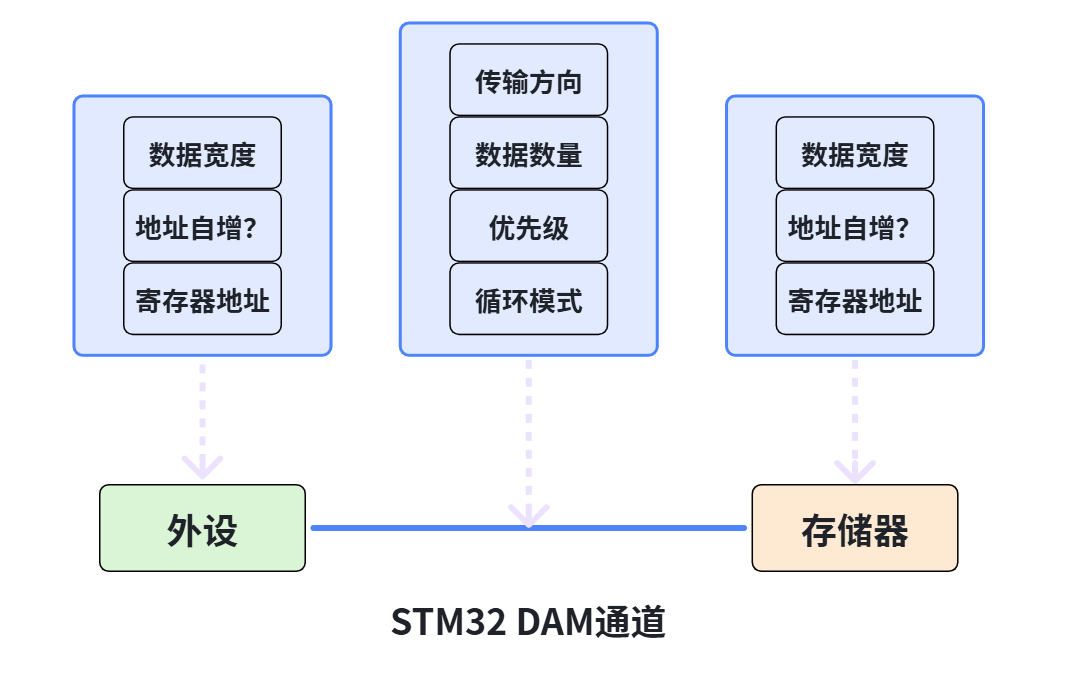
对单个 DMA 通道的配置参数,逻辑上分 3 类:
- 外设端:外设地址(CPAR)、外设数据宽度(PSIZE)、外设自增(PINC);
- 存储器端:内存地址(CMAR)、内存数据宽度(MSIZE)、内存自增(MINC);
- 传输过程参数:传输方向(DIR)、传输数量(CNDTR/NDT)、优先级(PL)、循环模式(CIRC)、中断使能(TCIE/HTIE/TEIE)等。
此时还有个未解决的问题:搬完了,CPU 怎么知道?------答案是中断,下一节讲。
📌 本知识点一句话总结
每个 DMA 通道由 4 个寄存器构成:
CCR(配置:方向/宽度/自增/循环/优先级/中断使能)、CNDTR(传输数据项个数 NDT,最大 65535,总字节 = NDT×宽度)、CPAR(外设数据寄存器地址)、CMAR(内存地址)。核心配置可归纳为三类:外设端、存储器端、传输过程参数。关键点:DIR 决定方向(0 外设→内存,1 内存→外设);宽度建议源/目相同避免截断;PINC/MINC 控制地址自增;CIRC 决定单次还是循环;NDT 决定何时结束。
10. DMA 中断:TC、HT、TE
10.1 直接回答问题
Q:数据搬迁完毕后,CPU 怎么知道?DMA 怎么告诉 CPU?
A:DMA(核心是通道)本质也是一个 MCU 片上外设,和串口、SPI、I2C 一样,也能通过中断通知 CPU。当 DMA 搬迁完数据,会通过中断通知 CPU,CPU 在中断处理函数里做后续处理。
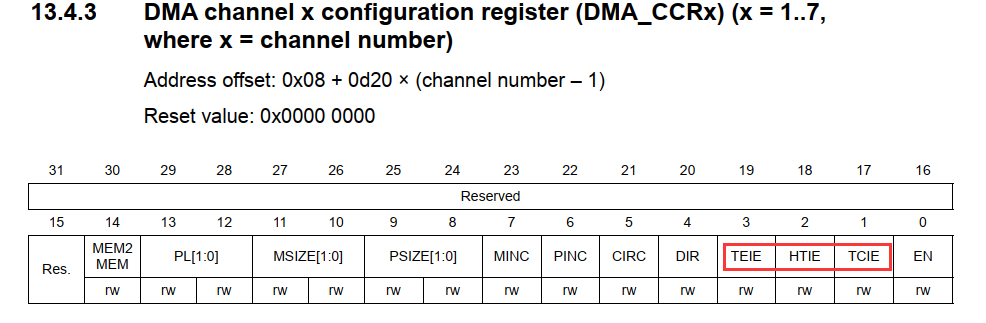
10.2 三种中断(在 CCR 里配置)
DMA_CCRx 里与中断有关的配置位(每个通道都有):
-
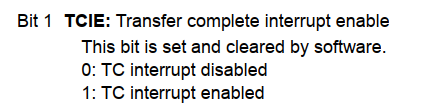
TCIE(传输完成中断使能) :所有数据传输完成时触发,最常用。作用就是通知 CPU"我搬完了,你可以处理了"。
-
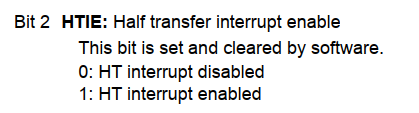
HTIE(半传输中断使能) :数据传输量达到预设总额一半 时触发。
-
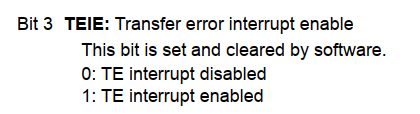
TEIE(传输错误中断使能) :传输中发生总线错误或配置冲突时触发,用于异常捕获和处理,避免程序卡死。
10.3 为什么要有"半传输中断"
原因 :实现数据传输与数据处理的并行,消除等待时间。
- 若只有 TC 中断,CPU 必须等整块数据搬完才能开始处理。
- 有了 HT 中断,可以先搬一半 → 触发 HT 中断 → CPU 处理前半段,同时 DMA 继续搬后半段,逻辑上"数据搬运"和"数据处理"并行进行。
双缓冲(Ping-Pong Buffering) 是 HT 的经典应用。假设 1024 字节缓冲区:
- 前半 512 字节填满 → 触发 HT 中断 → CPU 处理前半段,DMA 继续搬后半段;
- 后半 512 字节填满 → 触发 TC 中断 → 循环往复,像"接力赛"。
典型场景:音频播放。如果"读完再播放、再读再放",会卡顿;用 HT 中断让"播放音频"和"拷贝音频"同时进行,就能解决卡顿。
📌 本知识点一句话总结
DMA 通过中断通知 CPU 传输状态,在 CCR 寄存器里有三个中断使能位:TCIE(传输完成,最常用,通知 CPU 搬完可处理)、HTIE(半传输,搬满一半时触发)、TEIE(传输错误,捕获异常防卡死)。"半传输中断"的核心价值是实现搬运与处理的并行:先搬一半触发 HT,CPU 处理前半段时 DMA 继续搬后半段,即双缓冲(Ping-Pong)机制,典型用于音频播放等对实时性要求高的场景,消除"等全部搬完再处理"的等待时间。
11. 区分中断类型:ISR 与 IFCR
11.1 问题:一个通道就一根中断线,怎么区分是哪类中断
一个通道只有一根中断线连到 NVIC,最多传递"有中断了"这个信号,无法传递"是传输完成、传输一半、还是出错"这么多信息。
11.2 解决方案:DMA_ISR 与 DMA_IFCR
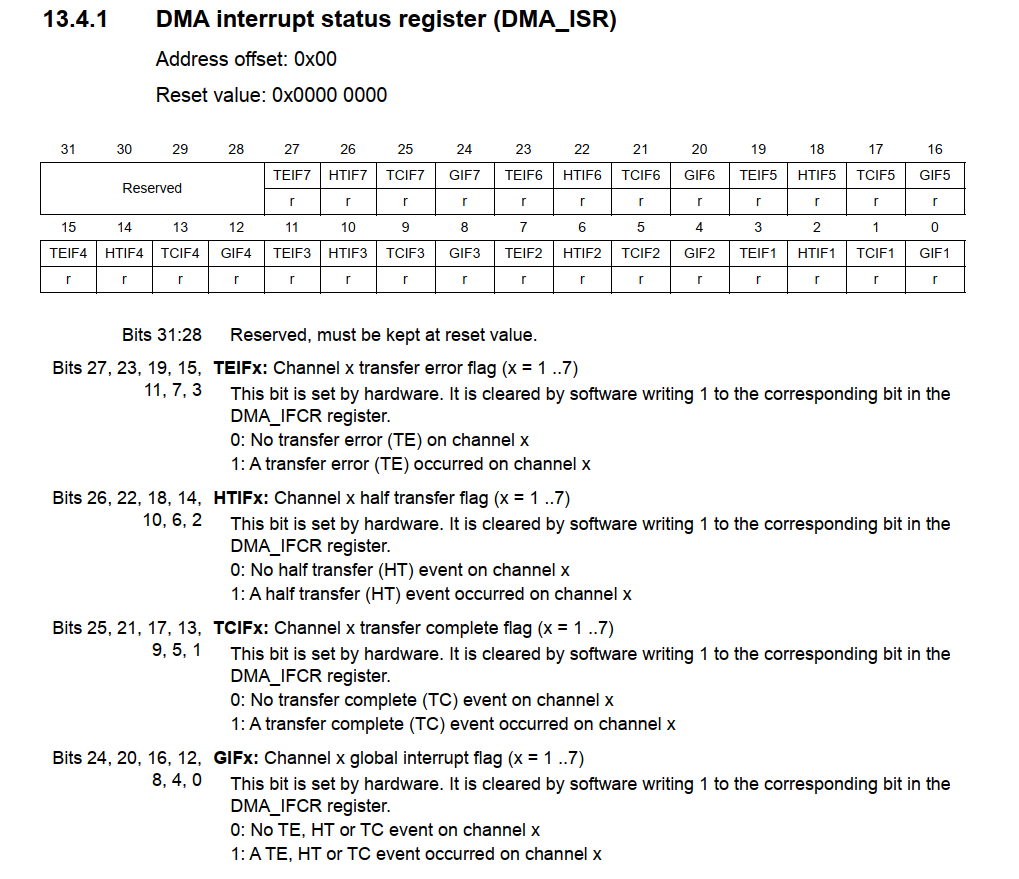
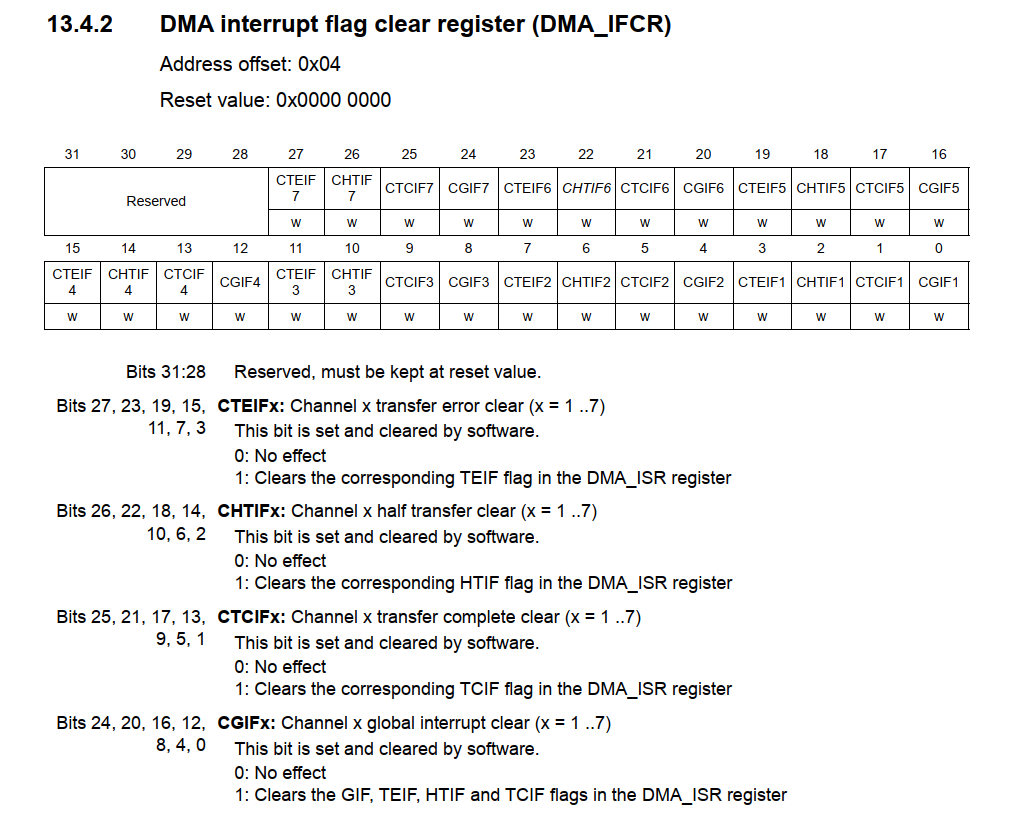
为了区分 DMA1 中 7 个通道、每个通道的不同中断类型,DMA 内部提供了两个中断管理寄存器(就是前面说的那"2"个寄存器)。
每个通道的中断情况由 4 个标志位表示:
- GIFx:是否产生了上述任意事件(全局中断标志);
- TCIFx:是否发生了传输完成;
- HTIFx:是否发生了半传输完成;
- TEIFx:是否发生了传输错误。
(x 表示通道号,1~7)
关键机制:
- 一旦特定通道产生中断,DMA 硬件除了向 CPU 发中断,还会自动 设置
DMA_ISR寄存器中对应的位。- 例如通道 5 发生 TC:
TCIF5=1, HTIF5=0, TEIF5=0, GIF5=1。
- 例如通道 5 发生 TC:
- CPU 收到中断后,回头读
DMA_ISR寄存器,就能明确是哪个通道、发生了什么中断,再做相应处理。至此 DMA 逻辑闭环。
标志位清除 :这些中断标志位是只读 的,不能直接写 0 清除。要清除,必须写 DMA_IFCR 寄存器的对应位(写 1 清零)。
比喻:你把村里的小朋友打了,小朋友不直接找你(打不过),而是去找你妈,让你妈收拾你。这里的"ISR 只读、IFCR 负责清除"就是类似的"间接操作"逻辑。
这些寄存器的设置和清除,后续有 HAL 库自动完成,我们读源码时再回来看文档即可。
📌 本知识点一句话总结
因为一个通道只有一根中断线,无法区分中断类型,DMA 用
DMA_ISR(中断状态寄存器)和DMA_IFCR(中断标志清除寄存器)来解决。每个通道有 4 个标志:GIF(任意事件)、TCIF(传输完成)、HTIF(半传输)、TEIF(传输错误)。硬件触发中断时会自动置位 ISR 对应位,CPU 在中断里读 ISR 即可判断是哪个通道、哪类中断。ISR 只读,清除标志要通过写 IFCR 的对应位完成。这两个寄存器就是 DMA1 那"2 个"中断管理寄存器。
12. 配置案例
12.1 案例 1:USART1 用 DMA 接收数据的配置
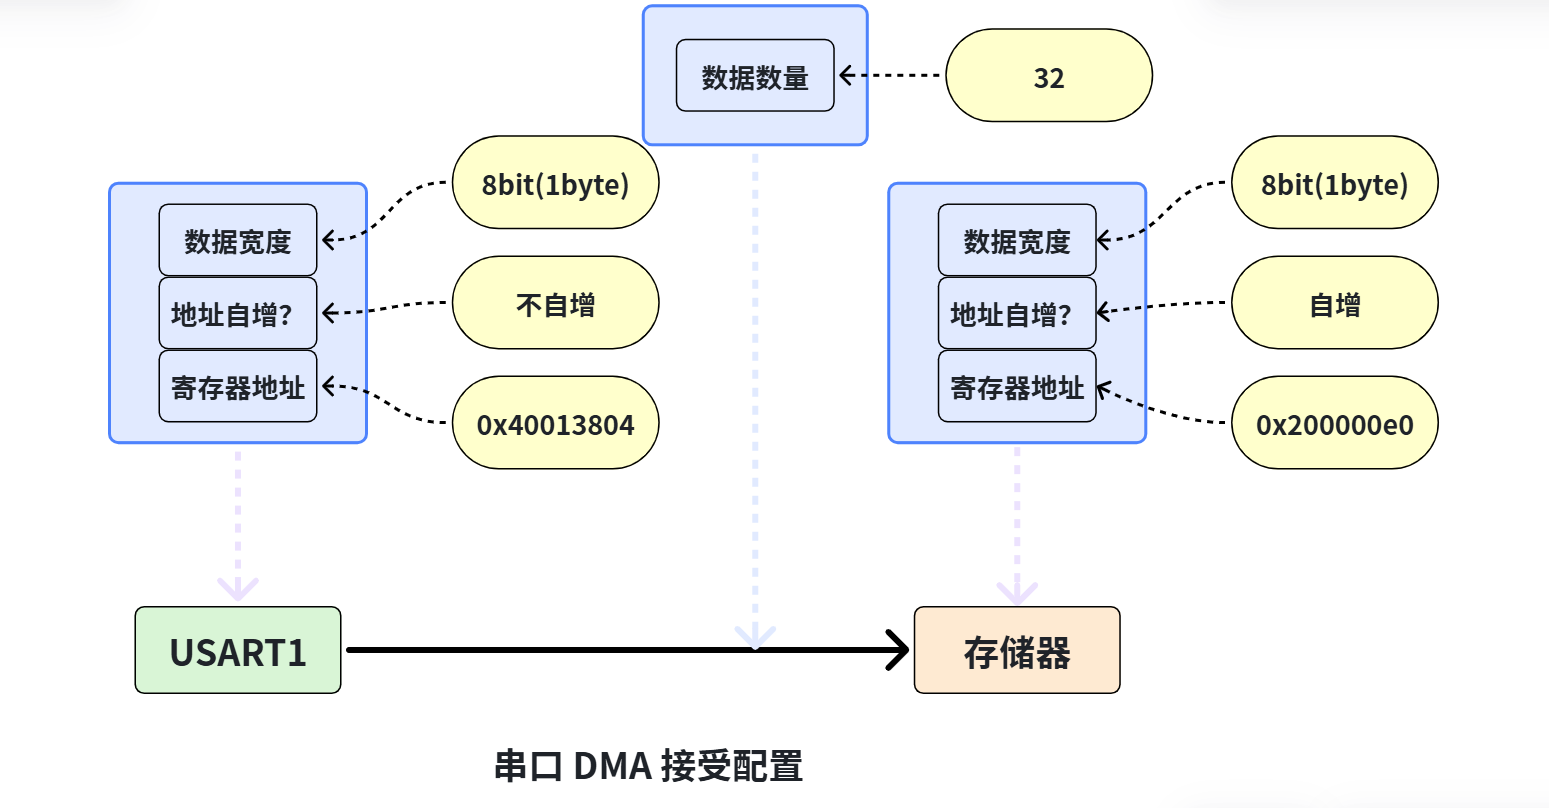
一个使用 USART1 的 DMA 模式进行接收的配置示例:
- 寄存器地址
0x40013804:就是 USART1 的数据寄存器(DR)地址。 - 数据宽度 8 位:因为串口有效数据是 8 位,收发端宽度都配 8 位。
- 外设端不自增:因为只有一个数据寄存器,外设地址固定。
- 存储器端自增:因为要连续保存串口数据,内存地址要自增。
12.2 案例 2:按图说话
需求:
- 传输方向:外设 → 存储器(DIR=0)。
- 外设只有一个 8 位数据寄存器,地址
0x40013804,记作REG(0x40013804)。 - 内存缓冲区 256 字节,起始地址
0x200000e0,记作BUF(0x200000e0)。 - 数据宽度 8 位,外设地址不自增,一次 DMA 传输读 256 字节,内存地址自增。
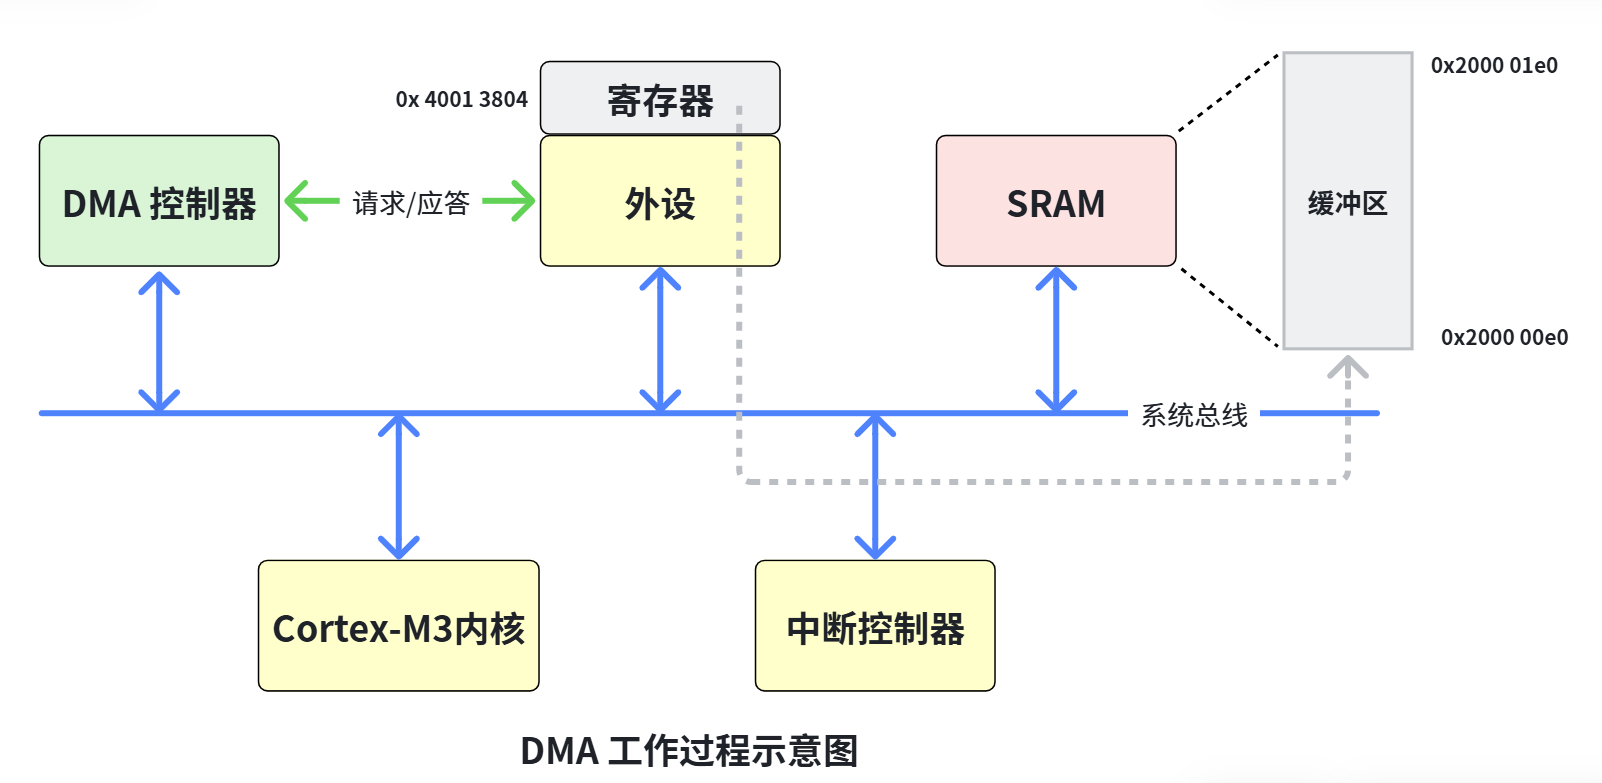
一次 DMA 传输过程:
- CPU 启动 DMA 数据传输。
- 外设寄存器数据非空,外设向 DMA 发出请求。
- DMA 应答,启动传输:
REG(0x40013804) → BUF(0x200000e0)。 - 传输完成,寄存器"数据非空"事件自动清除。
- 外设又来数据(非空),再次请求。
- DMA 应答,传输:
REG(0x40013804) → BUF(0x200000e0+1)。 - 传输完成,事件自动清除。
- ......(以此类推)
- 外设再来数据,请求。
- DMA 应答,传输:
REG(0x40013804) → BUF(0x200000e0+255)。 - 传输完成,事件自动清除。
- 256 字节搬完,产生传输完成(TC)中断。
这个案例完整串起了前面所有知识点:外设地址固定(PINC=0)、内存地址自增(MINC=1)、每搬一个字节外设请求一次、最后产生 TC 中断。
📌 本知识点一句话总结
配置一个串口 DMA 接收,核心是:外设地址填数据寄存器地址(如 USART1 的
0x40013804)且不自增,内存地址填缓冲区首地址(如0x200000e0)且自增,方向 DIR=0(外设→内存),宽度按外设数据位宽(串口 8 位)。工作过程是"外设每来一个数据就请求一次,DMA 搬一个字节并让内存地址 +1",搬满预设数量(如 256 字节)后产生 TC 中断。整个过程 CPU 不参与搬运,只在最后的中断里介入处理。
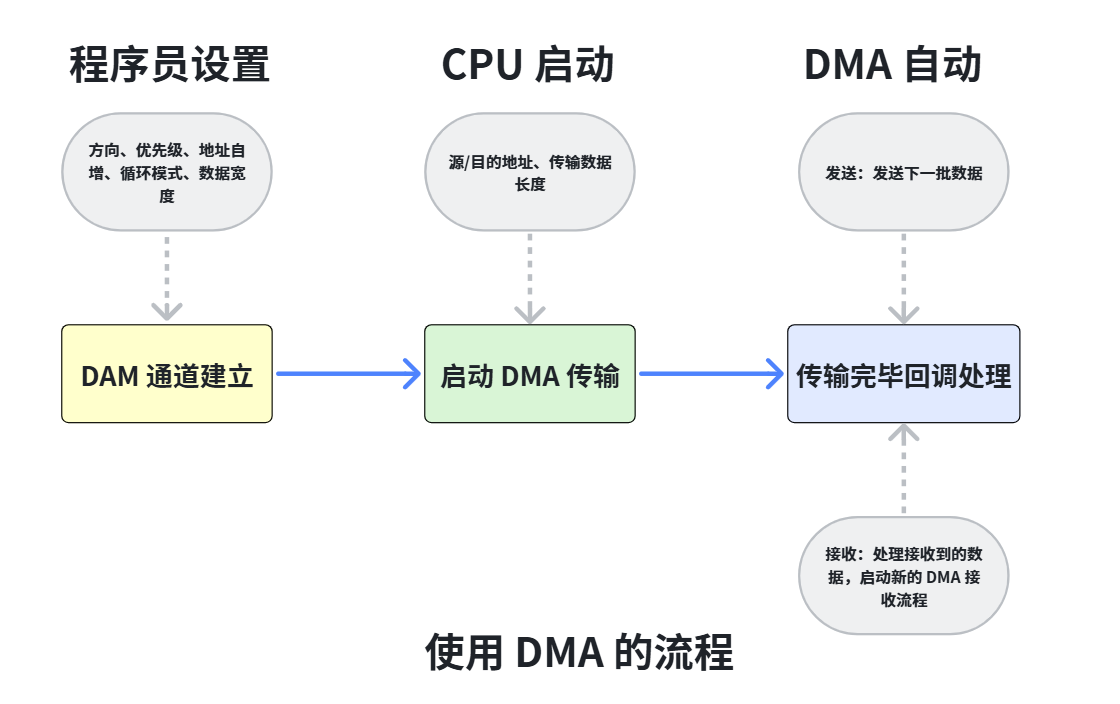
全文总结(速记卡)
- DMA 是什么:直接存储器访问,独立硬件控制器 + 总线主设备,代替 CPU 自动搬运数据。
- 为什么用:解放 CPU,把重复的搬运工作交给 DMA,CPU 专注业务逻辑。
- 四方关系:CPU(启动+收尾)、外设(发请求)、DMA(控制搬运)、内存(源/目的)。
- 工作流程:CPU 启动 → 外设请求 → DMA 握手搬运 → 中断通知 CPU。
- 总线共享:CPU 和 DMA 共享 AHB 总线,靠总线仲裁器循环调度,各占一半带宽,逻辑上互不影响。
- 通道与仲裁:多通道分时复用总线,仲裁器按"软件优先级(4 级)→硬件优先级(编号小优先)"仲裁;外设↔通道是硬映射(USART1_TX→通道4、RX→通道5),且排他。
- 寄存器 :DMA1 基地址
0x40020000,30 个寄存器;每通道 4 个(CCR/CNDTR/CPAR/CMAR)。 - CCR 关键位:EN(使能)、PL(优先级)、DIR(方向)、PSIZE/MSIZE(宽度)、PINC/MINC(自增)、CIRC(循环)、TCIE/HTIE/TEIE(中断)。
- 中断:TC(完成)、HT(半传输,双缓冲并行)、TE(错误);用 ISR 读状态、IFCR 清标志。
- 使用流程:配置外设 DMA 使能位 → 配置通道 4 寄存器 → 使能通道 → 中断收尾。