**引言:**从文本内容中抽取实体已经成为增强许多下游任务表现的一个关键因素。如何安装spacy库,下载spacy预训练语言模型以及使用模型抽取文本中的实体信息是本文的重点关注问题。若想详细了解spacy模型可以浏览github库https://github.com/explosion/spacy-models
文章目录
一、spacy安装
最简单直接的方式是采用以下命令直接在终端实施在线安装spacy包。
c
pip install spacy受python版本以及相关依赖包的缺乏,经常出现无法安装的窘境。为此,我们下载spacy包和相应的依赖包murmurhash、cymem,采用离线安装whl的方式实现安装。三个相关依赖包可通过官网下载:https://pypi.org/。一定要保证三个依赖包与自己的python版本匹配!!
c
1.pip install murmurhash-1.0.10-cp37-cp37m-win_amd64.whl
2.pip install cymem-2.0.8-cp37-cp37m-win_amd64.whl
3.pip install spacy
二、spacy预训练模型安装
从https://spacy.io/models库中找到对应语言的预训练模型。
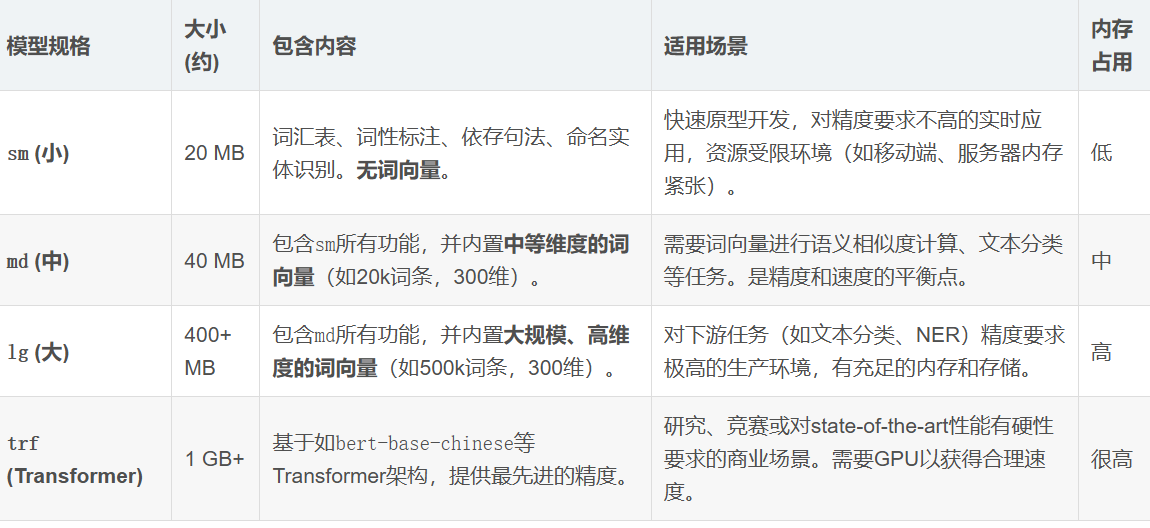
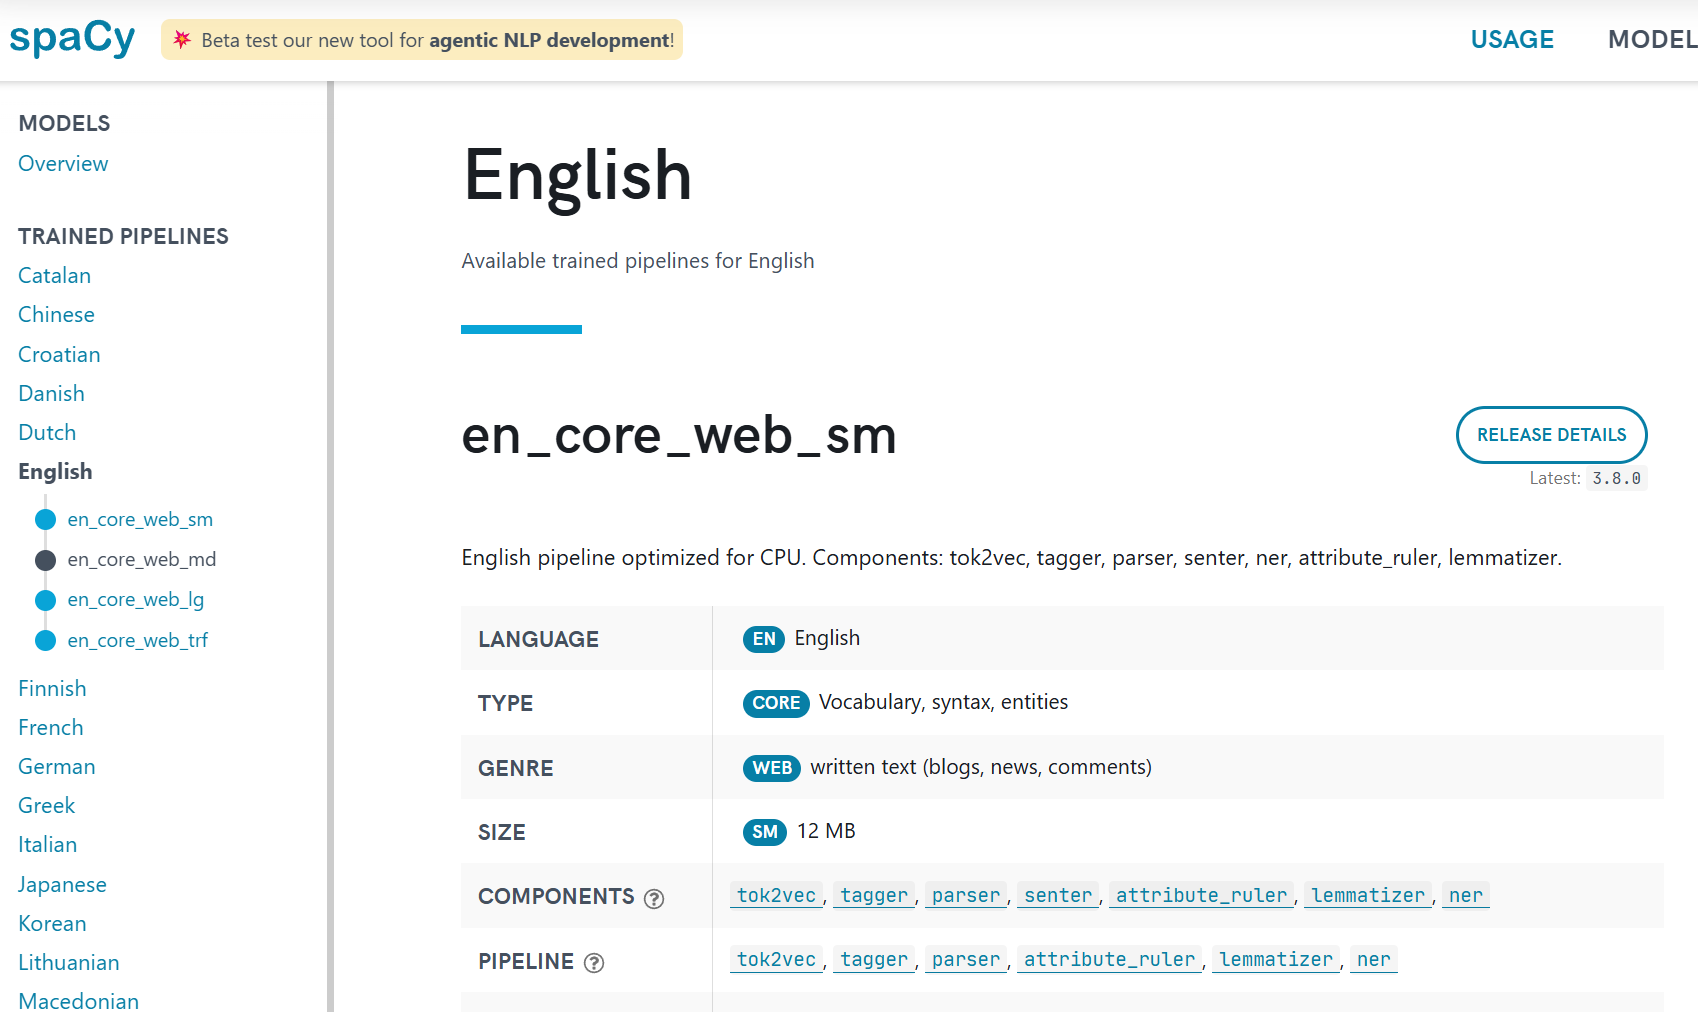 模型分为四类,各类模型描述如下:
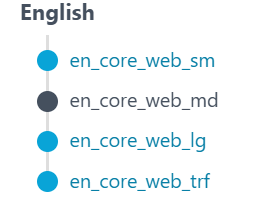
将与spacy版本对应的某语言模型的tar.gz或.whl文件下载到本地文件夹中,用pip install 命令安装预训练模型。
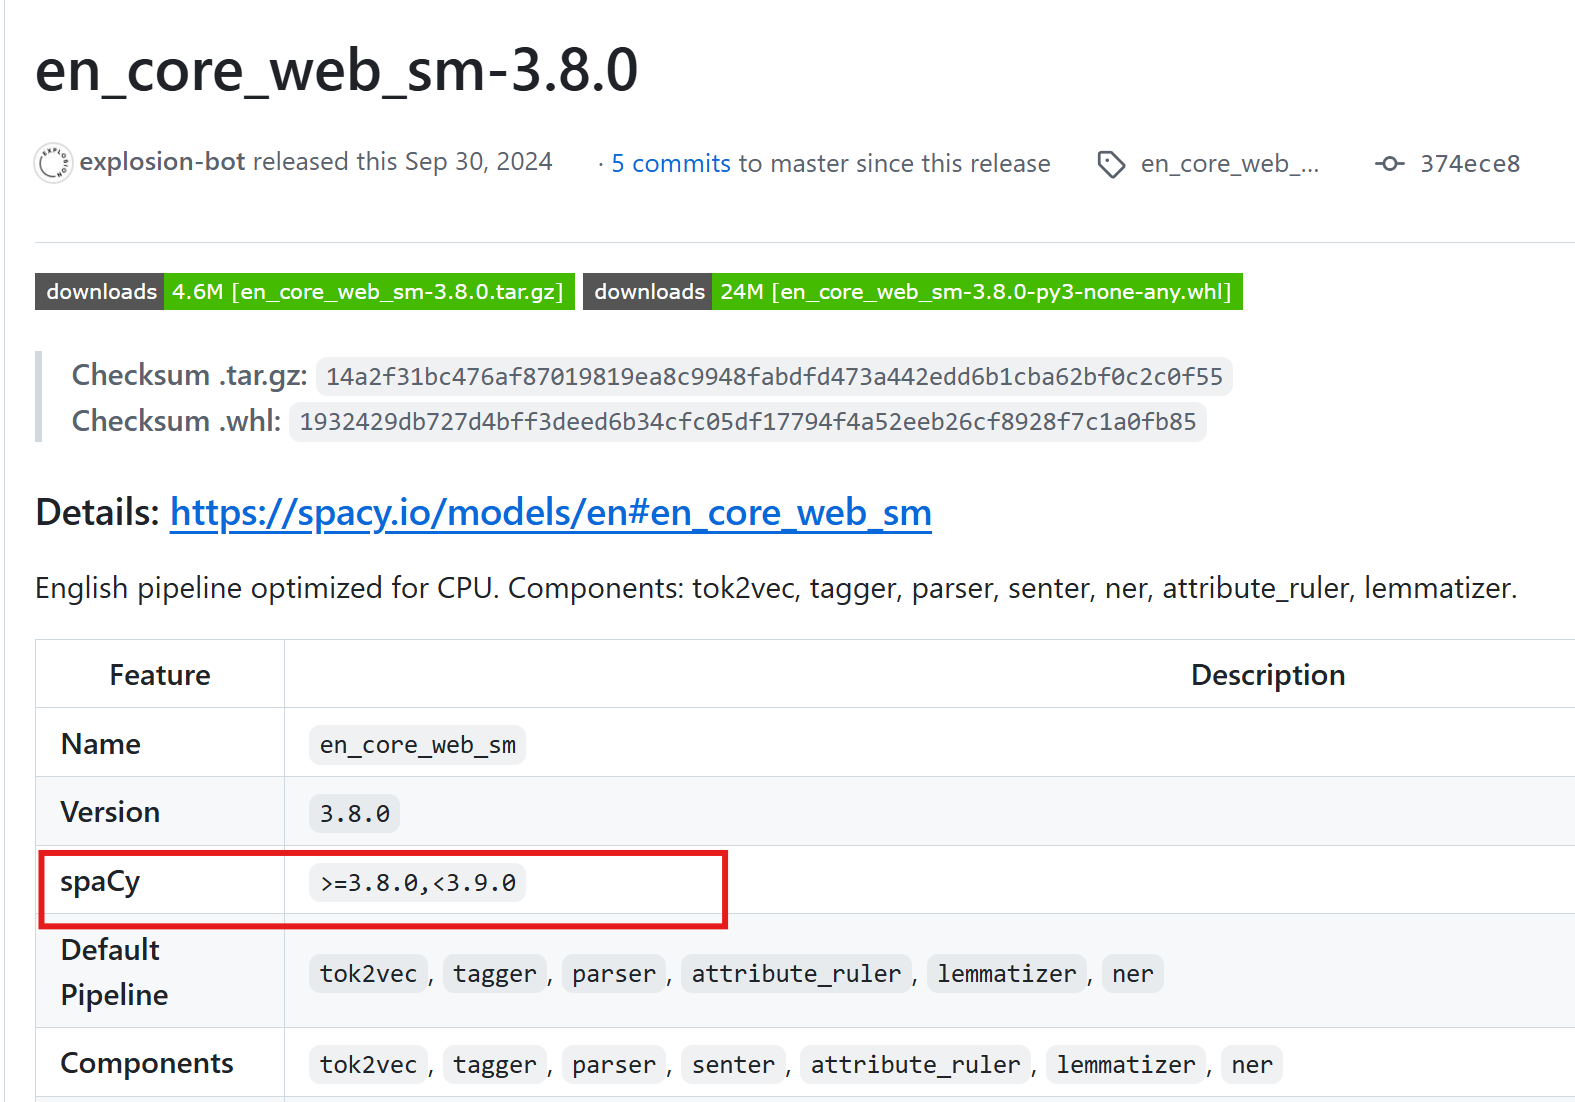
三、spacy模型的使用pytorch代码
下面列举两个英文和中文提取实体信息的示例代码
c
import spacy

try:
    nlp_en = spacy.load("en_core_web_sm")
    print("✅ English spaCy 模型加载成功!")
except Exception as e:
    print(f"❌ 加载失败:{e}")

try:
    nlp_zh = spacy.load("zh_core_web_sm")
    print("✅ Chinese spaCy 模型加载成功!")
except Exception as e:
    print(f"❌ 加载失败:{e}")

def extract_entities(text, lang="en"):
    """
    抽取文本中的实体
    lang: "en" 英文, "zh" 中文
    """
    nlp = nlp_en if lang == "en" else nlp_zh
    doc = nlp(text)
    return [(ent.text, ent.label_) for ent in doc.ents]


text = 'Apple Inc. was founded by Steve Jobs in Cupertino, California.'

en_text = "Apple Inc. was founded by Steve Jobs in Cupertino, California."
print("英文实体:")
for text, label in extract_entities(en_text, "en"):
    print(f"  {text}: {label}")

# 中文示例
zh_text = "2024年,阿里巴巴集团在杭州举办了云栖大会,创始人马云出席并发言。"
print("\n中文实体:")
for text, label in extract_entities(zh_text, "zh"):
    print(f"  {text}: {label}")
总结: spacy包已经成为抽取实体信息的必要环节。本博文从安装依赖包到下载预训练模型进行描述。如果对您有帮助,不要吝惜的点一个赞呀😁😁😁
参考博文:
1.https://www.cnblogs.com/my16/p/15167257.html
2.https://blog.csdn.net/cicd6pipeline/article/details/151013912